目录
自编教材分享:第十一章—MPI程序简介(二)

收录于文集
共41篇
07:08
自编教材分享:第十一章—MPI程序简介(二)
1106
0
MPI程序编写
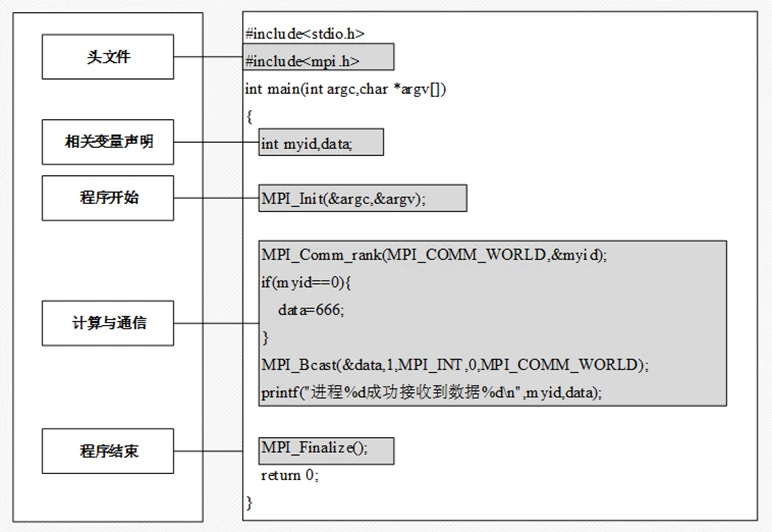
MPI程序的基本框架
主要由头文件、相关变量声明、程序开始、计算与通信和程序结束五部分组成。
入门的MPI程序
此代码的目的是使用0号进程发送一个整型数据,1号进程接收这个数据。
代码块
JavaScript
自动换行
复制代码
#include<stdio.h>
#include<mpi.h>
int main(int argc,char *argv[])
{
     int world_rank,world_size,send,recv;
     MPI_Status status;
     MPI_Init(&argc,&argv);
     MPI_Comm_rank(MPI_COMM_WORLD,&world_rank);
     MPI_Comm_size(MPI_COMM_WORLD,&world_size);
   if(world_rank==0){
        send=666;
        MPI_Send(&send,1,MPI_INT,1,0,MPI_COMM_WORLD);
        printf("共%d个进程,其中进程%d成功发送数据%d\n",world_size,world_rank,send);
    }
    if(world_rank==1){
        MPI_Recv(&recv,1,MPI_INT,0,0,MPI_COMM_WORLD,&status);
        printf("共%d个进程,其中进程%d成功接收数据%d\n ", world_size , world_rank,recv);
    }
    MPI_Finalize();
    return 0;
}
复制成功
将该程序命名为ex.c后,分别使用命令mpicc -o ex ex.c和mpirun -np 2 ex对其进行编译运行,得到如下结果:
代码块
JavaScript
自动换行
复制代码
共2个进程,其中进程0成功发送数据666
共2个进程,其中进程1成功接收数据666
复制成功
MPI版矩阵乘
串行矩阵乘法
代码块
JavaScript
自动换行
复制代码
#include<stdio.h>
#include<mpi.h>
#include<time.h>
#include"mympi.h"
#define DIMS 1000
int main(int argc,char *argv[]){
     data_t *A,*B,*C,i;
     double start_time,end_time;
     A=(data_t*)malloc(sizeof(data_t)*DIMS*DIMS);
     B=(data_t*)malloc(sizeof(data_t)*DIMS*DIMS);
     C=(data_t*)malloc(sizeof(data_t)*DIMS*DIMS);
     //初始化A和B矩阵
   //初始化函数传参2意味随机生成0/1矩阵,传入1代表生成0矩阵
    Init_Matrix(A,DIMS*DIMS,2);
    Init_Matrix(B,DIMS*DIMS,2);
    Init_Matrix(C,DIMS*DIMS,1);
    start_time=(double)clock();
    //矩阵A与B相乘,结果存于矩阵C
    Mul_Matrix(A,B,C,DIMS,DIMS,DIMS);
    end_time=(double)clock();
    printf("进程的执行时为:%.2lf\n",(end_time-start_time)/1e3);
    free(A);
    free(B);
    free(C);
return 0;
}
复制成功
MPI_Bcast:函数可以使用一个进程将消息广播发送给通信域中所有其它进程,同时包括它本身在内
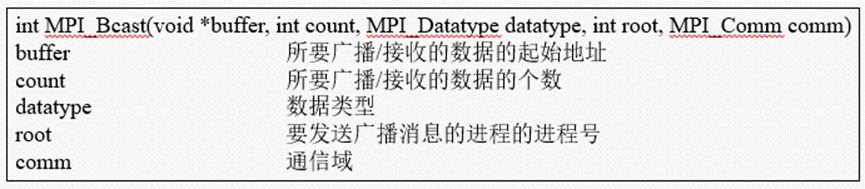
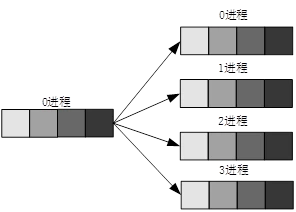
基础并行矩阵乘法:
代码块
JavaScript
自动换行
复制代码
#include<stdio.h>
#include<mpi.h>
#include"mympi.h"
#define DIMS 1000
int main(int argc, char *argv[]){
     data_t *A,*B,*C;
     int world_rank, world_size,lens,i;
     double start_time, end_time;
     MPI_Init(&argc, &argv);
     MPI_Comm_rank(MPI_COMM_WORLD, &world_rank);
     MPI_Comm_size(MPI_COMM_WORLD, &world_size);
     if(DIMS%world_size!=0){
        printf("总进程数world_size应整除矩阵维数DIMS!!!\n");
        MPI_Finalize();
        return 0;
    }
    //为所有进程创建A、B、C的空间并初始化C
    //在0进程初始化A、B进程
    A=malloc(sizeof(data_t)*DIMS*DIMS);
    B=malloc(sizeof(data_t)*DIMS*DIMS);
    C=malloc(sizeof(data_t)*DIMS*DIMS);
    Init_Matrix(C,DIMS*DIMS,1);
    if(world_rank==0){
        Init_Matrix(A,DIMS*DIMS,2);
        Init_Matrix(B,DIMS*DIMS,2);
    }
start_time=MPI_Wtime();
    //广播矩阵A、B到其它所有进程
    MPI_Bcast(A,DIMS*DIMS,MPI_FLOAT,0,MPI_COMM_WORLD);
    MPI_Bcast(B,DIMS*DIMS,MPI_FLOAT,0,MPI_COMM_WORLD);
    //每个矩阵要处理的A的行数
    lens = DIMS/world_size;
    //将A对应行与B相乘,结果存于C对应行
    Mul_Matrix(A+lens*DIMS*world_rank,B,C+lens*DIMS*world_rank,lens,DIMS,DIMS);
    //各进程将自身计算的C广播到其它进程,组合成完整的C
    for(i=0;i<world_size;i++){
        MPI_Bcast(C+i*lens*DIMS,lens*DIMS,MPI_FLOAT,i,MPI_COMM_WORLD);
    }
    end_time=MPI_Wtime();
    printf("进程%d的运行时间为:%lf\n",world_rank,(end_time-start_time));
    free(A);
    free(B);
    free(C);
    MPI_Finalize();
    return 0;
}
复制成功
本文为我原创,未经授权禁止转载
cv29589746
分享至
投诉或建议
