
今年你可能会被大模型,生成式AI等震惊到,因为这些东西真的很棒,但同样不可忽略的还有DeepMind的AlphaTensor。
AI与数学亦师亦友中介绍了如何利用AI发现数学定理,证明了AI可以帮助数学,今天要讲的AlphaTensor则是DeepMind另一个更加具体的AI应用:用AI加速矩阵乘法。
矩阵乘法是一种非常重要的基础计算,提升矩阵乘法效率被视为21世纪最难解决的问题之一。
官方博客:https://deepmind.google/discover/blog/discovering-novel-algorithms-with-alphatensor/
代码:https://github.com/google-deepmind/alphatensor
论文:https://www.nature.com/articles/s41586-022-05172-4 关注微信公众号:人工智能大讲堂,后台回复at获取论文和代码
有意思的是Google DeepMind喜欢以Alpha开头命名,例如,Alphago,AlphaZero,AlphaDev:用AI帮你生成排序算法,AlphaFold,AlphaCode 等等。Alpha代表着起点和开端的意思。这符合DeepMind试图在AI领域进行开拓和创新的理念。都哪些地方用到了矩阵乘法?例如,图像处理中的卷积,文本处理中的Transformer,可视化中的图像操作,数据压缩中的PCA。
通常一个矩阵乘法实现中,除了乘法还包括加法操作,为什么只关注乘法操作?
因为乘法无论对于CPU和GPU来说,都是比加法昂贵的。它需要消耗更多的时钟周期。
那么一个矩阵乘法需要多少乘法操作呢?
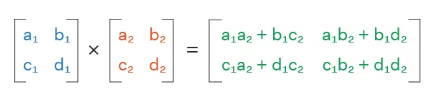
对于一个2*2的矩阵乘法,标准方法需要8次乘法操作
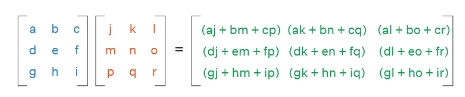
对于一个3*3的矩阵乘法,标准方法需要27次乘法操作
以此类推,一个大小为n的方阵,矩阵乘法中乘法操作的个数是O(n^3),可见乘法操作随矩阵大小呈指数级增长。
有没有更快的算法呢?
德国数学家Volken Strassen于1969年发现的更高效的Strassen's algorithm。
如下图所示,左侧为标准方法,右侧为Strassen方法,后者7次乘法运算,比标准方法8次乘法运算少一次。
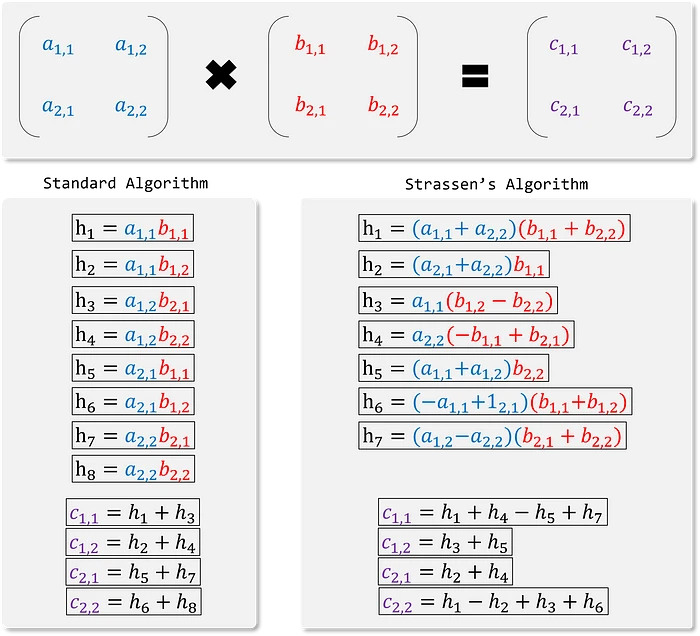
对于更大的矩阵乘法,该算法基于分治策略,将原始矩阵划分为更小的子矩阵,并使用递归的方式使用Strassen方法进行计算。

但科学家相信一定存在比Strassen方法更高效的方法,只不过我们目前还没发现。
而这种更高效的算法终于在Strassen方法提出50年后被发现,DeepMind将矩阵乘法转换为矩阵的低秩分解,并利用强化学习进行求解,它就是本文要将的AlphaTensor。
AlphaTensor 是如何实现的呢?
这有点类似于之前所说的[换个角度看问题]以及[拉格朗日乘子法与对偶问题]。既然在矩阵乘法这个原始问题中,很难找到比Strassen更高效的组合,那就换个角度,将其转换成其他更容易求解问题。
1.矩阵乘法的张量表征
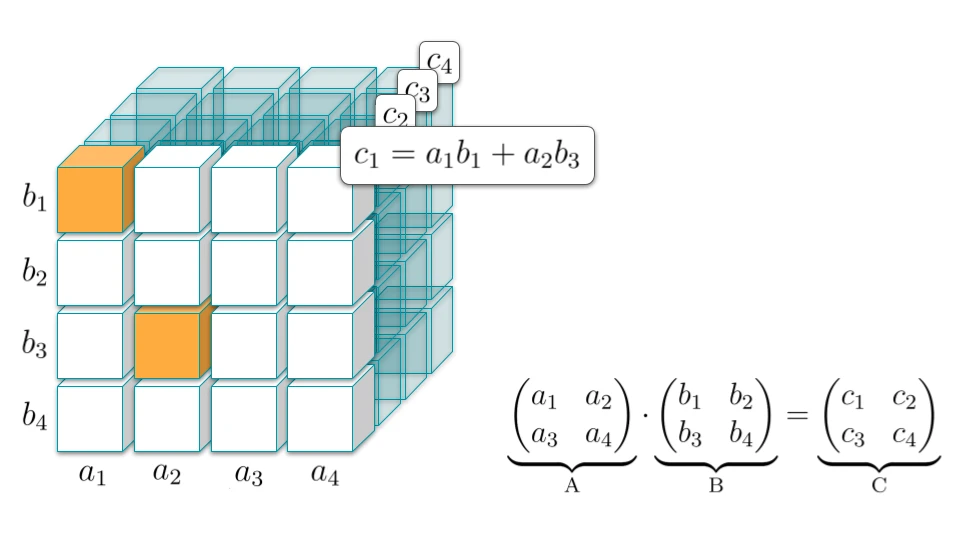
以2x2的矩阵乘法为例,c1=a1*b1+a2*b3,也就是c1的值对应了a1*b1和a2*b3两部分。分别以a、b、c为x轴、y轴、z轴,将这一对应关系表示在3维坐标中就得到 (a1, b1, c1) 和 (a2, b3, c1) 2个点。在c1这个维度上,将 (a1, b1, c1) 和 (a2, b3, c1) 2个点的位置标记为“1”,其余的位置标记为“0”,就得到了这种对应关系的一种“数值表征”。类似的,也可以得到在c2、c3、c4维度上各自的“数值表征”。也就是说,只要A,B大小确定,就存在唯一3D Tensor表征矩阵乘法AB=C。
AlphaTensor将矩阵乘法问题用张量进行表征,这也是AlphaTensor中Tensor的由来,任何维度的矩阵乘法都可以统一表示成一个3D Tensor,一种尺寸的矩阵乘法的计算过程对应一个唯一的张量表征。
有了Tensor这种数据表征,和矩阵乘法有什么关系?
2.矩阵乘法与张量表征的低秩分解存在一一对应关系
先说结论:一种3D Tensor的分解方法就唯一确定了一个矩阵乘法的算法流程。张量分解的秩越小,导出的矩阵乘法算法中的乘法次数越少。
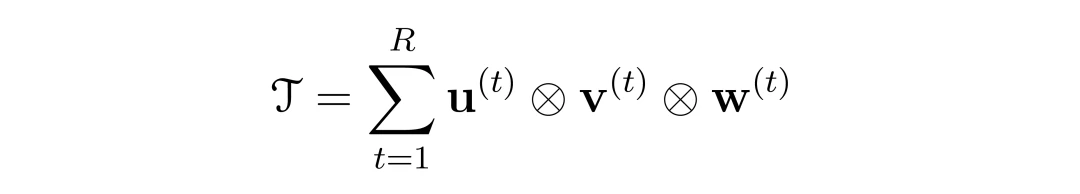
为3D Tensor,R就是乘法次数,接下来就是要找到最小的R。
在对3D Tensor的分解中,每个单独的因子u⊗v⊗w 相当于一次乘法步骤。下图说明了在 Strassen 算法中这种机制如何工作:
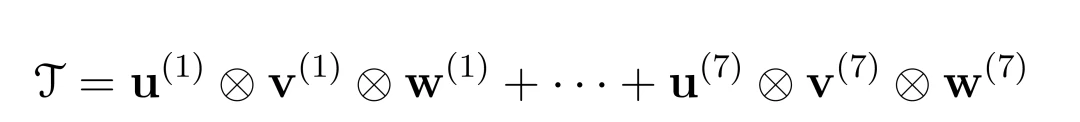
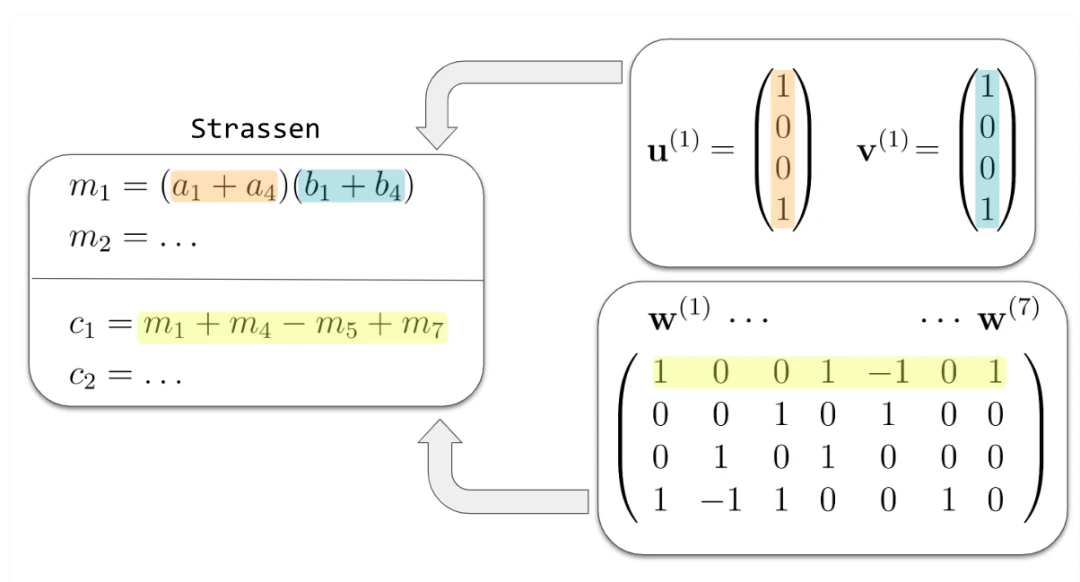
总结起来,为了找到一个新的算法(R次乘法),只需要找到将张量分解为上述形式的R个乘积u⊗v⊗w的分解即可。至此,已经将“设计更高效的矩阵乘法算法问题”,转换为“寻找秩更小的张量低秩分解问题”。
有人可能会说了,用暴力搜索的方法去测试所有的组合呢?答案是不行,因为搜索空间实在是太大了,仅仅是4*4的矩阵,就是3*3矩阵的10^10倍。
此时就需要一些更加复杂的策略。AlphaTensor的做法是通过玩一个名为TensorGame的三维棋盘游戏来实现。
张量分解可以被重新解释为一个强化学习问题,将环境建模为一个单人三维棋盘游戏,即TensorGame。

游戏目标:对于任意的张量,我们希望找到一个将
分解为R个外积u⊗v⊗w的分解,其中R代表算法中的乘法次数,使得乘法次数尽可能小。
游戏的进行如下:
第0步(t = 0):初始状态被设置为我们想要分解的目标张量:
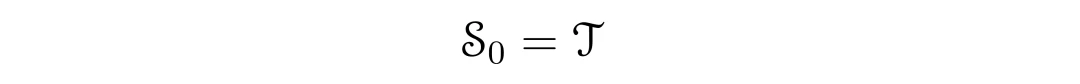
第t步(t = 1,2,3,...):玩家选择三个向量:
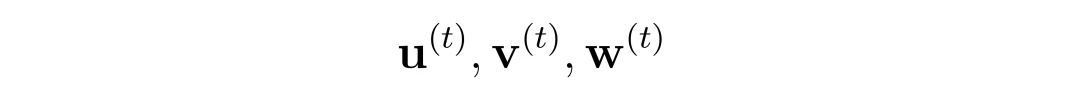
并且新的状态通过递归更新为:
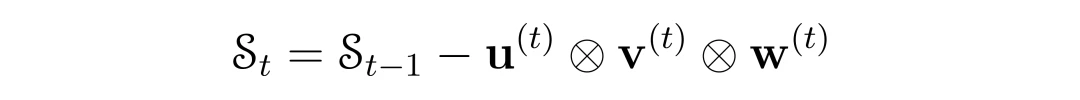
游戏结束:在经过R步之后,玩家达到了零张量:
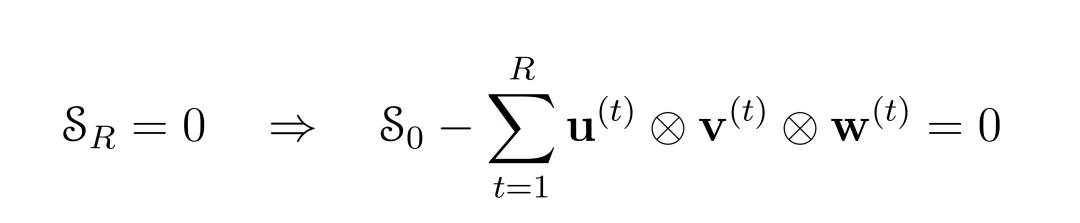
此时,这将给出初始张量的张量分解。在每一步t中,都会有一个负的奖励,鼓励尽量少的步骤达到零。如果达到预设的最大移动次数,此时玩家还没有达到0,则会施加额外的负奖励。
将前面所有东西组织在一起就构成了AlphaTensor,最后来一张总的流程图。
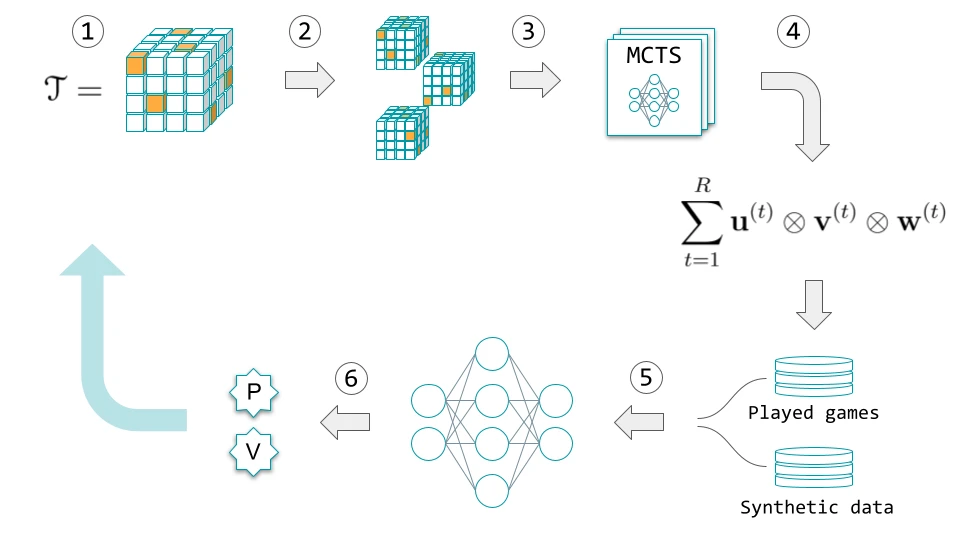
1.TensorGame开始:输入一个三维张量T,对应于乘法A * B = C的计算。
2.数据增强步骤: T通过随机选择的基变换进行变换(这些是根据不同参考系统表示相同张量的等效方式)。AlphaTensor被迫在所有基础上同时进行游戏。关键点是只需要找到任何一个基础的分解即可。这也自动将多样性注入到所进行的游戏中。
3.蒙特卡洛树搜索(MCTS)步骤序列与强化学习相结合,以决定下一步行动,直到该轮结束。MCTS通过策略函数和价值函数来引导操作。策略函数用于决定向下遍历树时要采取哪些步骤。价值函数用于估计所选择路径的奖励。
4.输出是一场已玩过的游戏,相当于对T的分解,并将其添加到已玩游戏的列表中。
5.深度强化学习开始:从已玩游戏的列表或准备好的合成数据列表中随机选择一个状态,并将其馈送给一个神经网络,该网络经过训练以学习和更新MCTS中使用的策略和价值函数。
6.模型使用新的策略和价值函数进行更新。新的迭代可以开始。
结果
AlphaTensor得出的新的矩阵乘法算法,对依赖矩阵乘法的计算过程都能起到显著的加速作用(较常用算法提速10%~20%)。千万别小看这点性能提升,即使是1%,可能某个工程问题就因此解决了。
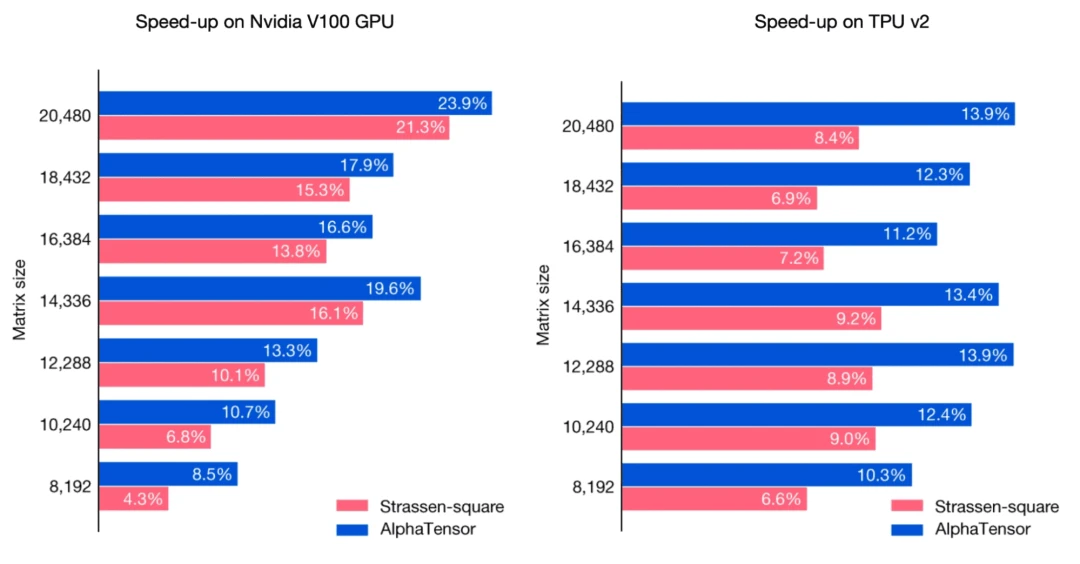
AlphaTensor发现的算法适用于GPU和TPU的算法的加速比(%),提取自DeepMind的论文。加速比是相对于相同硬件上的标准矩阵乘法(例如GPU的cuBLAS)进行测量,并与斯特拉森平方算法进行比较。来源:DeepMind。
AlphaTensor的潜在应用不一定局限于矩阵乘法的具体问题,而在于它引入的新颖思想以及进一步拓展的潜力。
参考文献
[1] DeepMind. Discovering novel algorithms with AlphaTensor. 2023. https://deepmind.google/discover/blog/discovering-novel-algorithms-with-alphatensor/
[2] AssemblyAI. DeepMind's AlphaTensor, Explained. 2023. https://www.assemblyai.com/blog/deepminds-alphatensor-explained/
[3] KDnuggets. First Open Source Implementation of DeepMind AlphaTensor. 2023. https://www.kdnuggets.com/2023/03/first-open-source-implementation-deepmind-alphatensor.html
[4] Towards Data Science. A I Mathematician: A Simplified Look at DeepMind's AlphaTensor. 2023. https://towardsdatascience.com/a-i-mathematician-a-simplified-look-at-deepminds-alphatensor-feeeac90c9f3
[5] Medium. AlphaTensor: A Short Introduction. 2023. https://medium.com/demistify/alphatensor-a-short-introduction-da2a82f0ba65
[6] YouTube. DeepMind AlphaTensor - Simplified. 2023. https://www.youtube.com/watch?v=fDAPJ7rvcUw
[7]https://www.assemblyai.com/blog/deepminds-alphatensor-explained/
[8]论文分享:Discovering faster matrix multiplication algorithms with reinforcement learning (AlphaTensor) - 知乎 (zhihu.com)
https://zhuanlan.zhihu.com/p/572729936
