目录
谷歌Gemini尝鲜实测体验,有点逆天

12月13号,谷歌发布了Gemini大模型,并做了视频展示。
今天,12月15日,尝试登录一下谷歌官网,看到Gemini Ai Studio开放了,立刻体验了一把。
先上,简直逆天
想体验的朋友,赶紧上去体验一把,下面是官网:
https://deepmind.google/technologies/gemini/#build-with-gemini
操作教程
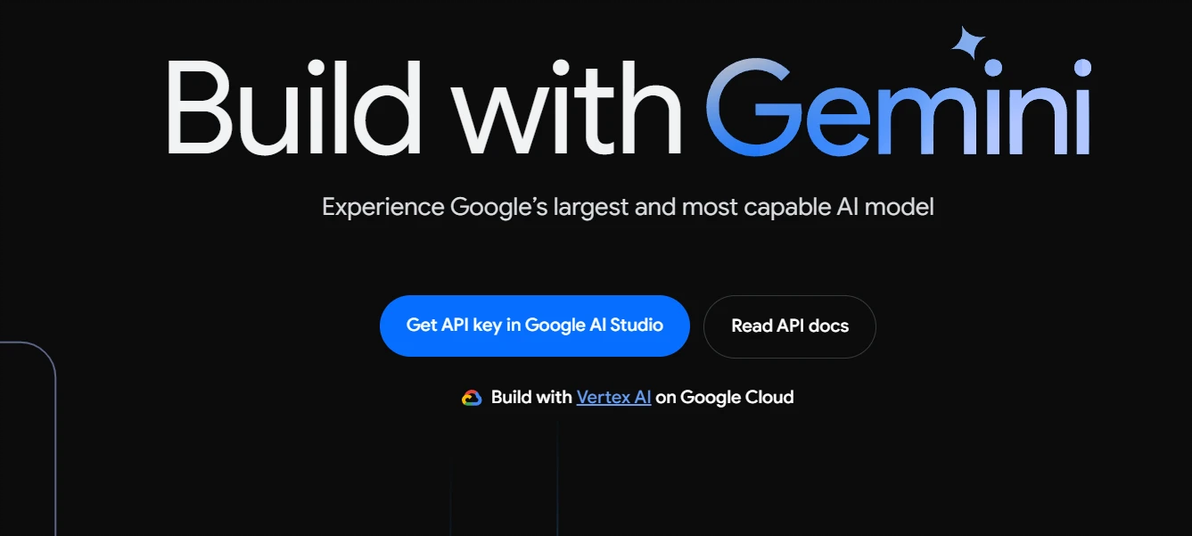
打开后进入:
点击蓝色框,GET API KEY in Google AI Studio
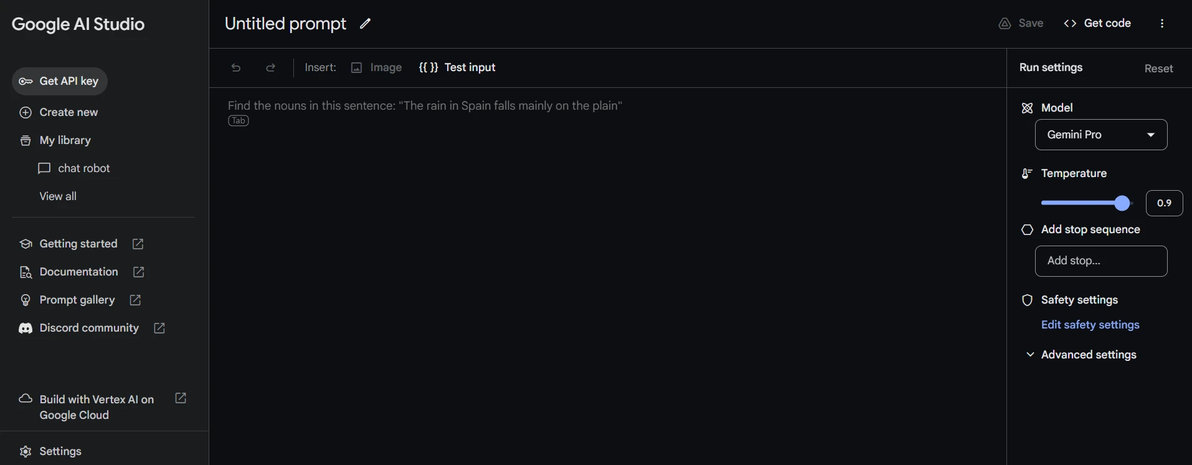
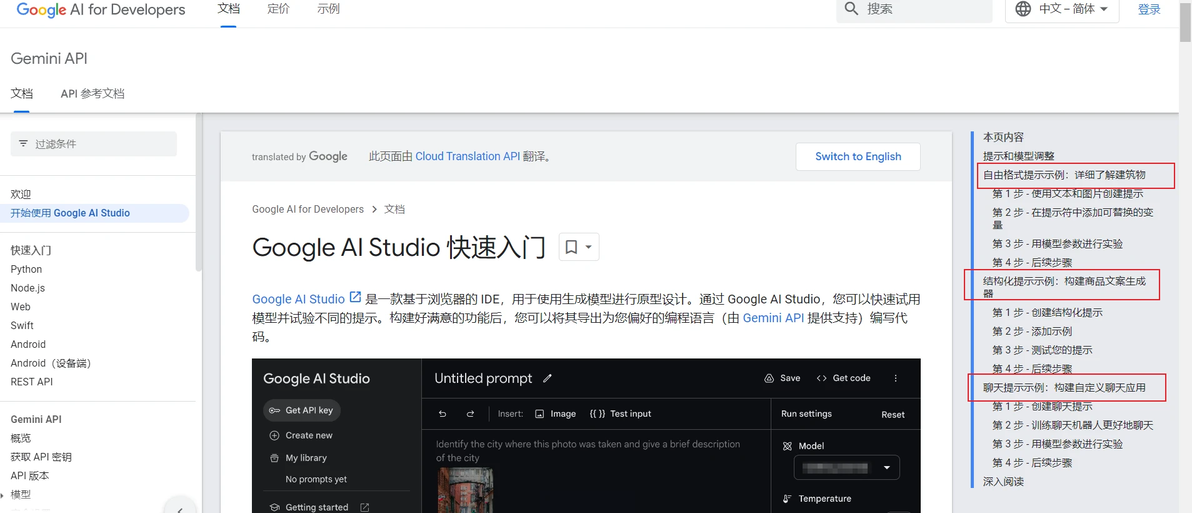
进入后,进入主界面,用户可以点击左边的 Getting started,会有细节教程。
入门官方教程:
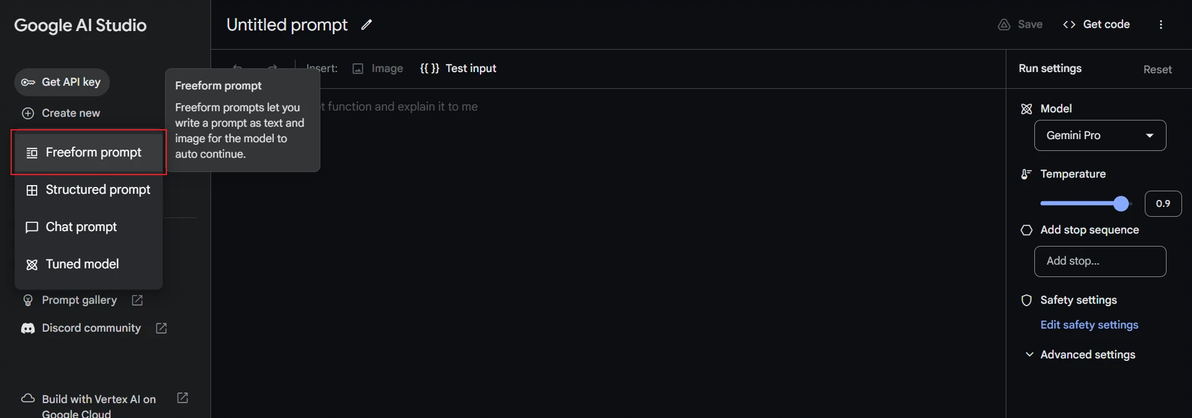
我这里,测试了第一个FREEFORM PROMPT
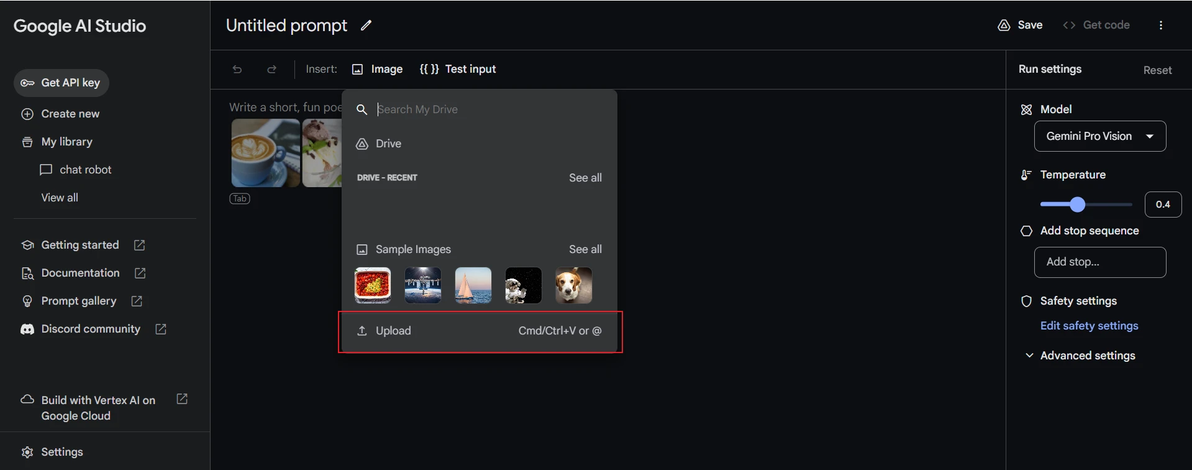
对于内部系统的图片,个人觉得在测试,没有意思,我就网络上先后找了图片扔进去,让他解析:
对于上传可能会有点问题,大家可以用截图 ctrl+v 的方式,将图片传上去体验。
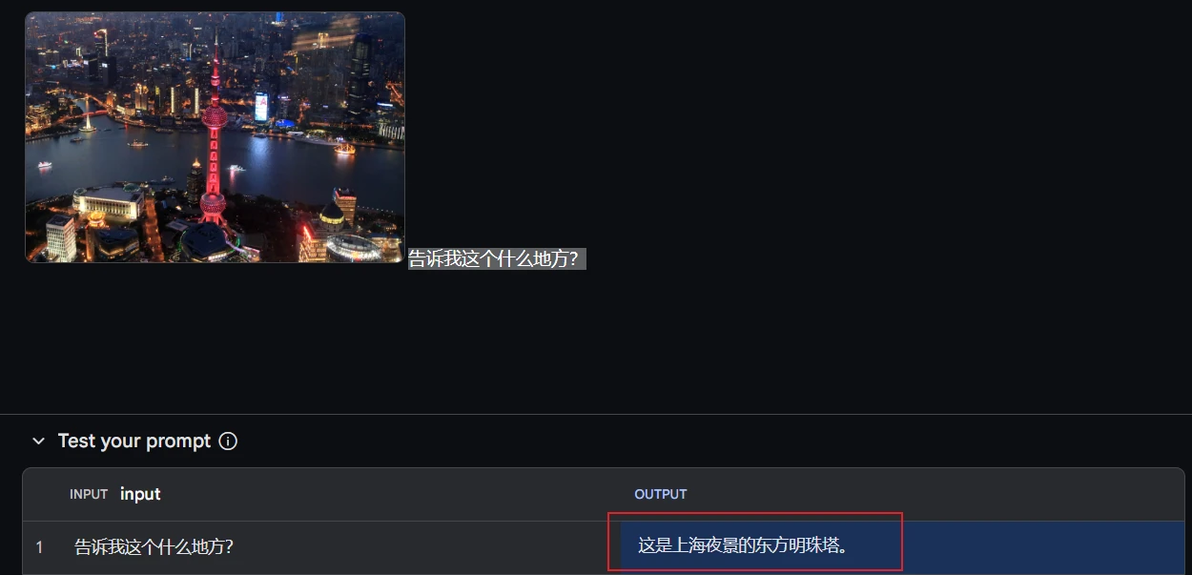
测试一
第一次,采用了上海地标建筑,大模型准确回答,并且可以回复什么场景下的建筑。
测试二
下面我开始想怎么才会有意思一点,网络上找了一张国粹图,并且加大问题难度,问了三个问题:
第一,几个人?
第二,性别是什么?
第三,在干什么?
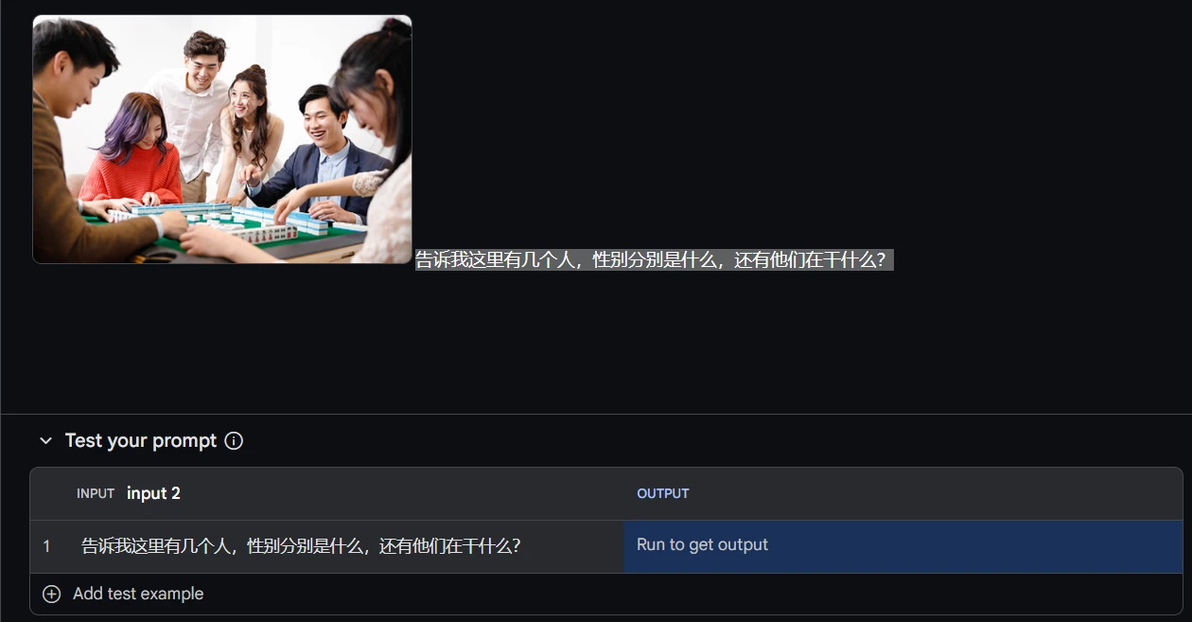
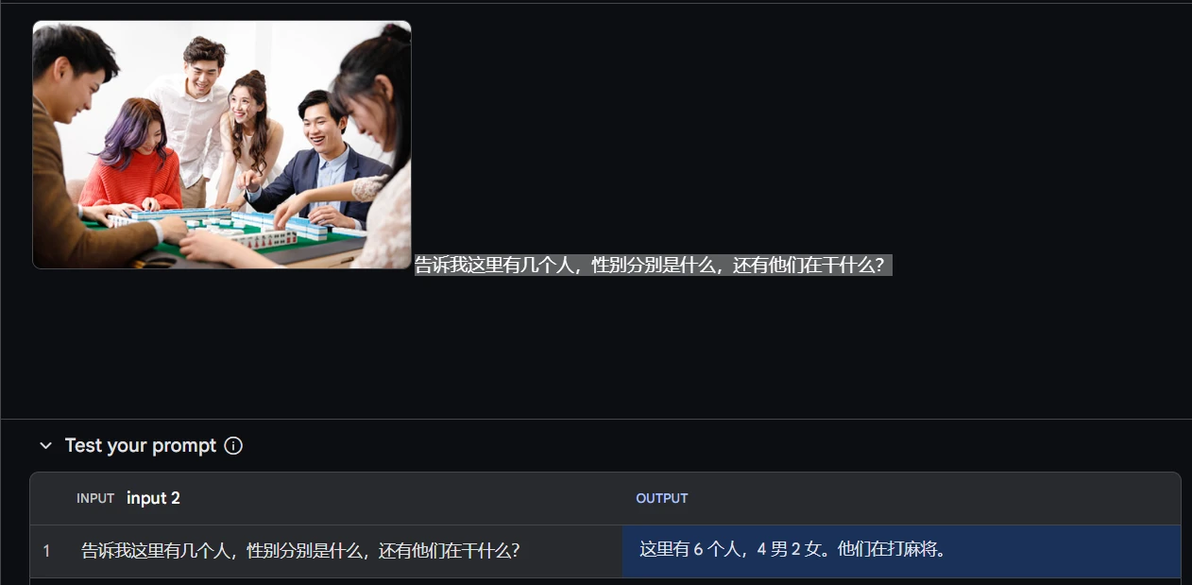
从回答上来看,第一个人数问题准确回答,第二个问题,可能是右边这个女士只有一半身,被识别为男的,第三个也准确回答。
测试三
我再次加大难度,又放了一张图,问:
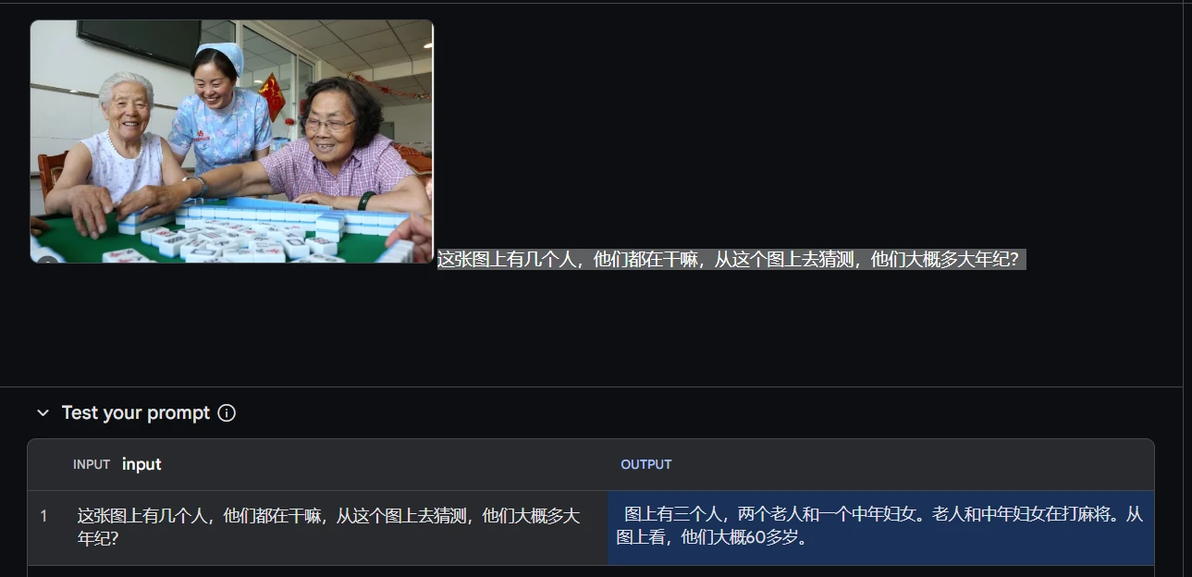
几个人?在干什么?多大年纪?
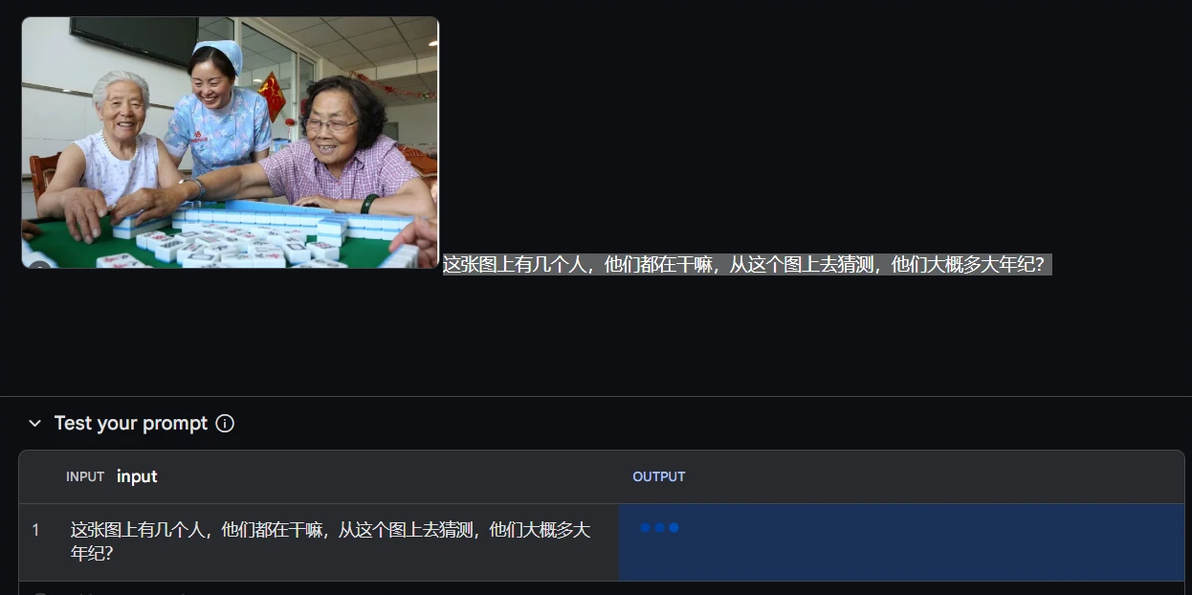
他都可以准确回答。
测试四
可以读取表情,分析人的状态。
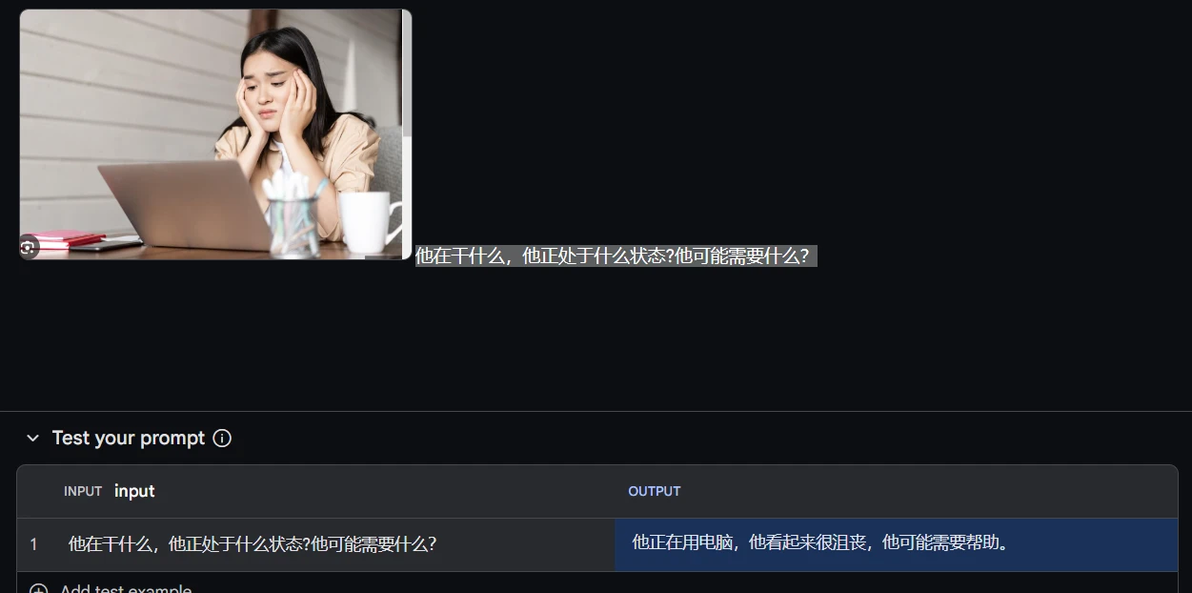
从上面可以看出,基本上的图像识别操作,Gemini都可以完成。最重要的是,可以分析图片,抓取人物情感状态等细微信息。不知道后面还会不会开放更多功能,甚是期待。
本文为我原创,未经授权禁止转载
cv28560034
分享至
投诉或建议
