
一言蔽之:OpenAI 的技术迭代以及消费产品功能全部围绕 AGI 终局来展开。
1 从 Function Call 开始理解
1.1 FunctionCall 思路 OpenAI 在 6 月份的时候发布了 FunctionCall 功能,让 LLM 具备和现实世界交互的方法。炸一听挺神奇的,但它的实现方式可能非常简单粗暴。在 OpenAI 之前 AutoGPT、LangChain 的工作都已经实现了这个功能。其思路是:
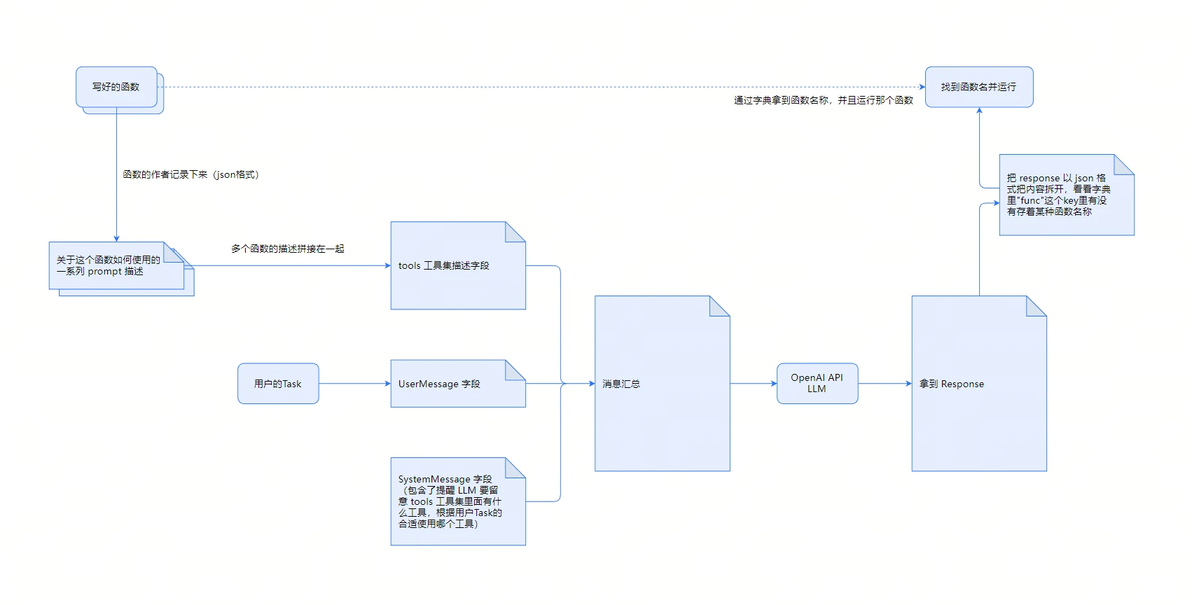
这是 OpenAI 官方的一个函数描述示意:
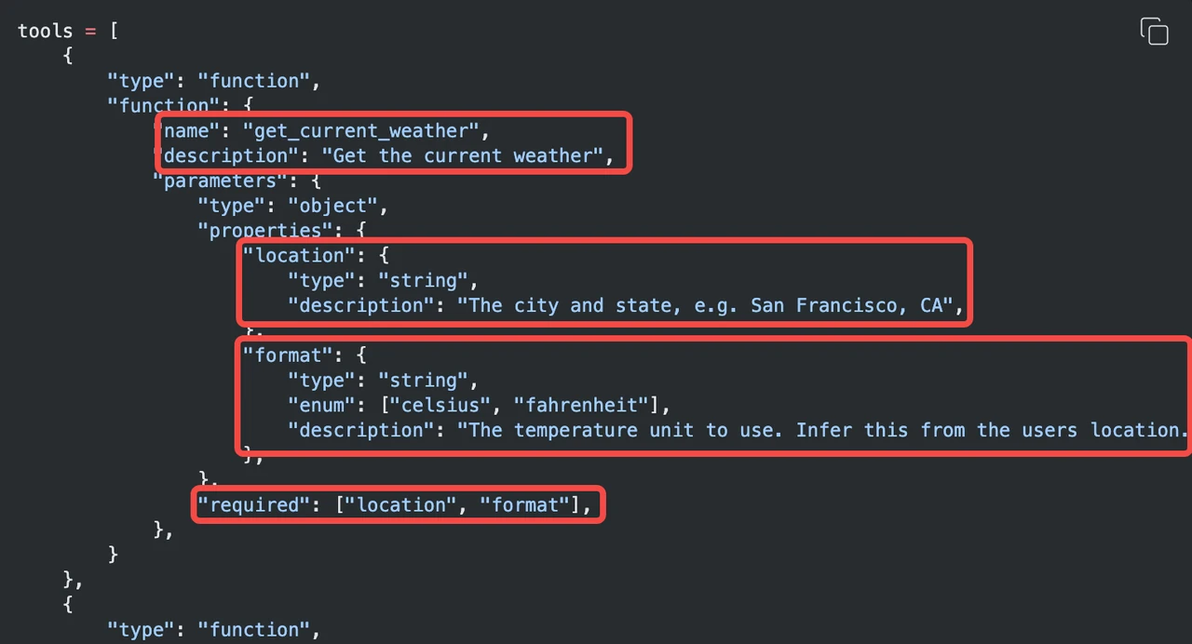
就像一个给 LLM 的使用说明书。函数名称叫 get_current_weather,它的功能描述是「Get the current weather」,它有一些参数包括 Location,以及这些参数的含义都以这种描述方式写在 json 字典里,最终拼接成较长的 prompt 发给 LLM。然后 LLM 就会根据当前对话的情况判断要不要使用函数,以及如何使用函数,这个决策过程和质量是 LLM 的推理水平以及和人类意图对齐的水平决定的。根本就是大力出奇迹。
而函数可以是写在本地的,也可以是 OpenAI 官方写在自己云端的。最近的更新中,ChatGPT 在使用 Bing、Dalle 3 不再需要切换模型,就是这两个被做成 FunctionCall 了。以后所有的服务(service)都可以让 LLM Call,这就是最近更新中 Assistant 的 Action 功能的支撑。
1.2 FunctionCall 和 Reinforcement learning FuncionCall 功能的实现和迭代应该是在强化学习 Reinforcement learning 阶段进行的。目前没有看到官方说明,是我个人的猜测。 首先,用强化学习来做 FunctionCall 实做起来应该比较简单(下面会分析);其次,强化学习阶段是让 GPT 对齐人类意图的重要阶段。而让 LLM 根据人类的需要以及可用的工具集来决定要 Call 哪些工具,这件事情听起来就像是在做「对齐人类意图」。
为什么用强化学习做 FunctionCall 会简单 在 OpenAI 发布 FunctionCall 之前,AutoGPT 和 LangChain 等工作已经粗暴的实现过一遍。但是当时的 Call 的准确率并不高,特别是当提供的工具集多了之后(大概超过 20 个)GPT 就开始乱 Call。而在 6 月官方推出 GPT 迭代版本来支持 FunctionCall 之后,Call 的准确率有了大幅的提升,11月还有进一步提升。 FunctionCall 要求 GPT 按照特定的 json 格式输出它的文本,但是这种函数输入和输出如何匹配的上下文在人类的语料库里可能很少见,单纯靠「成语接龙」也就只能做到 AutoGPT 当时的水平了。必须要有一种自动生成这种格式语料的机制才能 Train 得好 FunctionCall。 正好,FunctionCall 本质上是要去执行一个函数。那么可以生成很多函数让 GPT 试着去 Call 它们,函数的返回值如果是正确的,那么就算「赢」了一次,返回值是错误的就算「输」了一次。这实质上就是一个 Reward 奖惩机制,就是在做 Reinforcement learning。
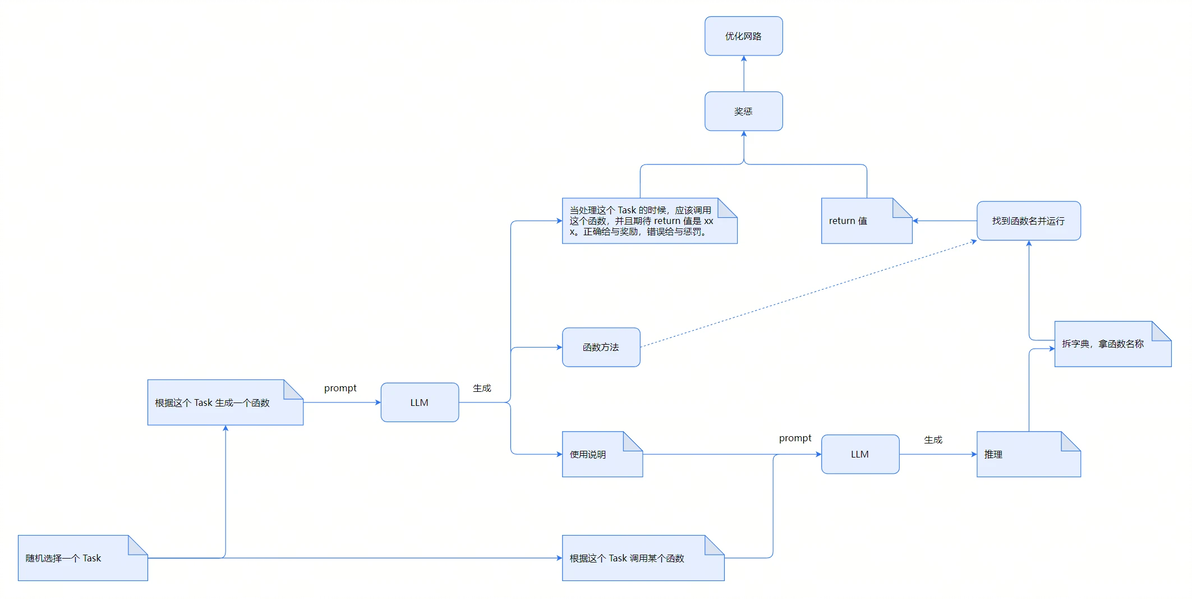
通过这个流程就可以让强化学习转起来。LLM 左脚踩右脚原地起飞。
其中用 LLM 生成函数的准确率很重要,但是复杂度不重要。可以就让它生成一些比较简单的函数,而 GPT 只需要学会「对于不同的 Task 应该如何正确的使用工具」这一件事而已,理论上学会使用工具是比学会制造工具要简单得多的。
2 对齐人类意图意味着什么 OpenAI 把训练 GPT 分两个阶段,「成语接龙」阶段和强化学习阶段。「成语接龙」阶段训练出来的 GPT 只能顺着句子往下填字,它是具备知识和预测能力的,但是这样没办法按照人的需求做 Task。例如问它「世界上最高的山叫什么?」它可能会说「世界上最深的海叫什么?」做排比句去了。而强化学习阶段就是要让 GPT 对齐人类意图。试想,对齐人类意图这件事情对智能体来讲到底意味着什么?和什么能力有关?
2.1 和什么能力有关?
可能的能力:
理解能力:解析用户的命令和问题的真正意图。注意力机制训练出来的对 UserMessage 的关注可能就是在寻找用户意图。
决策能力:在多种可能的行动方案中做出最符合用户意图的选择。调整下一个预测的概率分布就是在做决策。根据注意力的信号来决策让什么东西出现的概率变高,而其他出现的概率变低。
规划能力:决策能力和规划能力密切相关。只有更好的决策能力才能支撑更好的规划能力。
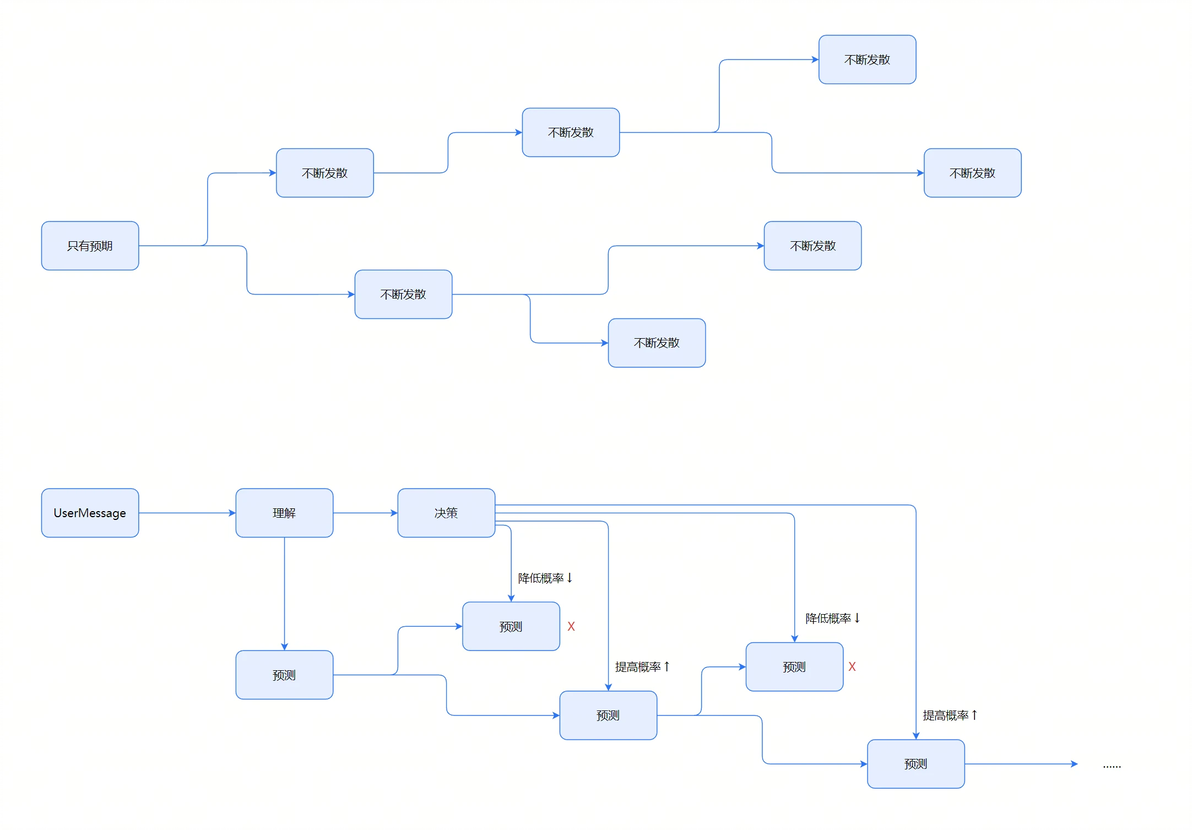
这样看,对齐人类意图是让 LLM 向着有更优秀的理解、决策、规划能力演进的,而且主要是在强化学习阶段来提升这些能力。
2.2 强化学习的优势 上一次强化学习的大新闻是 AlphaZero 。AlphaZero 在围棋上已经全世界无人能敌,而人类尝试学习和理解 AlphaZero 在围棋上的智慧。由于围棋的比赛规则和胜负的存在,有条件做一个虚拟环境让 AI 进行自我对局,而不依赖人类的历史棋谱就能超越人类,这是被实证的。 如果文字也能发明出一种对局条件并做成虚拟环境,AI 就可以用强化学习在里面原地飞升了,FunctionCall 可能就是这么做的。近期的关于 OpenAI Q* 的新闻和猜想应该都看到一些,一些大佬之前对于强化学习的发言也被挖出来,这里就不赘述。 只说一个观察:OpenAI 看起来对自己的模型迭代充满信心,至少员工们看起来对 GPT 的成长空间以及对奥特曼的领导方针全都充满信心。可能他们内部已经发现了什么,并且正在酝酿着。我个人认为很可能和强化学习的突破有关。这个想法和 Q* 新闻没有关系,而是在分析「对齐人类意图」和什么能力有关看到的——强化学习阶段的进步和诸多 GPT-4 亟待改善的能力有关。
3 起手就做对话式生成 Agent
3.1 为什么这么做产品 OpenAI 第一次做 GPTs 平台起手就做对话式生成 Assistants。这个产品策略是怎么诞生的。 类 GPTs 平台有很多做法,一些创业项目也已经跑在前面,例如 FlowGPT,甚至商业策略都有了。甚至国内的文心一言平台都比 OpenAI 发布 GPTs 要早。但是这些平台全都没有做对话式 Build Agent。
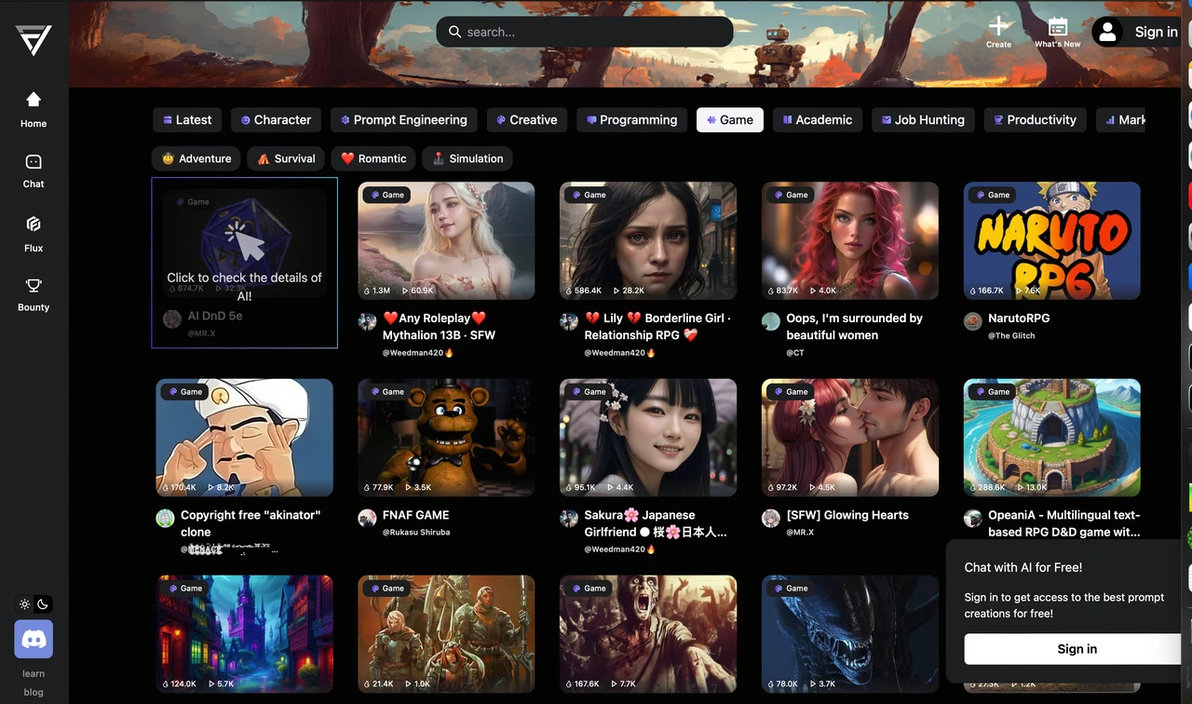
甚至有一些 APAAS 平台把 MultiAgent 都做了也没有做对话式生成的。例如 n8n 已经可以无代码搭建多智能体项目了,但是仍然不支持对话式生成 Workflow。

对于 OpenAI 来讲,产品功能发布节奏大体是这样的:
GPT > FunctionCall > 多模态vision
> 128k > Assistants > 对话式Build Assistants
> Agent探索社区(未发布) > MuiltiAgent(未发布)> WorkFlow(未发布)
OpenAI 对自己的定位是非常清晰的。
自己是一家 AI 科技公司,是要引领 LLM 的进步的,目标是实现 AGI 。最关键的是提升 LLM 的基础能力,并保持领先。
发布消费产品的核心目的是让 LLM 能逐步的接触现实,得到现实的反馈之后进一步提升模型能力,以达到 AGI 的目的。而不是为了赚钱。
而其他的诸如 FlowGPT 这类重运营的工作不是 OpenAI 优先投入的领域,和 AGI 无关的工作都应该被延后。 调工具的能力、多模态能力、token窗口大小等等都是围绕 AGI 必然要建设的,而 Agent 探索社区和 Workflow 就相对边缘了,可以做也可以不做,别人做了也不可惜。
那么对话式 Build Assistants 为什么对于 AGI 是重要的。我理解这个问题有两个层面: 第一个方面:让一个 Agent 通过理解用户意图去规划出另外一些 Agent 。这个点关乎于「理解用户意图」,关乎于「提升 LLM 的理解、决策、规划能力」,是强化学习的重要改进地方。这个在上一节已经铺垫了。 OpenAI 通过这个产品功能,让用户在把玩对话式 Build Assistant 的过程中,就能收集到海量的关于「一个 Agent 如何理解用户意图进而规划出另外一些 Agent 行为」的语料,可以用于后续改善强化学习阶段的训练。类似于上文提到用强化学习做 FunctionCall 的框架里由一个 LLM 去生成函数的步骤。 这个思路是只有真正在做大模型的厂商才会有的思路。它不是因为对话式生成 Agent 对用户体验友好,门槛足够低才有这样的产品策略的。而是 OpenAI 密谋着提升强化学习阶段,提升 LLM 模型本身,收集语料的巧思。而只做社区,只做 Workflow 的厂商是不会报以这种思路工作的。
第二个方面:为 AGI 终局做准备,也是为下一代 AIOS 做积累和铺垫。让一个 UserProxyAgent 直接和用户交互,而它可能在后台规划出一些 AppAgent 来处理用户的 Task。这在之前的文章铺垫了。关于 LLM 的畅想 (在内核架构和线程安全那个部分)
下一代的 App ,可能是 OS 构建出来的 Agent。而真正的第三方 App 服务可能会退化到 service 级别,对应的就是现在 Assistant 的 Action 级别。在 HCI 方面,第三方开发者已经没有必要维护一个典型意义上的前端 UI 界面,都可以是 OS 构建出来的 AppAgent 的交互,而自己提供的真正有价值的服务是 Action,如何让 OS 更有可能调用到自己的 Action 是下一个时代的 SEO 和黑客增长。这里说的是服务,而不是内容。是类似于打车、订餐这样的服务,而不是类似于游戏,短视频这样的内容。
3.2 套壳 OpenAI 注定消亡 —— 尤其别花太多精力在 UI 上 这是奥特曼作为 OpenAI CEO 在了解一些内部消息的情况下说过的话。在调用 API 接口之上构建的应用产品,大部分最终都会被 OpenAI 的迭代覆盖掉。特别是那些在短期内提升一点 GPT 能力的应用,以及制作了更好用的用户交互界面来使用 GPT 的应用,都会被 GPT 自身的迭代覆盖掉,如多模态能力的迭代。
3.3 LLM 产业链可能局面
这篇文章的铺垫都是为了回答好这个问题:
对于 OpenAI 来讲:
LLM 技术是核心中的核心,是改变世界格局的东西。而越往外围越脱离 OpenAI 的视野。而其他 LLM 厂商和 OpenAI 是直接竞争关系,OpenAI 能让你死就尽可能让你死。
和 LLM 安全有关的问题决定了用户会不会继续使用 LLM ,也是 OpenAI 核心要解决的。Assistant API 的内核态的架构表示 OpenAI 在认真的一点一点解决安全问题。而其他厂商即使做了,也会被 OpenAI 覆盖掉,一不小心让你死。
关于自动化流程 APAAS 。OpenAI 的目标是 AGI,并且在用强化学习不断的让 LLM 对齐人类意图。APAAS 自动化流程就是一个试图让机器尽可能按照人的意图自动运作的工具集,这和 OpenAI 的目标是重合的,做着做着你就死了。
Action 服务提供商,第三方做,多多益善,分钱好说。
传统第三方 App ,都来做 Action 供应商吧。
传统内容平台,也来做 Action 供应商吧。
传统社交平台,也来做 Action 供应商。
内容生产者,来做 GPTs 吧,给你分发。
传统 OS 厂商,可以合作,只要他们不自研 LLM 就行。
硬件芯片,大力合作。 结语:可以看到,产业链里大部分开发者其实并不直接使用 OpenAI API 来建一个直接面向用户的 App ,而更多是在自己的服务器上架设好 Action 的后端服务,等着 OpenAI 调它。而更多的内容生产者也不使用 API,而是使用自然交互(不局限在文字,未来有多模态)。神奇~
补充两个点。
OpenAI 承诺对于 API 调用所产生的数据,他们不会收集拿去做训练。可能对于 OpenAI 来说,调 API 的人在干嘛真的对自己不是很重要。OpenAI 只需要有用户就行,而用户的价值不是财务回报上的价值,而是能帮助他们迭代 LLM 的价值,他们的产品策略也围绕这个来设计。
OpenAI 可能从来不在乎是否盈利,他们只在乎是否能实现 AGI。如果为了实现 AGI 必须要盈利,那就盈利,如果实现 AGI 必须要有商业模式,那就有商业模式,如果实现 AGI 必须要安全,那就做安全。这个可能是奥特曼的理念,也可能是奥特曼能吸引 OpenAI 其他科学家员工的原因。
