VideoCrafter1:生成高质量视频的神器

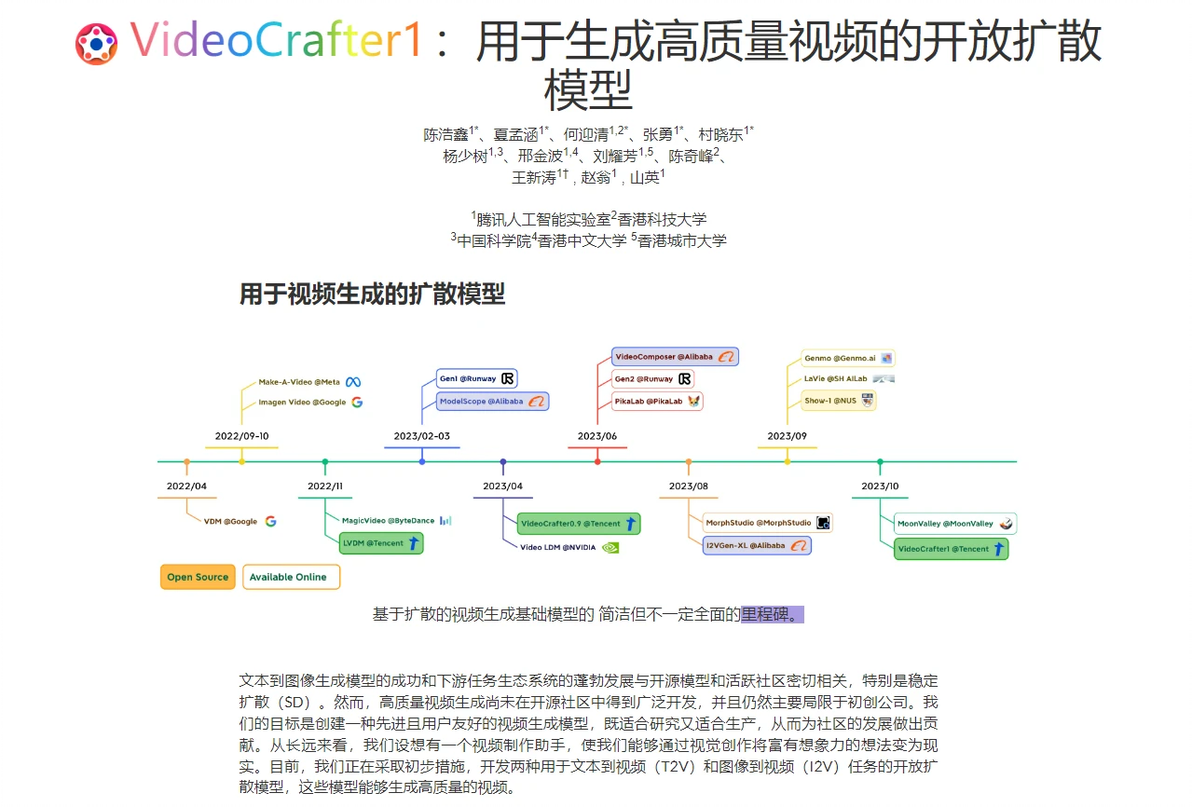
VideoCrafter1是由腾讯AI实验室打造的视频生成模型,包括文本到视频(T2V)和图像到视频(I2V)两个模型。
文本到视频(T2V):能生成1024×576分辨率、电影级别的视频;
图像到视频(I2V):能生成参考图像内容、结构和风格高度一致的视频。
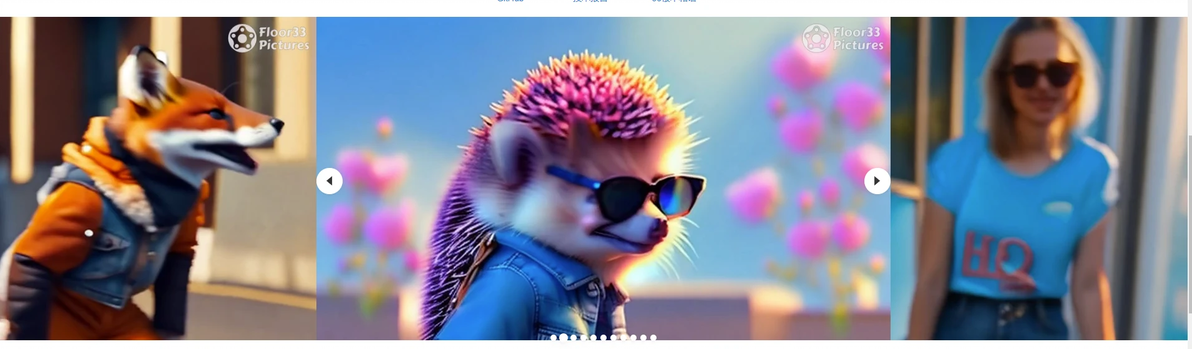
文本到视频(T2V)模型原理:
1、基于SD 2.1架构:这是一个先进的视频生成网络;
2、时间注意力层:确保视频在时间上连贯;
3、生成高质量视频:分辨率为1024×576,时长2秒。
特点和优势:
1、高分辨率:输出的视频画质非常高;
2、时间连贯性:避免任何不自然的跳跃或卡顿。
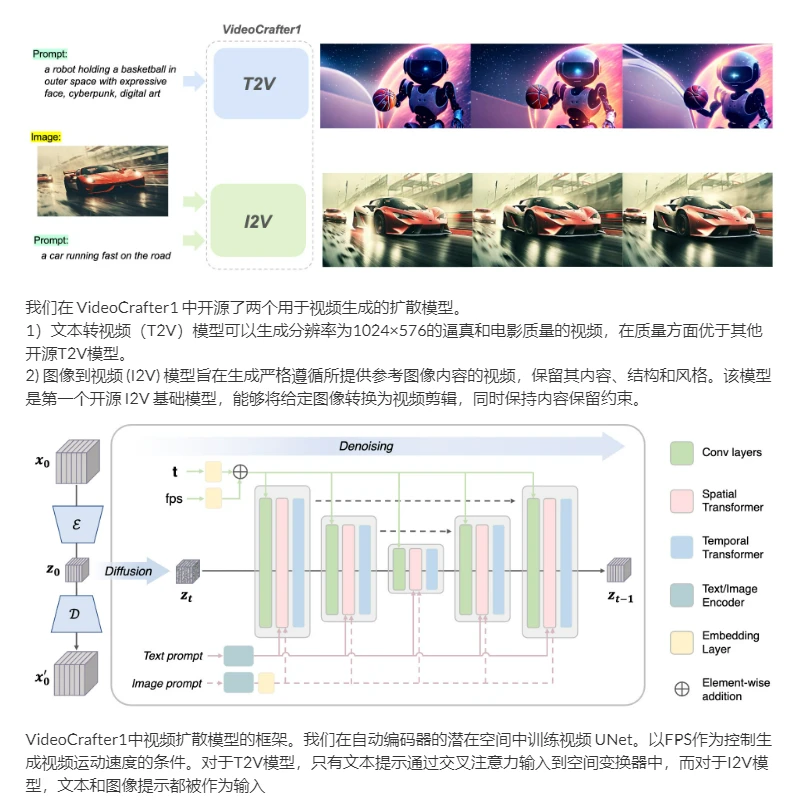
图像到视频(I2V)模型原理:
该模型可以接收图像、文本或两者组合作为输入,生成高度一致的视频。
1、图像嵌入:从给定的图像中提取特征;
2、交叉注意力机制:将图像嵌入注入到SD UNet网络中,考虑图像内容和结构;
3、生成严格一致的视频:严格保留给定图像的各个方面。
特点和优势:
1、内容保留:生成的视频能严格保留给定图像的内容;
2、多输入支持:接受图像、文本或两者组合作为输入,灵活性更高;
3、高质量输出:经过大量数据集训练,生成的视频质量非常高。
项目地址:https://ailab-cvc.github.io/videocrafter/
论文:https://arxiv.org/abs/2310.19512
GitHub:https://github.com/AILab-CVC/VideoCrafter
cv27439412
分享至
投诉或建议
