一. 概述
针对基于阿部洋一漫画及插图提取的画风lora进行测试,并简要总结本次尝试的训练方法。
测试包含:
1.画风Lora在不同Checkpoint上的跑图情况;
2.画风Lora与服装Lora并用时的跑图情况 (基于单个Checkpoint);
3.画风Lora与人物Lora并用时的跑图情况 (基于单个Checkpoint);
注: 本文撰写结构及参数总体参考
“【AI绘画】SD米山舞画风lora 分享,测试与实战”
作者:Chuck_2023
网页链接
出处:bilibili
二. 测试部分
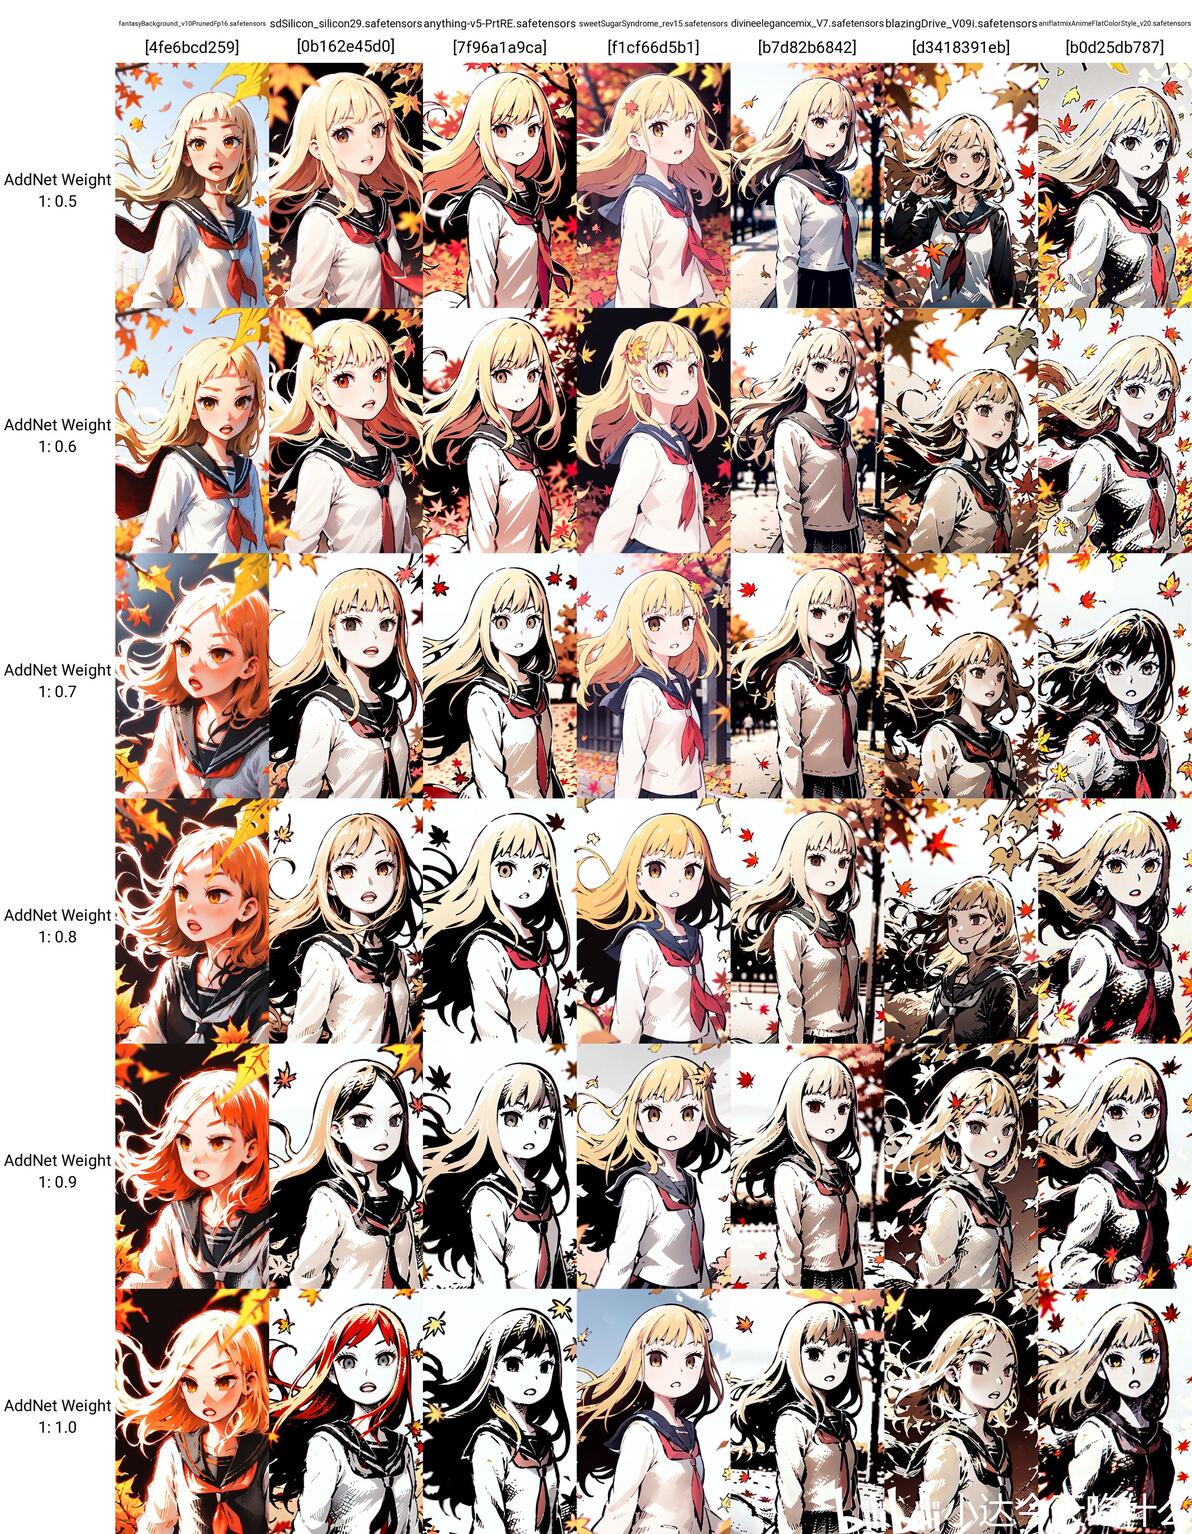
2.1 画风Lora & 不同Checkpoint
本文采用了作者常用的7个大模型 (均可以在C站上找到):
fantasyBackground_v10PrunedFp16
sdSilicon_silicon29
anything-v5-PrtRE
sweetSugarSyndrome_rev15
divineelegancemix_V7
blazingDrive_V09i
aniflatmixAnimeFlatColorStyle_v20
同时本文在生成图片时对所有Checkpoint均启用了VAE:
anythingKlF8Anime2VaeFtMse840000_klF8Anime2
绘图参数:
Step:25 / CFG Scale:11 / Sampler : DPM++ 2S a Karras / 分辨率:512x823
Seed:1545499136
正:
masterpiece, floating hair,chromatic aberration, blurry, bowdepth of field,monochrome, best quality , 1girl, solo, leaf, school uniform, serafuku, long hair, red neckerchief, blurry, sailor collar, neckerchief, blonde hair, shirt, autumn leaves, parted lips, outdoors, floating hair, long sleeves, white shirt, bangs, upper body, red necktie, open mouth, necktie, teeth, brown eyes, wind, autumn, maple leaf, falling leaves, blurry background, day, ginkgo leaf, depth of field,
负:
EasyNegative,text,username,logo,(low quality, worst quality:1.4), (bad anatomy), (inaccurate limb:1.2), bad composition, inaccurate eyes, extra digit, fewer digits, (extra arms:1.2)
测试逻辑:
横轴为大模型,纵轴为画风Lora权重,从0.5开始到1,以0.1递增。
2.2 画风Lora & 服饰Lora
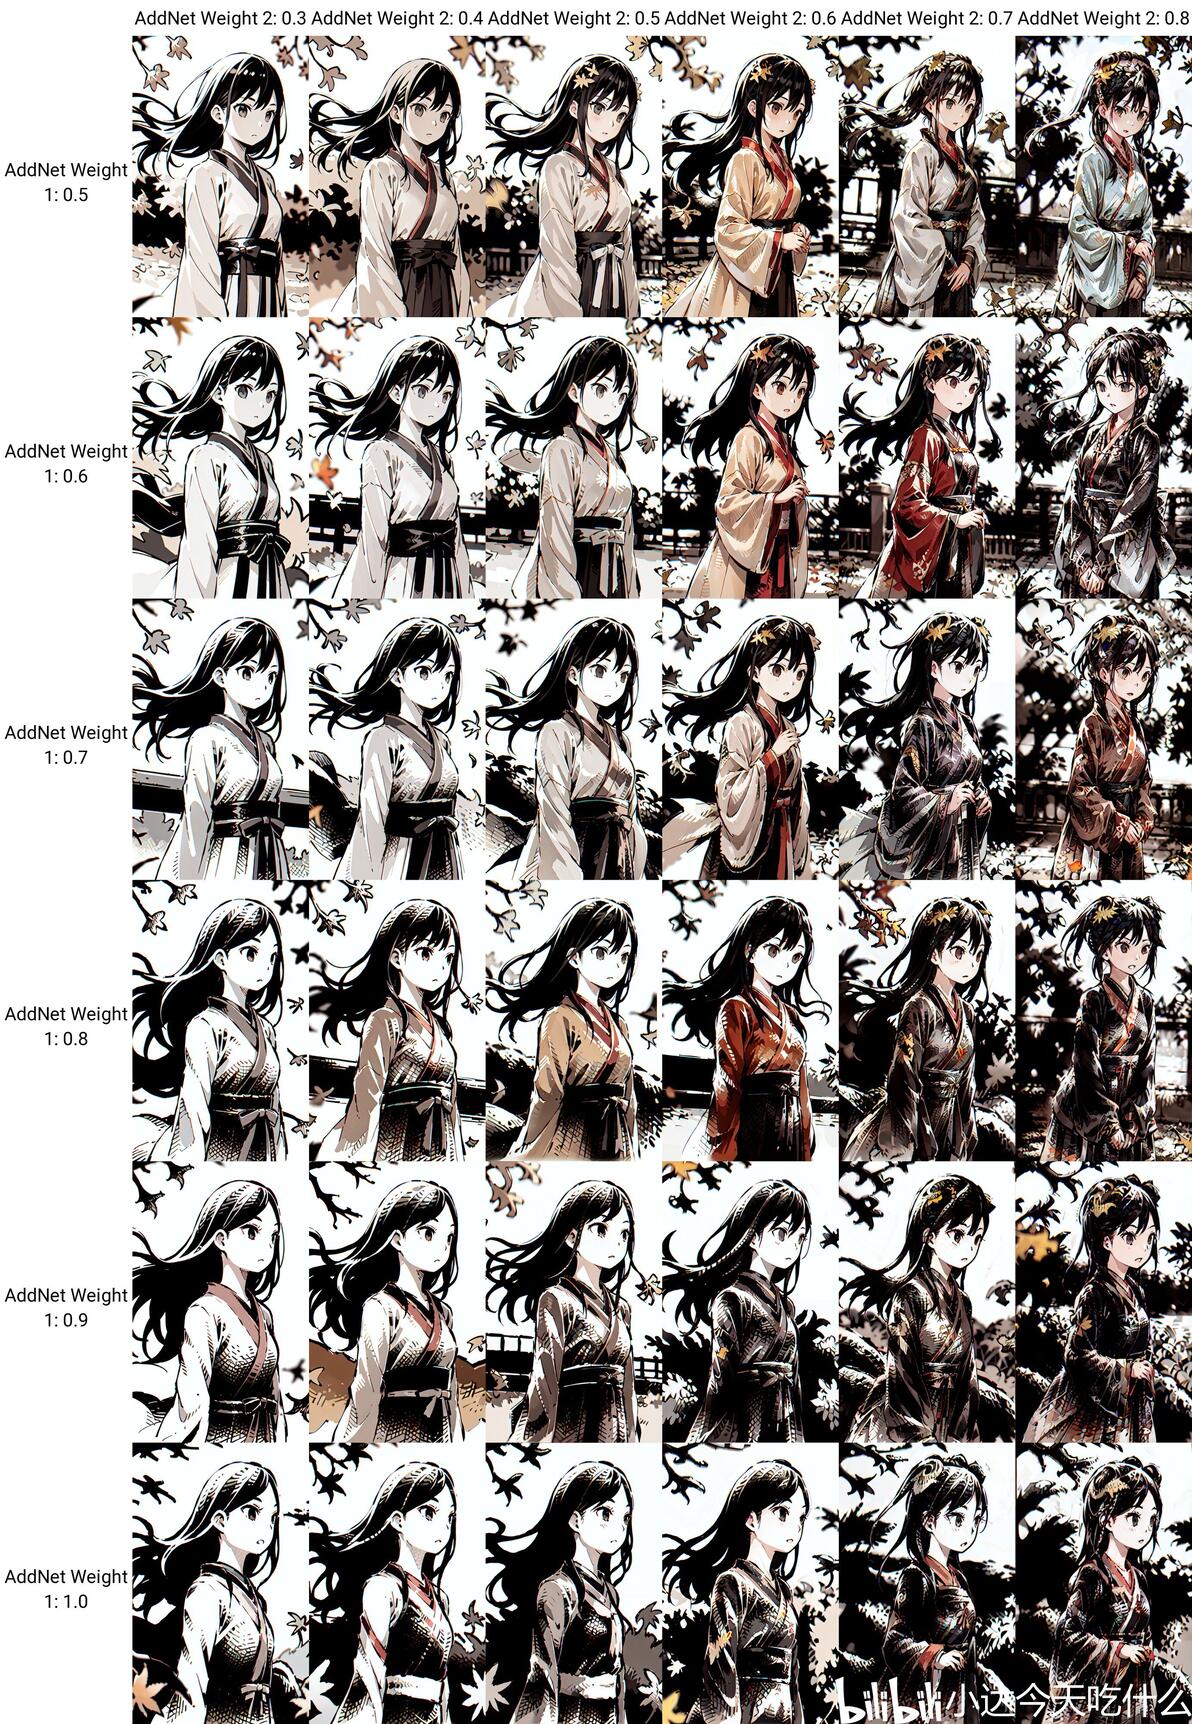
本文采用的服饰Lora:
hanfu_v30
https://civitai.com/models/15365/hanfu
本轮测试使用的Checkpoint:
anything-v5-PrtRE
绘图参数:
Step:25 / CFG Scale:11 / Sampler : DPM++ 2S a Karras / 分辨率:512x823
Seed:1545499136
正:
masterpiece, best quality ,
floating hair,chromatic aberration, bowdepth of field,monochrome,
(1girl, solo),
hanfu,song,
strong rim light,upper body
wind, autumn, maple leaf, falling leaves, blurry background, day, ginkgo leaf, depth of field,
负:
EasyNegative,text,username,logo,(low quality, worst quality:1.4), (bad anatomy), (inaccurate limb:1.2), bad composition, inaccurate eyes, extra digit, fewer digits, (extra arms:1.2)
测试逻辑:
横轴为服装Lora权重,0.3-0.8;纵轴为画风Lora权重,0.5-1。均以0.1递增。
服装Lora在权重0.8以上发生了明显的畸变因此未纳入测试范围。可能需要开启分层控制,需要进一步测试。
2.3 画风Lora & 人物Lora
本文采用的人物Lora:
(1) EreshkigalChameleonAI_v1.0
https://civitai.com/models/15457?modelVersionId=18228
(2) StarRail_Qingque_AP_v1
https://civitai.com/models/73792/qingquehonkai-star-rail
本轮测试使用的Checkpoint:
anything-v5-PrtRE
绘图参数:
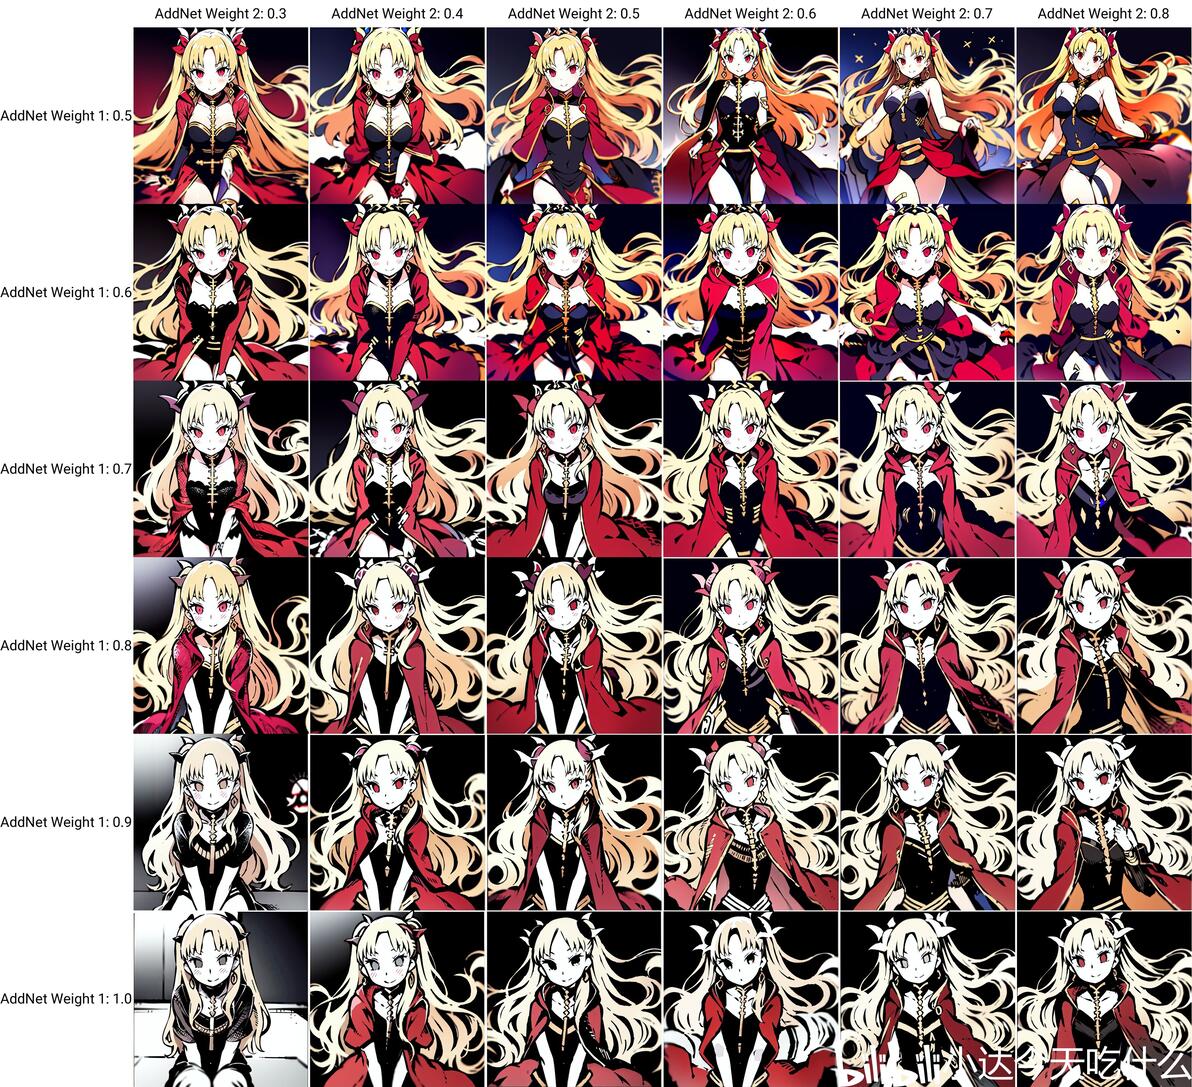
(1)Ereshkigal
Step:25 / CFG Scale:11 / Sampler : DPM++ 2M Karras / 分辨率:768x768
Seed:1674400499
正:
masterpiece, best quality, 1 girl, Ereshkigal, EreshkigalDress,
负:
(worst quality, low quality:1.4), signature, EasyNegative, by bad-artist, bad-artist-anime, bad_prompt_version2
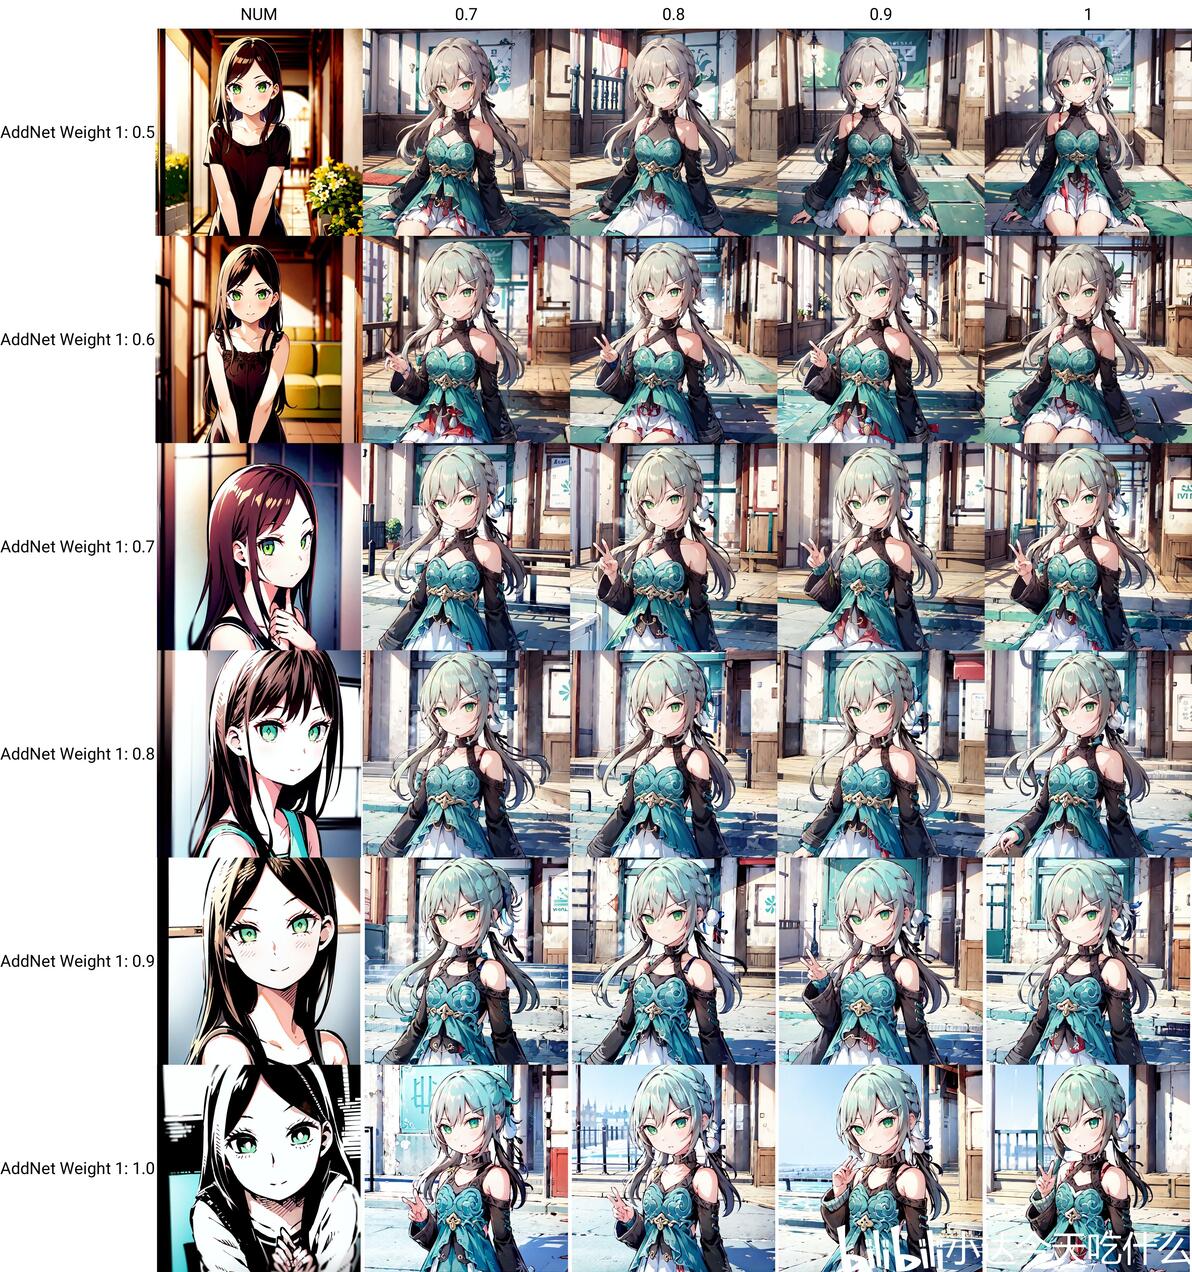
(2) 青雀
Step:25 / CFG Scale:11 / Sampler : DPM++ 2M Karras / 分辨率:768x768
Seed:1674400499
正:
masterpiece, best quality, 1 girl, official, green eyes, <lora:StarRail_Qingque_AP_v1:NUM:1:lbw=MIDD>
负:
(worst quality, low quality:1.4), signature, EasyNegative, by bad-artist, bad-artist-anime, bad_prompt_version2
注:青雀Lora采用分层控制的原因是,该Lora固有的画风十分稳定,画风Lora对画面的整体影响较小。为了能够更明显的体现画风,仅打开了人物Lora的MIDD层数。
测试逻辑:
(1) Ereshkigal
横轴为人物Lora权重,0.3-0.8;纵轴为画风Lora权重,0.5-1。均以0.1递增。
(2) 青雀
横轴为人物Lora权重,0.7-1;纵轴为画风Lora权重,0.5-1。均以0.1递增。
(1) Ereshkigal
(2)青雀
三. 画风提取训练方法小结
3.1 素材准备
本次画风提取,共使用127张不同角色的黑白画面素材。
人物半身约占比70%,人物脸部特写约占比10%,人物全身(站/坐/蹲等)约占比20%。
约10%的素材中包含了消除文字后的空白对话框。但未发现对生成图片有明显影响。
使用576*768图片46%左右。640*640图片48%左右。768*576图片6%左右。
约90%的素材,为使长宽尺寸符合要求,添加了白边或黑边。但未见对生成图片有明显影响。
所有提取后的原图素材均经过SD img2img 重绘放大处理。重绘幅度为0.3。在i2i界面使用controlnet中tile_resample预处理器+SD1.5_tile。并打开SD放大脚本。参数为默认,放大算法为R-ESRGAN 4x+ Anime6B。
放大后将图片从新使用Brime进行缩小到放大前的尺寸。
3.2 打标
采用Data Set Tag Editor中的swinv2-tagger-v2及deepdanbooru。均设置自定义阈值为0.2,并去除重复标签。
对所有图片添加统一触发词标签。
由于参考了B站上大佬们的画风提取视频,了解到画风提取可以尽量保留相关标签,所以未对标签进行进一步处理。
3.3 训练参数
采用NAI-latest (也就是7G版本)作为底模。(之前尝试过anything系列等常见底模选择,但是泛化性明显低于NAI)
repeats定为8。(看大佬们的视频说6~8比较合适。由于原画中其中一位女主角有羊角,担心即便打标较为全面如果repeats较少仍然会保留相关特征,因此选择了8)
分辨率定为576*768。默认开了多分辨率兼容。
Echo设定为10,且每轮保留。(尽管有视频说画风训练基本在3000steps就可以。但是本次画风提取,每一个Echo都在1000steps左右。而跑上述图片的Lora则是在7000steps左右。经过比较之后其效果要明显优于3000步。可能是由于原视频中素材仅有27张,而作者采用了大的多的素材量。因此画风的拟合步数延后了许多。)
U-Net 1e-4 文本编码器 5e-4 (从视频当中看来的,但是很多视频都说参数还是要根据自己的实际情况调整)
cosinewithrestarts 重启次数 1
优化器 AdamW8bit
dim 128
alpha 64
shuffle 打开 keep 第一个关键词(也就是自己设定的触发词)剩下的乱序
noise_offset 0.1
3.4 小结
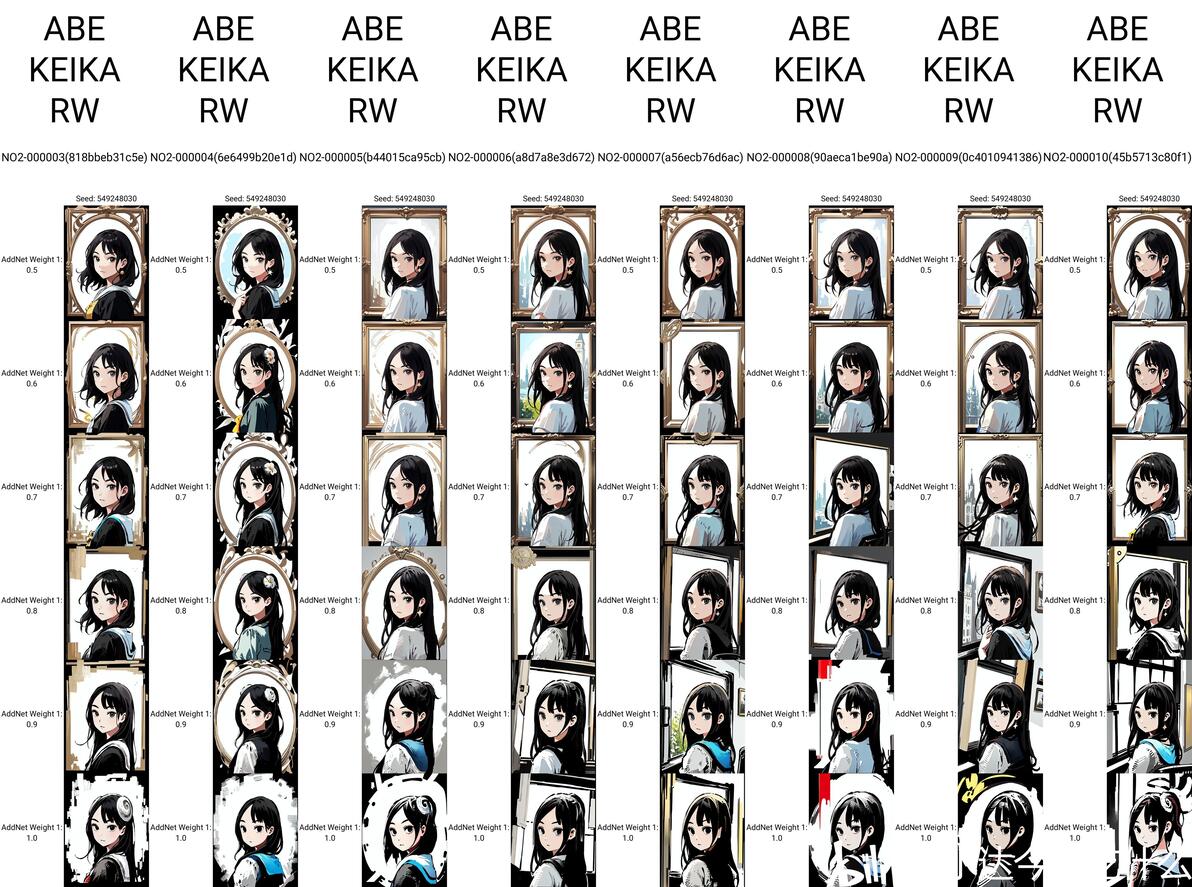
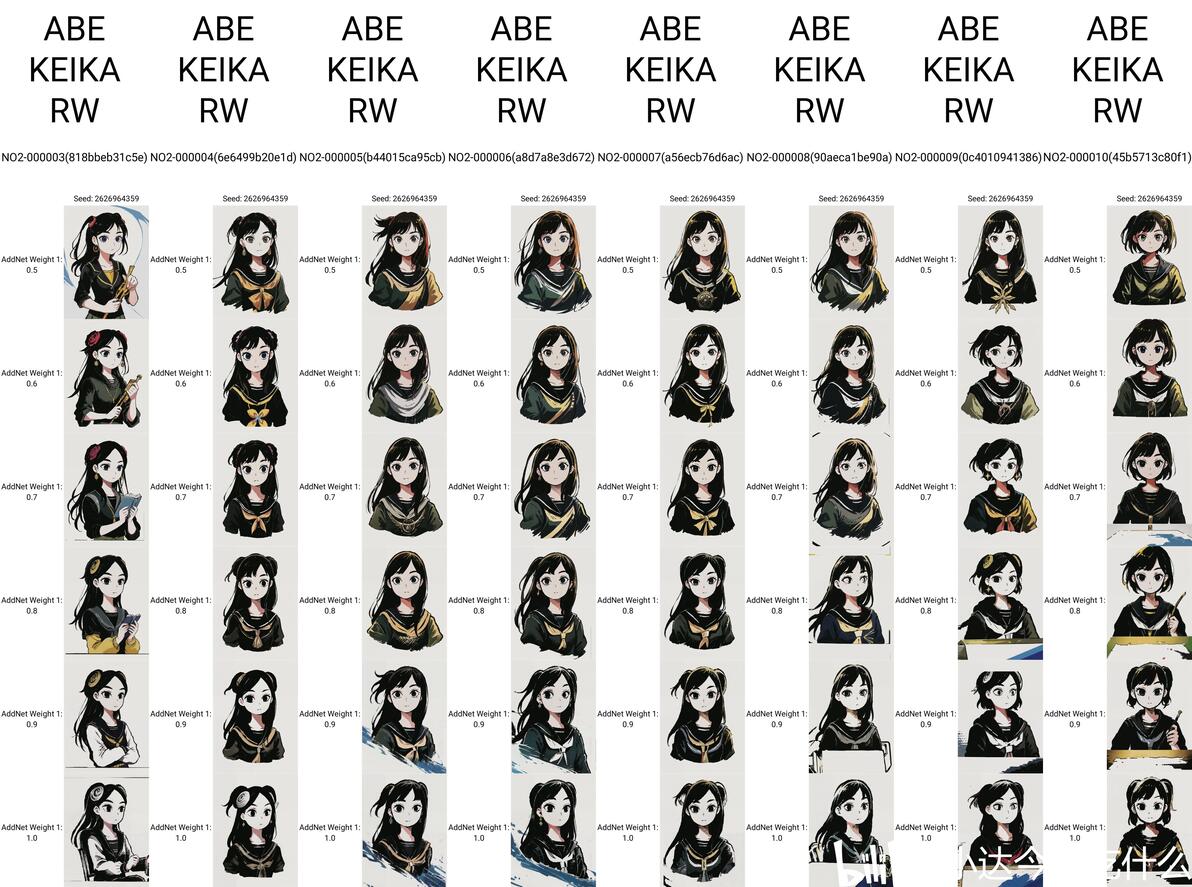
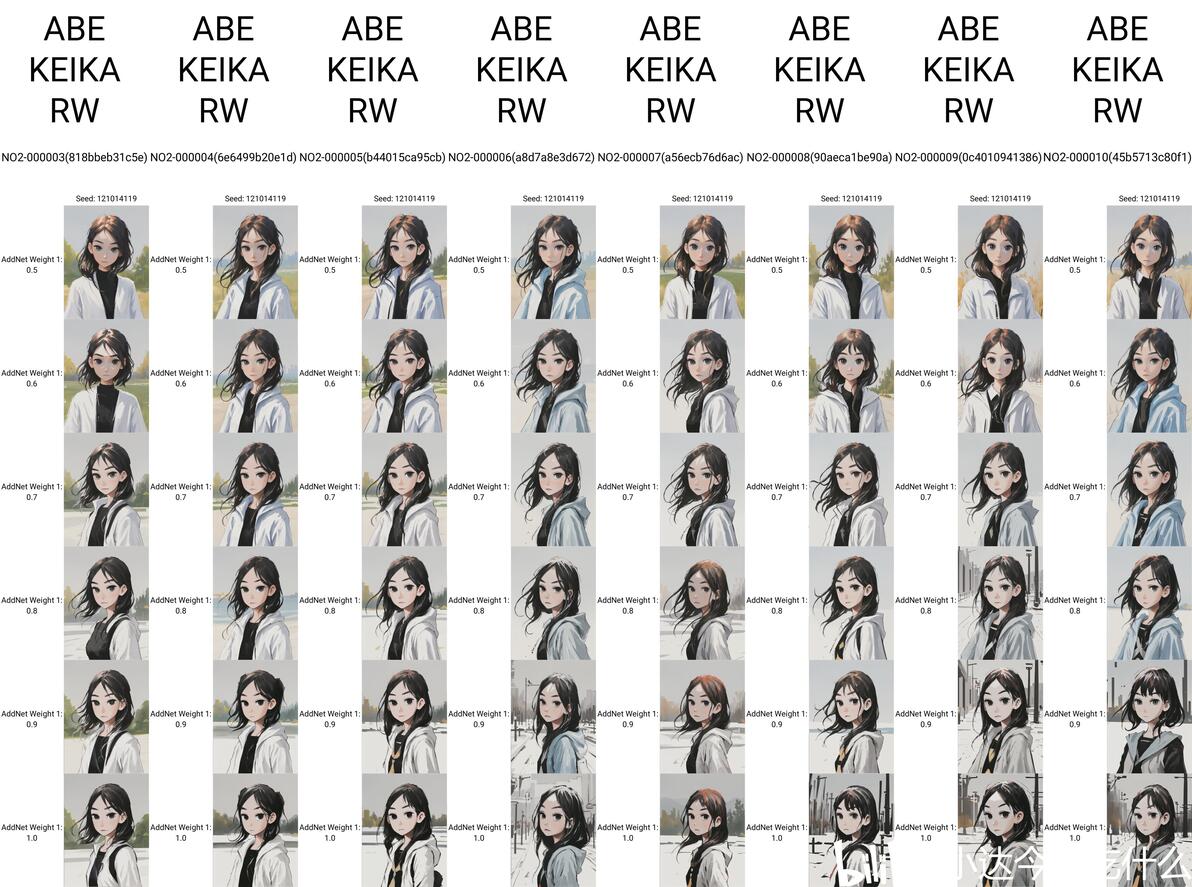
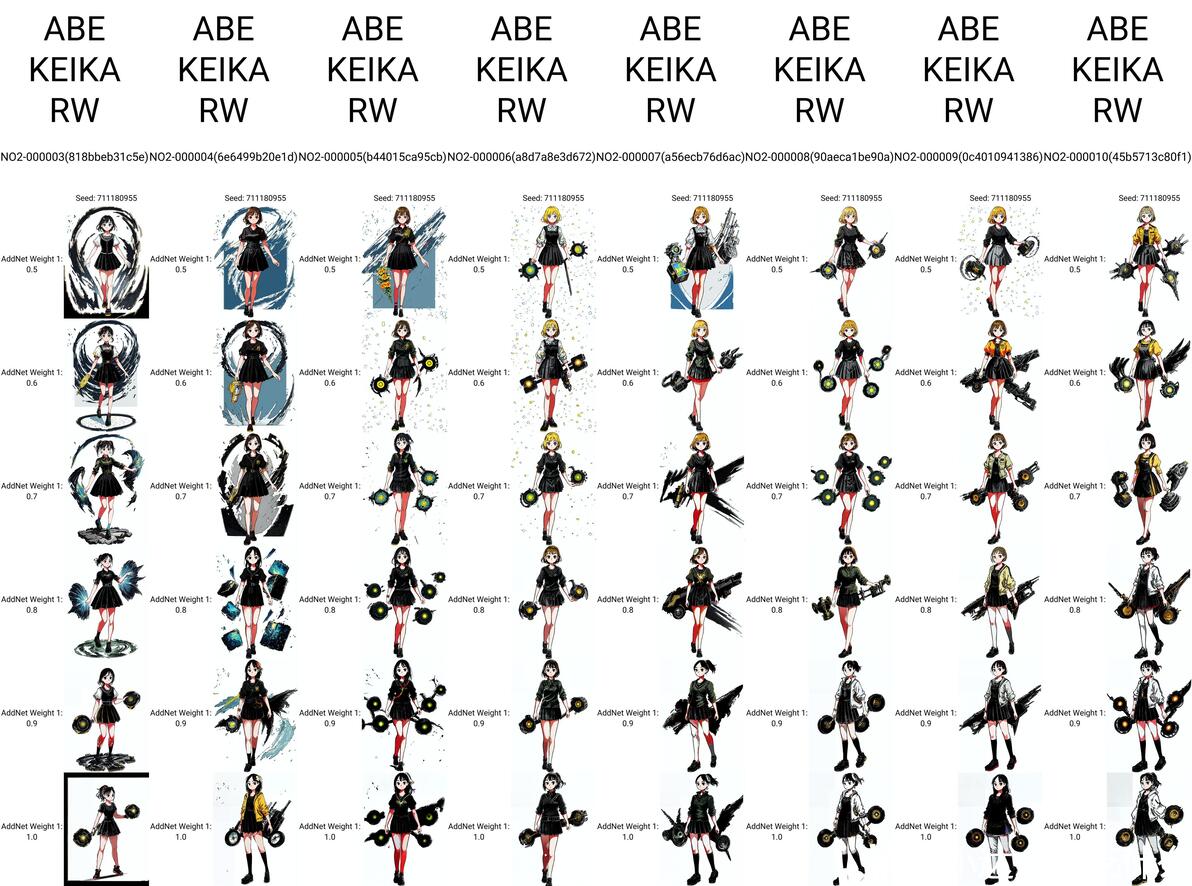
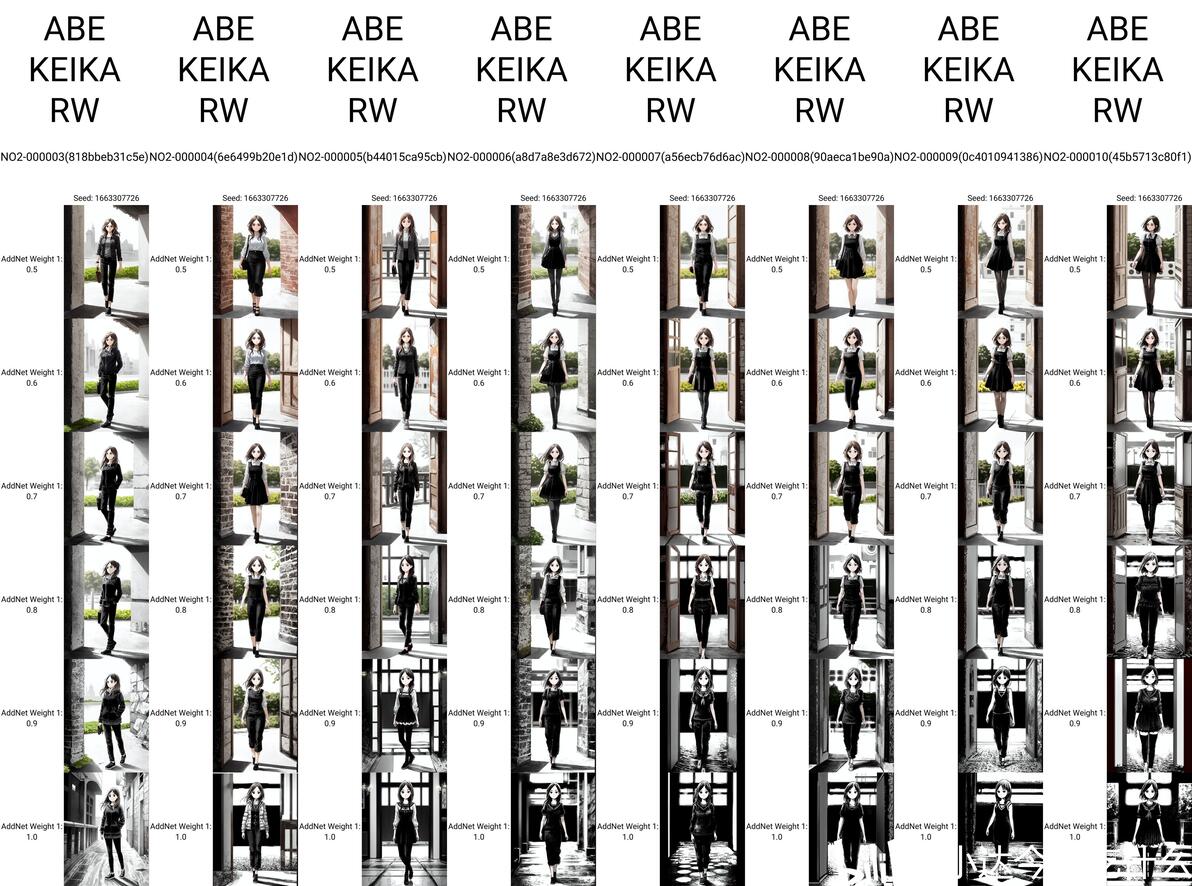
初次尝试画风Lora,其实感觉最难以抉择的部分是在众多的训练结果中找出最优的Lora。作者尝试过将训练出来的一系列Lora放在不同的Checkpoint上跑。许多Lora从总体上来比较都可以算是伯仲之间。
但是受制于二手矿卡的生产力,要对每一个Lora进行全面测试的时间成本实在太高。最后选出7000步这个模型也是大差不差。
例如:
写在最后:
阿部洋一老师的漫画画风非常有特色,而且脑洞异常的大。有兴趣的读者可以去阿部老师的X空间看看。老师的推ID:@beyoichi
最后分享两张老师的插画