


内容若有缺漏和错误欢迎交流指正~
近年来以openai为代表的AI公司一次次向我们展示了更大模型和更高参数的魅力,模型训练规模一年年增长,效果一年年变强,让人感觉到大就是正义,而大模型的天花板似乎还没有被看到.......
Scale is All You Need
大模型更偏向工程领域,对于stable diffusion这种大模型,普通人以个人或者以小型实验室为单位是很难从规模上做出突破的,这其实也是好事,说明AI领域正在一步步走向成熟。事实上,以Google为代表的大公司还是无私慷慨的,将自己训练出的模型直接免费开源,还提供了Google Colab实验平台,国内的百度也对标开发了AI Studio平台,普通人可以从中获取免费或低价的显卡资源。尤其是最近几年AI领域发展迅速,仿佛涌向未来的浪潮。
对于处于浪潮中的普通人,学会站在巨人的肩膀上思考才是最重要的,利用好大模型,保持对新知识的好奇和学习,掌握相关行业动态,产生自己的灵感创意,大胆地去实践。
Brain is All You need
夸夸其谈就此结束,回到正题。
前三篇我们分别从整体,数学原理和实际操作浅谈了stable diffusion的原理,经过前几篇的阅读,我们对扩散模型已经有了大概的认知。
stable diffusion(latent diffusion)出现后,得益于其开源和火爆,社区内诞生了很多Fine-tuning(微调)之类的工作,让扩散模型的魅力进一步展现,本文就围绕相关工作展开浅谈,顺便填上前几期的缺漏。
由于相关工作的发展速度惊人,笔者对这些方面不甚了解,若有错漏,还望交流指正。
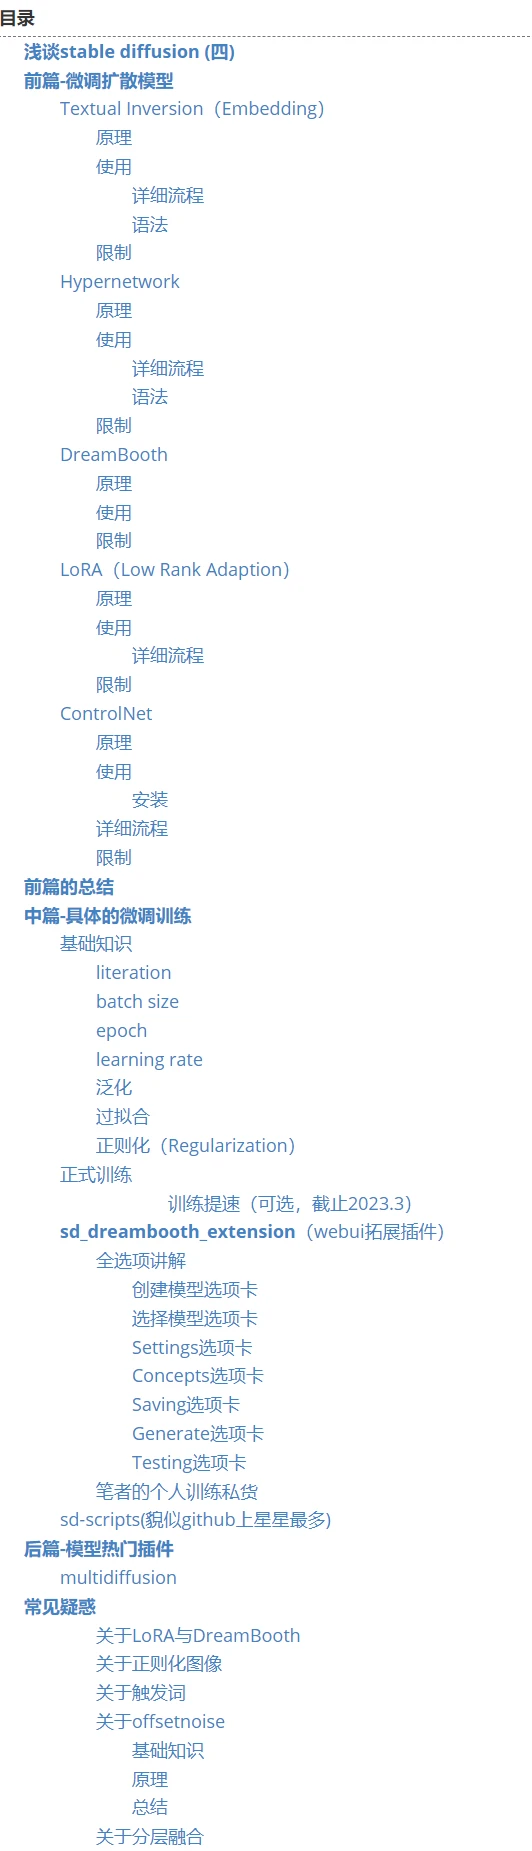
虽然B站专栏不支持目录,但是你可以ctrl+F找到你想要看的~
前篇-微调扩散模型
本篇很多东西在第二篇有过介绍,本篇将进行更深入的分析,并为下一篇的的训练打下基础。
Textual Inversion(Embedding)
中文名为文本反转,该功能基于Rinon Gal等人的论文
An Image is Worth One Word: Personalizing Text-to-Image Generation using Textual Inversion
原理
现有的图像生成大模型可以很好地根据用户的文本生成不同图像,这种强大的生成能力能够生成各种各样的艺术创作,但是对用户来说还是难以控制大模型的生成,用户单单用自然语言很难传达自己脑海中的需求。
再加上将一些原先模型没有的新概念引入大模型是非常困难的,普通人无法承担重新训练的代价,而盲目的微调(Fine-tuning)可能导致大模型遗忘先验知识(prior knowledge),所以常见的方法是将原来的模型参数进行锁定然后添加更多层网络结构来调整大模型。
本篇中只有DreamBooth的方法是在一系列措施下对原有模型调整(破坏)了权重,其余都是通过添加多层网络且锁定原有模型参数
文本反转提出了个性化的文生图方式(personalized text-to-image generation),可以根据文本和用户给的几张图来生成新图像。
读过前面几篇文章,我们已经知道了文本经过文本编码器中被转化为语义向量,那么在这一阶段,我们试图利用一个被我们创造出的伪词(pseudo-words)来直接优化这一过程。
浅谈越来越深入了......
那我们就要搞清楚这一过程发生了什么
在文本编码器中用户输入的字符串的每个单词或者子词经过分词器(Tokenizer)被转换为token。
标记化(Tokenization )是计算机理解单词的方式,人类可以读单词,但是计算机只能读数字,这就是为什么下图我们的token是数字
每个token通过一个字典(可以理解为的下图Embedding Lookup)索引到一个对应的词向量(embedding)。
这些词向量是可以被训练学习的,每个词向量都对应着一个768维的向量(V1版本下)
我的们的伪词(下图的
)也化为对应的向量(下图的
),然后和其他普通词汇一同进入下一流程。
我们的伪词实际上代表我们向大模型注入的新概念,就这样和其他词一起被处理。
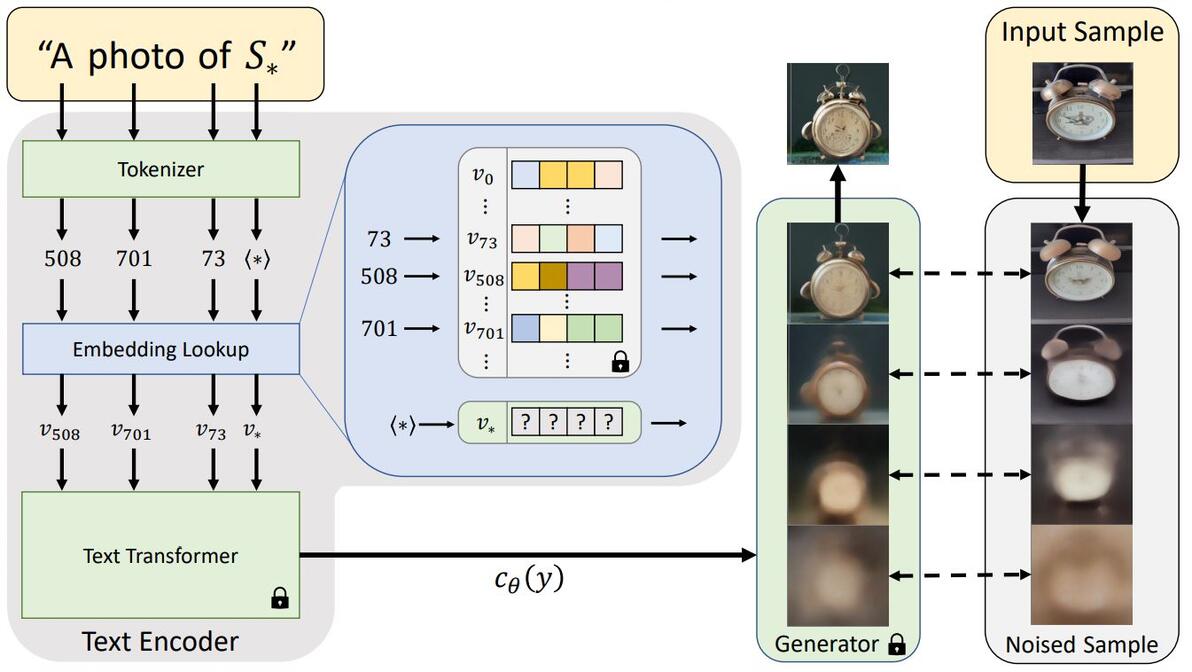
文本嵌入和反转过程的概要
那么我们如何通过学习训练使得我们的伪词()被转化为的向量(
)真的能代表我们的新概念呢?
我们寻找了我们想要的概念在多种背景或者姿势下的小组图片(通常3-5张)
我们通过基于我们新概念构造的短语来生成新图片,然后通过训练使得我们通过新概念构造的短语生成的新图片与我们找到的小组图片尽量相符合
在这一个尽量相符合的过程中,我们模型就学习到了不同图片的共同特征,那些不同的东西也在一定程度上被抛弃了
优化目标为:
找到一个向量
通过这个过程我们学习到了我们需要的向量(),而且我们并没有影响其他词语到对应向量的转换,然后我们就可以利用我们新学到伪词进行生成了。
使用
详细流程
下载好的模型应放置于./stable-diffusion-webui/embeddings
点击按钮如下图
显示如下
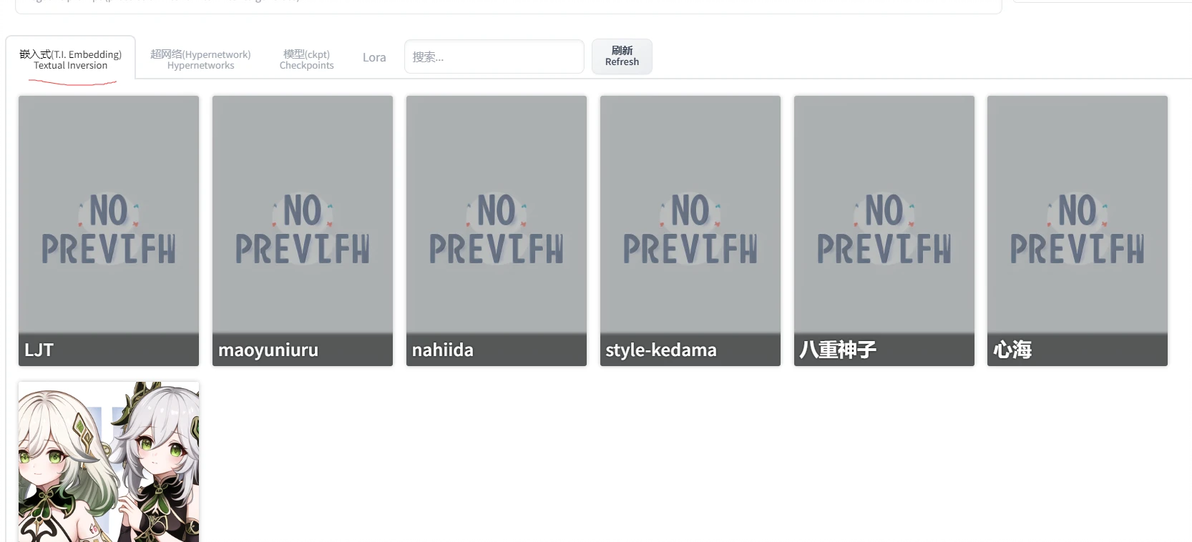
这个嵌入式就是我们所说的文本反转的选项,点击你想要应用的模型即可自动在prompt处输入
心海点击生成
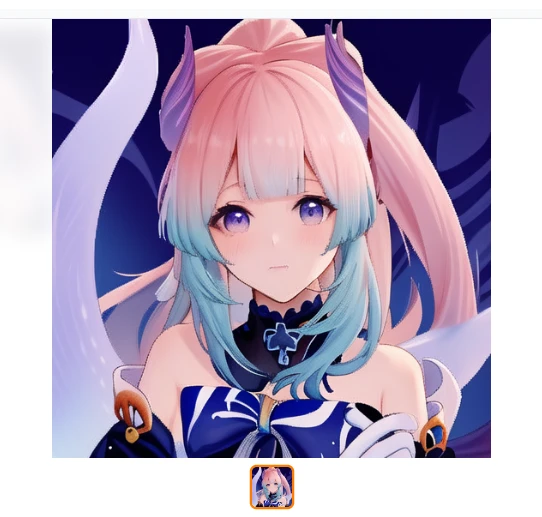
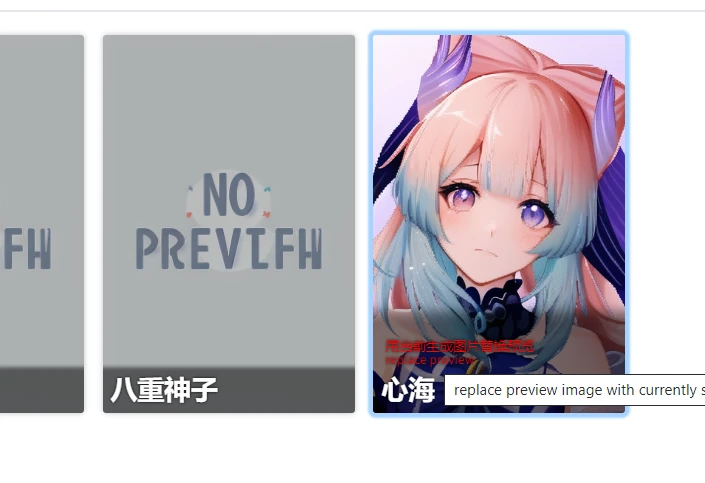
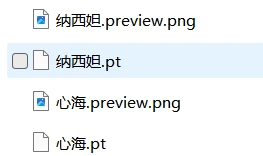
此外我们可以在生成后,对着预览栏对应模型,点击切换预览图,点击后会在模型文件夹所在目录生成同名的图片
语法
我们创建的伪词是和普通的文本一同遵守prompt语法的,我们在第三篇已经有了完整详细的介绍,我在此处只放出例子
我这里的心海和纳西妲都是embedding
心海 AND 纳西妲生成图片,貌似心海老婆略胜一筹
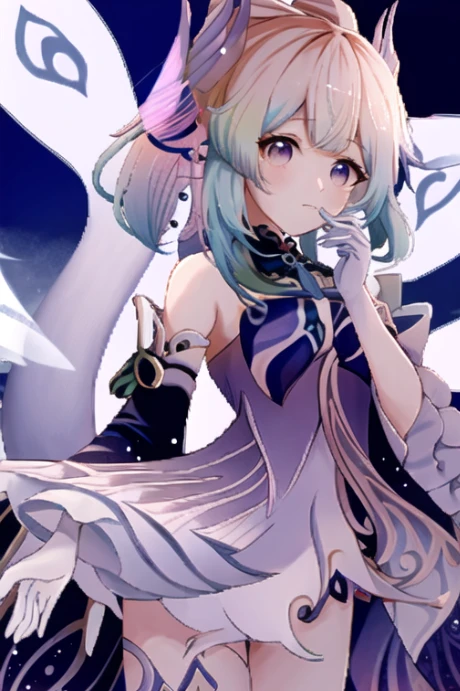
我们按照AND的语法调整权重
心海:0.8 AND 纳西妲:2.2生成图片,纳西妲老婆占据了上风
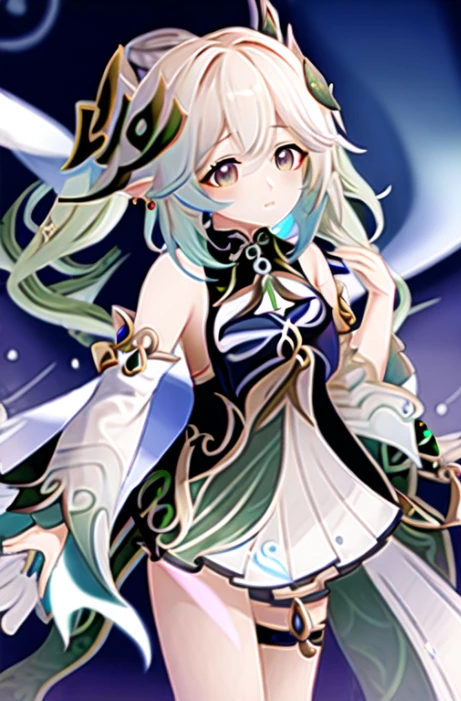
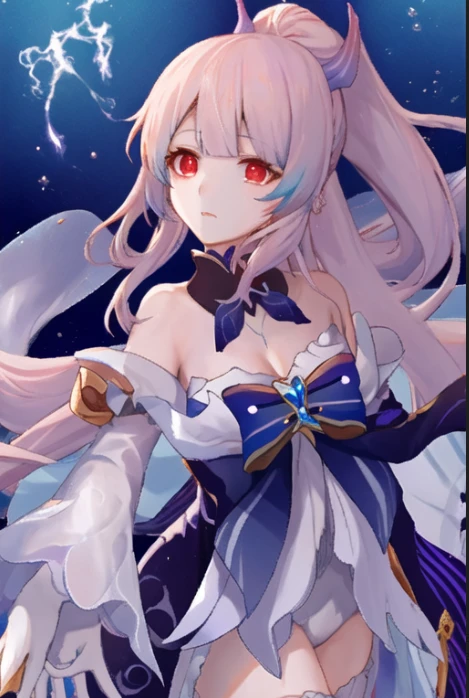
通过上文的原理,我们知道我们创建的embedding并没有影响到其他词的词向量,所以可以被用于自然语言中
我的老婆 (心海:0.8) with red eyes生成结果,非常成功的例子~
限制
因为优势因应用而异,所以这里只提限制
在高精度生成的方面可能会有限制
虽然能帮助生成相似图片,但是是基于我们训练出的V_*而生成,我们希望学习的东西的“本质”并没有实际融入
学习一个新概念大概需要1-2小时
在V100上大概需要1小时,可能随着后续发展缩短时间
在不同的模型上效果不一致,除非你们的模型是基于同一个大模型训练的,所以很难重现效果
你不能在stable diffusion v1版本练出的embedding用于v2版本,因为文本编码器使用的语言模型经过替换。你可以通过上文的按钮来查看你可用的embedding
Hypernetwork
中文名为超网络,来自Novel AI的模型微调技术。
不要和通常的超网络搞混了,我愿意称这个为NovelAI Hypernetwork,但俩者在思路上是有共同之处的。
原理
该技术将一个小的额外神经网络附加到原来的模型上进行微调,当然此时原来的模型参数是被锁定了的。
具体附加到了我们稳定扩散模型的噪声预测器U-Net的注意力交叉模块(cross-attention),具体的网络通常是非常简单的小神经网络。
通过之前的学习我们知道注意力交叉模块正是扩散模型用条件(文本)控制图像的地方
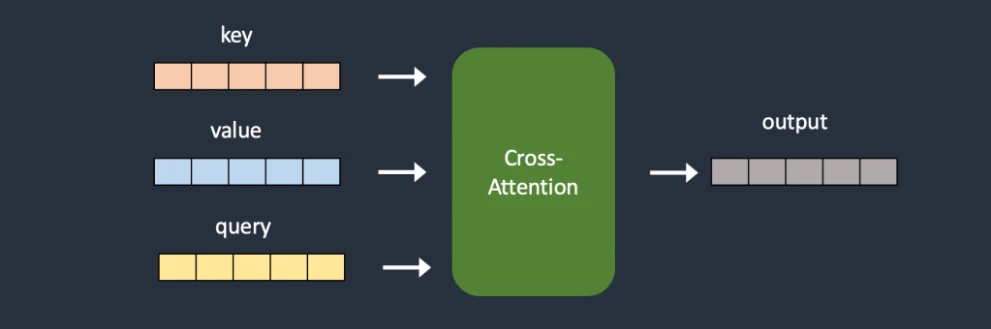
原始扩散模型的交叉注意力模块
超网络注入额外的神经网络参数来转换键和值
由于附加的神经网络非常小所以训练起来很快且不需要大量计算机资源。
Hypernetwork可以以LoRA的形式进行存储,但是没人写脚本......因为一个东西长得像LoRA使用起来也像LoRA,那他就是LoRA
使用
详细流程
下载好的模型应放置于./stable-diffusion-webui/hypernetworks
点击按钮,即可应用hypernetworks
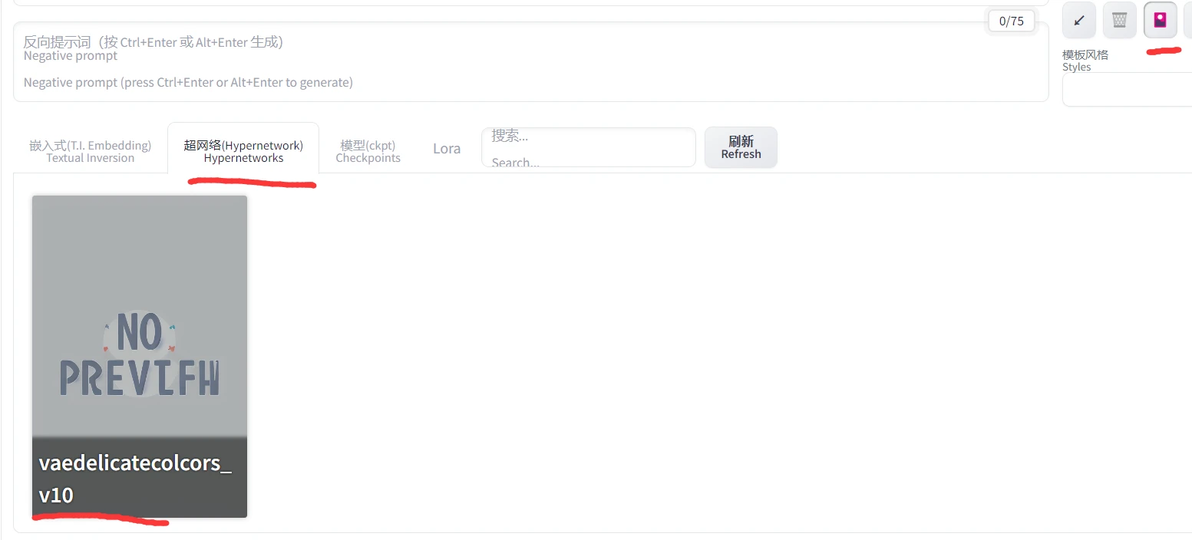
你的超网络的名称将会被插入提示词框,和文本反转稍有不同,这种应用方式只是提示你开启了这个超网络,在实际生成时,这个提示词将会被删除再送入文本编码器,所以你肯定是不能把prompt的语法应用在上面的。
<hypernet:vaedelicatecolcors_v10:1>
我们来生成试试
这里用到了提示词矩阵(prompt matrix)的脚本
masterpiece, beauteaful anime girl, sunflower, finely detailed beautiful eyes and detailed face, colorful, blonde hair, red eyes, white kimono, off shoulder, shining, dark color, fox ears| <hypernet:kyoudaSuzukaAnime_10:1>
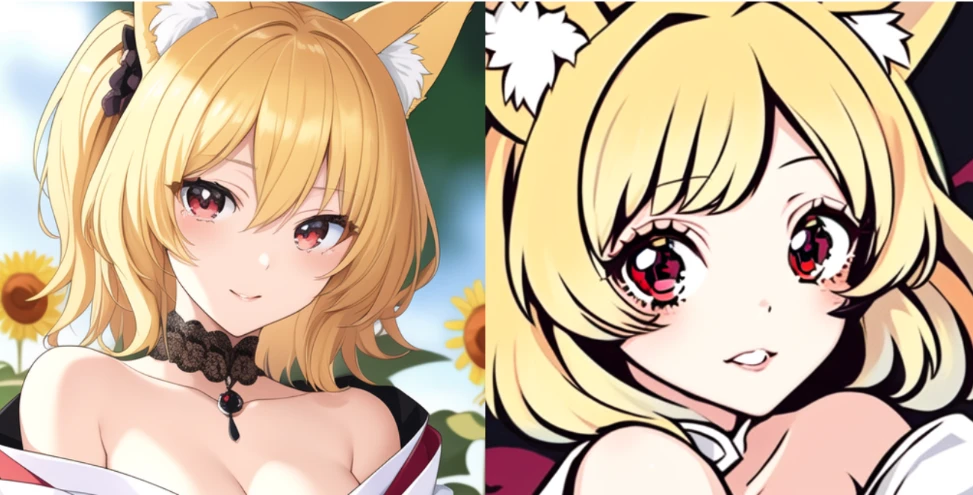
减弱效果试试
masterpiece, beauteaful anime girl, sunflower, finely detailed beautiful eyes and detailed face, colorful, blonde hair, red eyes, white kimono, off shoulder, shining, dark color, fox ears| <hypernet:kyoudaSuzukaAnime_10:0.5>
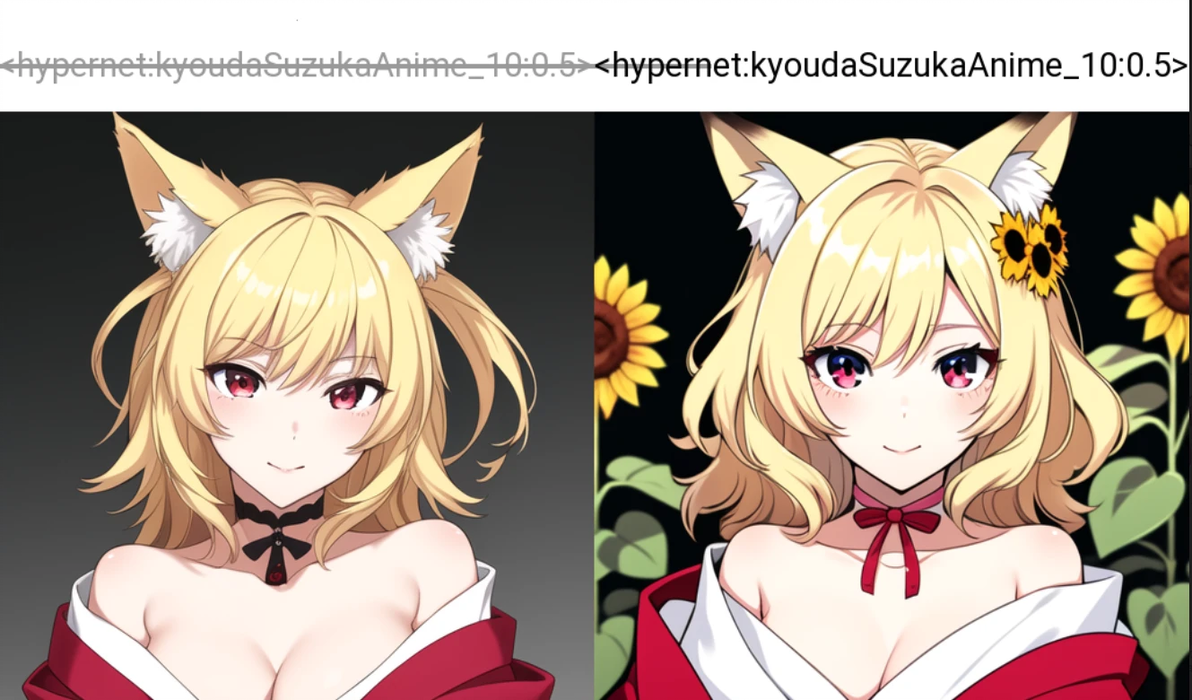
看着相当不错哇~
语法
上述例子我们已经讲的很清楚了,此处再重复一遍
下面是超网络的短语,multiplier可以影响效果强弱,置0就禁用了。
<hypernet:filename:multiplier>超网络的短语并不是prompt,所以不适用prompt语法,自然也不适用于自然语言。
实际生成过程,超网络的短语是被删去了的,如以下例子可以很好证明,注意我此处的kokomi是文本反转提示词
ko<hypernet:vaedelicatecolcors_v10:1>komi,ANIME
限制
存储体积大,相比文本反转和LoRA系列
作用效果的控制力比较尴尬,作用范围很难去掌控
不同模型上效果不一致
DreamBooth
中文名常被翻译为梦幻照相馆,我认为非常贴切。
It’s like a photo booth, but once the subject is captured, it can be synthesized wherever your dreams take you.
原理
以下原理主要侧重于原本论文意图
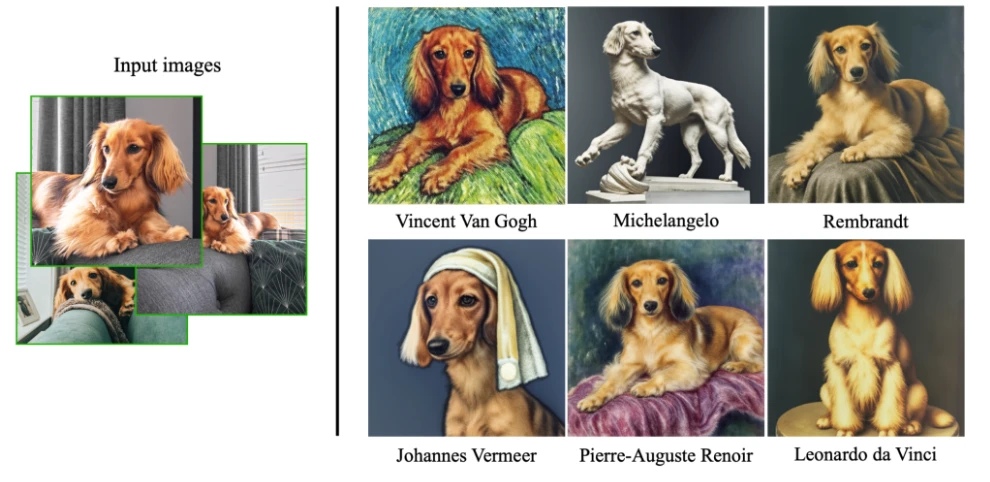
只需 3 张训练图像,Dreambooth 就可以将自定义主题无缝地注入扩散模型
其原理是扩展目标模型的text-image 词典(其实就是文本编码器部分),将新的文本标识符与特定主题或图片进行联系(其实就是训了对应词的词向量),然后引导图片生成
小数据集会导致过度拟合,而且茫然地扩展text-image还会导致语义漂移(language drift)
而DreamBooth则通过一些方式解决了这些问题:
为新的主题使用一个罕见的词(是不是想到了文本反转),避免语义漂移(可以理解为prompt撞车)
比如sks
保留同类的先验知识,通过设计一个损失函数,鼓励扩散模型不断生成与我们的主题相同大类别的不同实例(不要忘记之前的知识)。
看着是不是和我们之前讲到的文本反转(Textual Inversion)很像,请注意DreamBooth注入了一个罕见词,且微调了整个模型,而文本反转则是注入了一个新的关键词,只微调了模型的文本嵌入部分。
此外在训练时通常要给出你要训练的提示词+训练集,和所在类的提示词+所在类的训练集,如果不给所在类的训练集则会让模型通过你给的类的名称生成图片作为所在类的训练集。
以上说法根据最开始的dreambooth脚本,具体实现看你训练脚本。
使用
一般而言,单纯用DreamBooth进行训练的模型都可以通过stable diffusion模型处进行切换。
使用过程中请使用你的模型在训练时所用的提示词,因为模型在训练过程中也调整了文本嵌入层。
不排除某些训练脚本锁定了文本嵌入层,或者某些模型训练画风甚至都不需要先验知识(所在类的训练集)自然也不需要提示词
限制
训练过程相比其他方法更消耗显存内存。
体积大。
调整(也可以认为是破坏)了原有模型,可能会出现一些原模型没有的缺点。
控制能力差(不能即插即用)
LoRA(Low Rank Adaption)
中文名也许是低秩适配,本文大概讲讲stable diffusion内的LoRA。
原理
LoRA并不是扩散模型专有的技术,而是从隔壁语言模型(LLM)迁移过来的,旨在解决避免将整个模型参数拷贝下来才能对模型进行调校的问题。因为大型语言模型的参数量过于恐怖,比如最近新出的GPT-4参数量约为100 万亿。
LoRA采用的方式是向原有的模型中插入新的数据处理层,这样就避免了去修改原有的模型参数,从而避免将整个模型进行拷贝的情况,同时其也优化了插入层的参数量,最终实现了一种很轻量化的模型调校方法。
和上文提到的Hypernetwork相同,LoRA在稳定扩散模型里也将注意打在了crossattention(注意力交叉)所在模块,LoRA将会将自己的权重添加到注意力交叉层的权重中,以此来实现微调。
添加权重是以矩阵的形式,如果这样做,LoRA势必需要存储同样大小的参数,那么LoRA又有了个好点子,直接以矩阵相乘的形式存储,最终文件大小就会小很多了,训练时需要的显存也少了。
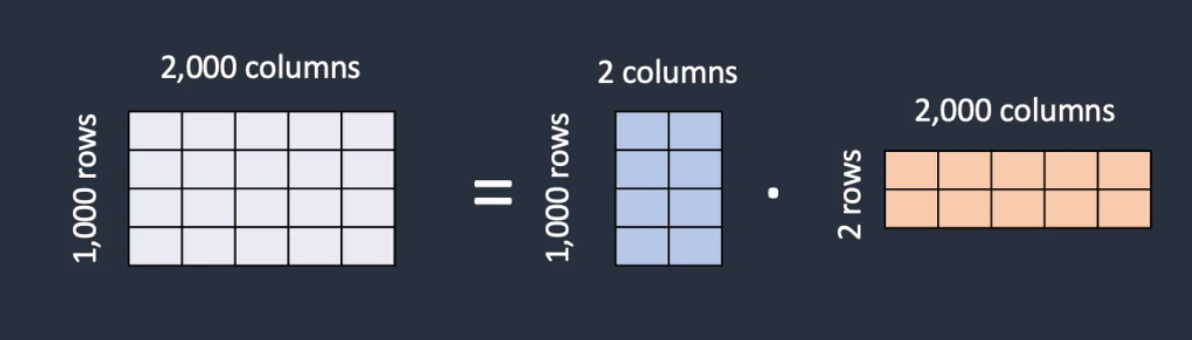
!!!严格来说LoRA的名字指的是这种数据的存储方式,实现方式与我们的目标有关,上文我们所说LoRA作用注意力交叉模块的说法来自最早的LoRA训练脚本的早期时候。
比如你以DreamBooth的方式进行微调的时候额外使用LoRA这种存储方式,你得到的结果也是LoRA,这也是目前大部分魔法师口中的LoRA。
如果你的训练方法中包含了正则化图像训练集,就可以理解为是DreamBooth的一种实现方式
你可以在网上找到LoRA for Convolution Network,自称从LoRA演进的版本,貌似存储的参数量更少,至于好不好用,不太好说。
使用
使用方法和Hypernetwork类似
我这里讲的是官方用法,LoRA官方适配前还有插件提供了支持,用法稍微有点不一样
详细流程
点击即可应用LoRA
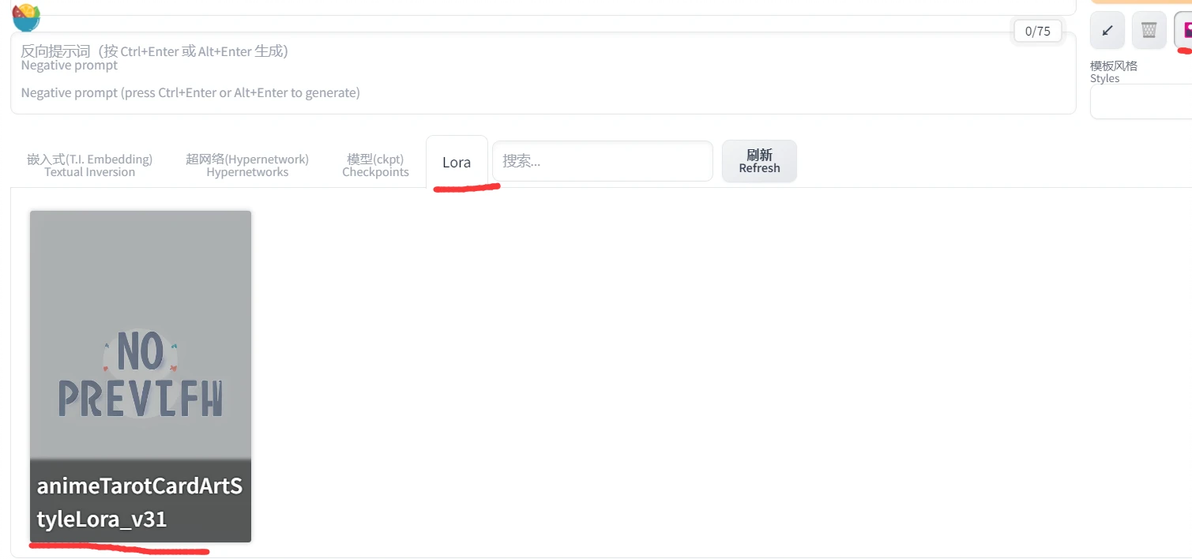
<lora:animeTarotCardArtStyleLora_v31:1>我这个LoRA是训练师口中的画风LoRA,所以特定的prompt对LoRA作用能力虽然有但不是很强,以下仍然是例子:
虽然出现了大写,但根据前面的学习我们是知道在如果我们文本编码器使用clip那么大小写是不影响的
首先是不带LoRA短语,seed为3869586516
a girl|CARD|TAROT
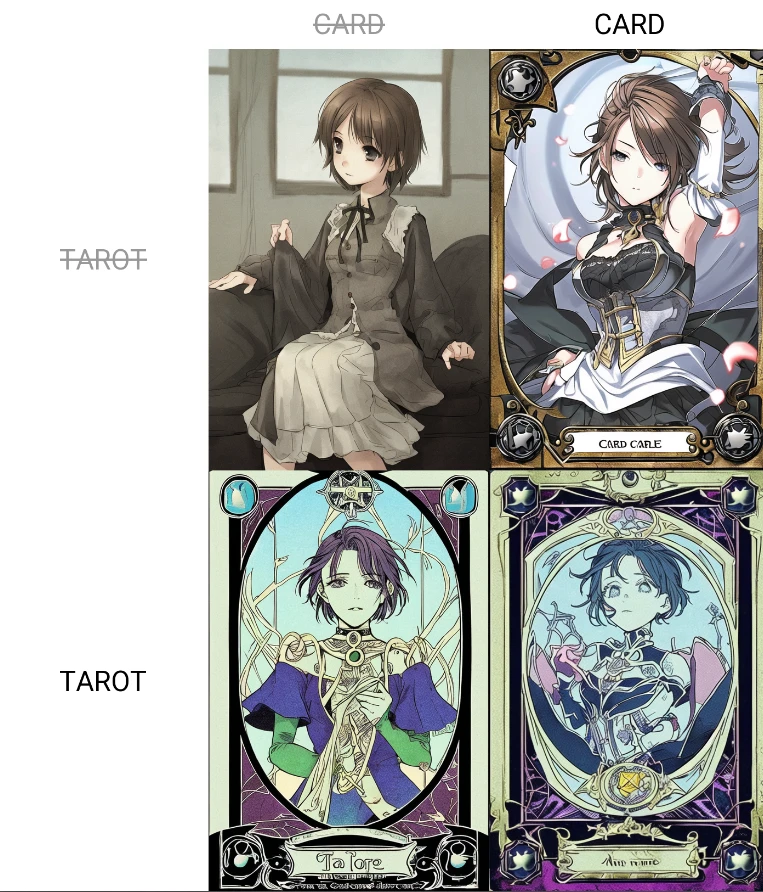
然后是带LoRA短语,seed为3869586516
<lora:animeTarotCardArtStyleLora_v31:1>,a girl|CARD|TAROT
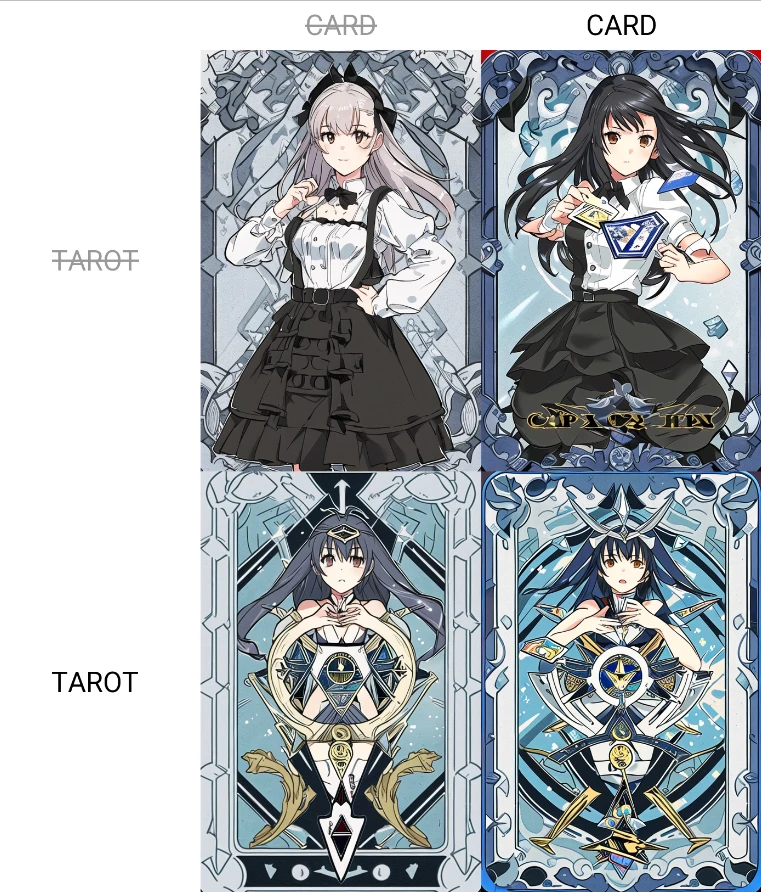
看着作用力很强啊?
但是我说指的是特定prompt作用力不是很强,可以看到这个LoRA的作用范围词是很广的,比如我的a girl即使没有CARD和TAROT词,也染上了塔罗牌的特色,而加上了CARD和TAROT等特定词效果更是发挥完全,但是并没有达到一词质变的效果。
这个模型,一定的广度提示词都有特定图集的效果,说不定这也是作者的意图......
我们接下来找个其它的LoRA,要找到一个能在我的模型上发挥好效果的LoRA还是挺难的......
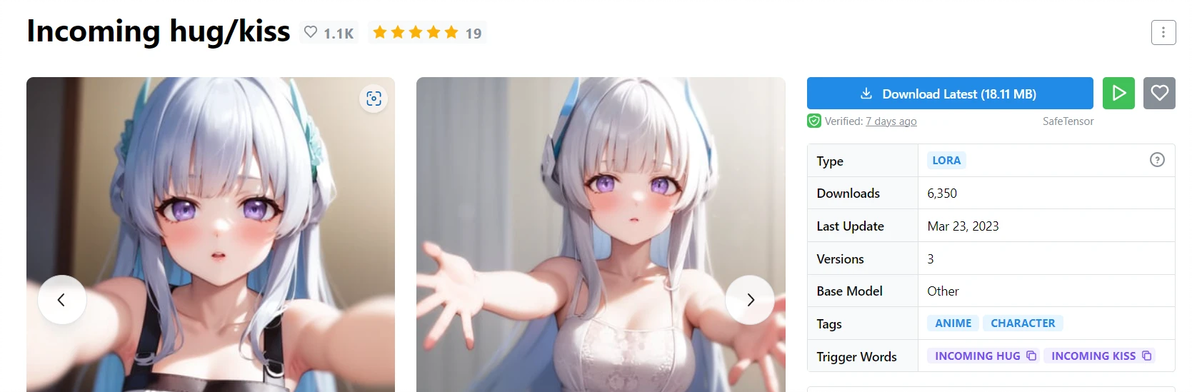
我们最终看到了上面这个,等等Trigger Words(触发词)是啥,之前没有提到过这个,别急(我很急)
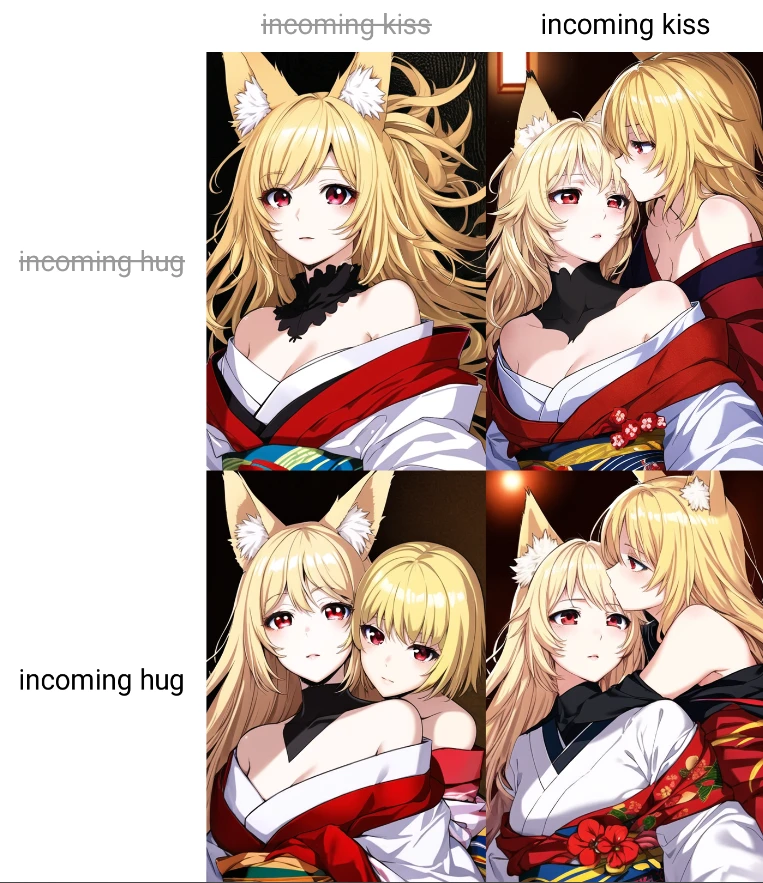
我们先来上个提示词矩阵
不含LoRA版,种子520
<lora:incomingHugKiss_v12:0>,masterpiece, beauteaful anime girl, finely detailed beautiful eyes and detailed face, colorful, blonde hair, red eyes, white kimono, off shoulder, shining, dark color, fox ears|incoming kiss|incoming hug
LoRA版,种子520
<lora:incomingHugKiss_v12:0.8>,masterpiece, beauteaful anime girl, finely detailed beautiful eyes and detailed face, colorful, blonde hair, red eyes, white kimono, off shoulder, shining, dark color, fox ears|incoming kiss|incoming hug
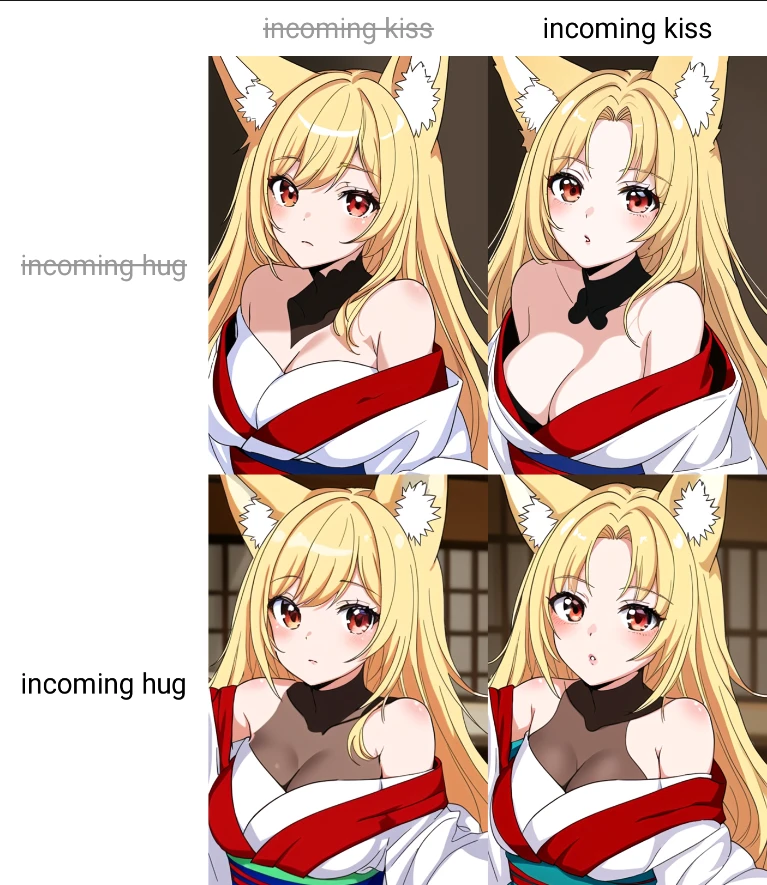
可以看出不同的Trigger Words的效果差别很大,而且和无LoRA时相差很大,很好地把握住了作者想要体现的意图,实现了所谓的Trigger(触发)的效果。
但是我们仍然可以看到,即使是没有Trigger Words我们的画面仍然是被影响了,这可能是我的模型选用和作者不同的缘故。
这又是什么原理呢,我猜测这个LoRA正是我们之前提到采用DreamBooth方法进行训练的,同时训练了文本嵌入层和网络层。文本嵌入层的实现使得Trigger Words的效果强烈,比如
在训练时,将图片分为incoming hug和imcoming kiss和俩者兼有三类,分别打上tag,即可使得Trigger words产生效果(原理接近文本反转)。
但是我们注意到,这和文本反转最大的不同是,我们只触发了一种姿势,而并没有产生相应的原有图片可能造成的特征,笔者认为这是在训练过程中采用了更详细的prompt来进行这一过程,接下来我将给出个例子
比如下图的白毛,我们将其分到incoming hug一类,并为其打上tag
incoming hug
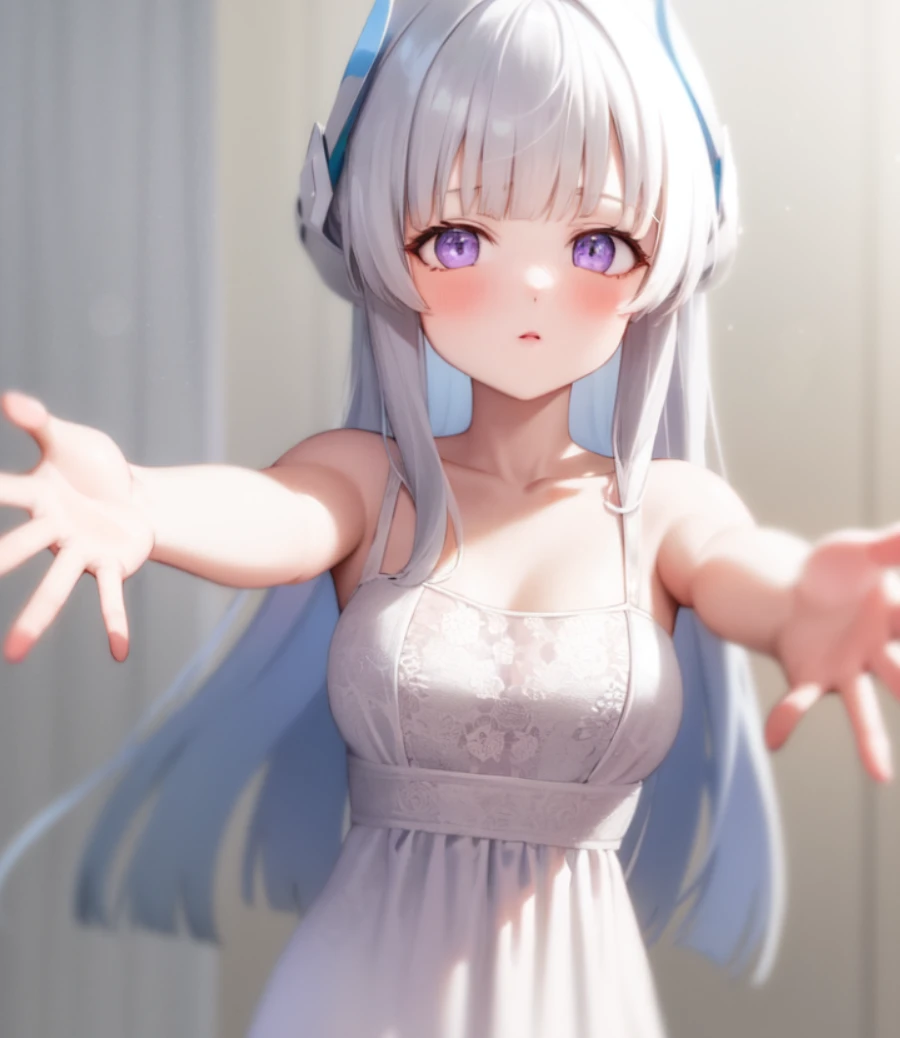
这时我们的incoming hug就会开始学习这个白毛,但是我们是不想这个词学习到白毛或者是这件衣服,
所以我们对打上的tag进行了修改,下面的中文只是我不想打对应英文
white hair,衣服,白色背景,窗帘,incoming hug这样由于在训练过程中,其余词对模型来说是常见的词都能对应上,incoming hug将会学习到靠近的拥抱这一姿势,而不是把衣服也学习到,不断地这样训练,我们的incoming hug最终会成为靠近的拥抱这一姿势的触发词。
不知道你理解到其中的关键之处没,如果你理解到了,其实可以推出我们在构建这个修改后的tag时,需要把我们不想要触发词包括进去的元素(比如上图的白毛),尽量用模型已知的词语进行替代(比如white hair),而触发词要尽量罕见(比如diffusers喜欢用的sks)才能和模型以前的这个词对应的元素进行分离(够罕见的话,原模型的对应元素很少),当然如果你只是想加强或修改原模型对应触发词的元素(比如我想加强ganyu),你可以选择原模型该元素的对应词(直接选择ganyu作为ganyu图片触发词)。
那么一个问题的关键是,我们怎么知道什么样的词是罕见词,什么样的词是模型应该已经知道了的词?
你是否想到了Clip和DeepBooru,我们可以轻松通过这俩知道模型已经知道的词
注意只有基于Novelai泄露的模型才对DeepBooru效果好
那么上图经过询问DeepBooru得到
blurry, blurry background, blurry foreground, depth of field, open hand, outstretched arm, outstretched hand, palms, reaching, reaching out, spread fingers, foreshortening, 1girl, beckoning, purple eyes, outstretched arms, breasts, looking at viewer, selfie, waving, dress, long hair, hands, pov, motion blur, open hands, collarbone, blush很好地概况了图片的特征,此时我们需要把靠近的拥抱这一姿势相关的词删掉,避免我们的触发词的效果被这些词抢去了,我决定删除以下的词
open hand, outstretched arm, outstretched hand, palms, reaching, reaching out, spread fingers, open hand, outstretched arm, outstretched hand, palms, reaching, reaching out, spread fingers, beckoning,outstretched arms, open hands得到
blurry, blurry background, blurry foreground, depth of field, 1girl, beckoning, purple eyes, outstretched arms, breasts, looking at viewer, selfie, waving, dress, long hair, hands, pov, motion blur, collarbone, blush然后增加我们这个被称为触发词的东西(incoming hug),他将会抢占被我们删除的词语对应的元素,最终是这个
blurry, blurry background, blurry foreground, depth of field, 1girl, beckoning, purple eyes, outstretched arms, breasts, looking at viewer, selfie, waving, dress, long hair, hands, pov, motion blur, collarbone, blush,incoming hug删词还是挺累的,估计有美术细菌的话能更好把握这种东西。
当然,以上只是我基于原理的纯粹推理,这个作者究竟是做了怎样的处理,我也无从知晓。
总之通过这种方式,我们其实能在文本嵌入层做出远比文本反转更加眼花缭乱的操作。
与此同时由于我们还训练了网络层,使得即使没有这俩词我们的图片也会产生变化。
虽然dreambooth方法使用了设计好的损失函数尽量避免先验知识的损失,但是是针对原模型的,我的模型和作者不同,不能很好地体现这一点。
限制
效果弱于DreamBooth,主流的训练方式的网络结构目前在尽量追求DreamBooth的效果,但是具体效果是很多因素影响的。
成分复杂(你不知道你的LoRA究竟是用哪种网络结构训练出来的,LoRA的方式训练确实太好用了),用前建议鉴别来源。
控制力弱(虽然即插即拔,但是LoRA训练方法混乱,训练成品良莠不齐,很难有效把控)
不同模型效果不同
ControlNet
我的回合,抽卡!!!
不好意思,走错片场了。ControlNet论文作者Lvmin Zhang真的了不起,2021年才本科毕业,目前博一已有多篇工作,还在空闲时间开发了热门游戏YGOPro2,是真正的时间管理大师。
一飞冲天的背后是一步步的积累
原理
ControlNet 是一种神经网络结构,通过添加额外条件来控制扩散模型。
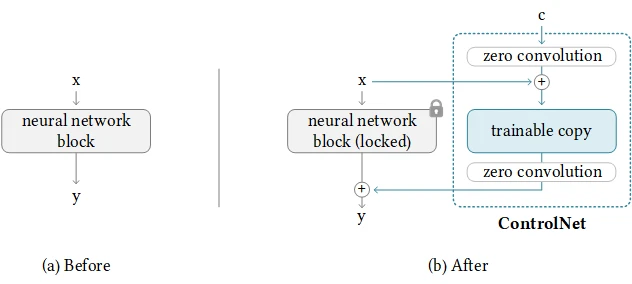
展示了将ControlNet应用于任意神经网络块的方法。x,y是神经网络的深层特征。“+”表示功能添加。“c”是我们要添加到神经网络中的一个额外条件。“zero convolution”是一个1×1卷积层,权重和偏差都初始化为零。
ControlNet将神经网络权重复制到一个锁定(locked)副本和一个可训练(trainable)副本。
可训练副本将会学习新加入的条件,而锁定副本将会保留原有的模型,得益于此在进行小数据集训练时不会破坏原有的扩散模型。
可以看到使用了零卷积(zero convolution), 这样做的好处是可以以0值初始化,卷积权重会以学习的方式从0开始增长到优化参数,所以在训练的初始阶段(训练前)不会影响原模型,所以不是从头开始训练,仍然属于微调(fine-tuning)。
这种结构也方便我们对模型/权重/块/层进行合并/替换/偏移。
以下为ControlNet在stable diffusion中产生作用的过程
根据前几篇我们对stable diffusion已经有了初步了解,但是为了理解ControlNet我们仍需要再稍微蹭进去一点。stable diffusion的U-Net结构如下图所示,包含12个编码器块(Encoder Block),12个解码器块(Decoder Block),还有一个中间块(Middle),完整模型包括25个块,其中有17个块是主块。文本使用clip进行编码,时间步长采用位置编码。
我们将上图的简单结构附加在stable diffusion 原来的U-Net结构上14次(相当于复制了一次编码器块和中间块,然后改造成ControlNet结构),就完整地对原有的结构进行了控制(影响),原有的stable diffusion 就化身为了 stable diffusion + controlnet
实际上笔者认为不一定要复制stable diffusion的块结构,可以是任何结构,作者选择stable diffusion的块结构大概是因为SD的块已经经过实践检验了,作者认为这些块是深厚、坚强、强壮、有力的主干(deep, strong, robust, and powerful backbone)
好吧,要是自己弄出的块比stable diffusion好还搞微调干什么,直接重练算了
原谅我打字累,我下文以SD-T来指代stable diffusion + controlnet
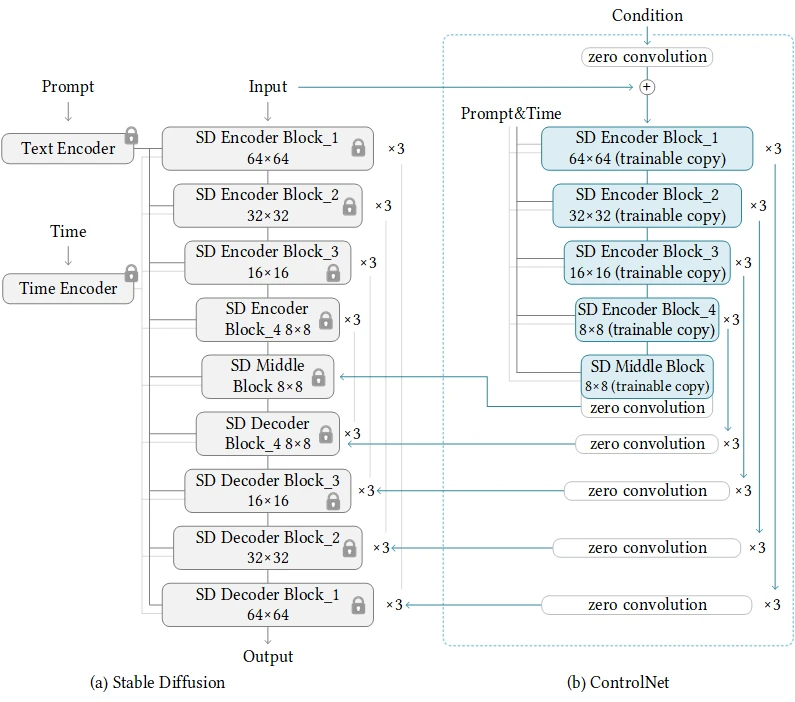
然后SD-T就可以继续尝试用特定数据集来训练学习新东西来试图完成我们想要模型完成的新任务,比如边缘检测,比如人体姿势探测,整个过程流畅,顺滑。
这是SD-T的损失函数,可以看出是在SD的基础上增加了新的控制条件
等等,为什么这样就能做到?
SD-T既能做到边缘检测,又能做到涂鸦检测,而且是在一统的架构下进行的,多种任务只需要一种解决方式,这......也许就是大模型+优秀结构的魅力吧。
所以一句话概括就是,ControlNet是一种新型的大模型训练微调机制,而且效果非常好
论GPT-4是如何碾压其他的模型
实际的生成流程中的步骤
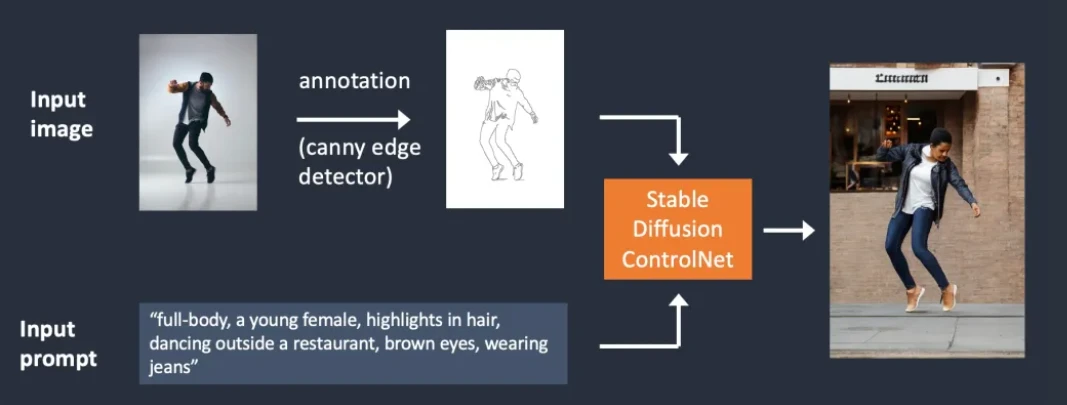
ControlNet通过获取额外的输入图像并使用Canny边缘检测器(Canny edge detector)来获取轮廓图,这一过程被称为预处理
轮廓图(自然是会被处理到隐空间去)将会作为额外的条件(conditioning)和文本提示被送入SD-T
由于SD-T进行扩散时参考了我们多出来的条件,所以最终出现的图会具有我们预处理时的特征
T2I-Adapter原理和ControlNet相似,都是为了给稳定扩散添加额外的输入条件,我也就不再介绍
使用
安装
因为ControlNet基于SD1.5模型二次训练,用于其他模型需要进行偏移(至少效果不会更差),所以建议在插件下使用。
安装webui插件sd-webui-controlnet

此外我们还需要下载进行预处理的模型和SD-T模型,预处理的模型会在你使用时自动进行下载
SD-T模型太大需要自行下载,但是我们无需下载我们模型专用的SD-T,因为插件会在使用时自动根据你的模型进行偏移操作。
但是SD-T有点大,所以插件也提供了用SD-T 减去SD得到T (或者从SD-T 提取 T)的 修剪模型(T)。
上面这个描述不太准确,意思意思~
原SD-T
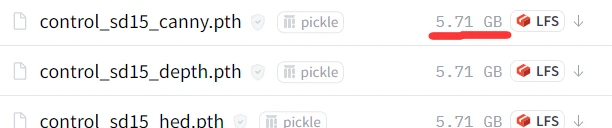
修剪后的T,5.71GB --> 723MB
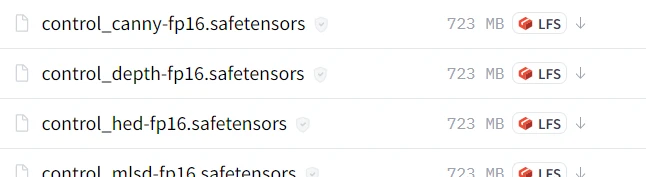
所以是要下载原来的SD-T还是T就看你的硬盘/内存和显存了
以下是原SD-T模型地址
Pretrained Models: https://huggingface.co/lllyasviel/ControlNet/tree/main/models
以下是修剪后的模型地址(里面也有预处理模型)
Pre-extracted model: https://huggingface.co/webui/ControlNet-modules-safetensors
Pre-extracted difference model: https://huggingface.co/kohya-ss/ControlNet-diff-modules
模型下载后放在./extensions/sd-webui-controlnet/models/ControlNet/
预处理模型文件下载位置./extensions/sd-webui-controlnet/annotator/xxx对应文件下/
详细流程
只是给一个简单的例子
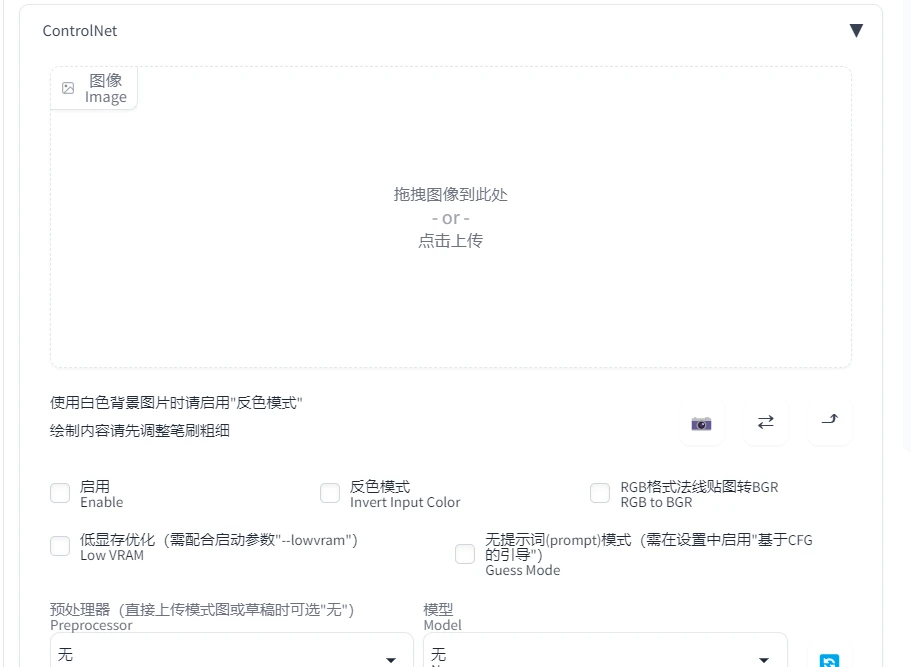
点击ControlNet,展开了页面
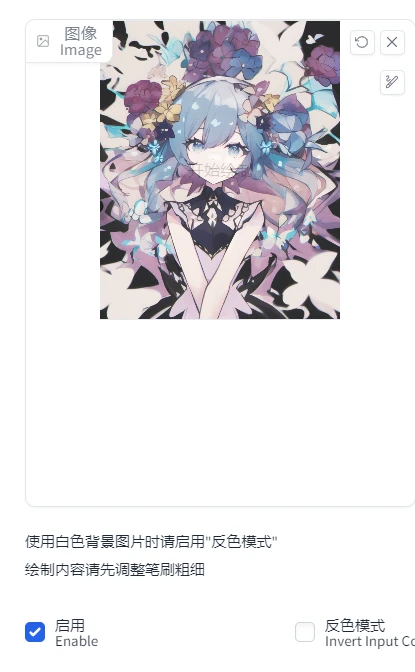
点击上传图片并启用
点击这个可以预览预处理结果
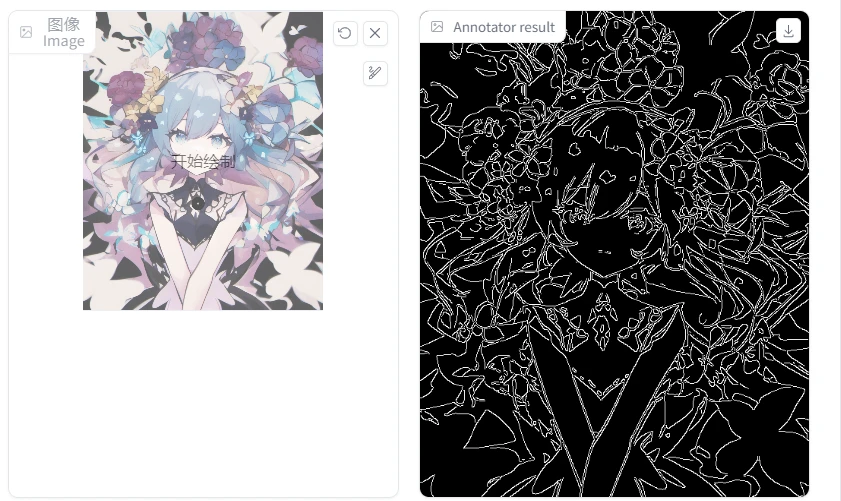
点击生成
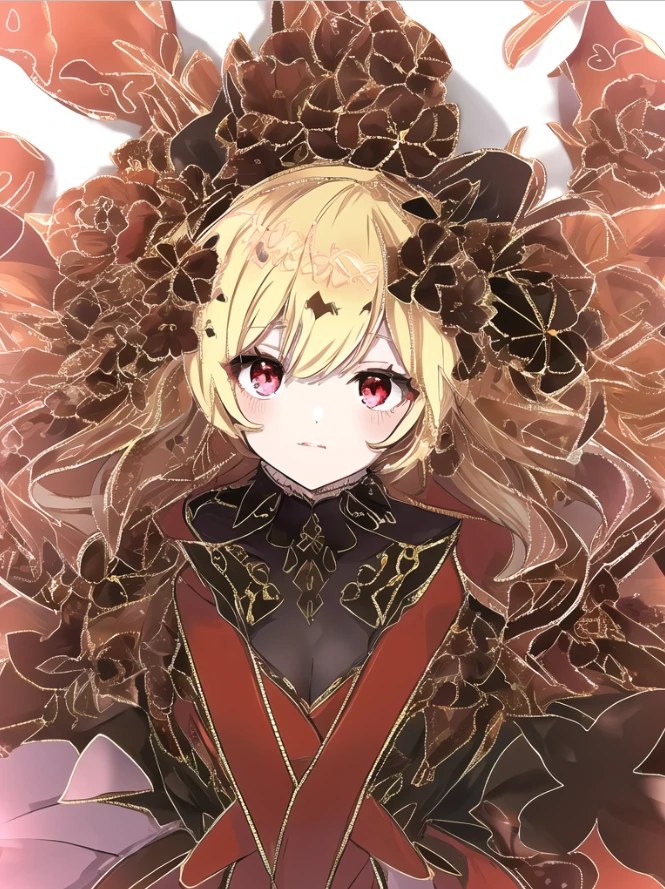
效果不错,完美对应上了结构,就是线条太惹眼了,是什么问题造成的呢,可以看到我们预处理时分辨率太低了,对于我们生成的图来说线条太粗(对应到隐空间也是如此)。
我们再来详细看下设置
反色模式
用来帮助检测器在白色背景下进行识别
RGB格式法线贴图转BGR
检测器是基于opencv?这项笔者尚不清楚
低显存优化
无提示词(prompt)模式(需在设置中启用"基于CFG的引导")
看来是屏蔽掉prompt的引导,因为ControlNet添加了新的条件,所以即使是没有prompt同样能实现CFG(隐式分类器指导)。
预处理器
模型
模型应该和预处理器有对应关系
预处理器分辨率
预处理图片的分辨率有关
强/弱边缘判断阈值
边缘检测器用来检测边缘的范围条件
缩放模式
画布高宽
那么很明显,我们应该调整预处理器分辨率,调高一点,试试1024
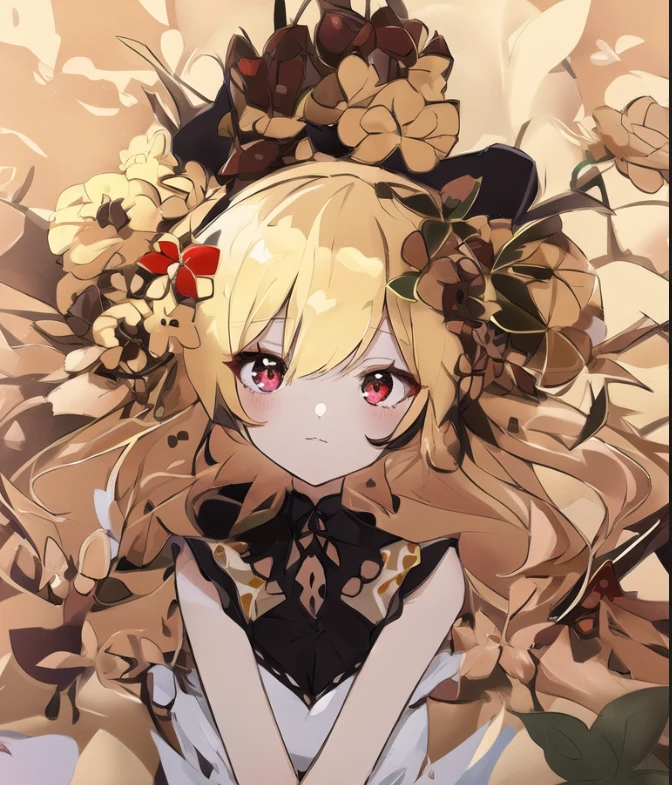
效果非常棒!
限制
个人很难训练
前篇的总结
关于stable-diffusion我上面只讲了几个最近热门的微调方法,
但是我们其实能看出其中惊人的相似性,
普遍的做法是冻结了原模型的参数或者大部分参数,然后在外部增加新的网络结构,
通过额外的数据集来训练外部网络结构,最终可以利用外部网络结构的参数影响原模型。
本质思想和Hypernetwork(广义上的 超网络,不是指的Novelai那个)非常接近。
我觉得这些工作还是具有启发性的,尤其是文本反转非常有趣
未来大模型会出现诸如此类的小方法,将大模型通过较低的成本个性化,专用化。
中篇-具体的微调训练
得益于社区的飞速发展,现在的训练方式可谓多种多样。
普通用户可以在本地通过消费级显卡通过高度封装的脚本快捷训练,比如sd-scripts
也可以在云端如colab或者飞桨平台通过diffusers或者ppdiffusers提供的脚本在免费的专业显卡上训练
B站上也出现了各式各样的教学视频
笔者本身也并不是模型训练师,只是对stable diffusion感兴趣的人,所以讲解将不会出现丰富的经验教训,
而是尽量结合前篇的原理和训练教程为例,来抛砖引玉
在进行本篇前我希望你能尽量了解一点基础知识
基础知识
数据集处理
literation
使用一个Batch(批)的数据进行一次权重更新就是一个Ilteration
batch size
每个Batch里包括了多少个训练集的数据个数
epoch
epoch可以理解为次数,整个训练集被完整练了一遍就叫1个epoch
learning rate
学习率,炼丹就像炒菜,学习率过高就像炒菜火开大了就会很快导致菜糊了(过拟合)然后前功尽弃,不好把握菜什么时候好。而低学习率就会导致火太小了,很久才能把菜弄熟。
所以适当的学习率+适当的存档频率才是炼丹的诀窍。
泛化
泛化通常指模型遇到新概念或者新情况时仍能有效应对的能力。
过拟合
模型在训练集上表现好,测试集上表现差就叫过拟合。
其原因是因为模型训练过度,导致模型学习了我们并不需要模型学习的特征(噪声)。
正则化(Regularization)
控制理论有个著名的词汇----鲁棒性(robustness),是一个日语音译词汇,用来描述一个系统或模型在噪声下的稳定性。
笔者最初见到这个词时后面没有跟着英文,当时可谓大眼瞪小眼,关键这个词在很多领域都经常出现,我常常想要是鲁棒性翻译成健壮性会不会让非相关领域或者初次见到这个词的时候能好理解一点。
笔者最初接触正则(regular)时也是一头雾水,后来查了下英文是规则,规范,约束之类的含义......
regular,英文单词,形容词、名词、副词,作形容词时意为“定期的;有规律的;合格的;整齐的;普通的”,作名词时意为“常客;正式队员;中坚分子,人名;(以)雷古拉尔”,作副词时意为“定期地;经常地”。
为什么翻译成正则?正则一词出自楚辞,意为正其礼仪法则。正则这个词对国人来说门槛不可谓不高哇。
笔者认为也许是有传统文化素养的日本太君发扬光大了“正則”然后传入中国。
《楚辞·离骚》篇有“皇揽揆余於初度兮,肇锡余以嘉名;名余曰正则兮,字余曰灵均”。 马茂远《楚辞选》注:“屈原名平,字原。‘正则’,是阐明名平之意,言其公正而有法则,合乎天道”
那么正则化(Regularization)的中文意思可等同于规则化/约束化。基于此种翻译,如果我们要让一个东西变得规则化,那么我们通常会选择添加规则(约束),这也就是正则化的过程。
通常我们所说的正则化就是对最小化经验误差函数加上约束,而这样的约束可以被解释为先验知识。
正式训练
说在前头的话
上面所说的原理和实际的训练流程可能有出入。
因为微调本来就是一件个性化的事,加之微调方法也没有怎么才是好,没有谁最好的标准。
不同的微调训练的脚本的实现方式不尽相同,但具体的使用不会离开原理。
此外我更建议使用diffusers库进行训练
训练提速(可选,截止2023.3)
安装torch1.13.1+CUDA11.7+Xformers0.0.16 (推荐,懒人选择删掉venv文件夹重新安装依赖)
安装torch2.0+CUDA12.0+Xformers0.0.18 (建议有基础的人选择)
sd_dreambooth_extension(webui拓展插件)
自行安装,自行解决环境问题
这里还是提一下大部分设备可以通过这俩条命令解决环境问题,注意是在所在虚拟环境下
#安装pytorch2.0
pip install --force-reinstall torch torchvision --index-url https://download.pytorch.org/whl/cu118
#如果你的CUDA是117就用下面这条
#pip install --force-reinstall torch torchvision --index-url https://download.pytorch.org/whl/cu117
#安装预览版xformers
pip install --force-reinstall --no-deps --pre xformers我看得最顺眼的一个训练GUI
而且提供了很多非常棒的功能。
提供了LoRA和LoRA Extended
提供了一系列数据集处理脚本
提供了一系列优化器选项
同类图像生成的精细控制
全选项讲解
创建模型选项卡
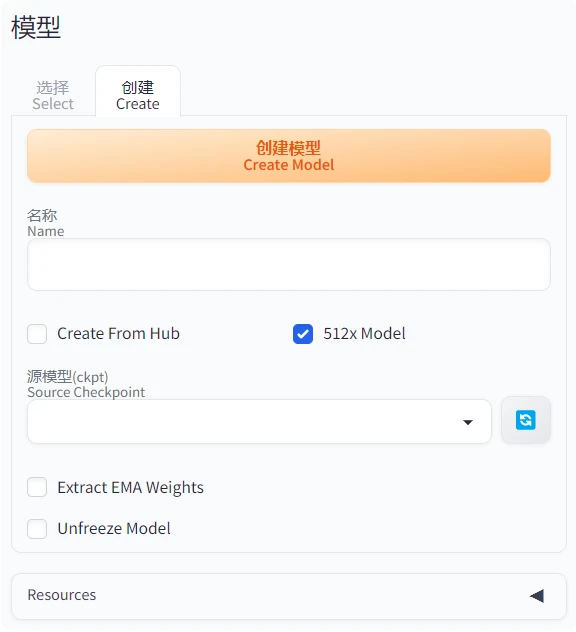
我们通常使用的stable diffusion的模型通常是集合了很多模块的权重到一起,包括vae,unet,text-encoder之类,DreamBooth插件会将其分开,方便我们进行更加个性化的训练。
这个选项卡用来从已有模型创建你的模型。
Name/名称 ,随便填
Create From Hub ,如果点击就会出现下列选项卡,填入HuggingFace的模型路径和Token(如果是私有模型),就可以直接下载并应用,非常方便在云端训练的同学
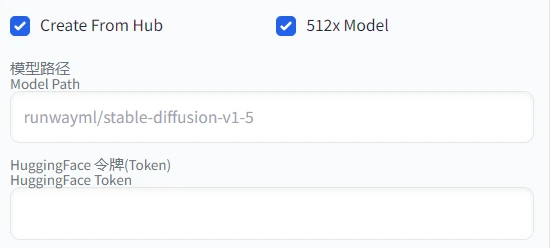
512XModel,应该是指的是你要训练的模型分辨率,应用后就是512X512,如果你想选择768X768就不要选中这个,如果你想训更高分辨率我只能祝你好运~
Extract EMA Weights/提取EMA权重,针对的是非修剪版本模型,可以把EMA权重提取并替换,应用后你的非修剪版本模型等同于修剪版本模型被训练
Unfreeze Model/不冻结模型,一个非常重要的选项,说明该插件可以冻结原模型参数(可能只是冻结了部分),代表着我们实际训练时更新的参数更少,花费的计算机资源也更好,适合低配玩家开启。但是这也代表着效果可能不如不冻结的情况。建议拥有高显存的玩家考虑选择。
选择模型选项卡
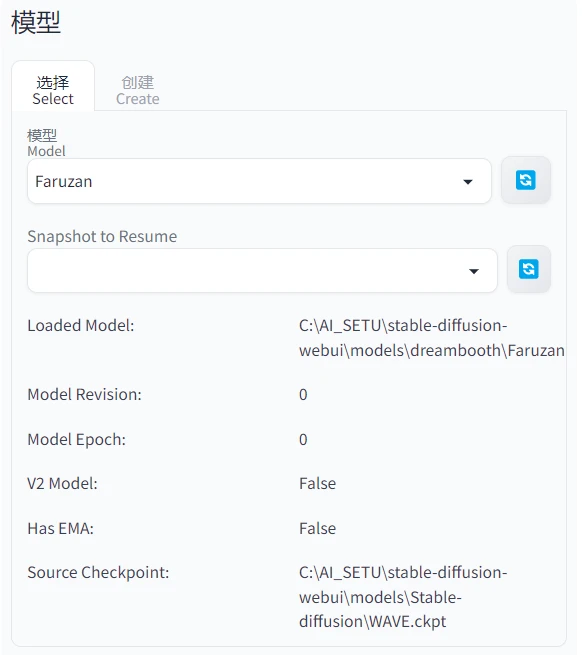
这里可以选择你想训练的模型,并可以选择从快照中恢复训练,不得不说不愧是是专业搞训练的涅~
还可以看模型的参数,比如训练了多少Epoch或者是是否含有EMA,和模型源。
模型/Model,选择你要训练的模型
Snapshot to Resume/从快照中恢复,大概就是把以前的模型捡起来继续练,非常重要的选项,可以让我们有更精细的训练方案。
Settings选项卡
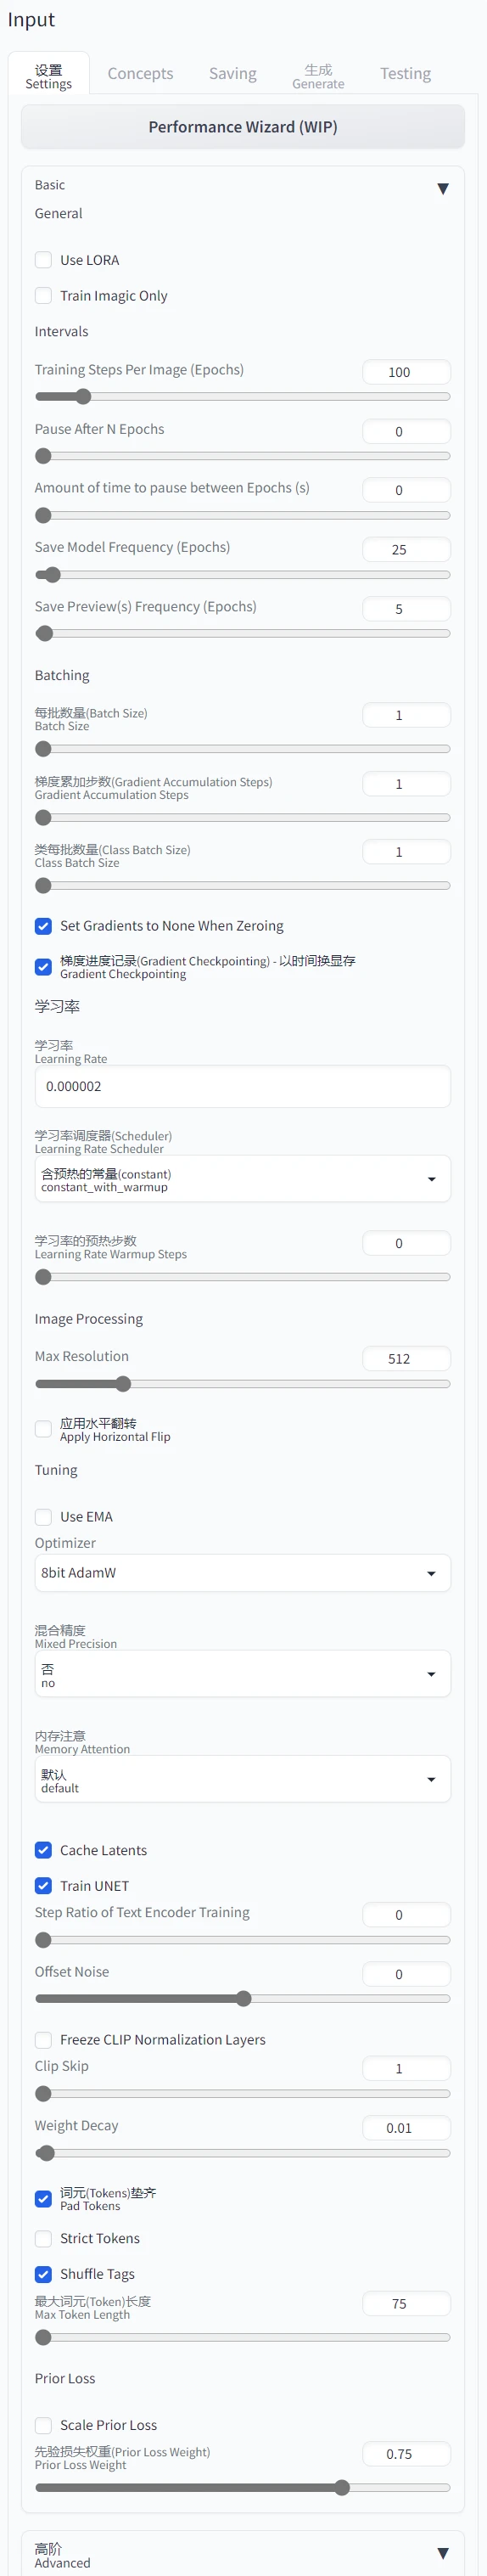
应该是最重要的选项卡了,在这里可以调整具体训练参数。
老规矩一项项讲
Performance Wizard (WIP),最重要选项,根据你显存自动调整训练参数,萌新按这个就对了
Use LORA/用LORA方式训练,使用LORA方式训练肯定是降低了训练消耗的,因为更新的参数量较少,也因此效果会有所下降,点击后会出现Use Lora Extended,LORA的拓展版应该是增加了更多的可训练参数,所以效果也许更好,但是与此同时需要的计算机资源会增加。
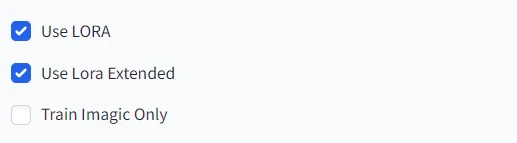
Train Imagic Only,应该是一种特殊的微调方式,根据介绍可以用一张图进行训练,应该涉及的参数量更少。
Training Steps Per Image (Epochs)/每张图训练多少次(训练多少epoch)
Pause After N Epochs/每N个epochs暂停,不是吧啊sir,真有人拿显卡当老婆,没拿显卡挖矿就好了,还想停下?
Amount of time to pause between Epochs (s)/每次暂停暂停多少秒
Save Model Frequency (Epochs)/每多少个Epochs暂停一次,如果SSD足够大就把这个值尽量减小,防止炸炉后重练,默认为25
Save Preview(s) Frequency (Epochs)/每多少个Epochs生成一张预览图,默认为5
Batch Size/每批数量,小显存建议一批1张,我之前用A100训练时是一批16张(从零开始ldm)
但是batch_size的大小会对最终模型稳定性有影响,batch_size越大,更新的loss越平稳,batch_size大于某个临界点后会导致模型泛化能力下降
Gradient Accumulation Steps/梯度累加步数,时间换空间的选项,增加就相当于增加了Batch Size(倍数级)
大多数情况下,采用梯度累加训练的模型效果,要比采用小batch_size训练的模型效果要好很多。
你要注意你的训练集数量应该需要被Gradient Accumulation Steps X Batch Size的积整除
Class Batch Size/类每批数量,类所在的图像的处理的每批数量
Set Gradients to None When Zeroing,一个优化显存占用的选项,建议开启
Gradient Checkpointing/梯度进度记录,降低显存占用
Learning Rate/学习率,建议按默认的来,容易过拟合就调低,事实上非常容易过拟合
如果你调高batch size之类的,可以调高学习率(倍数级),研究表明更大的学习率有利于提高泛化能力
Learning Rate Scheduler/学习率调度器,更自定义的学习率设置,建议按默认的来
Image Processing/图像处理,这里可以限制一下最大尺寸
Apply Horizontal Flip/引用水平翻转,常见的使训练集翻倍的手段
如果你训练人物或者是不具有对称性的物体,我强烈建议你不要选
Use EMA/使用EMA算法,虽然我觉得对于diffusion没啥用,详见第三篇,可以开,开后需要更多显存
Optimizer/优化器,你可以将其称为训练狮,在训练时应用各种优化,不同训练狮有不同的个性,这个还是比较难把控的,建议多磨合就知道它的脾气了,萌新保持默认
Mixed Precision/混合精度训练,B/FP16能开就开,大户人家无所谓,保持默认
Memory Attention/内存注意,保持模型
Cache Latents,消耗一定显存提升训练速度
Train UNET,貌似不开是锁定的文本编码器?
Step Ratio of Text Encoder Training,貌似会影响文本编码器的训练程度,置0能进一步降低显存占用
数值0.7会适合人物,0.2会适合风格
Offset Noise/噪声偏置,给给训练出来的模型更高的色彩自由度,这个选项是新加入的,可以选0.1,保守主义者选择低点,具体原理文末会介绍
Freeze CLIP Normalization Layers,这选项我不好说
Clip Skip,玄学选项,你想玄学就真人选1动漫选2
Weight Decay,我猜也是玄学选项
Max Token Length,这几个选项可以看第三篇,我觉得可以保持默认
Prior Loss/先验损失,DreamBooth特色,但是我觉得可以保持默认
高阶选项,不建议动。
Concepts选项卡
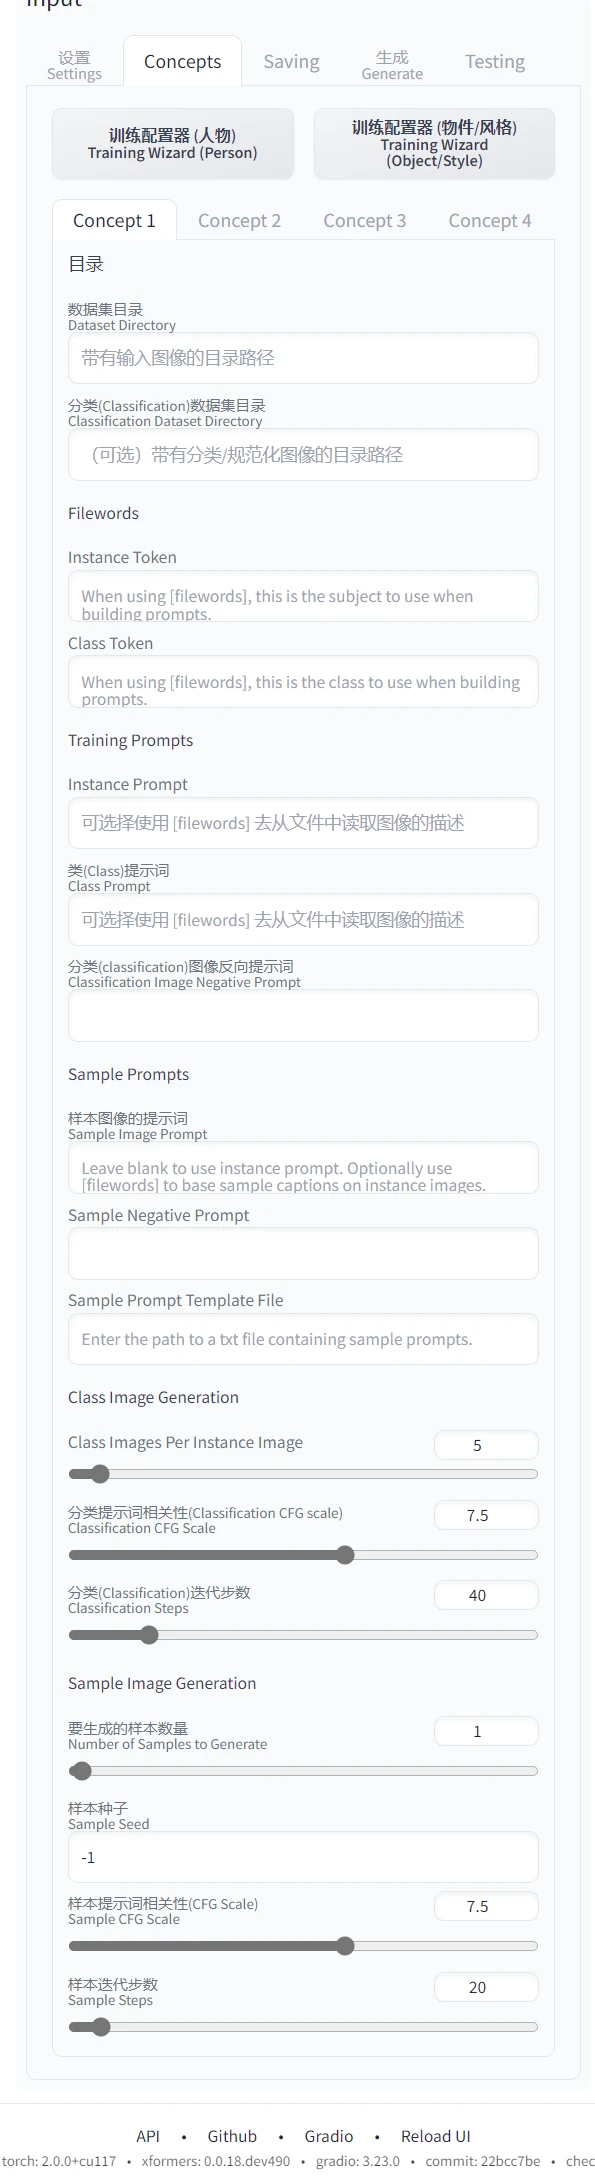
最影响效果的选项卡,在这里设置你想训练什么,训练时是否/如何使用class image,训练时的样本图像如何生成之类。
最上面的Wizard 可以快速帮你调整到最适合人物或画风的选项,按就对了
Concept1-4,一个概念就是一个concept,可以同时训练多种
数据集/classimg目录
Tokens,我看了一下官方介绍,如果下面的Traning Prompt使用[filewords]时,作用更像是个查找/替换脚本,把classimg对应的提示词的Istance Token(目标提示词)替换成 Class Token。
Traning Prompt,中文翻译已经很详细了
Sample Prompts,生成样本的设定
class image Generation,生成所在类图像的设定,数量设定为0则不适用类图像,非0时先会检测类图像目录是否含有目标类图像,没有就会使用模型自动生成对应数量的图像。
Saving选项卡
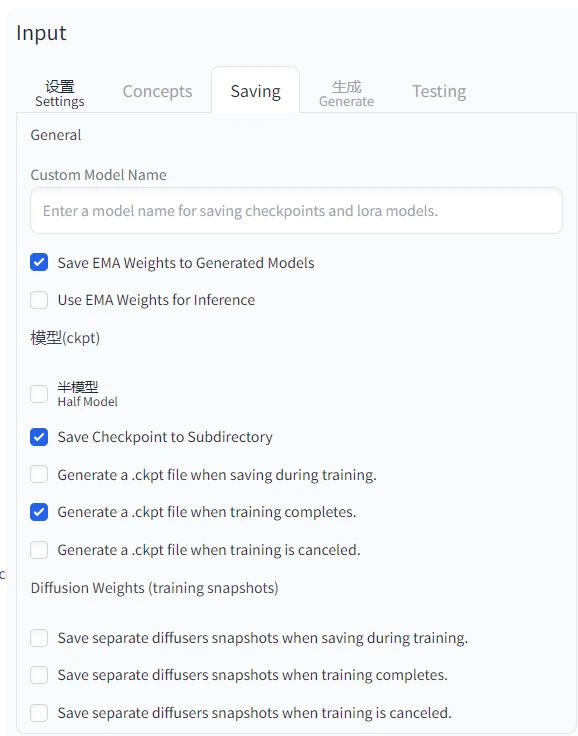
选择模型训练时的保存方式
这个直接看名字就能得出其含义
理论上当你SSD足够大,保存越频繁越方便。
Generate选项卡
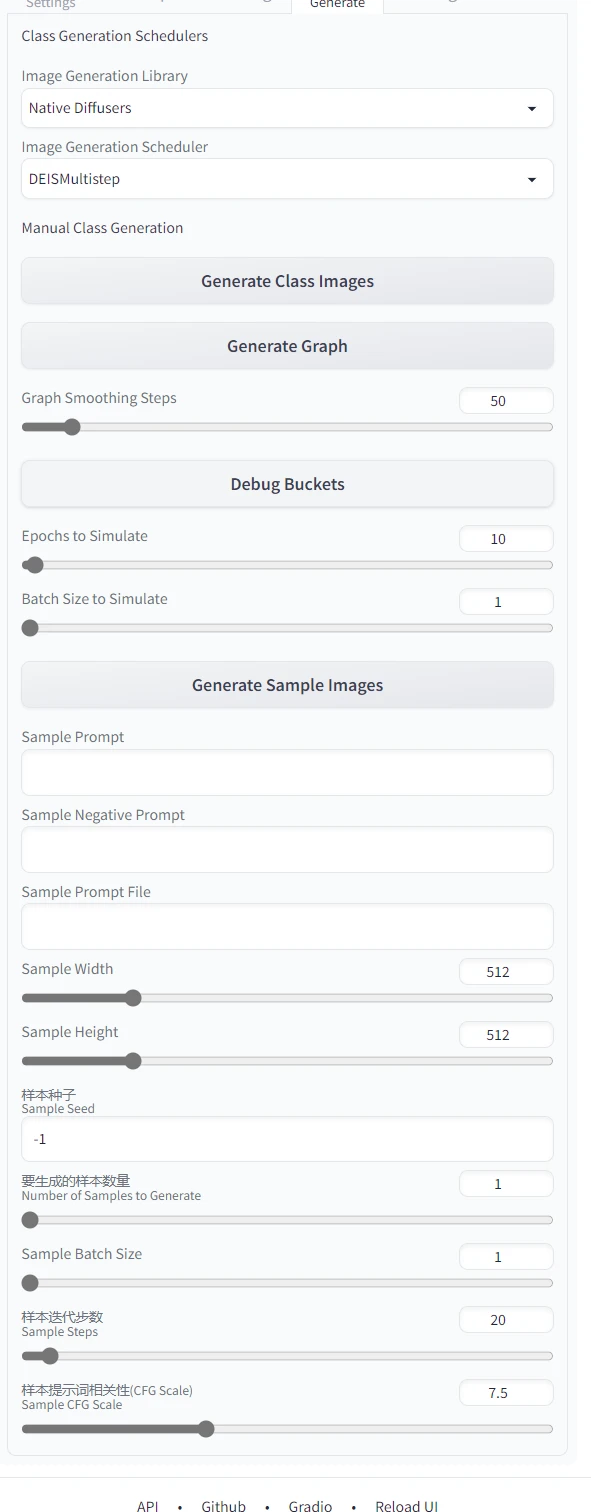
这里可以生成示例图像,或者生成类图像,可有可无的功能吧
Testing选项卡
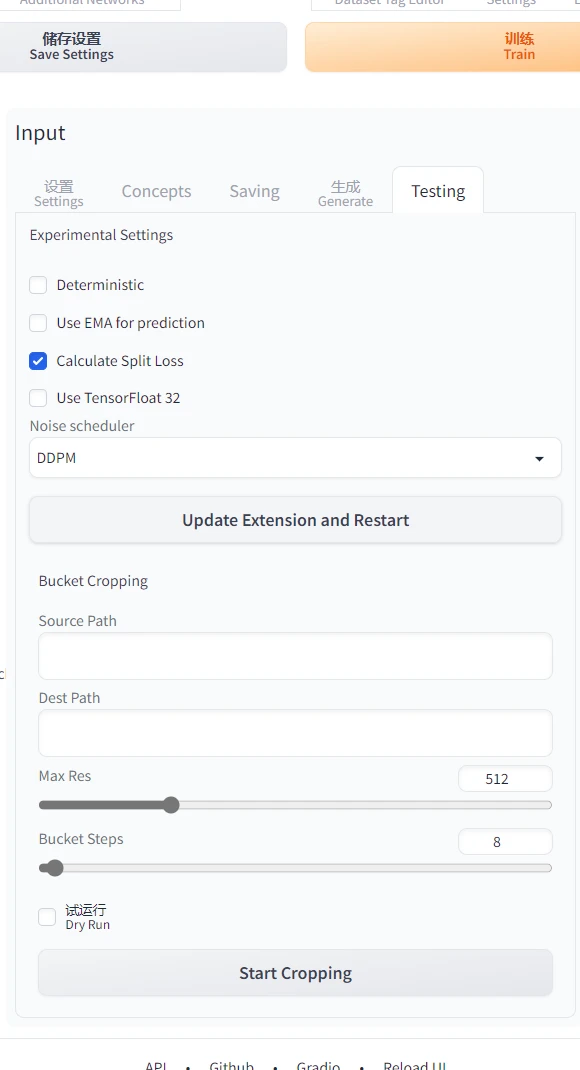
非常有意思的部分。
Deterministic/确定性,我猜会固定训练时的随机种子
Use EMA for prediction,训练预测时使用EMA
Calculate Split Loss/计算分割损失,目前笔者还不知道指的啥
Use TensorFloat 32,A100的用户可选,理论上加速训练
Noise scheduler,重点来了,我们知道stable diffusion已经有好几种加速采样的方法了,其实是出现了对扩散过程的不同的可解析的诠释,比如用到了电动力学的ODE之类,这里不详讲。那么训练方法同样可以应用改进或者更快的方式,事实也是如此,但是学术界目前始终喜欢DDPM或者DDIM,这也让我十分不解。
毕竟DDPM或者DDIM已经经过了大模型的验证
而新的方法总是伴有不确定性的,比如你前向加噪的过程缩短了,那么图片中的低频信息是否能保证有效破坏
Bucket Cropping,帮助数据集图片裁剪,一般不用这个
笔者的个人训练私货
笔者从早期的原始dreambooth到现在的各种技巧混合训练的方法
可以看出发展还是很快的,但是其核心始终没有变动
数据集始终是最重要的!!!
数据集始终是最重要的!!!
数据集始终是最重要的!!!
没有夸大,学习的各种选项都可以在后面微调,但是数据集直接决定了你微调的模型的上限。
新手通常会出现训练过拟合,
如果过拟合就降低学习率,提高模型保存频率和生成样本频率。
找到一个合适步数的范围,直接加载附近步数的模型然后使用较低学习率去寻找最好的拟合。
不同数据集不同训练方法不同参数,需要的学习率不一样,大胆尝试记录,很快就能找到适合自己的。
如果懒得找就直接按教程或者默认参数
但是只有高质量的数据集才能决定你最终的效果。
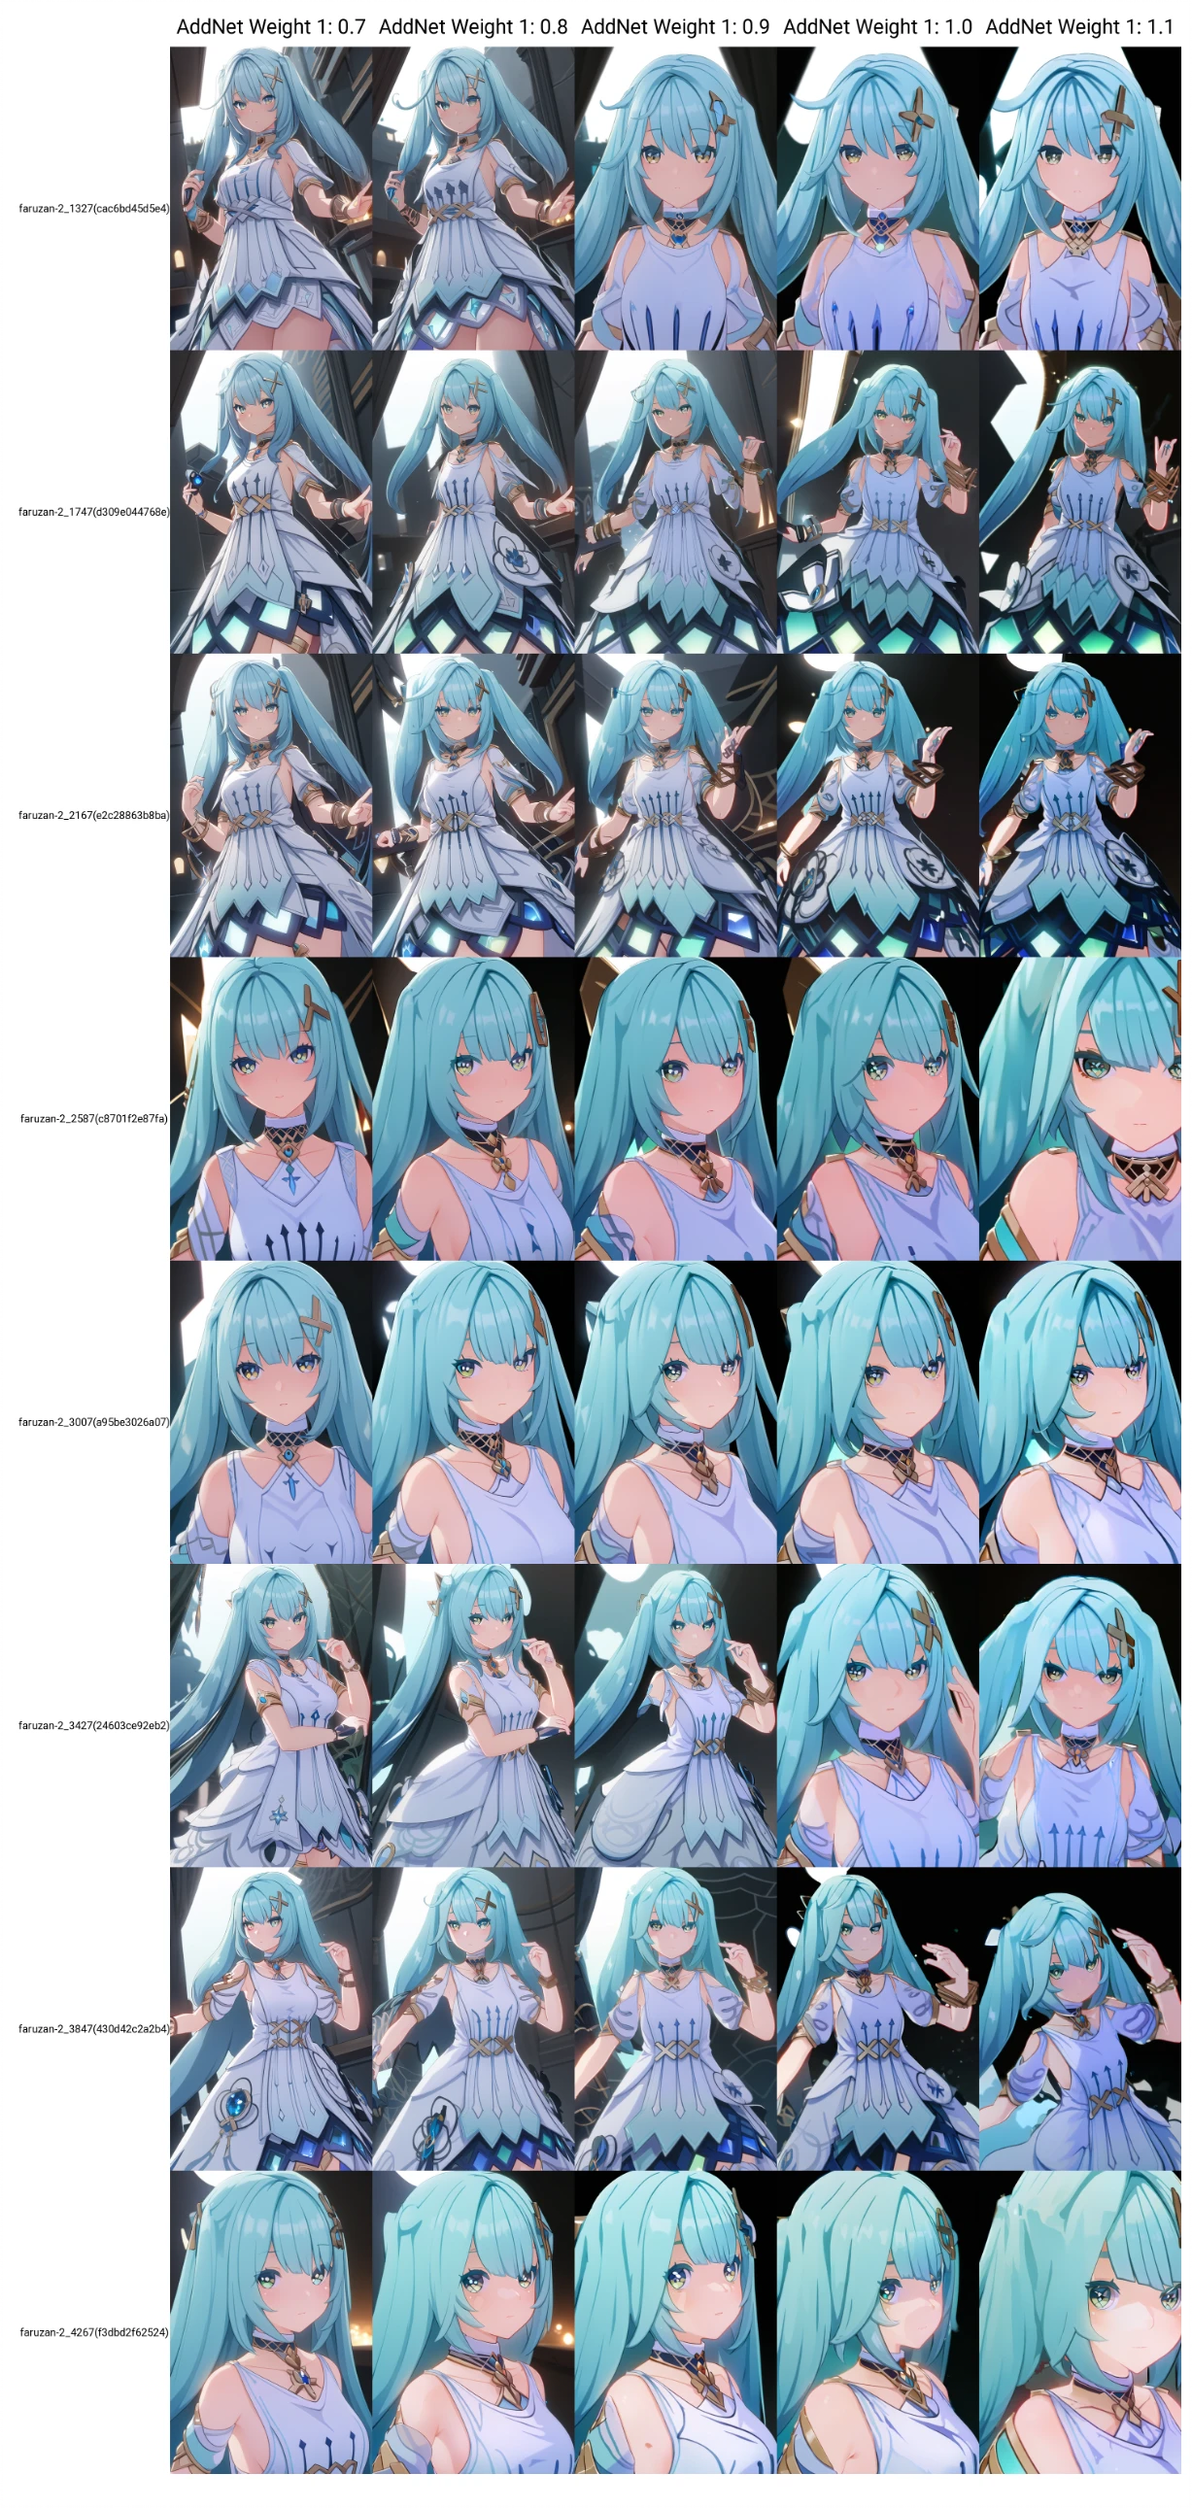
笔者昨晚随便跑的一个珐姐
以上的Faruzan的图片数据集来自原神游戏截图,不包含任何画师作品,不用作商业用途,不用于违法用途,只做教学,不包含色情或暴力要素,若让你感到不适或者侵犯到个人的合法权利请联系我删除!
对于萌新来说,练游戏角色成功率和数据集搜集速度是最高的,如果你有3D软件导入模型或者某些不可名状的游戏,那么搜集数据集对你来说应该不是很难。
sd-scripts(貌似github上星星最多)
日语仓库啊......苦手
提供了embedding、dreambooth、lora等的训练方法
但是我看了看其选项与上面的插件差不多,所以略过。
后篇-模型热门插件
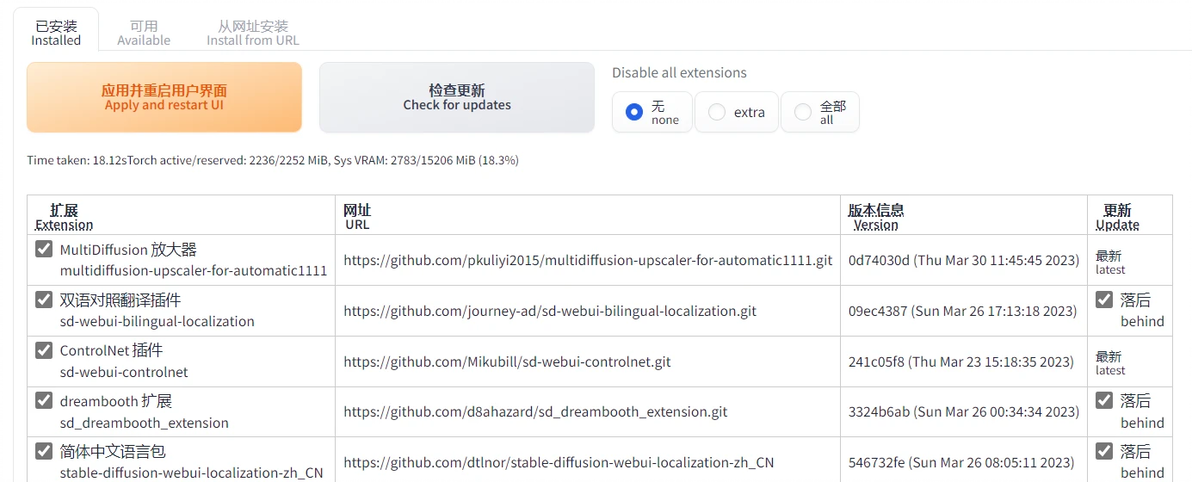
由于社区发展太快了,我建议每次使用前都检查更新,笔者2天不检查更新就有很多插件落后版本了。
multidiffusion
有中文说明的插件...、
功能包括:
Tiled Noise Inversion
Tiled VAE
Tiled Diffusion
看了一下,基本上算是目前最强的生成大型图片的插件
原理上没什么突破,官方已经给出了中文说明,我不再赘述
https://github.com/pkuliyi2015/multidiffusion-upscaler-for-automatic1111/blob/main/README_CN.md
常见疑惑
关于LoRA与DreamBooth
LoRA的名称更侧重于训练时参数利用低秩矩阵这种方式。
而DreamBooth的核心是使用一个经过设计的损失函数,通过训练所在类的图片,达到小数据集也能产生良好的效果的场景。
具体的实现方式因脚本而异,俩者结合也未尝不可。
关于正则化图像
貌似sd-scripts仓库是训练时使用正则化图像的出处,说实话这个正则化图像的命名是我不太能理解作者意图的,如果是表示为引入先验知识,那么diffusers库的“CLASS_DIR”或者“Classification”是珠玉在前(不懂日语,也许日语把class翻译成正則)。
但是sd-scripts中的dreambooth训练时正则化图像和我们上面所说的类的图像(Class_image)作用是相同的,所以作者也许是想表达这个意思。
那么训练dreambooth使用的类的图像最好是模型生成的图像,因为dreambooth原意图是为了保留模型原有的先验知识,比如我想要训练“1girl,red eyes”,那么我们的类图片就要选用”1girl“,这样就能一定程度上避免”1 girl“被我们的训练污染。
比如1 girl只能生成1girl,red eyes的情况,多样性大大降低。
显然作者在训练的正则化图像文件处没有说明这一点(不会日语,机翻看的大概,还没看代码),然后导致了一些up主的误解或者是中国社区一些同学的误解。
如果正则化图像指的是dreambooth的类的图像概念(Class_image)且使用了同一个损失函数(prior preservation loss),当在正则化图像使用真实图片或不是模型生成的图片,其实是相当于使用图片调整了整个模型的权重,有没有起到保留先验知识的作用不好说,但肯定是更改了原有模型的权重。
其效果大概相当于俩种数据集都练了一遍,虽然说深度学习的训练很玄学,但这也太玄了,笔者不建议这样做
那么关于正则化图像的处理方法就很自然地
如果选择的是所在类的图像,可以直接以类的名称作为图像标签训练,也就是说我们只是尽量不想破坏(污染)所在类的图像的名称对应的元素。
如果是选择的所在类的图像,但是其中的图像各自之间也是有较大变化的,我们想要守护更多先验知识,那么就给正则化图像的每个图片也打上tag(具体可以参照前篇的处理,只是不需要设计触发词),这样我们就做到了尽量不破坏原有的模型效果。
如果使用的不是所在类的图像而是非模型生成的图像或是其他类的图像,虽然我觉得这种做法非常灾难,但是一些做法也能达到部分目的。首先就是要详尽地打tag,这样就是多个tag分担了你行为带来的影响,且要避免你选择的正则化图像影响到了你真实想要训练的图像的触发词,千万千万不要把触发词往正则化图像打(假设你的正则化图像和训练集图像是不相关的东西),但最后这样的操作也就相当于训练了两遍模型。
关于触发词
说实话我没在任何训练仓库里没有找到我想要的Trigger Words(触发词?),我怀疑是训练狮里生造的词,请问训练狮们有相关论文吗?
触发词我猜是DreamBooth的“identifier”(标识)概念的衍化,前面原理我们讲到,DreamBooth为在小数据集上训练,为新概念设置了一个罕见词,那这个罕见词就是“identifier”。
原diffusiers库喜欢sks这个词,足够罕见能作为identifier
训练时采用sks dog作为训练集的提示词,用dog作为所在类的训练集的提示词
训练好了后,sks dog就能很好得展现我们的训练效果,而dog一词却不受影响
所以为什么这个“identifier”能发挥作用呢,你是不是想到了我们前面的文本反转的原理,DreamBooth和文本反转一样是训练了文本嵌入层(默认),其原理是类似的,下面我们就来分析sks dog在文本嵌入层发生了什么。
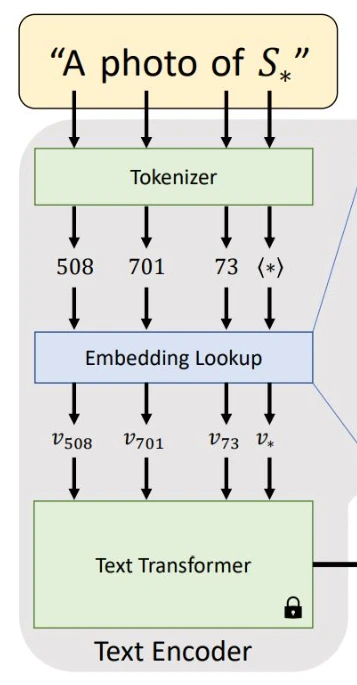
我们目标训练集的提示词sks dog首先来到了分词器,由于sks是一个罕见词,分词器将其分成了可以理解的分词,为了方便理解我们假设只分成了一个分词,然后分配了token,然后通过字典找到了对应的词向量 ,而我们的dog由于分词器很熟悉了,轻易就分配了token并找到了对应词向量
然后看看我们做了什么,我们开始了训练,在文本嵌入层我们的
和
通过我们的目标训练集的图片影响,对应的词向量改变。
然后我们的类的训练集的提示词dog来到了分词器,和上面的dog一样分到了词向量,然后
在训练时受到了我们类的训练集的图片的影响,对应词向量改变。
这样不断地反复,最终我们的和
掌握了我们目标训练集的特征,而
依旧是掌握着类的图片的特征,受到目标训练集的影响较小。
那么我们在生成时只要包含了和
所对应的提示词,不就能很好地把我们训练集特征展现吗
以上的例子只是发生在文本嵌入层的一个不准确的例子,旨在帮助理解,程序正义勿喷
那么此时V_x所对应的提示词,我们这个例子里是sks仿佛就有了“identifier”(标识)的作用,有sks就有目标训练集的特征,而没有就基本不会影响原模型的多样性,拥有了良好的特性。
从这里也其实希望能增强你dreambooth中使用类的图片的重要性的理解
这个“identifier”(标识)一定程度上也可以理解为触发器,生造一个所谓的触发词(Trigger Words),其实也不算离谱,意思到了的。
那么我们如何做出优秀的触发词其实就很容易理解了
首先一定要触发词一定要浓缩简短,其次训练时尽量用其他模型已知的prompt来分走画面中你的触发词不想表达的部分,然后训练集的共同特征要尽量少(最好共同特征少到只有你触发词达到的效果的本身)。
这样,我们的触发词就达成了“一触即发”的效果。
关于offsetnoise
基础知识
非常有趣的东西,让我想起以前做DCT(离散余弦变换)压缩图像,突然就想详细讲讲了,诶嘿~
不如从梯度讲起吧,
梯度是个向量(大学),其方向是函数某点变化最快的反向,其模是函数的函数某点的最大变化率,在单变量的实值函数中表现为导数(高中),在线性函数中表现为斜率(初中)。
无法理解建议就降维打击
图像梯度,如果我们把图像看出二维离散函数,图像梯度其实就是对这个二维离散函数求导。
根据过去的视觉研究实验表明人类视觉识别物体时对边缘更敏感,比如人眼可以通过物体边缘或者更抽象的边缘(简笔画)来识别物体,即使该物体失去了色块或纹理。
在图像梯度中,·值越高的的部分越接近人类视觉中所观察的边缘,换句话说梯度高,变化率越快的地方往往就是图像边缘的地方。而值越低的地方则就代表变化率低,通常表现为图像里的大色块。通常而言我们可以直接把梯度高的地方叫做图像高频信息,梯度低的地方叫做低频信息。
原理
CROSSLABS将图像信息按照不同范围频率进行分解如下图,你可以理解为右边的图叠加起来就是左边的图,且越往右图片信息越高频
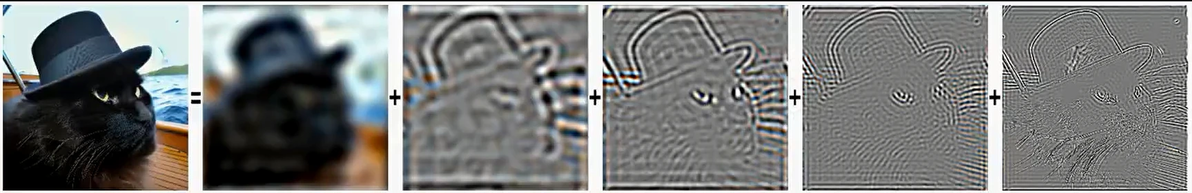
其实这里我们也可以看出,低频图片信息往往是色块或者整体的架构,比如分解后的第一张,而高频图片信息往往是体现了轮廓,比如分解后的第三张。
如果我们对图片不断加入高斯噪声会怎么样?
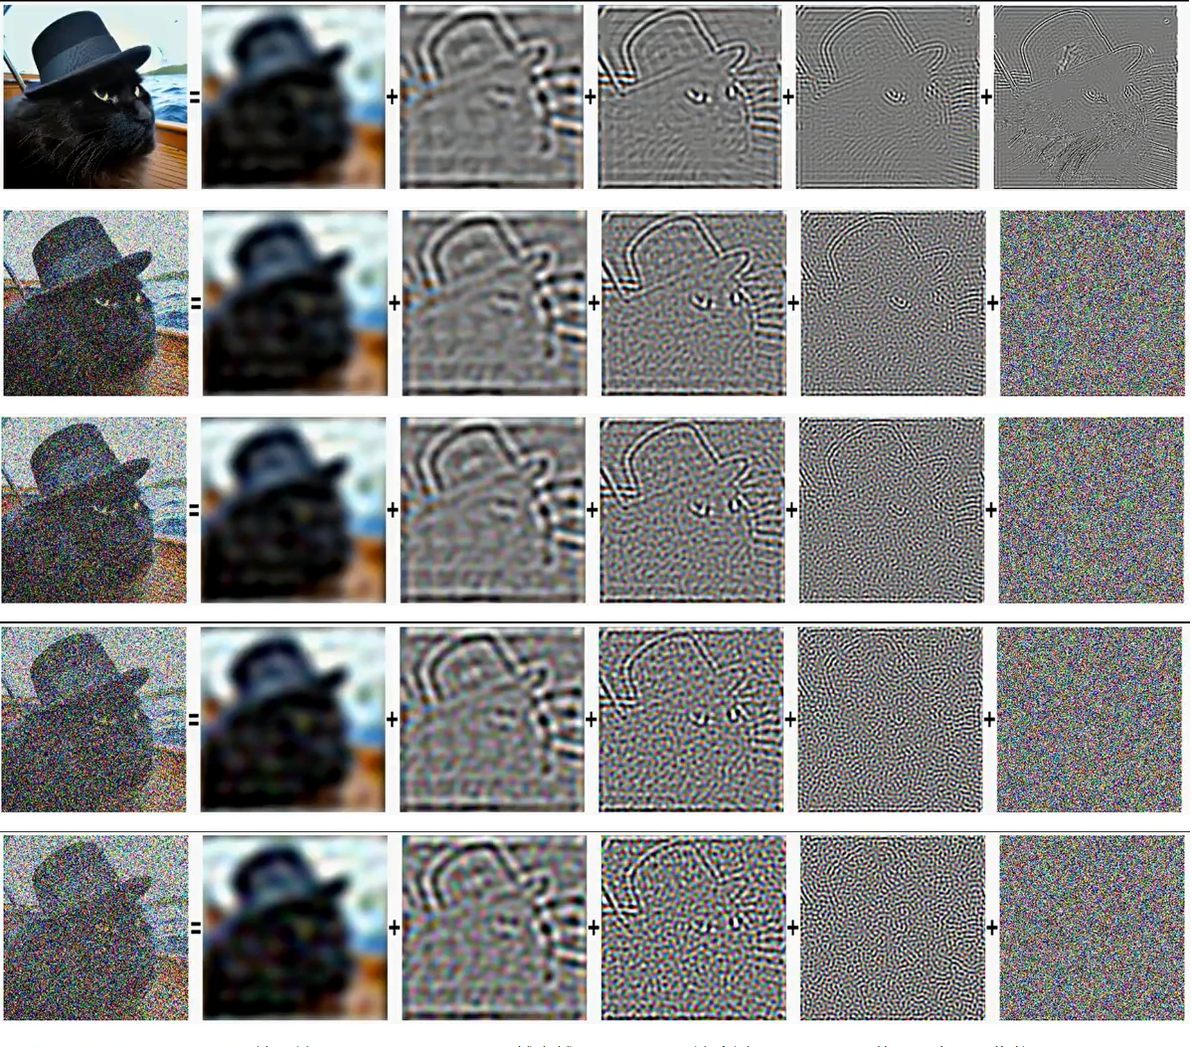
可以看到随着我们的原图(左边的这张),随着噪声的加入越来越模糊,我们将这个过程分解到不同范围频率的图像信息上,可看到最右边的高频信息的图像几乎是第一次添加就被破坏了,越靠近左边破坏地越慢,最左变的低频信息图像几乎没什么变化。
我们知道我们的稳定扩散的模型的训练过程就是前向不断加噪声的过程,反向则是预测并减去噪声,也就是说我们前向过程最后破坏的东西,在反向过程中是最先被生成的,前向过程中变化很弱的东西,反向过程变化也很弱。对应到我们实际生成图像的过程中就是先生成的色块随着步数变化基本不变,而轮廓或者说细节却变化较大。
实际使用的过程中如果你们开了实时预览或者利用过色块修复图像应该已经感受到了吧。
这也是为什么我们用同样的种子往往会产生彼此构图相关的图像,因为种子是决定初始信息,而构图(或者说图像的整体的近似)是低频信息。
这种现象当然不止是轮廓或色块或细节受到影响,上面的只是例子,扩散模型的正反向过程实际影响了哪些信息,哪些对我们有用,哪些无关紧要都是不好说的。
但是CROSSLABS注意到,如果你将stable diffusion生成出来的图进行一个像素值平均,那么你会发现大部分图都接近0.5(如果纯白图为1,纯黑图为0)。 这意味着stable diffusion生成出来的图在色彩上仿佛有了无形的约束,无法进行更真实或更具有想象力的创作。
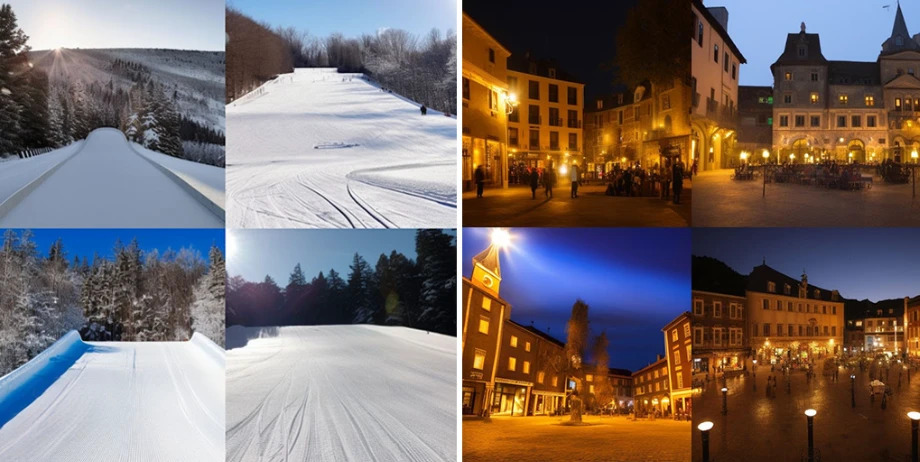
CROSSLABS用的示例
通过实验发现如果我们对一个图像进行不断地加噪,你会发现,图片的色彩均值变化波动非常小,可以理解为我们图像的低频信息。
导致的后果就是,我们实际生成时,最初的种子生成的噪声决定了图像的色彩均值,然后我们每次降噪时我们的色彩均值变化波动非常小(就像我们加噪时的那样)。
仿佛我们给模型加上了一个无形的规定:色彩均值变化率不要大!
这就导致如果我们进行低步数的采样过程,我们的色彩均值和种子最初决定的差不多,表现在stable diffusion的某些模型上就是生成出来的图色彩均值和0.5比较近。
这也解释了如果你进行一个步数非常长的采样过程,往往能得到更极端的图像。
那么如何解决这一点呢?大体是思路在训练时加快低频信息的破坏过程。
而CROSSLABS选择了offsetnoise,具体就是在给图片添加噪声的过程中,我们对于每个像素点额外在从高斯分布中采样一个数值并乘以某个系数然后加回对应像素点,然后自然就对图像的色彩均值造成了破坏。
具体到代码上
noise = torch.randn_like(latents)变成了
noise = torch.randn_like(latents) + 0.1 * torch.randn(latents.shape[0], latents.shape[1], 1, 1)
nise = torch.randn_like(latents.shape[1],latents.shape[0],2,)CROSSLABS将这个系数定为了0.1,是因为0.1在他们的实验中表现效果良好,在之后微调模型时使用了这个策略,然后发现stable diffusion能生成更亮或者更暗的图像了。
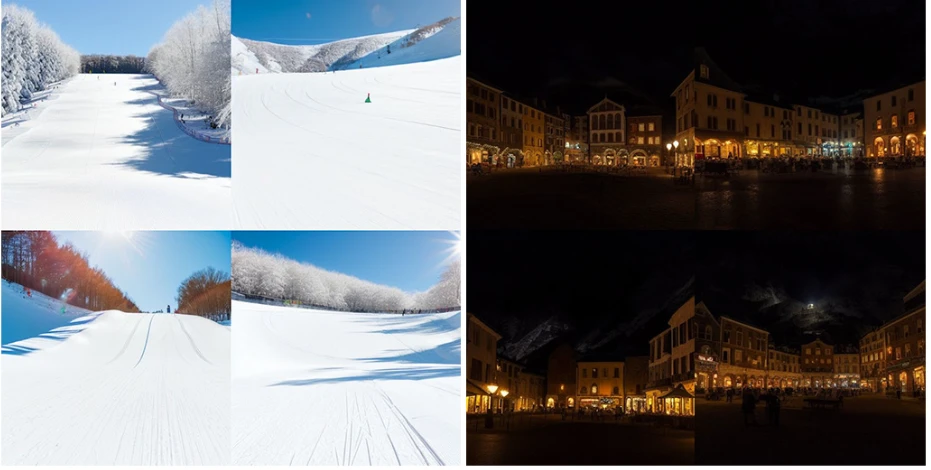
CROSSLABS用的示例,可以看出效果还是非常明显
总结
offset noise的出现能让我们训练出来的模型拥有更自由的对比度,光照和色彩,非常推荐训练时采用
CROSSLABS将其系数设为0.1,是因为他们觉得挺好,训练师根据自己的目标决定
由于增加了一个添加噪声步骤,开启此项对训练性能有一定影响
关于分层融合
大概看了一下,对模型而言将U-Net各层权重按比例融合,
对于LoRA而言也是差不多,主要是作用在U-Net的17个主块对应的LoRA权重按比例融合。
对于大模型而言,我们训练出的模型可以认为已经“掌握”了一些规律性上的东西,可能会被分散在U-Net的各模块上。
低纬度的噪声可能是高纬度的规律分布
所以调整模型组件的任何地方都有可能产生不同效果,如果这些效果能被总结出规律就是有效。
有点人类探求物理学的意思了,物理学存在吗?
......

这就是第四篇的全部内容了,内容若有缺漏和错误欢迎交流指正~
浅谈stable diffusion目前可讲内容已经快结束了,再深入下去就只能讲代码和逻辑了,但这确实没啥好讲的。
所以之后大概会修订一下第一二篇,因为最初是按照我自己的学习节奏写的,不适合大部分人看。
第五篇如果有的话就讲讲扩散模型在视频上的应用,或者如何从电动力学到diffusion(当初学电动力学没好好学,复习一下),或者ComfyUI,如果有时间的话......
