


(多图预警)
做为这个系列的开头(说是系列,其实每一篇的内容应该是相对独立的,毕竟理想的引擎应该是模块化的,我也打算一个一个模块地编写),我想先介绍一下一个实用的东西——形态学抗锯齿。其实这个算法我之前就已经实现了,所以严格说来算不上是一个游戏引擎编写的“进度”,不过因为它从原理到算法上都有许多令人惊叹的部分,所以我想仔细地介绍它,顺便从介绍一下不包括流式扩展部分的代码。
实时渲染中最为出名的莫过于MSAA(多重采样抗锯齿)算法了,其原理是通过点的深度信息,检测出物体的边缘,然后在边缘进行超采样,从而实现几何形状轮廓的抗锯齿,这些过程穿插在渲染的各个阶段。我的引擎也实现了这个算法,只不过众所周知,缺乏GPU的支持,这个算法在CPU下性能很差,而我的引擎因为没用其他的库,自然是不支持GPU扩展的。就在纠结于抗锯齿的时候,我了解到MLAA(形态学抗锯齿)这个算法,它是Intel®开发的仅依赖CPU的算法(https://software.intel.com/zh-cn/articles/morphological-antialiasing-mlaa-sample),随后被Jimenez改进(http://www.iryoku.com/mlaa/)。我一眼就被这个算法吸引,因为它可以算是一种截然不同的抗锯齿方式,与我学习抗锯齿之前assume的抗锯齿原理不谋而合。MLAA不同之处在于,它只需要在渲染的最后阶段(对于一般的正向渲染来说)处理等同于屏幕分辨率数目的像素,省去了MSAA大量冗余的计算。
行了不废话了,接下来进入正题。
MLAA流程
MLAA分为连续的三步过程:寻找物体边缘,重新矢量化,颜色混合。其实也非常好懂,众所周知锯齿产生的原因是有限分辨率的屏幕必然无法表示出无限分辨率的理想物体,如下图的直线穿过了两个像素,那么不管将像素着色成白色还是红色,都会形成不连续的轮廓,即锯齿。然而,我们其实也有个简单的办法改善,这也是所有抗锯齿方法的根本原理。通俗地说,就是假设屏幕上有无穷多的像素,再把它们分成有限多的格子,这些格子统一着色为格子内无限密的“像素”的颜色平均值,那么就可以用这些有限的格子粗略表示出无限的分辨率了。下图中,因为只有两种颜色,将红色和白色按占格子的面积(S2:S1)的比例混合,就是左边格子的混合颜色。
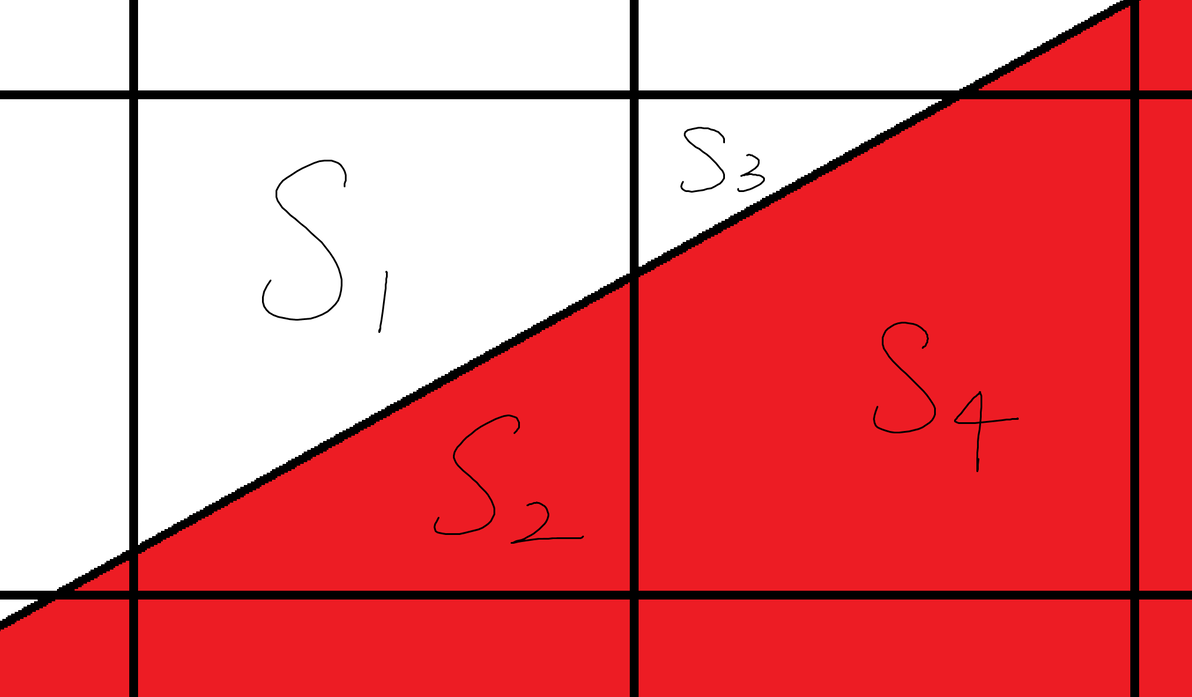
像素网格中的物体边缘轮廓线
不过,实际状况更加复杂,不可能只有两种颜色,于是我们显然做不到完美的抗锯齿——不可能得到无穷多个点的颜色平均值,因此传统的抗锯齿通过采样格子中的某几个点计算平均值来代表格子的颜色,从源头上减少锯齿;而MLAA另辟蹊径,它通过产生的锯齿来倒推出原本的直线,对其像素重新着色。
第一步就是找到这些锯齿(下面这些图片引用自Jimenez的PPT):具体方法是计算每个像素和下、右相邻像素的色差,如果超过阈值,则将像素标记成水平锯齿或垂直锯齿。然后寻找同一行的连续的标记为水平锯齿的像素,和同一列的连续的标记为垂直锯齿的像素,即是找到的锯齿。下图中的主要的锯齿是标记了水平锯齿的连续的三个像素(1,2),(2,2),(3,2),当然还有四个长度为1的锯齿。
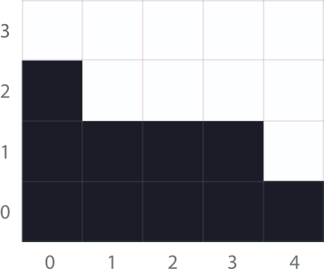
锯齿
第二步是倒推出原来的直线,称为重新矢量化。这一步并不能推出真正的原直线,只能大致地推断。具体方法是找到水平锯齿两端的单个垂直锯齿像素,或者是垂直锯齿两端的单个水平锯齿像素,称为次级锯齿边。下图中,像素(0,2),(3,1)是找到的垂直锯齿像素。注意,我们只考虑像素的右边界和下边界,所以是(3,1)而不是(4,1)。
连接它们对应边的中点,得到的就是推断出的直线。
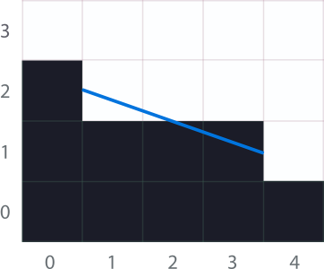
重新矢量化
根据找到的次级边的位置,可以把锯齿分成U型(次级边同向)、Z型(次级边反向)、L型(一侧没有次级边)、I型(两侧没有次级边)。其中,最后一种不进行重新矢量化。
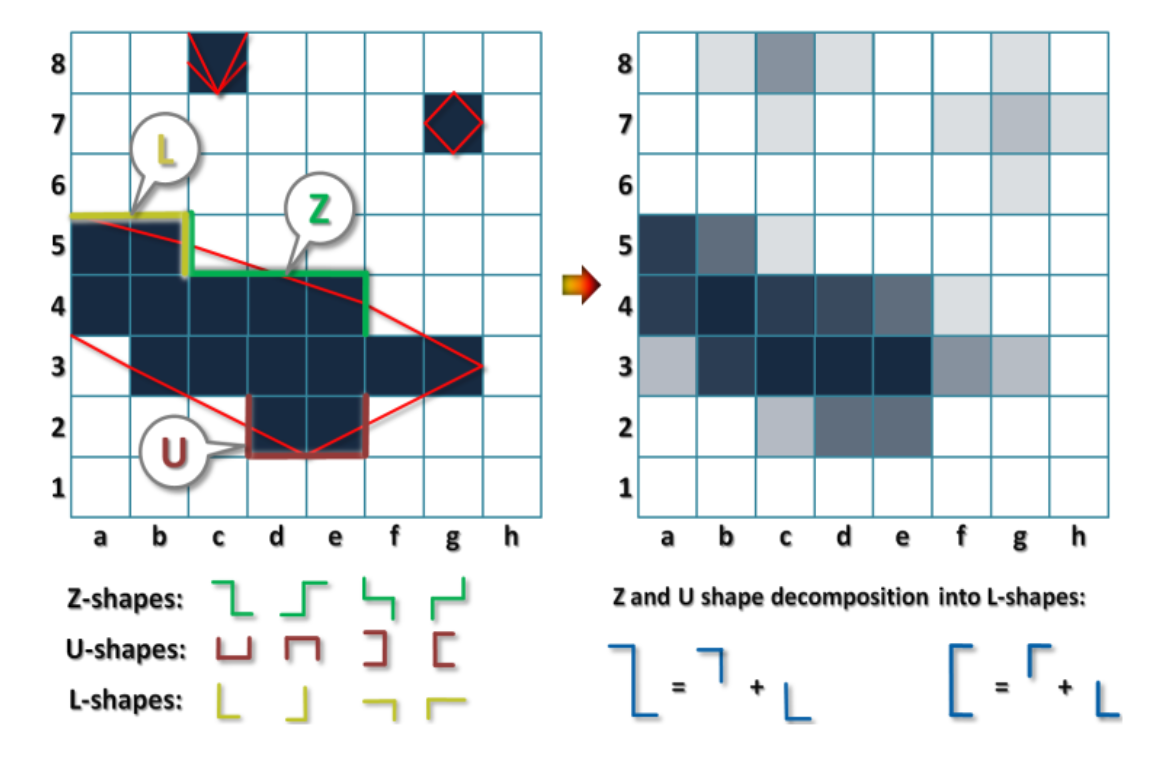
图源:Intel®
第三步进行颜色混合,这一次因为只需要考虑锯齿边两侧的两种颜色,所以直接按面积比例混合即可,见上图。
代码实现
接下来是C++实现部分,并不详细解释具体代码,有兴趣也可以参考开头两个网址里的源码。这里大致介绍一下思路。首先是类和方法列表:
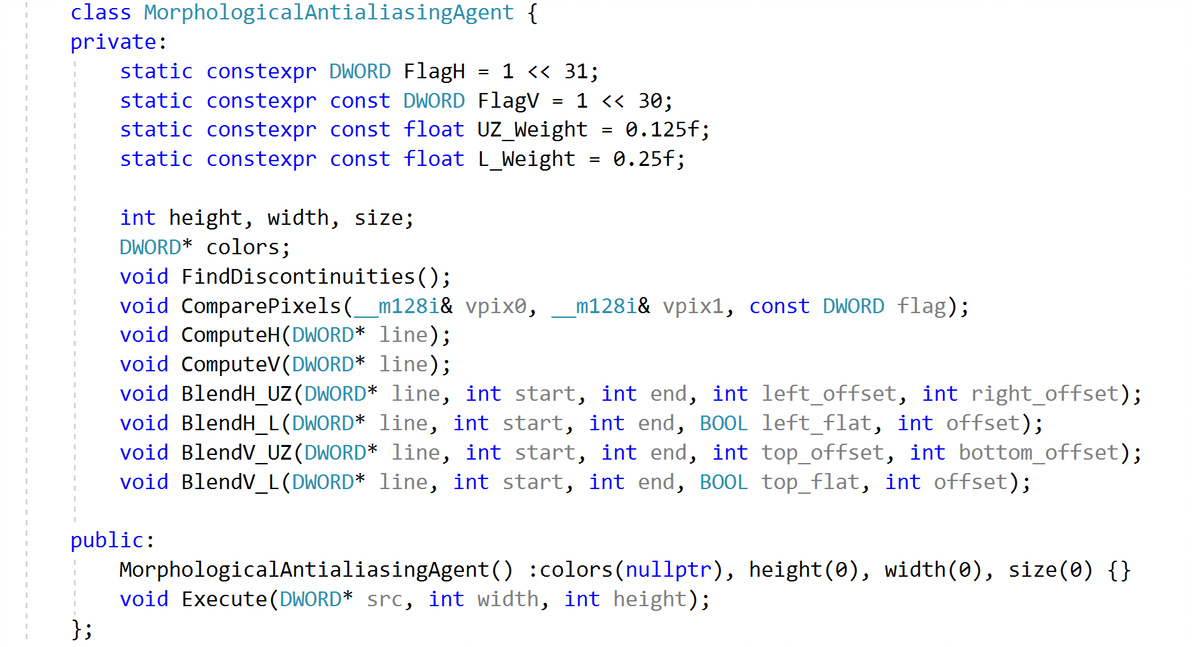
Agent类
公有方法是Execute函数,接受参数是待处理图片的像素,图片的宽度和高度,这里FindDiscontinuities函数负责寻找锯齿,在像素的最高8位作标记。因为这里的图片是24位颜色,因此32位的DWORD类型最高的8位是不存储信息的,故设定它的最高位和次高位分别存储水平锯齿标记和垂直锯齿标记(0表示无标记,1表示有标记),这也是静态常量FlagH和FlagV的由来。FindDiscontinuities函数的实现参照了Intel®的示例写法,由于使用SSE2流式扩展指令集的原因,代码可读性非常低……考虑到大多数人不会关心这里的细节我就不介绍了,但是具体原理是非常简单的逐像素色差判断,大于阈值则打上标记。然后,我将第二步和第三步放在一起进行,在ComputeH和ComputeV中实现,分别处理行和列。
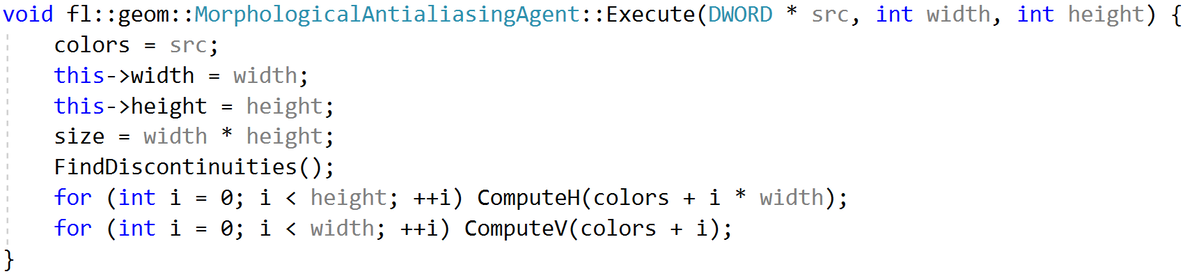
Execute函数
这里以ComputeH为例,接受的参数是一行的像素,前半部分就是寻找连续的水平锯齿标记的像素,区间记录为[start, end)。然后分别检查左右两侧的次级边,用secondary_offset记录次级边的类型:0(在当前行)、1(在当前行的下一行)、-1(不存在)。顺便提一下,这里有个不好的习惯就是喜欢把 if(x!=-1) 的条件判断写成 if(~x),这样子可读性不好。
然后把锯齿边的参数包括起点、终点和次级边形状传给BlendH函数,让它负责第三步的颜色混合。这里因为L形状和UZ形状差别很大所以分开处理。
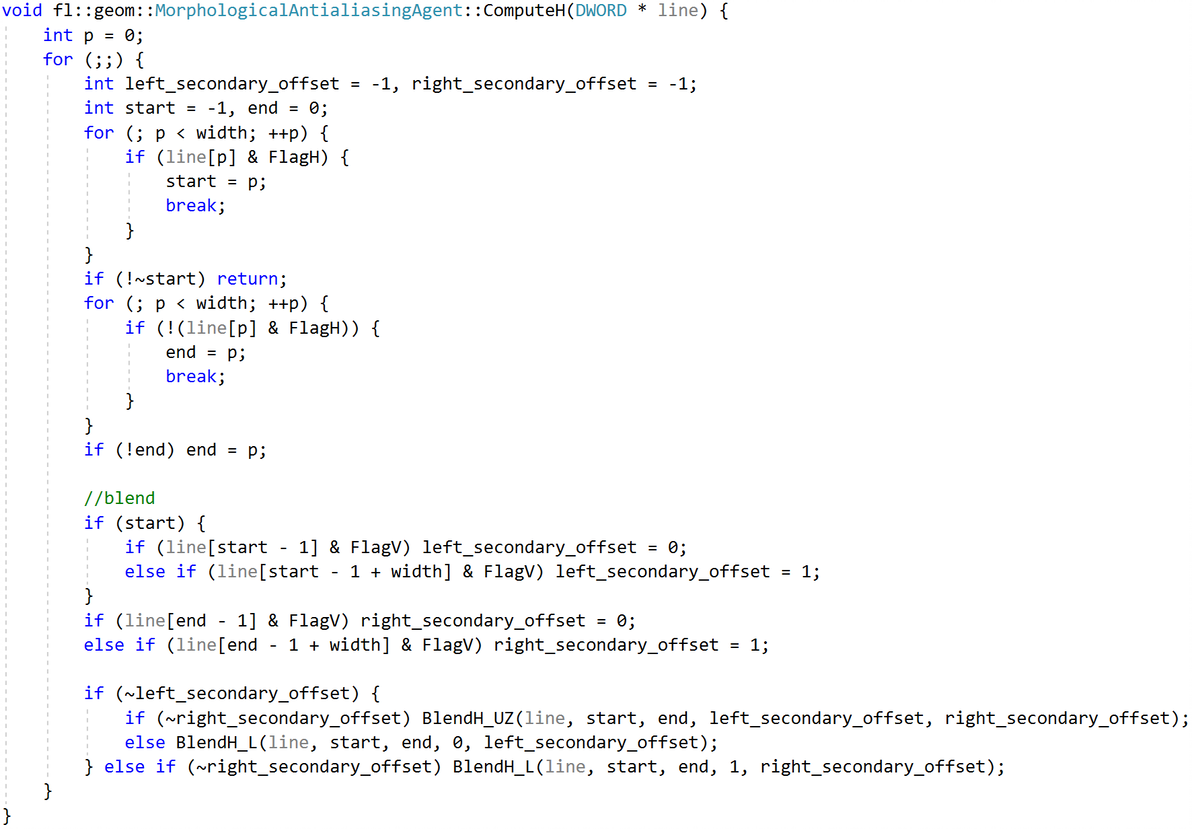
ComputeH函数
最后是以BlendH_UZ函数作为示例,它负责U或Z形状的水平锯齿边的颜色混合。比较讨厌的是根据锯齿长度的奇偶性,还需要分开处理(L形状则不需要),总之这里的代码看上去复杂难读,其实都是源于繁琐的面积计算,又不能损失太多性能,我就写出了不堪入目的丑陋代码……总之也没有什么技术难度,大抵是需要耐心和细心,正确地算出面积比例并把公式翻译成代码。MIX32函数负责混合颜色,接受参数是待修改的像素,外来像素权重和外来像素。其结果是:待修改像素=外来像素权重*外来像素颜色+(1-外来像素权重)*待修改像素。这个函数也使用了流式扩展,因此不做介绍,其原理也是非常的simple,只要把RGB通道分离,乘以权重混合,再重新组成RGB格式的颜色就可以了。
(屏幕小的话代码就不用细看了,反正写得又臭又长,而原理其实又很简单)
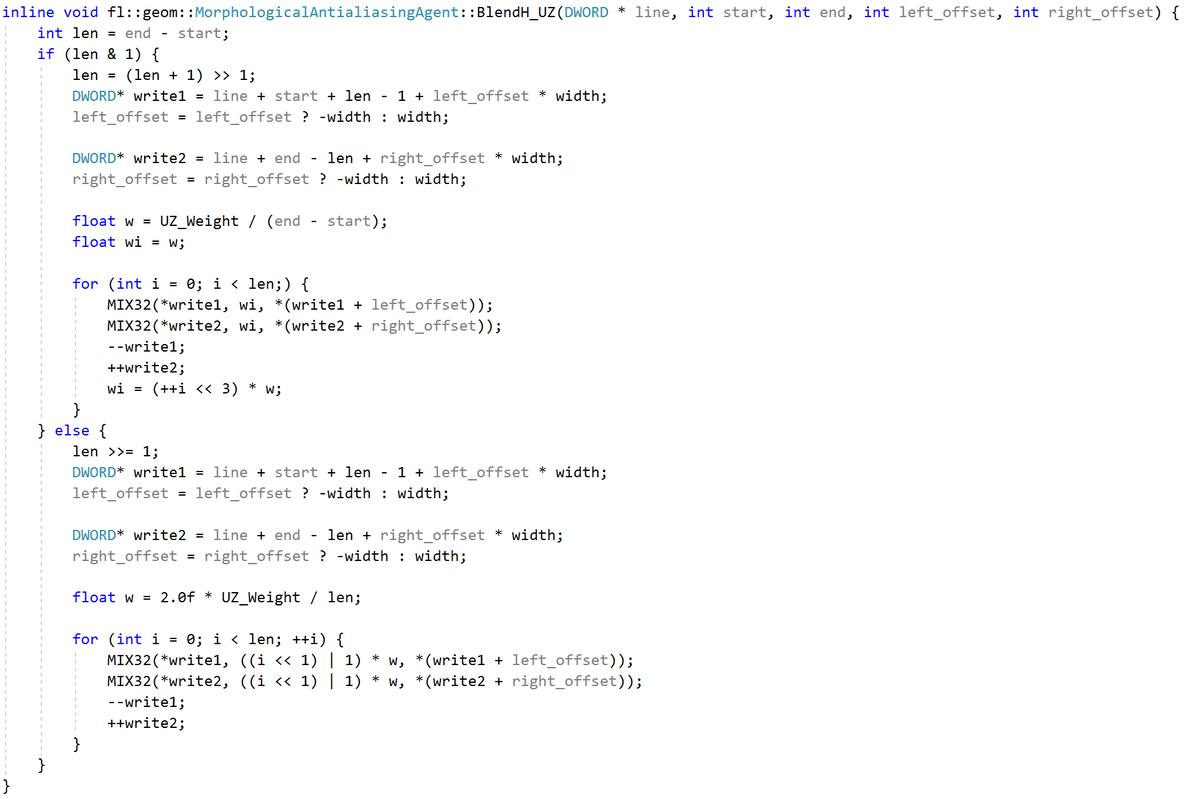
BlendH_UZ函数
总结
尽管限于篇幅和流式扩展算不上普及的技术这一点,没能够揭示算法实现方面的trick,但是算法本身的思想,尤其是重新矢量化的一步,还是非常有新意的。当然,“新”是对我这个图形学小白来说,毕竟MLAA算法本身已经过时,被它的改进版本SMAA淘汰了。但这也是我编写3D模块以来感觉最有意思的一个点,学习的过程中顺便学了一波流式扩展,颇具意义。
另外,不难发觉,这个算法不仅仅可以应用于实时渲染,也可以处理静态的平面图像,可以说是非常优秀了。至少,我的3D引擎大概率是靠着这个抗锯齿了,毕竟CPU带不动SSAA或者MSAA;而且,不像MSAA不兼容延迟渲染,MLAA即使在我未来加入延迟渲染模式也能发挥作用,又是基于CPU的,总感觉是天作之合呢……
最后,不定期更新(文理学院疯人院系课业顶不住了),虽然很忙,不过也欢迎私信交流……
P.S. 修仙写的,若有错别字见谅……另外,就不再放抗锯齿效果图了,脑补一下吧QwQ
