
这周真的很忙,加上在做大模型研究的过程中更加切实的体会到OpenAI确实在大模型理解上高了我们好几个层次,好几天没有更新了。今天还是来看看这篇微软对GPT-4的测试论文吧,由于整篇文章的内容是真的多,所以只讲一些我感兴趣的东西
1.说明
这篇文章用的并不是GPT-4论文中的那个GPT-4,而是较早期的一个GPT-4版本,并且是非多模态的版本,即只有语言模态的GPT-4。这个声明在整篇论文的很多地方都出现了,可能是在炫耀现在放出来的版本要强的多。
用以和GPT-4比较的主要对象是ChatGPT,其次还有达芬奇003之类的,总体看下来GPT-4确实在很多地方做的确实比ChatGPT好很多,但也同样继承来了很多缺点。
本论文的目的是探究GPT-4是否已经能够称为早期通用人工智能(AGI),得出的结论是我们确实看到了AGI的曙光,虽然还是有很大的差距。
关于什么是通用人工智能或强人工智能,有非常多不同的说法,所以某种程度上来说判断一个模型是否是AGI和判断一个模型是否真的通过图灵测试一样,某种程度上来说带有主观性,更像是噱头。但这篇研究论文表明,GPT-4确实非常强,至于到没到早期AGI,大家还是自行判断吧,我看网上吵得还是挺疯的。
2.谈几个有意思的点
先谈一些不展开太多的点
(1)在很多方面,GPT-4都可以吊打ChatGPT,包括能生成可以可视化的LATEX,虽然不知道GPT-4到底在哪些地方做了改进,但确实更强了一些
(2)GPT-4的数学能力虽然略强于ChatGPT,但仍然会犯很多错误,例如坚持某个错误的计算或思路以至于陷入死胡同等。后续一些研究也说明GPT-4会陷入一些死胡同,或在一些错误的模式中循环往复(ChatGPT有时候也会刚开始时生成正确的内容然后就同样的内容循环输出了)
(3)GPT-4的过程一致性还存在很多问题(毕竟可以认为GPT-4并没有一个特定的“人格”)。
(4)GPT-4不需要训练就可以在zero-shot下使用工具API。这一点挺惊艳的。众所周知,Meta发布了Toolformer这篇论文说明大语言模型是可以自己学会使用API的,结果GPT-4甚至不需要训练就能用(据说还能自己用自己),某种程度上也算打了Meta的脸(或者炫耀自己对大模型的理解高你几个层次):
【花师小哲】当代炼金术(神经网络)前沿(13)——语言模型自学使用工具?
(5)GPT-4可以玩游戏,即通过给出游戏的描述(特别是早期mud游戏),它可以玩下去。我自己也试过让ChatGPT作为强化学习的智能体,做的还是挺不错的
3.又是维特根斯坦狂喜
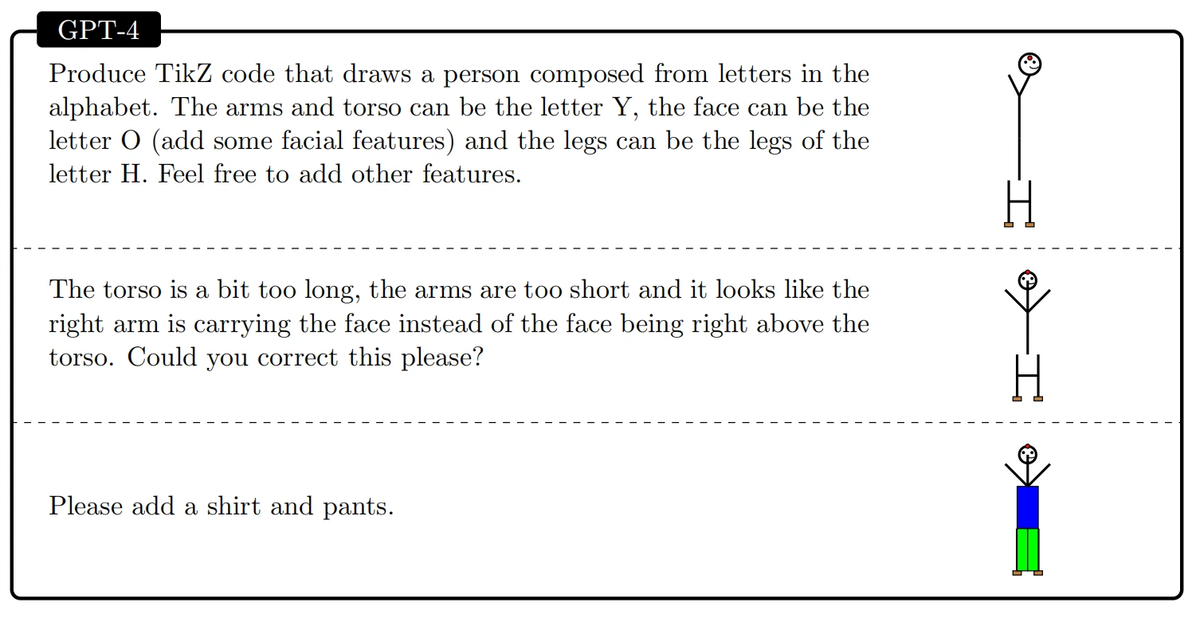
我们展开讲的一点是:GPT-4单纯通过学习大量语料就学会了其他模态。
简单来说,语言模型就像是盲人,所接受的只有文字,在这种情况下它竟然能够想象图像、音乐等多种模态。例如我们让GPT-4画画(图中的例子是画一个小人),他竟然是可以做到的。也许正如维特根斯坦的语言哲学所说,一切都只不过是语言游戏罢了:
4.自回归模型的固有缺陷和下一步的去向
研究还表明了自回归语言模型本身的限制,例如顺序处理在很多问题上确实造成了很多难以解决的问题,即使是简单的数学运算,一个简单的调换就会导致计算出错:
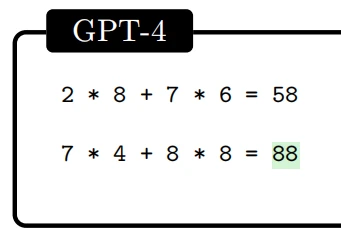
简单来说,GPT模型是decoder-only架构的,天生只适合生成下一个词,或者说,只适合从左到右进行顺序处理;而BERT是双向的,某种程度上在处理句子结构时能做的更好。
其实GPT能够成功,也和decoder-only架构脱不开关系,因为这种单向架构更加省空间,同样的参数量就可以做的更大,所以在目前硬件上限在那里摆着的情况下GPT就是比BERT的规模更大。也许BERT也能达到GPT这种规模,没准会强上不少。真的是成也decoder,败也decoder。这种缺点很可能是无法完全弥补的,只有不断打补丁了。
当然,这篇报告也给出了非常多的改进意见,这里也不多赘述了。
