
深度学习与计算机视觉初学笔记
Tensorflow 2版本
简介:
深度学习框架:快速方便建立模型,自己设计网络模型。
开源项目要注重学习,多学框架。深度学习必学。本框架:计算机视觉和自然语言处理。
Tensor:是TensorFlow中一个基本的单元,可以进行GPU加速计算的矩阵。
基础操作:
import tensorflow as tf import numpy as np
动态图:
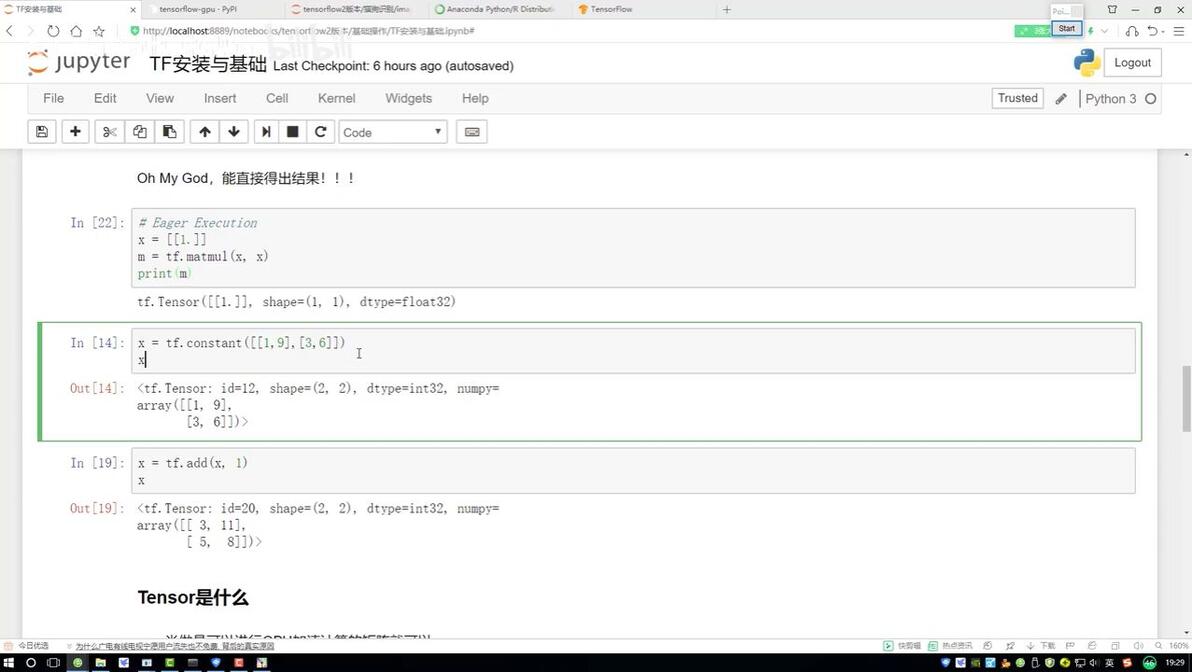
3.和numpy做交互
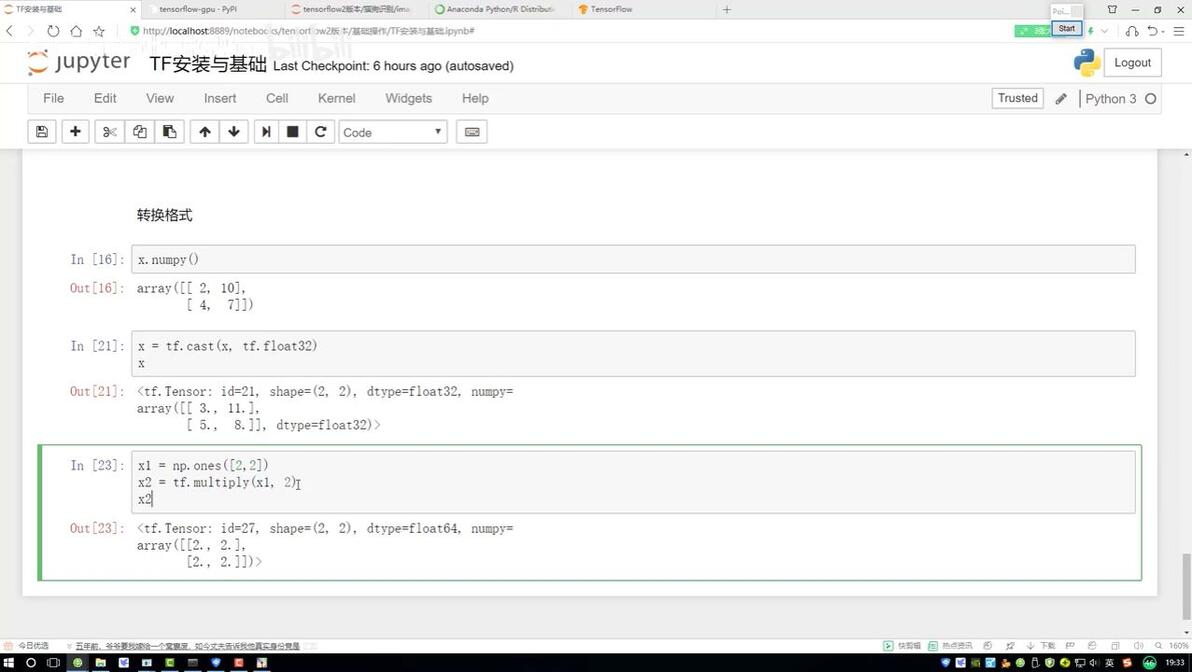
改成数组形式,改变数据格式。
深度学习
神经网络:特征提取的方法。数据的特征更重要。
机器学习流程:数据获取、特征工程、建立模型、评估与应用。 (数据特征据决定模型上限,预处理和特征提取是最核心的)
深度学习是机器学习最核心的部分,可以自己智能提取特征。数据规模越大效果越好。
应用:自动驾驶汽车(检测和识别),人脸识别(核心),医学细胞检测,分辨率重构让视频更清晰或者重新上色。
问题:移动端支持不是很好,计算量太大,速度有点慢。
计算机视觉
图像表示:计算机眼中的图像, 转为三维数组的形式(长宽加颜色通道,比如RGB,最后就是乘3),每个像素的值从0到255,从暗到亮。
面临的挑战:照射角度,形状改变,部分遮蔽,背景混入。
常规思路:收集数据并给定标签,训练一个分类器,测试+评估
数据集推荐:CIFAR-10
分类算法复习:K近邻算法(不适合做图像分类任务)
用在深度学习中的缺点:分不清主体和背景,希望识别出来那个部分重要
神经网络
线性函数(得分函数):输入图像,输出属于每个类别的得分 。图像由像素点(特征)组成,对应不同的权重参数,几个类别几组参数。注意还有一个偏置项b,各自类别各自微调。
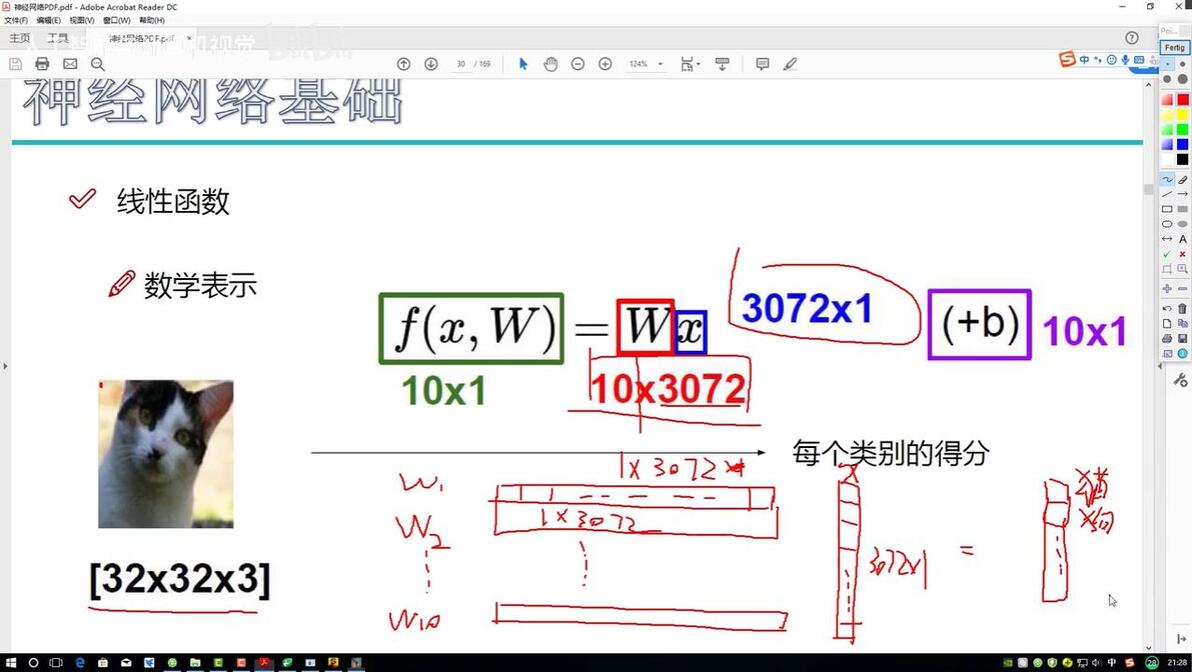
权重矩阵:先是随机产生矩阵,根据分类结果优化这个矩阵。
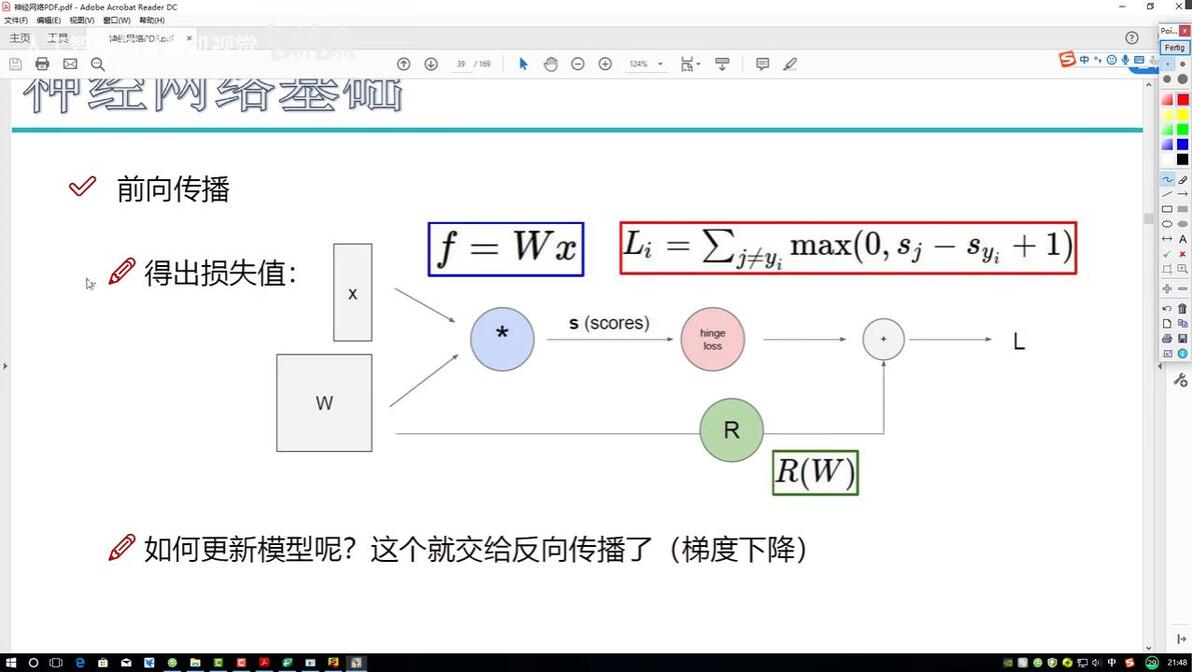
损失函数:不同的任务(分类或者回归),网络结构不会变,取决于损失函数的变化。损失函数也会加一个类似偏置的值,表示预测值得高出这么一个偏置,才能表示没有损失。
损失函数的改进:不同的模型(不同的权重矩阵)算出来的损失值相同,注意权重参数不能过拟合,接一个正则化惩罚项,这个与数据无关,只考虑权重参数,一般正则化惩罚项就是权重平方和相加然后乘一个那木大,因为神经网络太强大,非常容易过拟合。
损失值转概率:sigmoid函数
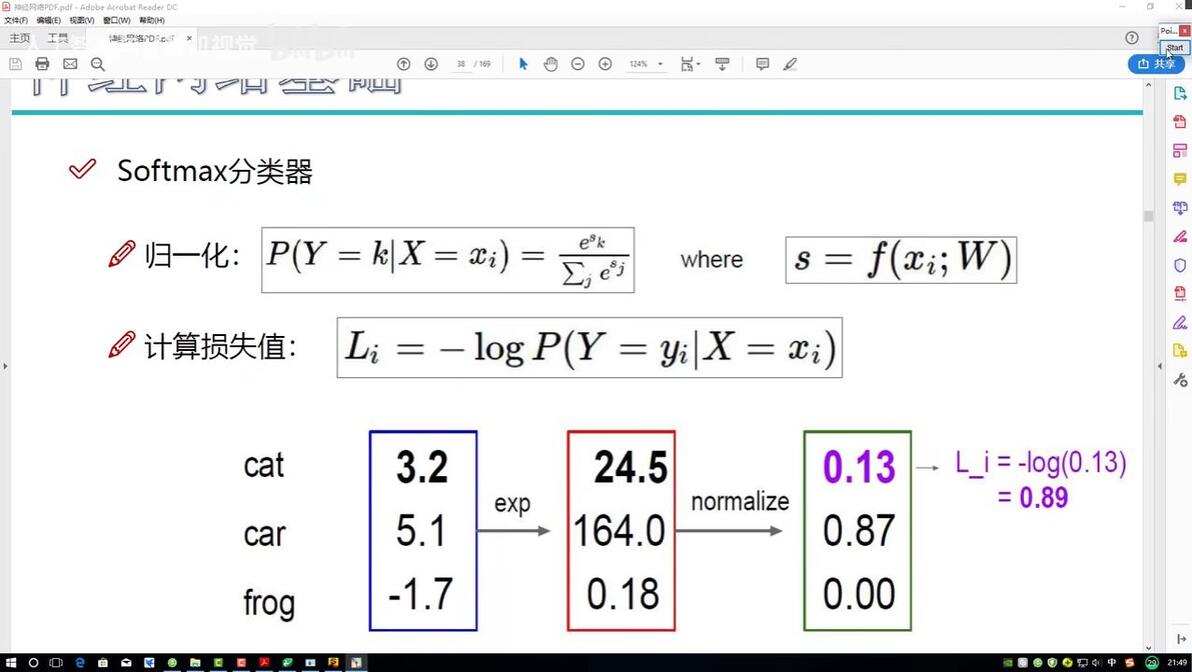
步骤:
1.放大各个类别得分之间的差异,用e的x方的函数。如果传进去负数,就代表是这个类别的可能性越小,传入指数函数表示的概率接近于0。
2.归一化:放大后的值除以所有值相加,转化成概率值。
3.计算损失:用对数函数求损失。我们期待正确类别的那个概率越接近于1,表示这个分类就越准确,损失函数就接近于0,这个特性也刚好符合对数函数的特点!在1处的值为0。
回归任务由得分值计算损失,分类任务由概率值计算损失。
反向传播计算方法:(梯度下降)
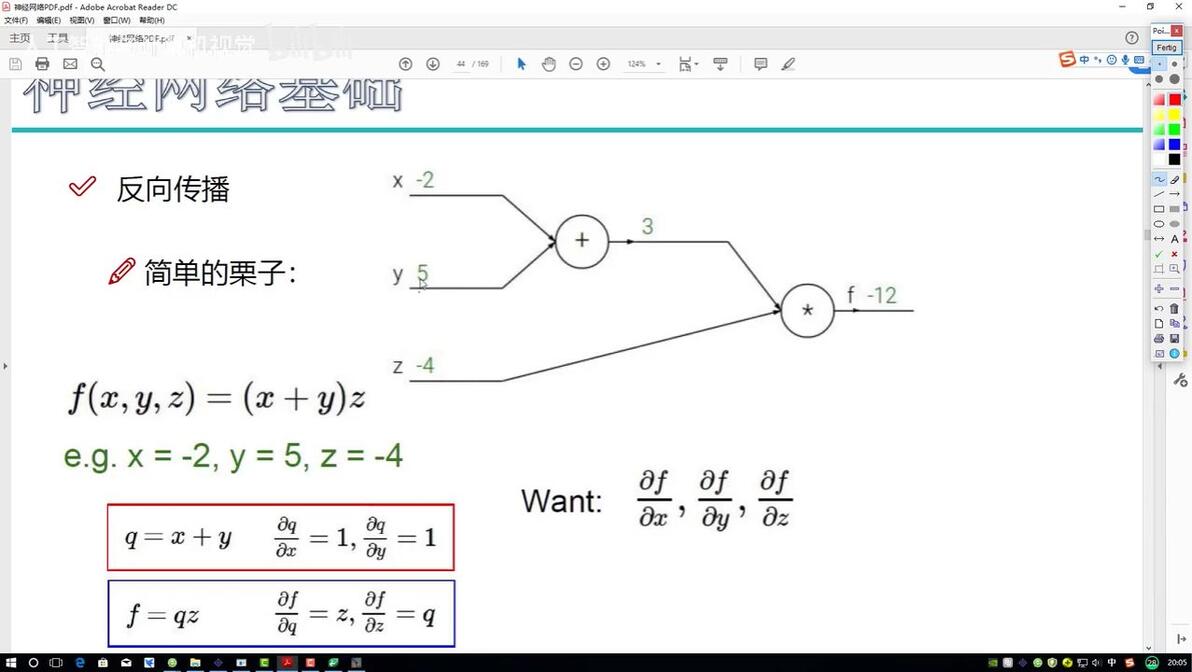
链式法则:梯度一步一步进行传播,逐层按顺序,从后往前求偏导。(理解就行,用工具包算)
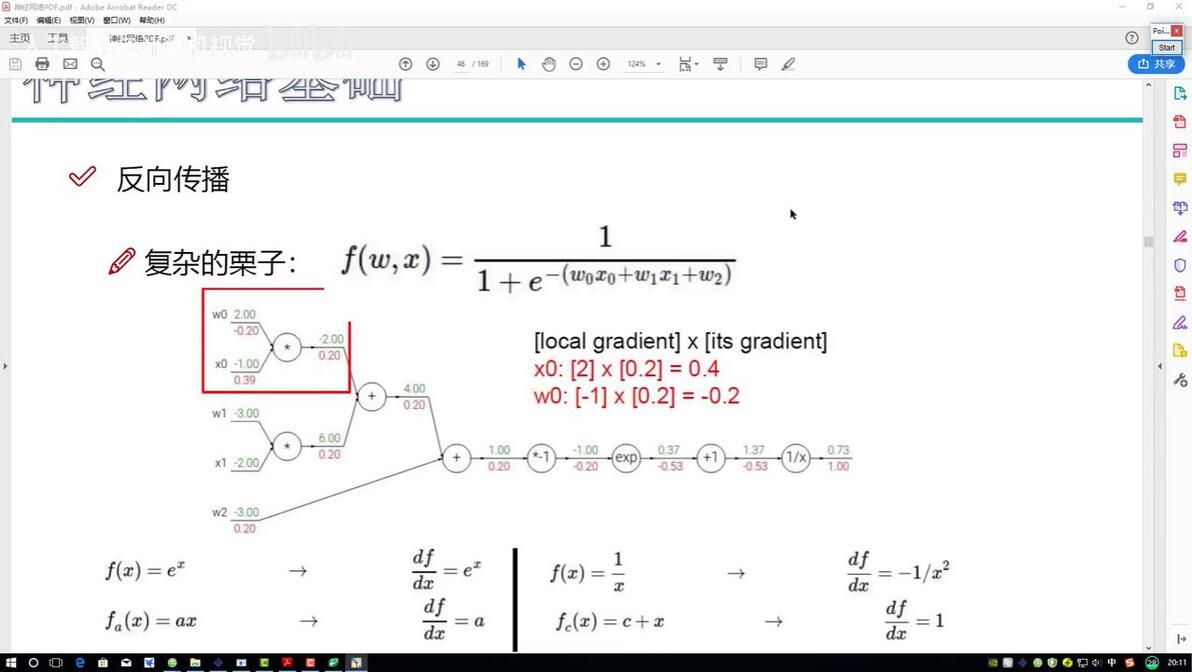
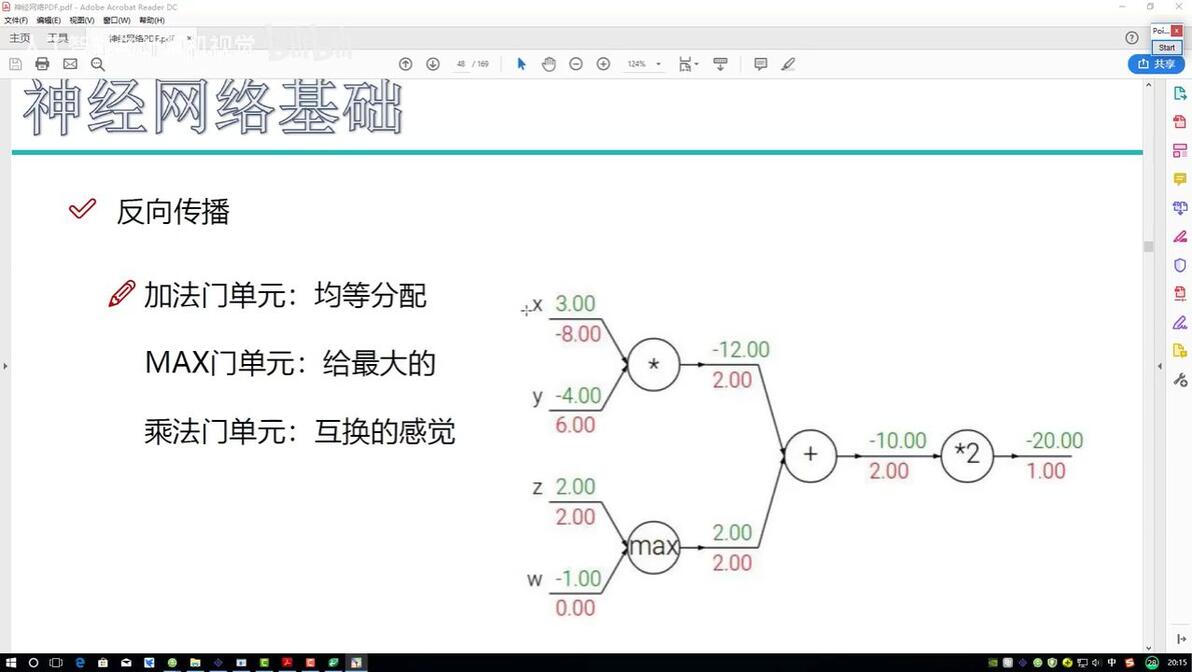
门单元的概念:
神经网路总结:
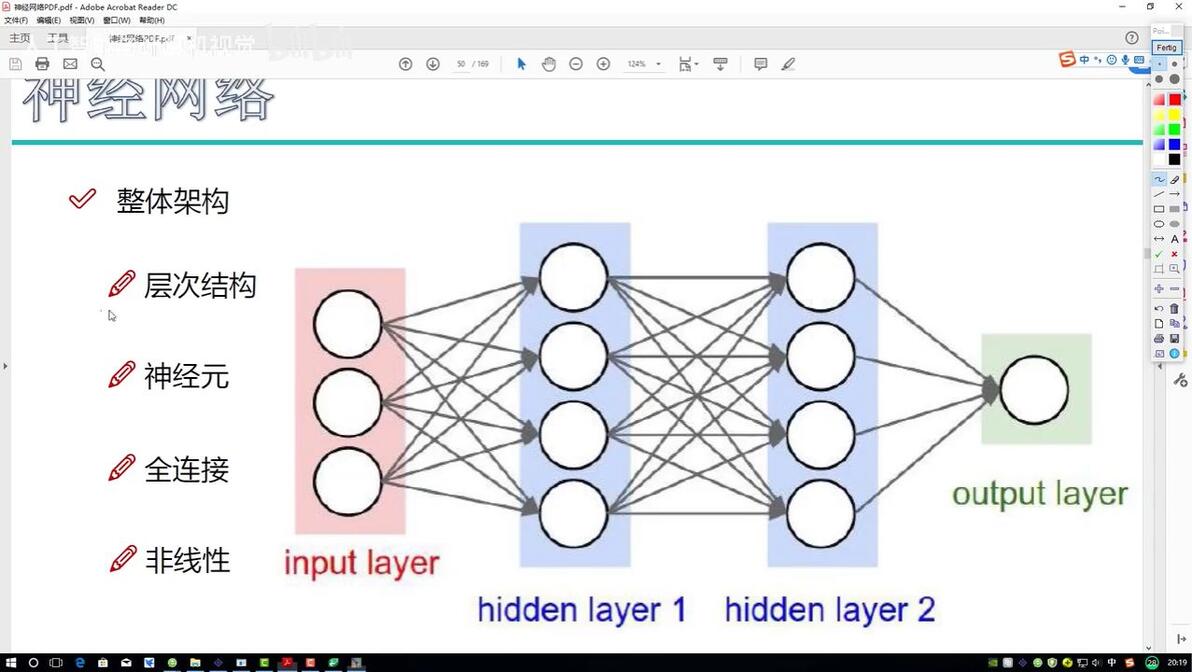
input layer:数据特征有多少个就有多少个圈23
hidden layer 1:将输入的三个特征扎转化为4个特征,转化成计算机更容易分辨的更好的特征。连的线就代表权重。中间做的矩阵乘法才能实现这样的转变,本题中第一个就是3×4的权重矩阵。
hidden layer 2:对特征进行再加工,中间就是4×4的矩阵。
output layer:最后一个是4×1的权重矩阵就能得出输出结果。
注意:非线性操作加在每一步矩阵操作之后,所以不能由一个权重矩阵代替所有的权重矩阵乘起来的结果。
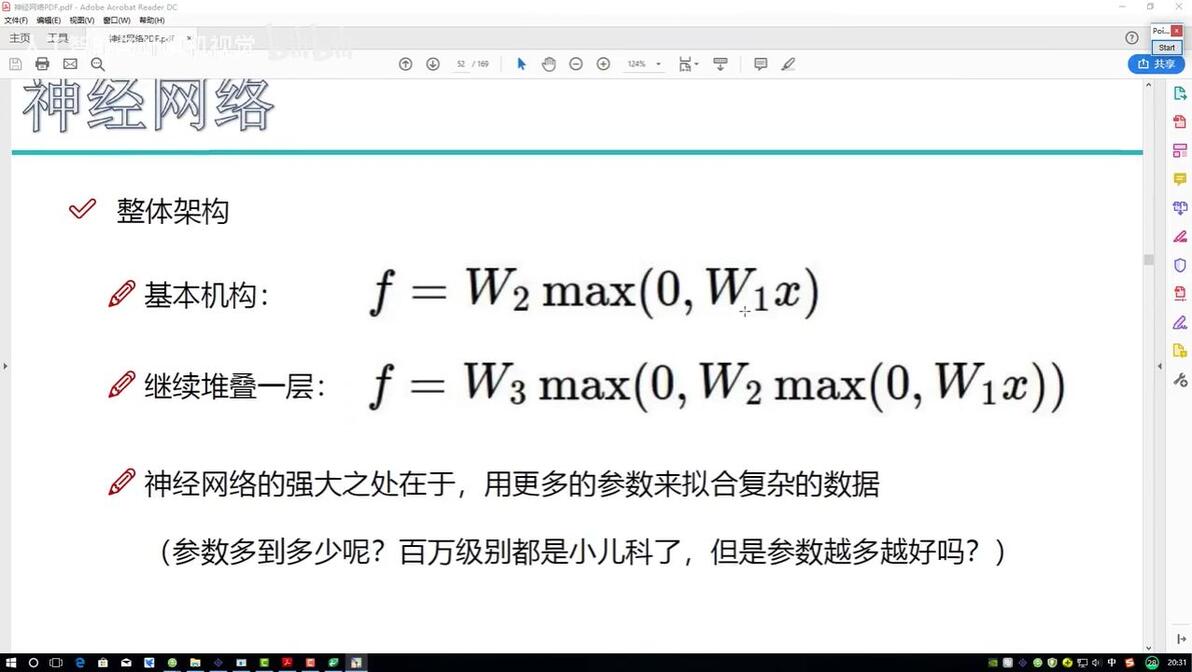
神经元个数对神经网路的影响:
有个网站:
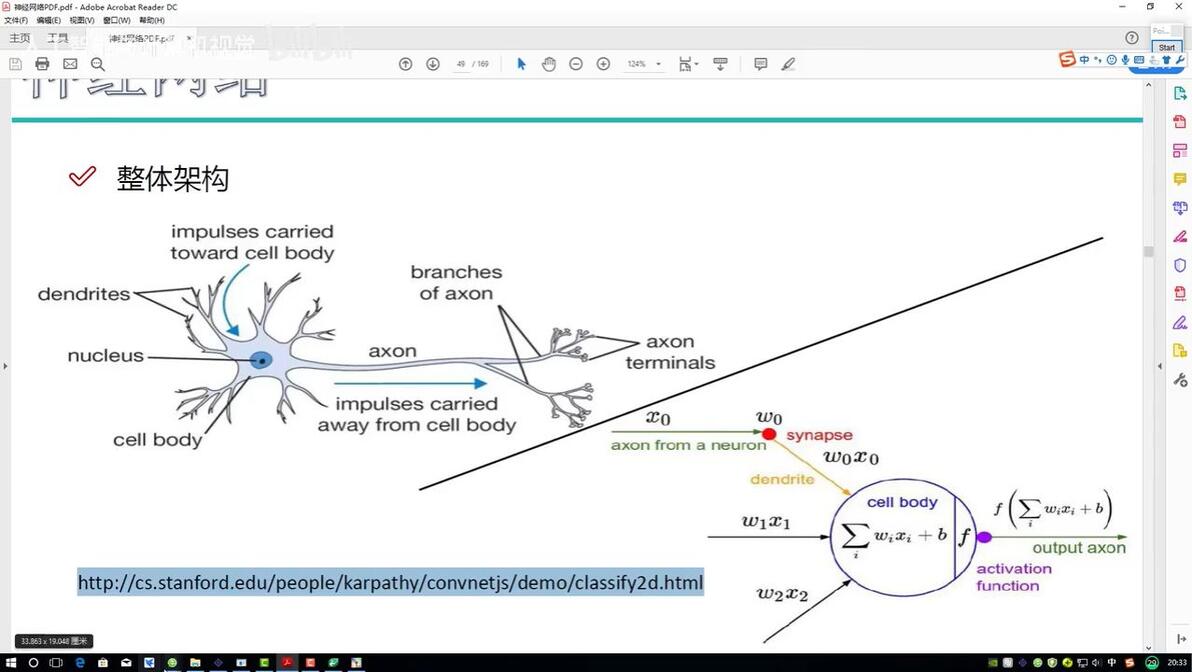
神经元个数越多,就像切得到越多,得到的网络效果越好。64、28比较常见。加一个神经元相当于加了一组参数。
神经网络特点:即使数据集随机,分类效果依然很好。
正则化与激活函数: 正则化就是加惩罚项防止过拟合,然后激活函数就是神经网络经过一组权重参数计算完之后要进行非线性变换,下面列举几个激活函数:
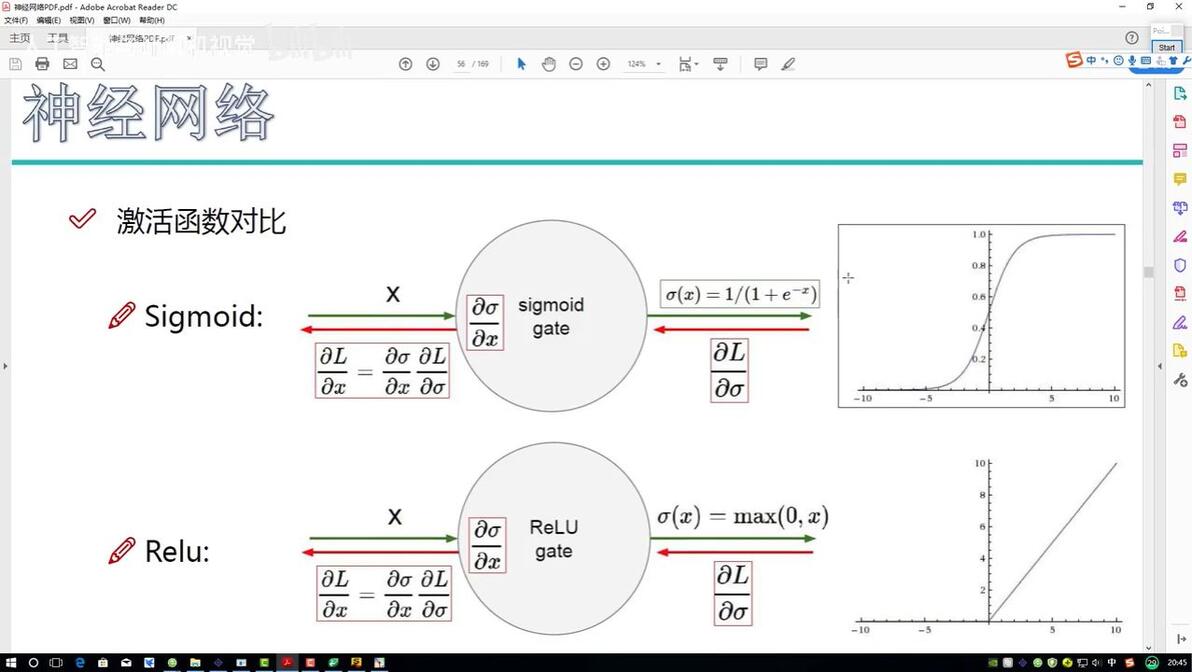
simoid函数的问题:数值较大或者较小梯度为0,出现梯度消失问题,后面就都不进行更新了,目前用的更多的就是第二个,梯度也好算,不会出现梯度消失,因为值不会小于0.
数据预处理:(标准化)
1.去中心化:除以均值
2.放缩或者扩充:除标准差
参数初始化:
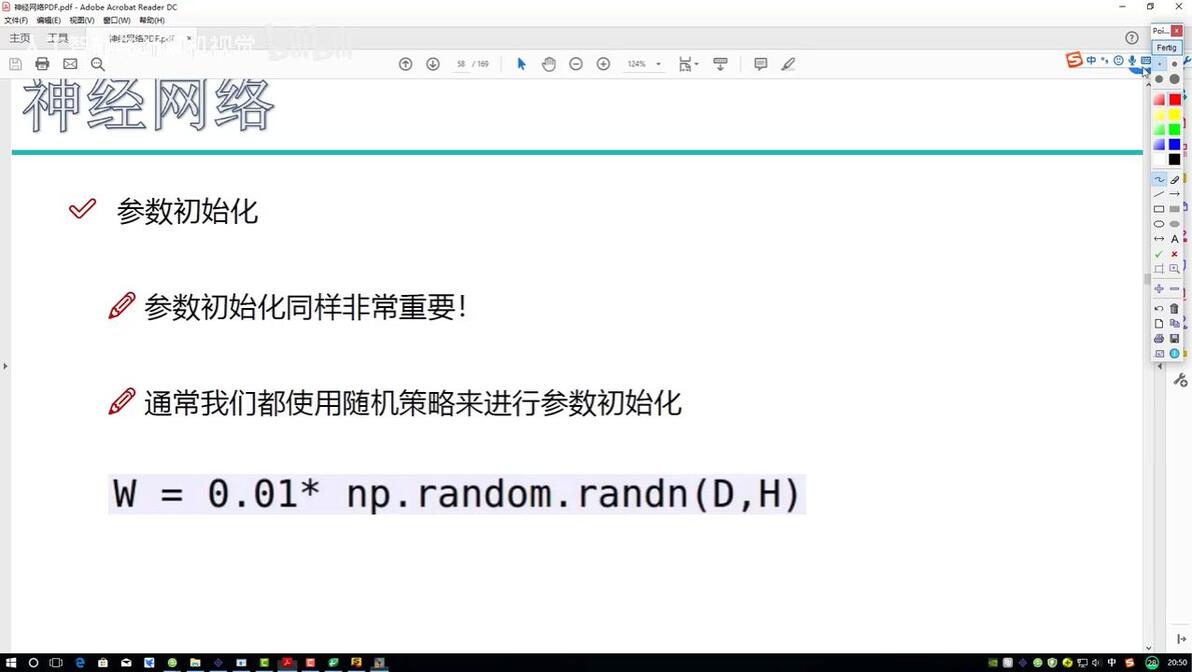
乘0.01就是防止让参数之间的浮动较大
防止过拟合新方法:
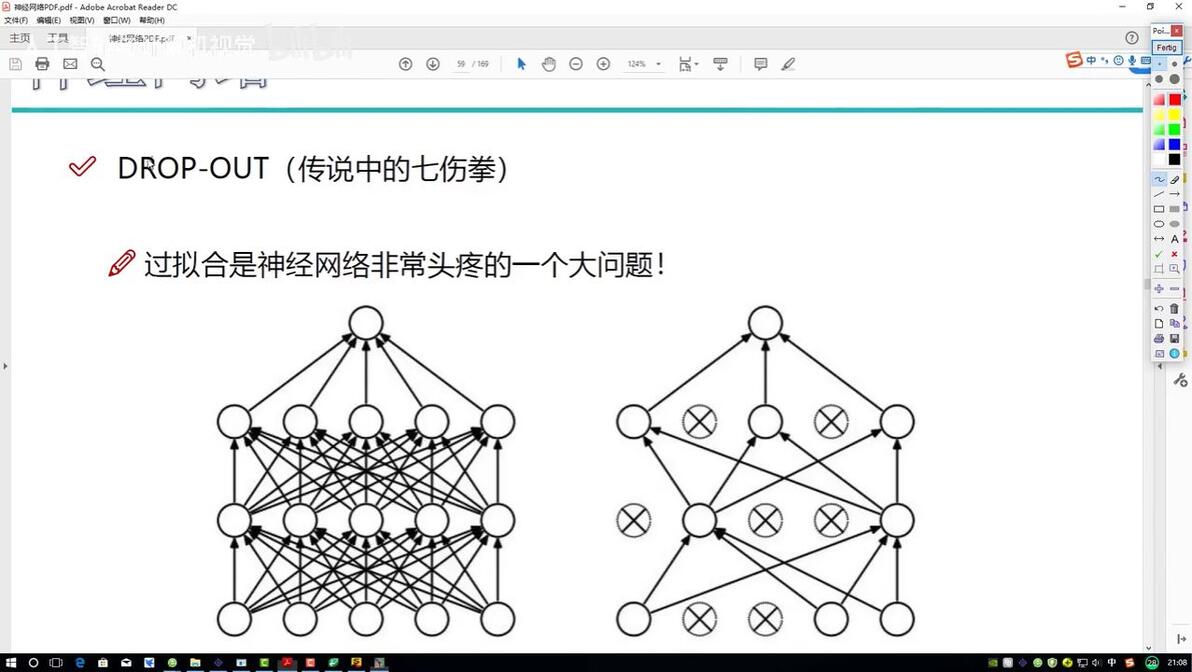
在训练网络过程中在每层中随机删除一部分神经元(固定比例),效果就是参数不参与更新,但是在测试的时候还是用的所有神经元。
猫狗识别项目实训
构建网络模型代码要用的API
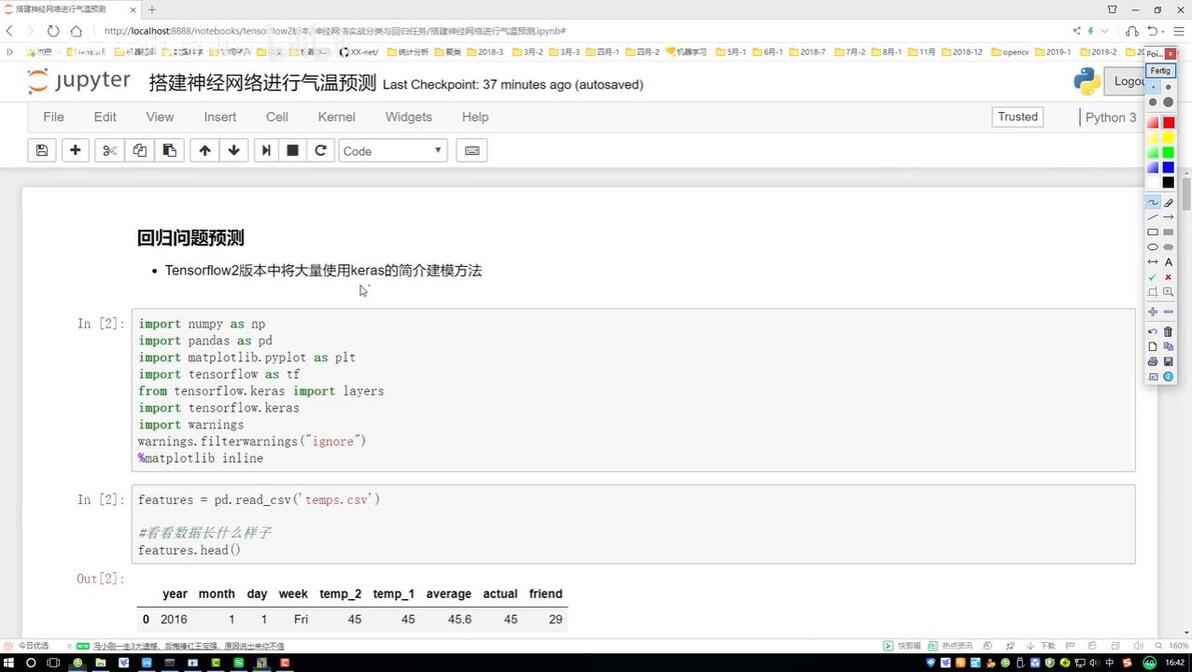
Dense全连接层神经网络
参数调整用现成的(或者开源项目),不用太认真。
注意过拟合
分类任务(任务需要)
数据集:minst数据集
数据处理:输入转化为特征向量,图片就是转化成一系列像素点
卷积神经网络:应用范围广泛
数据不是一个特征,而是一个三维特征,直接对图像数据进行特征提取
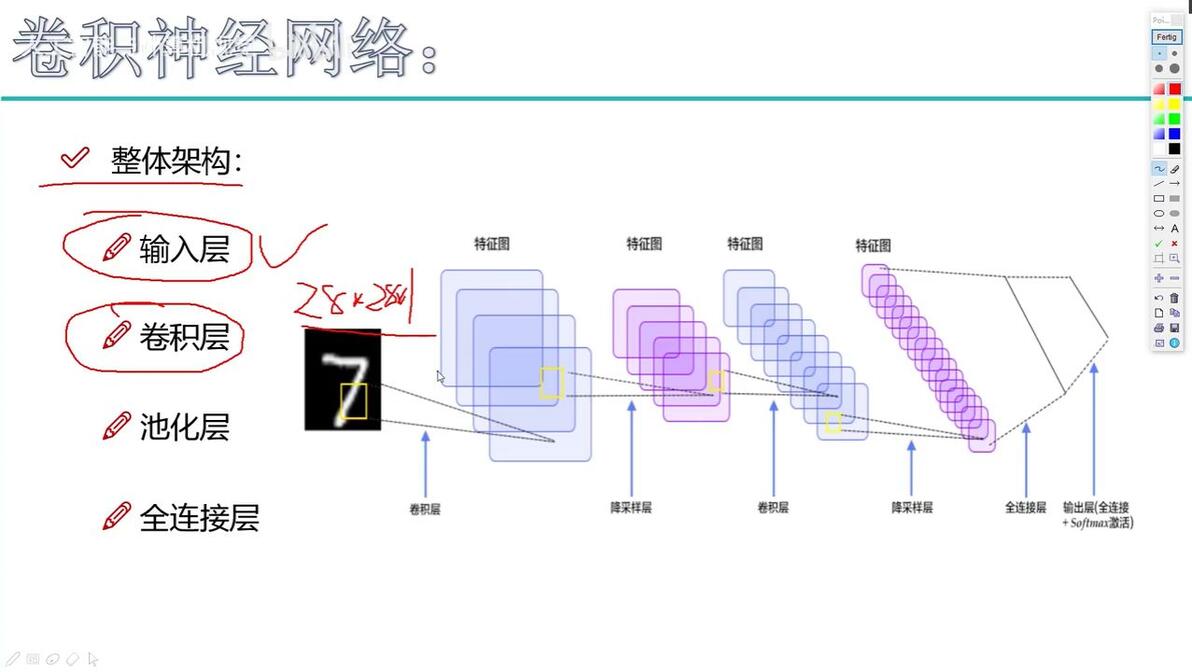
卷积层提取特征,池化层压缩特征
卷积:边缘和中间的特征重要程度不一样
图像颜色通道:三维数据最后一维如果是三就表示RGB三个颜色通道,分别做一次卷积然后把三个值加起来(多通道分别去做)
卷积之后的特征图大小计算:
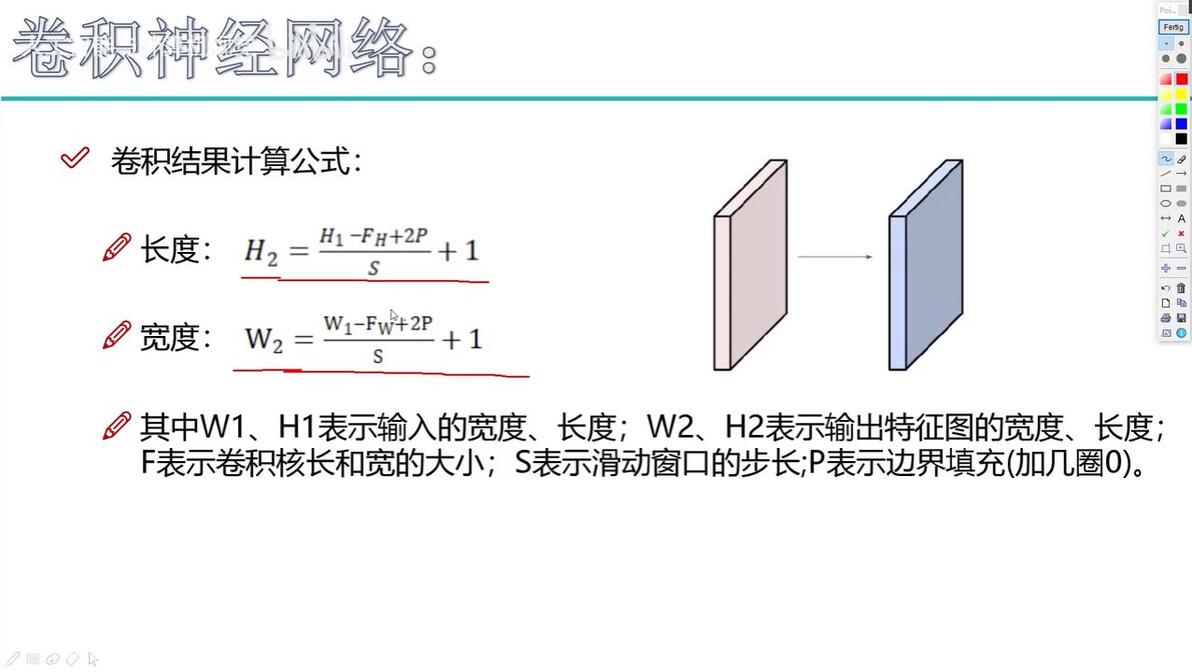
池化层:压缩特征,在元氏特征中进行筛选,只会变长和宽,打颗栗子:max pooling就会将每个区域最大的值选出来,还有平均池化,没有涉及矩阵计算哦
一般规律:两次卷积一次池化,当然这也只是对特征的提取,最后分类出结果还是需要全连接层,权重矩阵的大小前一个是前面提取出来的特征(可能是三维)拉成一个很长的特征向量,后面一个是类别,应该一说就懂
网络层数:带参数计算的才算一层,只有卷积层和全连接层需要,池化、relu没有参数
一些卷积神经网络架构:
VGG
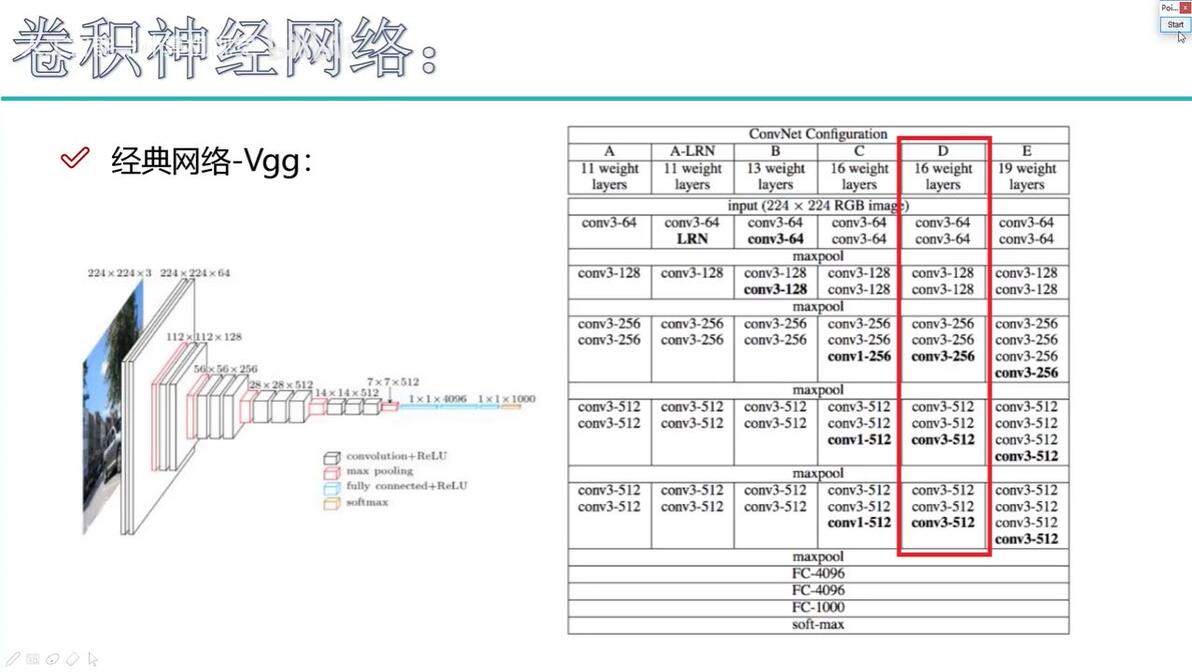
框起来的是主流版本:卷积核3*3, 有16或者19层,pooling之后会损失一些信息,下一次卷积的时候特征图翻倍,用特征图个数去弥补信息损失(16层比30层号)
Resnet
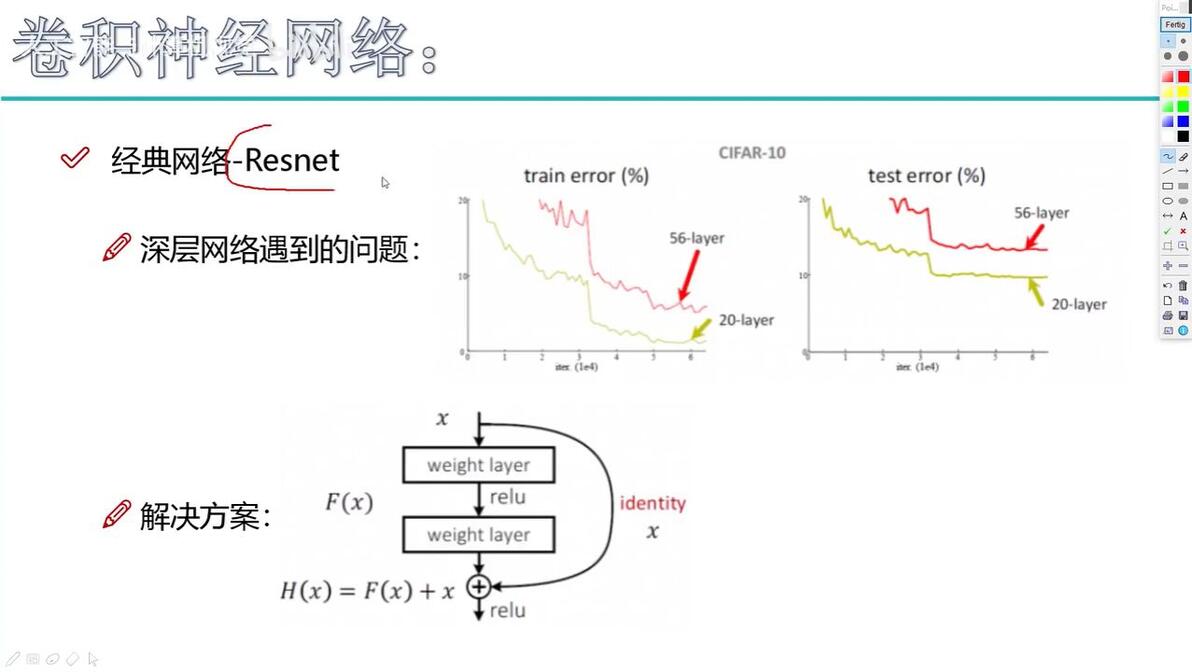
这个网络的特点就是在下一层除了有经过处理之后的数据之外还加了原本未处理的数据,如果这一层处理的效果不是很好的话就把这一层的参数全部设置为0,因为还有未处理的数据可以保底,效果就是层数越多效果肯定不会比原来差,但是好的话可能也就好一点点。(50,101层是比较常见的)(用途广泛)
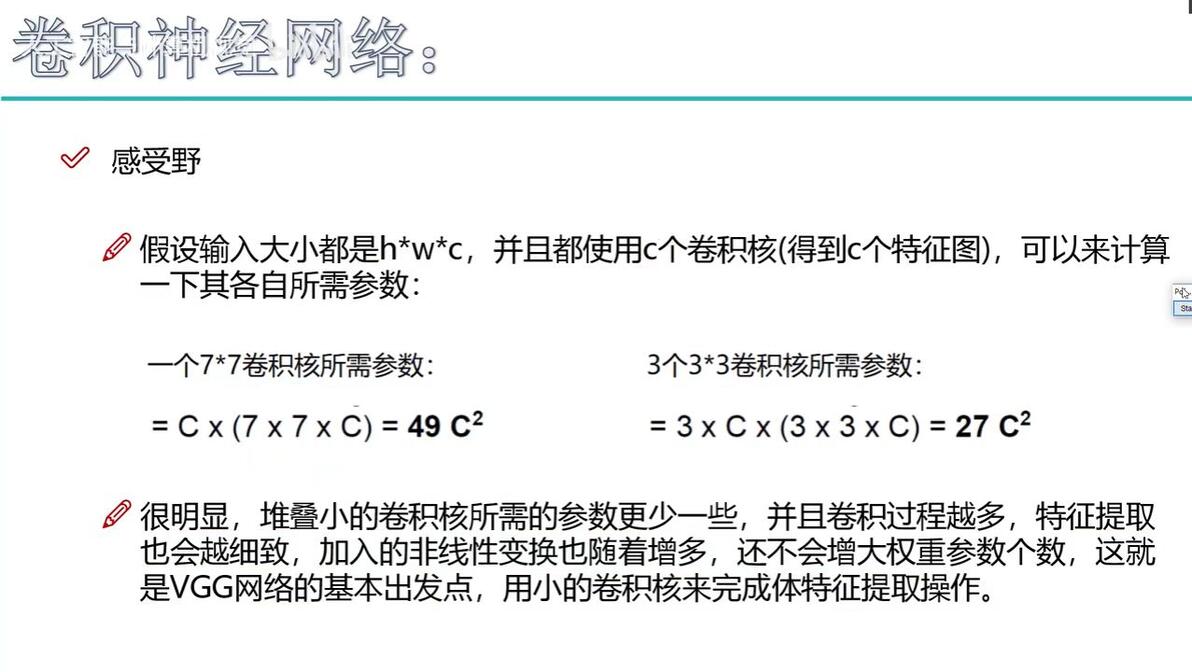
感受野:后一层的某一个格子能够感受到前面被卷积的区域比如3*3,希望感受野越大越好
项目实战之猫狗识别
数据预处理:
1.图像数据处理
2.准备训练集和验证数据集
卷积网络模型:
1.构建网络模型
过拟合问题:
1.观察训练和验证效果
2.针对过拟合问提出解决方法
数据增强:
1.图像数据增强方法与效果
迁移学习:
1.深度学习必备训练策略
