
SQl语句查询关键字
执行的优先级
优先级关键字作用1from指定要查询的表信息2where规定查询条件,然后查询并筛选3group by根据指定字段进行分组,如果没有指定字段,则整个表为一组4having指定查询的条件,筛选数据(二次筛选用在where之后)5select指定要查询的信息6distinct将数据去重7order by对查询的结果进行排序8limit限制查询结果展示的数量
1.select
指定要查询的信息
①字符串拼接—与
1)拼接任意字符串
2)指定一个连接符号拼接字符串,第一个参数separator是指定的连接符
2.from
指定要查询的表信息
SQL语句中关键字的执行顺序和编写顺序并不是一致的
比如我们编写SQL语句查找数据的时候,select写在from之前,但是先执行的是from
3.where筛选
where+条件可以筛选出我们想要的数据
编写SQL语句的技巧
SQL语句的编写需要反复修改,一次性写完容易出错
针对select后面的字段名可以先用填写*占位,写完在修改
而在实际情况中,select后面很少直接写,因为表示所有,用*查询表中的字段和数据非常浪费资源、效率也很低
①比较运算 - 、、、、、
通过使用比较运算符号筛选数据
② 逻辑运算 - 、、
通过逻辑运算符连接比较运算符
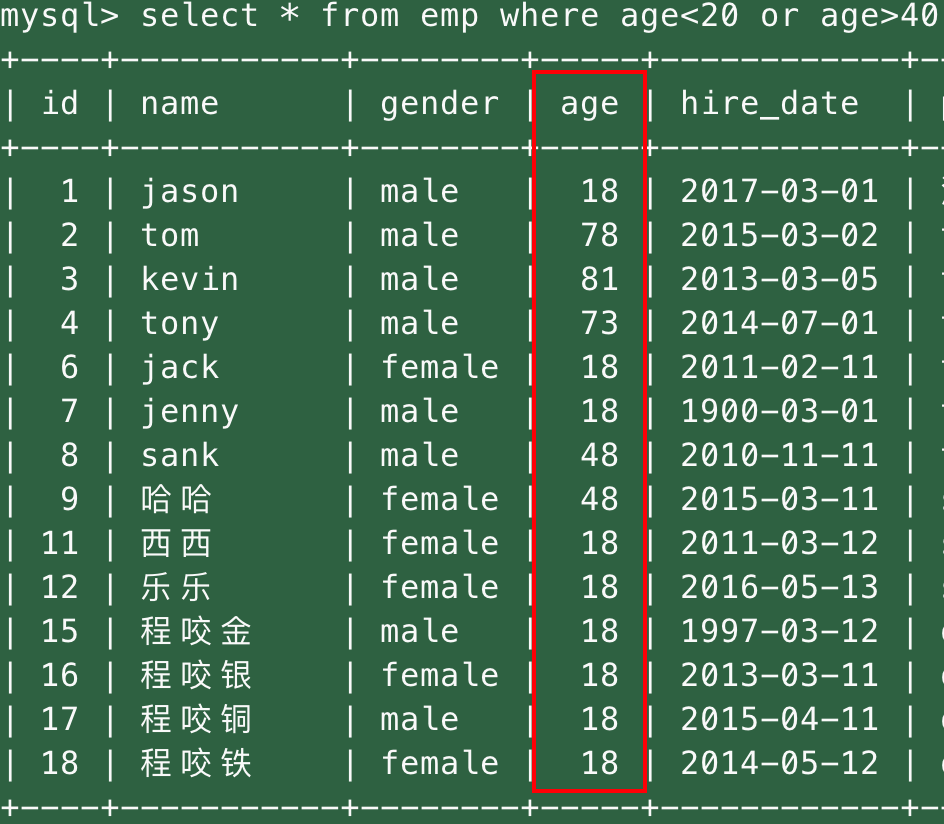
③ 成员运算 - 、
在特定的值中获取:
取反:
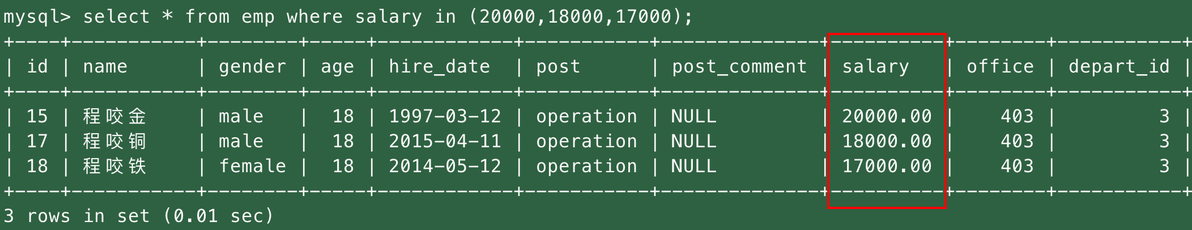
④ 区间 -
取出某一区间:
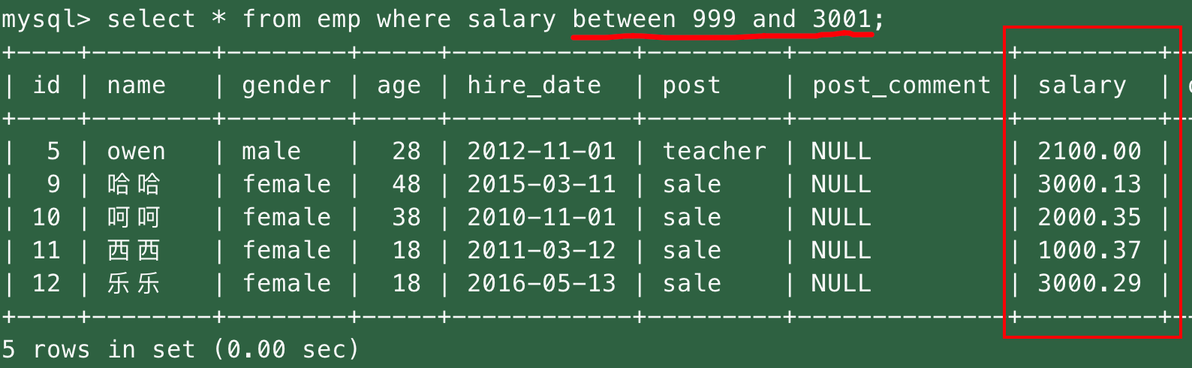
⑤ 模糊查询 -
条件不够精确的查询 称之为 模糊查询
1)匹配任意多个字符:
%n%可以匹配 字母n,在字符的开头/结尾/中间,且不限个数
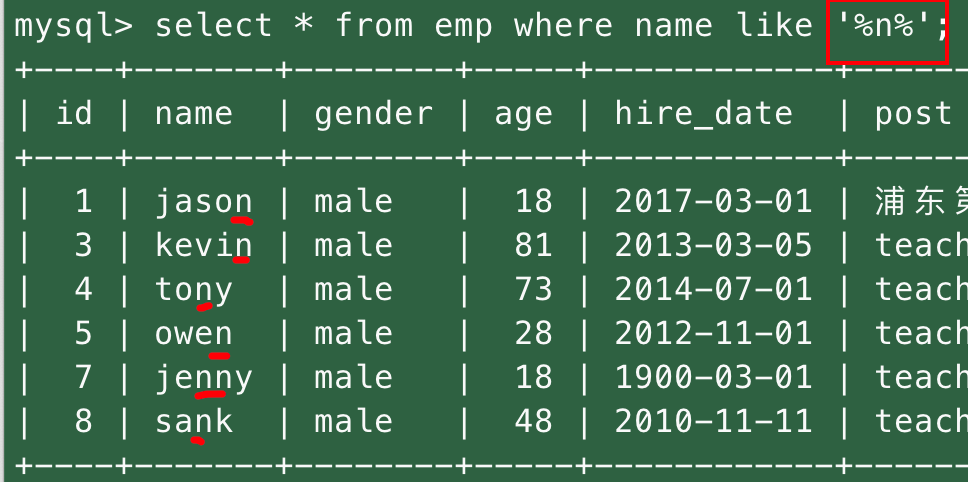
%n 只可以匹配结尾是n的字符
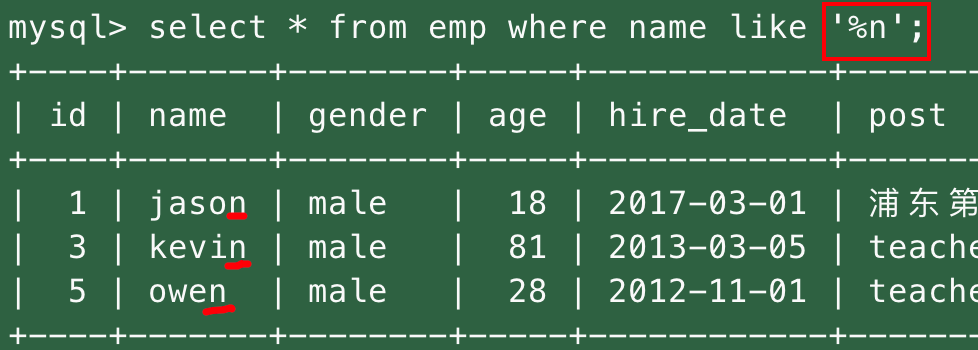
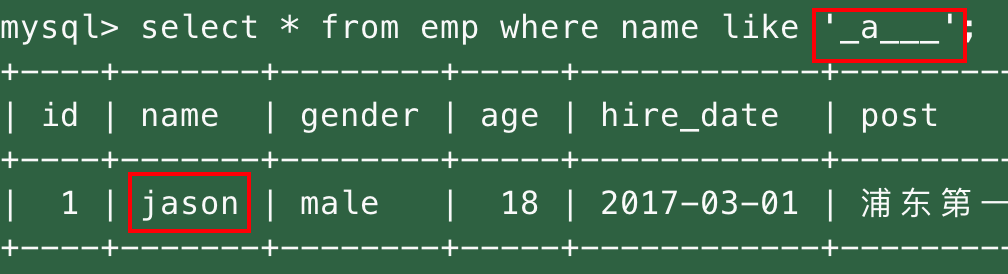
2)匹配任意单个字符:
_a___只匹配一个字母a在第2位的5位字符
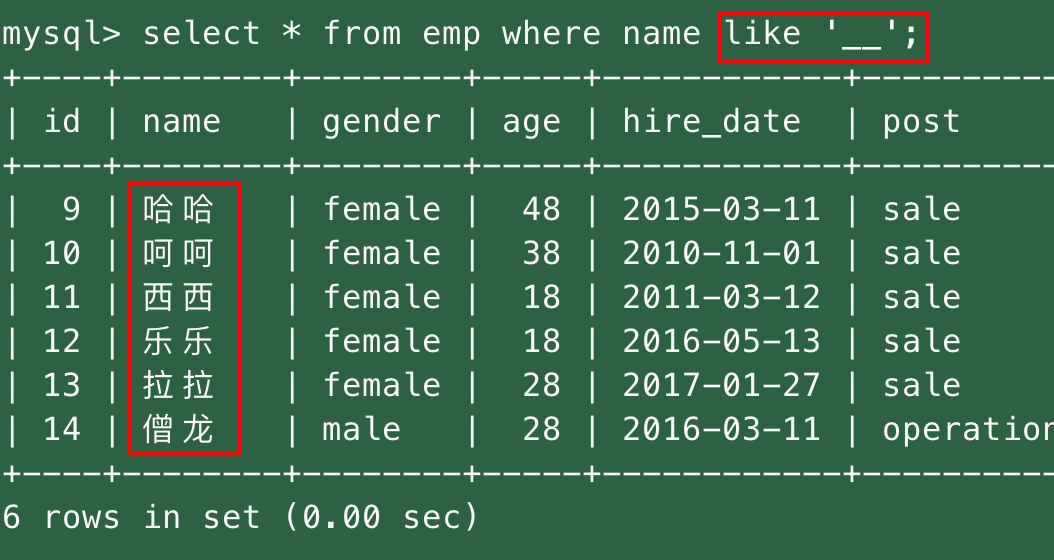
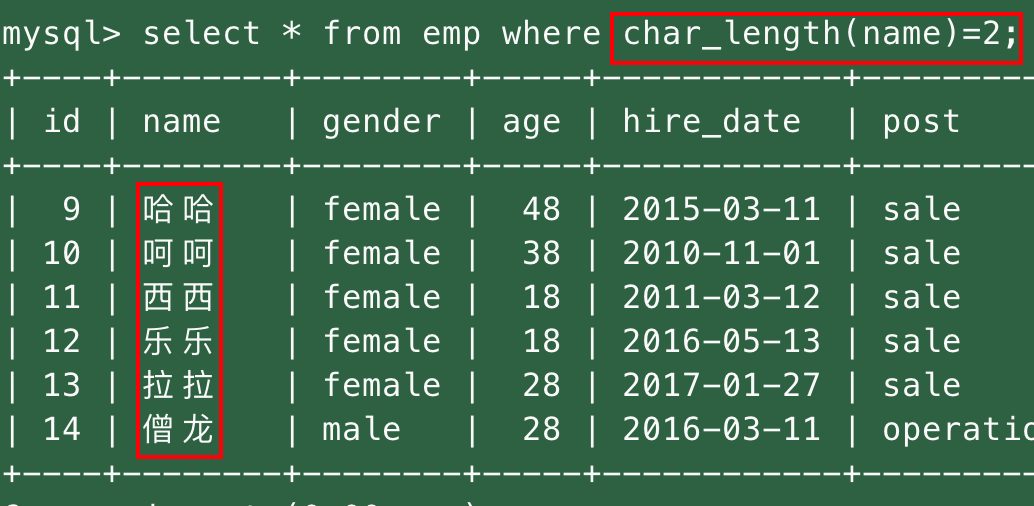
字符长度也可以通过char_length()函数去查询
通过help 方法名来查看内置方法,查看帮助手册学习MySQL内的方法
⑥身份运算符
值的判断不能用而需要用
为什么数据库筛选空字节要用is NULL而不是=NULL
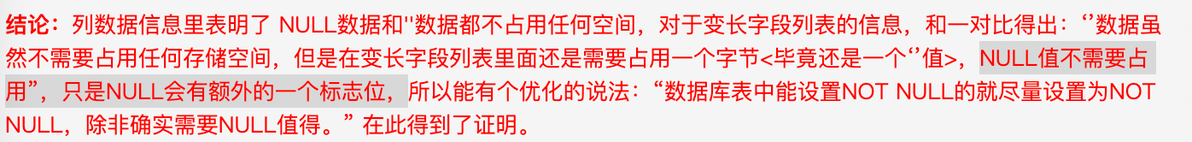
参见这个博客 https://www.cnblogs.com/zhoujinyi/archive/2012/10/17/2726462.html 总结: null不占用内存空间,是一个标志位判断。
数据虽然不需要占用任何存储空间,但是在变长字段列表里面还是需要占用一个字节<毕竟还是一个值>
4.group by 分组
分组行为发生在条件之后,我们可以将查询到的记录按照某个相同字段进行归类,一般分组都会配合聚合函数进行使用。
需要注意的是语句是排在条件之后的,因此聚合函数也能在语句中使用。
(1)分组的含义
根据指定字段进行分组,如果没有指定字段,则整个表为一组
如:将班级学生按照性别分组
(2)分组的目的:
为了更好的统计相关数据
(3)聚合函数
专门用于分组之后的数据统计的函数
聚合函数可以在执行后的所有语句中使用,比如,等。
函数名用途最大值最小值求和平均值计数
(4)如何分组
1)例1:将员工按照部门分组
当我们使用SQL语句 分组时
在MySQL 5.6 版本中,不报错
在MySQL5.7及8.0默认都会直接报错
报错原因:分组之后select后面默认只能填写分组的依据,不能再写其他字符段
分组之后默认的最小单位,应该是组筛选出来的范围也就是组,而不应该在是组内单个数据单个字段
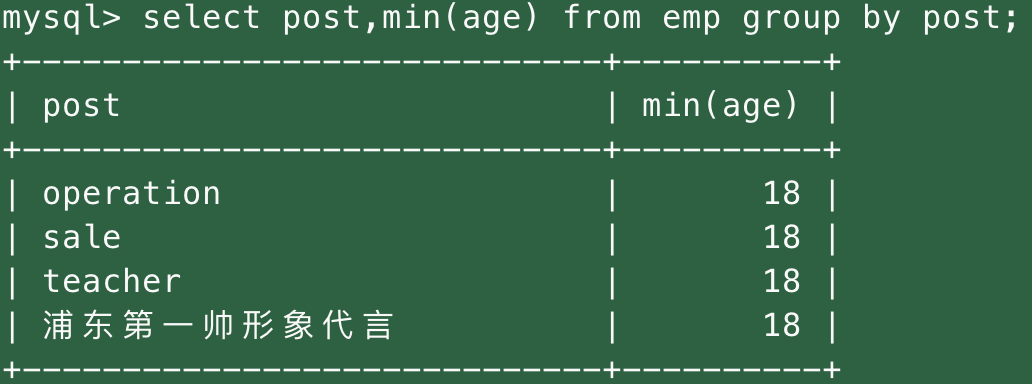
2)例2:获取每个部门的最高工资
需求中出现 关键字 比如最高、平均...
==>使用聚合函数
*as起别名
针对sql语句执行后的结果,我们可以通过as来起别名修改名称字段
3)例3:一次性获取部门薪资统计
连续跟多个聚合函数并用as起别名
用职位分组
用年龄分组
4)例4:统计每个部门的人数
count()统计的时候通常用唯一标识字段作为统计的依据
5)例5:统计每个部门的部门名称以及部门下的员工姓名
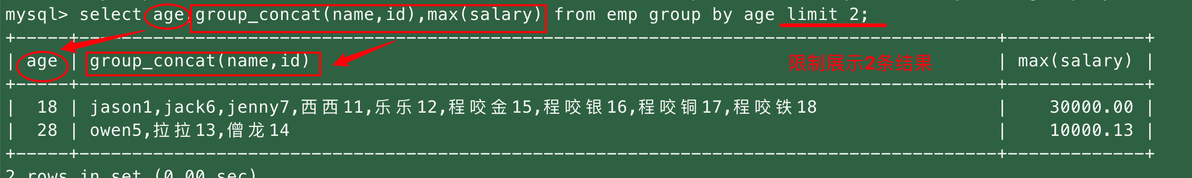
group_concat()分组之后其他字段的筛选与拼接
统计各个性别的人名
group_concat()拼接字段与字符串
5.having过滤
指定查询的条件,筛选数据(二次筛选用在where之后)
(1)having和where的区别
相同:having 与 where 本质是一样的,都是用来对数据做筛选
不同: where用在分组之前(首次筛选)
having用在分组之后(二次筛选)
1)统计各部门年龄在30以上的员工工资,并且保留平均工资大于10000的部门
对于复杂的SQL语句,我们可以先分解成几步,然后将每条SQL的结果可以看成一张表,并基于这个结果再去进行复杂的操作
比如:我们可以分布编写,复杂度从简入难
编写顺序:1) where 条件 2) group by 分组 3)having 条件
按年龄分组
6.distinct去重
distinct用于数据去重
去重的条件是:存在数据必须一模一样才可以去重
当后面有多个关键字的时候,针对的是多个字段组合后的结果去重
7.查询关键字之order by 排序
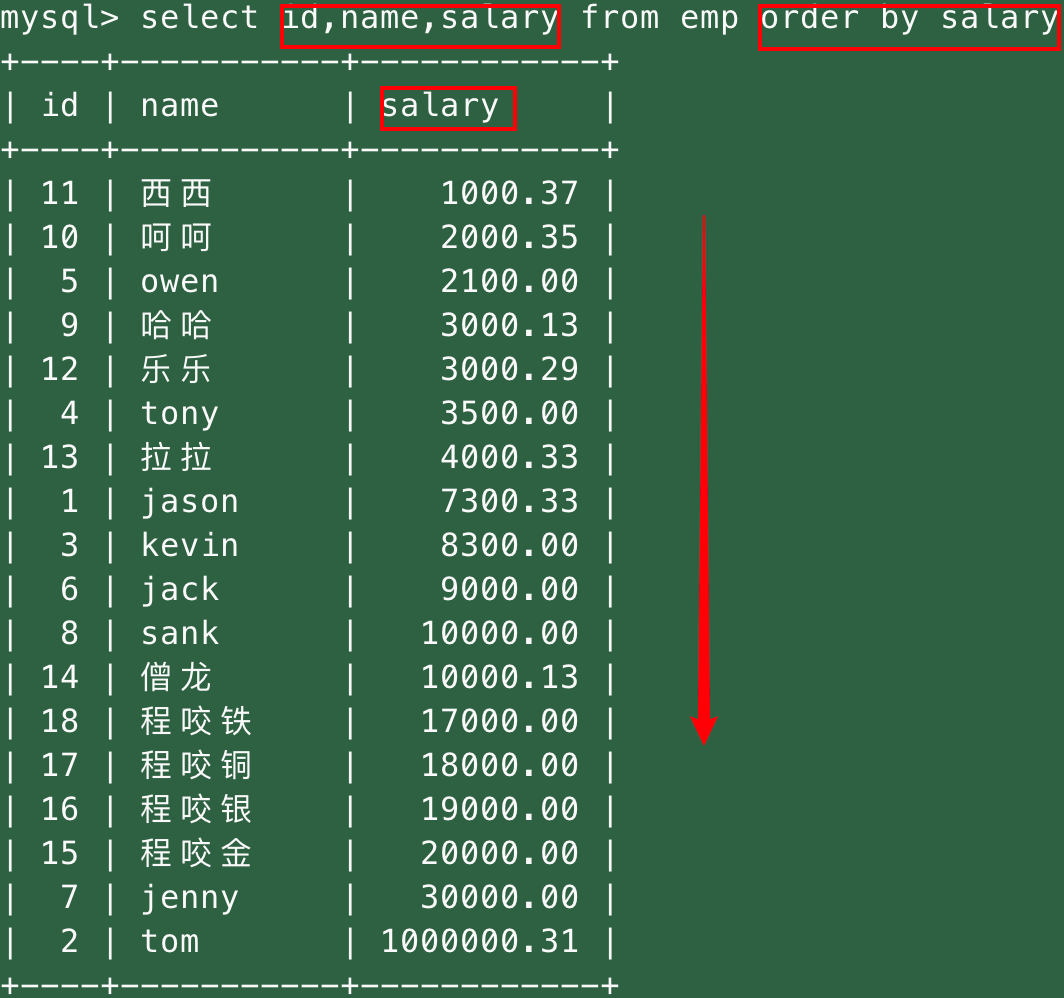
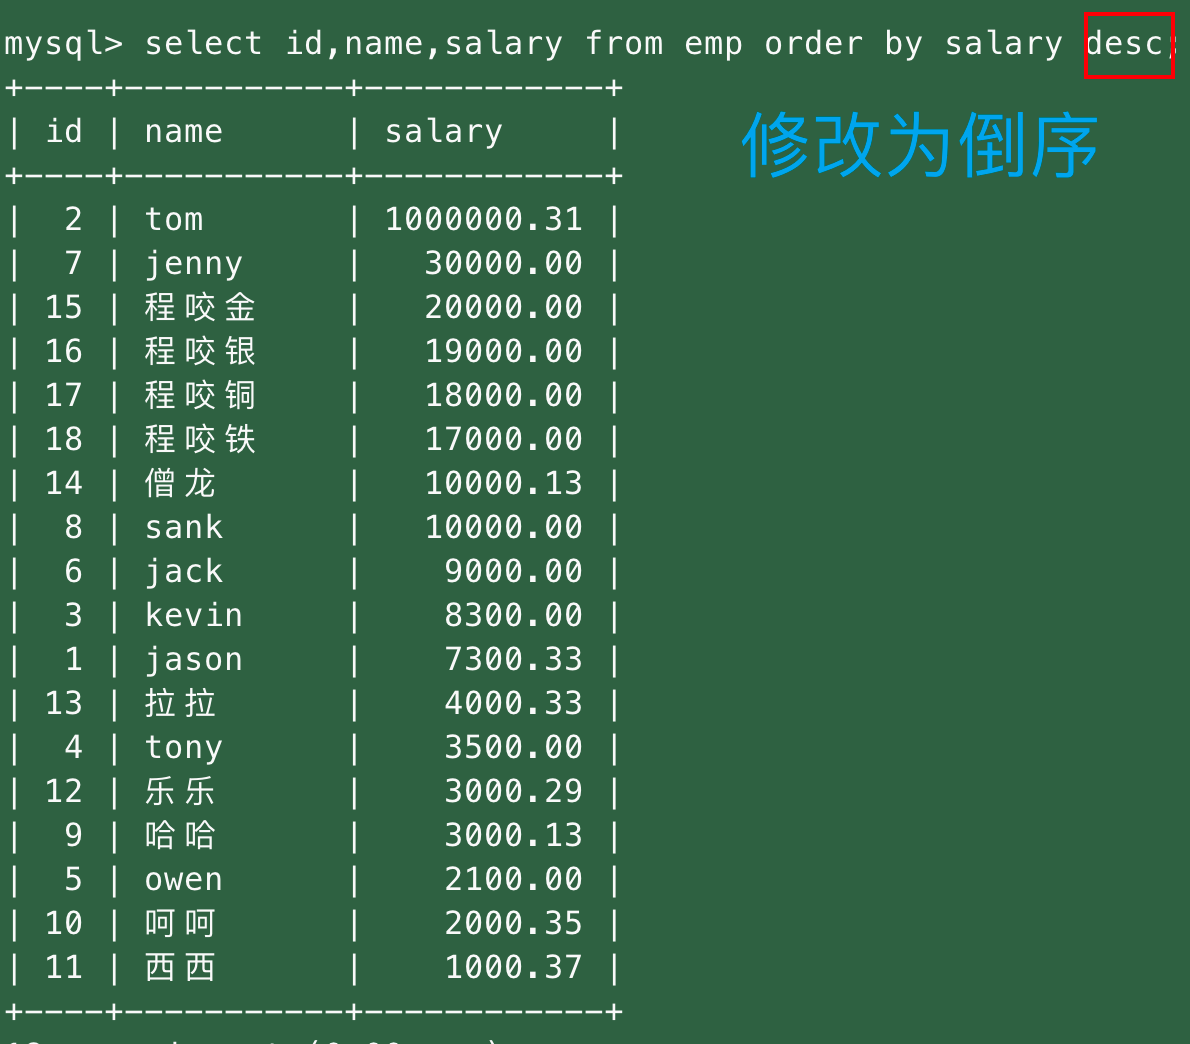
ordery by用于对查询结果进行排序
默认的排序是按照主键进行排序的
(1)单个字段排序
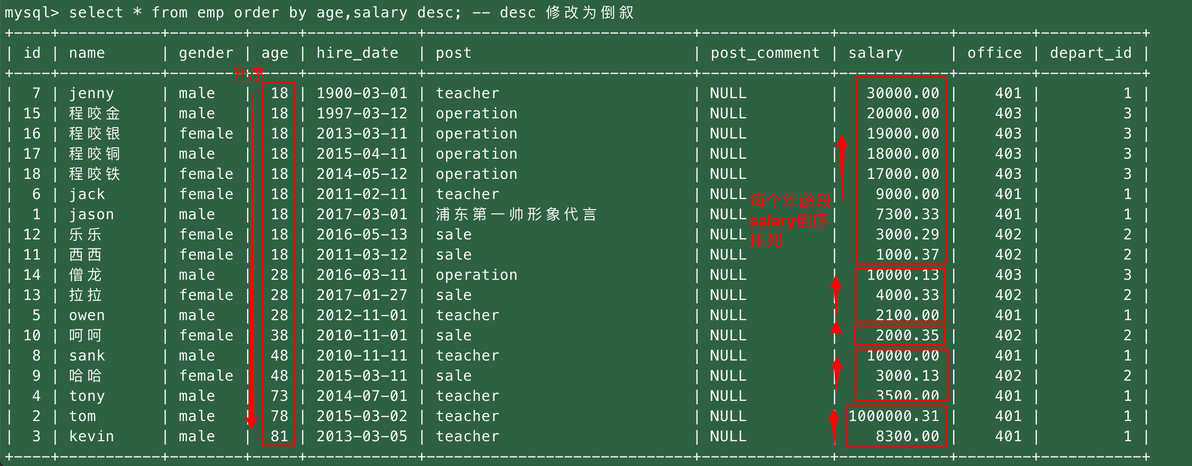
(2)多个字段排序
先按照一个条件升序排列,相同的情况下再按照薪资降序排列
1)例1:统计各部门年龄在10岁以上的员工平均工资,并且保留平均工资大于1000的部门,然后对平均工资进行排序
当一条sql语句中重复使用聚合函数计算的结果的时候,我们可以通过as起别名节省操作 用as 起别名,可以节省调用次数,也就是节省了底层运行效率
8.limit分页
limit用于控制显示的条数
当表中数据特别多的情况下,不会一次性展示所有的数据
比如:网站的分页出来,一次只展示固定数量的数据
(1)limit num 直接限制展示的条数
(2) 限制展示范围
表示至展示结果中的 排序为的数据
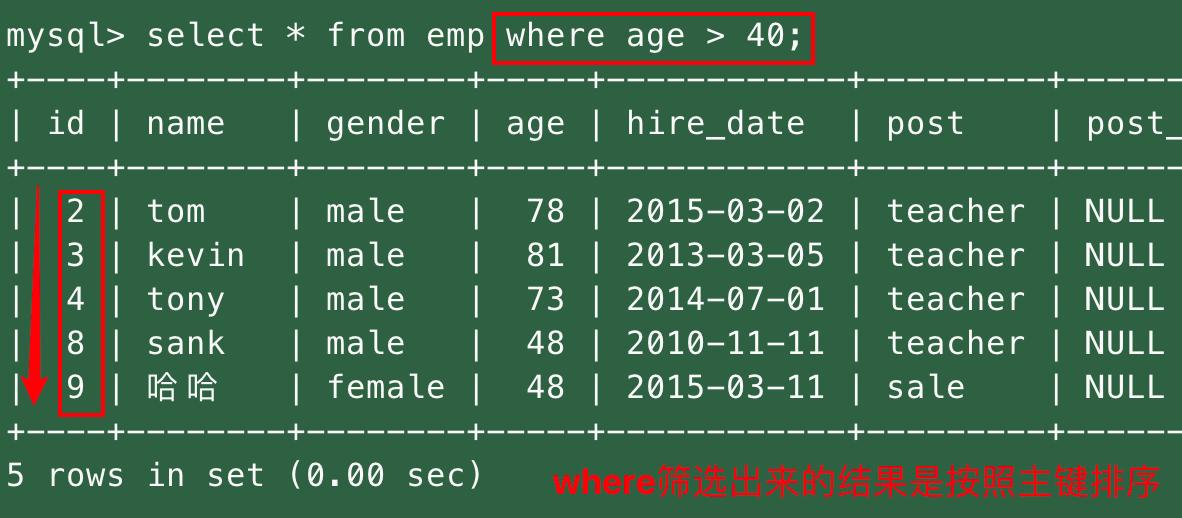
(3)limit展示的结果与筛选结果的顺序有关
比如:where筛选的结果,按照主键的顺序来排列的
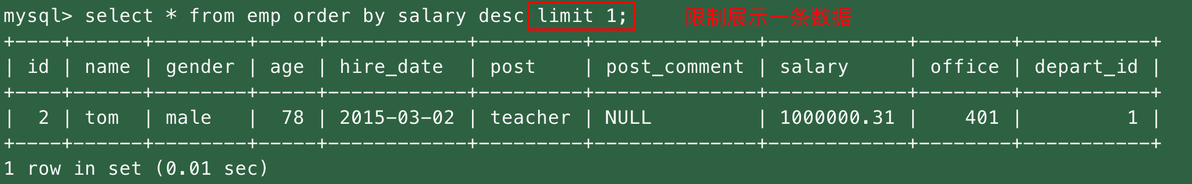
(4)通过limit来限制查询的信息
查询工资最高的人的详细信息
9.regexp正则表达式
SQL语句的模糊匹配如果用不习惯 也可以自己写正则批量查询
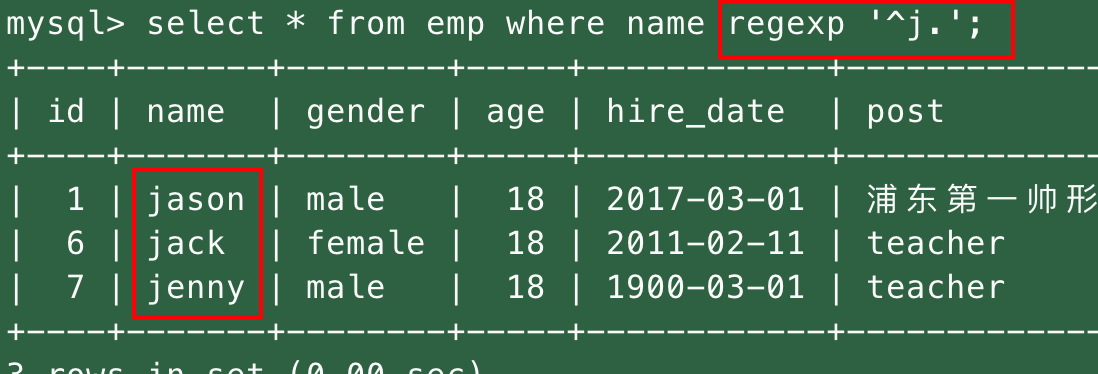
正则表达式报错

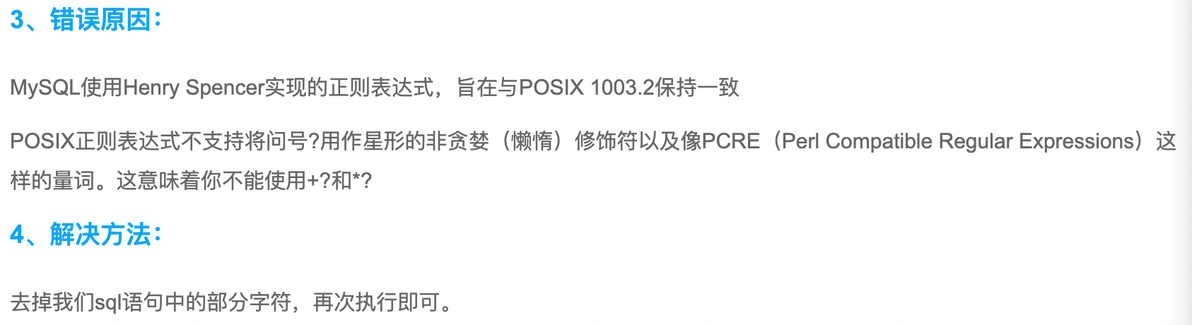
在MySQL中并非所有的正则表达式都可以使用,所以我们需要看是否编写的正则表达式符合MySQL的正则要求
链接:https://www.dianjilingqu.com/622336.html
