
笔记整理:
kelly,一线软件开发工程师,主要关注bsp及性能稳定性方面。
晓俊,某银行infra架构师,主要关注linux性能优化,内存管理和网络子系统。
一、性能可观测工具在Android系统性能优化中的应用
本次分享将通过对经典案例“camera启动出图延时”的分析,了解性能可视化工具在手机系统优化中的作用。
性能问题刨析可以采用工具systrace、dumpsys、adeb、perf、bcc来进行刨析。
1.systrace
在利用systrace进行本案例分析时,有如下发现,从图中可以看出camera对应的进程/线程长时间处于Runnalbe状态
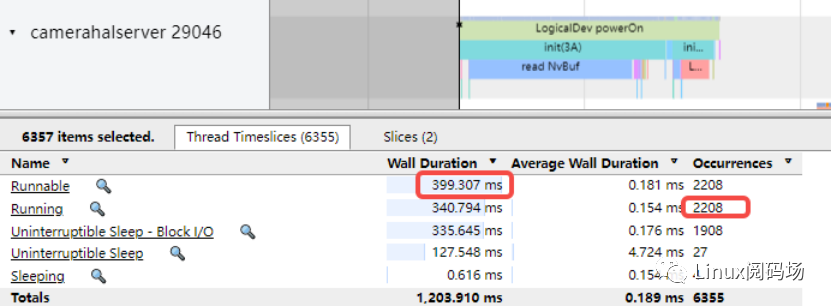
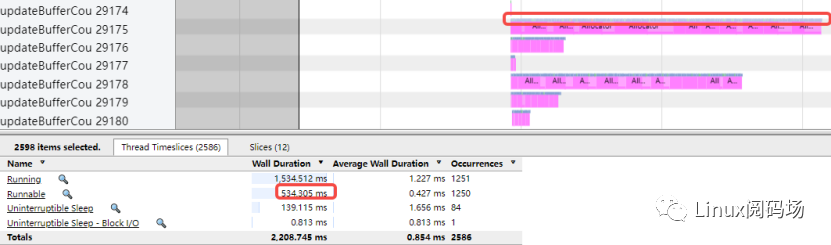
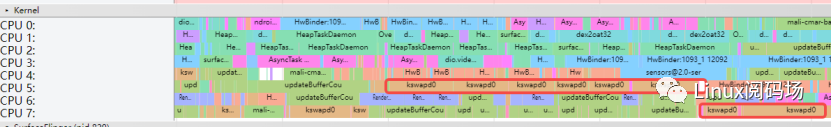
紧接着查看CPU到底在干什么,为什么没有调度camera相关进程/线程,其CPU使用情况如下,从下面图中可以看出,对应CPU正在调度kswapd,说明此时可能因为内存不足导致了camera启动出图延时。
2.dumpsys
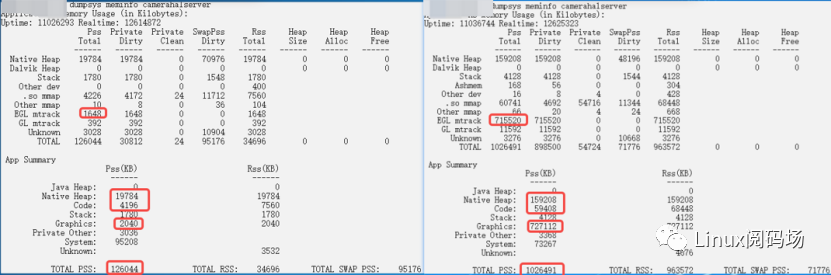
既然从systrace发现是内存导致的出图延时,那此时非常有必要通过命令dumpsys meminfo查看对应进程/线程的内存实用情况,下图左侧是启动camera前的内存使用情况,右图是启动后的内存使用情况,从图中可以看出,启动前后PSS相差大概1G(1026491-126044),此时我们可以大胆猜测,1s内申请内存约1G,大概率内存申请走了慢速路径,此时需要观测进程/线程申请内存情况。
3.adeb
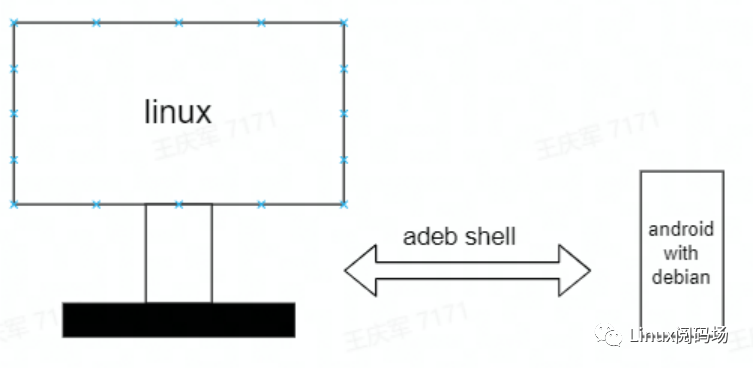
根据上面的分析,发现需要深入查看申请内存的情况,在此需要先引入adeb,如下图所示,需要在android系统中,构建了一个命令行的debian系统,集成了perf、bpftrace、bcc很多通用的内核分析工具,然后我们可以pc通过adeb shell同手机进行连接。
4.perf
Perf使用方法如下:
$ adeb shell
// camerahalserver pid
# perf record -g -p 1090
# perf report
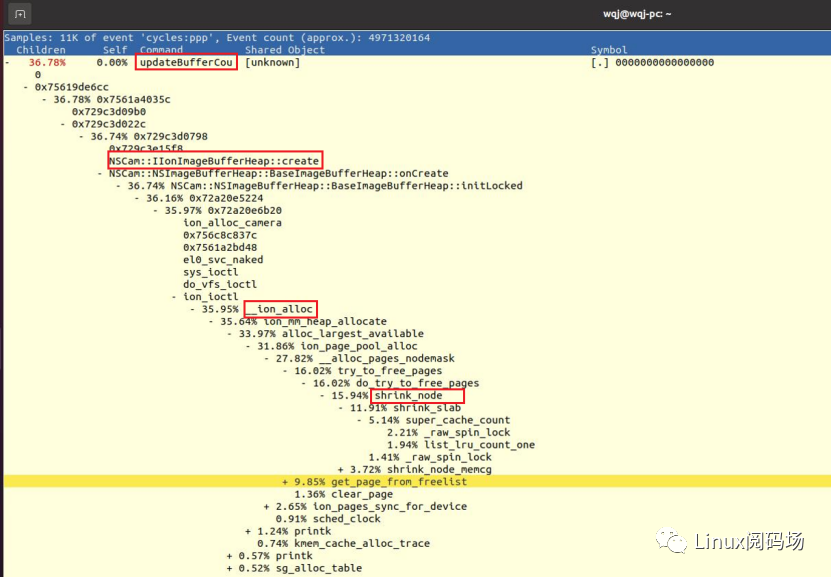
其结果如下图,图中已经采用红色方框选中了关键内存,其中shrink_node说明内存的申请确实采用了慢速路径,此时我们往上找,可以发现IIonImageBufferHeap在申请内存,可以让相应的技术人员去确认需要这么多内存的原因,看是否有优化或规避的方案;同时也可以向下去尝试提升内存分配效率。
5.存量-流量模型
内存的管理中,有内存回收,内存申请,内存回收会导致存量增加,内存申请会导致存量减少,当要使camera出土不延时,需要保证内存的存量+ 内存回收速度 * t >= 内存申请速度 * t(t = camera出图耗时)。
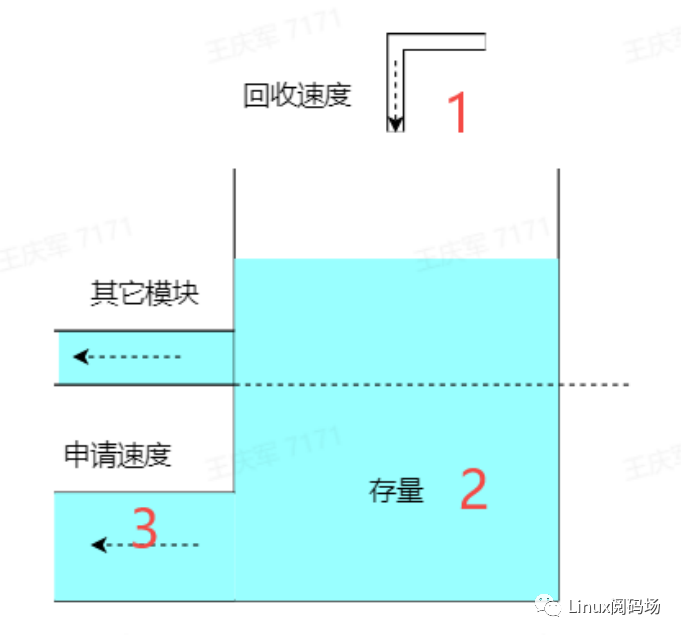
因此我们可以从存量,回收,内存申请速度三个角度考虑进行内存的优化方案,并进行部署测试。
6.bcc
编写bcc程序查看打开camera时的内存分配延时(ns),作为优化的量化指标,通过这个指标,可以很明确的了解优化方案的情况,当然也可以直接采用手机查看camera是否还存在出图延时来了解优化方法的情况,在此我主要介绍下量化指标方式。
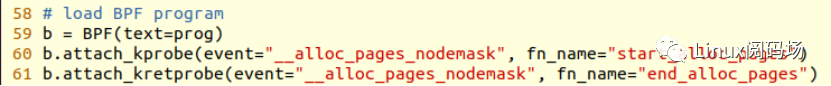
通过上图中的attach_kprobe和attach_kretprobe方式来进行打桩,这样在内存申请前后,通过在打桩函数start_alloc_pages和end_alloc_pages内部调用bpf_ktime_get_ns来获取对应的时间,具体的函数实现如下图所示:
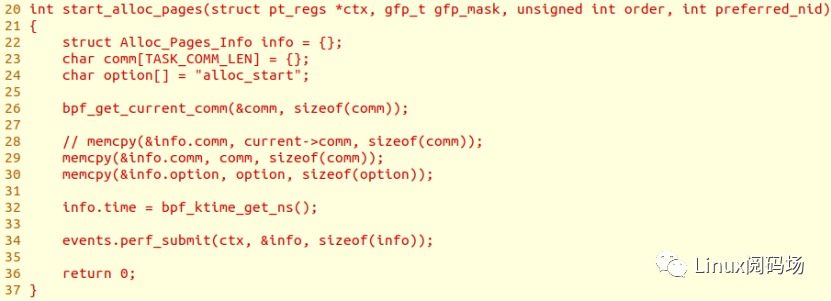
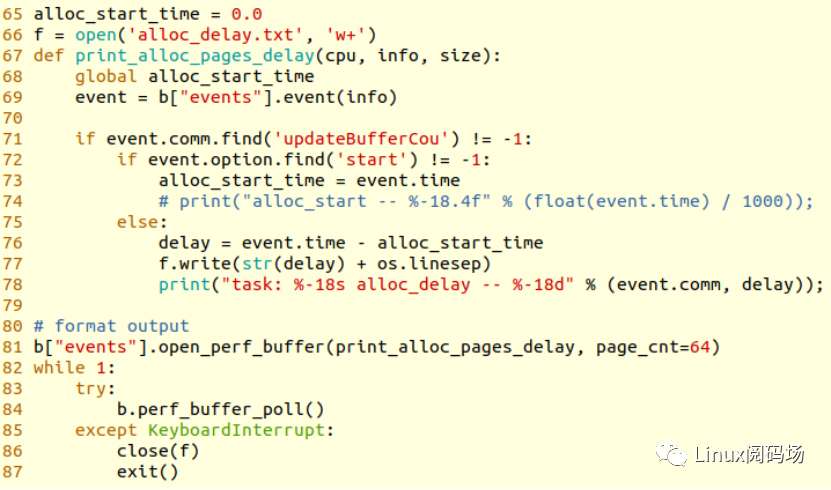
上图函数中的两个时间的差就是内存申请的延时时间。注意有很多进程/线程都会调用内存申请函数,此时就需要调用event.comm.find('updateBufferCou')来过滤出我们需要的进程/线程,进而计算出内存申请的延时,具体实现如下图:
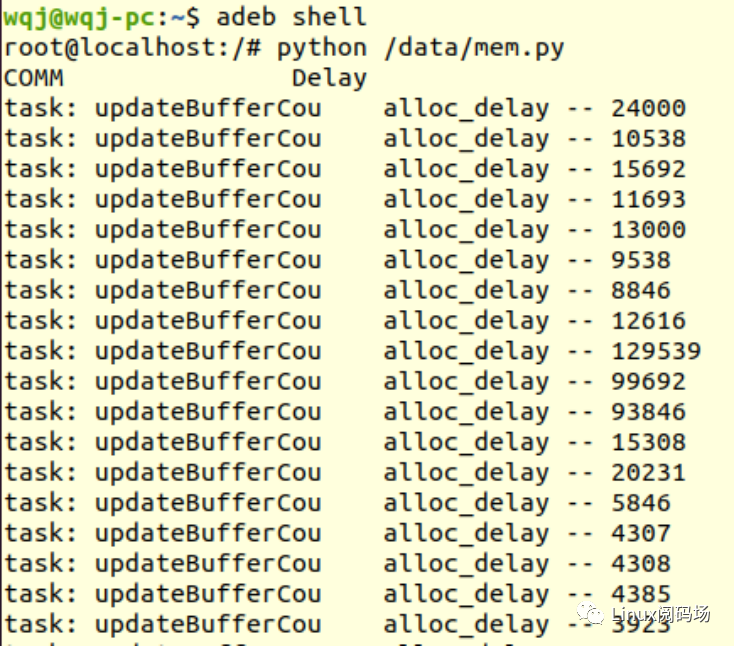
下图是我本地运行的情况,供大家参考
二、使用CoreSight技术调试Linux内核
1.关于CoreSight技术背景
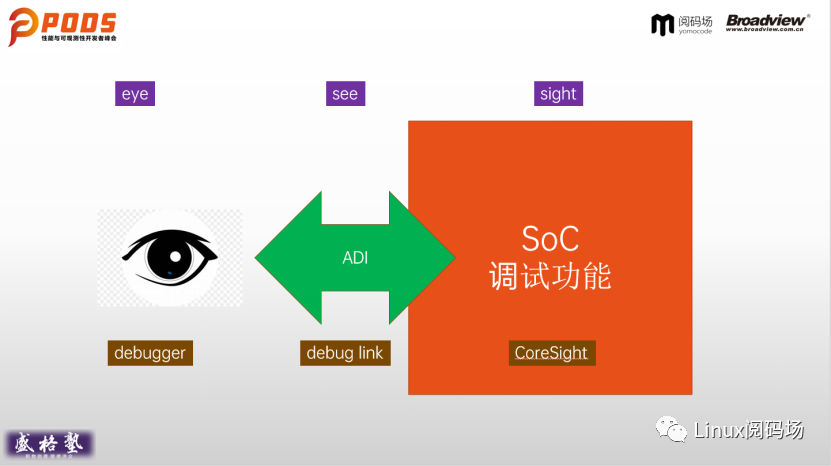
Coresight很少有人翻译成中文,没有确定的中文翻译还,我认为翻译成核景比较合适,是调试cpu底层的技术。
Arm coresight 就是通过这个技术让soc核心对于外界可观察。如今的芯片动辄几十亿的晶体管,如果有晶体管出问题,那将是致命的,所以芯片的可观察性也是十分重要的,那coresight说白了就是arm公司设计的增加芯片可观察性和可控制性的技术。
让cpu对外界可观察。如果要把coresight用起来,我们还需要了解ADI技术——高级调试接口。Coresight和ADI相辅相成。
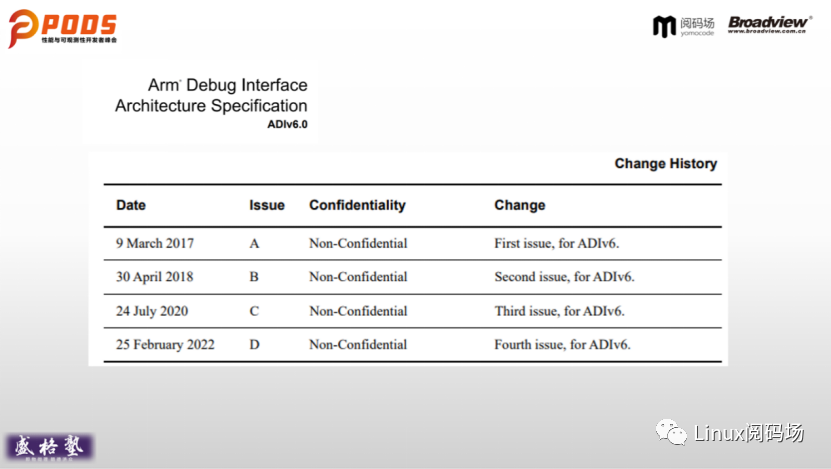
Coresight+adi核心中的核心arm积累起来。
Arm这两年无论是从指令集角度来看还是从调试技术角度看都是十分强悍的。
当前主要版本是adiv5版本,最新的是adiv6版本。
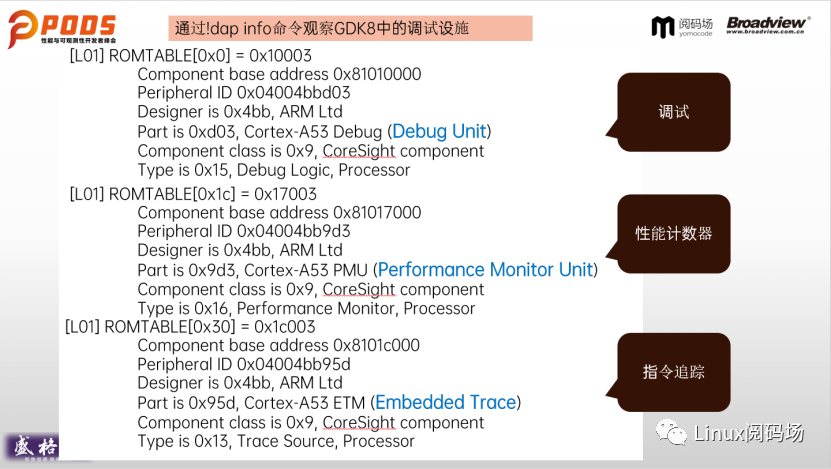
在这个框架下,SOC里面每个核心部件都是可观察可控制的。所以当我们架起来这个环境以后,我们可以执行!dap info这个命令。可以看到SOC内部有哪些coresight组件。如:Debug unit :通常就是用来调试CPU,给CPU设置断点。可以在调试状态下,让CPU执行指令。
Perforname Monitor unit:性能计数器。
Embedder trace:指令追踪技术。
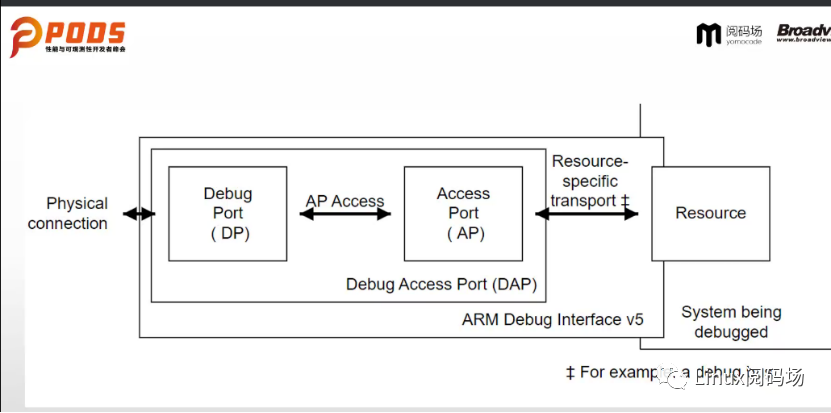
ADI 分为DP+AP,所以DAP命令即是DP+AP的简称。
DP调试端口,往主机端对接,对接调试器。
AP访问端口,往目标端对接,对接coresight组件。
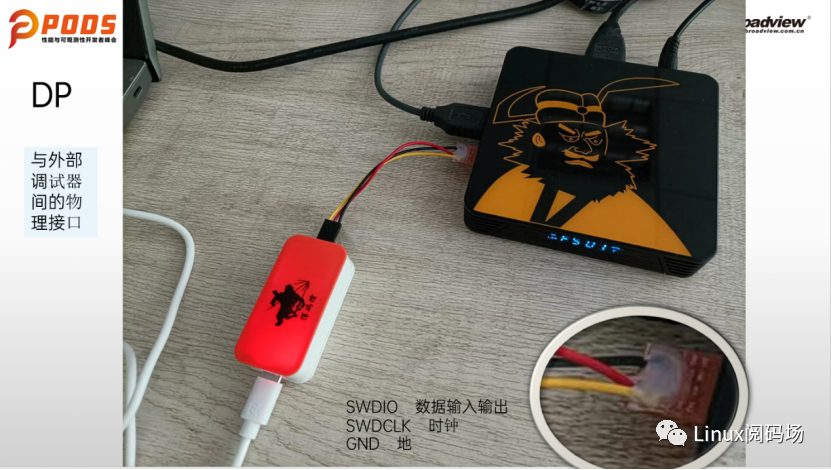
目前SOC内部已经实现了DP+AP(晶体管级别的实现),当然还需要外围的实现。一般有几种方式:
1.JTAG方式。
2.Arm的SWD方式。
Arm竞争力强,成本低。
Arm SWD 三根线普通,很便宜。
产业级别应用:
早期测试:基本是用coresight来封装测试。
刷机:arm刷机也是靠coresight技术。
还有Debug等也是coresight技术的核心应用。
2.用CoreSight技术调试Linux内核
Linux内核有很多软肋,在我看来它比较大的一个缺陷是它的调试的功能较弱。
长期以来主要调试靠想,靠printK。
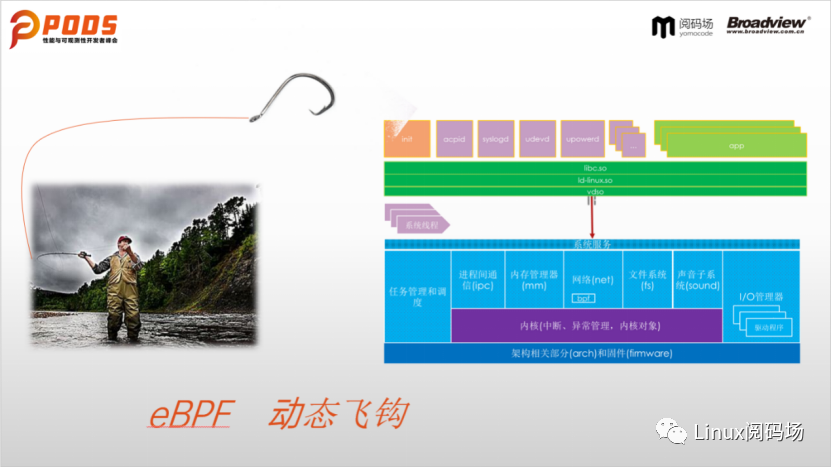
弥补printk的不足,近些年推出:ebpf和bcc(很精准的编译一小段代码,然后勾到内核里去,对内核版本要求很严格,因为如果不严格,kernal容易panic)——基于钩子技术。
我给大家提供一个新方法:经典内核调试器方式——真正的交互式调试。
是想在哪里停下来,它是真的停下来。
而bcc是走到哪里打印一下,如果我们没打印到我们想看那就做不到了,那就要重新挂钩,重新写bcc的脚本了。
KDB 或者KGDB
KDB不支持源代码级别调试。
他们从可控制性方面肯定是优于ebpf的,而不流行的原因在于:
1.环境在虚拟机容易搭起来,而在真实环境很难搭起来(真机环境下串口不常有)。
2.调试命令不够用。(因为前身GDB是源代码级别的弱调试器,定位是解决源代码级别的简单问题,而不是解决linux内核可能有的bug,这个难度不在一个数量级别上)
所以当前针对内核开发者的调试器是比较欠缺的。
而基于coresight技术实现的内核调试器能够满足KDB和KGDB的不足。
硬件断点各厂商支持数量:
Intel :4个。
Arm手册:不确定数量。
Soc厂商:6个。
直接把地址传给coresight
比如网络:
设置tcp sendmsg:
设置驱动层断点
基于微软vscode前端:
第一次断下来之后要.reload一下,加载一下符号:
Reload之后就可以看内核空间的模块列表。
命令:lm就可以看到内核空间的,lk代表linux kernal。
Bcmdhd:wifi驱动。
符号大约占300多M。
WIFI 模块现在显示还没有加载符号,可以X一下。
命令:X bcmdhd!*sendpkt (精准显示)
而命令:X bcmdhd!*send*则会显示多一点,毕竟模糊匹配了。
如图,对wifi里面sendpkt这个比较关键的函数设置硬件断点。
此时可以执行K命令,但没看到很多栈帧。因为每个函数有一个序言,开头有两条指令是建立所谓的栈帧的。此时可以单步两次。
跳过建立栈帧的过程。
再执行K命令再观察。
K命令默认显示20条,要显示更多,命令:K 100
Lk!el0_svc表示来自Arm架构上特权级别0的一次调用(系统调用):
Lk!_arm64_sys_sendto :经过arm的系统服务层,要查一张表,到arm入口,再到通用的代码net子系统,依次再到协议栈,协议栈再往下就到链路层,就到我们的WIFI驱动。
以上是第一个演示。
第二个演示:关于内存分配
X lk!mm
X lk!*page_fault
内核分配策略哲学思想笔者认为:
Linux比较倾向于佛系(不缺内存的时候我不做事情),优势:省电。
Windows内核,儒系(频繁收集内存)。
可以观察下Shrink_slab函数:
当物理内存不够用了,开始需要释放物理页了。
如下图,可以看到该Shrink_slab函数:
我们在这里埋一个断点:
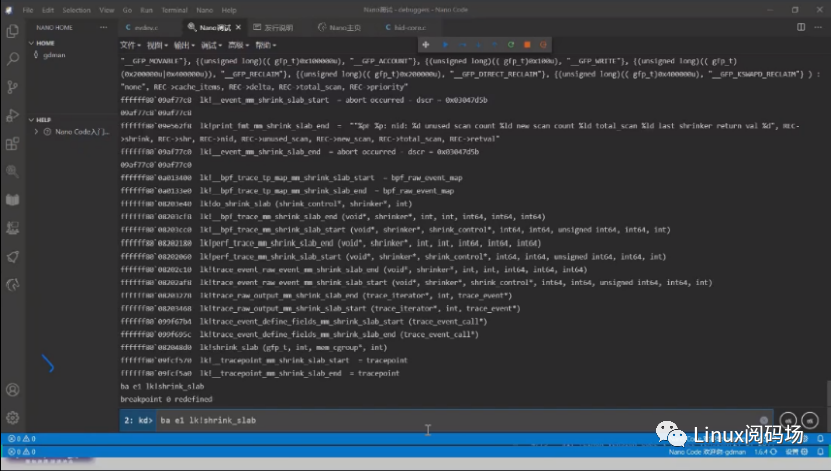
其实触发一个物理内存不够用的断点挺难的,因为如果应用程序去触发它,应用程序是低优先级的,而Camera是通过IO机制去分内存,这时候是内核用高优先级的一些分配策略,会更容易触发到该函数。
观察一个更频繁命中的do_page_fault:
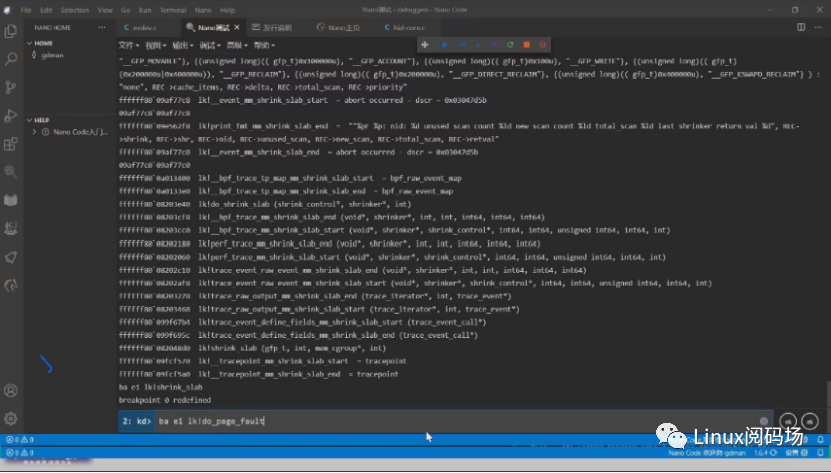
Cpu会频繁访问页表上去查虚拟内存如何对应到物理内存,如果发现一个虚拟页没有对应上,就会报Page fault错。
命令:g一下发现立刻命中。
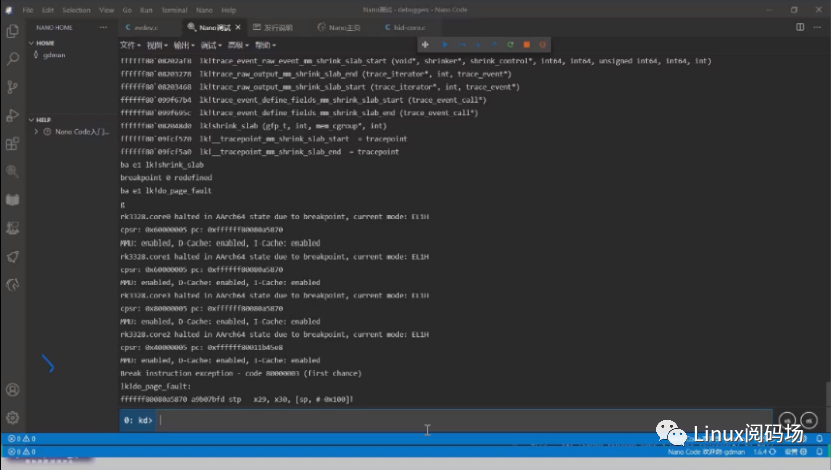
命令K:
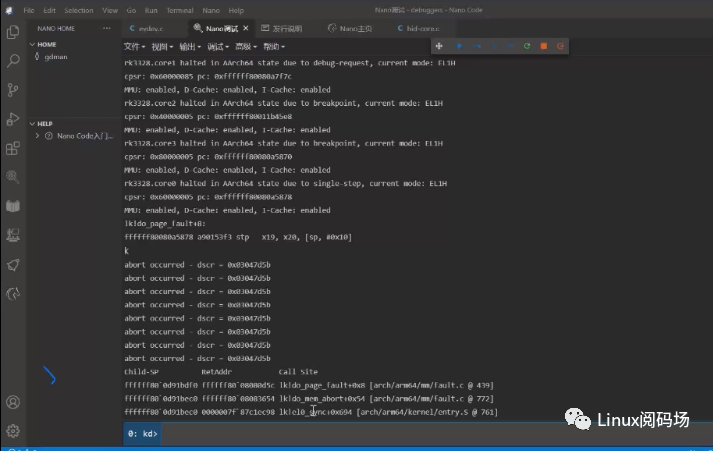
发现异常场景是说:某个程序访问了一个不在物理页的内存,这时候出现了异常。
第三个实验:Cpu切换机制
一般来说:内存紧张,回收内存,cpu就紧张,连锁反应。
来看下命令:x lk!*switch_to*
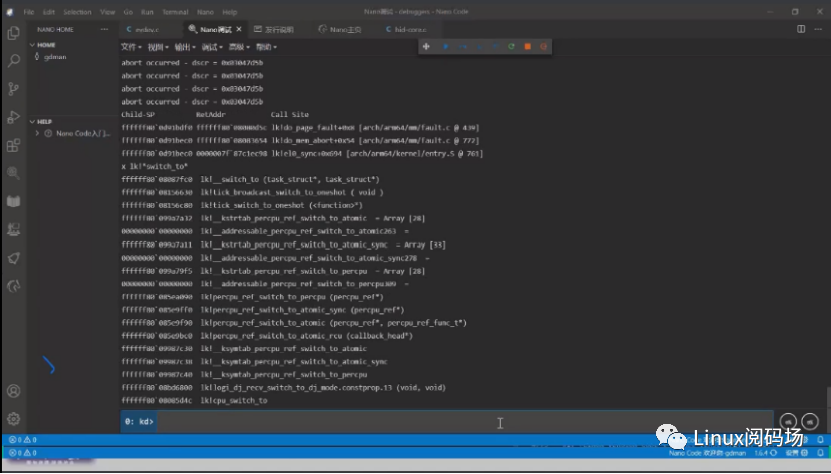
我们可以在switch_to这个函数这里设置一个断点。
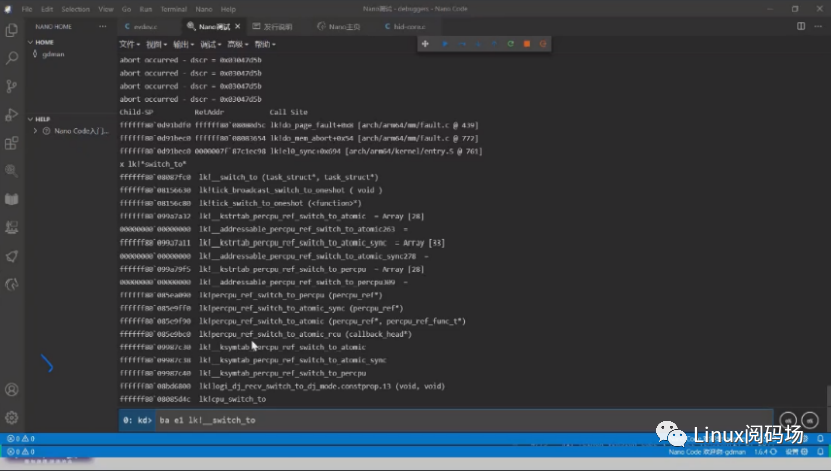
发现命中了,然后再K下看:
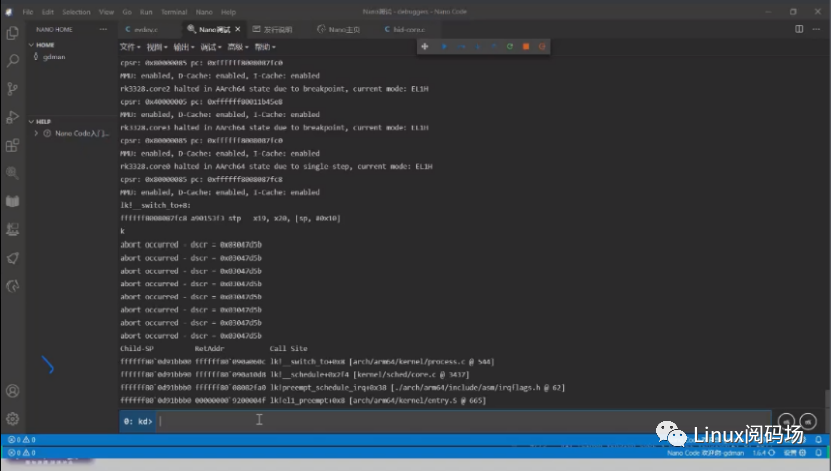
看下是谁在切线程,发现是抢夺机制(抢先式多任务调度)。
抢夺机制,当时间片用完时发生,也叫preempt multi-tasking。
同时观察下源代码:
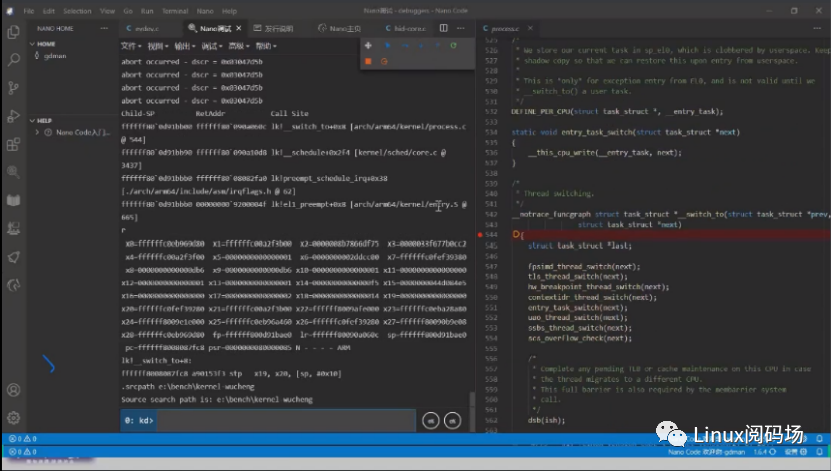
这里有很多switch,调了很多子函数,每一个都可能花微观意义上的几百个时钟甚至几千个一个时钟大约小于1纳秒,所以2000个时钟大约1000个多纳秒,大约1微妙,在某个C程序中,可能就几个微妙了。
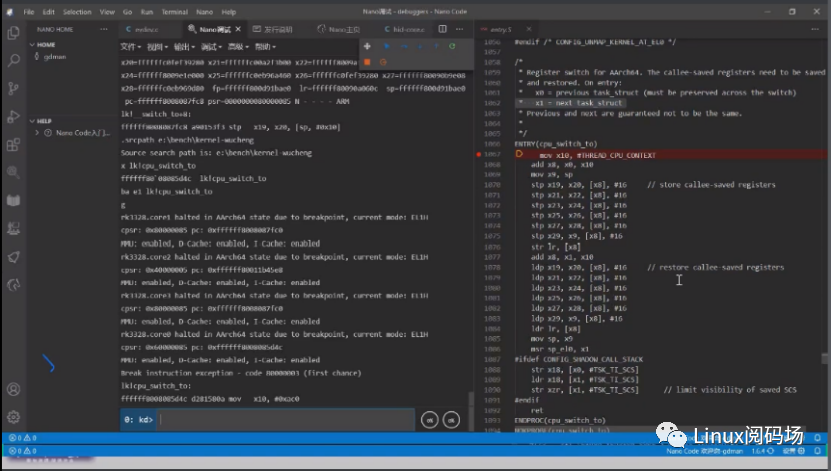
这里是cpu_switch_to设置断点。
把前一个寄存器的上下文保存,把新的load到内存里面,这些最敏感的都是用汇编写的。
Arm寄存器的用法也是有比较多有意思的地方:
比如传递参数是X0-X3寄存器(如果参数再多就改用栈来传递):
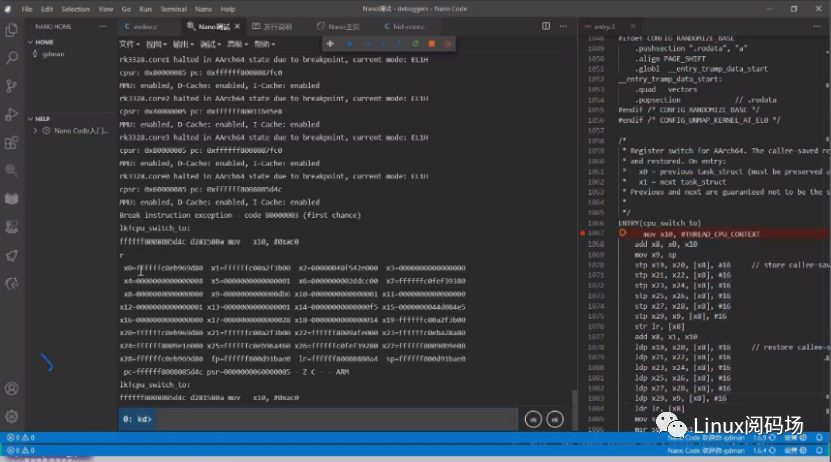
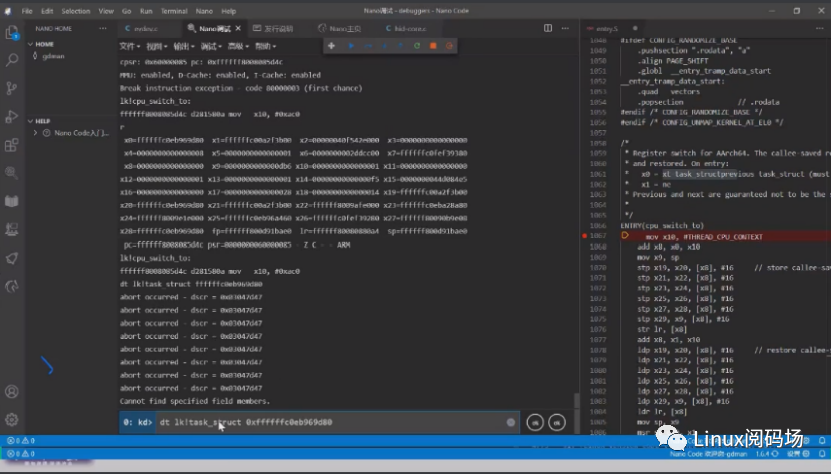
我们这里X0就代表前一个线程的task struct。
通过DT命令观察这个庞大的结构体:
用COMM表达当前进程主程序的名字:
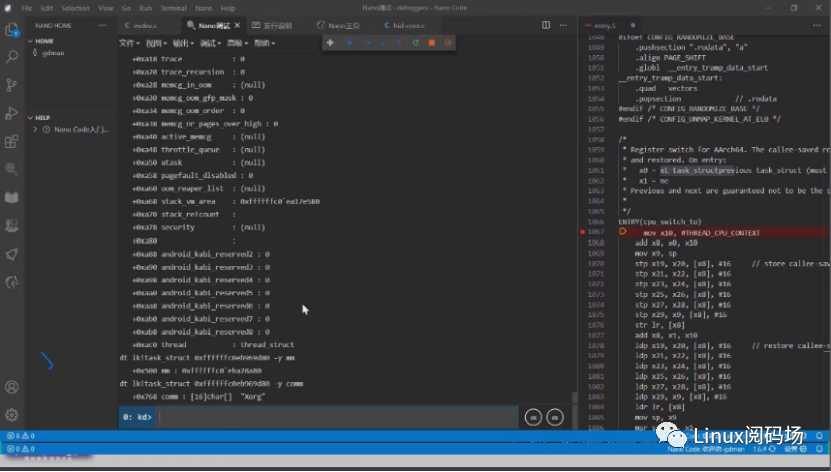
表示刚刚发生了一个抢先调度,是Xorg被抢了。
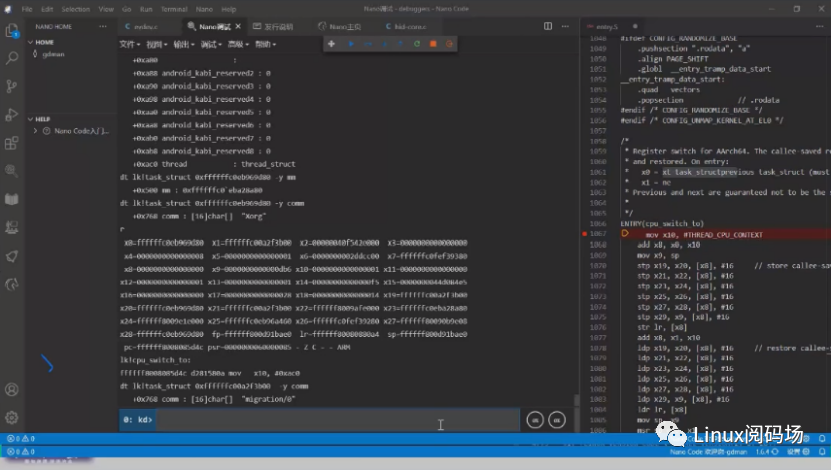
发现这次内核切线程是切给migration/0,用来线程迁移。(0号cpu在做切换,切到migration上,为0号cpu的系统线程,系统线程只在内核空间跑,不在用户空间跑,比用户空间线程优先级更高)。
