
重要,需要掌握
一、什么是索引
MySQL官方对索引的定义:索引(Index)是帮助MySQL高效获取数据的数据结构。
由此可知,索引的本质是数据结构。
就好像是字典前面的根据拼音和偏旁部首查找具体汉字页数的索引一样,可以大幅提升查找的效率。如果没有索引的话,在查找一些数据时,就需要遍历所有数据来进行查找,麻烦且效率低下。
MySQL中的索引可以理解为:排好序的能快速查找的B+树结构。
注:B+树中的B不是二叉(binary),而是平衡(balance)
二、索引的分类和基本语法
索引可分为三类:唯一索引、单值索引、复合索引。
1、唯一索引
指索引列的值必须唯一,但允许有空值(NULL可以出现多次)。
就好像是人的身份证号对应这个人,只能是一对一的关系,
每个数据库表的主键就是一个唯一索引。
2、单值索引
即一个索引只包含单个列,一个表可以有多个单列索引。
以员工列表中的员工姓名列(name)为例,允许有重名的情况出现,如果有两个人名字是张三,那么对姓名为张三进行查询时,就会有两个数据。
3、复合索引
即一个索引包含多个列。
索引的基本语法如下:
创建索引:
CREATE INDEX indexname ON tablename (columnname(length))
或
ALTER TABLE tablename INDEX indexname ON (columnname(length))删除索引:
DROP INDEX indexname ON tablename 查看索引:
SHOW INDEX FROM tablename
三、MySQL索引结构
B树:Balance Tree 多路平衡查找树
B+树:加强版多路平衡查找树
MySQL中的索引使用的数据结构是B+树。
数据结构有很多种,在MySQL索引中为什么选用了B+树?
可以从数据操作,也就是增删改查、分组排序的时间复杂度来判断。
数组?:
数组在查找方面效率很高,根据角标查询数据,时间复杂度为O(1),但如果发生了插入和删除,整个数组的角标都会变化,时间复杂度为O(n),效率很低。
哈希表?:
哈希表是由键值对组成的,其增删改查的时间复杂度都是O(1)。
但问题是,哈希表是无序的键值对,也就是说,如果发生了需要排序的操作,就需要遍历所有数据,效率低,不适合使用。
注:InnoDB数据库引擎,直接就不支持哈希索引。
二叉树?:
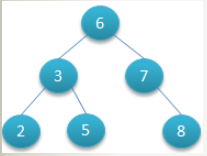
普通二叉树
二叉树每个节点有两个子节点,点数小于本节点的在左边,点数大于本节点的在右边。
就增删改查操作来说,哈希比树的操作更快,但二叉树有排序操作。
对于上图来说,查找一个数据,最多进行三次查找,增删改查的时间复杂度为O(log(n))
但是,普通二叉树是静态的,导致其并不稳定,各个节点添加后就无法修改优化,也就是说,可能会有下面的情况出现:
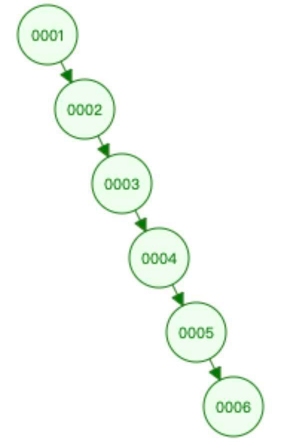
最糟情况下的普通二叉树
由此可见,静态的普通二叉树并不稳定,可能会出现以上情况降低查询效率。
平衡二叉树(AVL)?:
相比于普通二叉树,平衡二叉树会通过自旋来实现动态变化,是自身的结构稳定了下来。
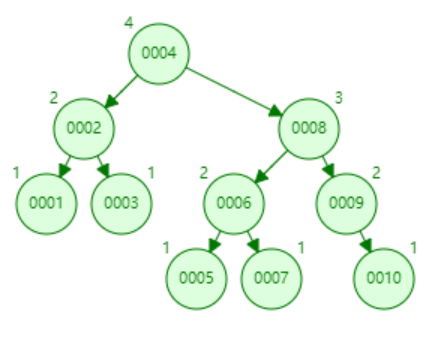
平衡二叉树动态改变节点保持稳定
到了平衡二叉树这里,各个操作的时间复杂度都已经相对稳定,且时间复杂度均为O(log(n))。
但如果还能进一步降低树的高度,就能减少IO的次数。、
B树?:
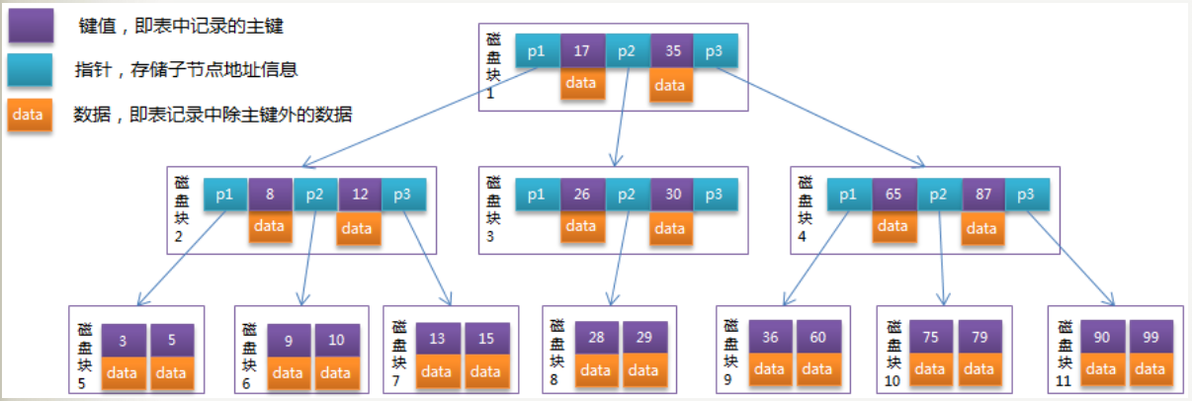
二叉树中,每个节点仅能有一个数据,B树中可以有两个(三叉树)。
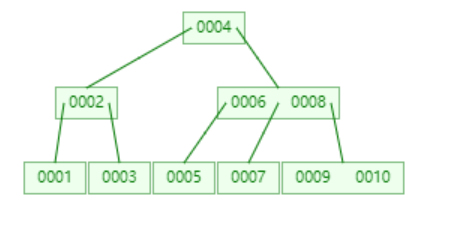
相比于二叉树,少了一次IO操作,提高了查询效率。
但是——
B+树(√):
这是B树的检索原理:
B树的检索原理
在B树中,每个磁盘块中键值和数据存储在一起。
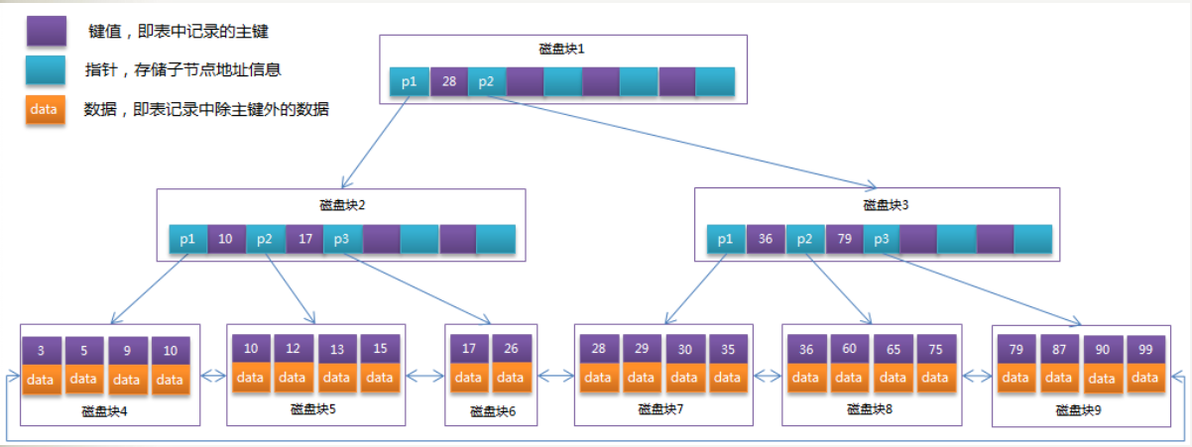
B+树的检索原理
B+树中,单独将数据(data)取出,排序放在磁盘块中,使得上面的一个磁盘块中能够存储更多的指针和键值,进一步降低B+树的高度。
相比于B树,B+树的所有数据都存储在叶子节点中,非叶子节点只存储键值信息,所有叶子节点间都有一个链指针来排序。
优点:
1、单磁盘块存的更多,进一步减少了数据查找时要进行的IO次数
2、B+树的数据按顺序排列,使得范围查找,排序查找,分组查找,去重查找变得非常简单。
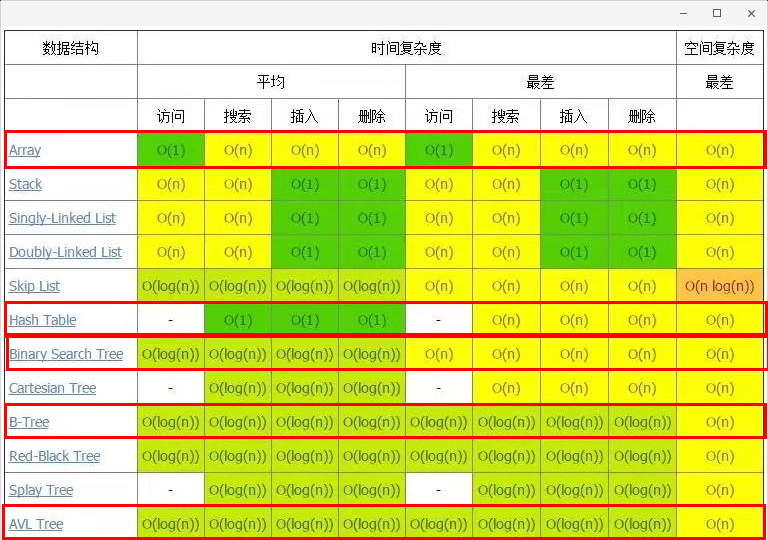
各个数据结构时间复杂度
索引的优劣势:
优势:① 提高数据检索的效率,降低数据库的IO成本。
② 通过索引列对数据进行排序,降低数据排序的成本,降低了CPU的消耗。
劣势:① 索引提升了查询速度,但也降低了更新表的速度,如INSERT、UPDATE、DELETE。因为更新表时,不仅要保存数据,还要保存索引文件中每次更新添加了索引列的字段,调整因为更新所带来的键值变化后的索引信息。
② 索引实际上也是一张表,保存了主键和索引字段,并指向实体表的记录,所以引也是要占内存的。
四、MySQL的查询处理
MySQL的查询处理,也就是使用EXPLAIN关键字模拟优化器执行SQL查询语句,从而得知MySQL是如何处理你的SQL语句的,由此来分析你的查询语句或是表结构的性能瓶颈。
EXPLAIN + SQL语句  如:
EXPLAIN SELECT * FROM tablename执行EXPLAIN所获得的信息:

注:由于Mysql5.5/5.7/8.0底层做了不同优化,不同版本下性能表现不同。
根据上述数据,我们可以得到:
1、表的读取顺序
2、数据读取操作的操作类型
3、哪些索引可以使用
4、哪些索引被实际使用
5、表之间有哪些引用
6、每张表中有多少行被优化器查询
① id
id是select查询的序列号,包含了一组数字,表示查询中执行select子句或操作表的顺序。
有三种情况:
id相同,执行顺序由上至下。
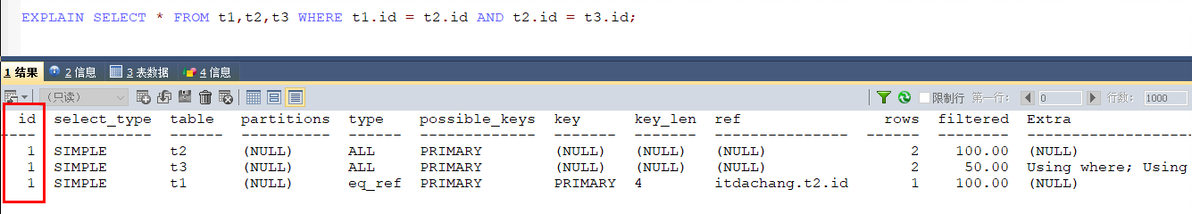
id不同,如果是子查询,id的序号会递增,id越大优先级越高,越先被执行。
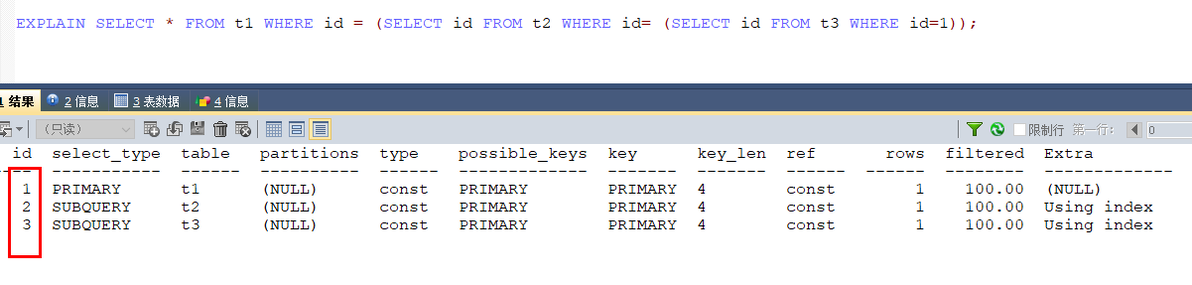
id相同的由上至下执行,不同的,id越大越先执行。
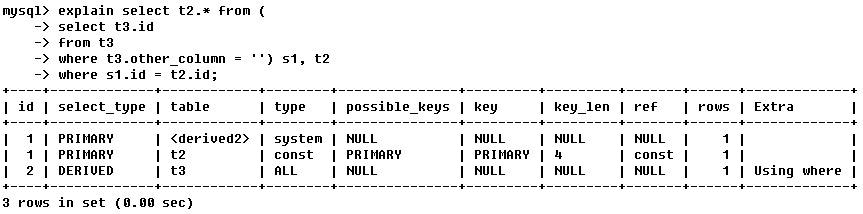
id的每个号码表示一趟独立的查询,一个sql语句的查询趟数越少越好
② select_type
代表查询的类型:
1、SIMPLE
最简单的select查询,查询中不包含子查询或UNION
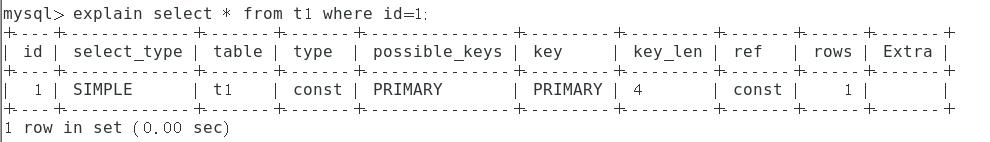
SIMPLE类型
2、PRIMARY和SUBQUERY
查询中若包含复杂的子部分,则最外层被标记为PRIMARY,在select或where中的子部分为SUBQUERY
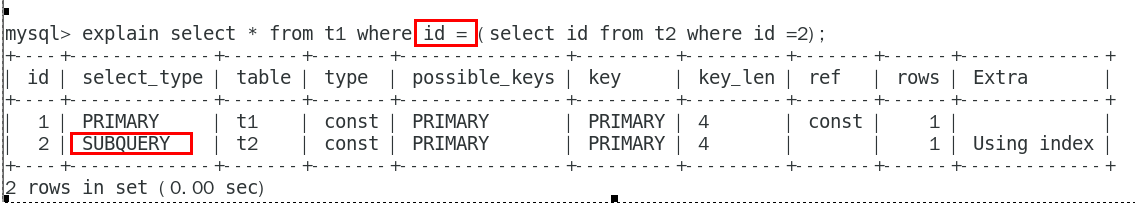
PRIMARY和SUBQUERY类型
3、DERIVED
在FROM中包含的子查询被标记为DERIVED(衍生),MySQL会递归执行这些子查询,将结果放到临时表中。
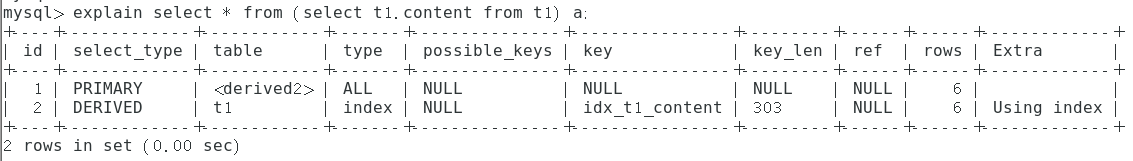
DERIVED类型
4、UNION和UNION RESULT
如果第二个select出现在UNION之后,则被标记为UNION;
如果UNION包含在FROM子句的子查询中,外层的select将被标记为DERIVED;
从UNION表获取结果的select就是UNION RESULT
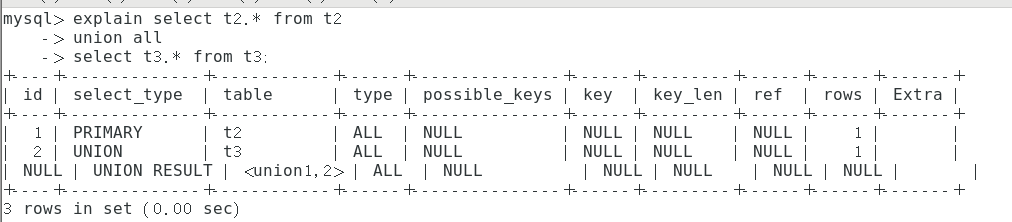
UNION和UNION RESULT类型
还有DEPENDENT SUBQUERY和UNCACHEABLE SUBQUERY,但不常用。
③ table
显示这一行的数据是关于哪张表的。
④ partitions
代表分区表中的命中情况,如果没有进行过分区操作非分区表,该项为null。
⑤ type
显示查询使用了何种类型,从好到差依次是:
system > const > eq_ref > ref > range > index > ALL
1、system:表中只有一行记录,属于const的特例,平时不出现,可忽略不计。
2、const:表示通过索引一次就找到了,用于比较主键或者唯一索引,由于只匹配一行数据,所以很快。如果将主键置于where列表中,MySQL就能将该查询转换为一个常量。
3、eq_ref:唯一性索引扫描,对于每个索引键,表中只有一条数据与之匹配,常见于主键或唯一索引扫描。
4、ref:非唯一性索引扫描,返回匹配每个值的所有行。一个索引键,可能会匹配到多个符合条件的行。
5、range:只检索给定范围的行,使用一个索引来选择行。key列会显示使用了哪个索引。一般出现在where中出现了between、<、>、like、in等的查询。
6、index:遍历索引树,比ALL快,因为索引文件比数据文件小。
7、ALL:遍历全表。
注:一般来说,需要保证查询至少要达到range级别,最好能达到ref
⑥ possible_key
表示可能应用在这张表中的索引,可能是一个或多个,只要查询涉及到的字段存在索引,该索引就会被列出,但不一定被实际使用。
⑦ key
表示实际使用的索引,如果为null,则没有使用索引;
查询中如果使用了覆盖索引,则该索引和查询的select字段重叠。
⑧ key_lenshiyi
表示索引中那个使用的字节数,可通过该列计算查询中使用的索引的长度;
根据它可以判断索引的使用情况,尤其在使用复合索引的时候,判断该索引有多少部分被使用非常重要。
⑨ ref
显示索引的哪一列被使用了,如果可能的话,是一个常数。
哪些列或常量被用于查找索引上的值。
注意,和前面type中的ref完全没关系。
⑩ rows
显示MySQL认为它执行查询时必须检查的行数。当然,值越小越好。
⑪ filtered
表示查询后从存储引擎返回的数据在server层过滤后,剩下多少满足查询的记录数量的比例,注意,该值为百分比,不是具体记录数。
⑫ Extra
包含不适合在其他列中显示但十分重要的信息。
1、Using where
表明使用了where过滤。
2、Using filesort(需要优化)
说明MySQL会对数据使用一个外部的索引排序,而不是按照表内的索引顺序进行读取,MySQL中无法利用索引完成的排序称为“文件排序”。
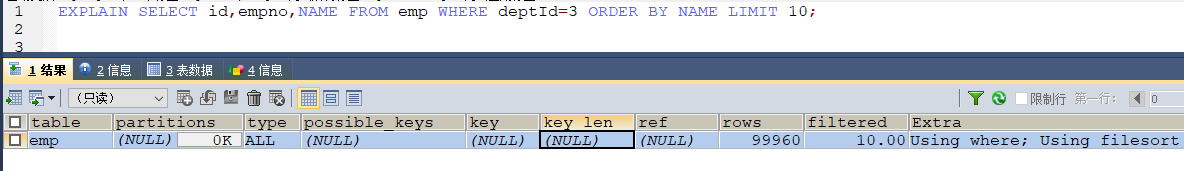
建立索引前
上图中未建立任何索引,在执行排序order by操作未建立索引的数据时,就会产生Using filesort,此时,建立索引即可完成优化。
CREATE INDEX index_deptid_name on emp(deptid,name);创建索引后:
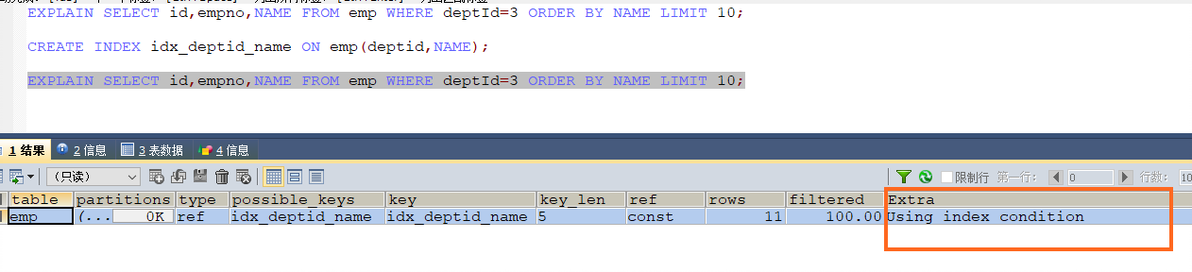
建立索引后
建立了的deptid和name的索引后,该排序就会使用索引,大幅提升效率。
3、Using temporary(需要优化)
使用了临时表保存中间结果,MySQL在对查询结果排序时使用了临时表。常见于排序order by和分组查询group by。
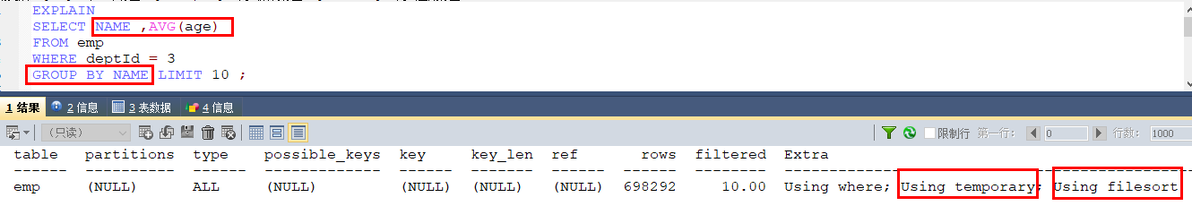
建立索引前
相比于上面的order by操作,group by操作要在where查询后对其进行分组操作再产生一张新表作为结果,也就是说,where查询的数据被形成了一张中间的临时表用于下面的操作,既然如此,就会发生Using temporary。
同样的,建立索引可以进行优化。
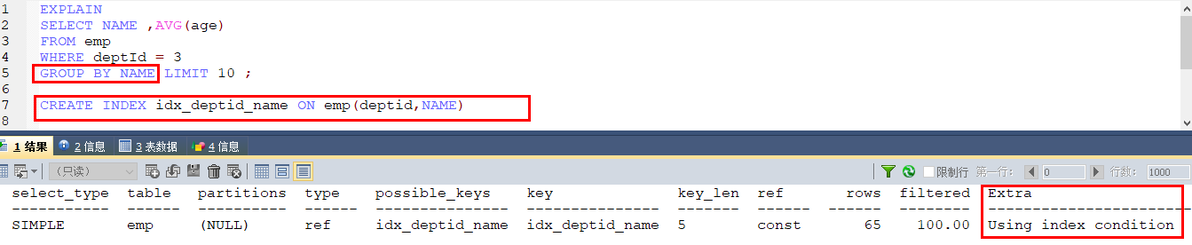
建立索引后
如图,建立索引后,完成优化。
4、Using index(无需优化)
表示响应的select语句中出现了覆盖索引,即查询字段正好和索引字段完全一致,避免了访问表的数据行。
效率很好,无需修改。
如果同时出现了using where,表明索引被用来执行索引键值的查找;
如果没有出现using where,则表示索引是用来读取数据而非执行查找动作。
