
T1 分糖果
题目背景
红太阳幼儿园的小朋友们开始分糖果啦!
题目描述
红太阳幼儿园有 n 个小朋友,你是其中之一。保证 n ≥ 2。
有一天你在幼儿园的后花园里发现无穷多颗糖果,你打算拿一些糖果回去分给幼儿园的小朋友们。
由于你只是个平平无奇的幼儿园小朋友,所以你的体力有限,至多只能拿 R 块糖回去。
但是拿的太少不够分的,所以你至少要拿 L 块糖回去。保证 n ≤ L ≤ R。
也就是说,如果你拿了 k 块糖,那么你需要保证 L ≤ k ≤ R。
如果你拿了 k 块糖,你将把这 k 块糖放到篮子里,并要求大家按照如下方案分糖果:只要篮子里有不少于 n 块糖果,幼儿园的所有 n 个小朋友(包括你自己)都从篮子中拿走恰好一块糖,直到篮子里的糖数量少于 n 块。此时篮子里剩余的糖果均归你所有——这些糖果是作为你搬糖果的奖励。
作为幼儿园高质量小朋友,你希望让作为你搬糖果的奖励的糖果数量(而不是你最后获得的总糖果数量!)尽可能多;因此你需要写一个程序,依次输入 n, L, R,并输出出你最多能获得多少作为你搬糖果的奖励的糖果数量。
输入格式
输入一行,包含三个正整数 n, L, R,分别表示小朋友的个数、糖果数量的下界和上界。
输出格式
输出一行一个整数,表示你最多能获得的作为你搬糖果的奖励的糖果数量。
输入输出样例
输入 #1
7 16 23
输出 #1
6
输入 #2
10 14 18
输出 #2
8
说明/提示
【样例解释 #1】
拿 k = 20 块糖放入篮子里。
篮子里现在糖果数 20 ≥ n = 7,因此所有小朋友获得一块糖;
篮子里现在糖果数变成 13 ≥ n = 7,因此所有小朋友获得一块糖;
篮子里现在糖果数变成 6 < n = 7,因此这 6 块糖是作为你搬糖果的奖励。
容易发现,你获得的作为你搬糖果的奖励的糖果数量不可能超过 6 块(不然,篮子里的糖果数量最后仍然不少于 n,需要继续每个小朋友拿一块),因此答案是 6。
【样例解释 #2】
容易发现,当你拿的糖数量 k 满足 14 = L ≤ k ≤ R = 18 时,所有小朋友获得一块糖后,剩下的 k - 10 块糖总是作为你搬糖果的奖励的糖果数量,因此拿 k = 18 块是最优解,答案是 8。
【数据范围】
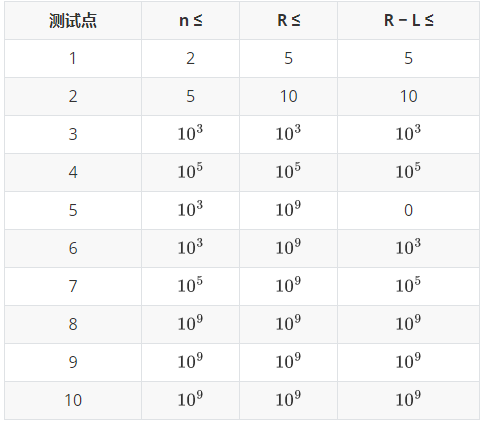
对于所有数据,保证 。
问题分析
问题本质:求在[L, R]区间内对n模数最大。
方法一:枚举区间内所有数,打擂台求最大值。
时间复杂度:
,期望得分70 分,CCF数据实测90分。
#include <bits/stdc++.h>
using namespace std;

int main(){
	int n, l, r;
	cin >> n >> l >> r;
	int ans = 0;
	for (int i = l; i <= r; ++i)
		ans = max(ans, i % n);
	cout << ans << endl;
	return 0;
} 方法二:观察区间内的余数,一般都是递增的,只有一种情况可能变小,即从 n - 1 变成 0,从前开始找并记录,如果出现递减就 break.
时间复杂度:
  #include <bits/stdc++.h>
  using namespace std;

  int main(){
  	int n, l, r;
  	cin >> n >> l >> r;
  	int ans = -1;
  	for (int i = l; i <= r; ++i){
  		if (i % n >= ans)
  			ans = i % n;
  		else
  			break;
  	}
  	cout << ans << endl;
  	return 0;
} 方法三:枚举模数0 - n - 1,检测该模数在[L, R] 内是否存在。
对于模数 x ,如果 x >= L % n,则模数为x的最小数为 L / n * n + x,否则为 (L/ n + 1) * n + x,再判断一下该数是否小于等于R即可。
从大到小检测,找到第 1 个能得到的模数就结束。
时间复杂度:
,期望得分:70分 - 100分,CCF数据实测 100 分。
  #include <bits/stdc++.h>
  using namespace std;

  int l, r, n;

  int main(){
  	cin >> n >> l >> r;
  	for (int i = n - 1; i >= 0; --i){
  		int x;
  		if (i >= l % n)
  			x = l / n * n + i;
  		else
  			x = (l / n + 1) * n + i;
  		if (x <= r){
  			cout << i << endl;
  			break;
  		}
  	}
  	return 0;
}方法四:如果区间长度大于n,解一定为 n - 1。当区间长小于n时,分析左右端点的模数ls, rs,如果ls > lr,解一定为 n - 1,否则解为rs.
时间复杂度:
,期望得分:100分,CCF数据实测 100 分。
  #include <bits/stdc++.h>
  using namespace std;

  int main(){
  	int n, l, r;
  	cin >> n >> l >> r;
  	int ls = l % n;
  	int lr = r % n;
  	if (r - l >= n || ls > lr)
  		cout << n - 1 << endl;
  	else
  		cout << lr << endl;
  	return 0;
} 方法五:也可判断左右端点整除 n 的值:lk, rk,如果lk = rk,则结果为右端点的模数,否则一定为 n - 1.
时间复杂度:
  #include <bits/stdc++.h>
  using namespace std;

  int l, r, n;

  int main(){
  	cin >> n >> l >> r;
  	if (l / n != r / n)
  		cout << n - 1 << endl;
  	else
  		cout << r % n << endl;
  	return 0;
  }
T2 插入排序
题目描述
插入排序是一种非常常见且简单的排序算法。小 Z 是一名大一的新生,今天 H 老师刚刚在上课的时候讲了插入排序算法。
假设比较两个元素的时间为 ,则插入排序可以以
的时间复杂度完成长度为 n 的数组的排序。不妨假设这 n 个数字分别存储在
之中,则如下伪代码给出了插入排序算法的一种最简单的实现方式:
这下面是 C/C++ 的示范代码
for (int i = 1; i <= n; i++)
for (int j = i; j >= 2; j--)
if (a[j] < a[j-1]) {
int t = a[j-1];
a[j-1] = a[j];
a[j] = t;
}
这下面是 Pascal 的示范代码
for i:=1 to n do
for j:=i downto 2 do
if a[j]<a[j-1] then
begin
t:=a[i];
a[i]:=a[j];
a[j]:=t;
end;
为了帮助小 Z 更好的理解插入排序,小 Z 的老师 H 老师留下了这么一道家庭作业:
H 老师给了一个长度为 n 的数组 a,数组下标从 1 开始,并且数组中的所有元素均为非负整数。小 Z 需要支持在数组 a 上的 Q 次操作,操作共两种,参数分别如下:
1 x v:这是第一种操作,会将 a 的第 x 个元素,也就是 的值,修改为 v。保证
,
。注意这种操作会改变数组的元素,修改得到的数组会被保留,也会影响后续的操作。
2 x:这是第二种操作,假设 H 老师按照上面的伪代码对 a 数组进行排序,你需要告诉 H 老师原来 a 的第 x 个元素,也就是 ,在排序后的新数组所处的位置。保证 1 ≤ x ≤ n。注意这种操作不会改变数组的元素,排序后的数组不会被保留,也不会影响后续的操作。
H 老师不喜欢过多的修改,所以他保证类型 1 的操作次数不超过 5000。
小 Z 没有学过计算机竞赛,因此小 Z 并不会做这道题。他找到了你来帮助他解决这个问题。
输入格式
第一行,包含两个正整数 n, Q,表示数组长度和操作次数。
第二行,包含 n 个空格分隔的非负整数,其中第 i 个非负整数表示 。
接下来 Q 行,每行 2∼3 个正整数,表示一次操作,操作格式见【题目描述】。
输出格式
对于每一次类型为 2 的询问,输出一行一个正整数表示答案。
输入输出样例
输入 #1
3 4
3 2 1
2 3
1 3 2
2 2
2 3
输出 #1
1
1
2
说明/提示
【样例解释 #1】
在修改操作之前,假设 H 老师进行了一次插入排序,则原序列的三个元素在排序结束后所处的位置分别是 3, 2, 1。
在修改操作之前,假设 H 老师进行了一次插入排序,则原序列的三个元素在排序结束后所处的位置分别是 3, 1, 2。
注意虽然此时 ,但是我们不能将其视为相同的元素。
【数据范围】
对于所有测试数据,满足 ,
,
,
。
对于所有测试数据,保证在所有 Q 次操作中,至多有 5000 次操作属于类型一。
各测试点的附加限制及分值如下表所示。
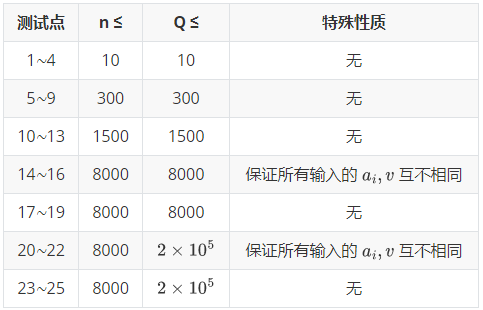
问题分析
方法一:按题意模拟,用 b 数组存储原数列,修改操作直接修改原数列, 询问操作可以将原数列复制到 a 数组中按题意进行排序。
排序后如何查找该数在排序后的数组中的位置呢?如果数值都不同可以在数组中查找该数值,但如果有相同的数这种方法就不行了。
可以再定义一个数组 w,w[i]表示 a 数组中第 i 个数在原数列中的位置。排序时,与 a 数组同步交换,询问时在 w 中查找。
时间复杂度:
, 期望得分36分以上,CCF数据实测 52 分。
  #include <bits/stdc++.h>
  using namespace std;

  int n, a[8010], b[8010], w[8010], Q;
  //b数组用来存入原数列
  //a数组用来复制原数列并排序
  //w数组用来记录a数组中每个数的原序号
  int main(){
  	cin >> n >> Q;
  	for (int i = 1; i <= n; ++i){
  		cin >> a[i];
  		b[i] = a[i];
  		w[i] = i;
  	}
      //先进行一次排序
  	for (int ii = 1; ii <= n; ii++)
  			for (int jj = ii; jj >= 2; jj--)
  				if (a[jj] < a[jj-1]) {
  					swap(a[jj], a[jj - 1]);
  					swap(w[jj], w[jj - 1]);
  				}
  	for (int i = 1; i <= Q; ++i){
  		int op, pos, x;
  		cin >> op;
  		if (op == 1){ //修改操作
  			cin >> pos >> x;
  			b[pos] = x;//修改b数组
              //复制并对w数组进行赋值
  			for (int j = 1; j <= n; ++j) a[j] = b[j], w[j] = j;
              //排序
  			for (int ii = 1; ii <= n; ii++)
  				for (int jj = ii; jj >= 2; jj--)
  					if (a[jj] < a[jj-1]) {
  						swap(a[jj], a[jj - 1]);
  						swap(w[jj], w[jj - 1]);//交换时注意w数组同时交换
  					}
  		}
  		else {  //询问
  			cin >> pos;
              //顺序查找
  			for (int j = 1; j <= n; ++j)
  				if (w[j] == pos) cout << j << endl;
  		}
  	}
  	return 0;
}方法二:本问题是稳定排序,即当数值相等时,序号小的应该排在前面;可以给每个数带一个原序号,使用双关键字排序,不需要将数列还原成再重新排序。
每修改一次就重新排序一次。算法效率取决于排序的方法,这里采用STL-sort排序。
时间复杂度:
,期望得分 65以上, CCF数据实测 76 分。
#include <bits/stdc++.h>
using namespace std;

struct nod{
	int v, id; //v用来记录该数的值, id用来记录原序号。
} a[8010];
//比较函数
bool cmp(nod p, nod q){
	return (p.v < q.v) || (p.v == q.v && p.id < q.id);
}

int n, m, w[8010];
bool flag = 1;//用来标记序列是否是排好序的, 0表示排好序,1表示未排好序

void readp(){
	cin >> n >> m;
	for (int i = 1; i <= n; ++i){
		cin >> a[i].v;
		a[i].id = i;
	}
}

void work(){
	for (int i = 1; i <= m; ++i){
		int op, pos, x;
		cin >> op;
		if (op == 1){// 修改
			cin >> pos >> x;
            //查找该数并修改
			for (int i = 1; i <= n; ++i)
				if (a[i].id == pos){
					a[i].v = x;
					break;
				}
			flag = 1; //未排好序
		} else {
			cin >> pos;
			if (flag){
				sort(a + 1, a + n + 1, cmp);
				flag = 0; //已排序
			}
            //顺序查找
			for (int i = 1; i <= n; ++i)
				if (a[i].id == pos){
					cout << i << endl;
					break;
				}
		}
	}
}

int main(){
	readp();
	work();
	return 0;
}方法三:上面算法有两个瓶颈:1、每修改都重新排序;2、询问为O(n)算法。
1、每次都重新sort是没有必要的,对于有序数列,每次修改一个数,只需要将该数向前或向后调整即可(类似插入排序)。调整效率:
2、对于第 2 个问题可用 w 数组维护原数列每个数被移动的位置,实现
时间复杂度:
,期望得分100分,CCF数据实测 100 分。
#include <bits/stdc++.h>
using namespace std;

struct nod{
	int v, id;
} a[8010];

bool cmp(nod p, nod q){
	return (p.v < q.v) || (p.v == q.v && p.id < q.id);
}

int n, m, w[8010];
//w数组表示原数列的第 i 个数当前位置为w[i]
void readp(){
	cin >> n >> m;
	for (int i = 1; i <= n; ++i){
		cin >> a[i].v;
		a[i].id = i;
	}
	sort(a + 1, a + n + 1, cmp);//排序
	for (int i = 1; i <= n; ++i)//初始化w数组
		w[a[i].id] = i;
}

void work(){
	for (int i = 1; i <= m; ++i){
		int op, pos, x;
		cin >> op;
		if (op == 1){
			cin >> pos >> x;
			int nowp = w[pos];
			if (a[nowp].v > x){ //数变小,向前调整
				a[nowp].v = x;
				for (int j = nowp; j > 1; --j)
					if (a[j].v < a[j - 1].v || a[j].v == a[j - 1].v && a[j].id < a[j - 1].id){
                        //同时维护 w 数组
						w[a[j].id] = j - 1;
						w[a[j - 1].id] = j;
						swap(a[j], a[j - 1]);
					} else {
						break;
					}
			} else if (a[nowp].v < x){ //数变大,向后调整
				a[nowp].v = x;
				for (int j = nowp; j < n; ++j)
					if (a[j].v > a[j + 1].v || a[j].v == a[j + 1].v && a[j].id > a[j + 1].id){
						w[a[j].id] = j + 1;
						w[a[j + 1].id] = j;
						swap(a[j], a[j + 1]);
					} else {
						break;
				}
			}
		} else {
			cin >> pos;
			cout << w[pos] << endl;
		}
	}
}

int main(){
	readp();
	work();
	return 0;
}T3 网络连接
题目描述
TCP/IP 协议是网络通信领域的一项重要协议。今天你的任务,就是尝试利用这个协议,还原一个简化后的网络连接场景。
在本问题中,计算机分为两大类:服务机(Server)和客户机(Client)。服务机负责建立连接,客户机负责加入连接。
需要进行网络连接的计算机共有 n 台,编号为 1∼n,这些机器将按编号递增的顺序,依次发起一条建立连接或加入连接的操作。
每台机器在尝试建立或加入连接时需要提供一个地址串。服务机提供的地址串表示它尝试建立连接的地址,客户机提供的地址串表示它尝试加入连接的地址。
一个符合规范的地址串应当具有以下特征:
必须形如 a.b.c.d:e 的格式,其中 a, b, c, d, e 均为非负整数;
0 ≤ a, b, c, d ≤255,0 ≤ e ≤ 65535;
a, b, c, d, e 均不能含有多余的前导 0。
相应地,不符合规范的地址串可能具有以下特征:
不是形如 a.b.c.d:e 格式的字符串,例如含有多于 3 个字符 . 或多于 1 个字符 : 等情况;
整数 a, b, c, d, e 中某一个或多个超出上述范围;
整数 a, b, c, d, e 中某一个或多个含有多余的前导 0。
例如,地址串 192.168.0.255:80 是符合规范的,但 192.168.0.999:80、192.168.00.1:10、192.168.0.1:088、192:168:0:1.233 均是不符合规范的。
如果服务机或客户机在发起操作时提供的地址串不符合规范,这条操作将被直接忽略。
在本问题中,我们假定凡是符合上述规范的地址串均可参与正常的连接,你无需考虑每个地址串的实际意义。
由于网络阻塞等原因,不允许两台服务机使用相同的地址串,如果此类现象发生,后一台尝试建立连接的服务机将会无法成功建立连接;除此之外,凡是提供符合规范的地址串的服务机均可成功建立连接。
如果某台提供符合规范的地址的客户机在尝试加入连接时,与先前某台已经成功建立连接的服务机提供的地址串相同,这台客户机就可以成功加入连接,并称其连接到这台服务机;如果找不到这样的服务机,则认为这台客户机无法成功加入连接。
请注意,尽管不允许两台不同的服务机使用相同的地址串,但多台客户机使用同样的地址串,以及同一台服务机同时被多台客户机连接的情况是被允许的。
你的任务很简单:在给出每台计算机的类型以及地址串之后,判断这台计算机的连接情况。
输入格式
第一行,一个正整数 n。
接下来 n 行,每行两个字符串 op, ad,按照编号从小到大给出每台计算机的类型及地址串。
其中 op 保证为字符串 Server 或 Client 之一,ad 为一个长度不超过 25 的,仅由数字、字符 . 和字符 : 组成的非空字符串。
每行的两个字符串之间用恰好一个空格分隔开,每行的末尾没有多余的空格。
输出格式
输出共 n 行,每行一个正整数或字符串表示第 i 台计算机的连接状态。其中:
如果第 i 台计算机为服务机,则:
如果其提供符合规范的地址串且成功建立连接,输出字符串 OK。
如果其提供符合规范的地址串,但由于先前有相同地址串的服务机而无法成功建立连接,输出字符串 FAIL。
如果其提供的地址串不是符合规范的地址串,输出字符串 ERR。
如果第 i 台计算机为客户机,则:
如果其提供符合规范的地址串且成功加入连接,输出一个正整数表示这台客户机连接到的服务机的编号。
如果其提供符合规范的地址串,但无法成功加入连接时,输出字符串 FAIL。
如果其提供的地址串不是符合规范的地址串,输出字符串 ERR。
输入输出样例
输入 #1
5
Server 192.168.1.1:8080
Server 192.168.1.1:8080
Client 192.168.1.1:8080
Client 192.168.1.1:80
Client 192.168.1.1:99999
输出 #1
OK
FAIL
1
FAIL
ERR
输入 #2
10
Server 192.168.1.1:80
Client 192.168.1.1:80
Client 192.168.1.1:8080
Server 192.168.1.1:80
Server 192.168.1.1:8080
Server 192.168.1.999:0
Client 192.168.1.1.8080
Client 192.168.1.1:8080
Client 192.168.1.1:80
Client 192.168.1.999:0
输出 #2
OK
1
FAIL
FAIL
OK
ERR
ERR
5
1
ERR
说明/提示
【样例解释 #1】
计算机 1 为服务机,提供符合规范的地址串 192.168.1.1:8080,成功建立连接;
计算机 2 为服务机,提供与计算机 1 相同的地址串,未能成功建立连接;
计算机 3 为客户机,提供符合规范的地址串 192.168.1.1:8080,成功加入连接,并连接到服务机 1;
计算机 4 为客户机,提供符合规范的地址串 192.168.1.1:80,找不到服务机与其连接;
计算机 5 为客户机,提供的地址串 192.168.1.1:99999 不符合规范。
【数据范围】
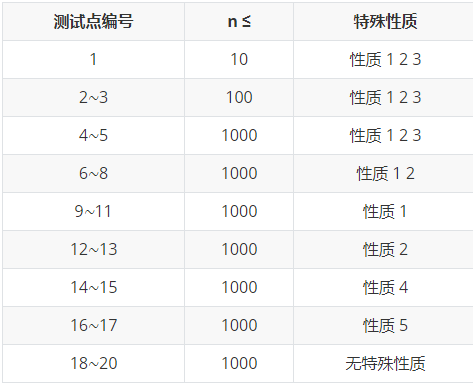
“性质 1”为:保证所有的地址串均符合规范;
“性质 2”为:保证对于任意两台不同的计算机,如果它们同为服务机或者同为客户机,则它们提供的地址串一定不同;
“性质 3”为:保证任意一台服务机的编号都小于所有的客户机;
“性质 4”为:保证所有的地址串均形如 a.b.c.d:e 的格式,其中 a, b, c, d, e 均为不超过 且不含有多余前导 0 的非负整数;
“性质 5”为:保证所有的地址串均形如 a.b.c.d:e 的格式,其中 a, b, c, d, e 均为只含有数字的非空字符串。
对于 100% 的数据,保证 1 ≤ n ≤ 1000。
分析问题
模拟题,难点在地址串判错。
方法一:11个点保证地址串正确,针对该部分数据编写程序。
定义字符串数组 a 用来存储连网成功的服务器,定义 w 数组用来存入服务器的序号。
如果读入的是服务器,到表中查找,找到输出“FAIL",否则输出”OK"并将该地址串存入 a ,序号存入w.
如果读入的是客户机,到表中查找,找到输出该服务器编号,否则输出"FAIL"。
时间复杂度:
,期望得分 55 分,CCF数据实测 55 分。
  #include <bits/stdc++.h>
  using namespace std;

  string a[1010];
  int n, w[1010], js = 0;

  int main(){
  	cin >> n;
  	string ops, ips;
  	for (int i = 1; i <= n; ++i){
  		cin >> ops >> ips;
  		if (ops == "Server"){ //服务器
  			//到表里查找
  			int p = 0;
  			for (int j = 1; j <= js; ++j)
  				if (a[j] == ips){
  					p = j;
  					break;
  				}
  			if (p) //找到
  				cout << "FAIL" << endl;
  			else{
  				cout << "OK" << endl;
  				a[++js] = ips;
  				w[js] = i;
  			}
  		} else {  //客户机
  			int p = 0;
  			for (int j = 1; j <= js; ++j)
  				if (a[j] == ips){
  					p = j;
  					break;
  				}
  			if (p){  //找到
  				cout << w[p] << endl;
  			} else {
  				cout << "FAIL" << endl;
  			}
  		}
  	}
  	return 0;
}方法二:也可用STL中 map 实现地址串与序号的映射。
时间复杂度:
,期望得分 55 分,CCF数据实测 55 分。
#include<bits/stdc++.h>
using namespace std;
map<string, int> mymap;

bool check(string s){
	return true;
}

int main(){
	int n;
	string stp, ips;
	cin >> n;
	for (int i = 1; i <= n; ++i){
		cin >> stp;
		getline(cin, ips);
		if (!check(ips)){
			cout << "ERR" << endl;
			continue;
		}
		if (stp == "Server"){
			map<string, int>::iterator iter = mymap.find(ips);
			if (iter != mymap.end()){
				cout << "FAIL" << endl;
			} else {
				cout << "OK" << endl;
				mymap[ips] = i;
			}
		} else {
			map<string, int>::iterator iter = mymap.find(ips);
			if (iter != mymap.end()){
				cout << mymap[ips] << endl;
			} else {
				cout << "FAIL" << endl;
				mymap[ips] = i;
			}
		}
	}
	return 0;
} 方法三:加入地址串判错。
地址串只包括数字,".", ":".
先查找地址串中非数字字符的位置并记录下来,如果有四个并且依次为".",".", ".", ":"则继续判断,否则返回false.
根据四个字符位置拆分五个数并判断:
1、没有前导0, 注意数字串的第一个字符为 0 并不一是前导零,因为数字串可以为0. 数字串长度大于2,第一个字符为 0 的才是前导零。
2、考虑长度为 0 的错误, 比如两个 '.' 连在一起。
3、将数字转化成整数再比较大小。
特别注意:地址串在错误的情况下,数字串最大可达21位,定义成 long long 可通过CCF数据。但特殊数据下 long long 也可能爆的,可先判断数字串长度,大于5就返回false
时间复杂度
,期望得分 100 分,CCF数据实测 100 分。
#include<bits/stdc++.h>
using namespace std;
map<string, int> mymap;

bool check(string s){
	int a[30], js = 0;
    //遍历标记所有非数字字符位置
	for(int i = 0; i < s.size(); ++i)
		if (s[i] > '9' || s[i] < '0'){
			a[++js] = i;
		}
	if (js != 4) return false; //字符个数不为4
    //四个字符不是'.','.','.',':'
	if (s[a[1]] != '.' || s[a[2]] != '.' || s[a[3]] != '.' || s[a[4]] != ':')
		return false;
    //加前后段标,方便循环处理
	a[0] = -1; a[5] = s.size();
	for (int i = 1; i <= 5; ++i){
        //前导零判断及长度判断
		if (a[i] == a[i - 1] + 1 || s[a[i - 1] + 1] == '0' && a[i] - a[i - 1] > 2 || a[i] - a[i - 1] > 6)
			return false;
        //数字串转换整数
		int num  = 0;
		for (int j = a[i - 1] + 1; j < a[i]; ++j)
			num = num * 10 + s[j] - '0';
        //大小判断
		if (i < 5 && num > 255) return false;
		if (i == 5 && num > 65535) return false;
	}
	return true;
}

int main(){
	int n;
	string stp, ips;
	cin >> n;
	for (int i = 1; i <= n; ++i){
		cin >> stp >> ips;
		if (!check(ips)){
			cout << "ERR" << endl;
			continue;
		}
		if (stp == "Server"){
			map<string, int>::iterator iter = mymap.find(ips);
			if (iter != mymap.end()){
				cout << "FAIL" << endl;
			} else {
				cout << "OK" << endl;
				mymap[ips] = i;
			}
		} else {
			map<string, int>::iterator iter = mymap.find(ips);
			if (iter != mymap.end()){
				cout << mymap[ips] << endl;
			} else {
				cout << "FAIL" << endl;
			}
		}
	}
	return 0;
}
T4 小熊的果篮
题目描述
小熊的水果店里摆放着一排 n 个水果。每个水果只可能是苹果或桔子,从左到右依次用正整数 1, 2, … , n 编号。连续排在一起的同一种水果称为一个“块”。小熊要把这一排水果挑到若干个果篮里,具体方法是:每次都把每一个“块”中最左边的水果同时挑出,组成一个果篮。重复这一操作,直至水果用完。注意,每次挑完一个果篮后,“块”可能会发生变化。比如两个苹果“块”之间的唯一桔子被挑走后,两个苹果“块”就变成了一个“块”。请帮小熊计算每个果篮里包含的水果。
输入格式
第一行,包含一个正整数 n,表示水果的数量。
第二行,包含 n 个空格分隔的整数,其中第 i 个数表示编号为 i 的水果的种类,1 代表苹果,0 代表桔子。
输出格式
输出若干行。
第 i 行表示第 i 次挑出的水果组成的果篮。从小到大排序输出该果篮中所有水果的编号,每两个编号之间用一个空格分隔。
输入输出样例
输入 #1
12
1 1 0 0 1 1 1 0 1 1 0 0
输出 #1
1 3 5 8 9 11
2 4 6 12
7
10
输入 #2
20
1 1 1 1 0 0 0 1 1 1 0 0 1 0 1 1 0 0 0 0
输出 #2
1 5 8 11 13 14 15 17
2 6 9 12 16 18
3 7 10 19
4 20
【样例解释 #1】
这是第一组数据的样例说明。
所有水果一开始的情况是 [1,1,0,0,1,1,1,0,1,1,0,0],一共有 6 个块。
在第一次挑水果组成果篮的过程中,编号为 1, 3, 5, 8, 9, 11 的水果被挑了出来。
之后剩下的水果是 [1,0,1,1,1,0],一共 4 个块。
在第二次挑水果组成果篮的过程中,编号为 2, 4, 6, 12 的水果被挑了出来。
之后剩下的水果是 [1,1],只有 1 个块。
在第三次挑水果组成果篮的过程中,编号为 7 的水果被挑了出来。
最后剩下的水果是 [1],只有 1 个块。
在第四次挑水果组成果篮的过程中,编号为 10 的水果被挑了出来。
【数据范围】
对于 10% 的数据,n ≤ 5。
对于 30% 的数据,n ≤ 1000。
对于 70% 的数据,n ≤ 50000。
对于 100% 的数据,。
问题分析
方法一:直接模拟,用 vh 数组标记该水果是否输出。
每次遍历所有水果,如果没有输出并与前面的水果不同(第1个单独处理)就输出。
用一个变量记录当前水果总数,每输出一个水果就减一,直到总数变成0.
时间复杂度:
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200010;

int n, a[MAXN], vh[MAXN];

int main(){
	cin >> n;
	for (int i = 1; i <= n; ++i)
		scanf("%d", &a[i]);
	int js = n, fv;
	while (js){//还有水果
		fv = -1;
		for (int i = 1; i <= n; ++i)//遍历
			if (!vh[i]){ //存在
				if (a[i] != fv){
					cout << i << " ";
					fv = a[i];
					js--;
					vh[i] = 1;
				}
			}
		cout << endl;
	}
	return 0;
}方法二:可用双向链表将所有水果都串起来,删除时将水果从链上删除,每次只需要遍历剩下的水果。
时间复杂度:
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200010;

struct nod{
	int v, fre, next;
} a[MAXN];
//v表示水果种类,fre,next分别指向前后水果的位置
int n;

int main(){
	cin >> n;
	for (int i = 1; i <= n; ++i){
		scanf("%d", &a[i].v);
		a[i].fre = i - 1;
		a[i].next = i + 1;
	}
    //0为空置头节点, 水果种类设置为 -1
	a[0].v = -1; a[0].fre = -1; a[0].next = 1;
	int js = n, fv;
	while (js){
		fv = a[0].v; //用来记录上一个水果的种类
		int fp = a[0].next;
		while (fp <= n){
			if (a[fp].v != fv){ //如果与上一个种类不同
				fv = a[fp].v;
				cout << fp << " ";
				js--;
                //删除
				a[a[fp].fre].next = a[fp].next;
				a[a[fp].next].fre = a[fp].fre;
			}
			fp = a[fp].next; //下一个
		}
		cout << endl;
	}
	return 0;
}方法三:仍按方法二将所有水果用双向链表串起来。
将所有块先处理出来,存入一个 tb 表中,记录每块的起始位置,结束位置和块中水果个数。
每次只需要遍历各块的第 1 个水果,并同时维护块表。
时间复杂度为
  #include <bits/stdc++.h>
  using namespace std;
  const int MAXN = 200010;

  struct nod{
  	int v, fre, next;
  } a[MAXN];

  int n, tb[MAXN][3], js = 0;
  //tb[i][0]表示第 i 块的起始位置
  //tb[i][1]表示第 i 块的结束位置
  //tb[i][2]表示第 i 块的水果总数
  //js记录块总数
  int main(){
  	cin >> n;
  	for (int i = 1; i <= n; ++i){
  		scanf("%d", &a[i].v);
  		a[i].fre = i - 1;
  		a[i].next = i + 1;
  	}
  	a[0].v = -1; a[0].fre = -1; a[0].next = 1;
      //初始数据分块
  	js = 1;
  	tb[1][0] = tb[1][1] = tb[1][2] = 1;
  	for (int i = 2; i <= n; ++i){
  		if (a[i].v == a[tb[js][1]].v)//与前一个水果相同
  			tb[js][1] = i, tb[js][2]++;
  		else { //不同增加一块
  			tb[++js][0] = i;
  			tb[js][1] = i;
  			tb[js][2] = 1;
  		}
  	}
  	while (js){
  		int js1 = 0;//用来记录新表中块的数目
  		for (int i = 1; i <= js; ++i){
              //输出该块的第 1 个,并将该水果从链中删除
  			cout << tb[i][0] << " ";
  			int fp = tb[i][0];
  			tb[i][0] = a[fp].next;
  			a[a[fp].fre].next = a[fp].next;
  			a[a[fp].next].fre = a[fp].fre;
              //块维护
  			if (tb[i][2] > 1){ //该块仍存在
                  //新块表为空,或该块与新块表中最后一块种类不同,新建一块。
  				if (js1 == 0 || a[tb[i][0]].v != a[tb[js1][1]].v){
  					js1++;
  					tb[js1][0] = tb[i][0];
  					tb[js1][1] = tb[i][1];
  					tb[js1][2] = tb[i][2] - 1;
  				} else { //与新块表中最后一块种类相同,合并。
  					tb[js1][1] = tb[i][1];
  					tb[js1][2] += tb[i][2] - 1;
  				}
  			}
  		}
  		cout << endl;
  		js = js1;
  	}
  	return 0;
}方法四:用线段树维护区间0, 1的个数,可查询区间[pos, n]的第 1 个 0/1的位置。
时间复杂度:
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200010;

struct nod{
	int c[2], l, r;
}tree[MAXN * 4];

int n, a[MAXN];
//建树
void creat(int root, int l, int r){
	tree[root].l = l; tree[root].r = r;
	tree[root].c[0] = tree[root].c[1] = 0;
	if (l < r){
		int mid = (l + r) / 2;
		creat(root * 2, l, mid);
		creat(root * 2 + 1, mid + 1, r);
	}
}
/*修改 x = 0/1, 表示pos位置放一个0/1水果,x = 2表示该水果删除*/
void modify(int root, int pos, int x){
	int l = tree[root].l, r = tree[root].r;
	if (l == r){
		tree[root].c[0] = tree[root].c[1] = 0;
		if (x < 2) tree[root].c[x] = 1;
		return;
	}
	int mid = (l + r) / 2;
	if (pos <= mid) modify(root * 2, pos, x);
	else modify(root * 2 + 1, pos, x);
	tree[root].c[0] = tree[root * 2].c[0] + tree[root * 2 + 1].c[0];
	tree[root].c[1] = tree[root * 2].c[1] + tree[root * 2 + 1].c[1];
}
//查找子树,pos位置后第 1 个 x 种类水果的位置, 返回n + 1表示未找到
int find(int root, int pos, int x){
	if (tree[root].c[x] == 0) return n + 1;//区间该水果数为0
	int l = tree[root].l, r = tree[root].r;
	if (pos > r) return n + 1;//区间在pos左边
	if (l == r){ //叶节点
		if (tree[root].c[x] > 0) return l;
		else return n + 1;
	}
	int mid = (l + r) / 2;
    //先找左区间
	int ans = find(root * 2, pos, x);
	if (ans > n) //左区间未找到
		ans = min(ans, find(root * 2 + 1, pos, x));
	return ans;
}

int main(){
	cin >> n;
	creat(1, 1, n);
	for (int i = 1; i <= n; ++i){
		scanf("%d", &a[i]);
		modify(1, i, a[i]);
	}
	int s = n;
	while (s){
        //找最左边的 0/1
		int p = min(find(1, 0, 0), find(1, 0, 1));
		int v = a[p]; //v用来记录上一水果种类
		do{
			cout << p << " ";
			s--;
            //修改
			modify(1, p, 2);
			v = 1 - v;
            //查找
			p = find(1, p + 1, v);
		} while (p <= n);
		cout << endl;
	}
	return 0;
}方法五:用树状数组维护 0 和 1 的个数,二分查找[pos, n]区间第 1 个 0 / 1的位置 。
时间复杂度:
, 期望得分:100 分, CCF数据实测得 100 分。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200010;

int c[2][MAXN], a[MAXN], n, m;
//c[0],c[1]数组分别统计 0 和 1 的个数
int lowbit(int x){
	return x & -x;
}
//修改
void modify(int arr[], int pos, int f){
	while(pos <= n){
		arr[pos] += f;
		pos += lowbit(pos);
	}
}
//求前缀和
int getsum(int arr[], int pos){
	int ans = 0;
	while (pos > 0){
		ans += arr[pos];
		pos -= lowbit(pos);
	}
	return ans;
}
//二分查找[pos, n]区内第 1 个位置,返回 n + 1表示未找到
int find(int arr[], int pos){
	int l = pos, r = n + 1, v = getsum(arr, pos);
	while (l + 1 < r){
		int mid = (l + r) / 2;
		if (getsum(arr, mid) > v)
			r = mid;
		else
			l = mid;
	}
	return r;
}

int main(){
	cin >> n;
	for (int i = 1; i <= n; ++i){
		scanf("%d", &a[i]);
		modify(c[a[i]], i, 1);
	}
	m = n;
	while (m){
        //找最左边的 0/1
		int p = min(find(c[0], 0), find(c[1], 0));
		int v = a[p];//记录上一水果种类
		do{
			printf("%d ", p);
            //修改
			modify(c[v], p, -1);
			v = 1 - v;
			m--;
            //查找
			p = find(c[v], p);
		} while (p <= n);
		printf("\n");
	}
	return 0;
}
