
上古时代(1978-2002)-物竞天择
1976-1977年,扑克教父DoyleBrunson连续获得两届WSOP主赛冠军。
1979年,Doyle Brunson的《超级系统》第一册出版。
1980-1981年,天才Stu ungar连续获得两届WSOP主赛冠军。
1987-1988年,东方快车Johnny Chan连续获得两届WSOP主赛冠军。
1989年,扑克顽童Phil Hellmuth获得WSOP主赛冠军。
1997年,Stu ungar获得WSOP主赛冠军,随后一年身故。
1999年,著名作家David Sklansky出版《The Theory Of Poker》,里面提到了博弈论内容。
2002年,Doyle Brunson的《超级系统》再版。
《超级系统》的再版标志着上古时代的结束。这本书是对当年那些伟大牌手成功策略的总结,被奉为最初的扑克圣经。开篇,即表明最成功的策略主要有:1、扑克是关于人的游戏,重要在于对人的解读;2、Aggressive凶是想赢的最重要方法。
凭借着这两条法宝,Brunson、Ungar这些鲨鱼们碾压了遍地松弱的玩家池。事实上,他们的策略和当代的松凶策略相距甚远,只能称之为古典松凶派。
古典松凶派的特点:翻前溜入被视为理所当然的行动,过宽的入池范围并没有进行过精细化设计,巨大比例的超池下注无规律可循,cbet和donk并没有清晰的概念,重中之重在于读牌读人。
那时的扑克策略还被称为艺术,而非科学。
前黄金时代(2003-2011)-百花齐放
2001年、PartyPoker、Pokerstars等online扑克正式上线。
2002年,视频摄像头首次用于WSOP主赛的报道。
2003年,从Pokerstars资格赛赢得门票的Chris Moneymaker获得了WSOP主赛事冠军,当年的亚军是Sam Farha。该事件史称“Moneymaker效应”,标志着扑克全民化全球化的开始。
2004年,Full Tilt Poker上线。
2004年,加拿大人Daniel Negreanu在WPT五钻世界赛获得冠军,同年他被评为WSOP年度最佳牌手。
2006年,Jamie Gold获得WSOP主赛事冠军,获得主赛史上最高的冠军奖金1200万美元。
2006-2007年,著名真人秀HighStakes Poker(2006-2011共7季)和Poker After Dark((2007-2011共7季,2018-2019重启2季)相继开播。电视扑克随着互联网传遍世界各地,造就了Phil Ivey、Tom Dwan、GusHansen、Daniel Negreanu、PatrikAntonius等一大批偶像明星。
2007-2008年,Gus Hansen赢得澳洲百万赛冠军和他的第三次WPT世界冠军,代表着现代松凶打法的巅峰。
2008年,Negreanu的《Small Ball: Poker Holdem Strategy 》、GusHansen的《Every Hand Revealed》出版,分别阐述了两人的独特策略:小球派和现代松凶(LAG)。
2005-2008年,一大批培训书籍雨后春笋般出现,比如2005的《小绿皮书》、2008的《哈林顿在现金桌》、2008的《范围之战》等等。一本2006年11月出版的神书也埋没在这股潮流里,它的名字叫《The Mathematics OfPoker》(扑克中的数学),作者是Bill Chen和JerrodAnkenman。然而,大众还处在耀眼的电视明星和网络的扑克盛宴中,当时并没有多少人注意到这本即将改写扑克策略历史的划时代巨作。
2009年,Online扑克已经风靡全球,高额桌Phil Ivey、Tom “durrrr” Dwan、Gus Hansen、Patrik Antonius、Dan “Jungleman12” Cates、Victor “Isildur1” Blom等大名如雷贯耳。当年,durrrr 与横空出世的瑞典人Isildur1,在Full Tilt Poker进行了后来被称为传奇单挑的HU,Isildur1一周内赢了如日中天的durrrr400万美元。
2011年,黑色星期五事件爆发,FBI和美国司法部关闭了美国的线上博彩网站,Full Tilt Poker卷入了诈骗官司。
Brunson、Ungar留下的古典松凶策略被了前黄金时代牌手进行了继承和发展,Daniel Negreanu改良了Stu Ungar的松凶打法并将其规范化,创建了小球派,主要特点是:翻前范围较宽、多用投机牌入池、采用最小下注和最小加注、翻后多用小额下注进行攻击、注意控制底池。
由于小球派打法符合锦标赛的特点,使其在黄金时代前期达到广泛的认同和应用。然而,天才松凶选手Gus Hansen以疯凶流的打法,压缩了小球派的生存空间,他代表性的现代松凶策略彻底摧毁了小球派控池的梦想。Hansen的技术特点可以称为Brunson的古典松凶进阶版:翻前3bet施压、持续三条街下注、边缘牌跟注、超池下注等。
于此同时,Tom Dwan,可能是电视扑克史上最具偶像气质的明星,也在Cash局中展现了类似Hansen的极具观赏性的松凶打法。这使松凶(Loose Aggressive)策略在众多爱好者的心目中奠定了战无不胜的印象。
然而,在快节奏的网络扑克中,太多的松凶模仿者折戟成沙。以前紧弱策略的玩家也在进化,一部分进化为紧弱的NIT,一部分进化为范围平衡但攻击性弱的ABC,一部分进化为范围紧但防守坚实的ROCK。虽然松凶天生带来的剥削性能很好的克制偏弱的玩家,但是硬币的另一面是松凶的高波动,不够坚实的Bankroll使这些未来的松凶大神倒在半路上。即使是Tom Dwan、Gus Hansen也避免不了线上大额亏损的命运。
现场锦标赛在黄金时代获得了重大发展,无数怀揣“Moneymaker梦想”的爱好者涌入MTT赛场,2006年的WSOP主赛事的参赛人次是创纪录的8773人。在一次次锦标赛的对抗中,玩家们发现逐步涨盲的赛事结构和松凶的波动性无法协调,而凶悍打法的剥削性又无法舍弃,在小球派与松凶的夹缝中,一个新的策略流派TAG(Tight Aggressive)应运而生并占据主流。TAG,紧凶,强调翻前范围,翻后以主动进攻打法控制主动权。
这是一个光辉灿烂的时代,TAG、LAG都拥有数目庞大的拥趸,不甘被淘汰的紧弱选手也纷纷进化为NIT、ABC、ROCK。百花齐放的流派让扑克市场产生了极大的繁荣。
后黄金时代(2012-2014)-打破成规
2012年,Phil Galfond(OMGClayAiken)成立Run It Once在线教学网站。
2012年,Antonio Esfandiari获得WSOP百万一滴水冠军,奖金1800万美元。
2013年,Doug Polk(Ben “Sauce123” Sulsky)在线上单挑比赛赢得84万美元奖金
2013年,Mattew Janda的《Applications of No-Limit Hold’em》出版。
2014年,Dan Colman获得WSOP百万一滴水冠军,奖金1500万美元,亚军是Negreanu。
2014年,Phil Ivey卷入Borgata边缘识牌诉讼案。
为何以黑色星期五为界,把黄金时代划分为前后?这是因为,在New School从策略上打败了Old School以后,那些黄金时代个人标签鲜明的选手已经绝迹了,网络时代再也无法出现TomDwan、Gus Hansen这样单一风格牌手,即使知名牌手自身也在进化,比如Negreanu。对TAG(紧凶)、LAG(松凶)风格的深入研究后,所有成功牌手的风格都在靠拢。HUD软件的应用让线上玩家归并了对手策略的类型,但是Good REG的数据趋于统一。
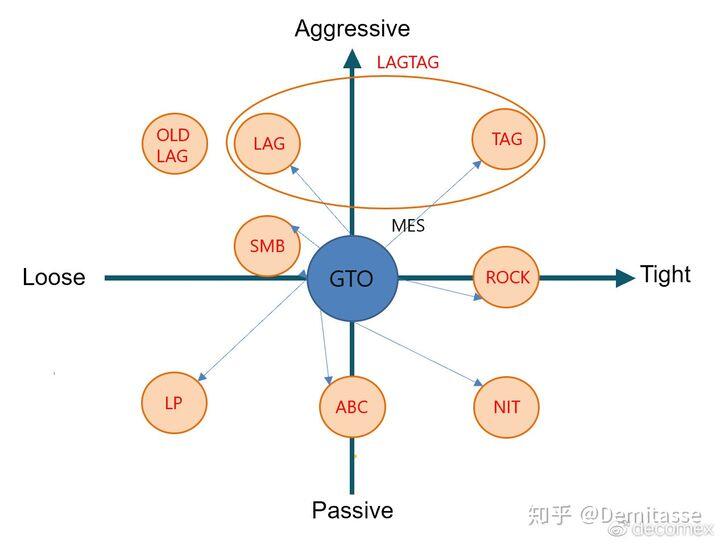
新的类型LAGTAG出现了,对高阶玩家类型的识别已经失去了作用。你无法判断坐在你对面的ID到底是TAG还是LAG,他们已经回到了老Brunson最初给人的教导,扑克打的是人。你会看到高手们时松、时紧、时凶、时弱,现在紧凶、松凶已经不是高手的标签或风格,而是他们针对相应玩家的单独策略方式。对NIT策略采用LAG,对ROCK策略采用TAG等等。采用这种控制自如的LAGTAG策略,可以称为是“Exploitative Play”的粗粒雏形。
这也是扑克策略进化的必然途径,标签化脸谱化的玩家类型识别只能应对于新手,对付几十万上百万手牌的强悍对手,给他分类只能说是刻舟求剑。
那么,扑克策略该向哪个方向继续进化呢?让我们回忆起2006年11月那本圣经般的的著作,《The Mathematics Of Poker》。
智能时代(2015-今)-纳什均衡
2015年,GTO Solver软件Piosolver1.0上市。
2015年,Doug Polk成立Upswingpoker在线教学网站,以GTO策略教学为主。
2016年,PS锦标赛大神BenCB789成立Raise Your Edge在线教学网站,教学GTO、剥削策略。
2016-2017年,Fedor Holz获得WSOP$111,111一滴水冠军,奖金498万美元;Rainer Kempe获得16年超级碗豪客赛2冠军,奖金500万美元;ChristophVogelsang获得17年超级碗豪客赛3冠军,奖金600万美元。以小组学习为主的德国帮崛起。
2017年1月,CMU的应用CFR+的人工智能程序Libratus在12万手HU中以14.7bb/HH的巨大优势战胜四名高水平人类选手。
2017年4月,人工智能程序Libratus冷扑大师在3.6万手HU中以22bb/HH的巨大优势战胜六名中国选手。
2017年,Libratus作者Noam Brown以不完全信息博弈论的解决方案获得NIPS2017最佳论文奖。
2018年,Justin Bonomo获得超级碗豪客赛中国赛、超级碗豪客赛4、WSOP百万一滴水冠军,奖金分别为480万美元、500美元、1000万美元。FedorHolz获得百万一滴水亚军。专家分析Bonomo使用的多为GTO策略。
2018年,瑞士人Linus “LLinusLLove” Loeliger和Timofey “Trueteller” Kuznetsov、Jonas“OtB_RedBaron” Mols一起,被Upswingpoker知名教练Andres“ Educa-p0ker” Artinano评为全球三大6MAX NLH玩家。因善用软件,LLinusLLove被网上称为“人肉Solver”。
2018-2019年,连续两年排名GPI第一的Alex Foxen在美国公开赛采访中宣称自己玩的是GTO策略。
2019年7月,CMU的人工智能程序Pluribus经过AIVAT方法计算后,宣布战胜与真人对弈的6MAX NLH。
《The Mathematics Of Poker》中的扑克策略,终于在2015年开始得到了软件的应用。同时,大量高质量的教学网站成立,以GTO策略、Solver使用为主。线下及线上顶级牌手纷纷利用solver软件进行策略研究,黄金时代的New School们逐渐被时代抛离。以往单纯的TAG、LAG风格迅速被遗弃。而基于LAGTAG的策略,也根据GTO发展精细化的“Exploitative Play”,即MES(Max Exploitative Strategy)策略。
GTO策略在MOP中被命名,Optimal的含义经常被语境所误解。事实上,GTO策略是一种NE(Nash Equilibrium)策略。如果当时Bill Chen把它写位GTNE,或许会少一点争议。但不可否认,GTO朗朗上口的缩写,也是这种均衡策略推广的助力之一。
至此,一种完全均衡的策略已经被开发出来,而那些松凶、紧凶、LAGTAG、NIT、ABC等以博弈论的眼光看都存在各种漏洞,在你无法确定对手是某种固定风格的玩家之前,或者对手是易变的、不稳定的风格的专家,采用GTO就是最好的策略。
Q&A
1. GTO的定义是什么?
A:GTO是一种基于NE(纳什均衡)的游戏策略。纳什均衡适用于非合作博弈/零和博弈。纳什均衡定义:在一个博弈过程中,无论对方的策略选择如何,当事人一方都会选择某个确定的策略,则该策略被称作支配性策略。一个策略组合被称为纳什均衡,是当每个博弈者的支配性策略都是为了达到自己期望收益(EV)的最大值,与此同时,其他所有博弈者也遵循这样的策略。根据以上,GTO策略的定义就是每个完全理性的博弈者都达到自己期望收益(EV)的最大值的策略组合。
2. GTO是一种不会输的策略吗?
A:任何策略都会输,这是NLH的波动性(或样本方差)决定的。GTO策略当然也会输,但是我们从定义上可得,采用GTO策略,你哪怕输,也不会损失EV。长期(long run)来看,一个重复进行的游戏,你的获得的价值必将等于你策略的EV值。
3. 那么长期是多长?
A:长期是一个统计学的概念。在CASH中,长期和你的百手盈利和session方差有关;在MTT/SNG中,长期和你的ROI(投资回报率)和比赛盈亏方差有关。具体计算方法可见前面的专栏。
4. GTO是一种防守的策略吗?
A:错。GTO是一种攻守兼备的策略,它具有不亚于LAG的各种进攻技巧。
5. 两个GTO选手一起打,不是都输给Rake吗?
A:Rake与GTO策略无关,无论你采用什么策略游戏,都会输Rake。哪怕你是盈利的,也是Rake后的盈利。
6. 初学者学GTO是错误吗?
A:恰恰相反。对于初学者,没有ABC、TAG、LAG等先入为主的策略的影响,反而更容易理解掌握正确的扑克理论。无论初学者学不学GTO,掌握GTO背后的全EV公式,都是至关重要的。
7. 剥削策略比GTO策略EV更高吗?
A:如果不基于均衡的策略,你的剥削策略将无从谈起。首先识别到对手有漏洞(应用贝叶斯法则),那么有多少的漏洞可供利用,有没有数学上的依据?所以必须掌握GTO策略才能用好MES策略。如果对手是一个前述有固定漏洞的玩家,MES确实比GTO的EV更高。但是对于一个不稳定易变的或极端聪明的玩家,采用剥削策略也可能被反剥削。综合来看,对于陌生的对手,GTO策略无疑是EV最大化的更好选择。
8. 对手不用GTO,我用GTO策略有没有用?
A:在双人游戏中,对手的漏洞造成的EV损失,你采用GTO策略会自动获利。这是零和游戏的基本特点。因此你采用GTO策略是完全有效的。
9. 合作博弈不能用GTO策略?
A:这个游戏的基础就是非合作博弈,如果存在合作博弈(正和博弈),并不能使用纳什均衡。伙牌不属于合作博弈,而是非合作博弈中的串通合谋。针对串通合谋,局中人与合谋团伙之间有一种“防合谋均衡”,具体算法未研究。
10. 多人池能不能用GTO策略?
A:多人博弈也存在NE,这是角谷不动点定理证明过的。但是,多人博弈可能存在多个纳什均衡点,当你执行其中一个均衡策略时,别人有可能执行另外一个,你的GTO策略可能不是EV最大化的选择。因为第三方的漏洞造成的EV损失,你并不会自动获得。但是GTO策略(执行一个均衡点)仍是有意义的,这会保证你的保底EV。
11. 多人池NE能用软件计算吗?
A:复杂的多人博弈的NE,2018年奈望林纳奖Daskalakis证明多人博弈纳什均衡是一个PPAD-Complete问题(PPAD代表有向图的多项式校验参数),所以想以多项式解得多人博弈的纳什均衡解还是很有难度。目前MonkerSolver的多人池解是采用了大量的抽象方法,可以参考。
12. 锦标赛能不能用GTO策略?
A:可以。但是,对于锦标赛,$EV和chipEV在不同阶段并不一致,参考Icmizer。我们通常的策略、计算和solver的设置都是对Cash的,也就是算的是chipEV。严格来说,在锦标赛中,我们应该考虑的$EV最大化的GTO策略。
13. Push or Fold跟GTO策略有关系吗?
A:目前所有的Push or Fold计算器,包括Icmizer、HRC等,用的都是NE解。我们前面说过,GTO策略就是NE策略,所以你用所有软件的Push or Fold就是GTO策略。
14. Pokersnowie是GTO策略吗?
A:Pokersnowie是一个基于人工智能AI的无限注德州扑克软件。它已经学会了玩各种各样的无限注德州扑克,从单挑到10人局,从小筹码局一直到非常深的筹码局(400个大盲注)。PokerSnowie的根基是人工神经网络。它通过自我对弈,训练出最大化EV的策略,这是一种形而上的求解GTO策略的方式。但是由于下注尺度的限制,它的GTO策略的dEV(纳什距离)离真正的GTO还差得很多。一个良好训练的牌手,在Snowie的下注尺度限制下,对AI应该能达到15bb/HH的领先优势。
15. Solver是人工智能吗?
A:不是。Solver是严格按照EV公式不断逼近接近纳什均衡解,完全没有AI的要素。
16. Solver解就是GTO策略吗?
A:这和模型建立有关,越精确的模型越接近纳什均衡解,越接近GTO策略。但是,完全的GTO解不可能达到,也没有意义。对于一个混合策略,21%和20%的精确差距没有必要完全解得。
17. Solver的解算都是超近道吗?
A:这种说法是无知的。Solver是逐渐逼近纳什均衡解,并不是超近道。如果说GTO解是一个圆,Solver的解就是一个内接多边形,范围越准确,策略树越完善,这个内接多边形就越接近于圆。因为目前计算机的能力,无法穷举所有的策略树,适当的下注尺度抽象是无法避免的。但是,Solver解毕竟是目前最接近于GTO策略。
18. 为什么Solver一定要输入翻牌面Board?
A:算法上没有一定要输入翻牌面的必要。翻前有169个同构面,翻牌有1755个同构面。正是因为计算机能力的不足,所以我们才要输入翻牌。如果有一天,计算机能力无限强大,那么我们无须输入翻牌面、无须输入策略树,甚至无须输入翻前范围,就可以得到完整的GTO策略。
19. 用Solver解算就不需要懂原理?
A:Solver的解算结果确实有很多我们不能理解。但是请相信,所有的解算结果都是通过全EV公式计算出的。你要了解的是,EV计算公式,这也是所有策略的根本。
20. Solver的计算方法跟Libratus一样吗?
A:Solver的计算方法是逆向归纳法,用全EV公式从河牌开始算起,倒推翻牌的行动,所有的转牌河牌面计算好以后再进行加权聚合。Libratus采用的是MCCFR(蒙特卡洛反事实遗憾最小化),从原理上来说,和Snowie的ANN神经网络更为接近。
21. Exploitative Play有计算软件吗?
A:Solver就是最好的Exploitative Play计算软件。Exploitative Play实际上是PBE(精炼贝叶斯纳什均衡),通过贝叶斯公式推断对手的漏洞点,利用翻前范围或节点锁定输入软件,得到MES解。MES解的准确度除了和GTO解一样外,还跟贝叶斯推断的准确度有关。
22. Action频率是GTO的关键吗?
A:个人观点:执行GTO策略不用特别考虑频率。频率是多次行动的综合,你首先要保证的是行动线的正确,不能有Off-tree的行动。比如下注20%,过牌80%,你以任何比例去选择混合策略,单手牌的EV都是一样的。关键在于你的后续行动,不能脱离整个策略树。
23. 下注尺度是GTO的关键吗?
A:个人观点:对于复杂范围(非ToyGame)来说,基本上任何一个下注尺度都是合理的,都是有相应的纳什均衡的。只要你能正确选择对应下注尺度的正确范围,下注尺度并不重要。所以关键的还是行动线和避免Off-tree。
24. GTO策略一定要用翻前NE范围吗?
A:个人观点:和行动频率一样,你的单手牌并不用特别考虑频率,例如AA 4bet-50%,call 50%之类。你只需要知道这手AA有4bet和call的两种选择就可以。长期的统计才带来频率。因此,翻前是否严格采用NE范围并不重要,你可以按NE范围的频率和接近牌力,设计自己舒适的翻前范围。
25. 如何用Solver/AI练习GTO?
A:个人观点:Snowie的AI适合练习翻前范围和HU,通过长期训练对各个位置的范围形成肌肉记忆。HU的训练会大大提高你翻后的能力。而Solver Trainer(如GTO+的PAS)是对行动线训练的最好工具,具体方法见以前专栏。
小可爱,在想啥呢?
还不赶紧点赞,收藏,订阅!!!
