
【千锋教育干货暴击】
如果你想更好的学习Python乃至转行,弯道超车,快人一步!本课程零基础即可加入学习,抓住大数据、机器学习、人工智能时代的红利,开启你的第一行代码吧!
↓ ↓ ↓
千锋教育Python教程_700集零基础Python入门到精通教程(保姆级新手教程)
千锋教育Python教程全套_python零基础入门到精通(学完可达到Python工程师水平)
正则表达式
正则表达式是对字符串操作的一种逻辑公式,就是用事先定义好的一些特定字符、及这些特定字符的组合,组成一个“规则字符串”,这个“规则字符串”用来表达对字符串的一种过滤逻辑。
需要引入内置模块re
缺点:效率低下,能用字符串方法完成尽量使用字符串的方法
优点:编码简单
1.为什么使用正则表达式
使用场景
敏感词过滤
手机、邮箱等验证
爬虫
2.正则表达式的组成
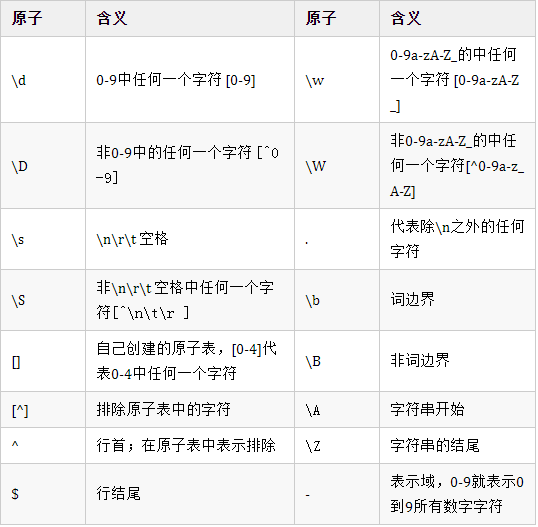
原子
组成正则表达式的最小单位,任何字符都可以
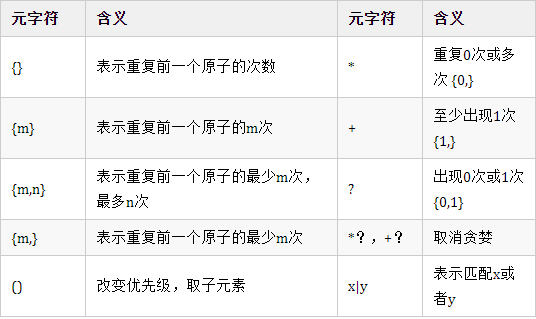
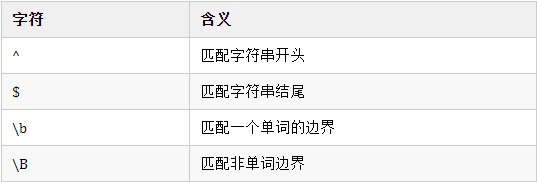
元字符
元字符能够增强原子的描述能力
模式修正符
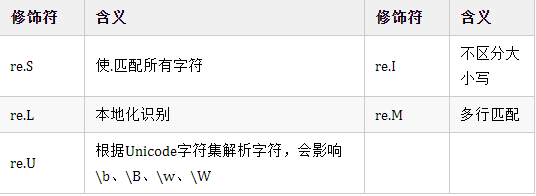
边界字符
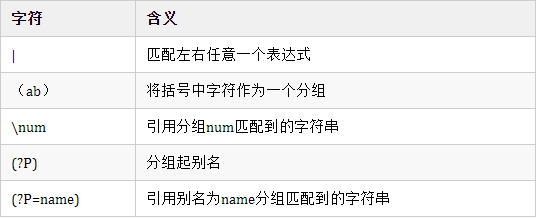
匹配分组
注意:
模式字符串一定要使用原字符串,也就是用r开头的字符串。r'www'
严格区分大小写
如果正则表达式中有{,},[,],-,?,*,|^,$,.等做普通字符,则要将其转义
3. 正则常用方法
compile():将正则表达式模式编译成正则表达式对象,其 match() 和 search() 方法可用于匹配
当我们使用正则表达式时,re模块会干两件事
1、编译正则表达式,如果正则表达式本身不合法,会报错
2、用编译后的正则表达式去匹配对象
编译正则表达式使用compile
原型:re.compile(pattern, flags=0)
参数:pattern 模式
     flags 模式修正符

re_telephon = re.compile(r"^1(([3578]\d)|(47))\d{8}$") #编译,返回正则对象
print(re_telephon.match("13600000000")) #

prog = re.compile('\d{2}') # 正则对象
prog.search('100abc') # 正则对象调用search获取匹配re.match() :从字符串起始位置匹配一个模式,如果从起始位置匹配没有匹配成功,则返回None
原型:re.match(pattern,string,flags=0)
参数:patter  模式
     string  要匹配的字符串
     flag    模式修正符
返回值: 匹配成功返回一个Match object,失败返回None

print(re.match(r'www','www.baidu.com'))
print(re.match(r'www','http:///www.baidu.com')) #None
print(re.match(r'www','cctv.www.baidu.com'))  #None
# 结合分组使用,进行标签匹配
str = "<span><h1>hello world!</h1></span>"
pattern = r"<(.+)><(.+)>.*</\2></\1>"
result = re.match(pattern, str)
print(result.groups())re.search() : 顺序扫描字符串,找到第一个匹配项则结束。
原型:re.search(pattern, string, flags=0)
参数:patter 模式
     string  要匹配的字符串
     flag  模式修正符
返回值:匹配成功,返回match object,否则返回None

print(re.search(r'll','hello'))
print(re.search(r'll','heLLo',re.I))

#读取字符串中文章浏览次数
str = "浏览次数为: 8098"
pattern = r"\d+"
result = re.search(pattern, str)
print(result.group())re.group()和re.groups()
用于提取子元素,模式中一个括号就是一个子元素,group和groups只能在match和search方法里使用,通过返回的match object获取子元素。在模式串和sub和subn中的替换字符串中可以使用\1,\2,\3....来引用子元素
m = re.match(r"(\d{3})-(\d{8})", "010-53247654")
#使用序号获取对应组的信息,group(0)一直代表的原始字符串
print(m.group(0))
print(m.group(1))
print(m.group(2))
#查看匹配的各组的情况
print(m.groups())

# 匹配出0-100之间的数字
pattern = r"0$|100$|[1-9]\d{0,1}$"
#测试数据为0,3,27,100,123
result = re.match(pattern, "27")
print(result.group())re.findall() : 扫描整个字符串,并返回结果列表
原型:findall(pattern, string, flags=0)
参数:patter: 匹配的正则表达式
  string: 要匹配的字符串
  flags:模式修正符
返回值:如果匹配成功返回一个列表,包含了所有匹配项,失败返回空列表
print(re.findall(r'oo','kksdkoosdflsdfooksdfsdoOppppweOo',re.I)) #['oo', 'oo', 'oO', 'Oo']

#findall方法取得所有满足的查找

str = "<div>hello</div>world<div>hello宋宋</div>"
pattern = r"\w+</h1>"
result = re.findall(pattern, str)
print(result)re.split() :用模式做分隔符,将字符串分隔,返回分隔列表,如果模式加上括号,则分隔符会被保留
通过出现模式来拆分字符串。如果在pattern中使用了捕获括号,那么模式中所有组的文本也将作为结果列表的一部分返回。如果maxsplit不为零,则最多会发生maxsplit分割,并将字符串的其余部分作为列表的最后一个元素返回。
原型:split(pattern, string,maxsplit=0,, flags=0)
参数:patter: 匹配的正则表达式
     string: 要匹配的字符串
     maxsplit 匹配次数,0不限制次数
     flags:模式修正符

# 遇到数字或者逗号或者分号,就分割
print(re.split(r'\d|,|;','w1w2w3w,w;w'))   #['w', 'w', 'w', 'w', 'w', 'w']
# \W表示非0-9a-zA-Z_的中任何一个字符,则分隔。
print(re.split(r'\W+','Words,words,words.'))  # ['Words', 'words', 'words', '']
# 遇到字母则分隔,忽略大小写
re.split('[a-f]+', '0a3B9', flags=re.IGNORECASE) # ['0','3','9'] re.sub和re.subn() :在目标字符串中以正则表达式的规则匹配字符串,再把他们替换成指定的字符串。可以指定替换的次数, 如果 不指定,替换所有的匹配字符串
sub(pattern, repl, string, count=0)
subn(pattern, repl, string, count=0)
参数:
    pattern:  正则表达式(规则)
    repl:     指定的用来替换的字符串
    string:   目标字符串
    count:    最多替换次数
区别:前者返回一个替换后的字符串,后者返回一个元组,第一个元素替换后的字符串,
     第二个元素表示被替换的次数
print(re.sub(r"(beautiful)", "graceful", "songsong is beautiful girl"))
print(re.subn(r"(beautiful)", "graceful", "songsong is beautiful girl"))
# 结果:
#  songsong is graceful girl
# ('songsong is graceful girl', 1)案例
最近王撕葱很火呀!事件起因后续请各位朋友自己百度吧! 今天看了一个这个文章《王思聪与孙一宁:一个拿钱买爱情,另一个只爱钱不爱你》,正好讲正则表达式,将内容我们实际运用一下,得到里面所有的图片,当然也包含聊天记录和葱油饼的帅照啦!
import re
import requests
import time

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}

response = requests.get("https://baijiahao.baidu.com/s?id=1702640148270885315&wfr=spider&for=pc",  headers = headers)

response.encoding=response.apparent_encoding
content = response.text

pattern = r'src="(.*?)"'

result = re.findall(pattern,content)
print(result)

# 将结果保存到本地
if len(result)>0:
 i = 0
 for pic in result:
  response = requests.get(pic,  headers = headers)
  with open(f'pic{i}.jpg','wb') as s:
   s.write(response.content)
   print(f'完成{i}')
   time.sleep(1)
i+=1 结果:
['https://mbdp01.bdstatic.com/static/landing-pc/img/logo_top.79fdb8c2.png',
'https://pics0.baidu.com/feed/f11f3a292df5e0fe4f91ae4154829ca05cdf72cb.jpeg?token=31e5f16c452781510717fa5c01cd1a16',
'https://pics6.baidu.com/feed/a5c27d1ed21b0ef4f4659d8bd026f9d283cb3e44.jpeg?token=b9888f41d2445081461ad3986470b15d',
'https://pics4.baidu.com/feed/d1a20cf431adcbefd45a5125a34d86d5a2cc9f95.jpeg?token=a1ee173c6905b106a73d8a04314d209f',
'https://pics1.baidu.com/feed/b21c8701a18b87d6bf8c55ca0dea80301d30fd00.jpeg?token=b5c2dd023588c08f5fd7d67017119ed2',
'https://pics0.baidu.com/feed/8cb1cb1349540923723e6d679dba7901b2de49ba.jpeg?token=7211d12f0ac5fda527a6c5a96d010e3e',
'https://ss0.bdstatic.com/5aV1bjqh_Q23odCf/static/superman/img/copy_rignt_8.png']图片结果: