
今天给大家推荐一篇最新的多模态大模型综述论文,由腾讯,东京大学,中科院沈阳自动化所联合创作。
├── 摘要
│ ├── 最新进展介绍
│ ├── 模型架构和训练流程讨论
│ └── 性能评估和未来方向
├── 引言
│ ├── 多模态预训练研究进展
│ └── 利用LLMs增强多模态任务
├── 模型架构
│ ├── 模态编码器
│ ├── 输入投影器
│ ├── LLM骨干
│ ├── 输出投影器
│ └── 模态生成器
├── 训练流程
│ ├── 多模态预训练 (MM PT)
│ └── 多模态指令调优 (MM IT)
├── 现状MM-LLMs
│ ├── 122个模型分类总结
│ └── 发展趋势分析
├── 性能评估
│ ├── 基准测试性能比较
│ └── 训练方法提供
├── 未来方向
│ └── MM-LLMs研究前景方向
├── 结论
│ └── 总结和持续进步强调
└── 限制
├── 研究局限性讨论
└── 改进方向展望
结合论文说一下我对多模态大模型的理解。
/ 01 /
多模态的概念
在机器学习中,图像、视频、文本、语音等每一种数据形式都是一种模态,所谓多模态,就是利用模型去同时处理多个模态数据,例如图生文本、文本生图等。多模态大模型则是在大规模语料上预训练能更好地理解和处理复杂的多模态数据。
/ 02 /
多模态任务类型
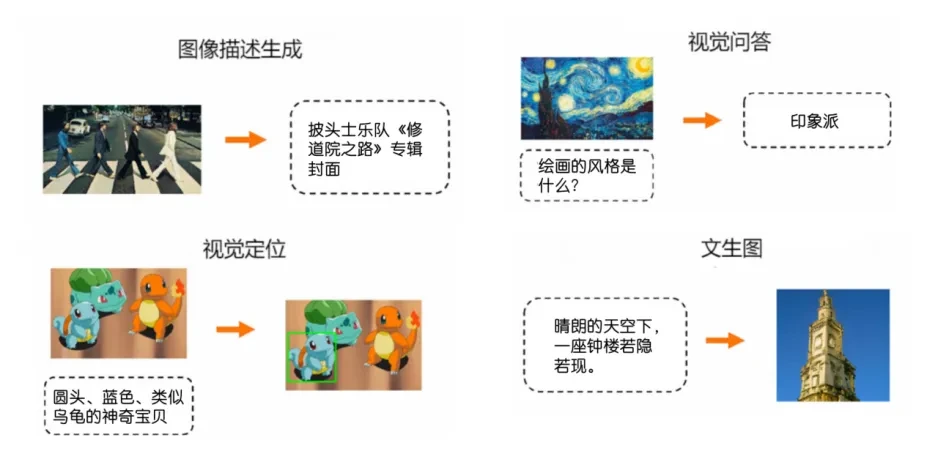
多模态任务可以分为文本和图像的语义理解、图像描述、视觉定位、对话问答、视觉问答、视频的分类和识别、音频的情感分析和语音识别等。
/ 03 /
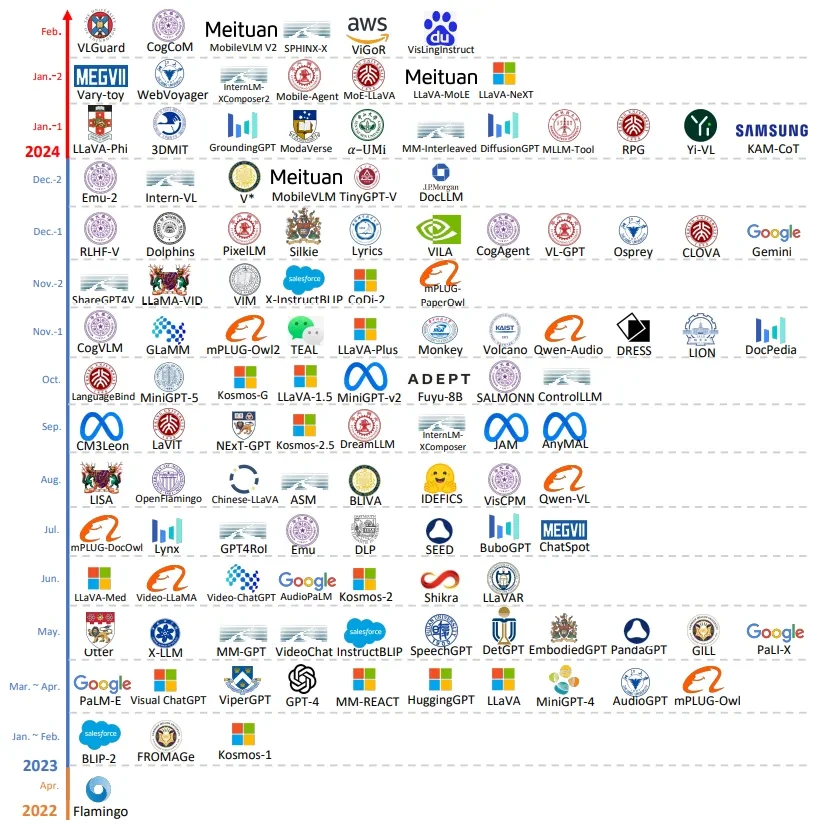
多模态模型编年史
/ 04 /
多模态模型结构
多模态大模型结构可以总结为如下五个主要关键组件。
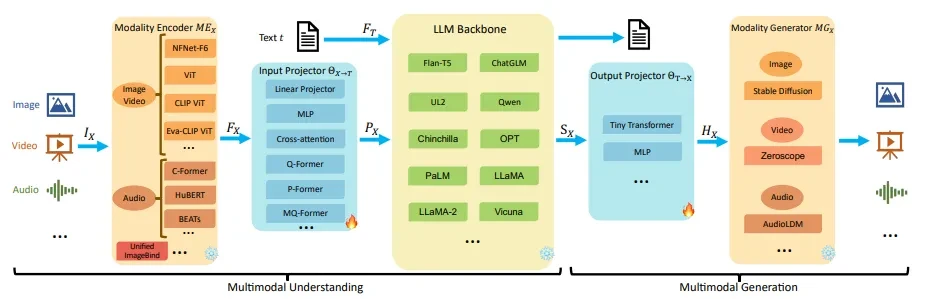
模态编码器(Modality Encoder):负责将输入的非文本数据(如图像、视频、音频)转换为模型能够理解和处理的特征表示。例如,图像编码器(Image Encoder)、视频编码器等。
输入投影器(Input Projector):将模态编码器的输出与文本特征进行对齐,以便模型可以统一处理多种模态的输入,(Multi-Layer Perceptron, MLP)、交叉注意力、线性投影器(Linear Projector)等。
LLM骨干(LLM Backbone):作为模型的核心,通常是一个强大的语言模型,用于处理和生成文本信息,同时能够理解和整合来自不同模态的输入。例如,GPT4等。
输出投影器(Output Projector):将LLM骨干的输出转换为适合生成特定模态内容的形式。例如,MLP等。
模态生成器(Modality Generator):根据LLM骨干和输出投影器的信号生成特定模态的输出,如图像、视频或音频。例如,Stable Diffusion等。
目前主流的大模型都以Transformer为基础,无论是NLP中的Transformer还是CV中的Vision Transformer,通过在大规模训练语料上预训练,能够对文本和视觉进行有效表征。
/ 05 /
多模态之间如何对齐
要想让计算机把一张小狗的图片和“一只小狗”理解成一个东西,最好的方式就是分别把图片和文本转编码成数字向量,且向量之间距离越小越好。
这里的数字向量也被称为Embedding。 文本转Embedding
在NLP中,处理文本时,先要转换成Token。
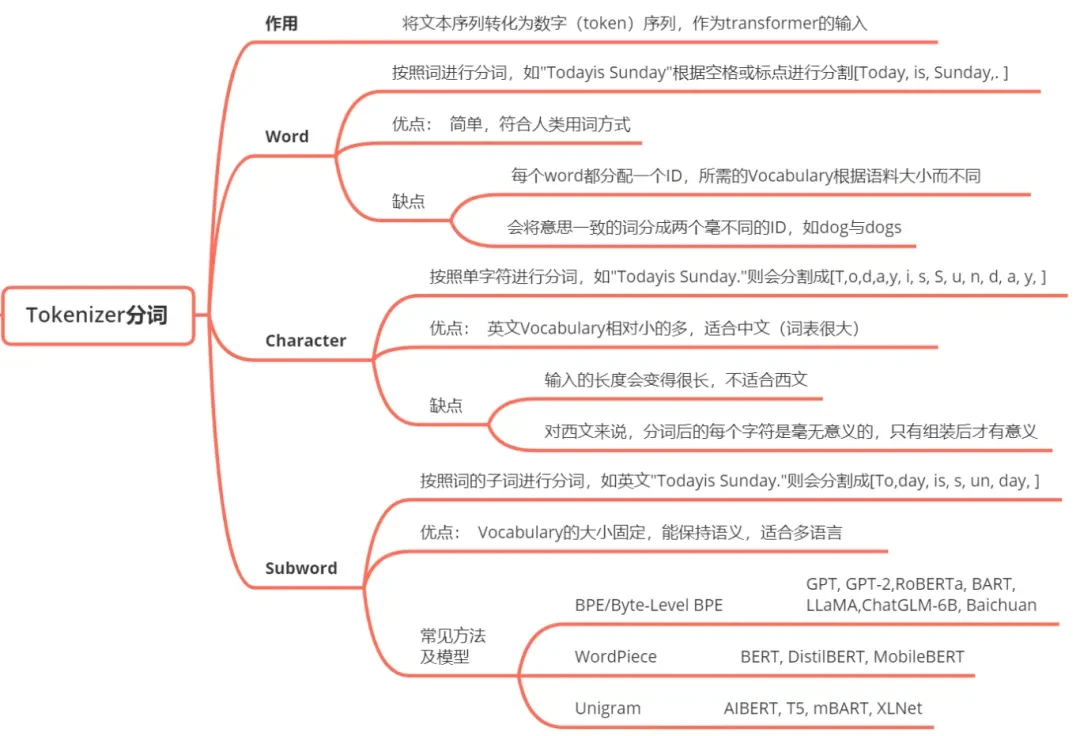
然后再将Token映射成Embedding。举个句子的例子。
输入文本:"I love you"
Tokenization后: ["I", "love", "you"]
Embedding:假设每个token被映射到一个768维的向量,“I love you”被转换成3*768的embeddings
图像转换Embedding
对应NLP中的Tokenization,CV中会将图像划分成小patch,然后再将patch经过线性变换得到patch Embedding。
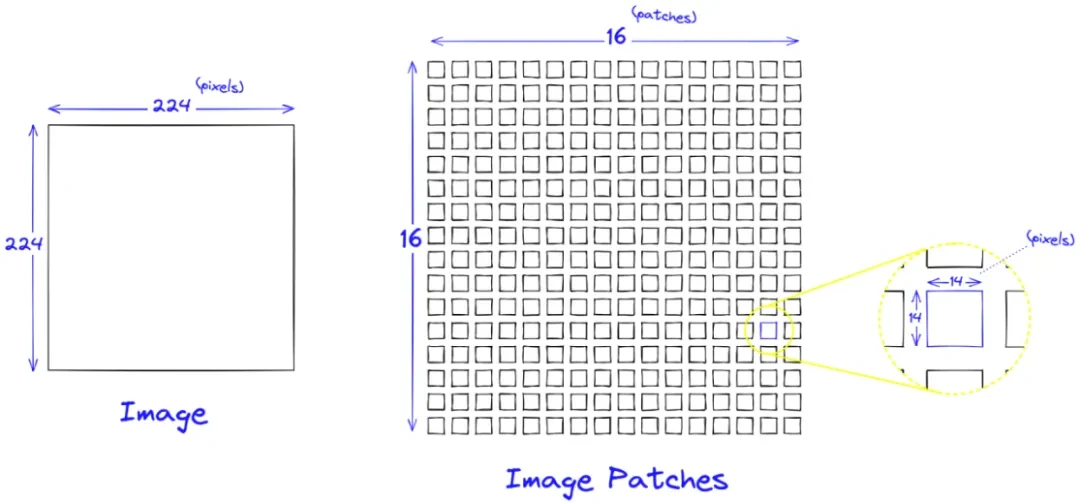
如上图所示,输入224x224大小的3通道图像,patch大小14x14,图像将被切分成(224/14) × (224/14) =256个patches。
每个patch可以展开成14×14×3=588大小的向量,假设每个patch被映射到一个768维的向量,则一幅图像就可以用256*768的embeddings来表示了。
模态对齐
但前面的文本Embedding和图像Embedding大小不一致,也就是对应不同的向量空间,所以还需要模态对齐,也就是通过训练输入和输出投影器来实现不同模态之间的对齐,以便LLM主干能够有效地处理多模态输入。
/ 06 /
多模态训练流程
多模态大模型训练分两个阶段:预训练和微调。 预训练
训练过程通过反向传播算法更新输入输出映射器参数来实现不同模态之间的对齐。数据集通常为图像-文本对,视频-文本对,语音-文本对等。 微调
与ChatGPT微调类似,可以分为指令微调和基于人类反馈的微调。
