
本Up专注于更新现有关于持续学习/终身学习/增量学习(Continual Learning/Lifelong Learning/Incremental Learning)的顶会顶刊论文,您的点赞、收藏、投币、转发或者任何反馈是思齐君更新的最大动力!!!
WX:wxk779963184、E-mail:xiangkunwang18@gmail.com (随时欢迎学术“骚扰”)
survey 1:A Comprehensive Survey of Continual Learning: Theory, Method and Application(TIPAMI2024)
详见论文:https://arxiv.org/pdf/2302.00487.pdf
作者信息:
主要内容:
本文为一篇关于持续学习的全面综述,内容涵盖理论、方法和应用,以最新的研究成果为基础。文章首先介绍了持续学习的设置,包括其基本公式、典型场景和评估指标。接着,作者总结了迄今为止在持续学习方面的理论,以及各种持续学习方法的发展动机。然后,作者详细介绍了各种代表性方法的最新分类和实际应用,并分析了它们的动机和典型实现。此外,作者还讨论了当前趋势、跨方向前景以及与神经科学的联系。
本文的创新点包括:
(1)对持续学习的全面调查,涵盖理论、方法和应用,为后续研究提供了全面的视角。
(2)提供了目前持续学习领域的最新趋势、跨方向前景以及与神经科学的联系,拓宽了研究者的视野。
(3)分析了各种代表性方法的动机和典型实现,有助于理解各种持续学习方法的优缺点和适用场景。
(4)总结了持续学习领域的一般目标和特定挑战,为后续研究提供了指导。
一、持续学习的概念框架
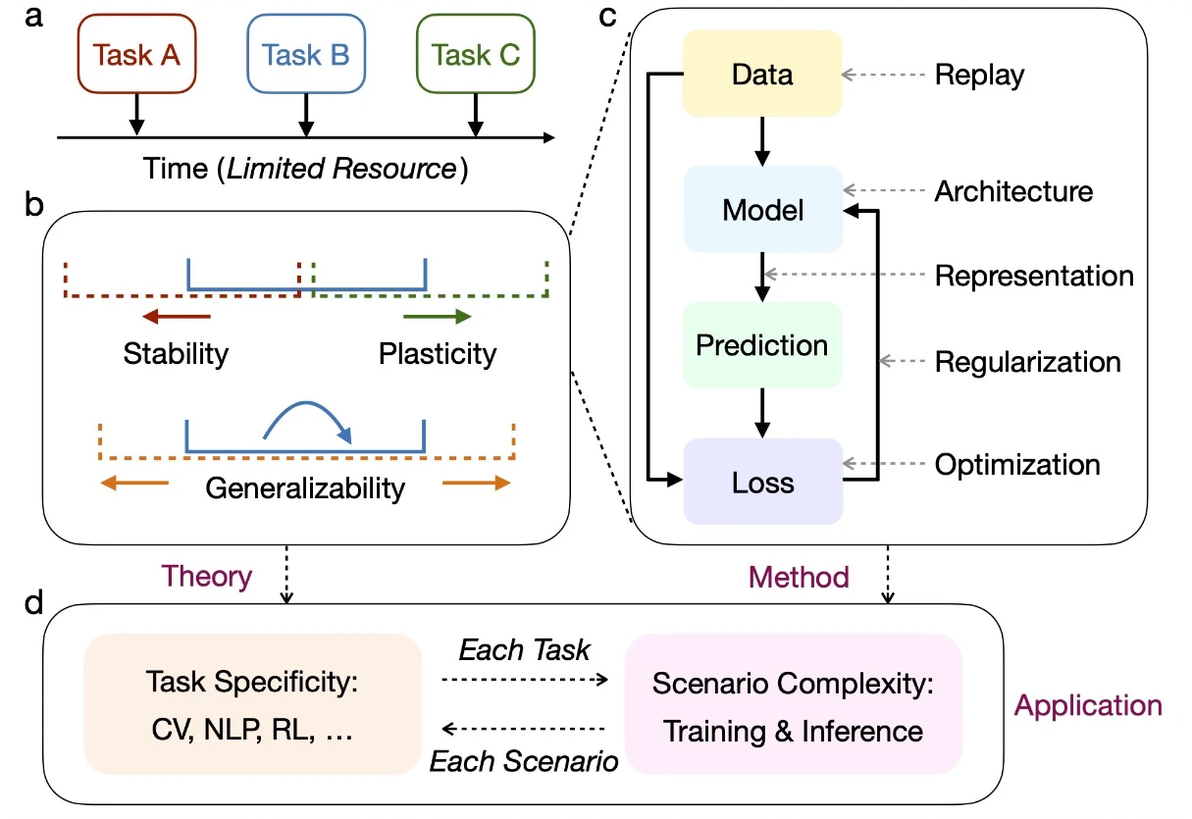
a,持续学习需要适应具有动态数据分布的增量任务(第 2 节)。b,一个理想的解决方案应该确保稳定性(红色箭头)和可塑性(绿色箭头)之间的适当权衡,以及对任务内(蓝色箭头)和任务间(橙色箭头)分布差异的适当概括(第 3 节)。c,为了实现持续学习的目标,代表性方法针对机器学习的各个方面(第 4 节)。d,持续学习适用于实际应用,以解决场景复杂性和任务特异性等特定挑战(第 5 节)。
二、持续学习分类
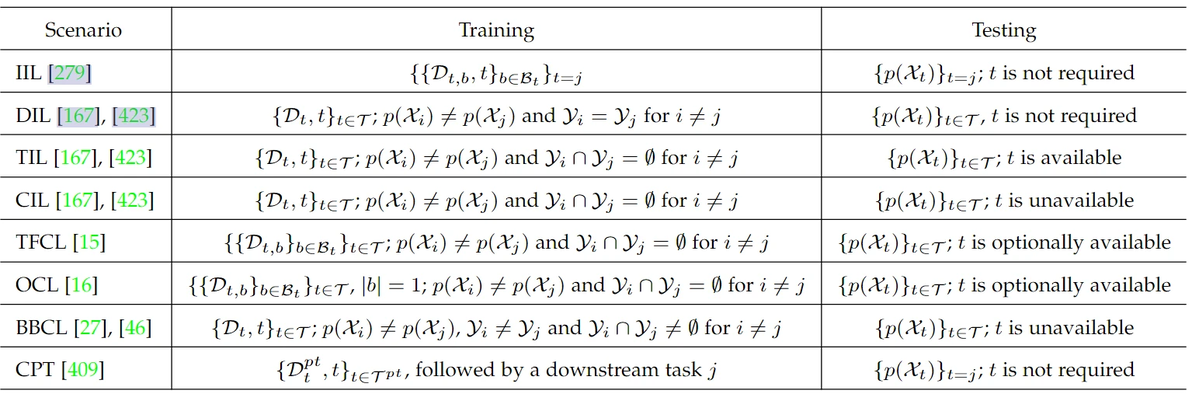
实例增量学习(IIL):所有训练样本属于同一个任务,批量到达。
域增量学习(DIL):任务具有相同的数据标签空间,但输入分布不同。任务身份不是必需的。
任务增量学习(TIL):任务具有不相交的数据标签空间。任务身份在训练和测试中提供。
类增量学习(CIL):任务具有不相交的数据标签空间。任务身份只在训练中提供。
无任务持续学习(TFCL):任务具有不相交的数据标签空间。任务身份在培训或测试中都没有提供。
在线持续学习(OCL):任务具有不相交的数据标签空间。每个任务的训练样本作为一个单通道数据流。
模糊边界持续学习(BBCL):任务边界模糊,其特征是不同但重叠的数据标签空间。
持续预训练(CPT):预训练数据按顺序到达。目标是改进知识转移到下游任务。
三、持续学习的关键因素分析
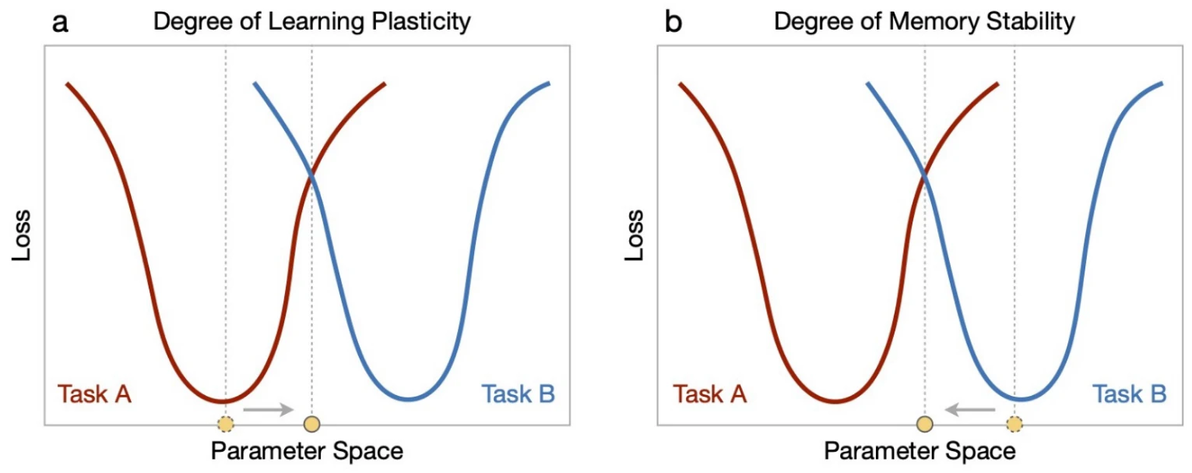
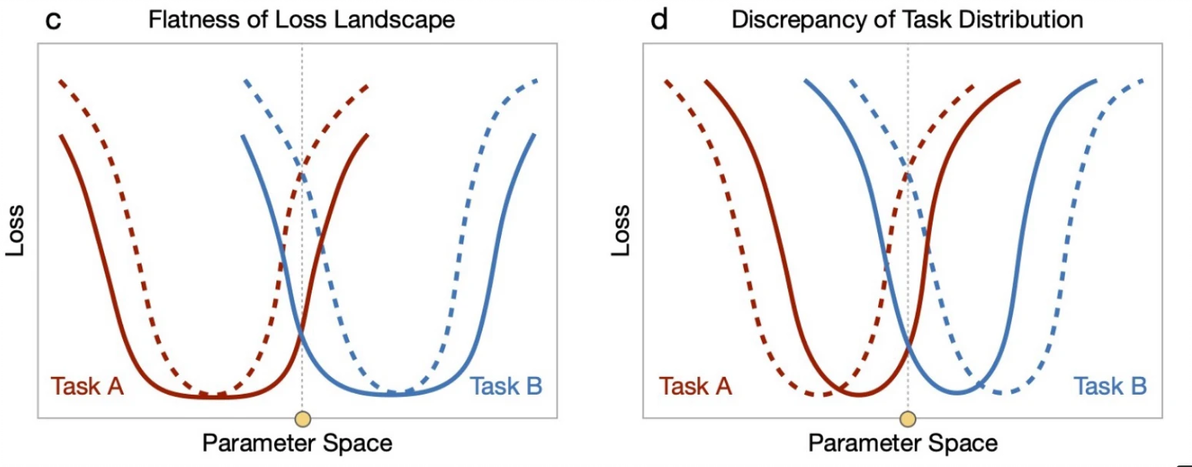
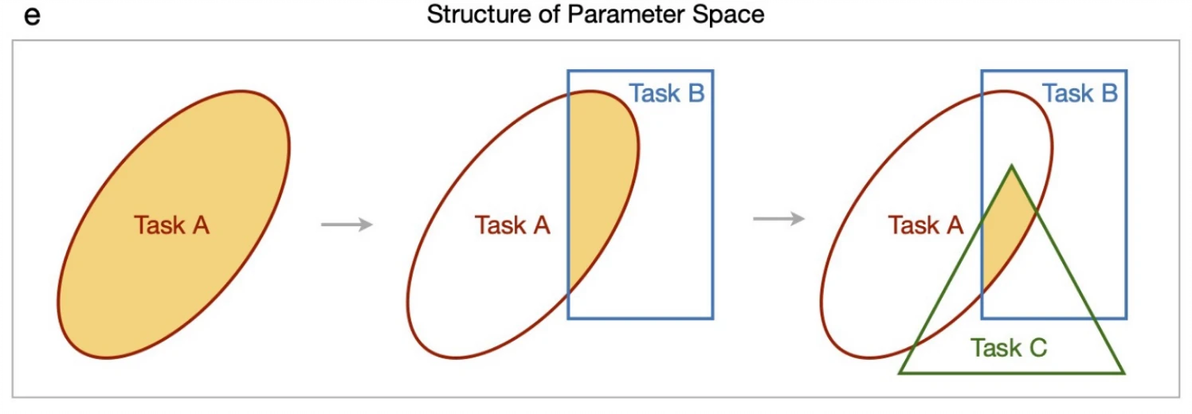
a, b,持续学习需要在学习可塑性和内存稳定性之间进行适当的平衡,其中多余的要么会影响整体性能。c, d,当收敛损失景观平坦且观测数据分布更相似时,适当平衡的解决方案可以更好地泛化到任务序列。e,参数空间的结构决定了寻找理想解的复杂性和可能性。黄色区域表示单个任务共享的可行参数空间,随着引入更多的增量任务,这往往是狭窄和不规则的。
四、持续学习方法分类
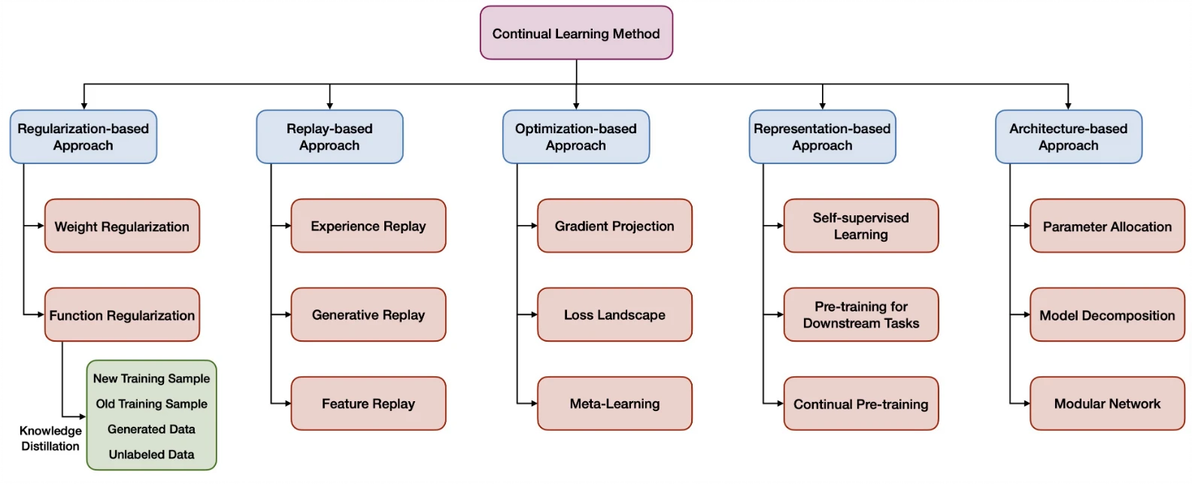
(1)基于正则化的方法
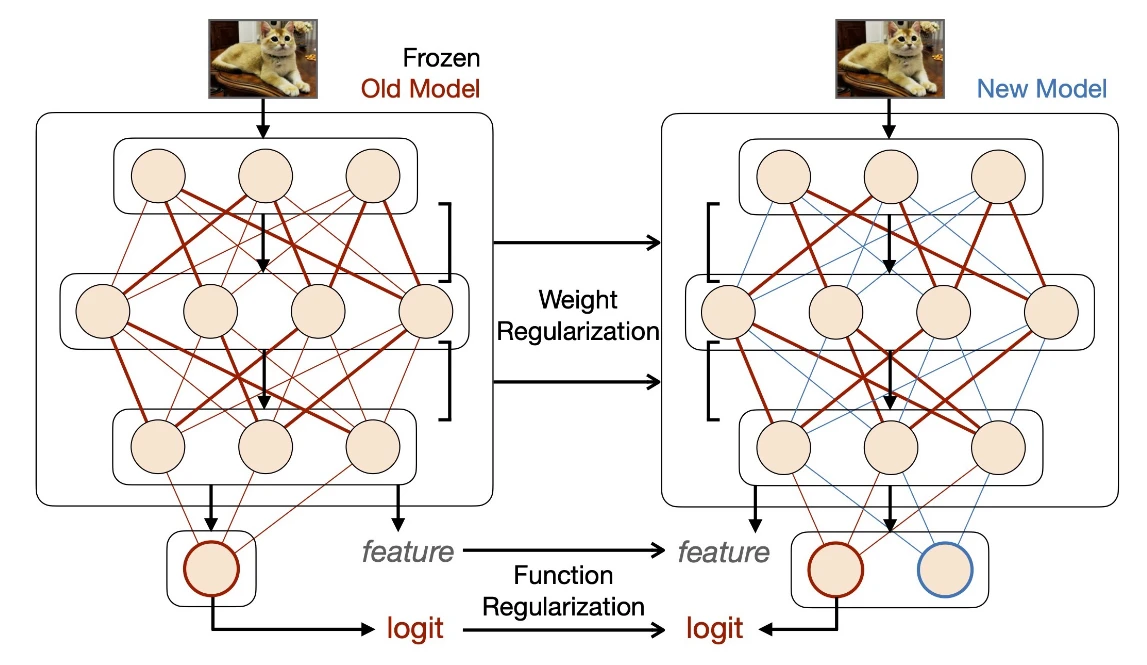
这个方向的特点是添加显式正则化项来模拟旧模型的参数(权重正则化)或行为(函数正则化)。
(2)基于重放的方法
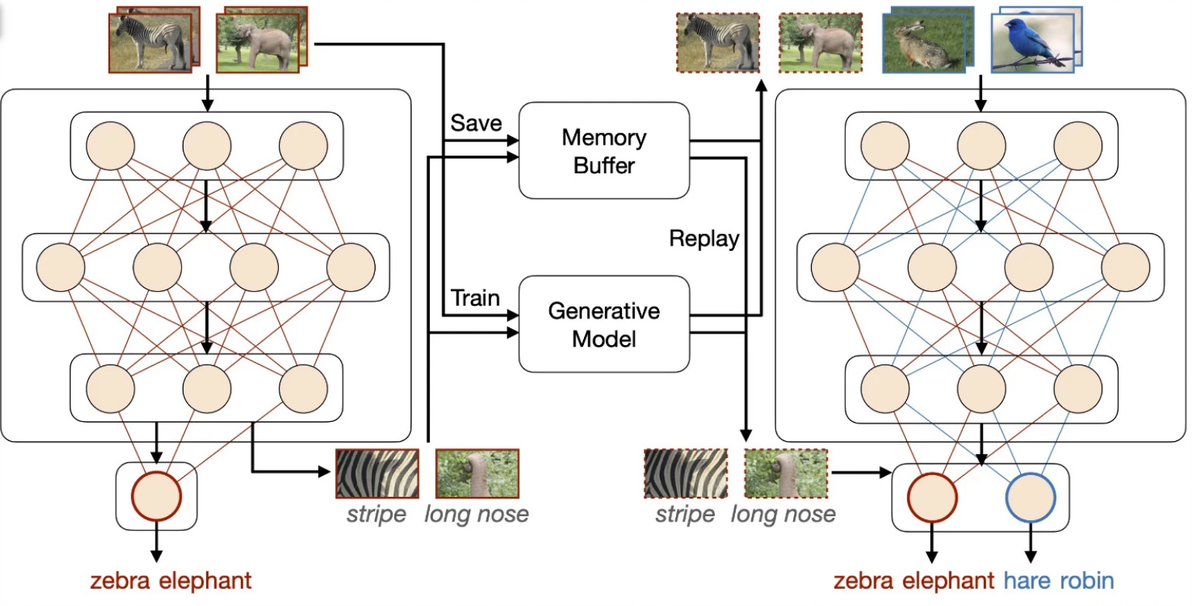
这个方向的特点是近似和恢复旧的数据分布。典型的子方向包括经验回放,它在内存缓冲区中保存了一些旧的训练样本;生成重放,它训练一个生成模型来提供生成的样本;特征重放,它通过保存原型来恢复旧特征的分布,保存统计信息或训练生成模型。
(3)基于优化的方法
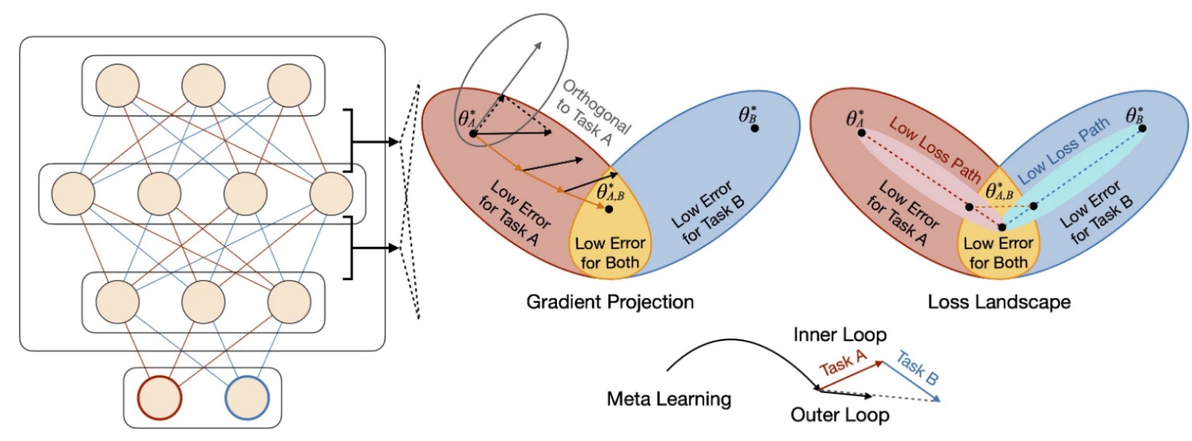
这个方向的特点是对优化程序进行明确的设计和操作,例如参考旧任务的梯度空间或输入空间的梯度投影、内环中顺序到达任务的元学习以及利用损失景观中的模式连通性和平坦最小值。θ∗A、θ∗B和θ∗A、B分别是任务A、任务B和两者的理想解决方案。
(4)基于表示的方法
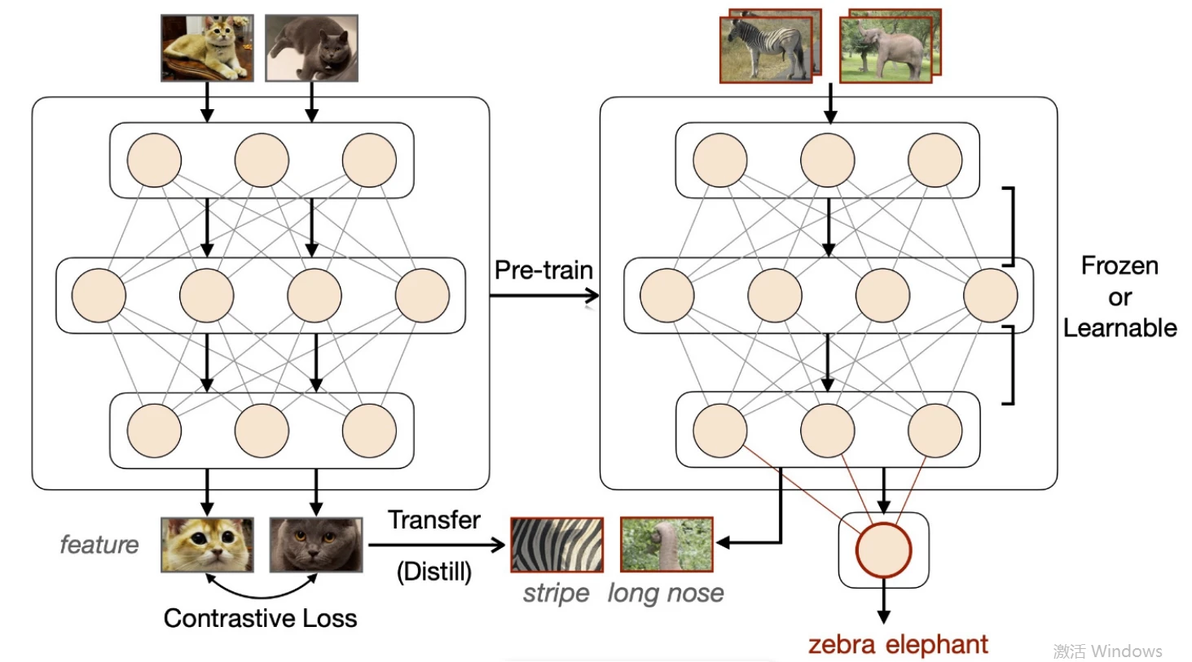
这个方向的特点是创建和利用表示的优势进行持续学习,例如通过使用自我监督学习和预训练。特别是,上游预训练和下游微调都需要持续学习,而预训练的表示可选地固定为学习特定的下游任务。
(5)基于架构的方法
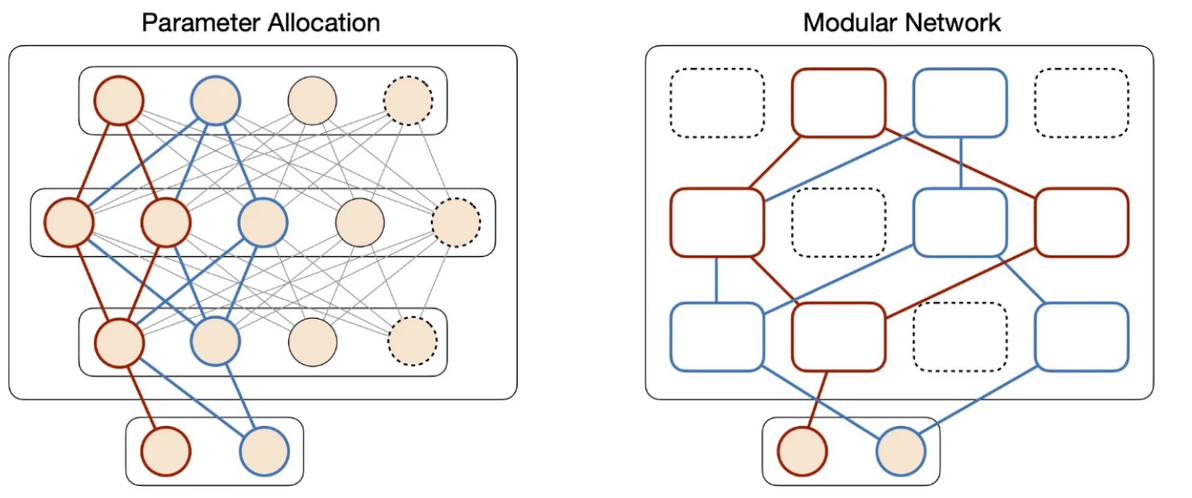
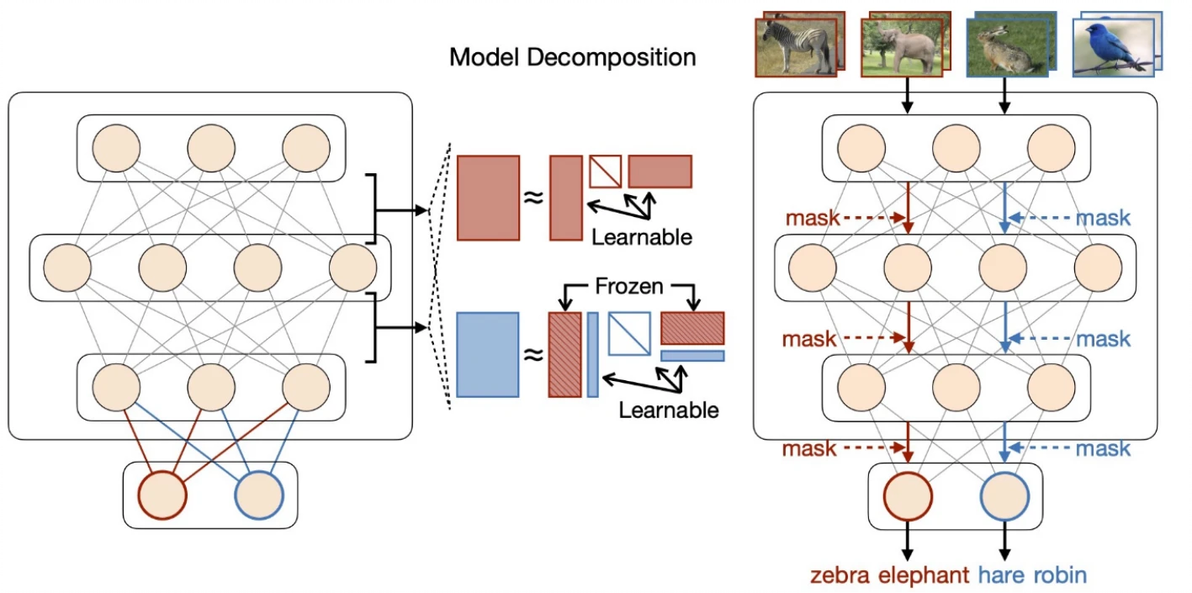
这个方向的特点是使用精心设计的架构构建特定于任务的/自适应参数,例如为每个任务分配专用参数(参数分配)、构建任务自适应子模块或子网络(模块化网络),并将模型分解为任务共享和特定于任务的组件(模型分解)。在这里,我们展示了两种类型的模型分解,对应于参数(低秩分解)和表示(中间特征的掩码)。
五、持续学习在现实应用中的复杂场景
(1)任务不可知推理
持续学习通常具有任务增量学习(TIL)作为基本设置,即在训练和测试中提供任务ID。相比之下,避免使用任务ID进行测试的任务不可知推理在实际应用中往往更自然,但更具挑战性,即分类任务的类增量学习(CIL)。例如,让我们考虑两个二元分类任务:(1)“zebra”和“elephant”; (2)“hare”和“robin”。在学习了这两个任务后,TIL 需要知道它是哪个任务,然后相应地对这两个类进行分类,而 CIL 同时直接对四个类进行分类。因此,CIL受到越来越多的关注,成为持续学习最具代表性的场景。
(2)标记数据稀缺
当前的大多数持续学习设置都假设增量任务有足够多的标记数据,这在实际应用中通常很昂贵且难以获得。出于这个原因,越来越多的研究集中在持续学习中标记数据的稀缺性。
(3)广义持续学习
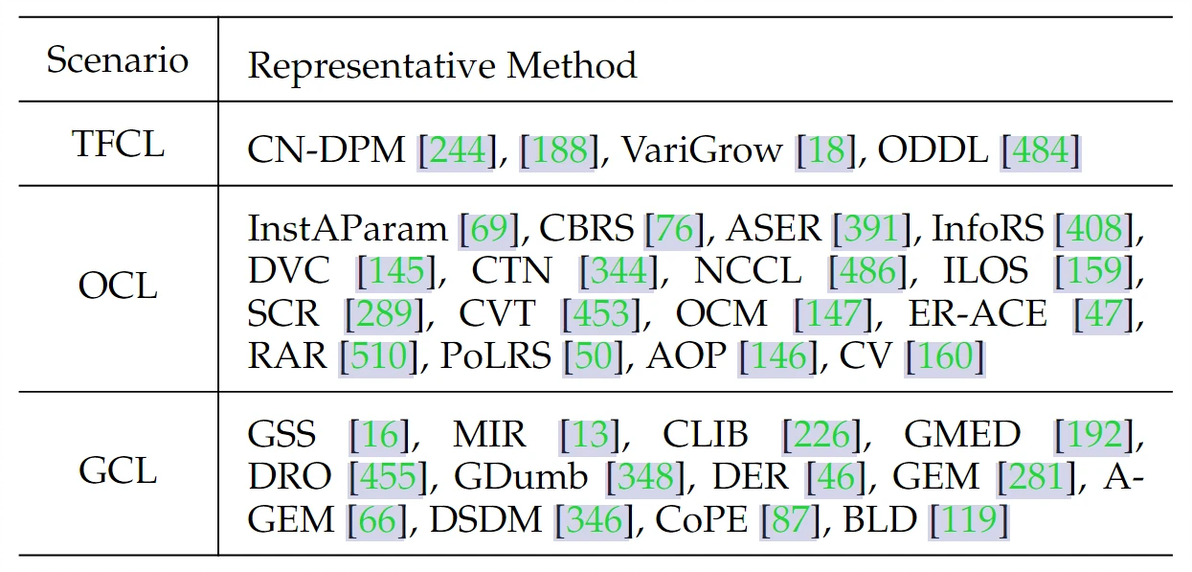
学习范式的潜在挑战可以概括为一个广义概念,称为广义持续学习(GCL),其中模型以在线方式观察增量数据,没有明确的任务边界。相应地,GCL由两个相互连接的设置组成:无任务持续学习(TFCL),其中任务身份在训练或测试中都无法访问;以及在线持续学习(OCL),其中训练样本在一遍数据流中观察到。由于 TFCL 通常一次只访问小批量训练样本,以逐步改变任务分布,而 OCL 通常只需要数据标签而不是每个训练样本的任务身份,因此 TFCL 和 OCL 的许多代表性方法确实兼容。
六、持续学习在现实应用中的具体任务
(1)增量目标检测(IOD)
是目标检测持续学习的典型扩展,其中按顺序引入用不同类别的训练样本,模型需要正确定位和识别属于先前学习的类的对象实例。与在每个训练样本中只有一个对象实例的视觉分类不同,目标检测通常有多个对象实例属于一起出现的旧类和新类。这种共现对 IOD 带来了额外的挑战,其中旧类的对象实例在学习新类时被注释为“背景”,从而加剧灾难性遗忘。另一方面,这使得知识蒸馏成为IOD的一种自然强大的策略,因为旧类的对象实例可以从新的训练样本中获得,以约束新旧模型之间响应的差异。
(2)持续语义分割(CSS)
对类进行像素级预测,除了旧的类外学习新类。与IOD类似,新旧类的对象实例可以一起出现。一些早期的努力利用持续学习中旧类和新类的完整注释。然而,由于重新注释旧类的显着费用和时间成本,更多的注意力集中在仅使用新类的注释上,这导致旧类被视为背景(称为背景偏移),从而加剧灾难性遗忘。
(3)持续条件生成 (CLCG)
与生成重放密切相关,可以通过恢复先前学习的数据分布来减轻当前训练的生成模型和/或判别模型的灾难性遗忘。这通常需要在新训练过程中保存旧生成模型的冻结副本以进行条件生成。由于采样分布通常在训练和测试中提供,因此 CLCG 类似于 TIL 的设置,而没有任务身份预测的挑战。
(4)持续强化学习 (CRL)
由于状态、动作和环境的过度交互,需要持续强化学习 (CRL) 来解决任务内和任务内的动态数据分布(分别对应于 TIL 和 TFCL 的设置)。各种类型的持续学习策略不仅被证明适用于视觉分类,还用于强化学习(RL),如EWC、MAS、VCL、P&C、AFEC、UCL、AGS-CL、CPR、渐进网络、PackNet、ER、A-GEM等。
(5)NLP中的持续学习
近年来,自然语言处理 (NLP) 中的持续学习受到越来越多的关注,它共享视觉领域中提出的许多典型设置和代表性方法。具体来说,NLP 考虑了一系列持续学习场景,包括 DIL、TIL、CIL、OCL 和 CPT [209]。因此,许多有代表性的方法适用于这些场景,被证明是有效的。
(6)可信的持续学习
持续学习可以使任务性能之外的许多考虑因素受益,例如效率、隐私和鲁棒性。持续学习的一个主要目的是避免重新训练所有旧的训练样本,从而提高模型更新的资源效率,不仅适用于学习多个增量任务,而且对常规单任务训练也很重要。由于基于梯度的优化的性质,网络倾向于“忘记”观察到的训练样本,因此需要重复训练来捕获分布。
七、讨论
(1)发展趋势
由于持续学习直接受到灾难性遗忘的影响,以前的努力试图通过促进旧知识的记忆稳定性来解决这个问题。然而,最近的工作越来越专注于促进学习可塑性和任务间的泛化性。这本质上促进了对持续学习的理解:一个理想的解决方案需要在旧任务和新任务之间进行适当的平衡,具有足够的泛化性来适应它们的分布差异。
(2)横向视角
Diffusion Model、Foundation Model、Transformer-based Model、Multi-Modality、Embodied AI等等
(3)神经科学视角
神经科学的灵感在持续学习的发展中起着重要作用。由于生物学习自然是在持续的基础上,其潜在的机制为AI模型提供了极好的参考。
生物神经网络能够灵活地调节突触可塑性以响应动态输入,包括(1)稳定先前学习的突触变化以克服后续干扰,这激发了权重正则化策略,选择性地惩罚参数变化;(2)功能连接的数量扩展和修剪,为新的记忆形成提供灵活性,它推导出了创建额外空间以学习当前任务并与前一个任务重新归一化的扩展重整范式;(3)突触可塑性的活动依赖和持久调节,即突触可塑性的元可塑性或“可塑性可塑性可塑性”,对应于元学习的使用;(4)激发神经元的抑制性突触,以减少其他神经元的活动,这与用于参数分配的二进制掩码类似。
至于区域协作,互补学习系统(CLS)理论已被广泛用于激发持续学习,它将生物学习和记忆的优势归因于海马体和新皮质的互补功能。海马体负责快速获取特定经验的分离表示,而新皮质能够逐步获取结构化知识进行泛化。特别是,海马体可以重放先前经验的神经表示,因此它的功能通常由记忆缓冲区或生成模型来表示,以恢复旧的数据分布。然而,海马体重放不是使用原始数据格式(例如,大约 6 秒的经验可以压缩为 0.2 秒),这可能会提高资源效率。通过重放压缩数据或特征表示,进一步结合了这种生物学优势。相比之下,新皮层依赖记忆通常是长期和可概括的,其中表示可以以无监督的方式逐步获得并表现出正交性,这与自监督学习中自我监督和预训练表示的优势一致。此外,生物大脑的某些区域具有类似于专家混合的模块化架构,例如前额叶皮层(即新皮层区域)调节来自各种皮层模块的感觉信息和蘑菇体(即果蝇中的记忆中心)协调多个平行隔室来处理顺序到达的经验,对应于在持续学习中使用模块化网络。
