
在本地的MP4视频获取帧十分简单,因为有各种各样十分强大的工具可以使用,但是一个网络视频就很难了,你可能需要完整的下载这个视频才能随机的从中获取一帧(FFMPEG就是这样的,可以边下边获取,但是不能随机获取)。
可能有人说现在网上播放视频,不是随便拉动进度条就可以播放了吗,也不用我完全下载整个视频啊,确实,我一开始也是这么想的,但是找了半天也没有找到对应的程序。
我的初衷是搞一个自动生成视频的缩略图的程序,是什么样的缩略图呢?如下图所示
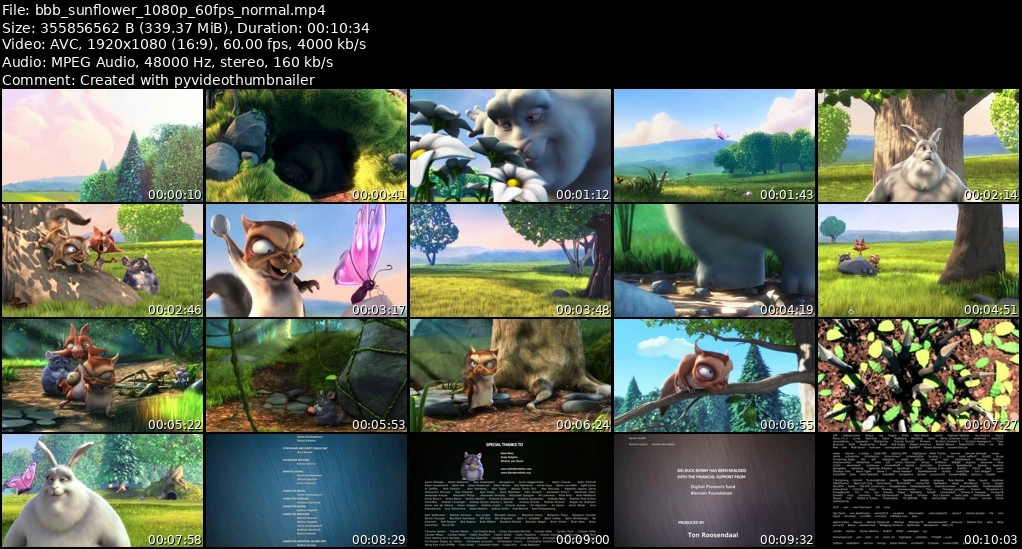
有很多程序可以生成这种缩略图,但是没有一个可以不用完整下载整个mp4文件就可以生成的,所以我就打算自己写,结果发现他们不搞是有原因的,这个东西远比想象的复杂。
先简单介绍下MP4的相关结构
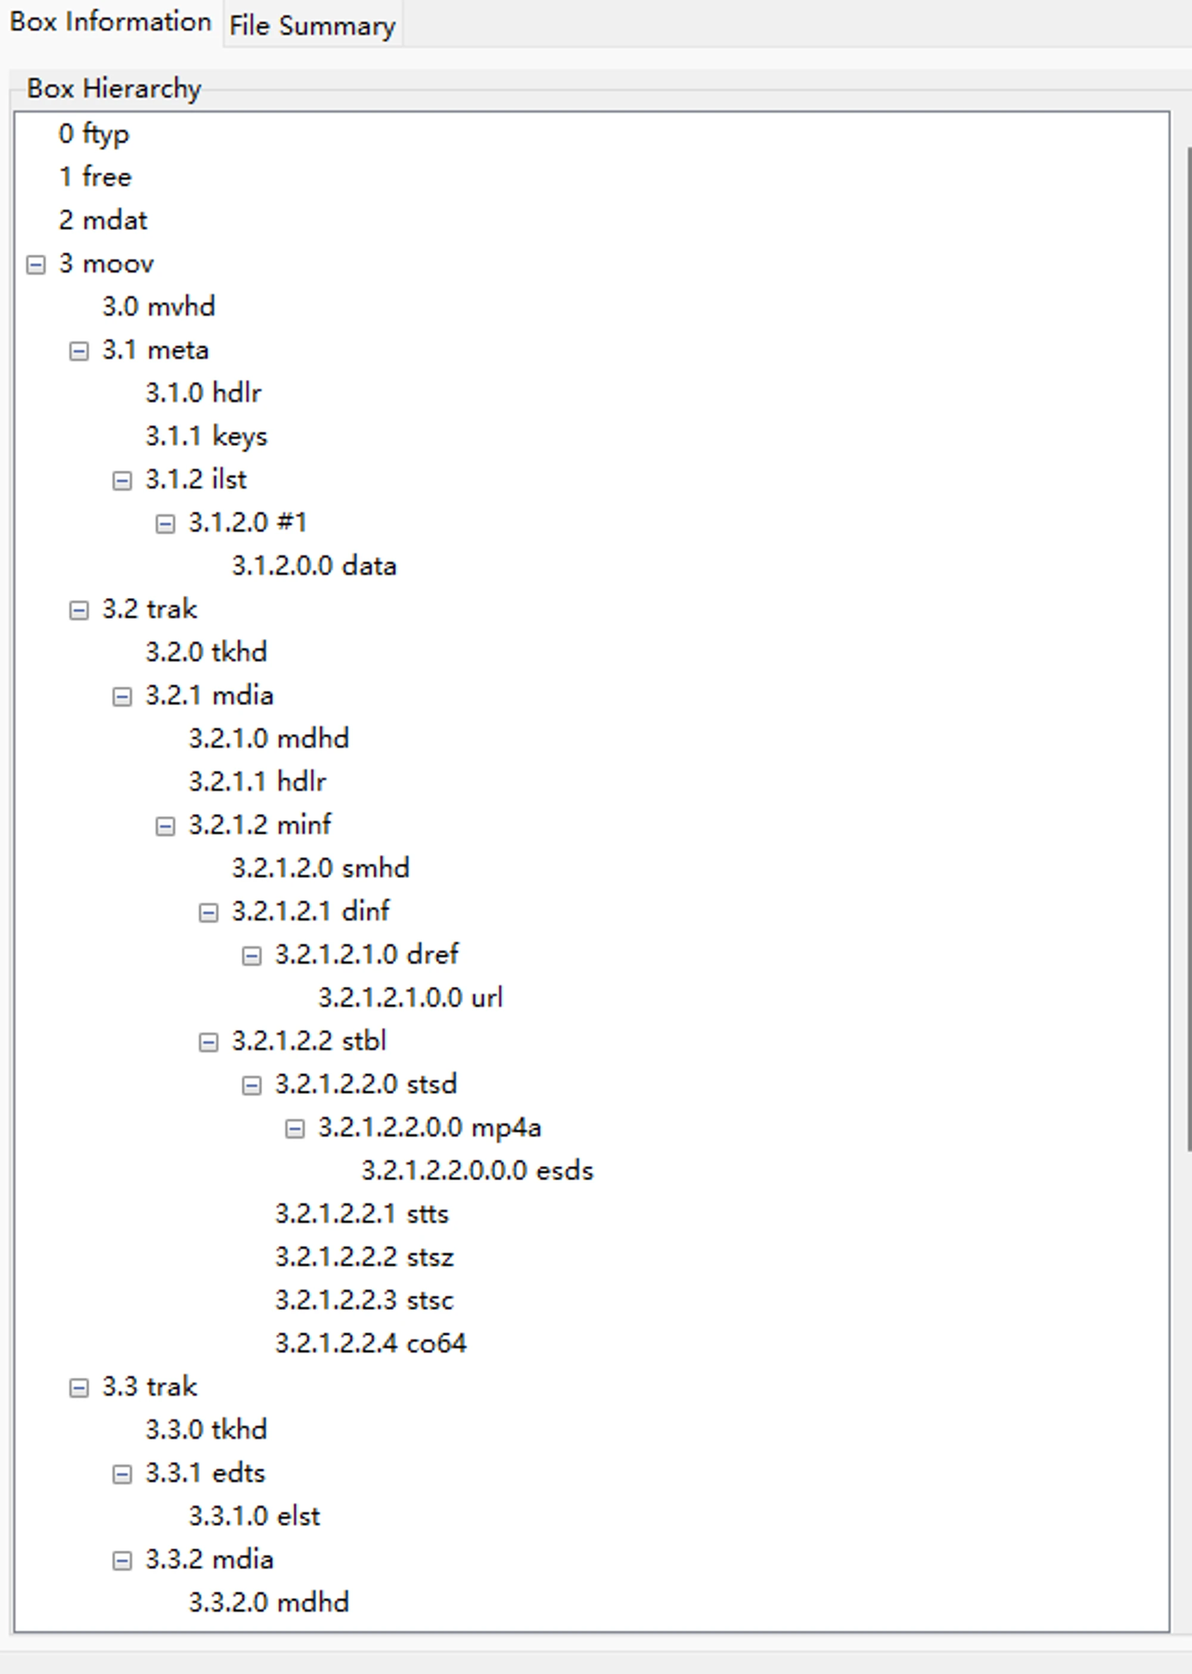
MP4文件是由多个box组成,一般来说常见的大box有三种:
ftyp( file type,文件类型)box:标明自己是 MP4 并提供额外的兼容性信息
moov(metadata container, 电影)box:包含以其他框的嵌套结构组织的元数据
mdat(media data container,媒体数据)box:包含音频/视频有效载荷。
其中,moov是最重要的部分,包含的信息如下
mvhd:movie header,文件的总体信息,如时长,创建时间等
trak:track or stream container,存放视频/音频流的容器
mdhd:media header,定义TimeScale , track需要通过TimeScale换算成真实时间
hdlr: handler,表明本track类型,指明是video/audio/还是hint
minf : media information container
stsd: sample descriptions
stts: decoding time to sample, DTS sample序号的映射表
ctts: composition time to sample CTS(创作时间)DTS对应sample序号的映射表
stsc: sample-to-chunk, sample和chunk的映射表
stsz/stz2: sample size, 每个sample的大小
stss: sync sample table, 关键帧列表
stco/co64: chunk offset, 每个chunk的文件偏移
stbl: sample table box包含样本序号/时间/文件位置映射的信息
tkhd:track header,track的总体信息,如时长,宽高等
mdia: track media information container ,不解释
找到MOOV BOX
第一步就是要找到moov box,以便于获取文件的相关信息,但是一般来说能看到的视频header有两种:
(可使用 https://hexed.it/ ,也可以下载010 editor进行二进制信息分析,这里使用的是010 editor)
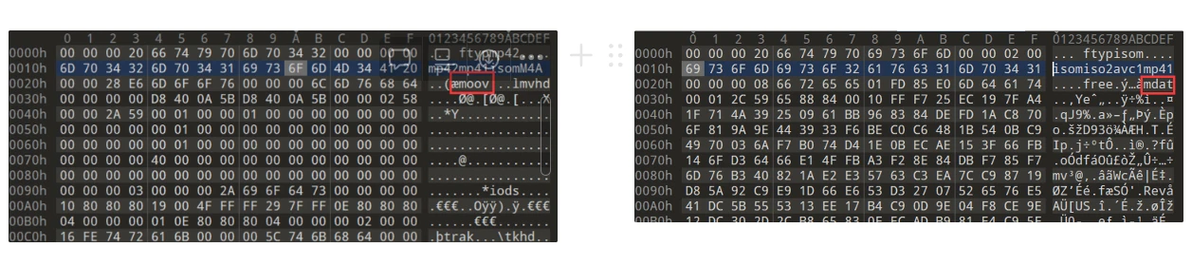
第一种比较容易,因为moov box直接在最前面,但是第二种就稍微麻烦了,因为mdat在最前面,所以必须跳过数据包部分,处理这个问题有一个分支,一个是小于4GB的文件,一个是大于4GB的文件,小于4GB的文件,数据字节量会在mdat前面,占用4个字节(2^{32}B),大于4GB的文件,数据字节量会在mdat后面,占用8个字节,8个字节足以存储绝大多数视频的数据部分所占用的字节数了。
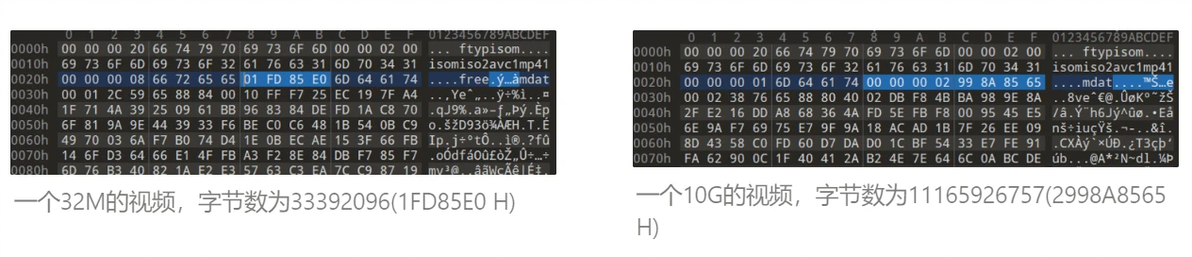
Python 代码如下:
if data.find(b"mdat") > 0:  # 如果数据块中包含mdat字符串
    index = data.find(b"mdat")  # 找到mdat数据块的起始位置
    # 读取mdat前的4个字节,如果结果是b'\x00\x00\x00\x01',则mdat数据块的大小需要用64位表示,需要读取mdat后面的8个字节
    if data[index - 4 : index] == b"\x00\x00\x00\x01":
        video_size = struct.unpack(">Q", data[index + 4 : index + 12])[0]
    else:  # 否则mdat数据块的大小用32位表示,需要读取mdat前面的4个字节
video_size = struct.unpack(">I", data[index - 4 : index])[0]我们使用requests请求视频,通过流的形式进行请求
r = requests.get(url, stream=True) # 使用stream模式获取视频数据获取时长和宽高
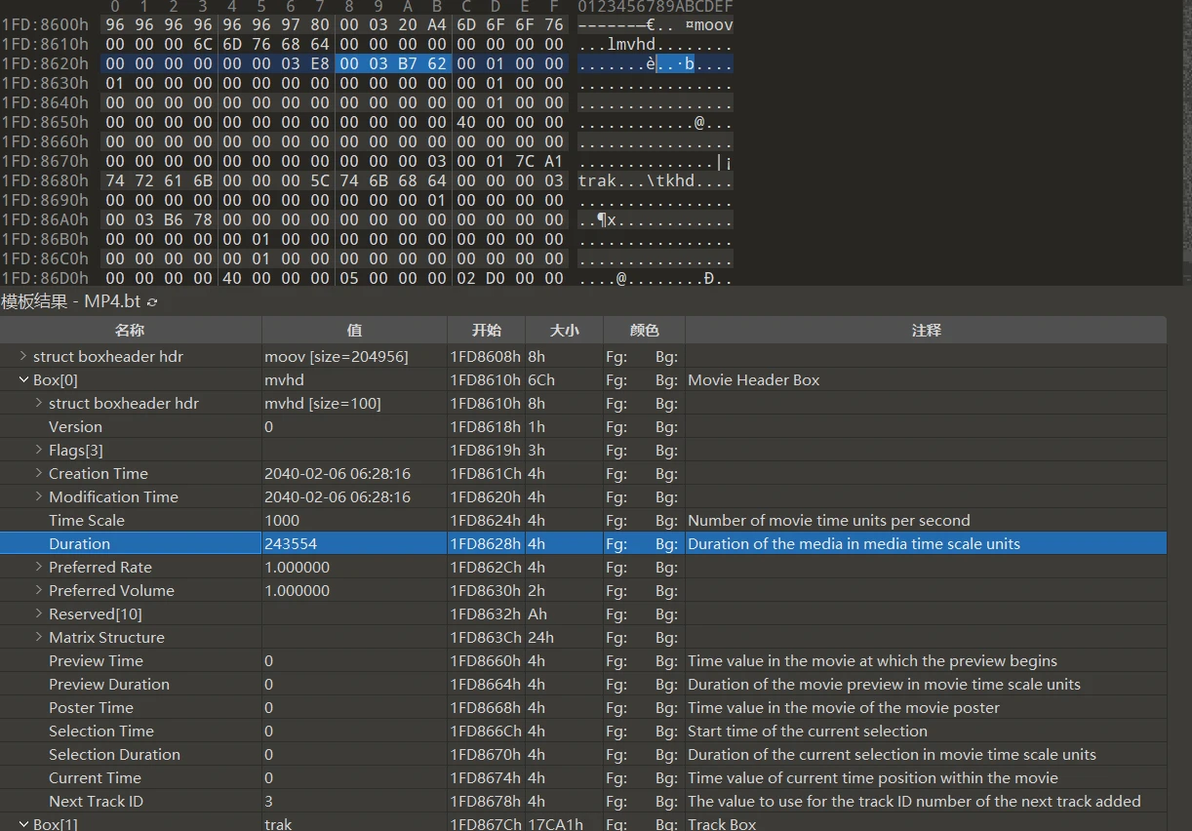
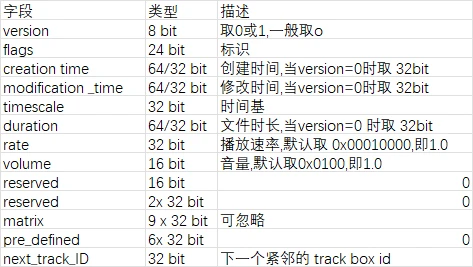
之后我们就要解析moov了。首先解析出视频的总时间、宽、高,我们首先找到mvhd,mvhd所包含的信息如下:
010 editor 自带的MP4模板
我们找到Time Scale和Duration,知道这个文件是以1000毫秒为时基,有243544个时长,处理代码如下:
if data.find(b"mvhd") > 0:  # 如果数据块中包含mvhd字符串
    index = data.find(b"mvhd") + 4  # 找到mvhd数据块的起始位置,向后偏移4字节
    # 从第13位到第17位读取时基的值,用大端序转换为整数
    time_scale = struct.unpack(">I", data[index + 13 : index + 13 + 4])[0]
    # 从第17位到第21位读取时长的值,用大端序转换为整数
    duration = struct.unpack(">I", data[index + 13 + 4 : index + 13 + 4 + 4])[0]
seconds = duration / time_scale # 计算视频的秒数再获取视频的长宽,视频的宽高一般来说是在第一个trak的tkhd中,第二个trak一般来说是音频的信息,tkhd所包含的信息如下:
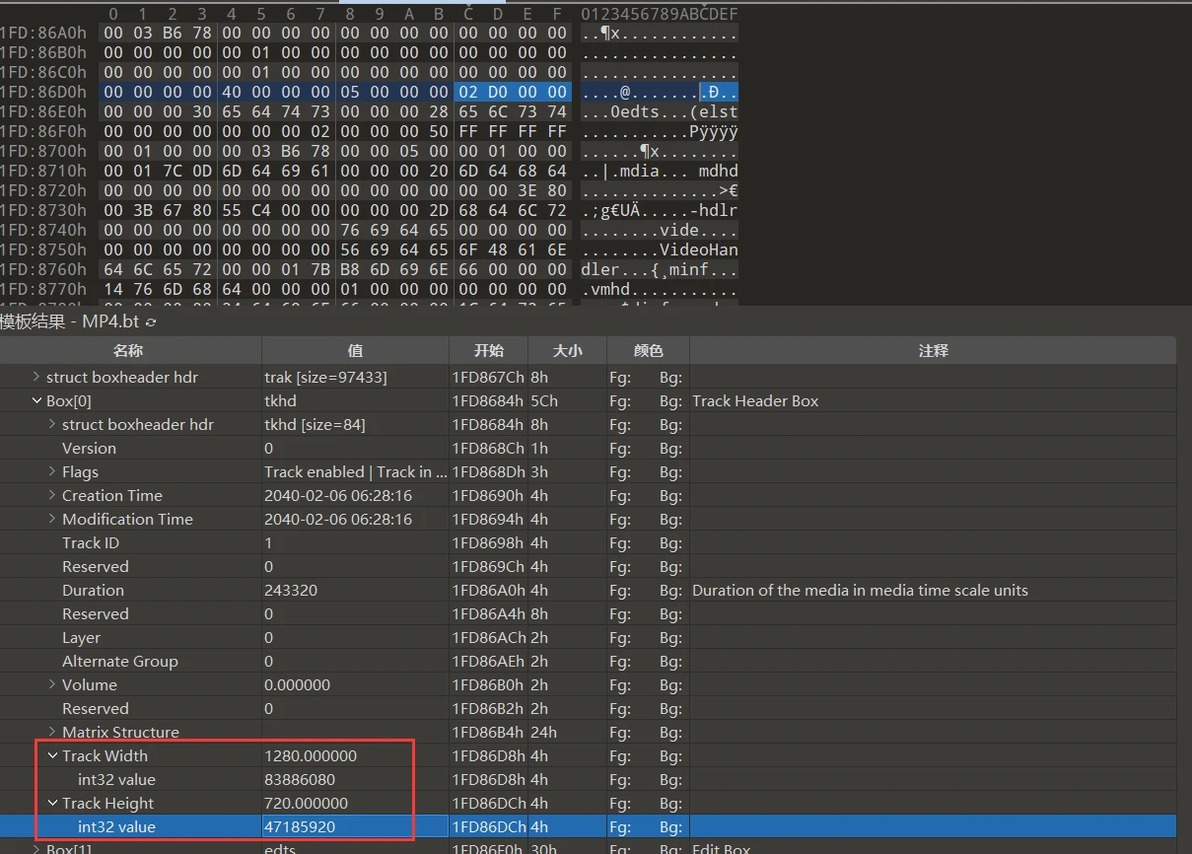
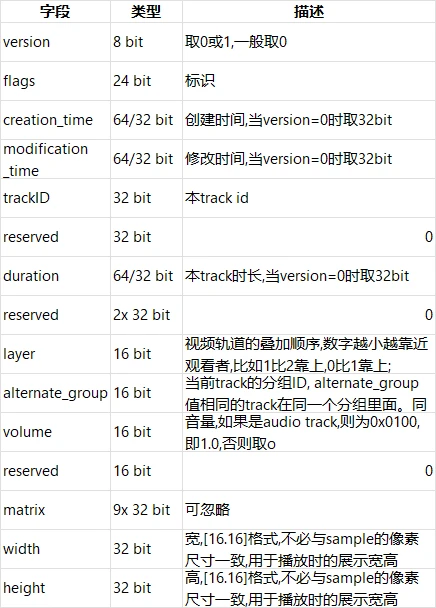
则代码如下:
if data.find(b"tkhd") > 0:  # 如果数据块中包含tkhd字符串
    index = data.find(b"tkhd") + 4  # 找到tkhd数据块的起始位置,向后偏移4字节
    # 从第76位到第80位读取视频长度的值,用大端序转换为小数
    temp = struct.unpack(">I", data[index + 76 : index + 76 + 4])[0]
    if temp > 0:
        width = temp / 65536  # 读取到的值除以65536,得到视频的宽度
        # 从第80位到第84位读取视频宽度的值,用大端序转换为整数
        height = struct.unpack(">I", data[index + 80 : index + 80 + 4])[0]
height = height / 65536 # 读取到的值除以65536,得到视频的高度由于可能读到音频的tkhd,所以需要限定值大于零,原始宽高的数据是乘了一个65536,要除掉。(1920 × 65536 = 83886080)
H.264 编码简介
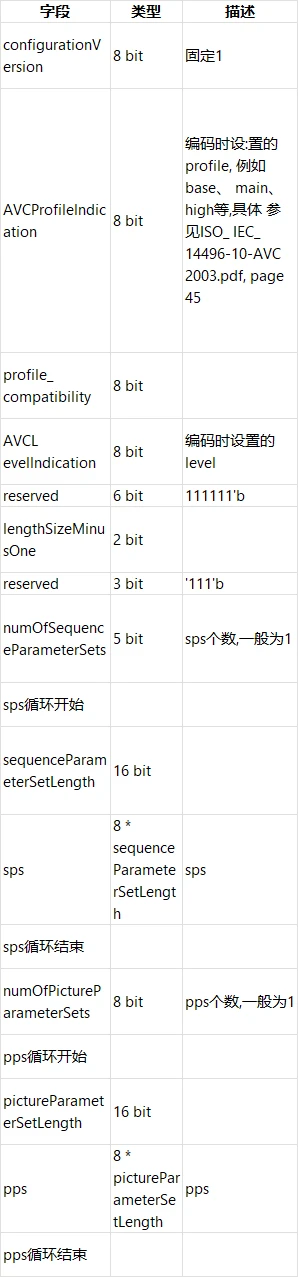
由于目前大部分MP4视频帧的封装格式都是h264,所以我们需要提取出h264的视频帧,然后加入h264的头,就可以把他们当做直播视频流之类的东西,通过PyAV库来进行解析,当然在这之前还需要确定这个视频是不是使用h264来进行编码的,此时需要检测是不是包含avc1 box,avc1 box包含在stsd(sample description box) 中。stsd的字段信息如下:
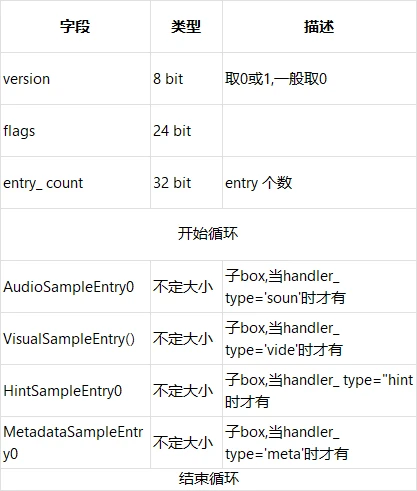
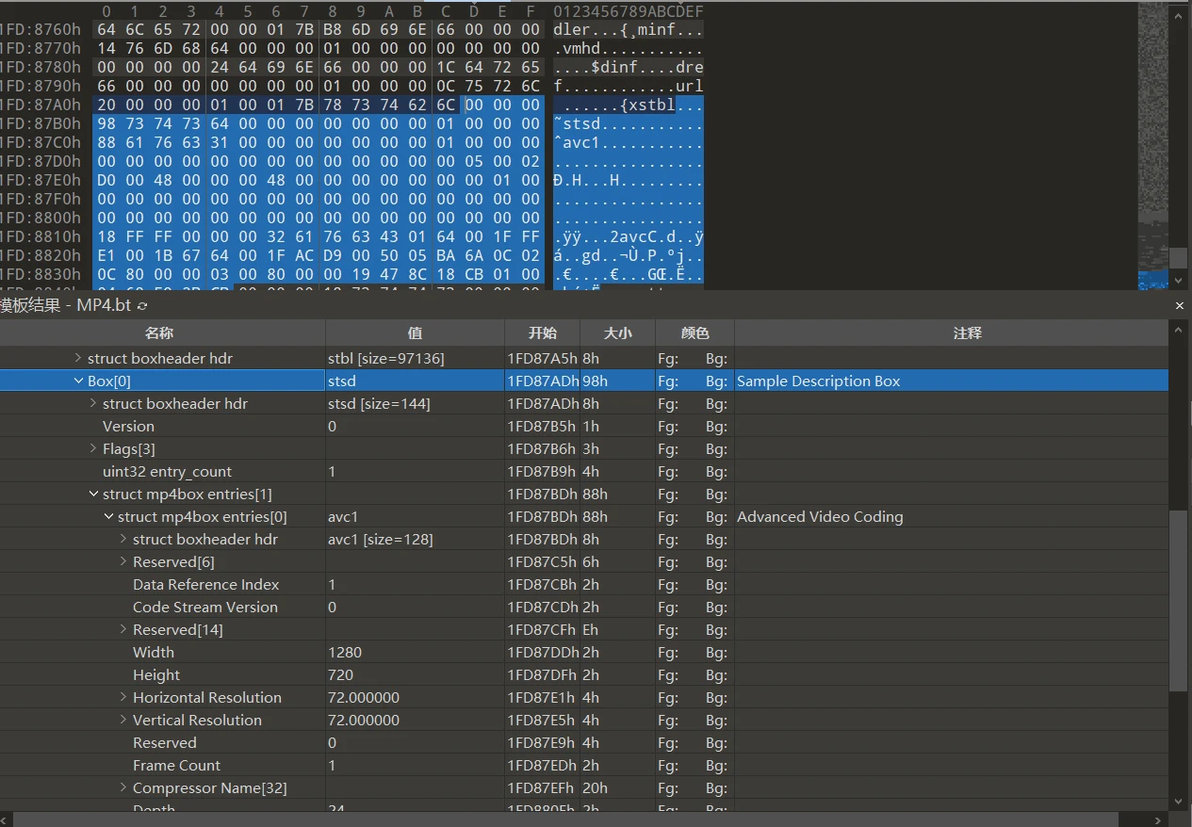
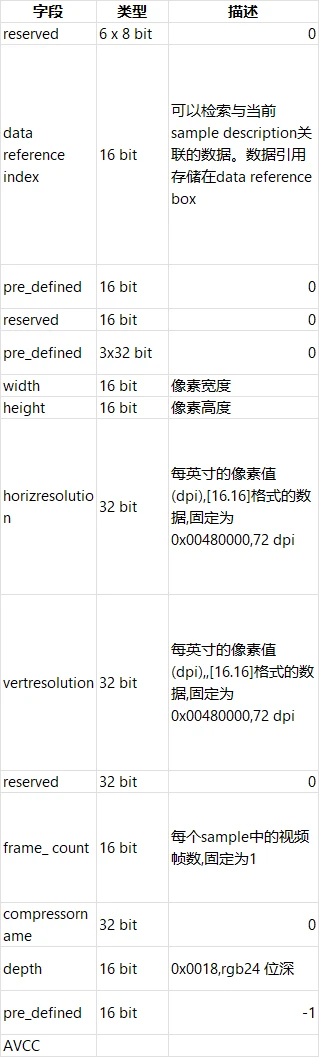
有了AVC1 box,就可以提取出对解码比较重要的,在AVCC box中的几个关键信息SPS(Sequence Parameter Sets)和PPS(Picture Parameter Set),SPS 和 PPS 中存放了解码过程中所需要的各种参数,是 H.264 解码的前置条件,没有 SPS 和 PPS,视频将会无法解码,所以在解码的时候,我们总是首先把 SPS 和 PPS 传给解码器,供解码器初始化。AVC1和AVCC box的定义格式如下
AVC1:
AVCC:
我们还要了解H.264编码的三种帧I帧 P帧 B帧。
I 帧:帧内编码帧,帧表示关键帧,你可以理解为这一帧画面的完整保留;解码时只需要本帧数据就可以完成(因为包含完整画面)
它是一个全帧压缩编码帧,它将全帧图像信息进行JPEG压缩编码及传输
解码时仅用I 帧的数据就可重构完整图像
I 帧描述了图像背景和运动主体的详情
I 帧不需要参考其他画面而生成
I 帧是P帧和B帧的参考帧(其质量直接影响到同组中以后各帧的质量)
I 帧不需要考虑运动矢量
I 帧所占数据的信息量比较大
P 帧:前向预测编码帧。P帧表示的是这一帧跟之前的一个关键帧(或P帧)的差别,解码时需要之前缓存的画面叠加上本帧定义的差别,生成最终画面。(也就是差别帧,P帧没有完整画面数据,只有与前一帧的画面差别的数据)
P帧的预测与重构:P帧是以 I 帧为参考帧,在 I 帧中找出P帧“某点”的预测值和运动矢量,取预测差值和运动矢量一起传送。在接收端根据运行矢量从 I 帧找出P帧“某点”的预测值并与差值相加以得到P帧“某点”样值,从而可得到完整的P帧。
P帧是 I 帧后面相隔1~2帧的编码帧
P帧采用运动补偿的方法传送它与前面的I或P帧的差值及运动矢量(预测误差)
解码时必须将帧中的预测值与预测误差求和后才能重构完整的P帧图像
P帧属于前向预测的帧间编码。它只参考前面最靠近它的 I 帧或P帧
由于P帧是参考帧,它可能造成解码错误的扩散
由于是差值传送,P帧的压缩比较高
B帧:双向预测内插编码帧。B帧是双向差别帧,也就是B帧记录的是本帧与前后帧的差别(具体比较复杂,有4种情况,但我这样说简单些),换言之,要解码B帧。不仅要取得之前的缓存画面,还要解码之后的画面,通过前后画面的与本帧数据的叠加取得最终的画面。B帧压缩率高,但是解码时CPU会比较累。
B帧的预测与重构: B帧以前面的 I 或P帧和后面的P帧为参考帧,“找出”B帧“某点”的预测值和两个运动矢量,并取预测差值和运动矢量传送。接收端根据运动矢量在两个参考帧中“找出(算出)”预测值并与差值求和,得到B帧“某点”样值,从而可得到完整的B帧。
B帧是由前面的 I 或P帧和后面的P帧进行预测的
B帧传送的是它与前面的 I 或P帧和后面的P帧之间的预测误差及运动矢量
B帧是双向预测编码帧
B帧压缩比最高,因为它只反映并参考帧间运动主体的变化情况,预测比较准确
B帧不是参考帧,不会造成解码错误的扩散
同时这解析的时候也不是顺序解析的,而是有一定的顺序,基本上来说就是I→P→B,看图:
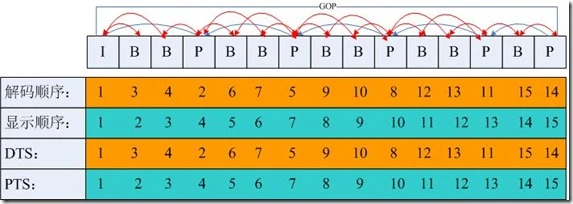
这个顺序是在MP4 moov头中的cttc box里描述的,但是据我的测试,没有这个顺序描述box,ffmpeg也能解析出实际的画面,这可能与我们是使用h264裸流进行解析的有关。
通过FFMPEG将MP4转换为H264裸流
ffmpeg -i input.mp4 -vcodec copy -an output.h264在H264中,每一个单元被称作NALU,这是H264的基本单位,在NALU之下,还有Slice和宏块(Macroblock),结构层级如下:
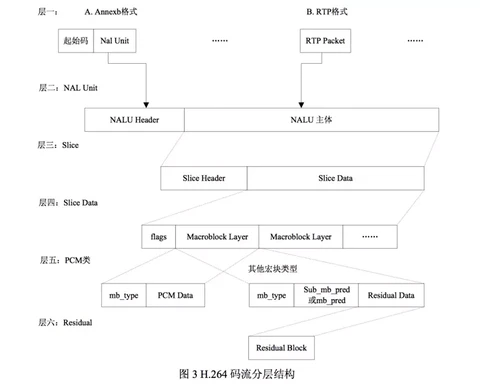
一般来说,一个NALU中含有一个Slice,一个Slice中含有多个宏块(Macroblock),在视频中,为了尽可能提高压缩率,上一帧和下一帧之间都是通过演算得到的,一般来说上一帧和下一帧都有共通点,比如出现了一个人站在一个场景里说话,实际上只是部分块发生了位移,这个时候就可以只把运动的块的位移算出来进行保存,就不用存储画面了,通过程序进行解析的效果如下:
一般来说,一个NALU中含有一个Slice,一个Slice中含有多个宏块(Macroblock),在视频中,为了尽可能提高压缩率,上一帧和下一帧之间都是通过演算得到的,一般来说上一帧和下一帧都有共通点,比如出现了一个人站在一个场景里说话,实际上只是部分块发生了位移,这个时候就可以只把运动的块的位移算出来进行保存,就不用存储画面了,通过程序进行解析的效果如下:
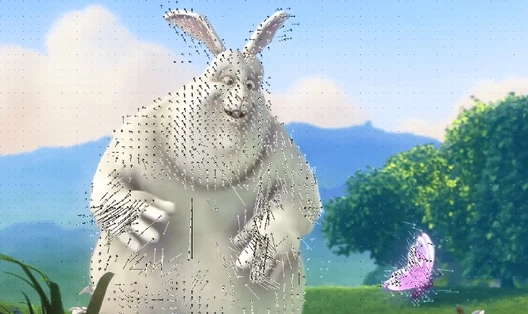
通过ffmpeg生成包含空间向量的视频
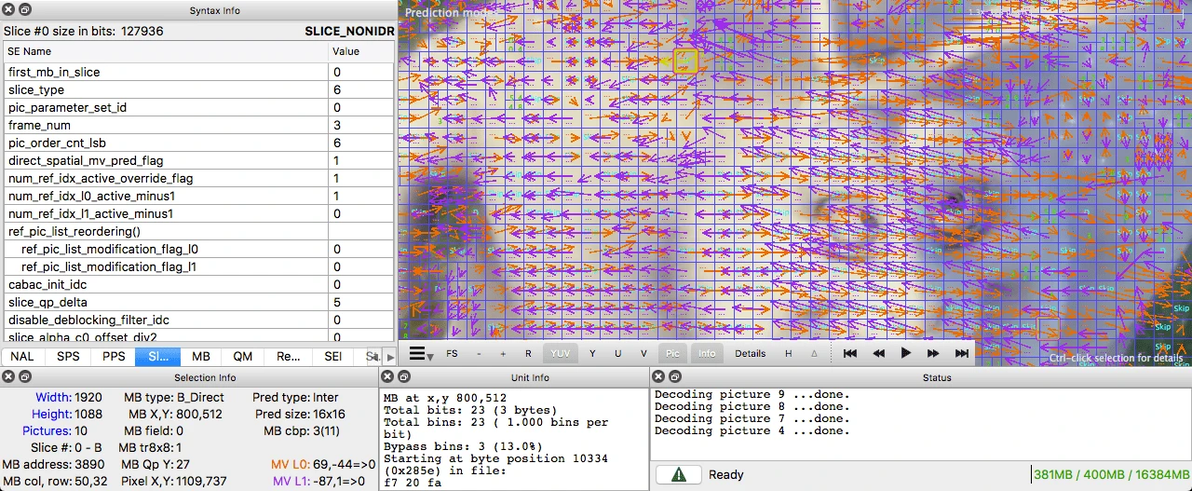
或者我们也可使用 Intel Video Pro Analyzer(需要付费,但也有只能查看前 10 帧的免费试用版)。
这就是宏块的作用,也是为什么P、B帧能压缩,并且压缩率能这么高。
在H264裸流中,每一个NALU都以 0x00 00 01 开头,这也是判断上下NALU的关键。
IDR NALU
在分析h264裸流时,会经常遇到两种NALU:IDR和非IDR:
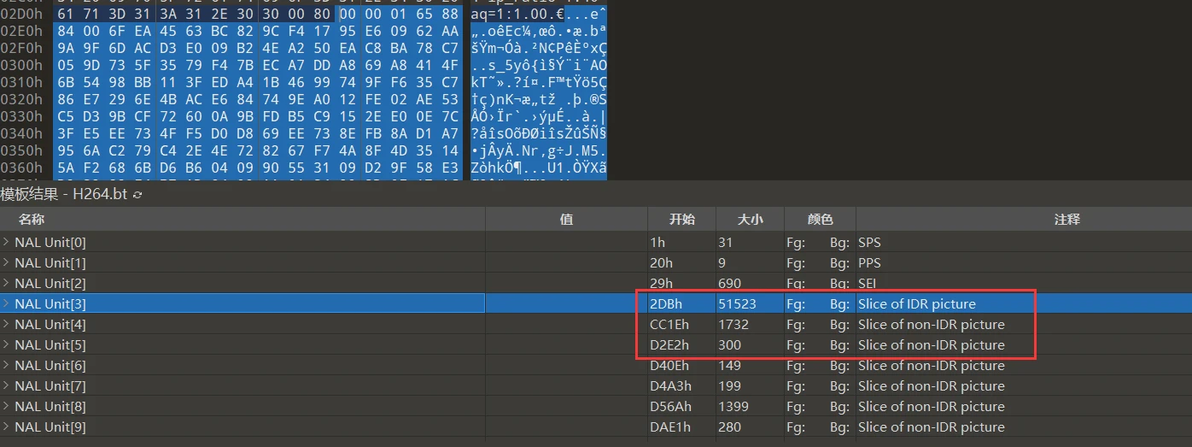
IDR(Instantaneous Decoding Refresh,即时解码刷新),从名字上可以看出,一遇到IDR,画面就应该立即刷新,同时IDR NALU比较大,我们可以认为IDR NALU ⇒ I 帧,但是I帧≠IDR。所有 IDR 帧都是 I 帧,但并非所有 I 帧都是 IDR 帧。IDR(瞬时解码器刷新)帧是特殊的 I 帧,它不仅包含完整的图片,还表示 IDR 之后的任何 P/B 帧都不允许引用 IDR 之前的帧。
IDR(Instantaneous Decoding Refresh,即时解码刷新),从名字上可以看出,一遇到IDR,画面就应该立即刷新,同时IDR NALU比较大,我们可以认为IDR NALU ⇒ I 帧,但是I帧≠IDR。所有 IDR 帧都是 I 帧,但并非所有 I 帧都是 IDR 帧。IDR(瞬时解码器刷新)帧是特殊的 I 帧,它不仅包含完整的图片,还表示 IDR 之后的任何 P/B 帧都不允许引用 IDR 之前的帧。
多个NALU描述一个画面的情况
我在实际测试的时候遇到了这样的文件,几个I帧连在一起,其实我们不应该通过看头是不是65来判断是不是I帧,是不是I帧实际上是由NALU中Slice Header中的slice_type规定
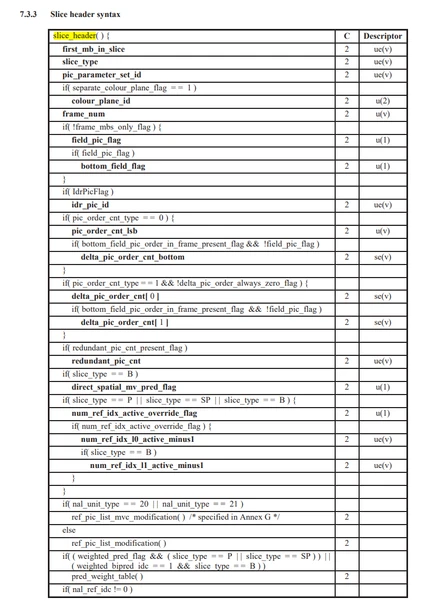
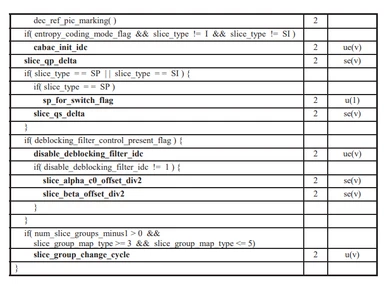
可以看到第二项就是slice type,而它的大小为ue(v),这里指的是无符号指数哥伦布算法,这种算法比较简单,但是单独介绍比较多,我直接上代码大家自行理解下
sps_parser_offset = 0


def sps_parser_read_bits(buffer, count):
    global sps_parser_offset
    result = 0
    index = sps_parser_offset // 8
    bit_number = sps_parser_offset - (index * 8)
    out_bit_number = count - 1
    for _ in range(count):
        if buffer[index] << bit_number & 0x80:
            result |= 1 << out_bit_number
        if (bit_number := bit_number + 1) > 7:
            bit_number = 0
            index += 1
        out_bit_number -= 1
    sps_parser_offset += count
    return result

# 无符号指数哥伦布
def sps_parser_read_ueg(buffer):
    global sps_parser_offset
    bitcount = 0

    while True:
        if sps_parser_read_bits(buffer, 1) == 0:
            bitcount += 1
        else:
            break

    result = 0
    if bitcount:
        val = sps_parser_read_bits(buffer, bitcount)
        result = (1 << bitcount) - 1 + val

    return result

# 有符号指数哥伦布
def sps_parser_read_eg(buffer):
    value = sps_parser_read_ueg(buffer)
    if value & 0x01:
        return (value + 1) // 2
    else:
        return -(value // 2)
写的有点多了,剩下的我找个时间把视频做出来吧,不过大家别抱什么期待,因为内容很多很难,所以不能保证这是不是挖的坑。
成品已经写出来了,大家可以去看看
https://github.com/gaowanliang/web-video-thumbnailer
参考资料
[封装格式--2:MP4格式详解 - 简书 (jianshu.com)](https://www.jianshu.com/p/1a110c19d7b7)
[MP4 媒体封装格式分析 | OctalZero’s Blog](https://octalzero.com/article/f4698d4c-1b5f-40d0-9b17-fab4456395cc#a31fb3a8536142f0ad13e84c039bd3c6)
[Decode mp4 to raw frames windows c++ - Stack Overflow](https://stackoverflow.com/questions/12603830/decode-mp4-to-raw-frames-windows-c)
[video - Using chunks of MP4 file for thumbnails - Stack Overflow](https://stackoverflow.com/questions/21223749/using-chunks-of-mp4-file-for-thumbnails)
[python - Decode h264 video frame from bytes received from a WebSocket - Stack Overflow](https://stackoverflow.com/questions/72928504/decode-h264-video-frame-from-bytes-received-from-a-websocket)
[avcC mp4a Box-ZigZagSin (zzsin.com)](https://www.zzsin.com/article/18_Avc1_Mp4a_Box.html)
[H264 I帧 P帧 B帧 - 知乎 (zhihu.com)](https://zhuanlan.zhihu.com/p/276357804)
[自己动手写 H.264 解码器-ZigZagSin (zzsin.com)](https://www.zzsin.com/catalog/write_avc_decoder.html)
[MP4 Inspector (alfg.dev)](https://alfg.dev/mp4-inspector/)
[MP4 文件结构浅析 - Cyrus Blog (dalvik.work)](https://www.dalvik.work/2021/07/05/mp4-structure/)
[【Agorans 征文】浅谈视频中的SEI以及测试中的使用场景 - 专栏 - 声网 RTE 开发者社区 (rtcdeveloper.cn)](https://www.rtcdeveloper.cn/cn/community/blog/18970)
[视频技术介绍 - E2ESOFT](https://www.e2esoft.cn/digital-video-introduction/)
[音视频八股文(8)-- h264 AnnexB | 程序员论坛 (learnku.com)](https://learnku.com/articles/77093)
[angrycoding/sps-parser: H.264 sequence param parser (sps) written in pure C with no dependencies (github.com)](https://github.com/angrycoding/sps-parser)
[FFProbe (ffprobe-wasm.netlify.app)](https://ffprobe-wasm.netlify.app/)
