1.什么是数据挖掘
数据挖掘寻找数据隐藏的知识并用于产生商业价值。
2.为什么要做数据挖掘
海量数据、唯独众多、问题复杂
3.数据挖掘作用
分类问题、聚类问题、回归问题、关联问题
4.数据挖掘怎么做
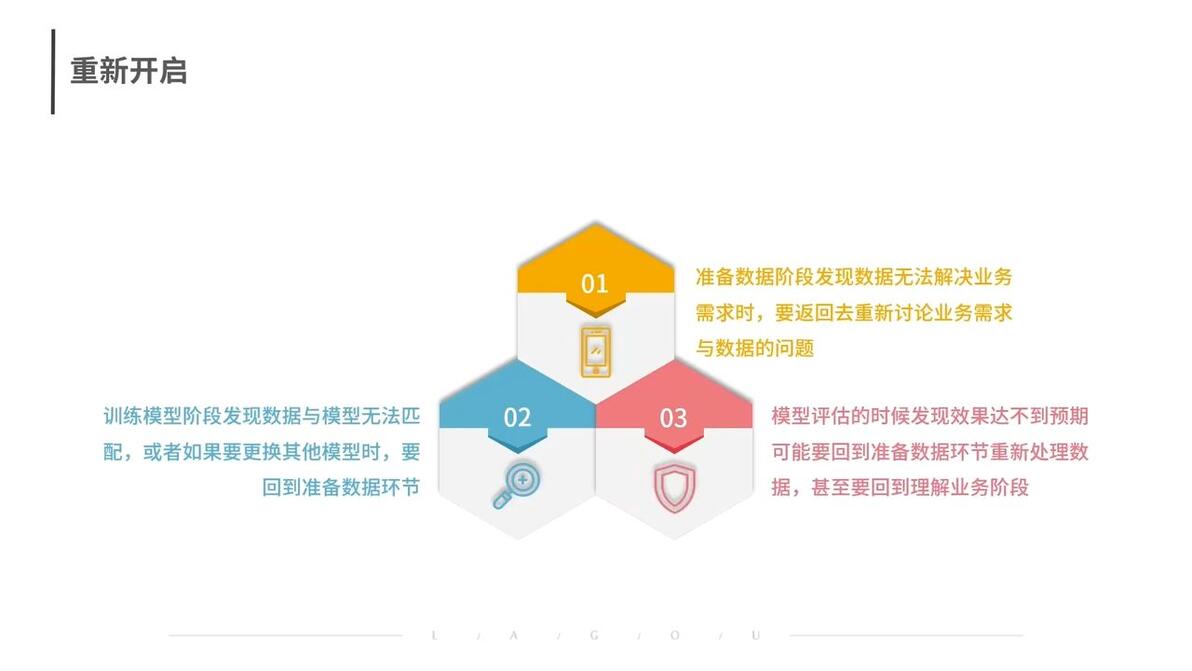
业务理解-------数据理解------数据准备------构建模型------评估模型------模型部署
Python的介绍
Python面向对象、直译
优点:简单易学、开源、移植性好、可扩展
缺点:语言兼容性不好
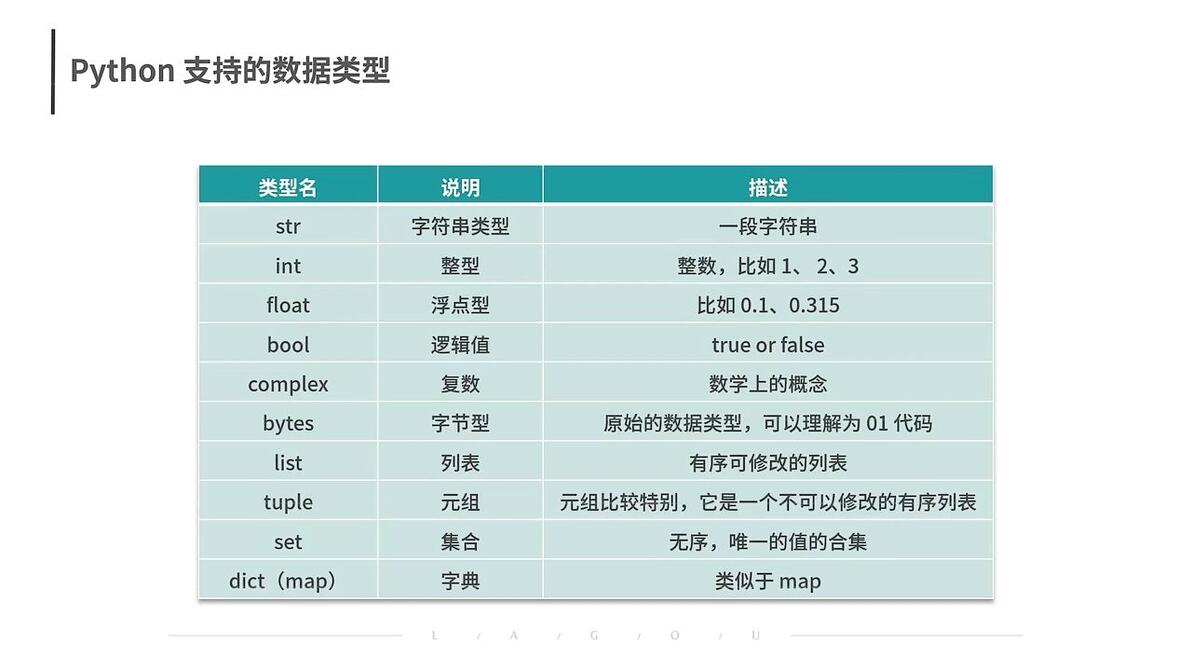
列表(list)
添加元素 list.append(x)
删除 del list[2]
如果对python不太熟悉可以先从
p1看到p22,
后面的建议是从
p57可视化开始看看到p62
然后再回过头看p36看到p56
数据分析的顺序是先分析再挖掘
当然如果有一定基础就可以直接从数据挖掘的部分开始看
当然我还没有看完,只是提出一点个人的建议
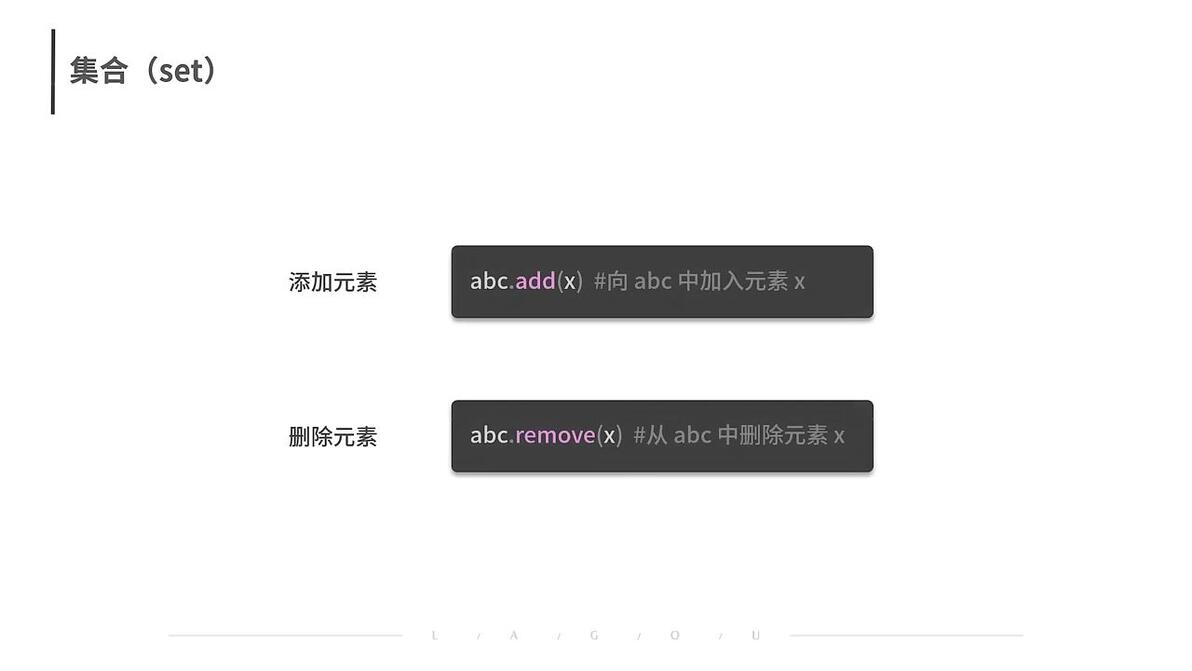
集合
字典---键值对
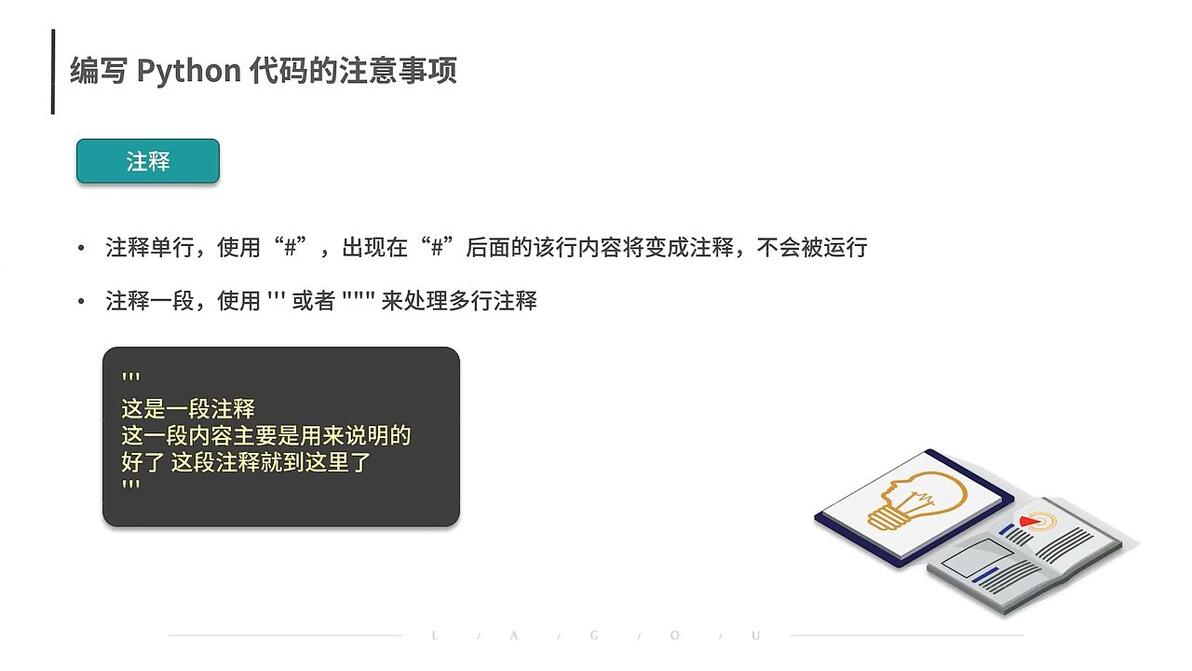
注释
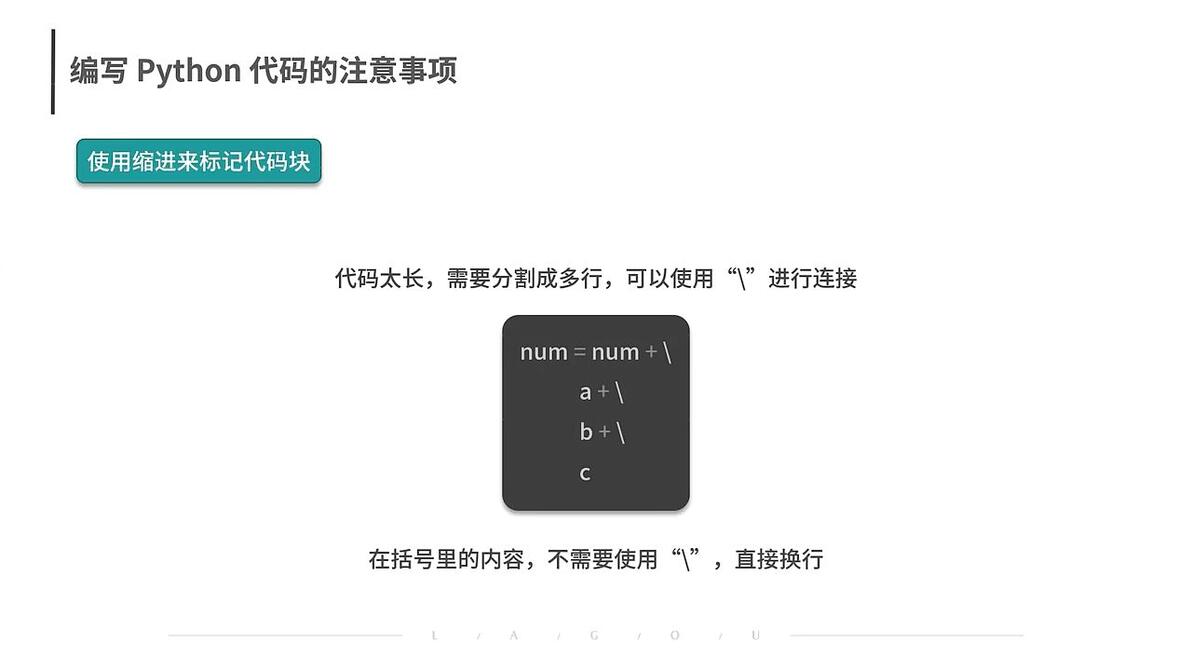
分割
导入
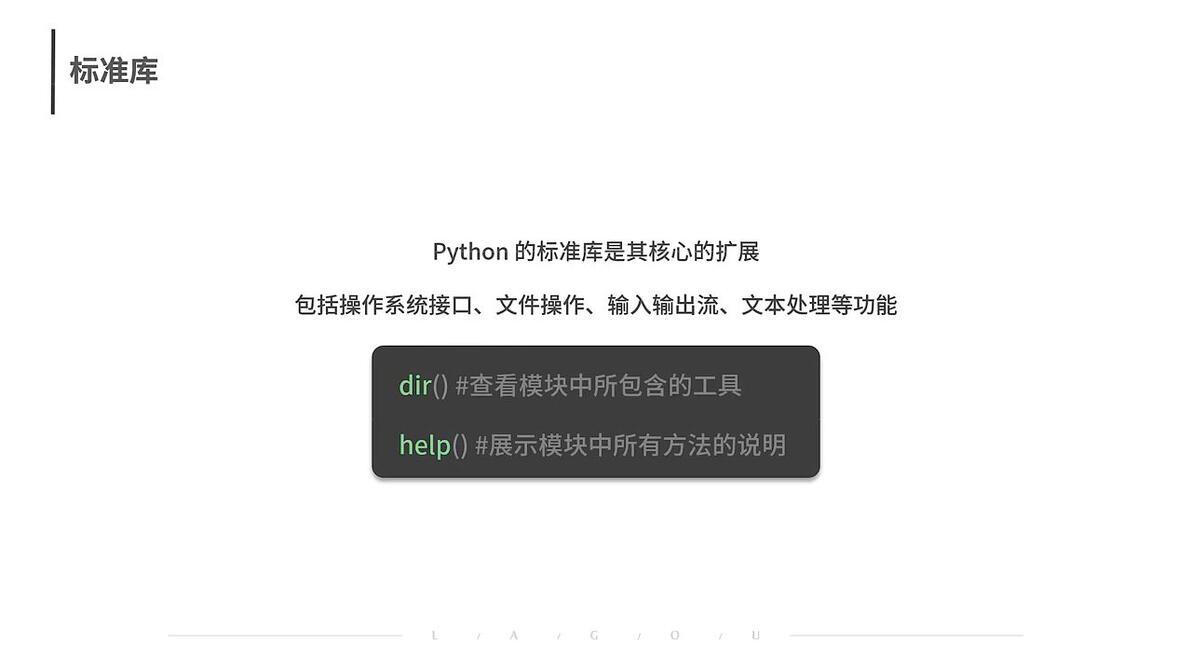
标准库
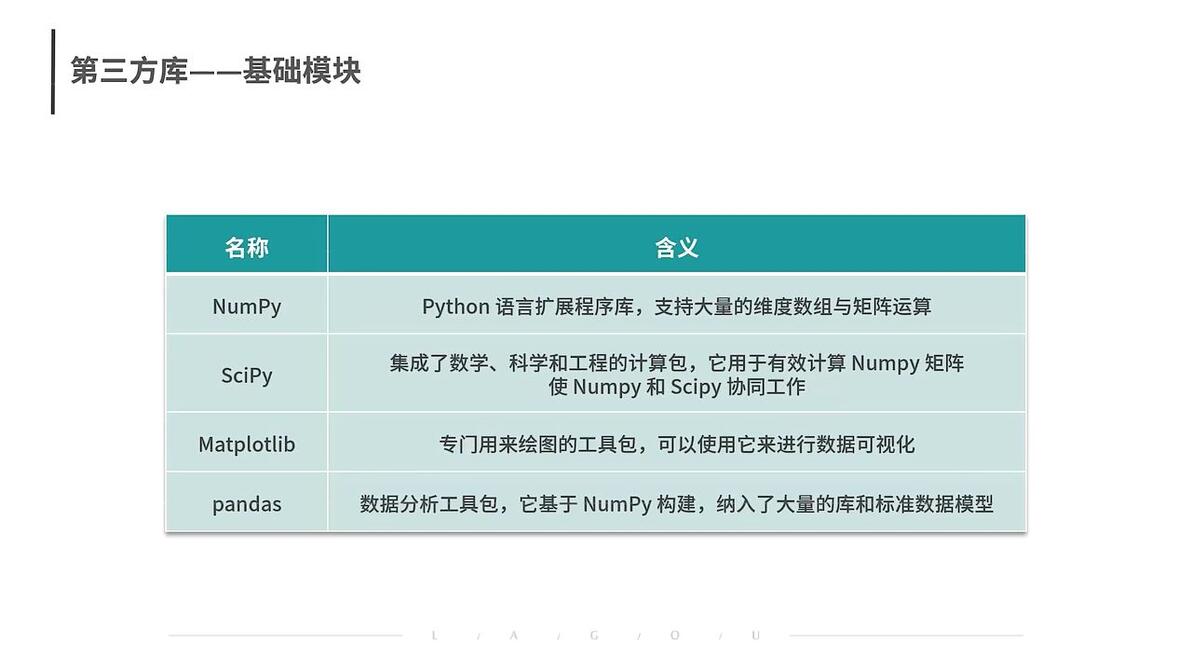
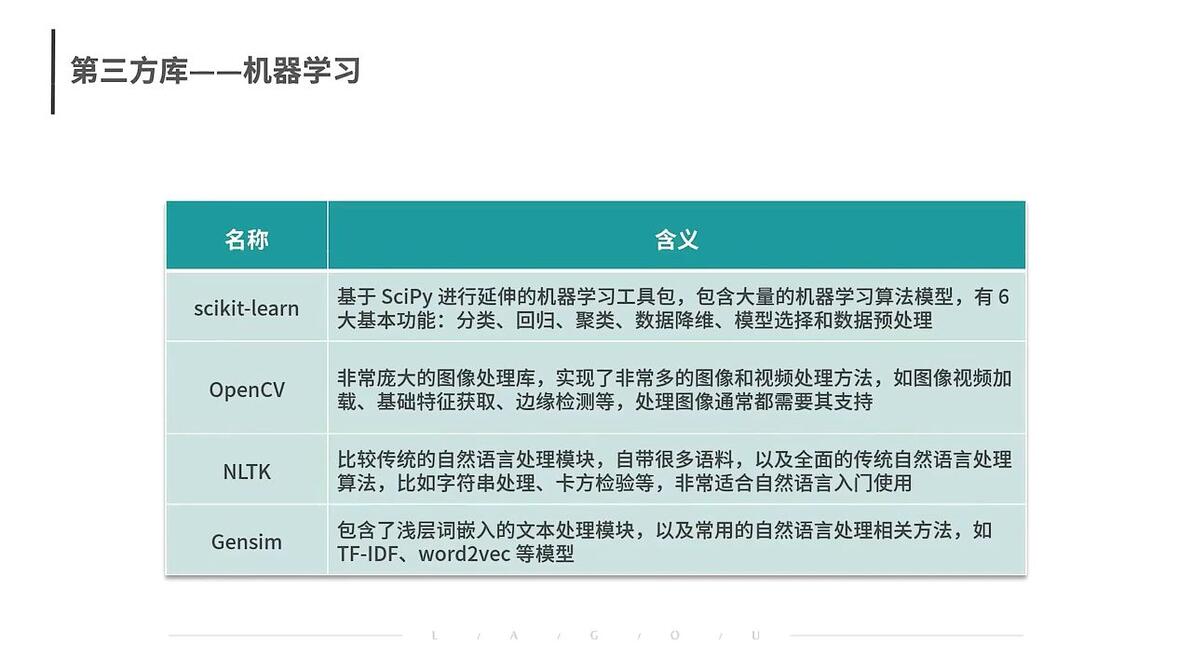
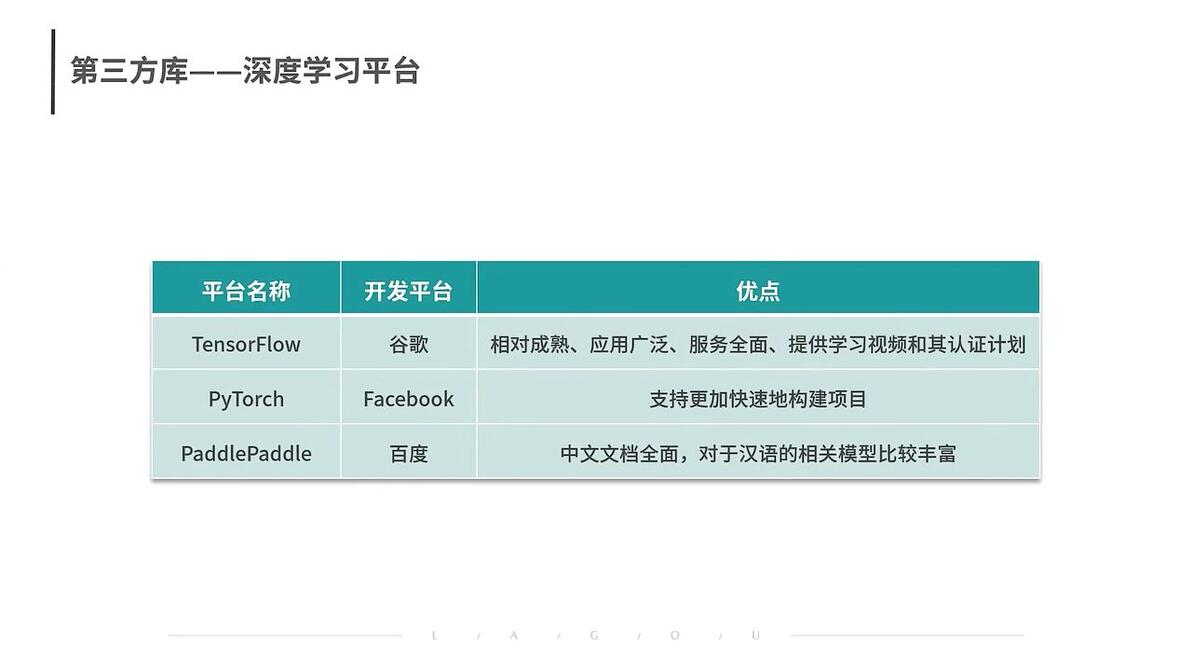
常用库
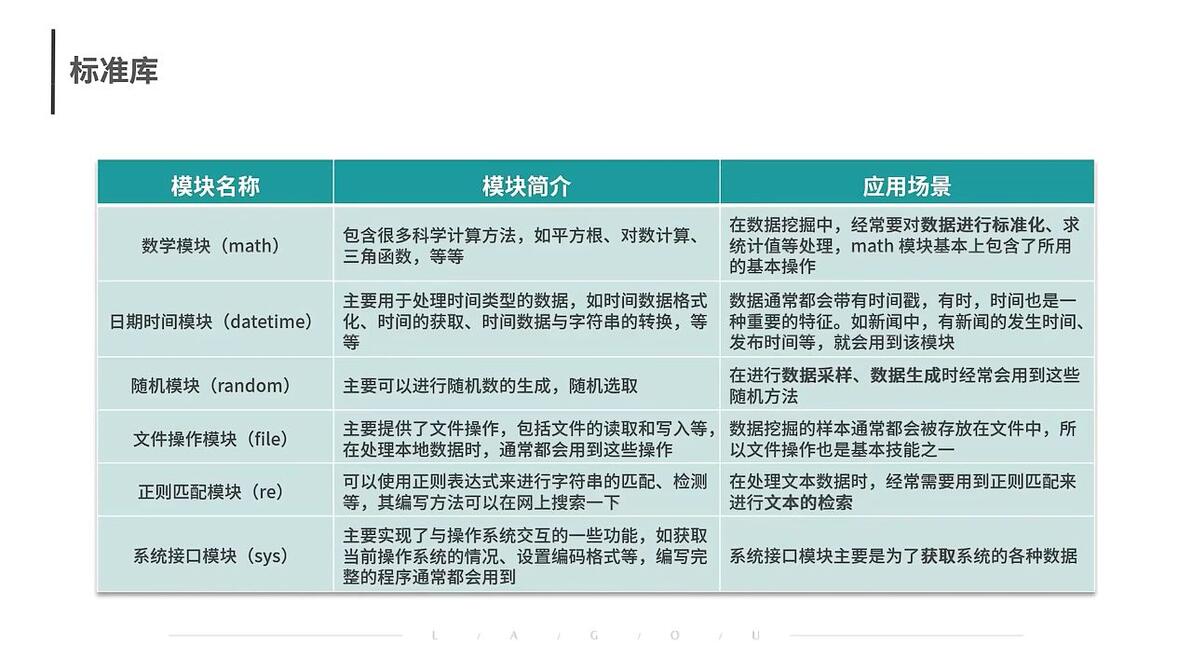
第三方库
机器学习库
深度学习平台
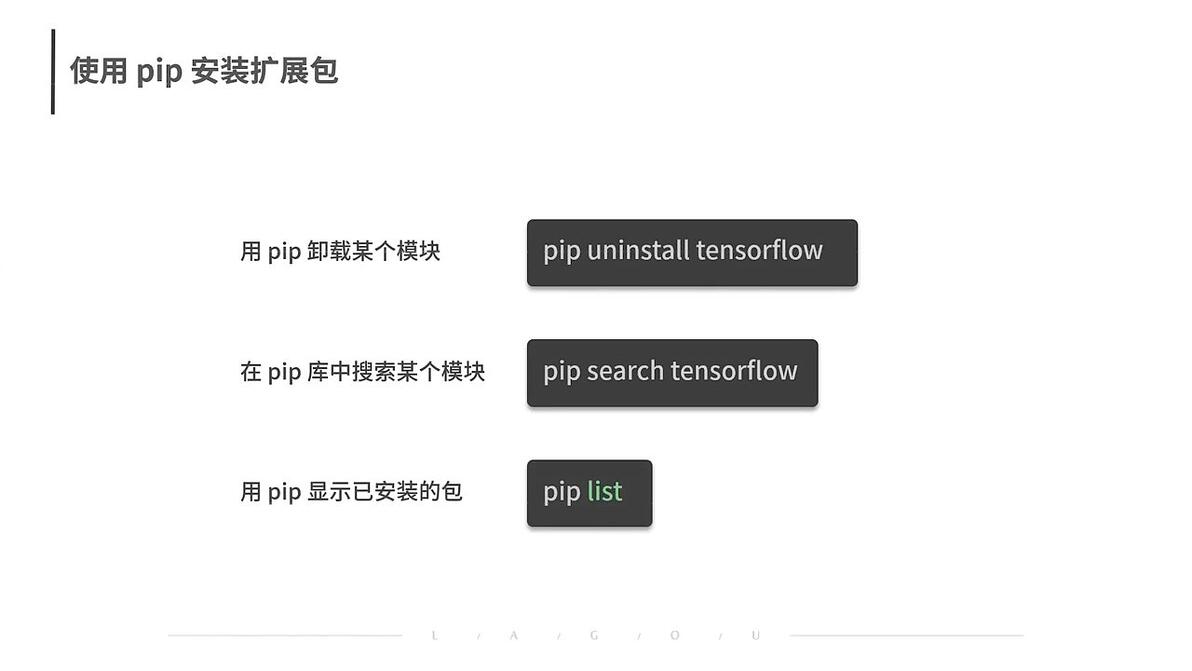
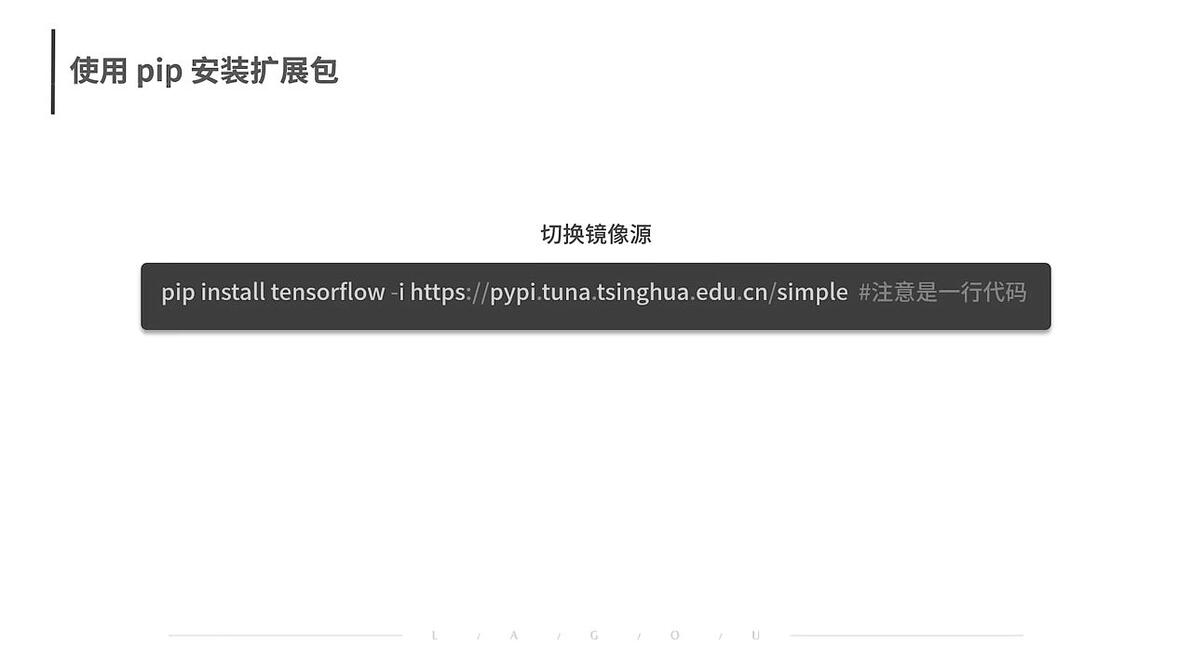
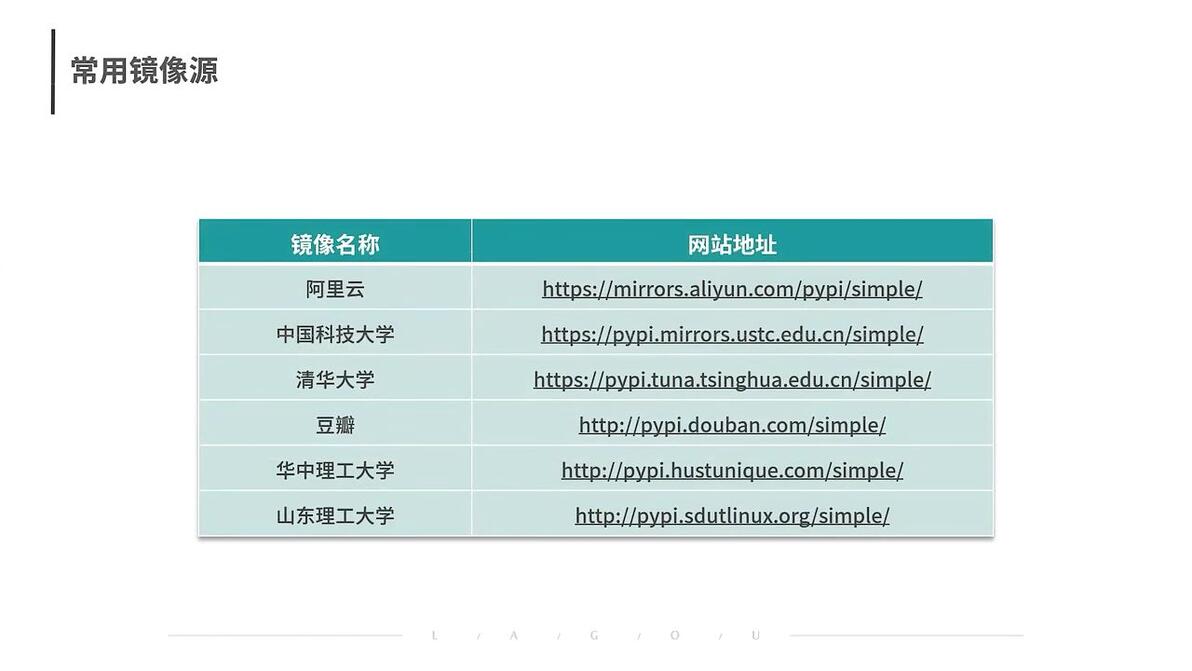
pip扩展下载
Python中的基本语法规则
变量名区分大小写
python随写随定义
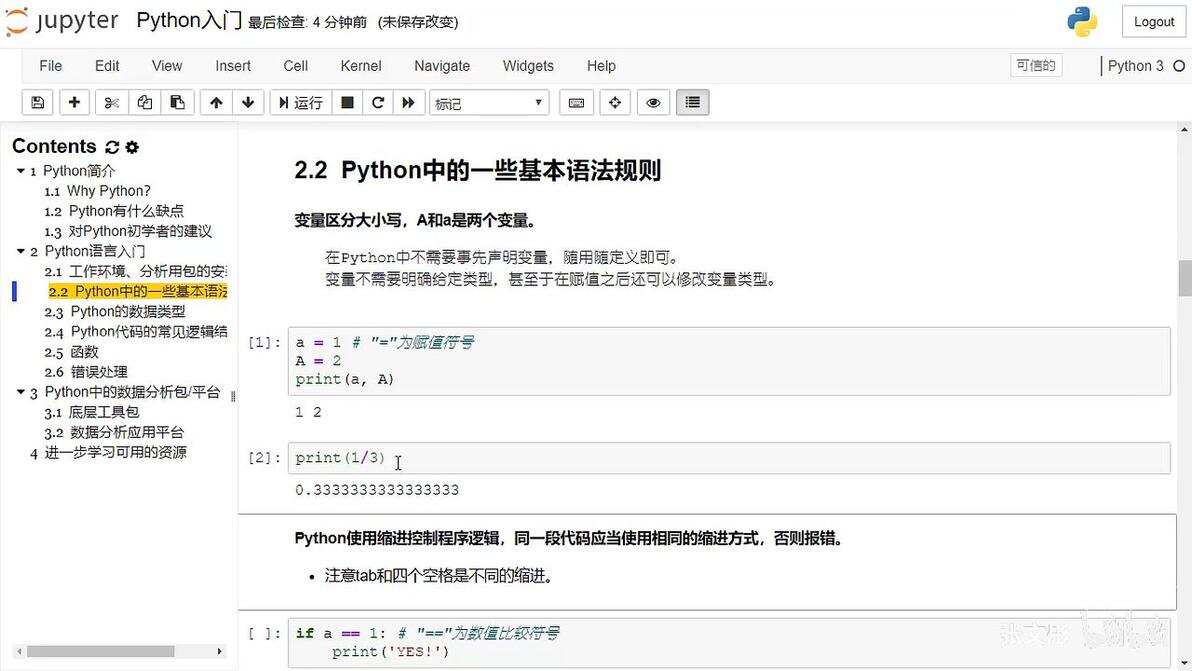
python使用缩进控制程序逻辑,同一段代码应当使用相同的缩进方式,否则报错
tab和四个空格是不同的缩进
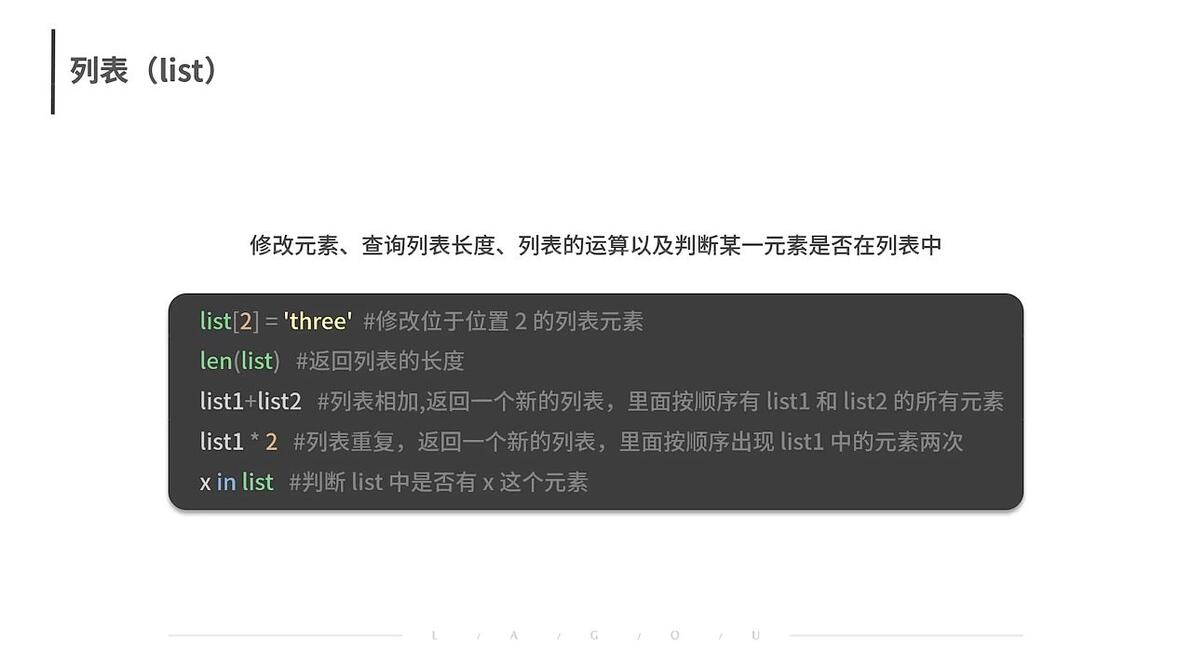
python的数据类型
单一类型:整形、浮点、负数、字符型、逻辑型。
四种集合类型:
列表(list),有序,可修改,可重复
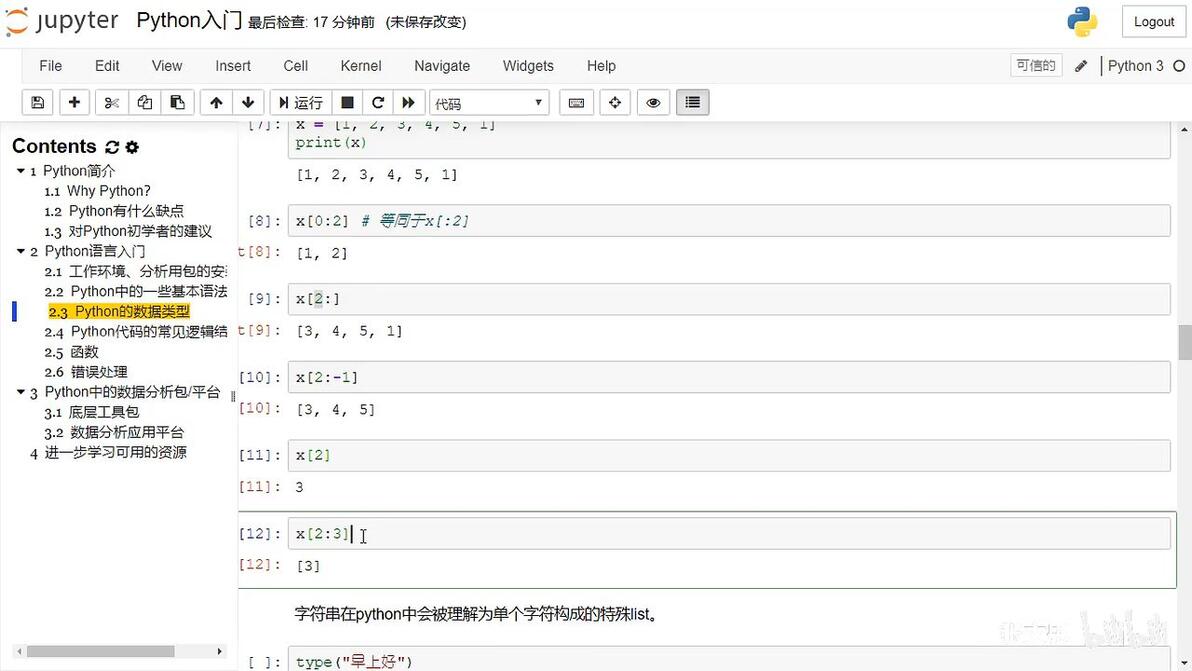
字符串
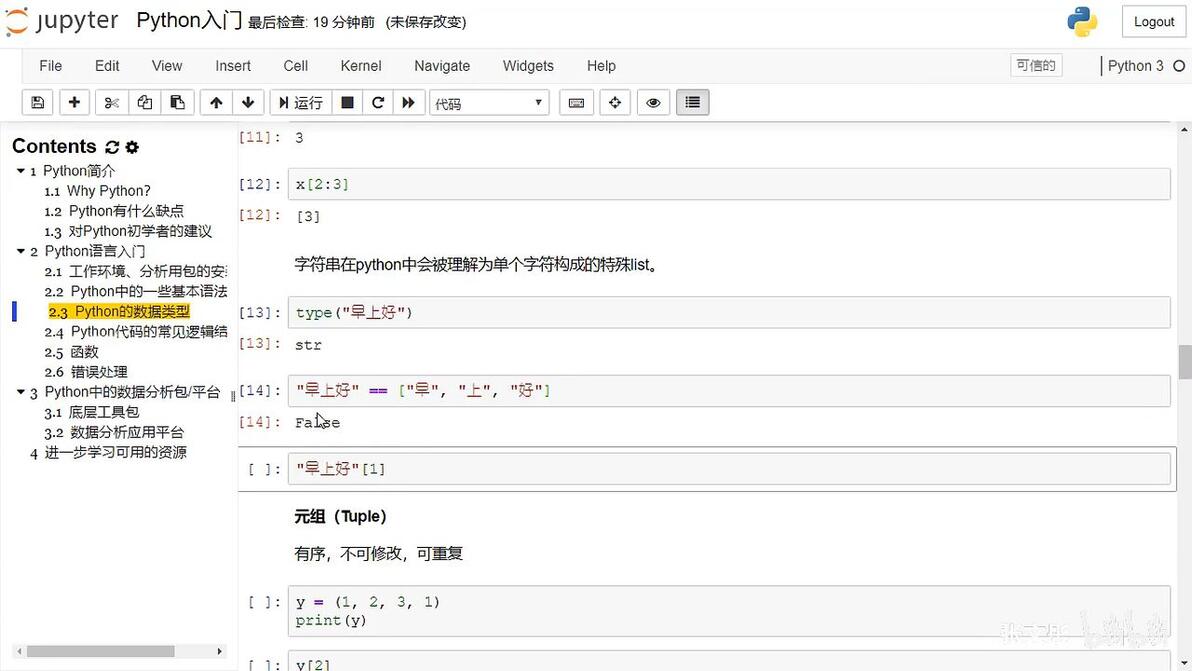
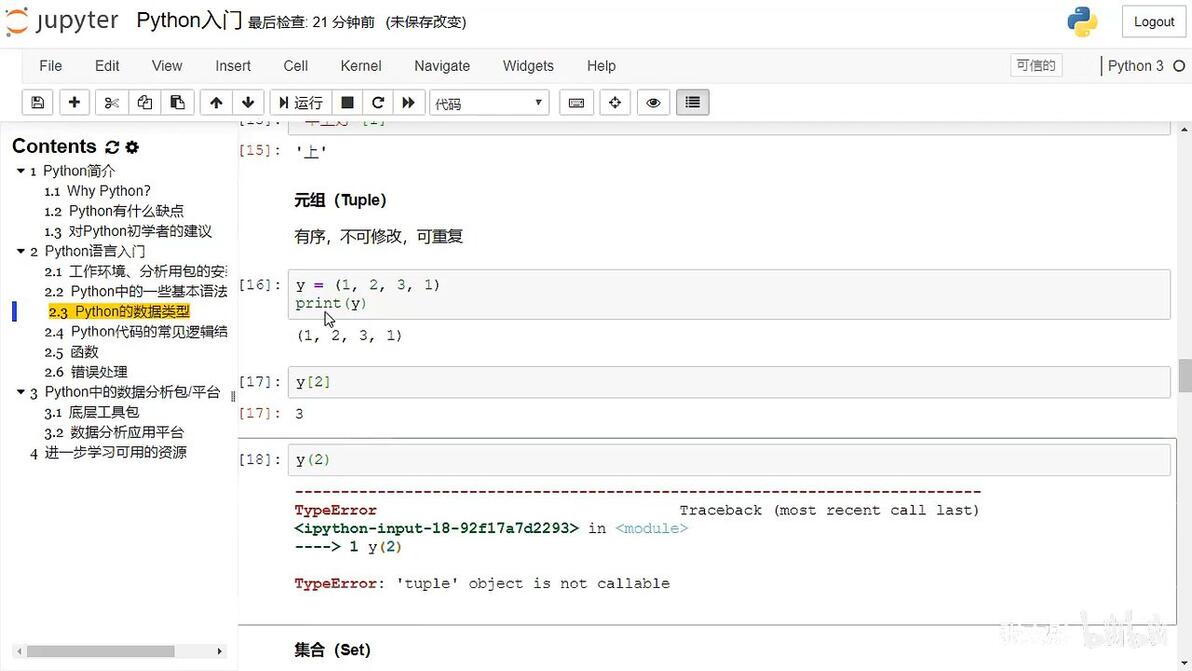
元组(Tuple),有序,不可修改,可重复
集合(Set)
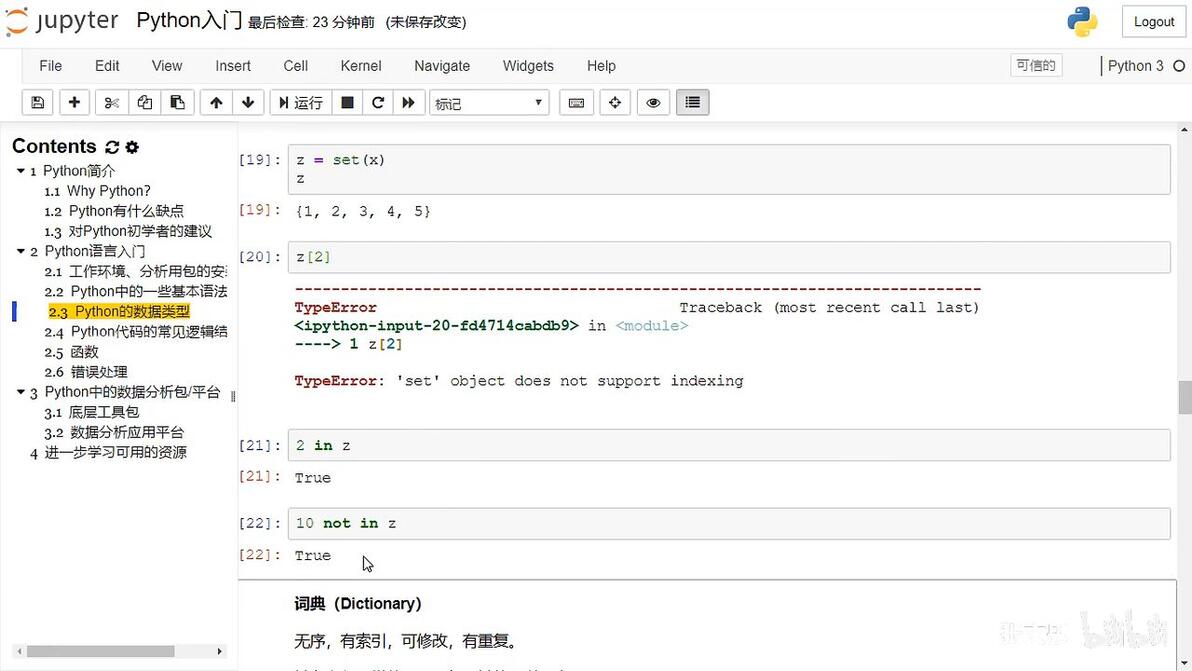
词典(Dictionary)无序,有索引,可修改,有重复,键名必须是常数,不重复,键值可以是变量
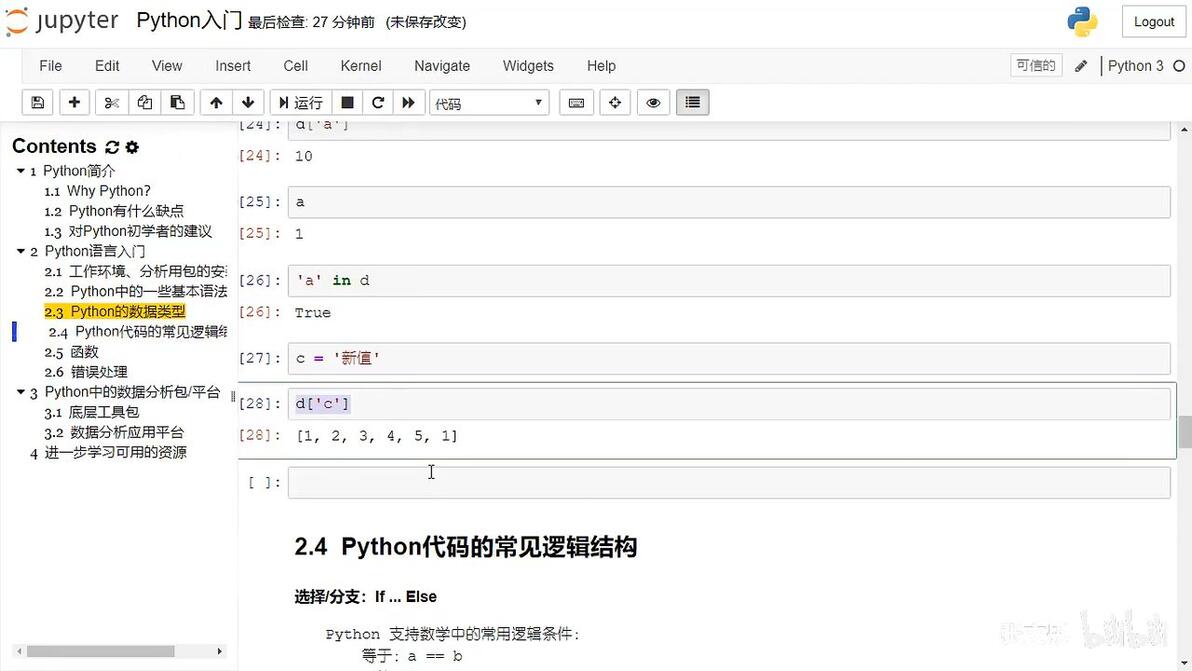
python代码的常见逻辑
if...else
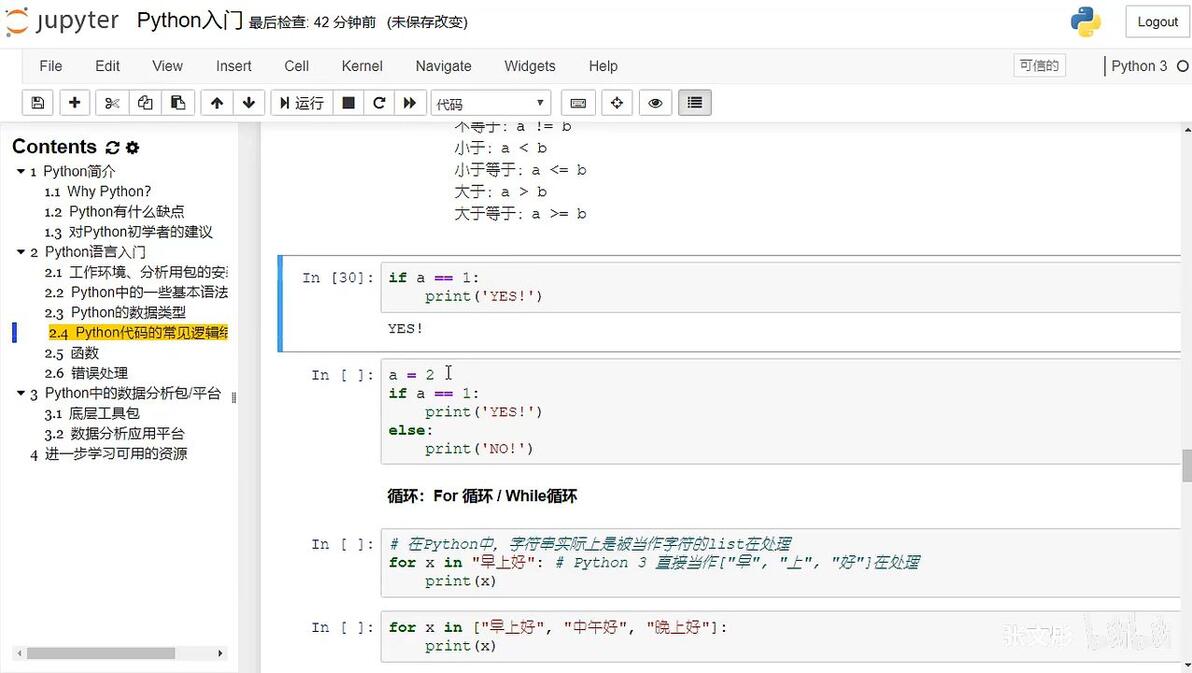
for循环/While循环
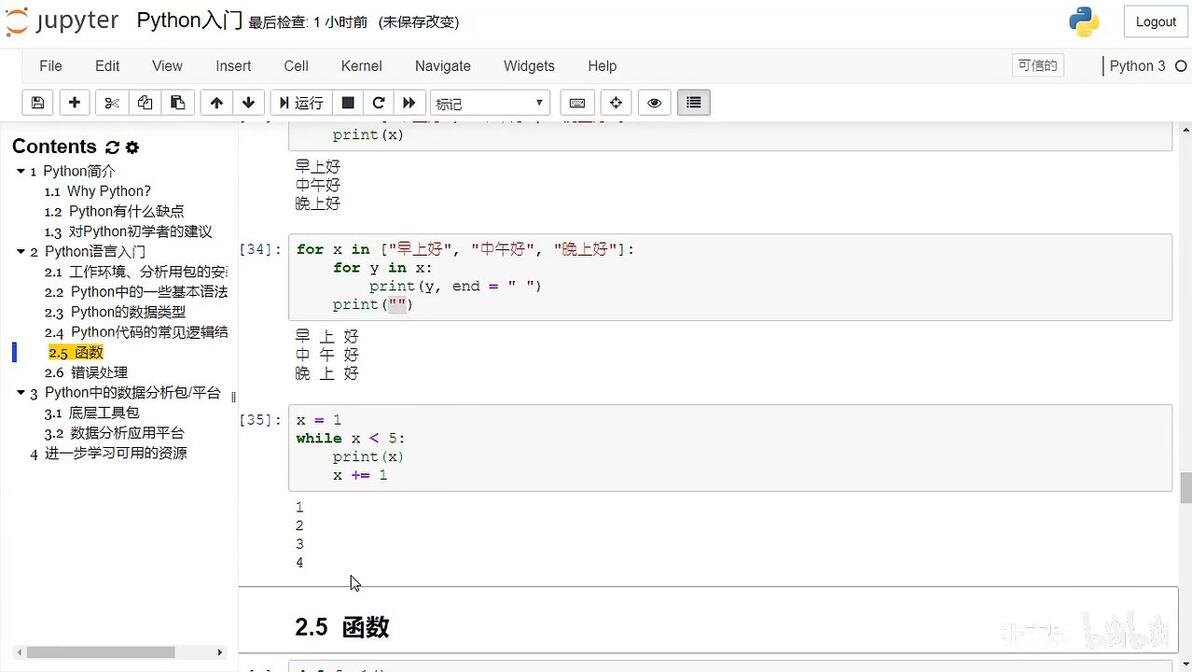
函数
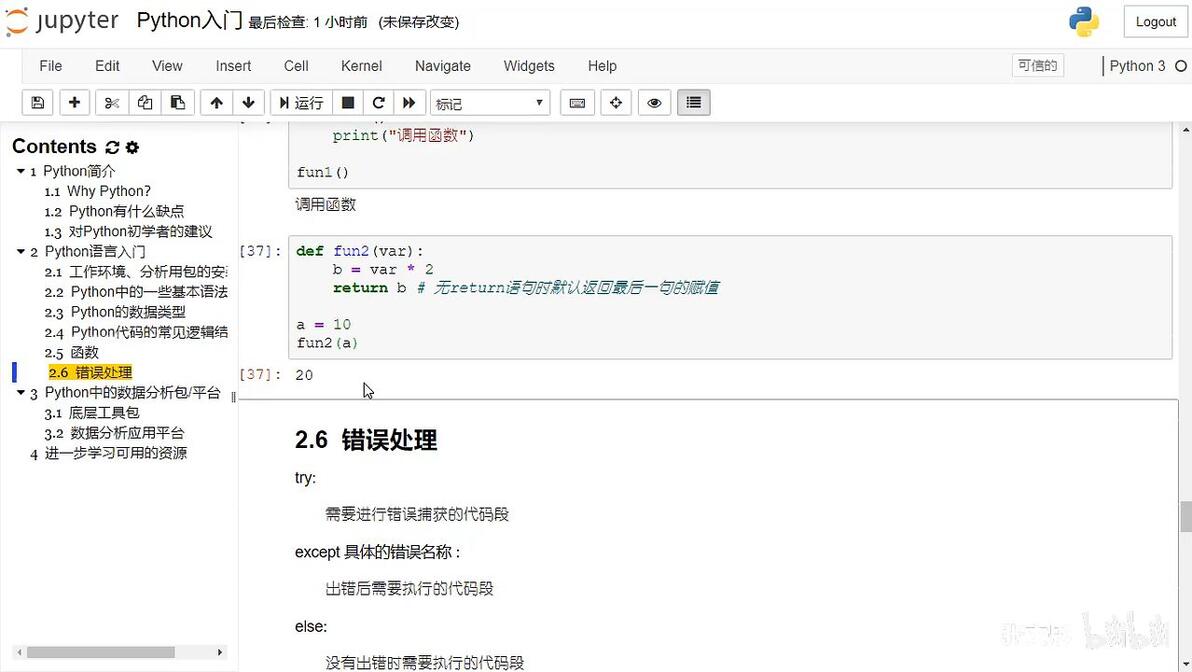
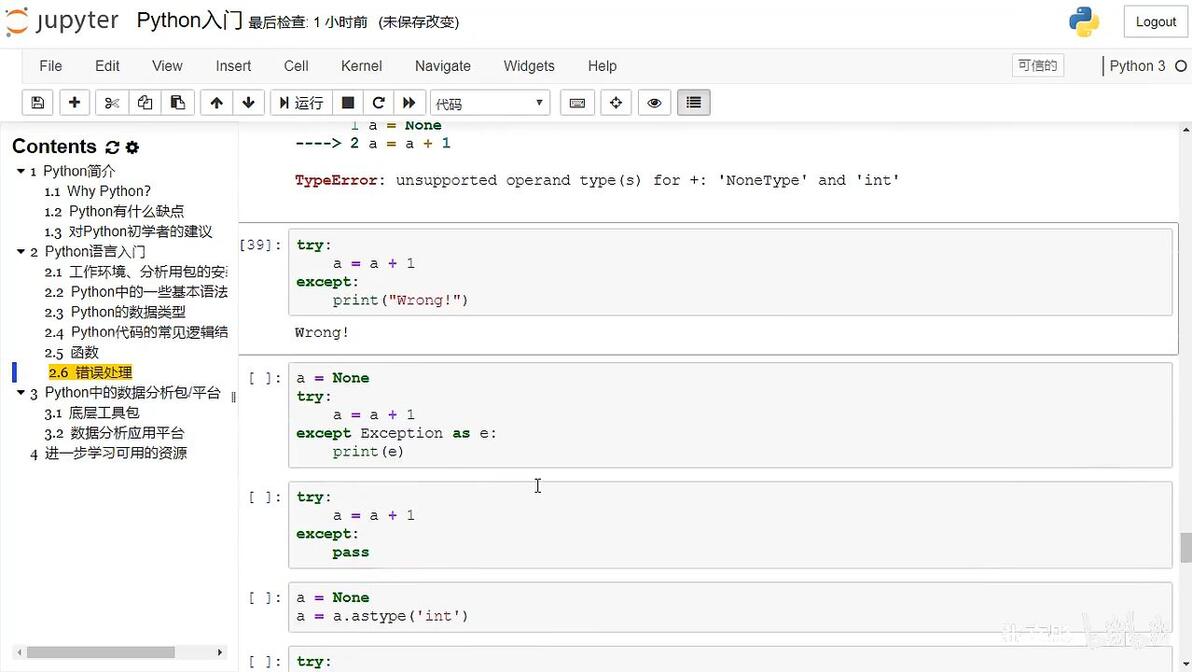
错误处理
try:
需要进行错误捕获的代码段
except具体的错误名称:
出错后需要执行的代码段
else:
没有出错时需要执行的代码段
Why Pandas?
二维表
提供大一统的标准框架
pandas可以清洗数据,管理数据
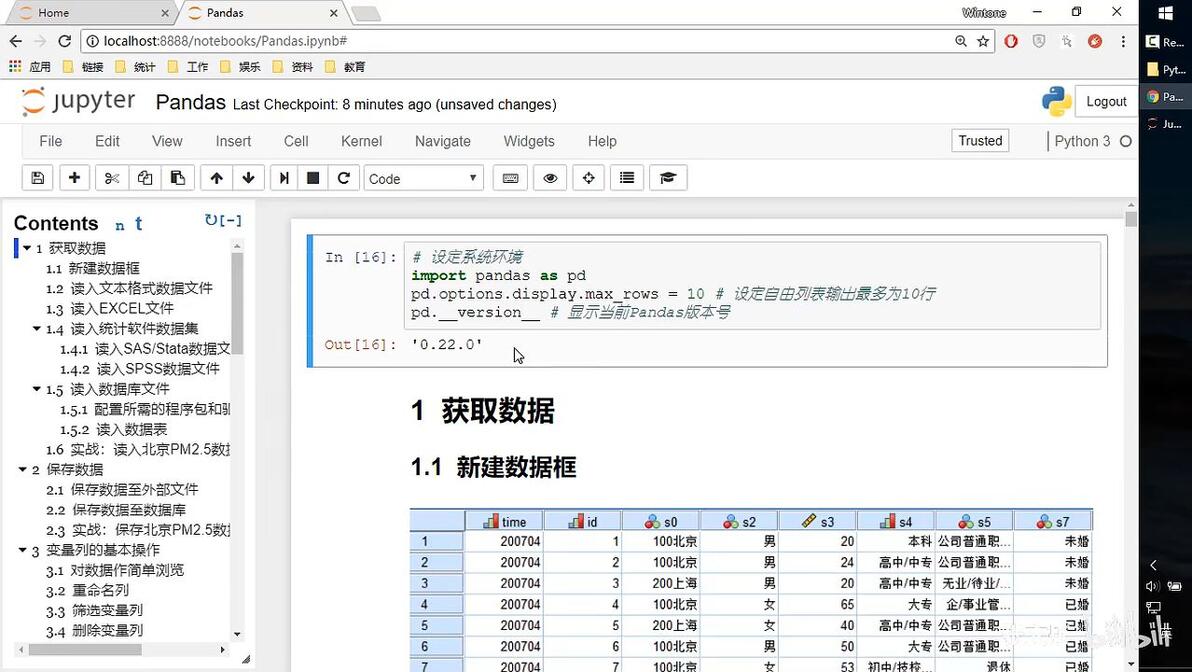
第二章数据的导入与导出
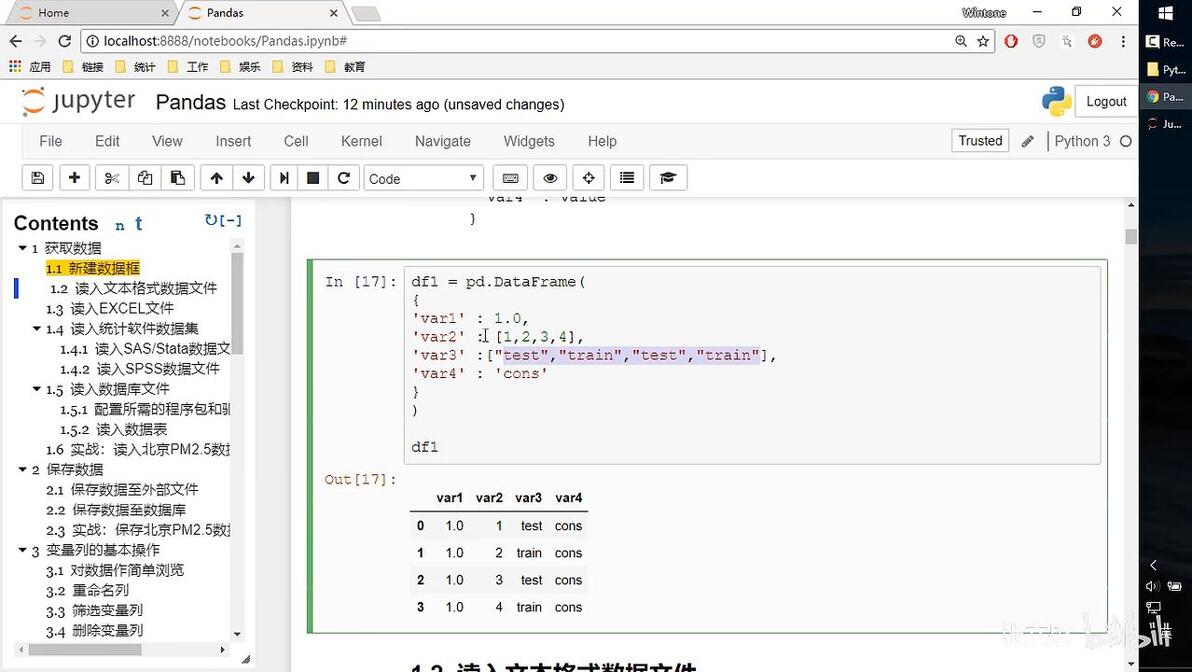
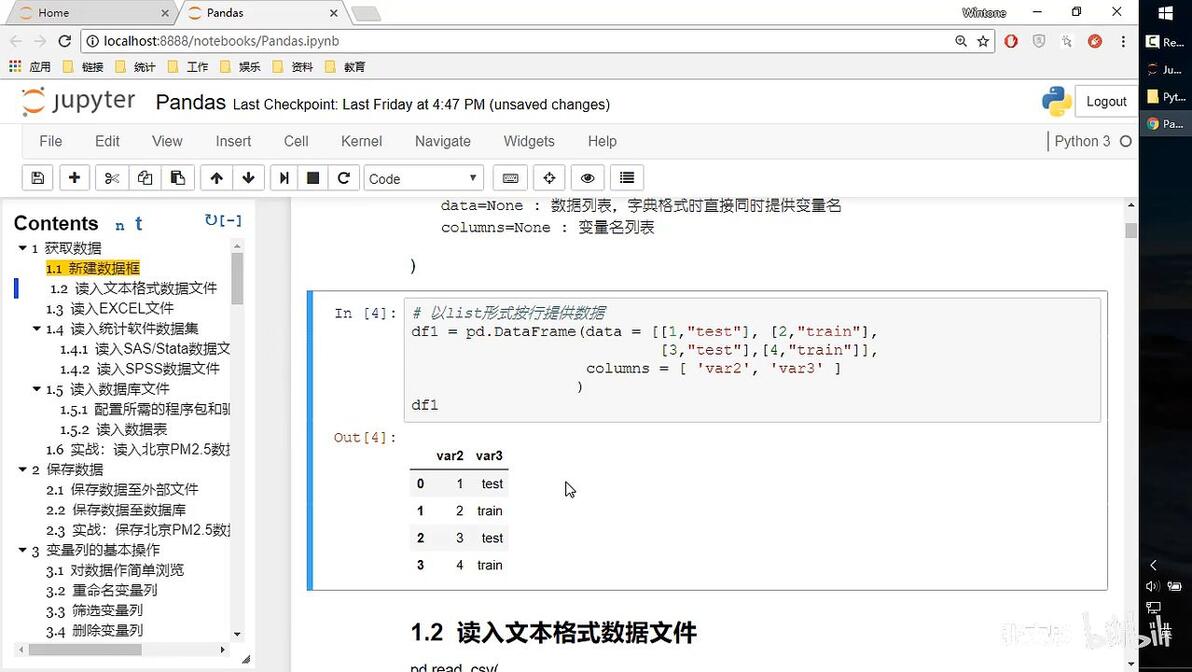
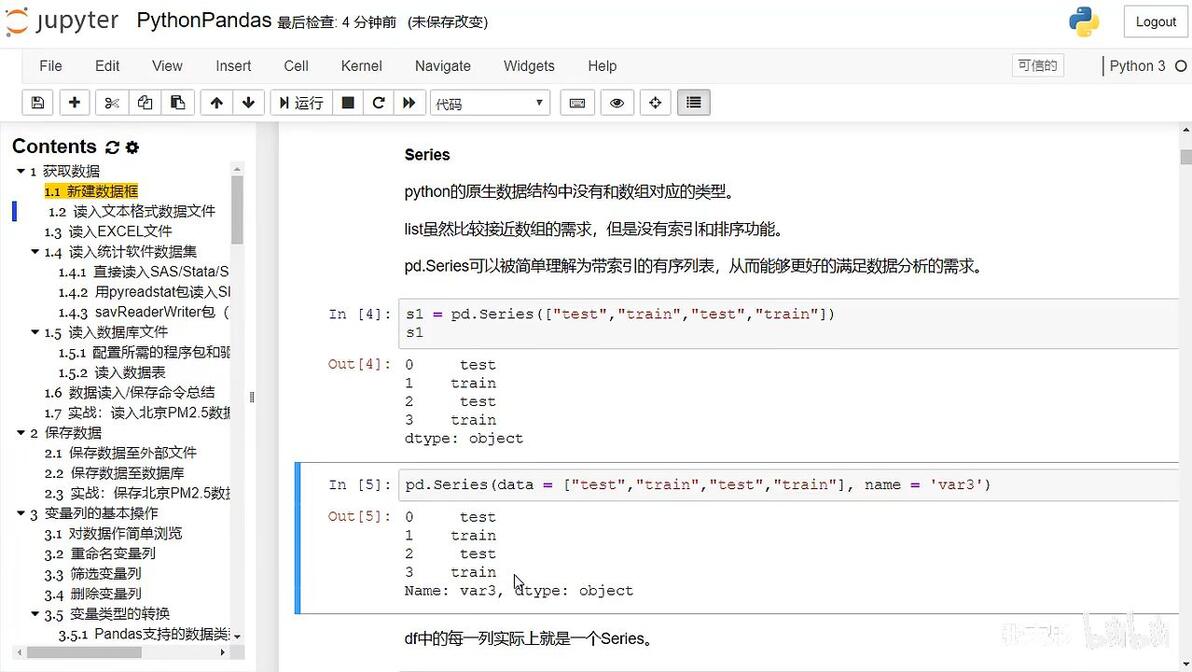
P11读入文本格式数据文件
pd.read_csv() 默认分隔符为逗号
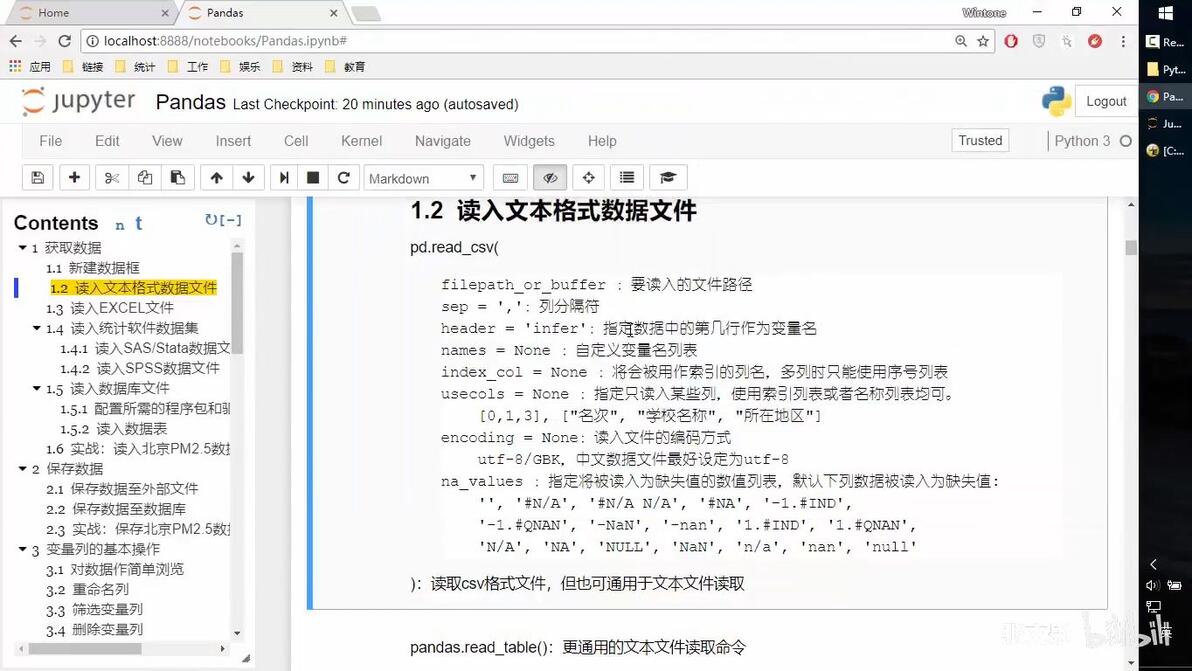
pandas.read_table() 默认分隔符为tab
p12 读入excel
pd.read_excel()
p13
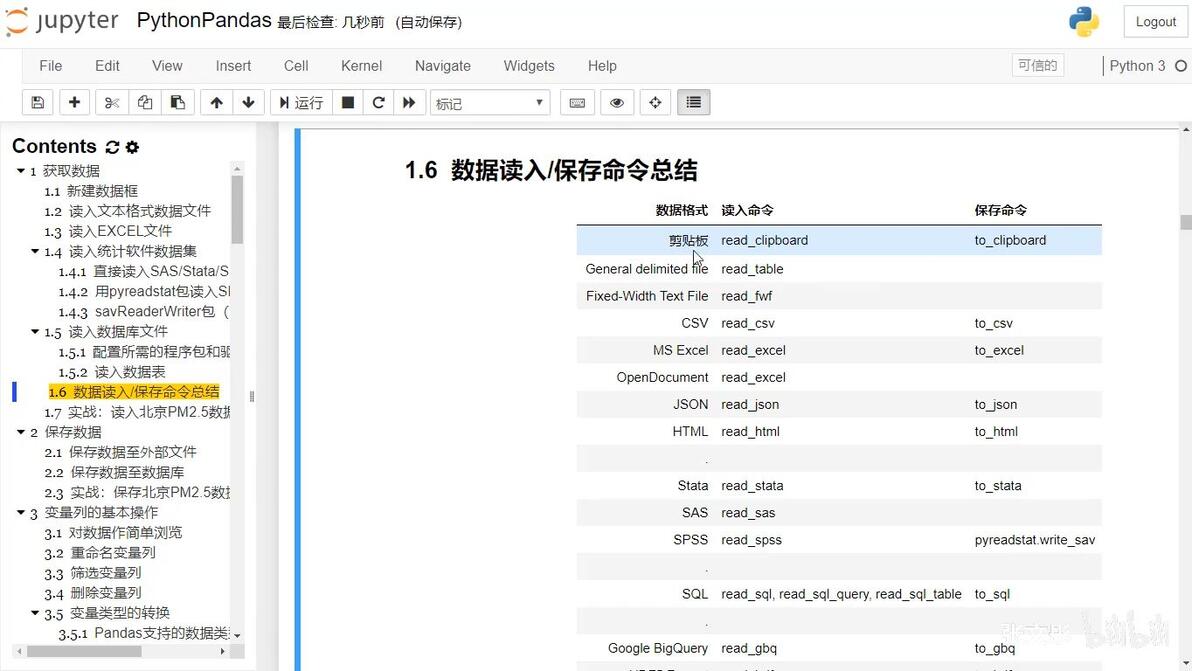
p14
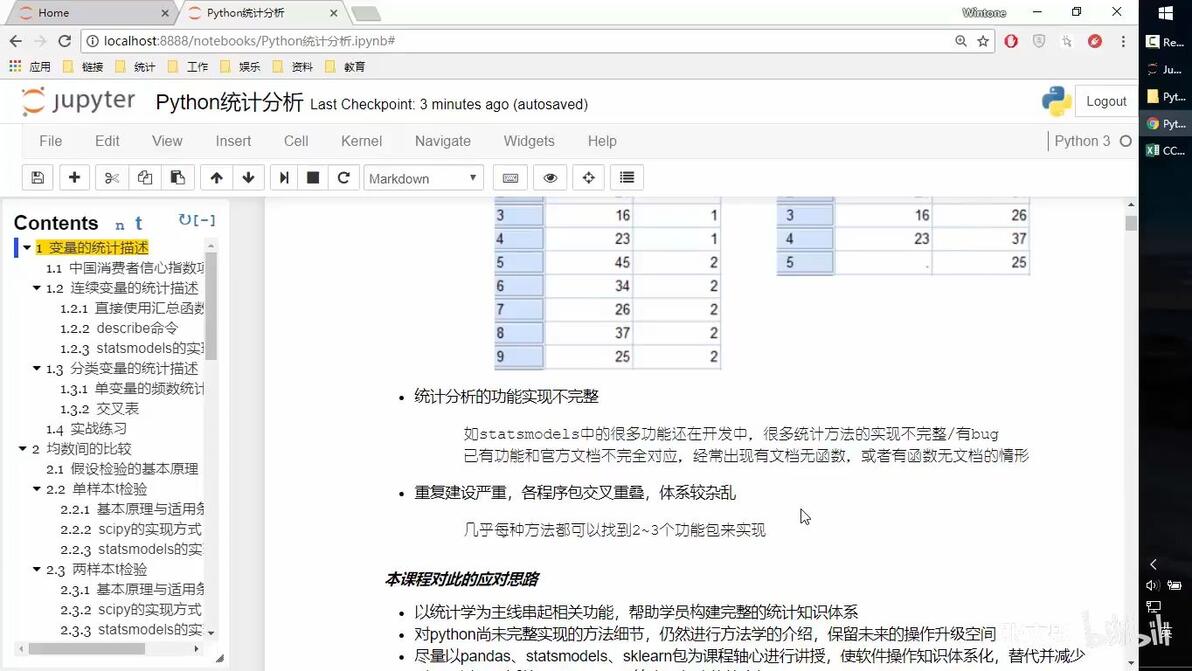
p15
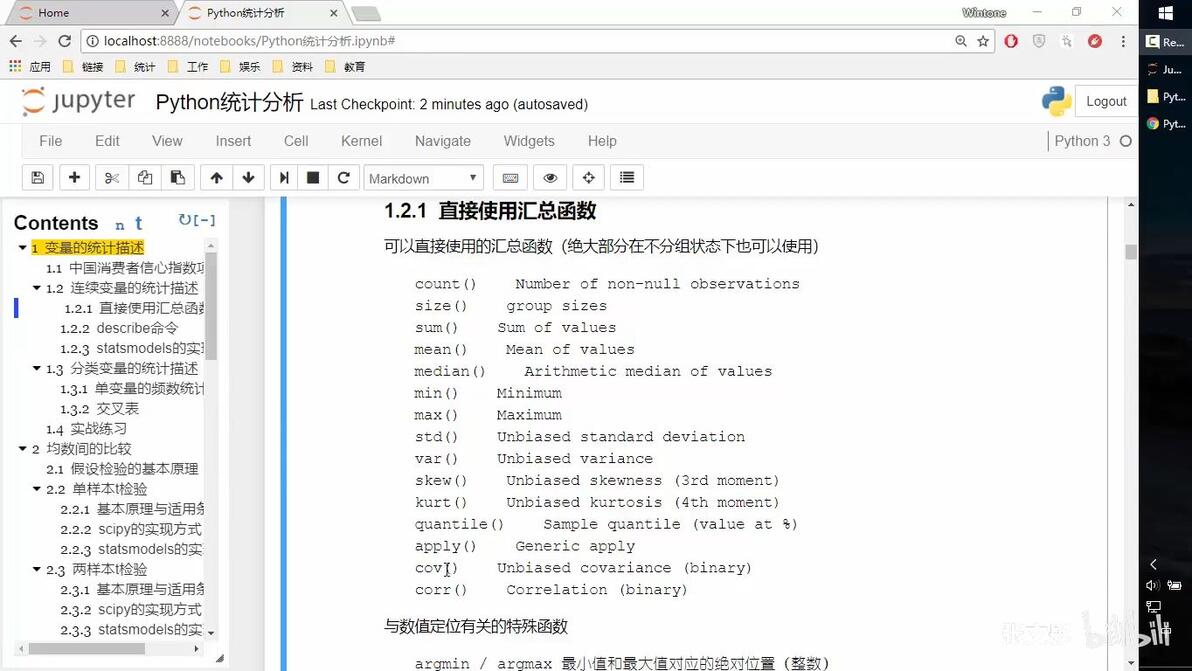
p18
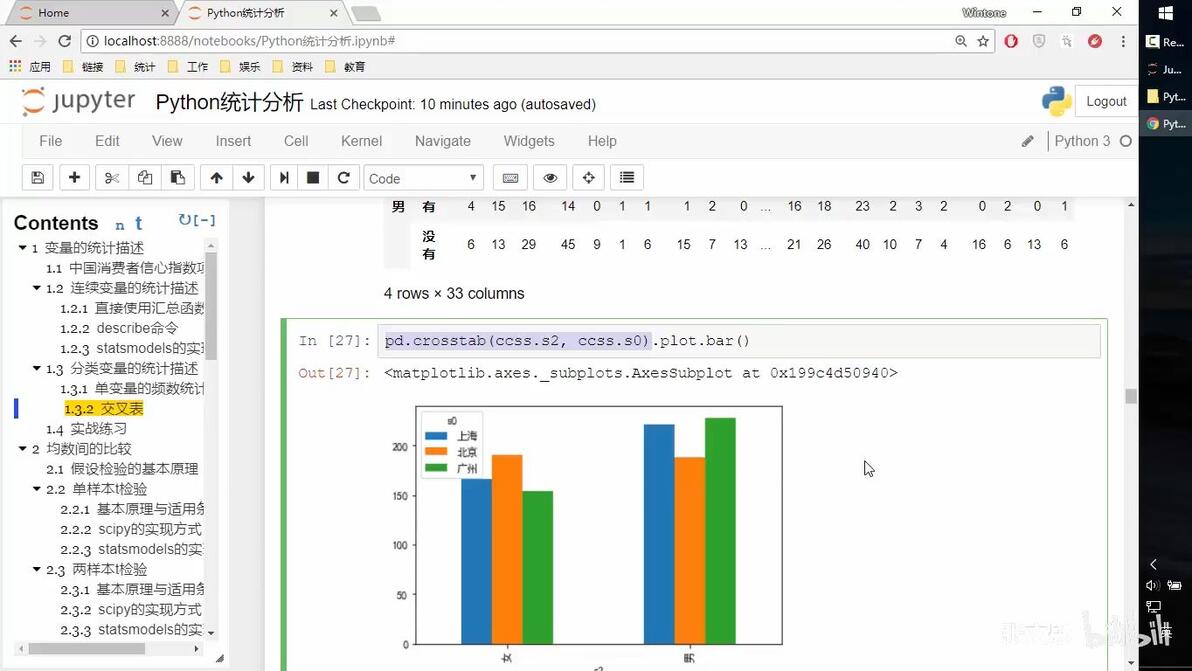
p23
Sklearn体系
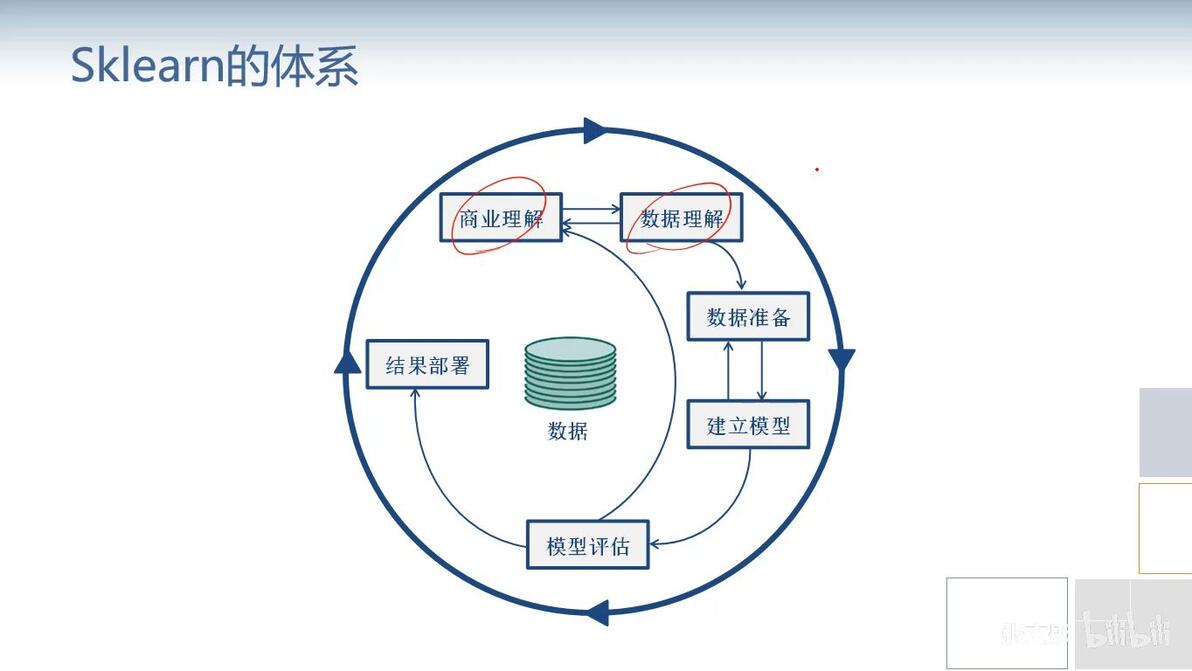
p25
p27
p29
p30
p31
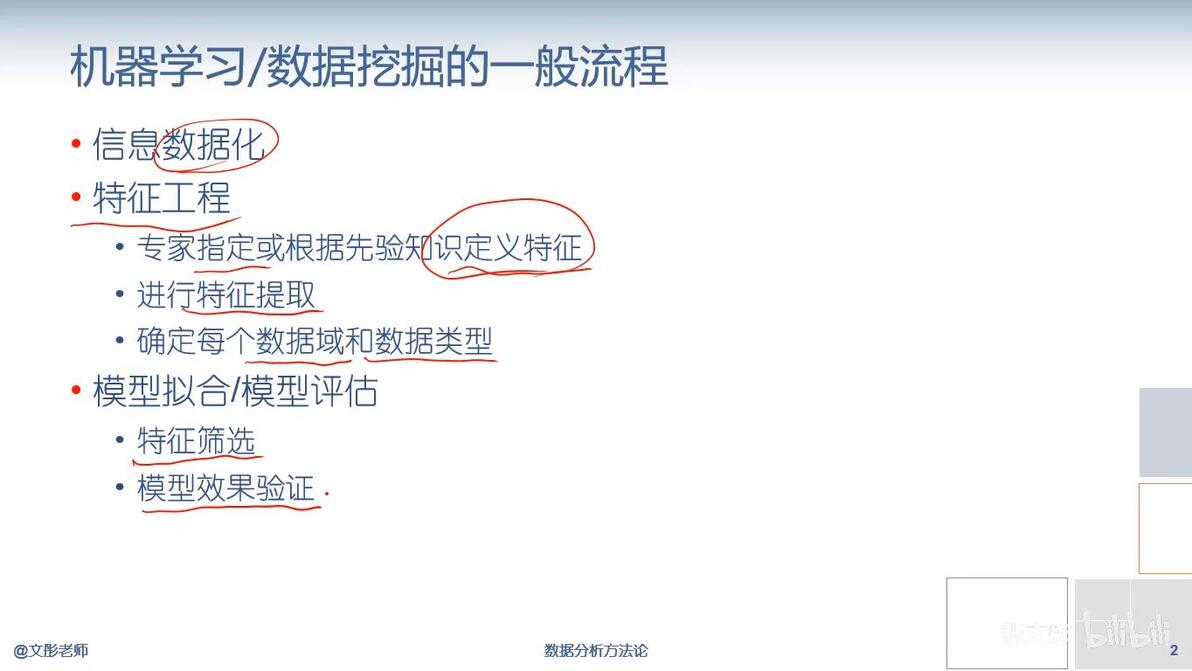
信息数据化
特征工程
专家通过行业经验指定
特征提取
确定数据域和数据模型
模型拟合
特征筛选-去除无关变量
模型验证-验证集-交互验证
结果部署、模型实施
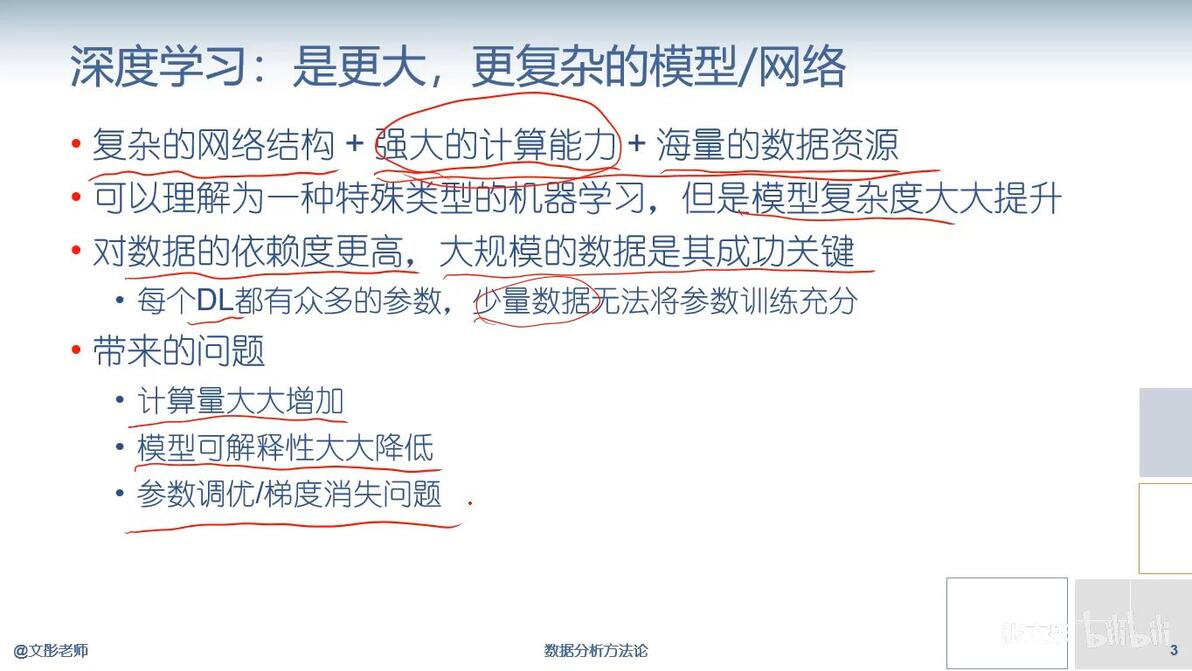
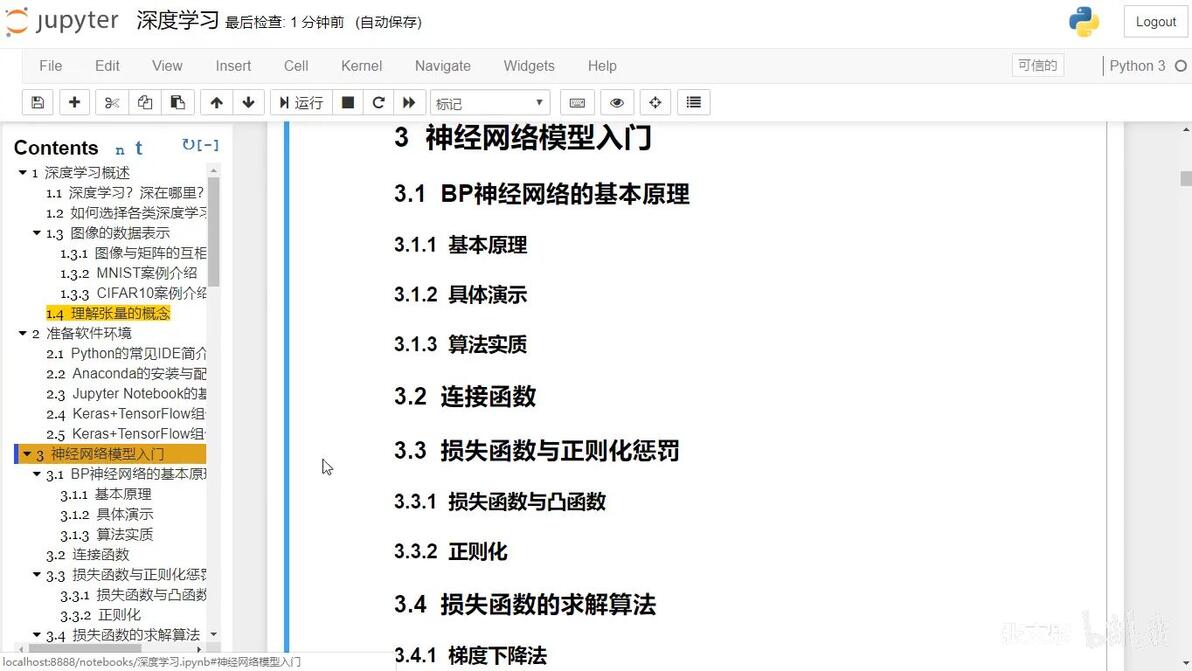
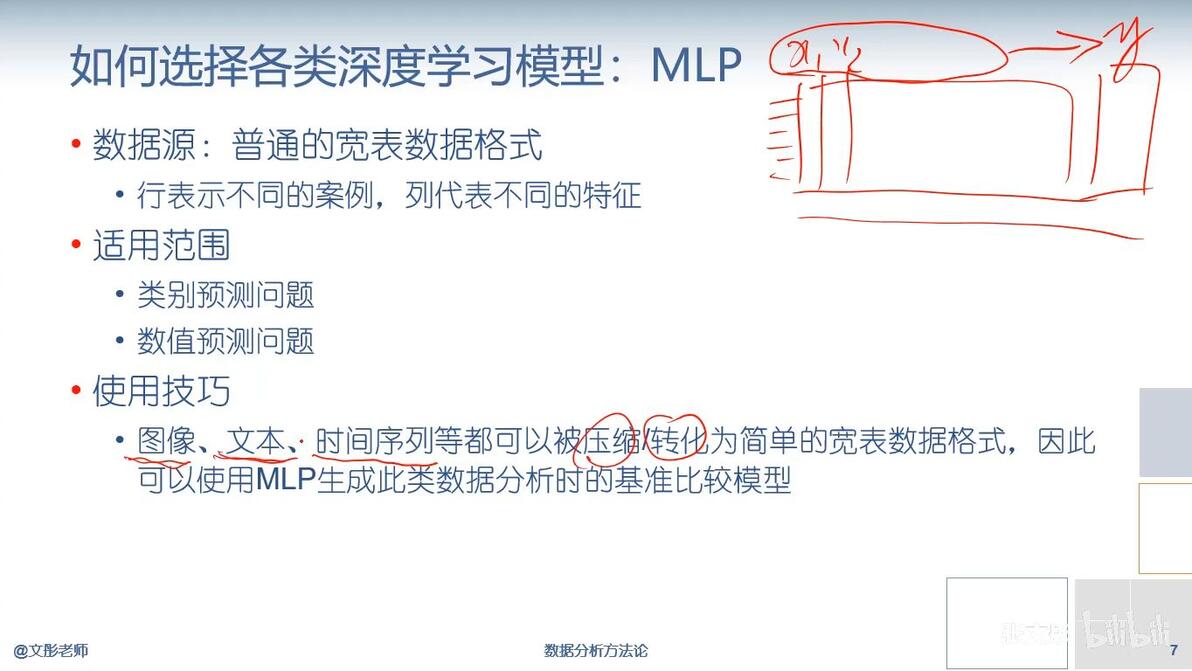
深度学习
更大更复杂的数据挖掘网络
复杂的网络模型+强大的计算能力+海量的数据
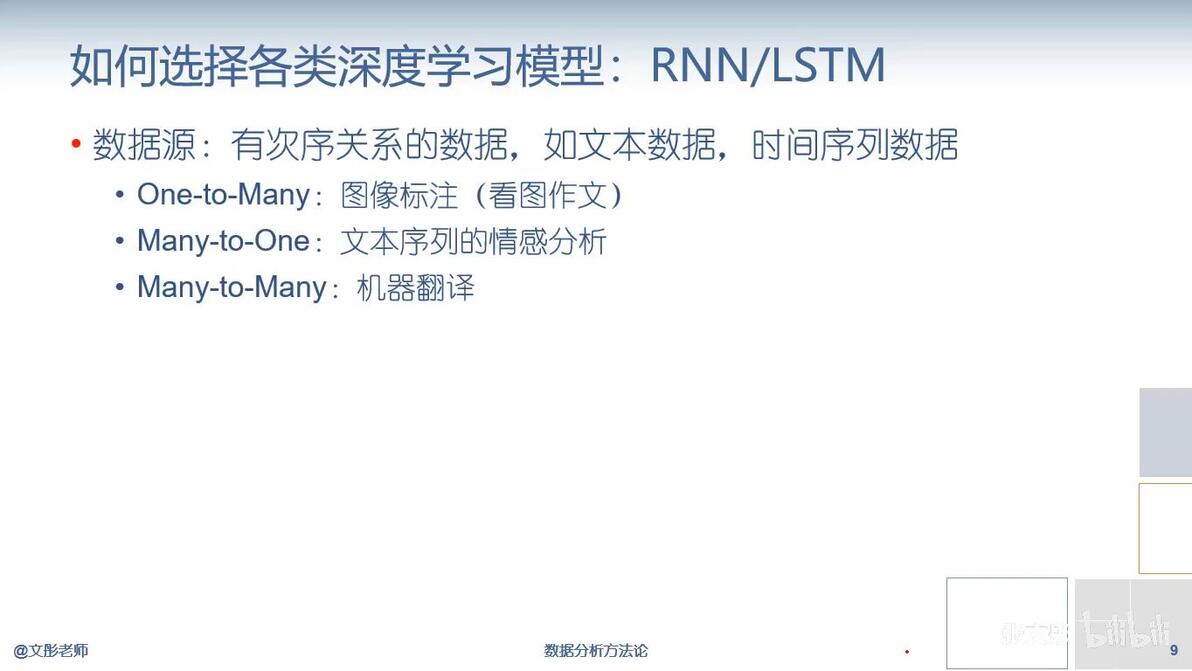
卷积神经网络-循环神将网络
计算量非常大、信息量非常丰富
简单的理解为深度学习可理解为复杂的深度学习
大规模的数据是成功的关键
带来的问题
计算量大大增加
模型的可解释性大大降低
参数调优、梯度消失问题
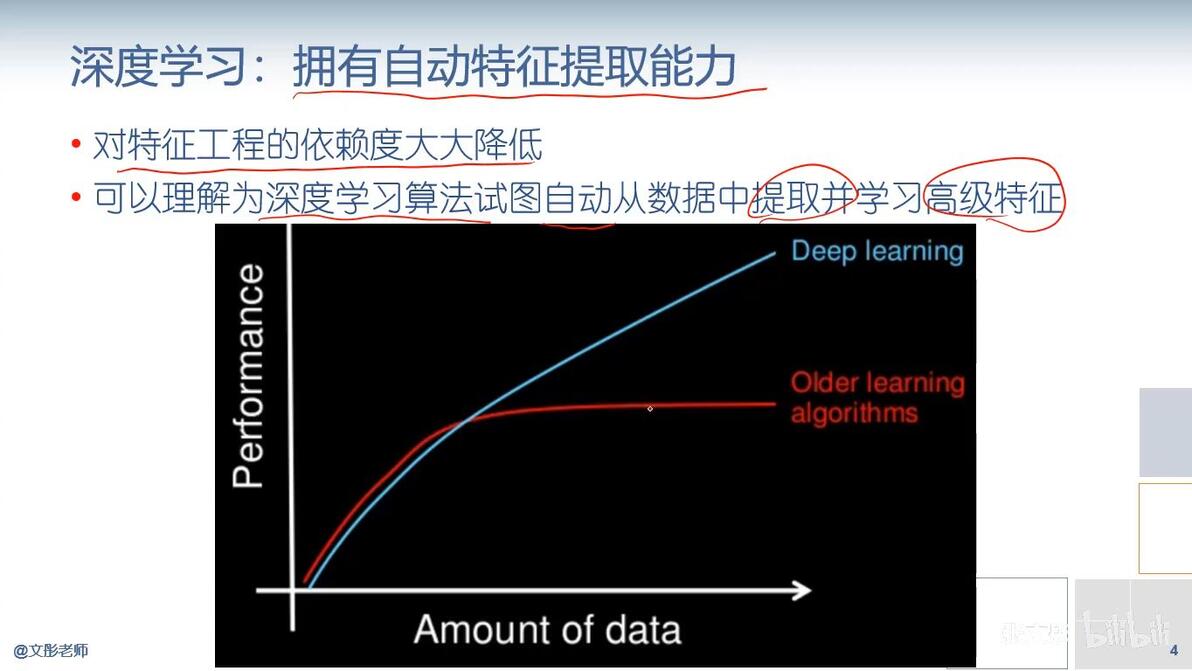
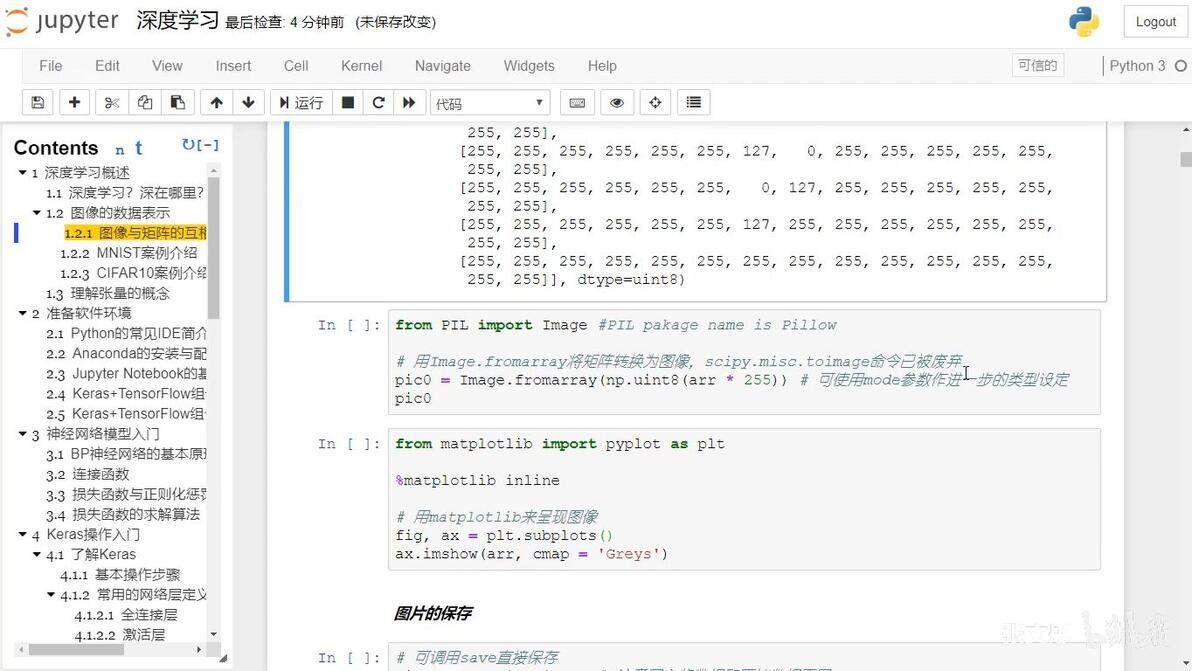
深度学习-拥有自动特征提取功能
对特征提取的依赖度大大降低
深度学习的算法试图自动从数据中提取并学习高级特征
p32
p33
p36
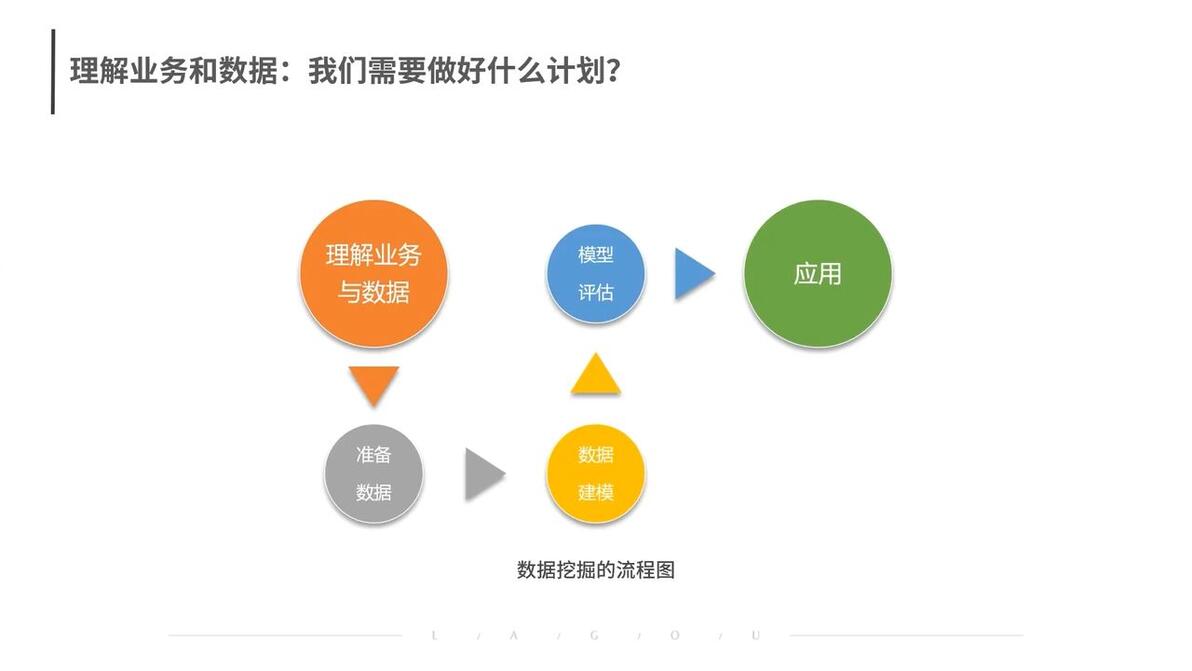
业务和数据理解
思想问题--- 避免对业务的轻视
挖掘人员需要真正理解业务场景
轻视业务是很容易犯的问题
深入学习业务明白业务
思想问题
明白业务的要求及目标
把握数据
p37
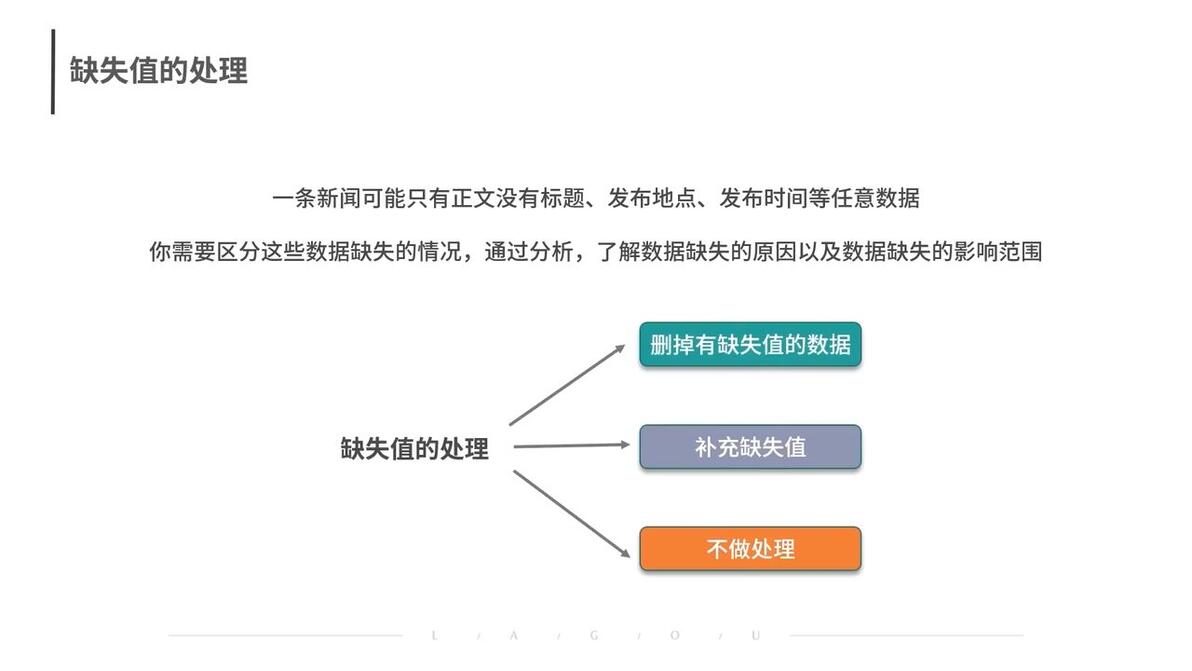
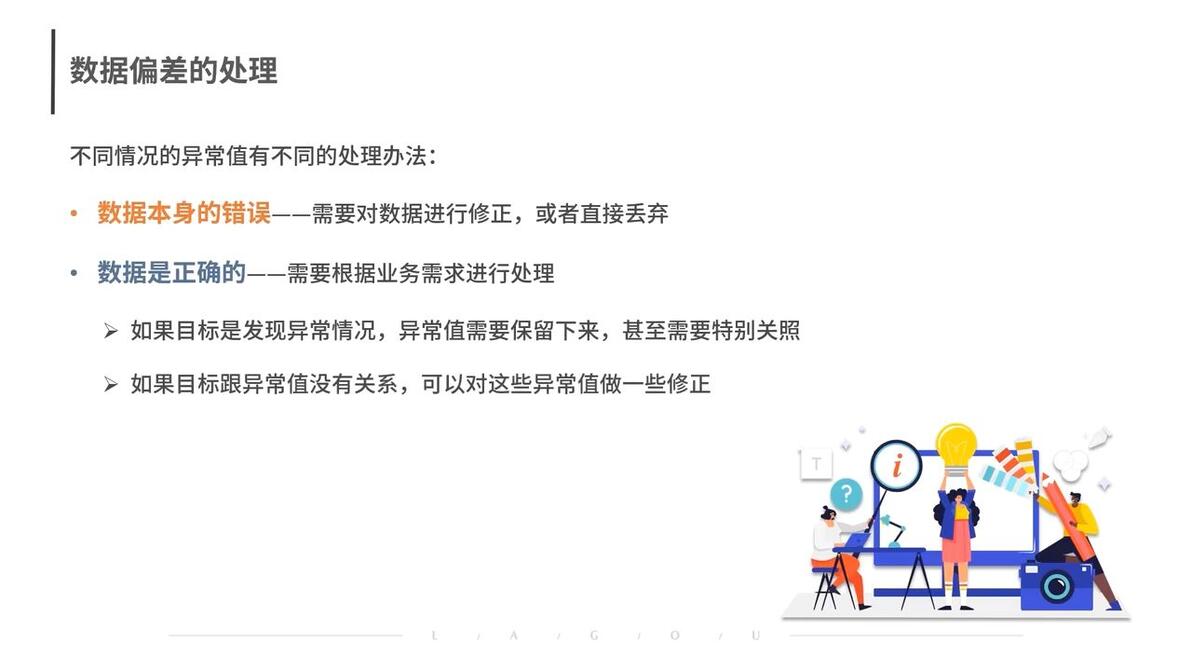
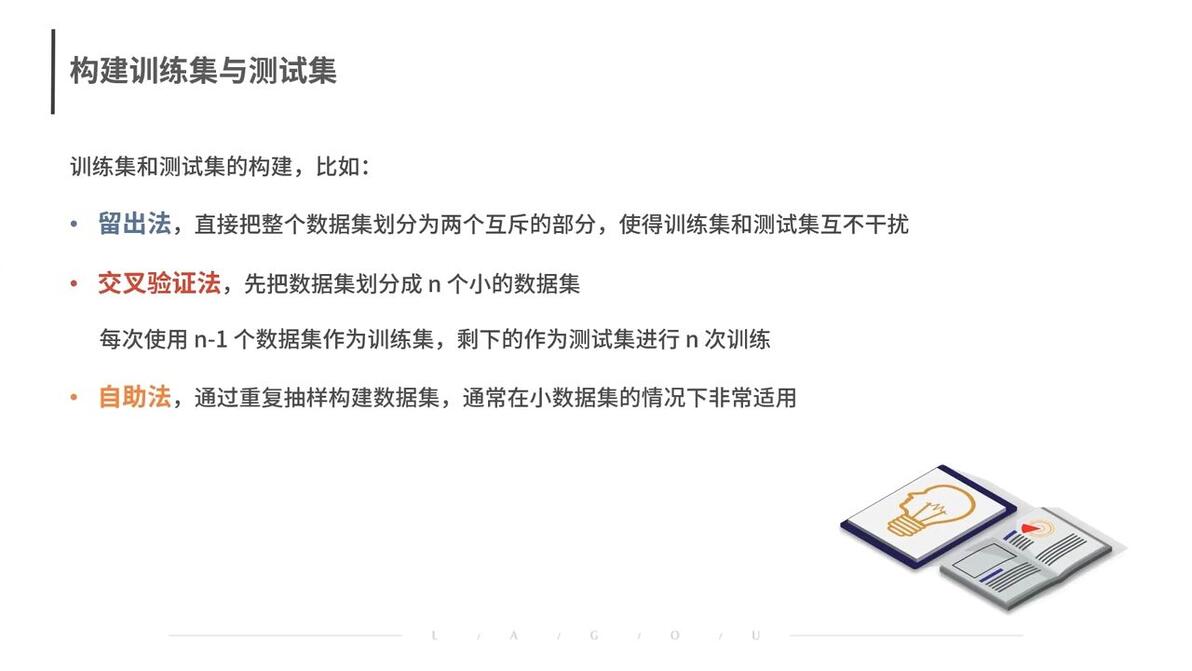
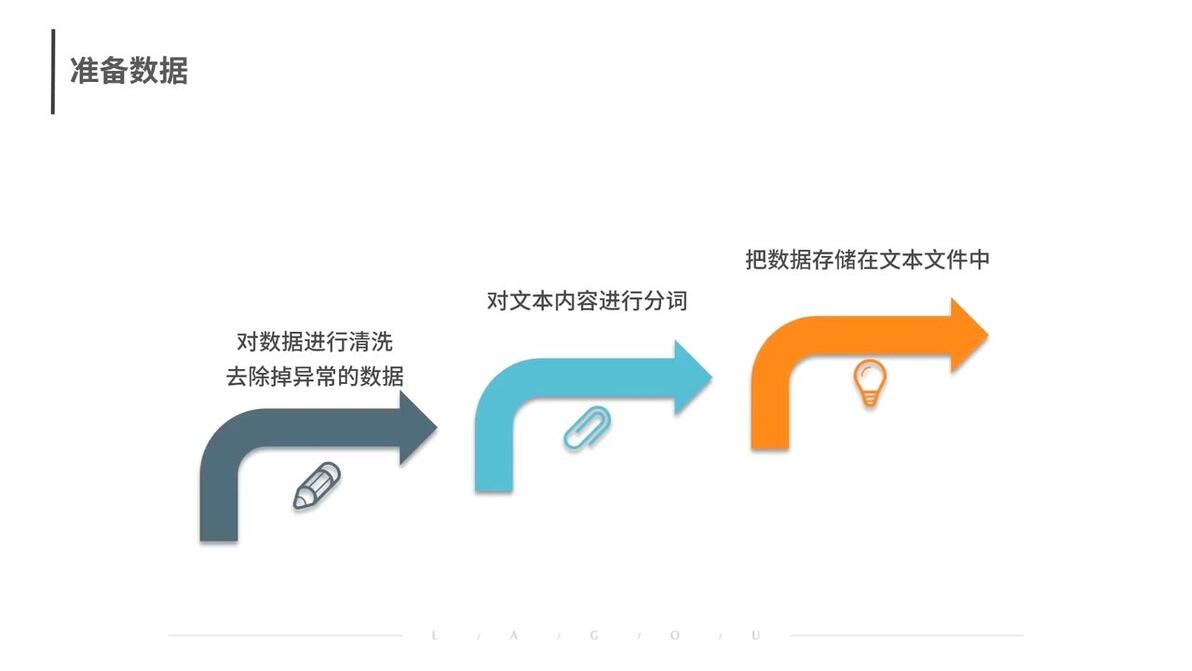
准备数据
数据清洗
p38
分类问题--------明确标签区分
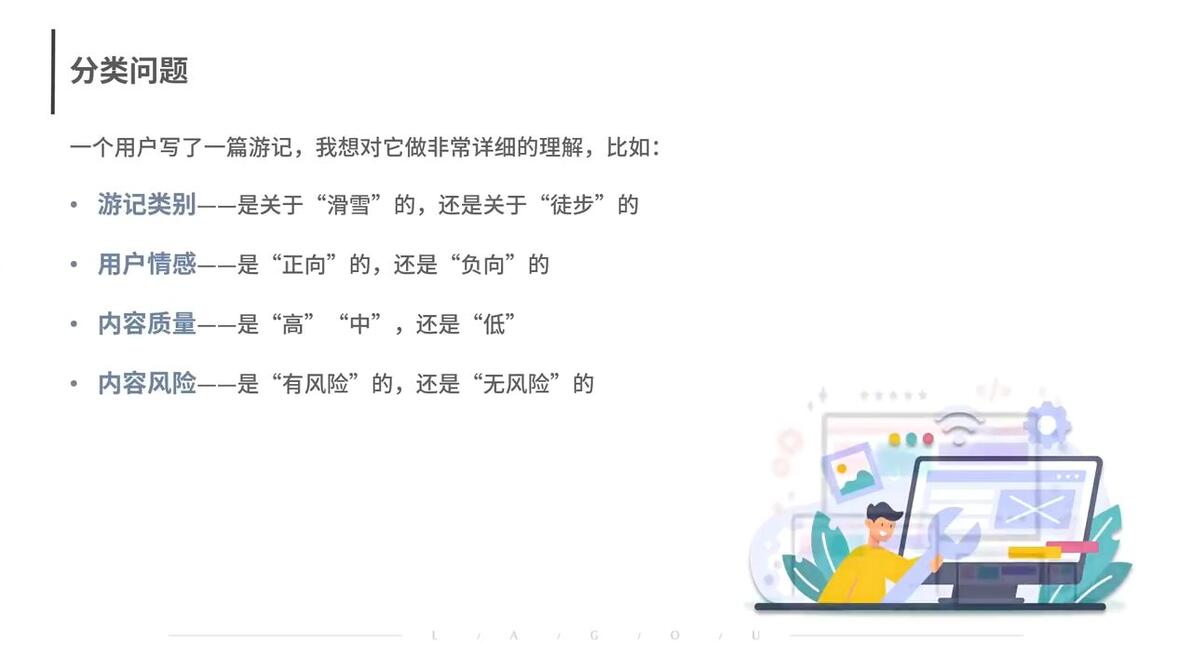
二分类--------是或否的情况
多分类问题---------在二分类基础上将标签范围扩大
多标签分类-----------数据可以被标注上多个标签
聚类问提
基于划分的聚类
基于密度的聚类
基于层次的聚类
基于模型的聚类
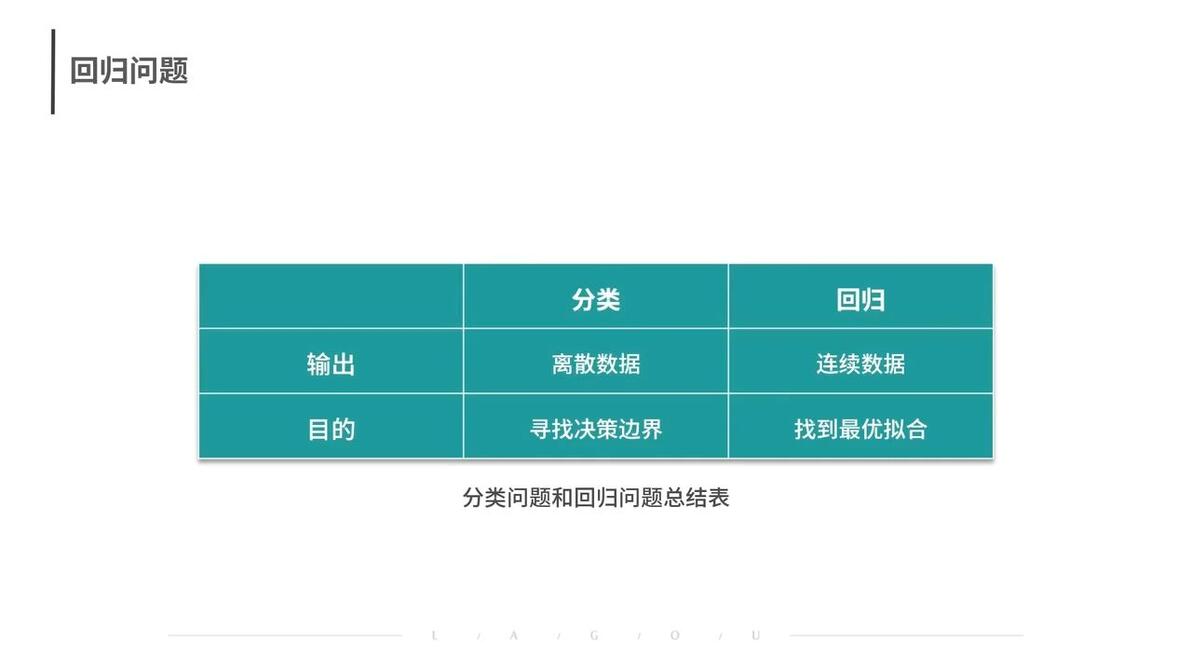
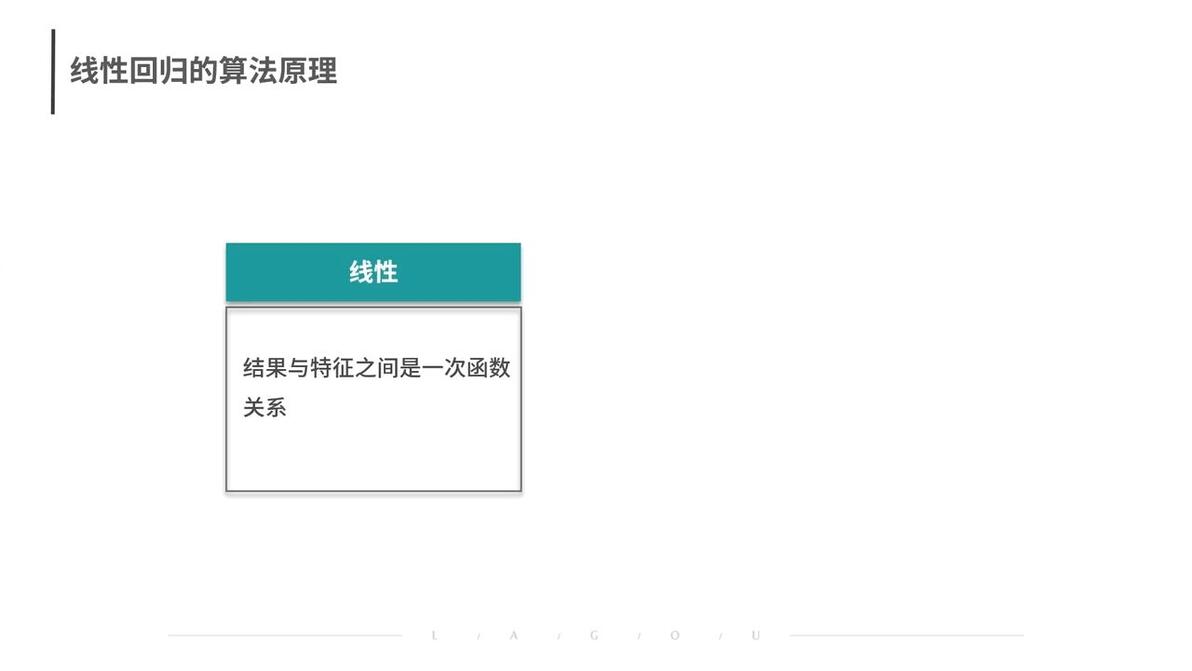
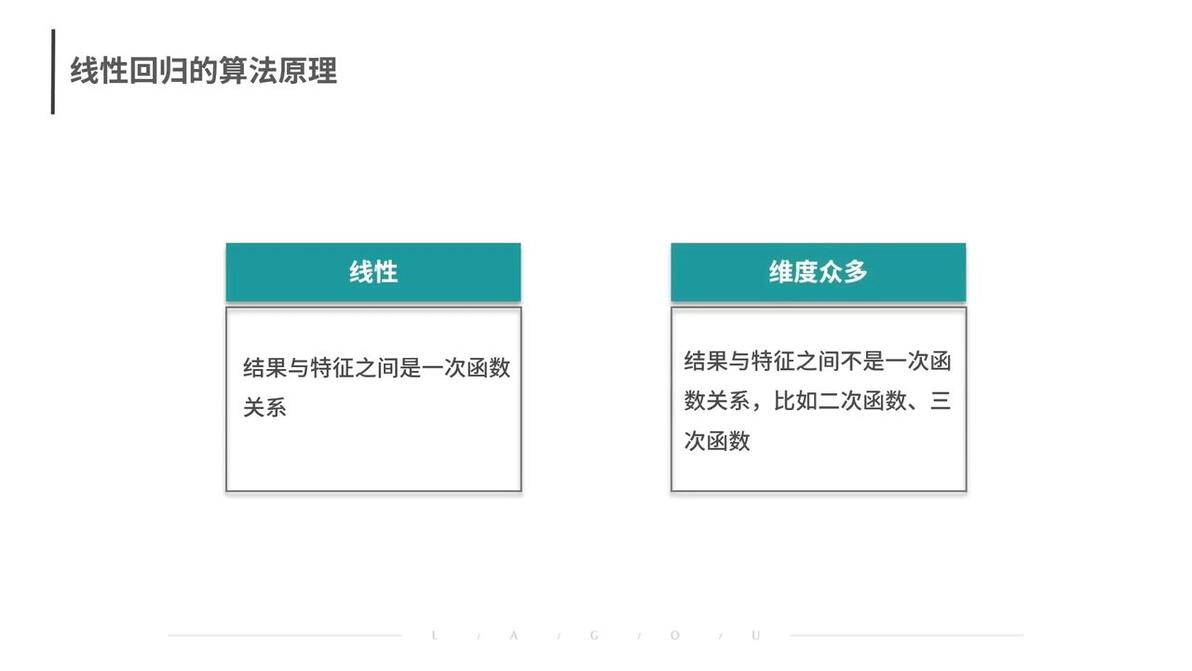
回归问题
分类方法输出的是离散的标签
回归方法输出的是连续值
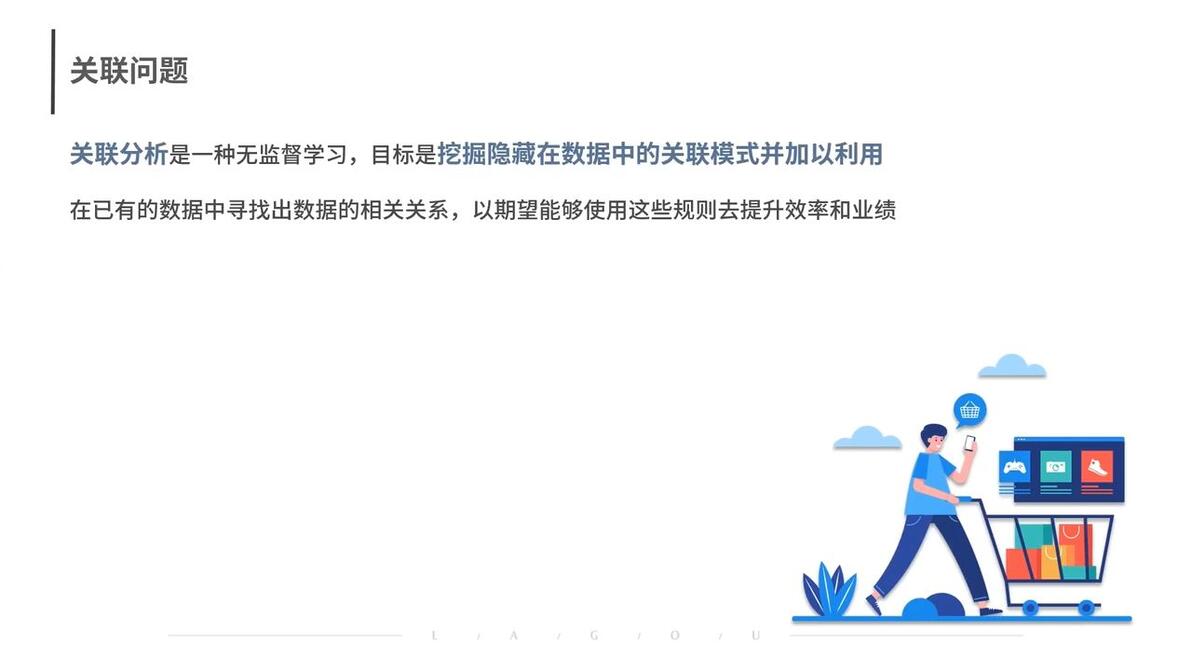
关联分析
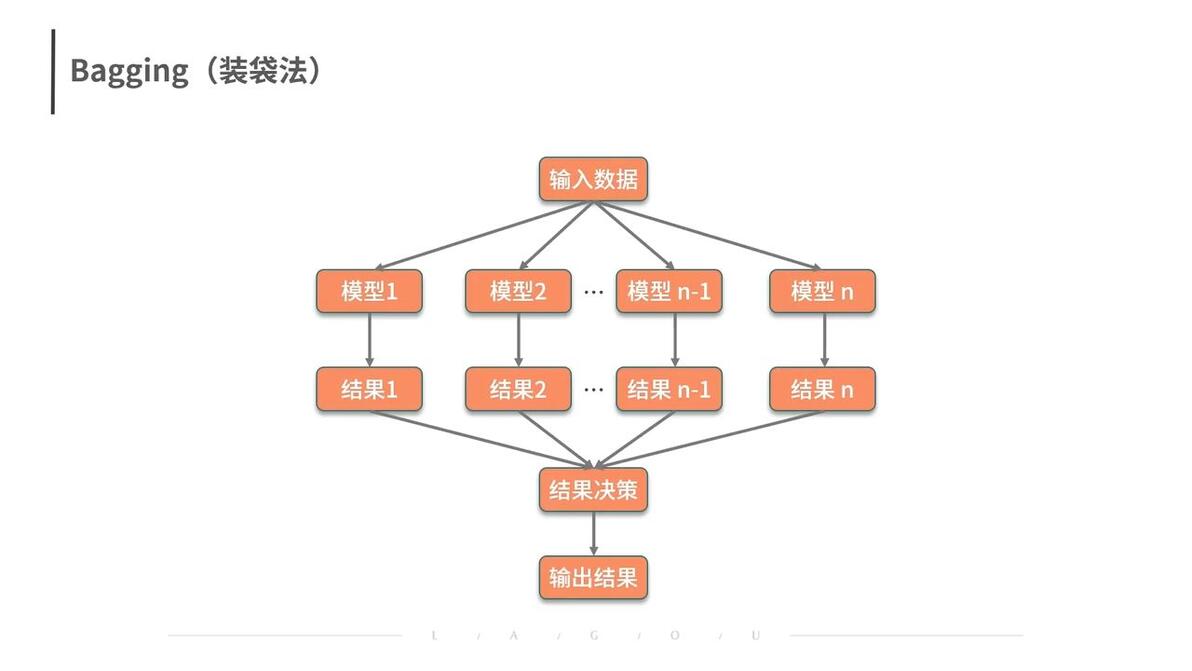
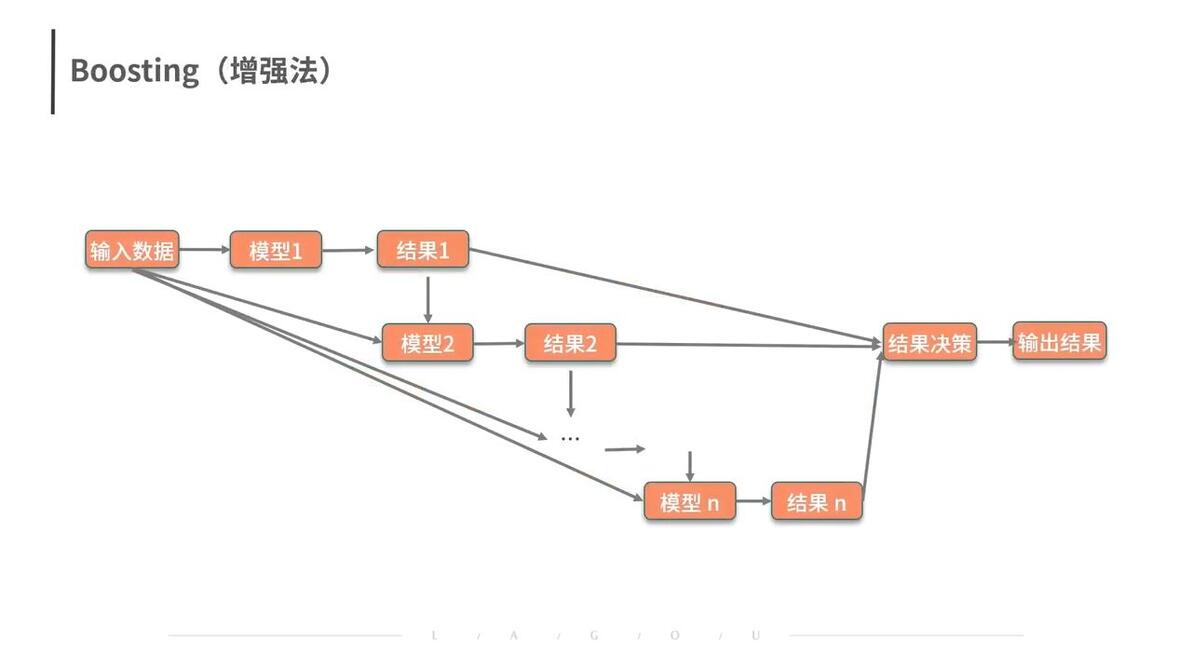
p41
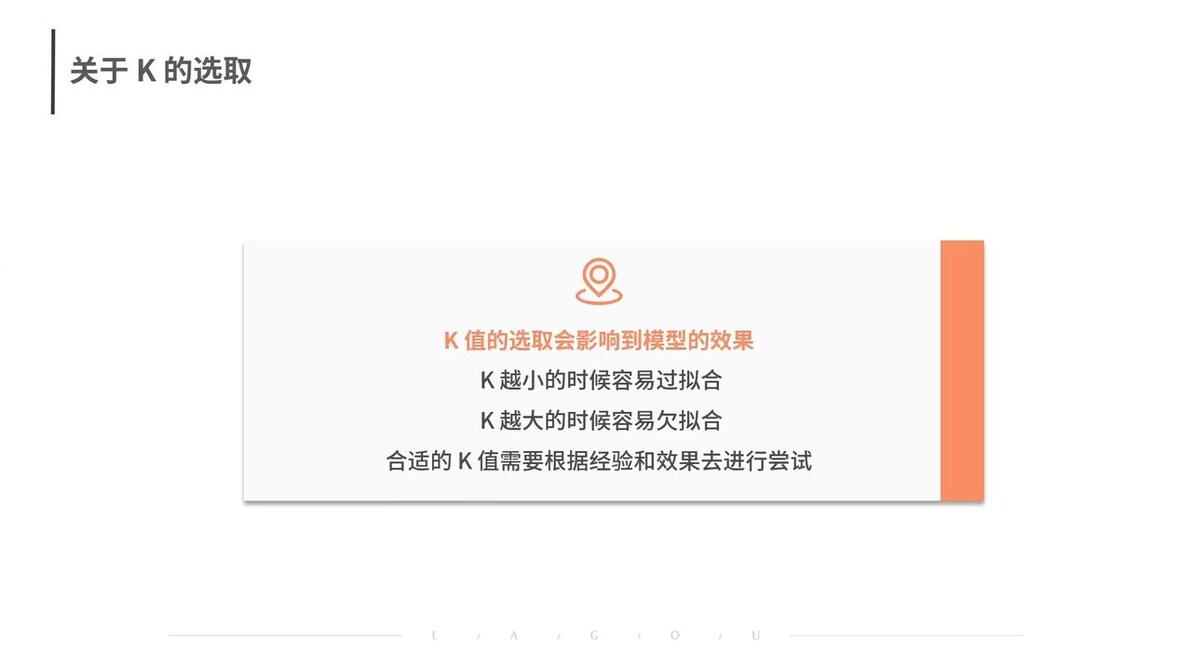
knn算法:最近相邻算法
knn算法原理-找到k个与新数据最近的样本取样本中最多的一个类别作为新数据的类别
找与新搬来的人家,距离最近的k个人家,看有钱人多还是穷人多
p42
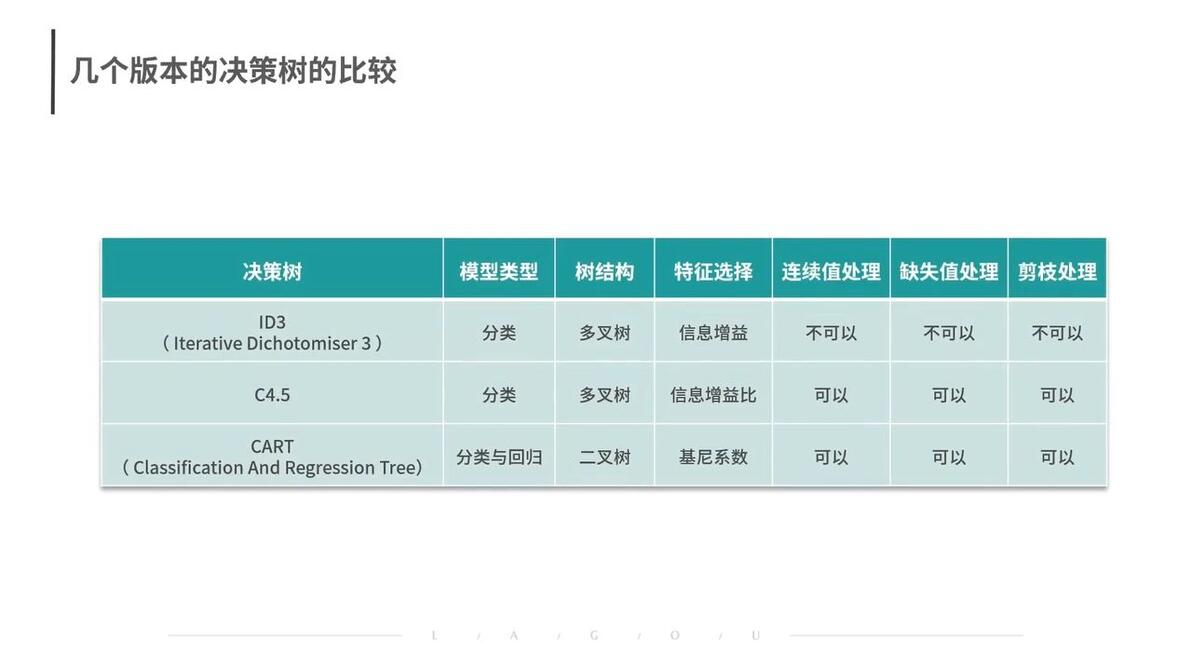
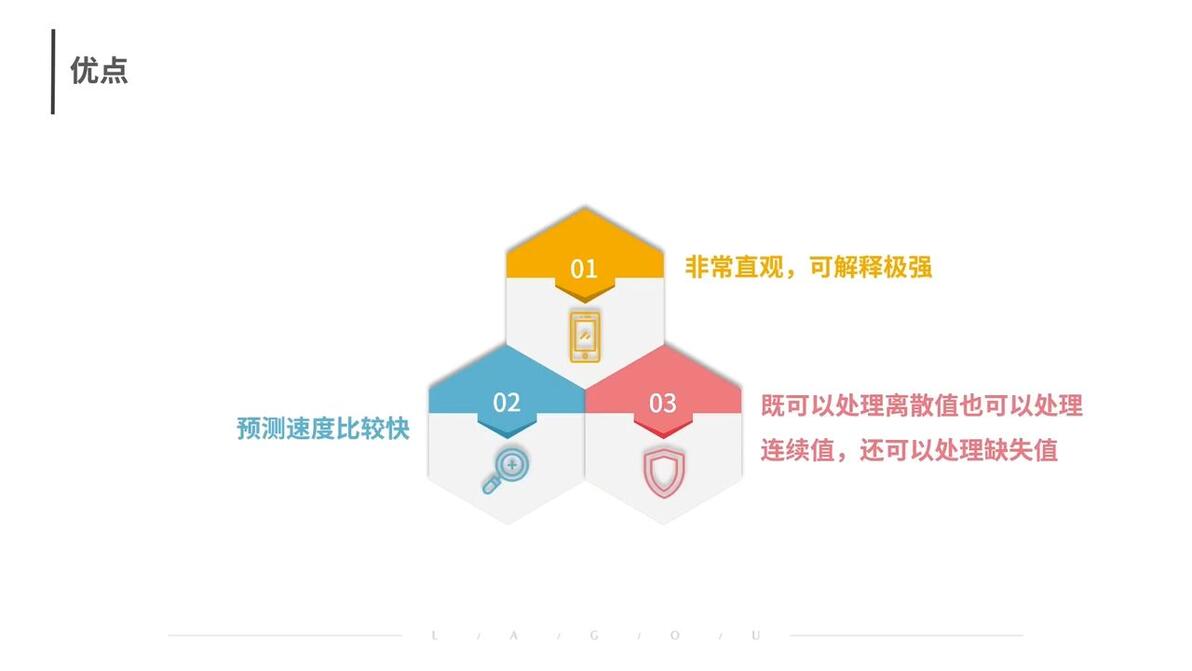
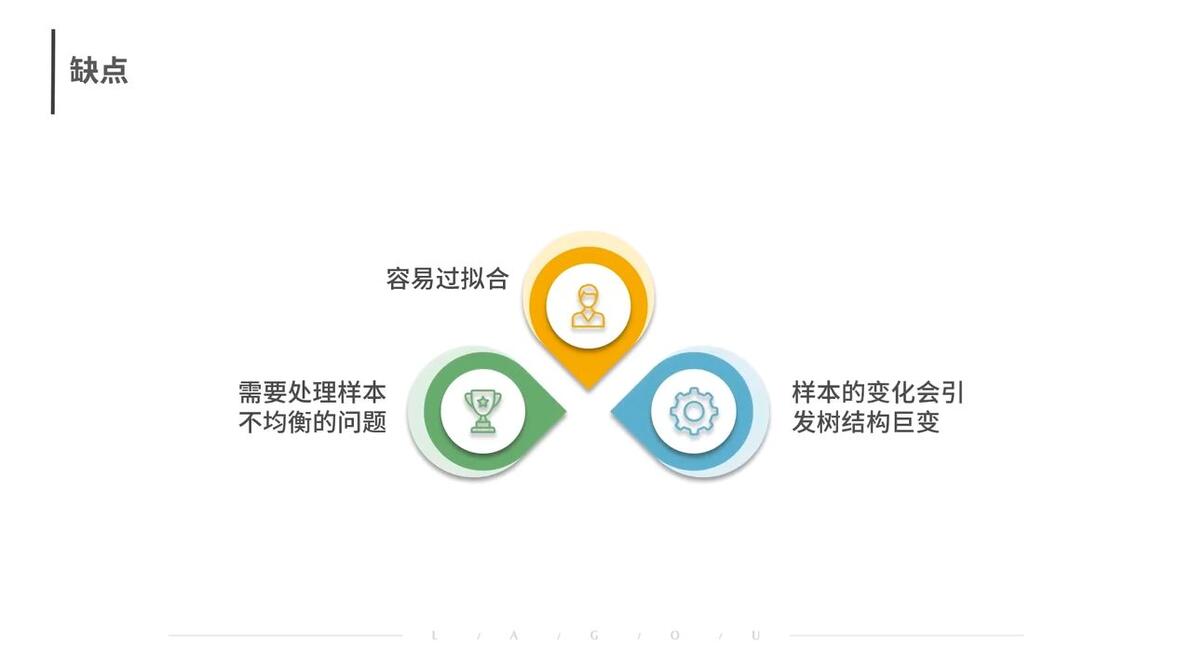
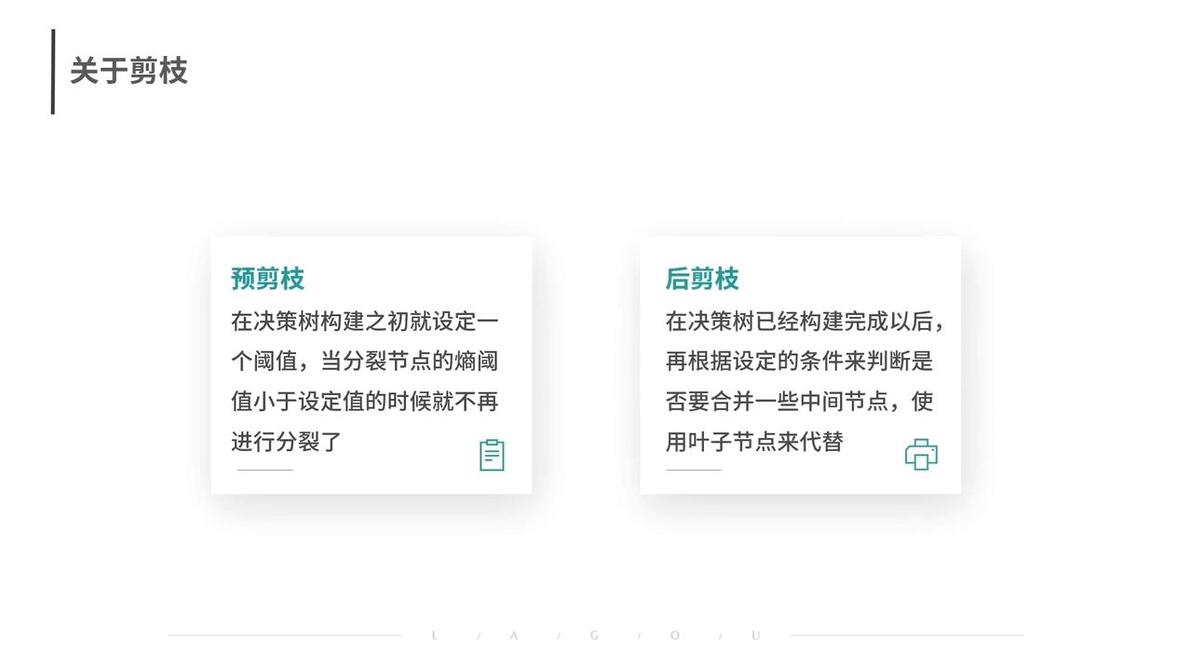
p43
p44
p45
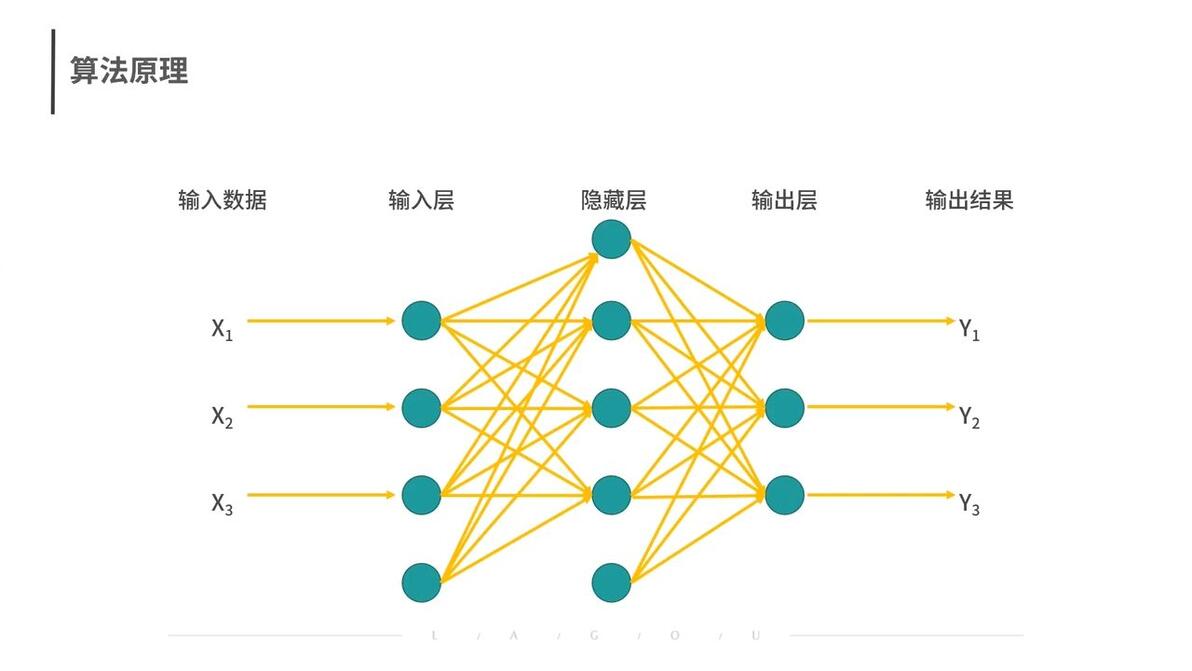
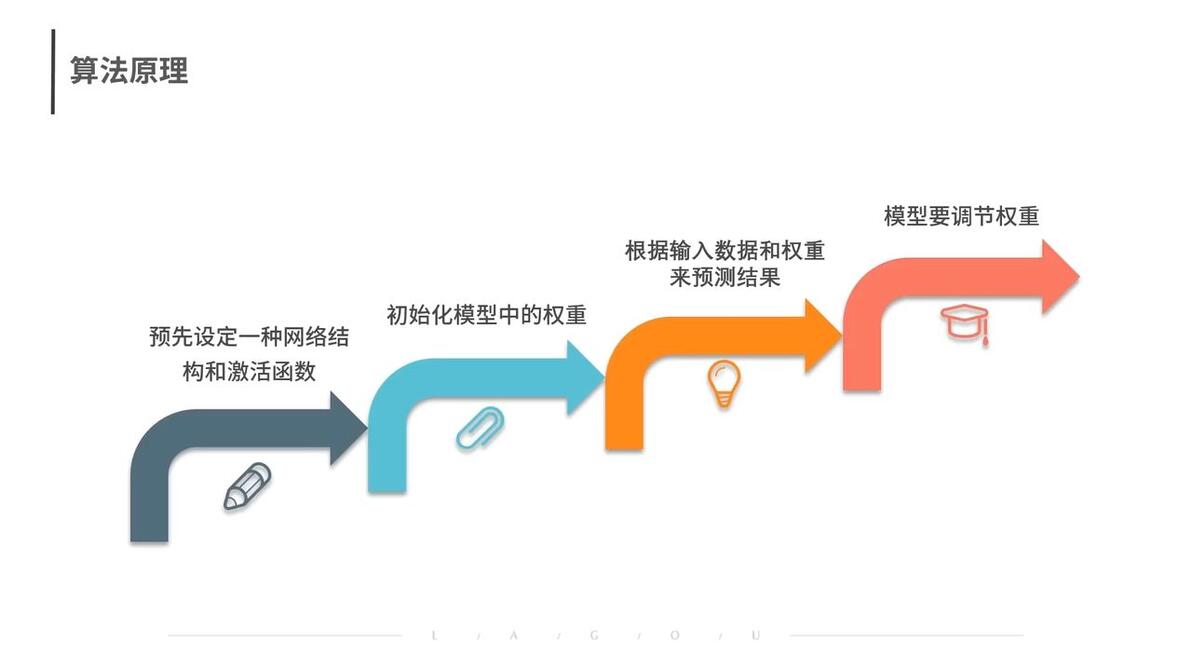
p46
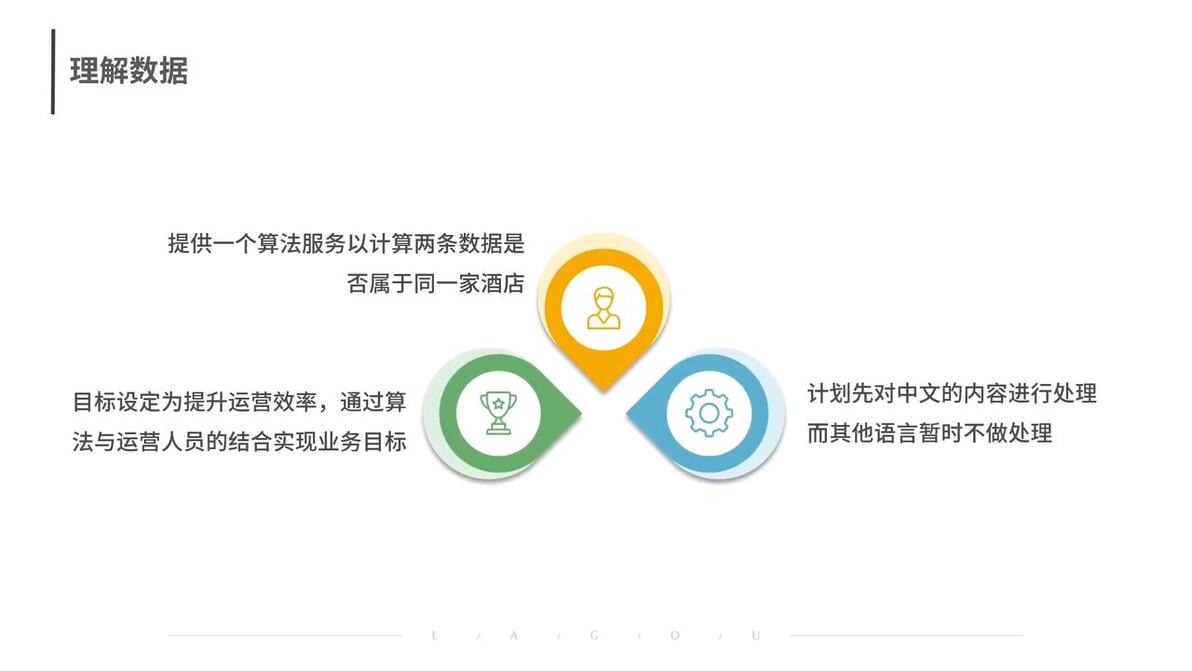
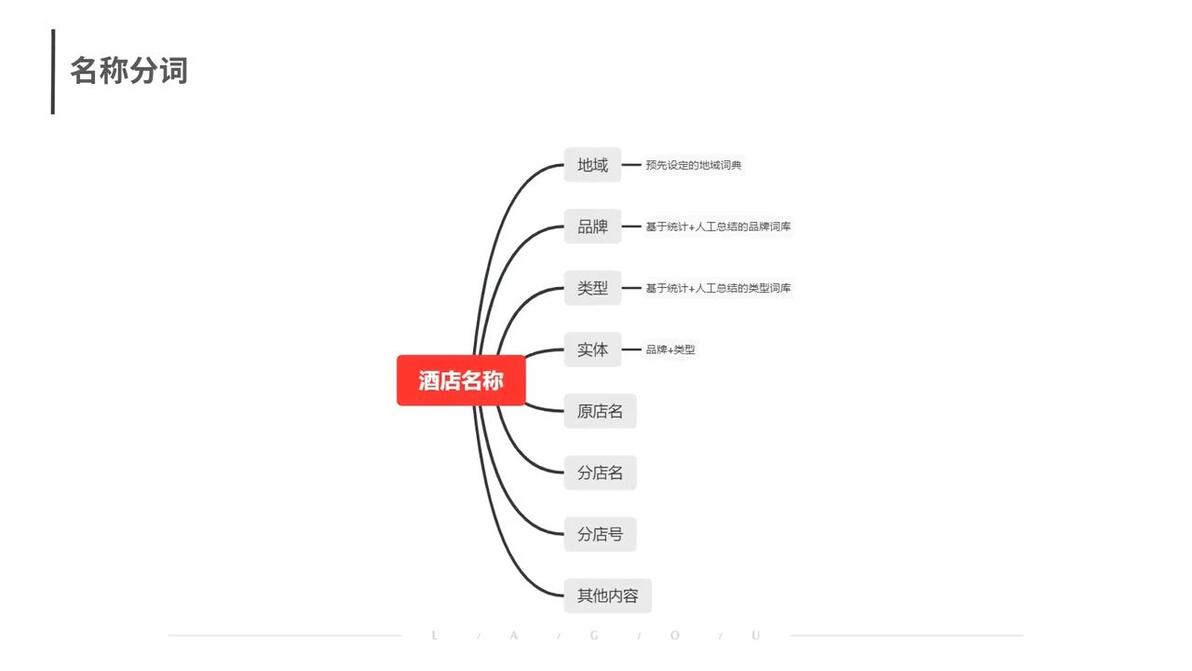
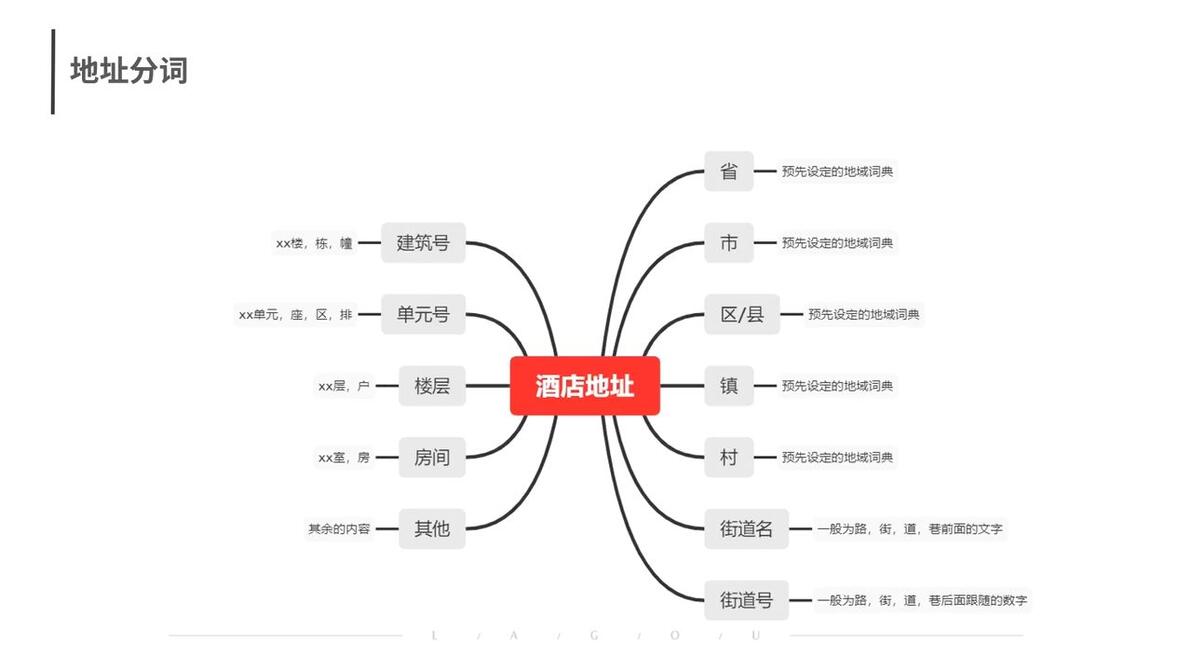
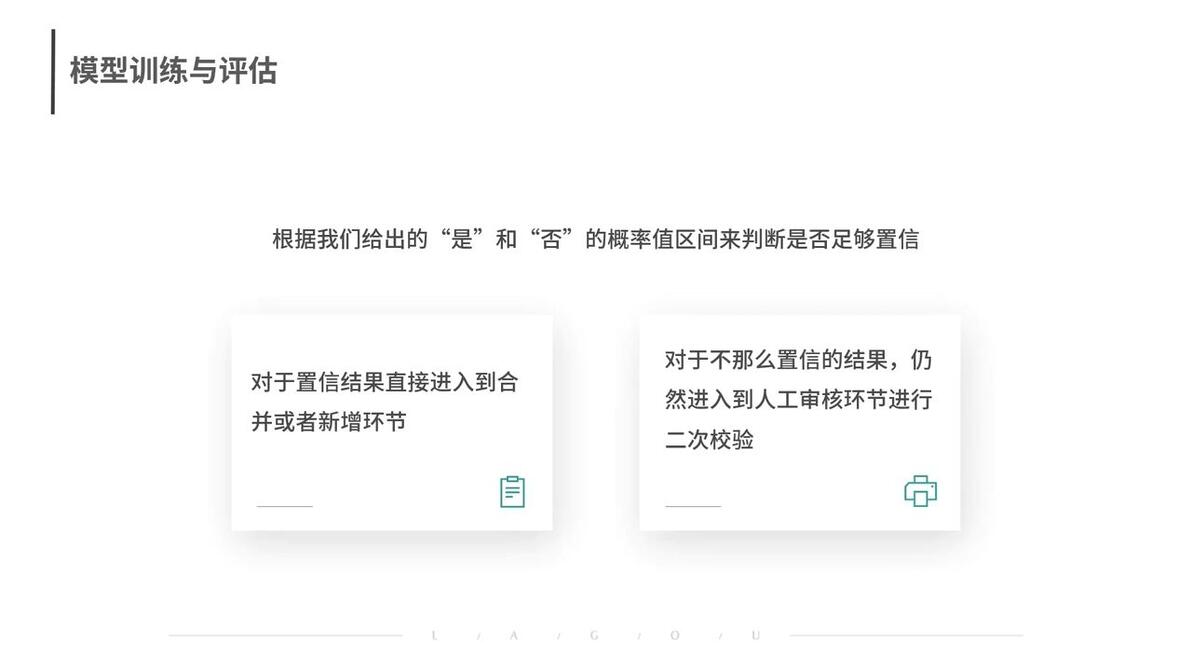
使用XGB实现酒店信息消歧
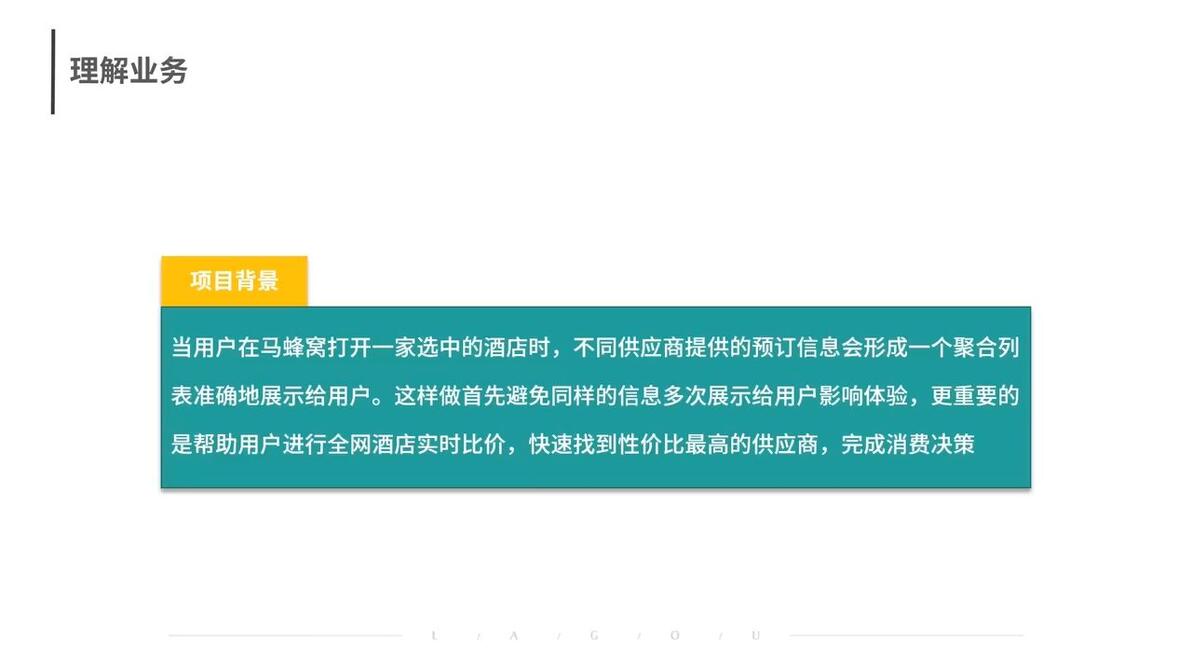
p47k-means聚类
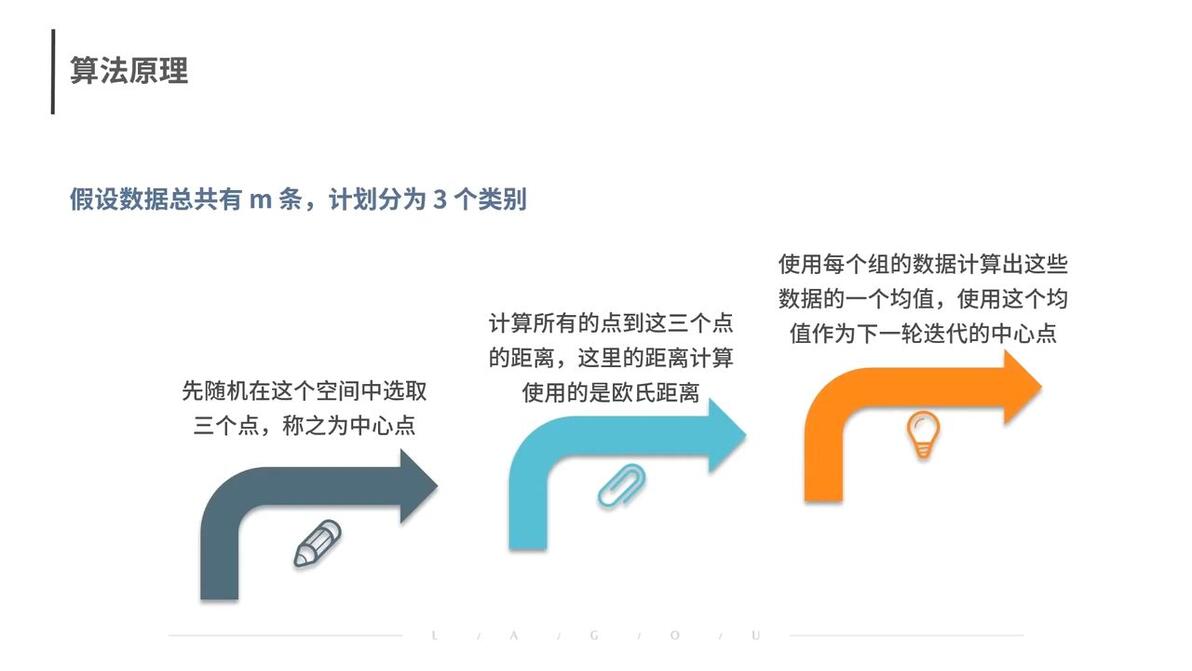
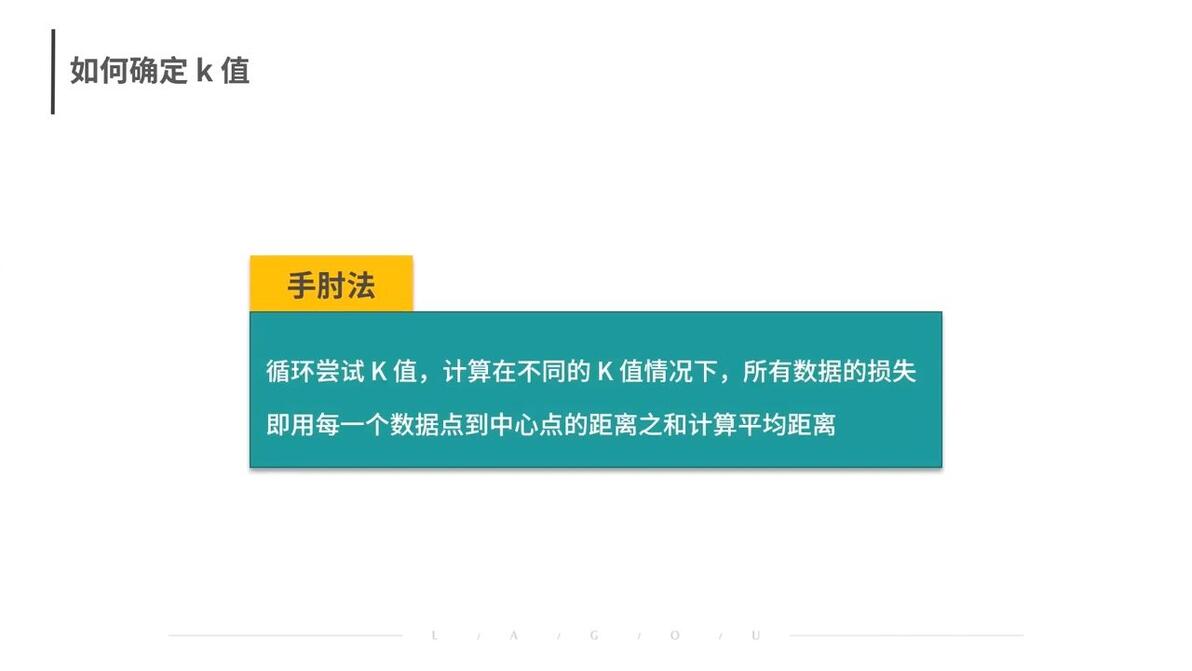
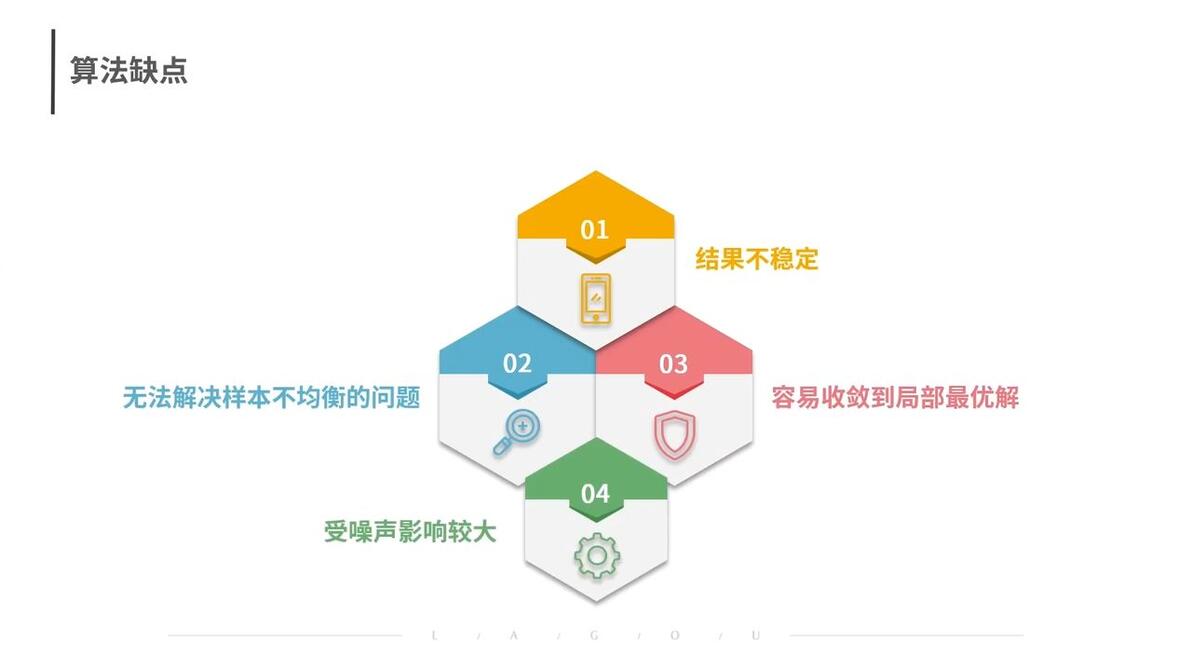
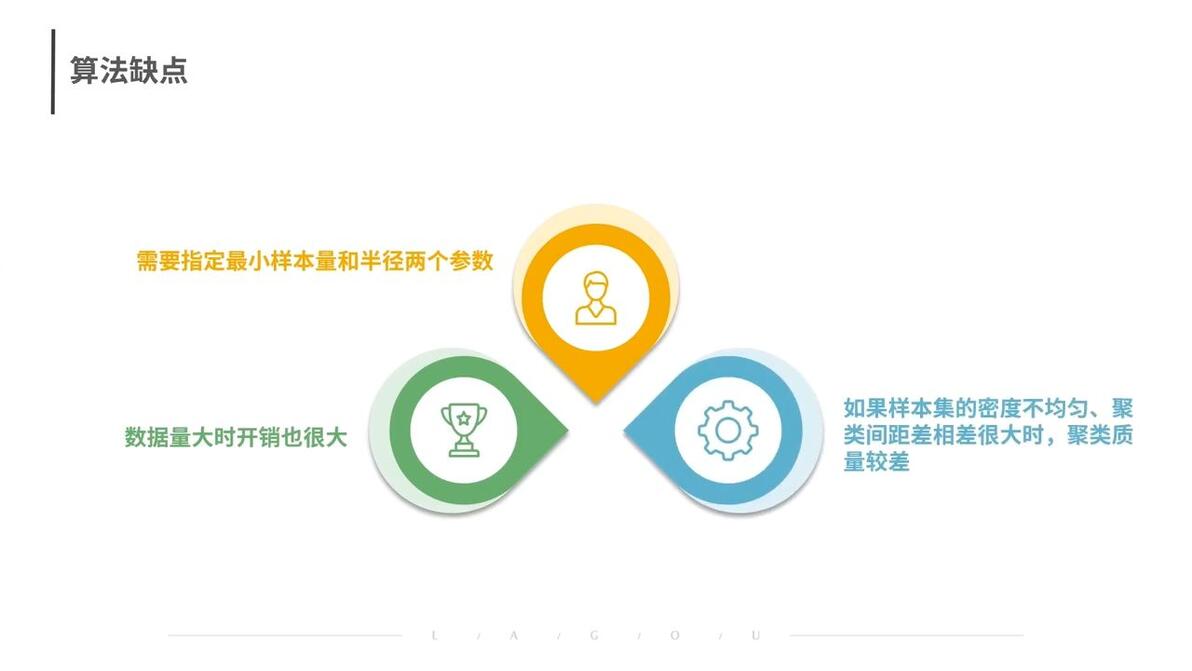
p48 DBScan聚类
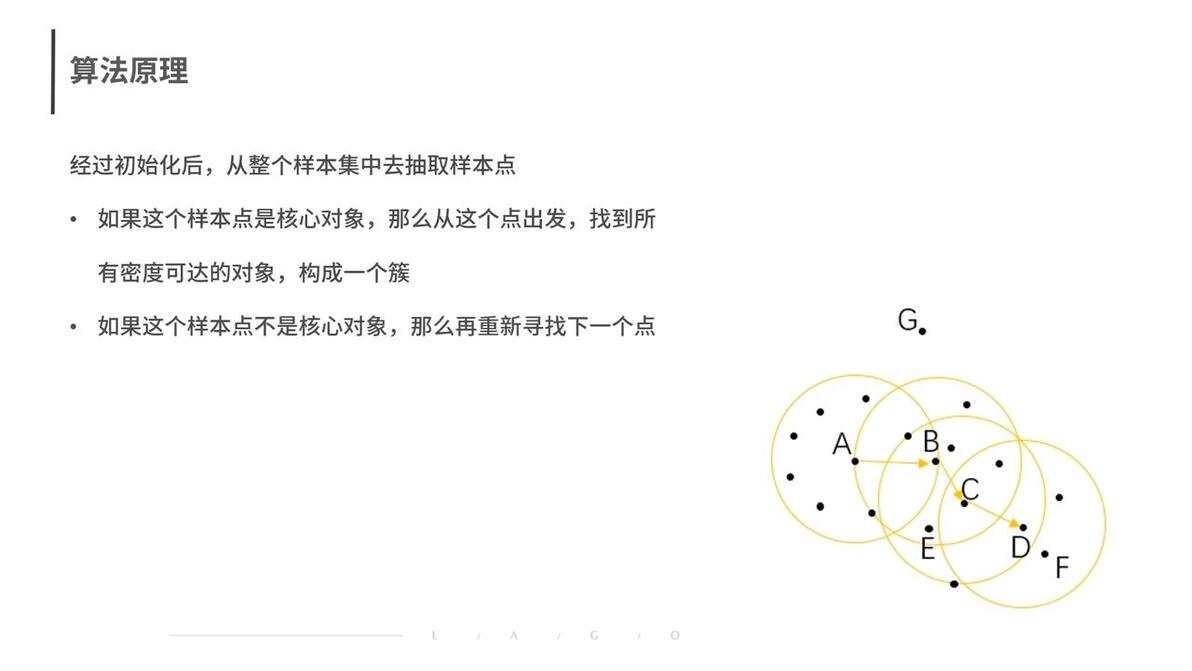
P49
p50回归
p63