AIGC(Al Generated Content):AI生成内容的统称

generative ai:生成式AI
两者关系

左边是生成式AI,右边是AIGC
各概念的关系
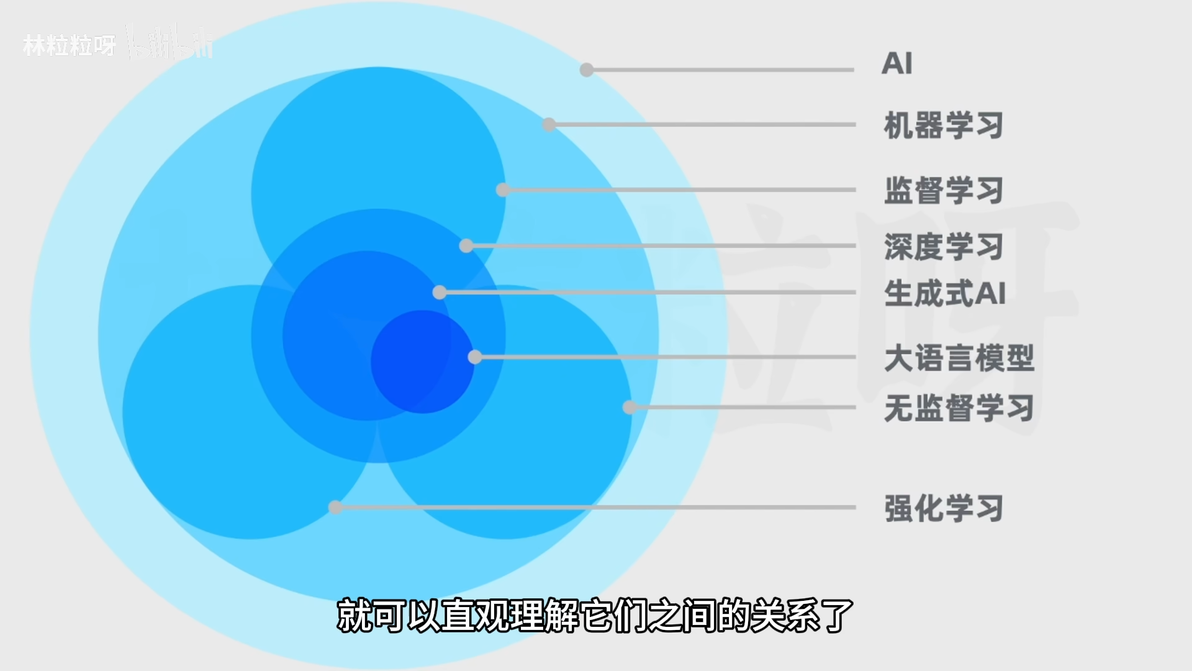
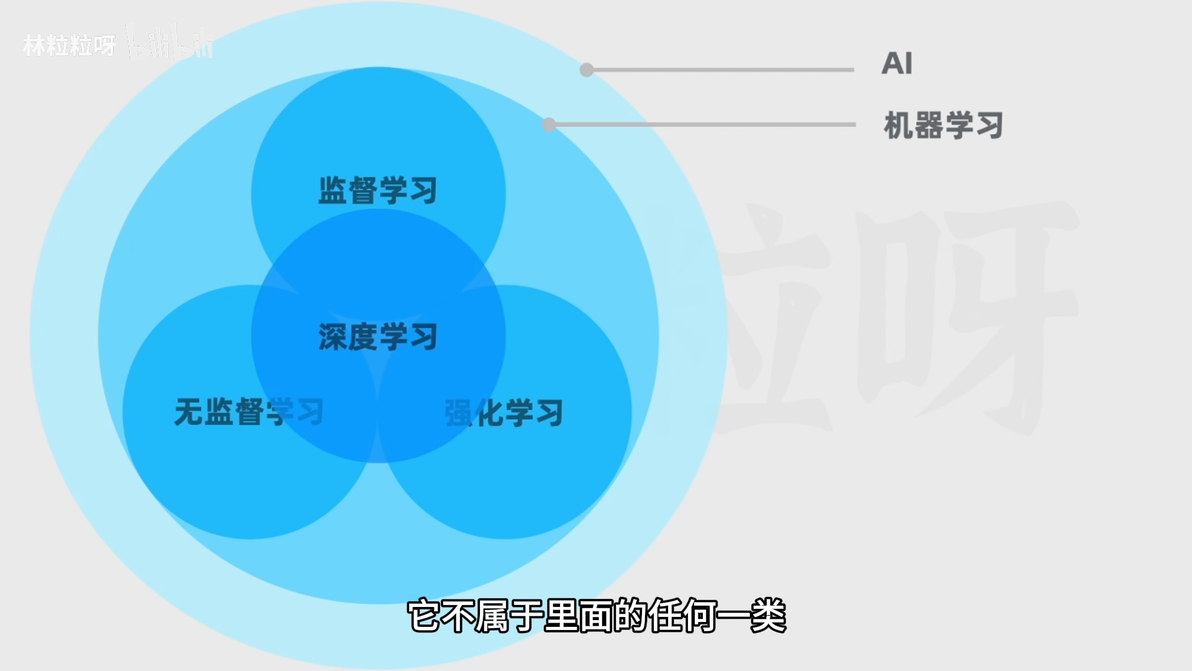
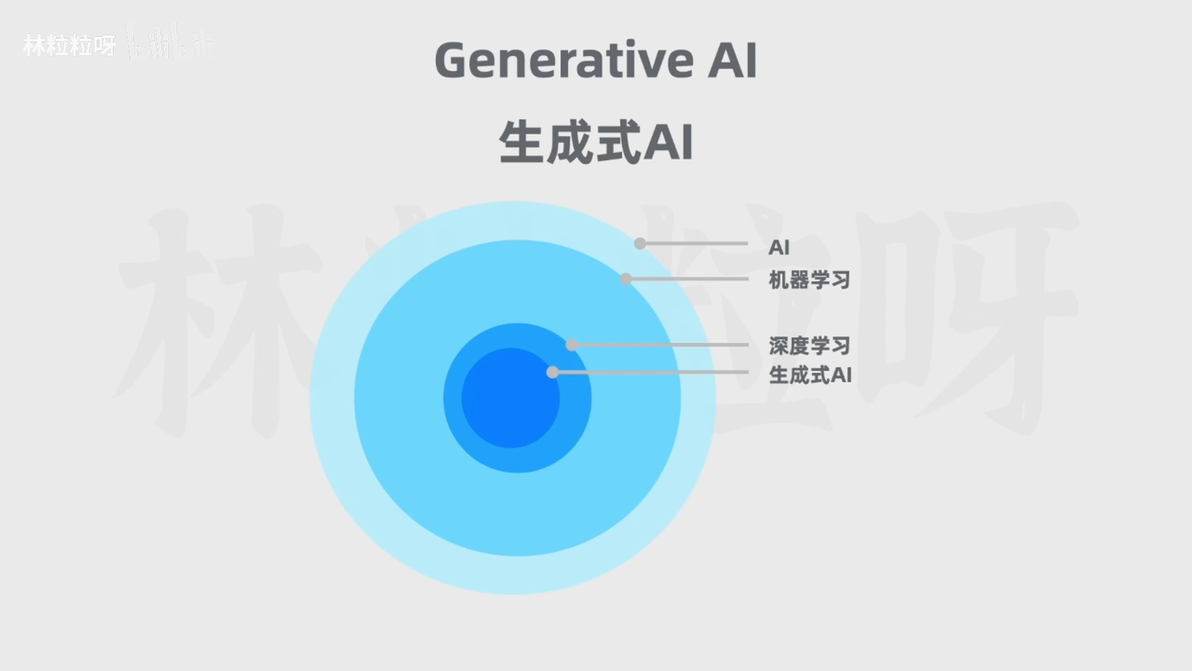
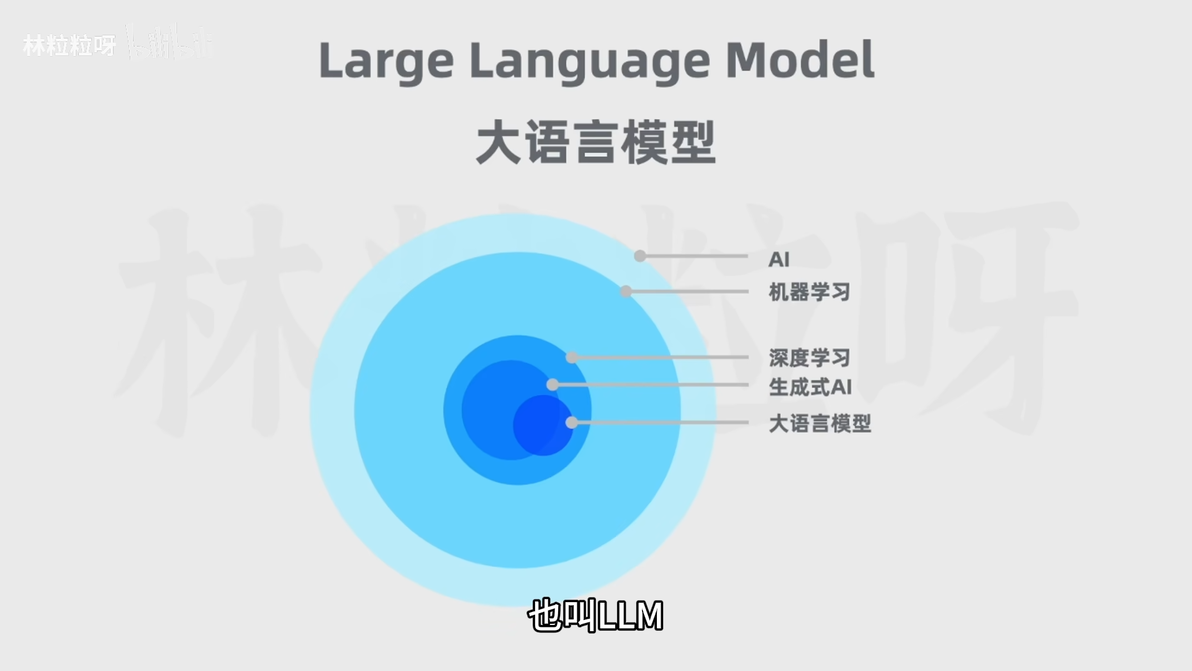
AI:即人工智能,是计算机科学体系下的一个学科,旨在让计算机系统去模拟人类的智能,从而解决问题和完成任务。
机器学习:不需要人类做显式编程,而是让计算机通过算法进行直觉学习和改进,去识别模式、做出预测和决策
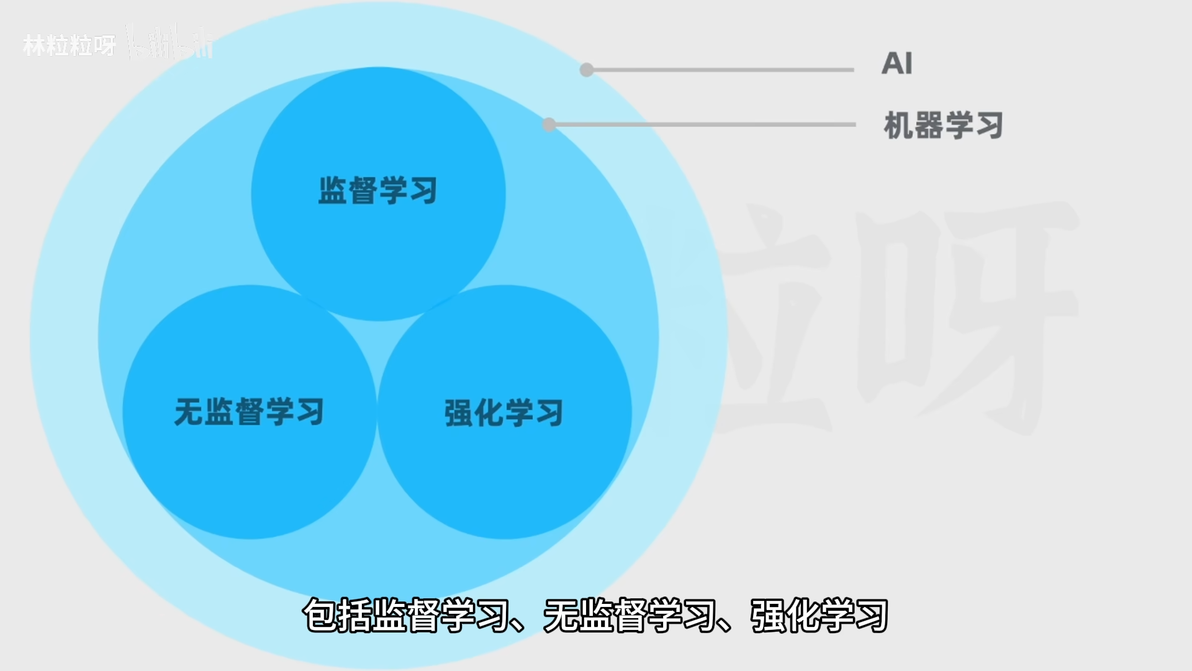
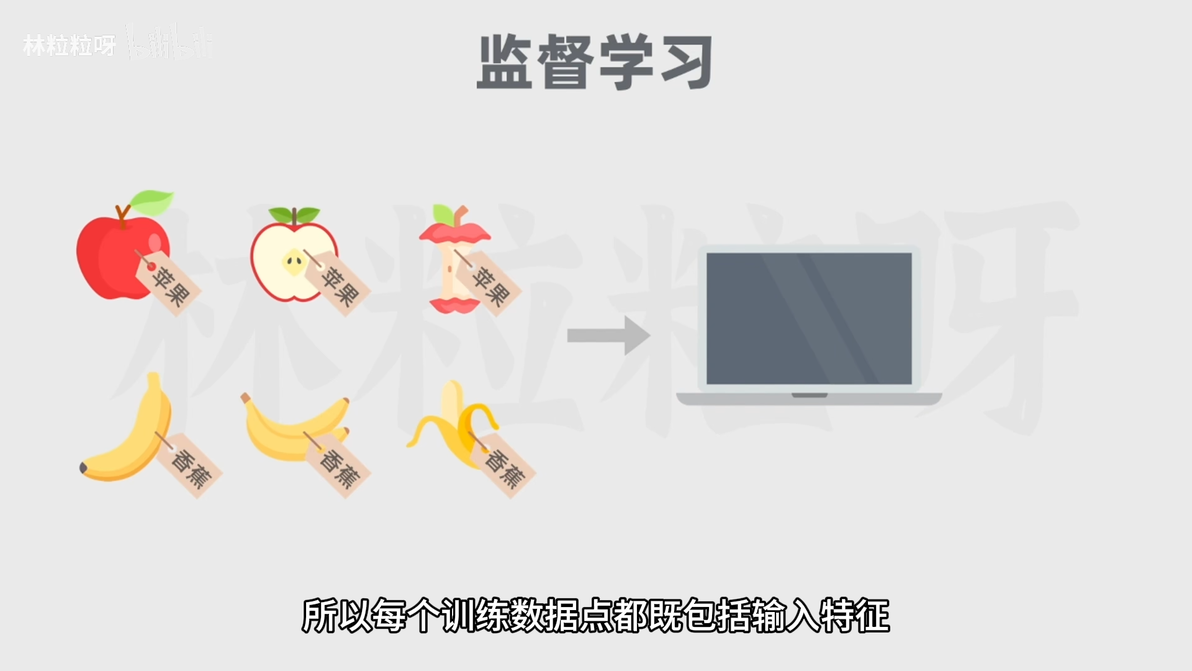
监督学习:机器学习算法会接受有标签的训练数据,标签就是期望的输出值,所以每个训练数据点都既包括输入特征,也包括期望的输出值,算法的目标是学习输入和输出之间的映射关系。从而在给定新的输入特征后,能够准确预测出相应的输出值(经典的监督学习包括分类、回归:对数值进行预测)
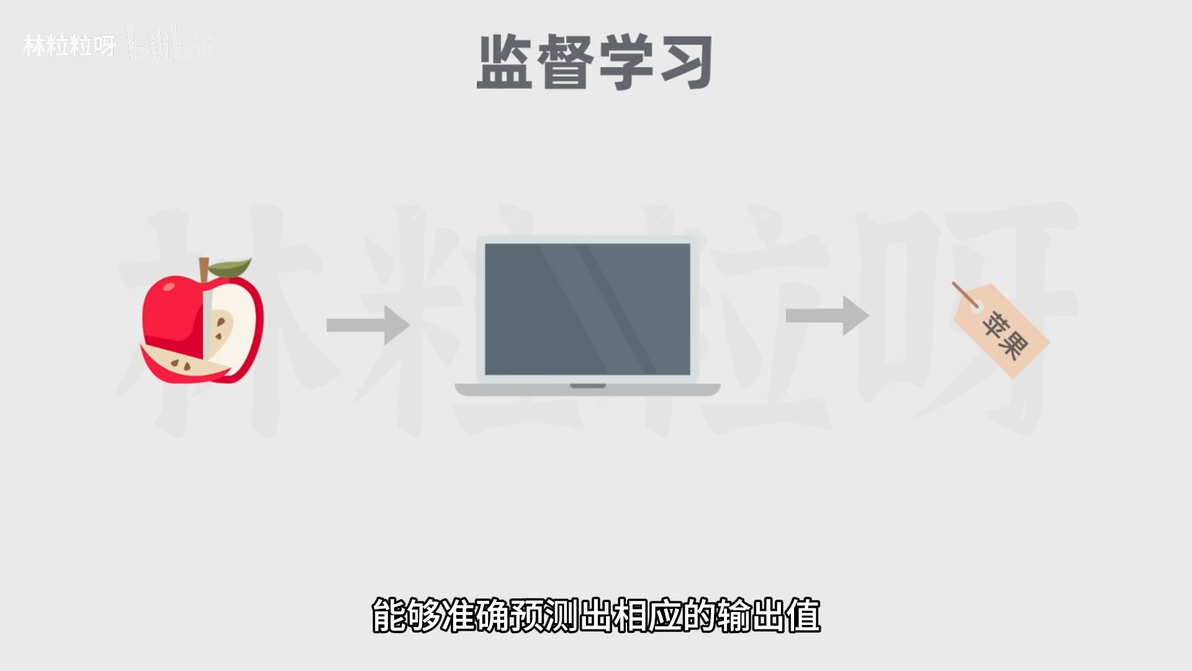
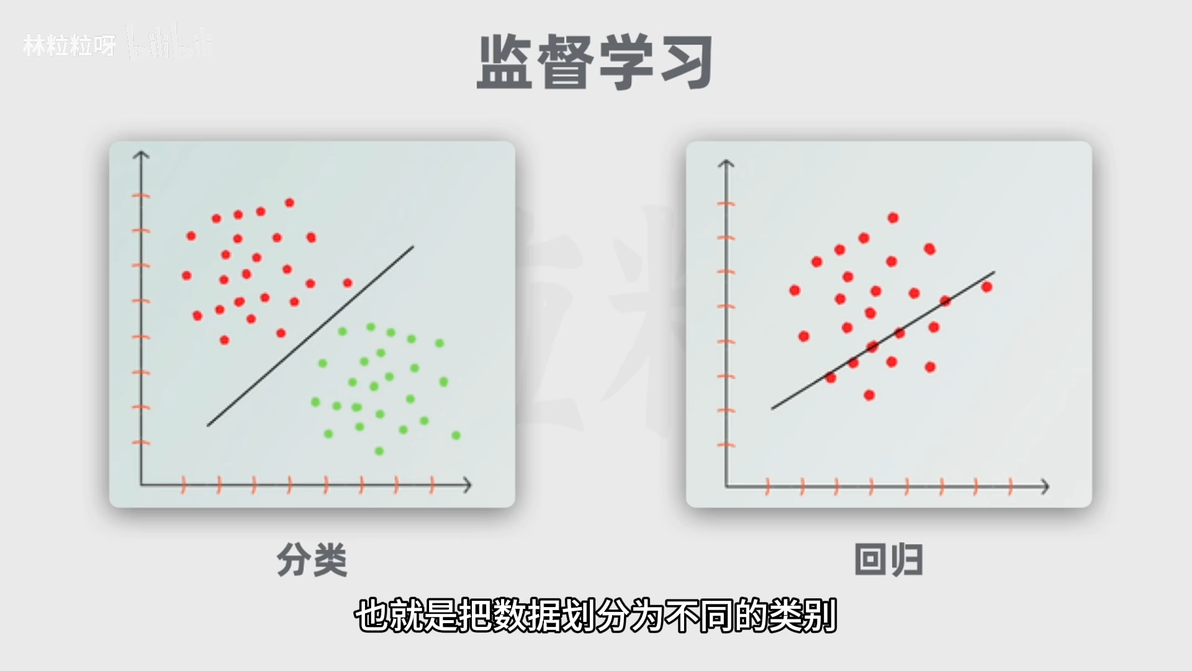
分类:根据原本的训练数据,让计算机判断出一个新的数据是什么
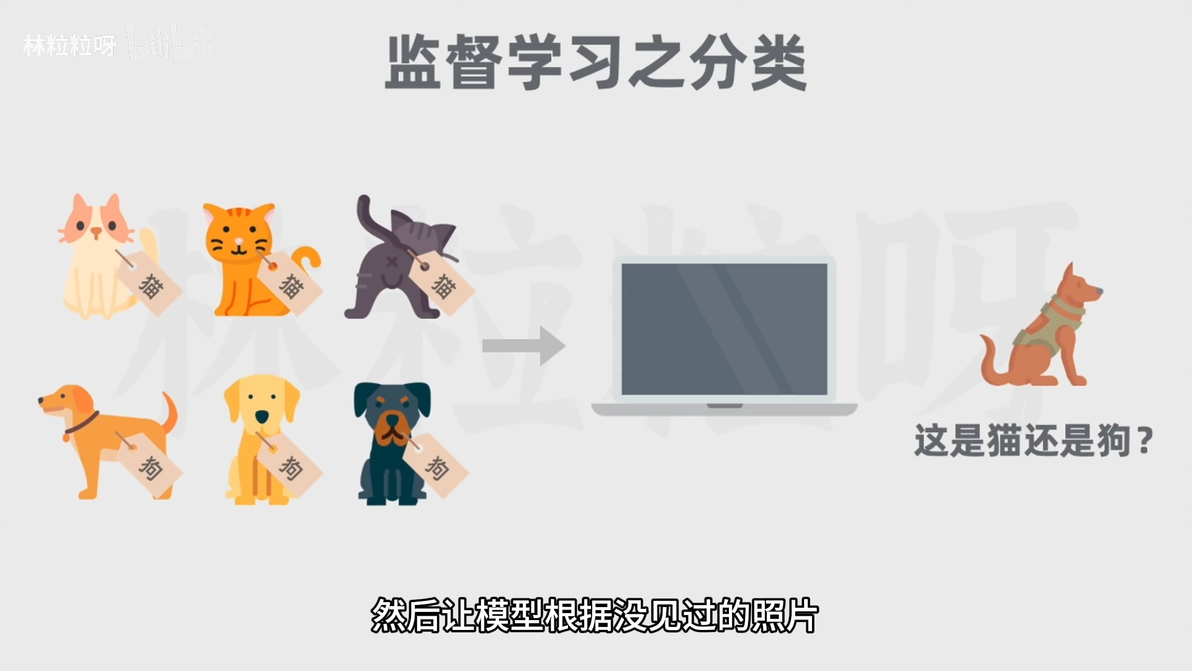
回归:拿一些房子特征的数据,比如面积、卧室数、是否带阳合等
和相应房价作为标签进行训练,然后让模型根据没见过的房子的特征预测房价
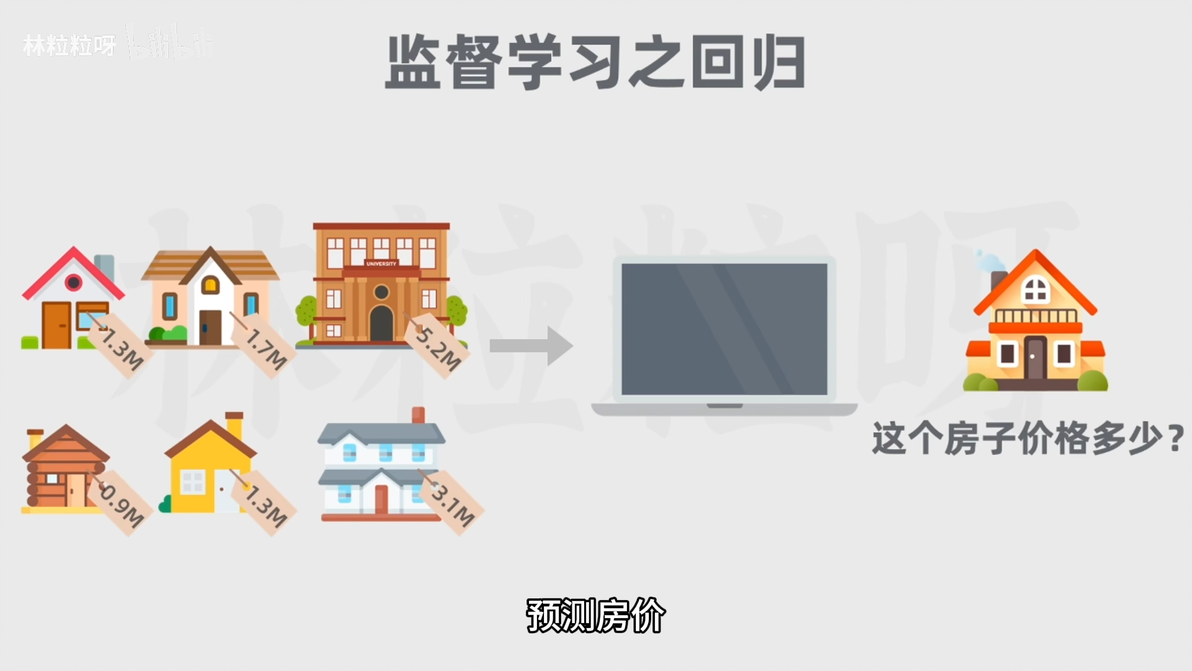
无监督学习:学习的数据是没有标签的,算法的任务是自主的发现数据的规律或模式(聚类:把数据进行分组)
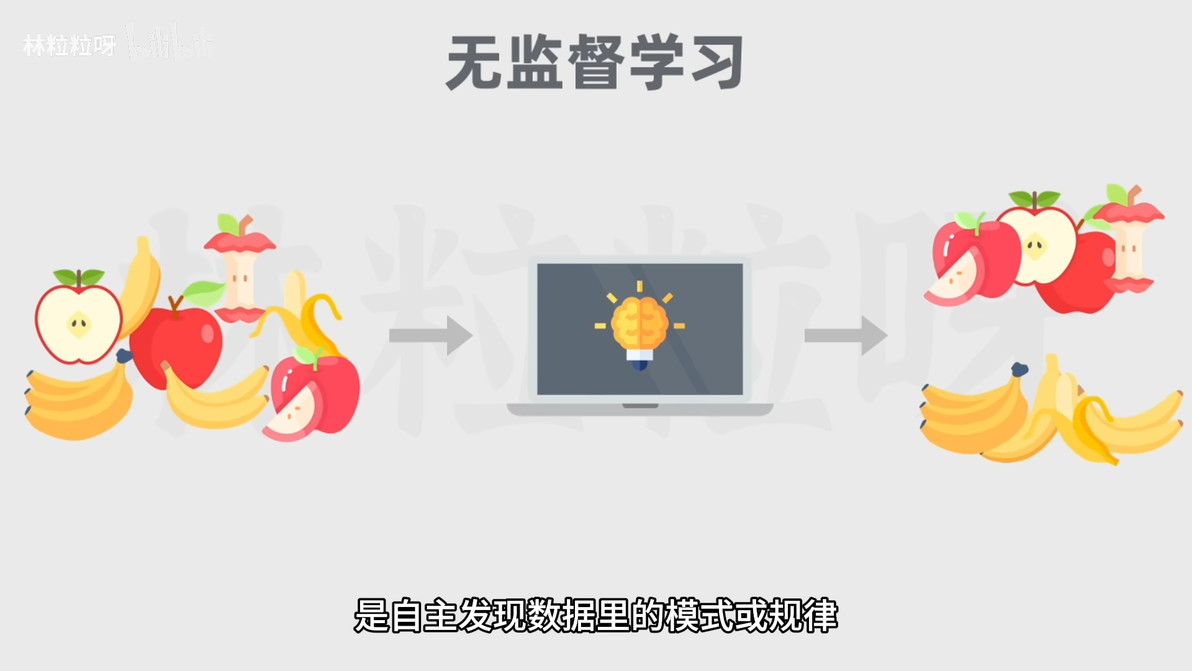
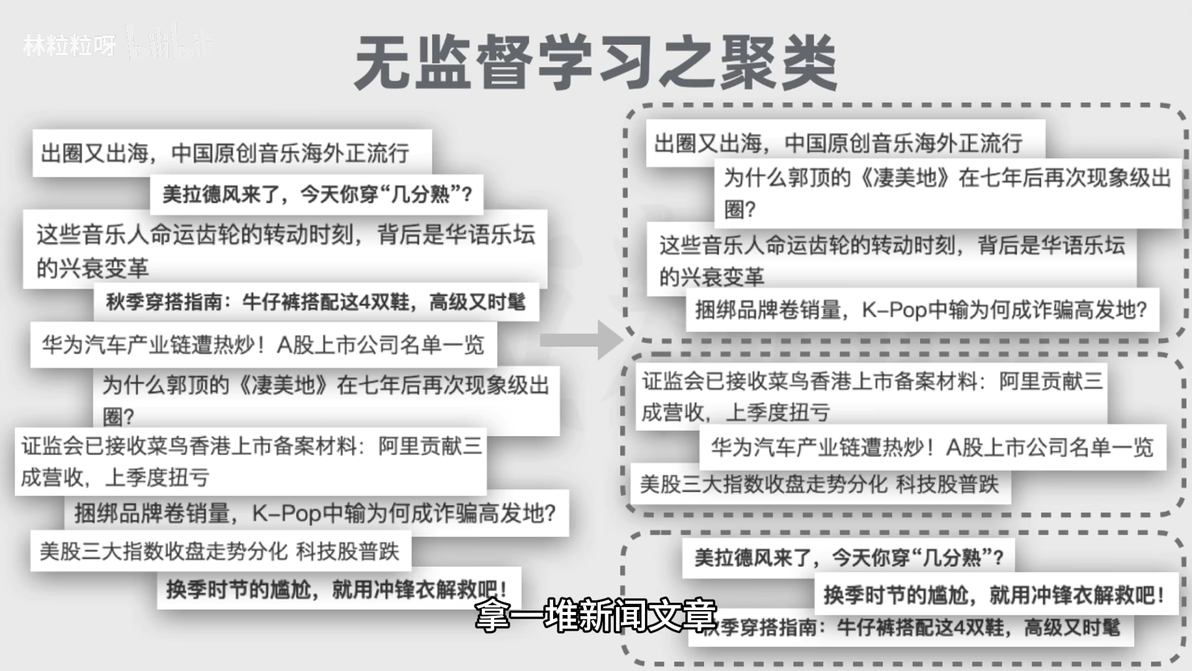
聚类自动把相似的新闻进行组织分类起来
半监督学习:结合了监督学习和无监督学习的技术,使用的是部分标记的训练数据。
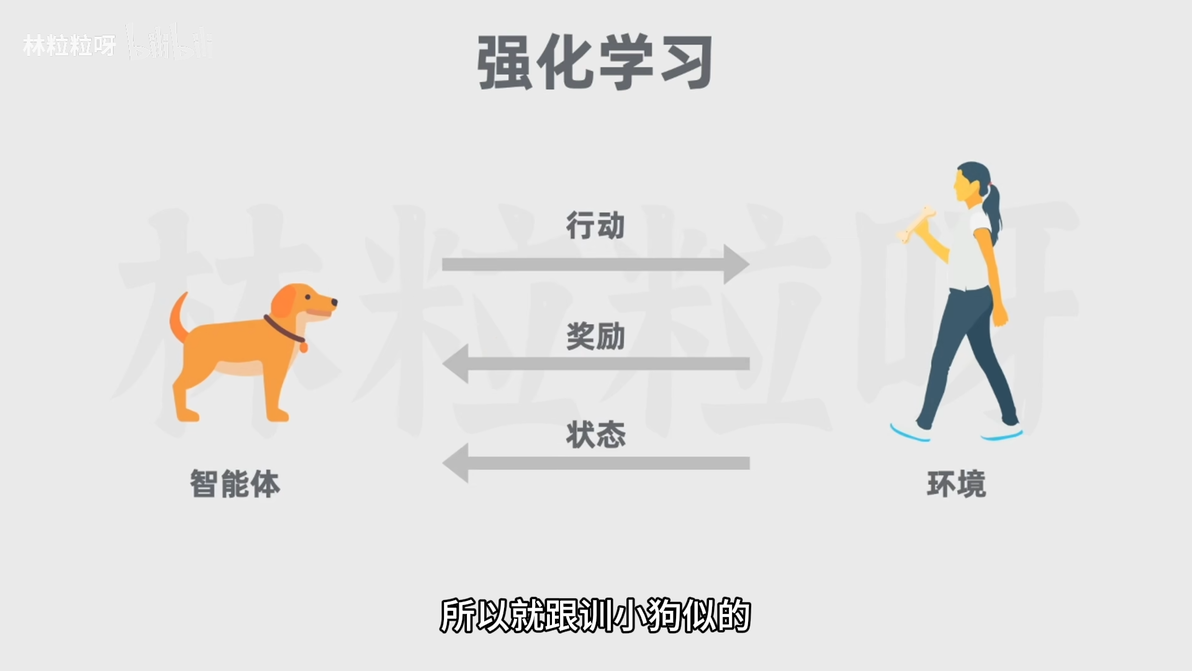
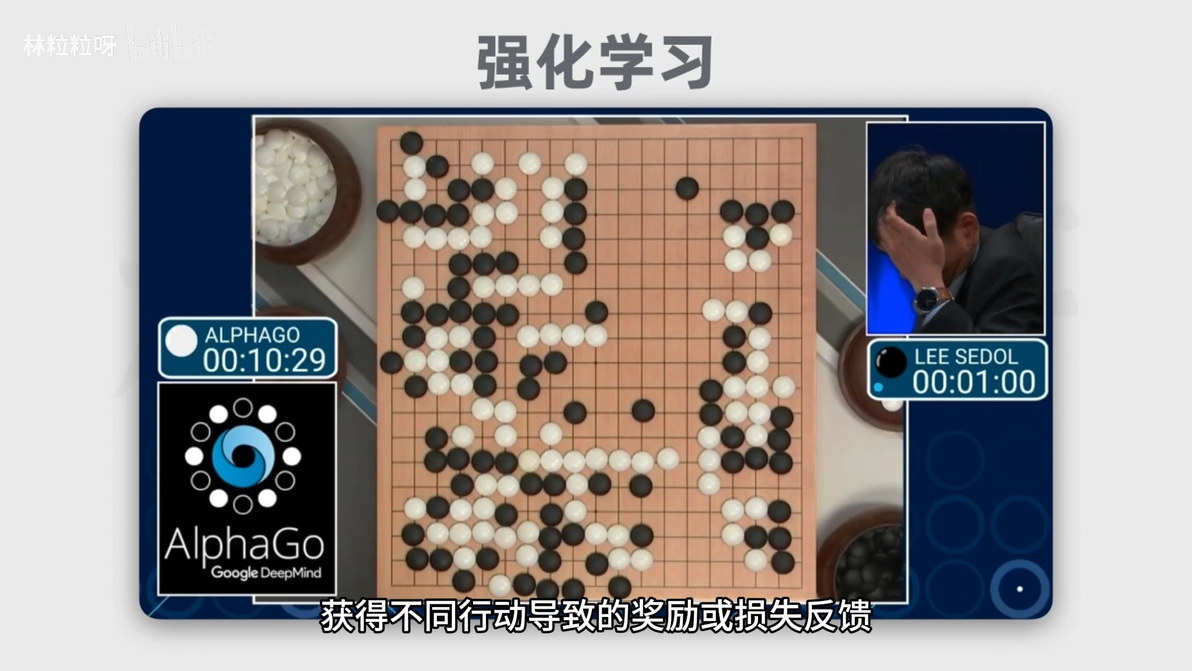
强化学习:让模型在环境里采取行动,获得结果反馈,从反馈里进行学习,从而能在给定情况下采取最佳行动来最大化奖励或是最小化损失(下围棋)
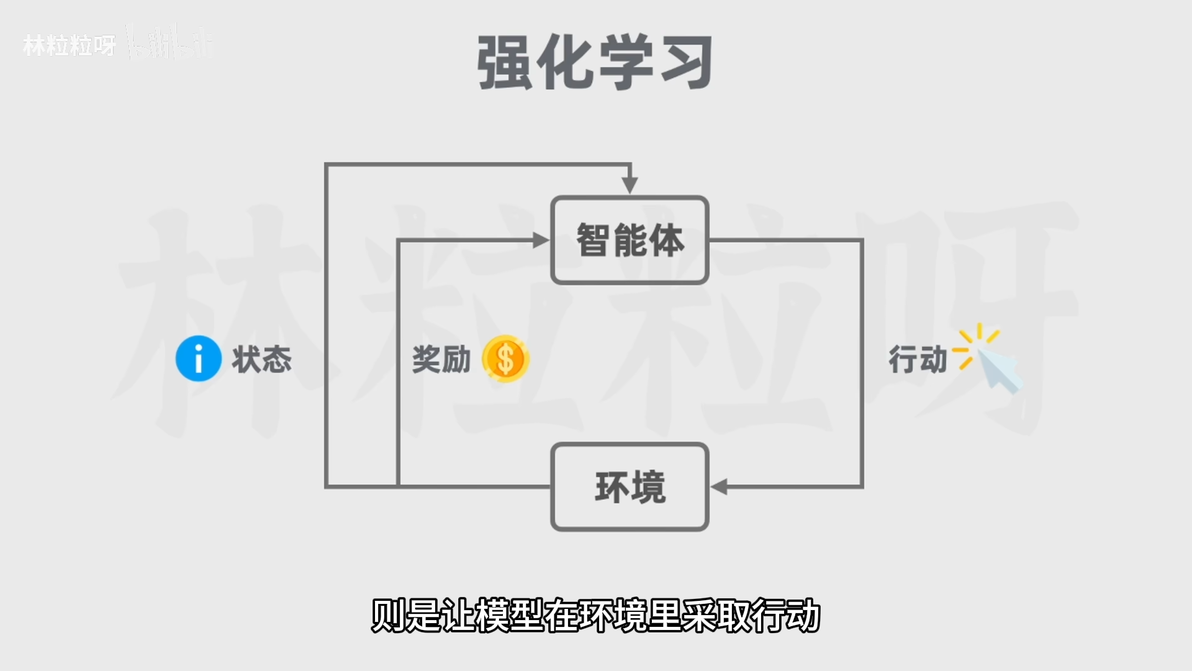
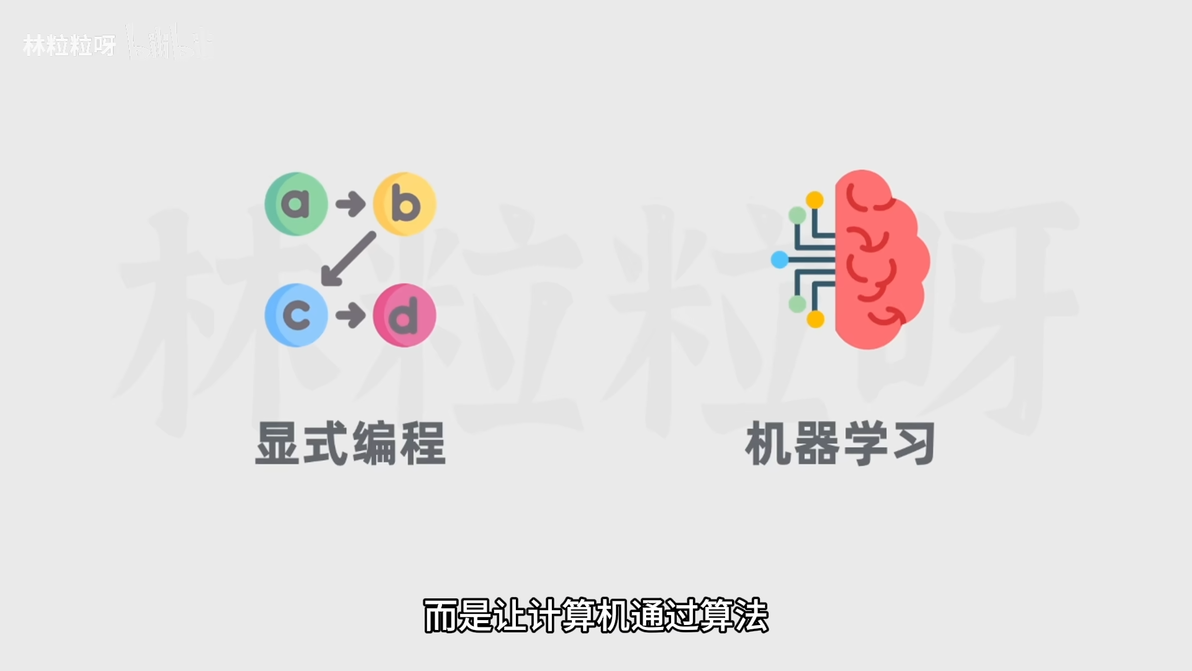
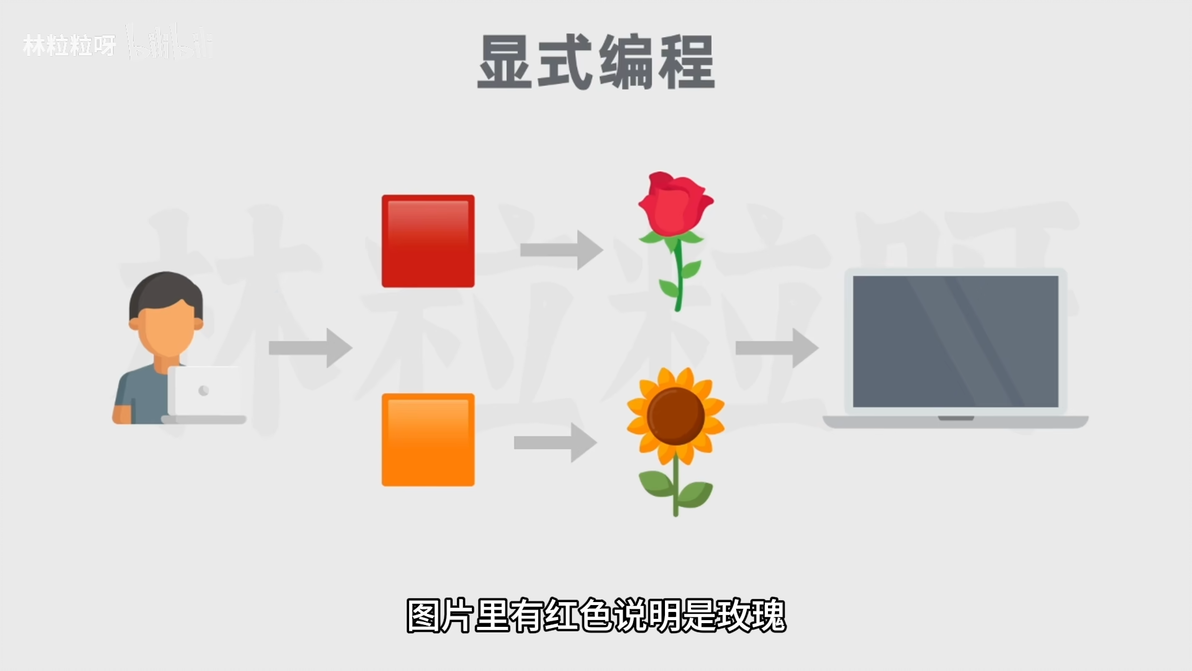
显式编程:
指程序员直接编写明确的指令,以告诉计算机具体的操作步骤来解决问题或执行任务的编程方式。
深度学习
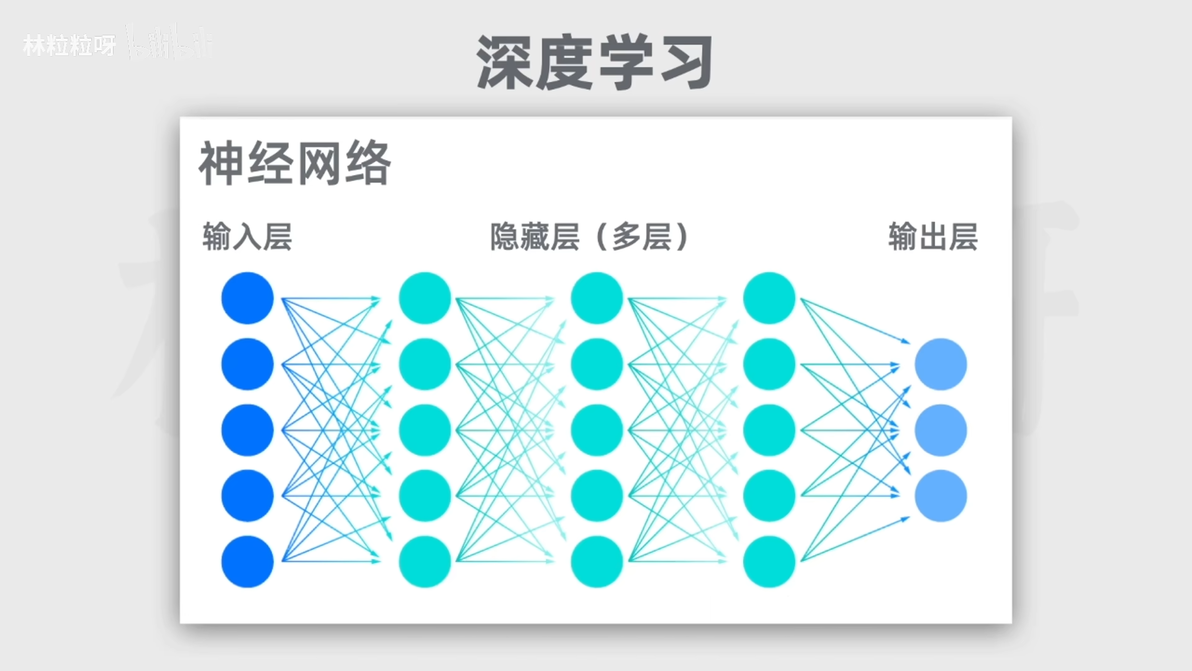
深度学习是机器学习的一个方法,核心在于使用人工神经网络,模仿人脑处理信息的方式。通过层次化的方法提取和表示数据的特征。
神经网络
是由许多基本的计算和储存单元组成,这些单元被称为神经元,这些神经元通过层层连接来处理数据。并且深度学习模型通常有很多层,因此称为“深度”
神经网络可以用于监督学习、无监督学习、强化学习,所以深度学习不属于他们的子集。
生成式AI
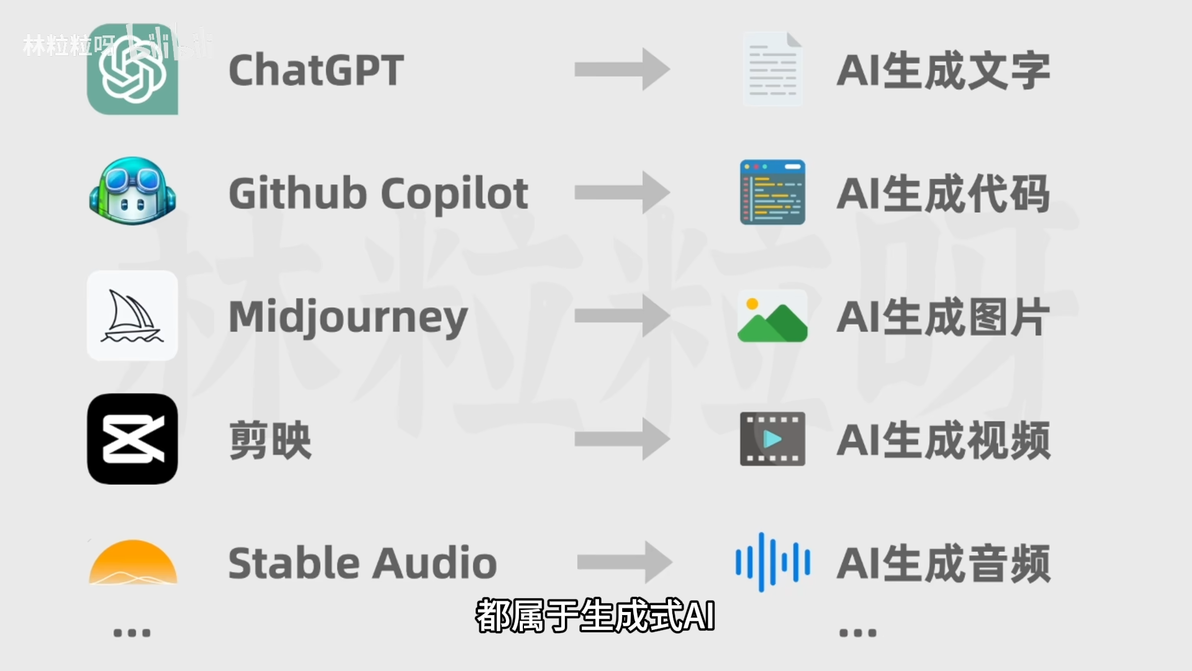
是深度学习的一种应用,它利用神经网络来识别现有内容的模式和结构,学习生成新的内容。内容形式可以是文本、图片、音频等等
大语言模式LLM
也是深度学习的一种应用,专门用于进行自然语言处理任务。
大语言模型里面的“大”字,说明模型的参数量非常大,可能有数十亿甚至到万亿个,而且训练过程中也需要海量文本数据集,所以能更好地理解自然语言,以及生成高质量的文本
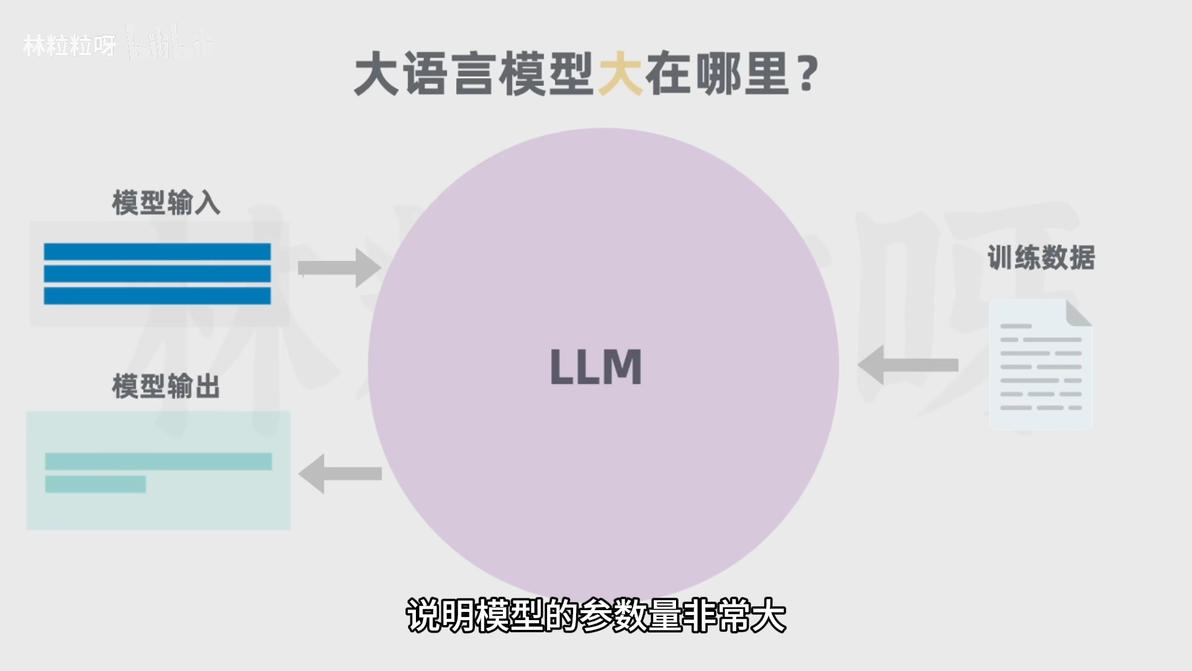
大语言模型的例子有非常多,比如国外的GPT、LLaMA,国内的ERNIE、ChatGLM等可以进行文本的理解和生成。以GPT-3这个模型为例子,它会根据输入提示以及前面生成过的词,通过概率计算逐步生成下一个词或token,来输出文本序列
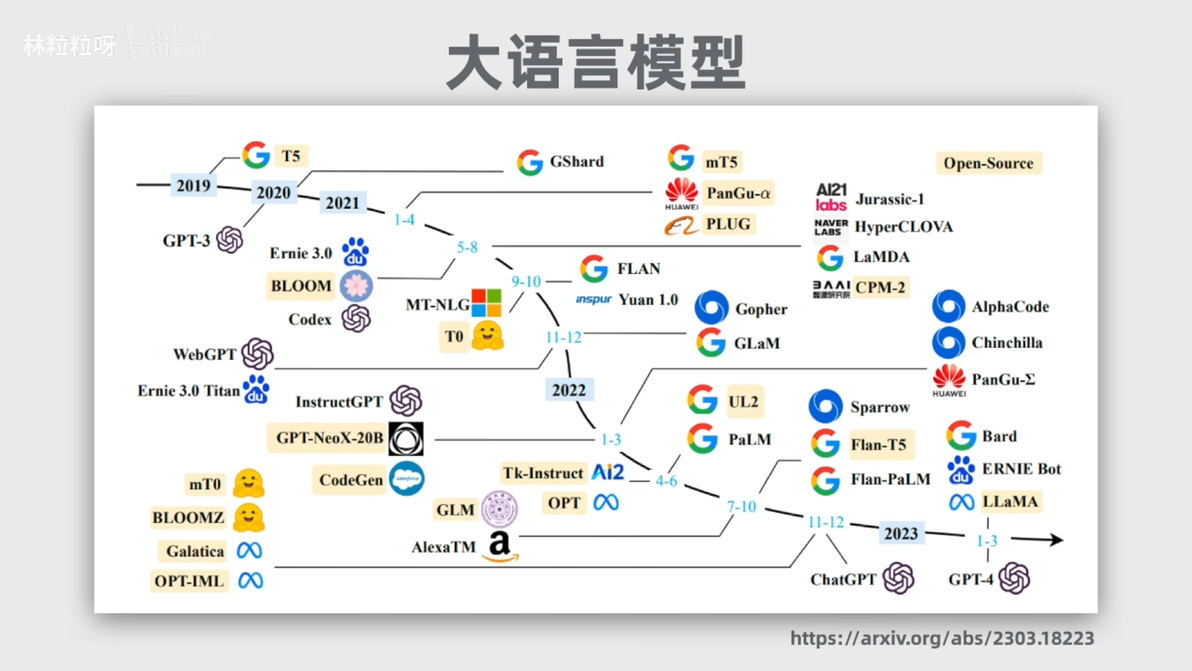
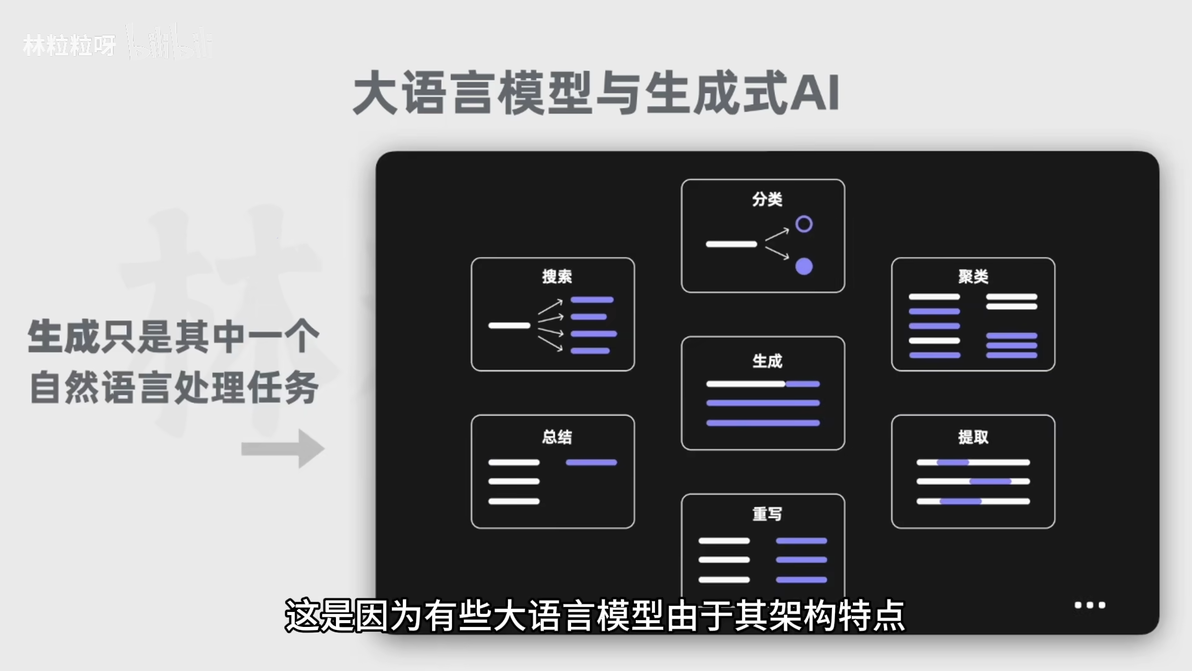
不是所有的生成式AI都是大预言模型,所有的大语言模型是否都是生成式AI,这也存在些许争议。
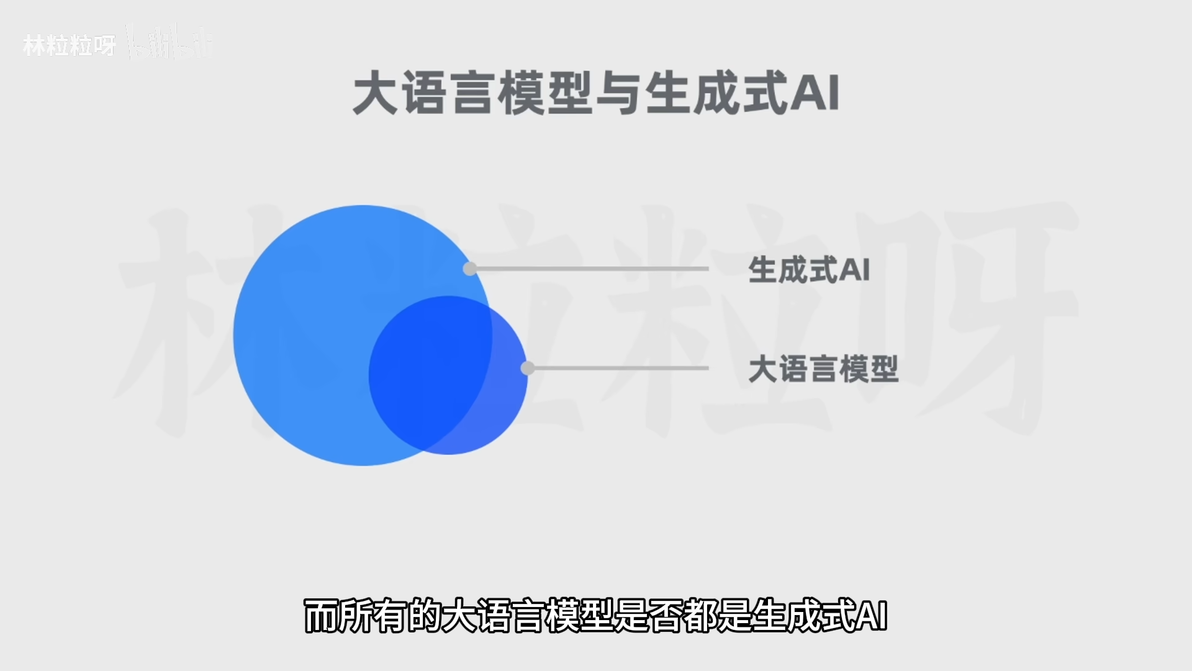
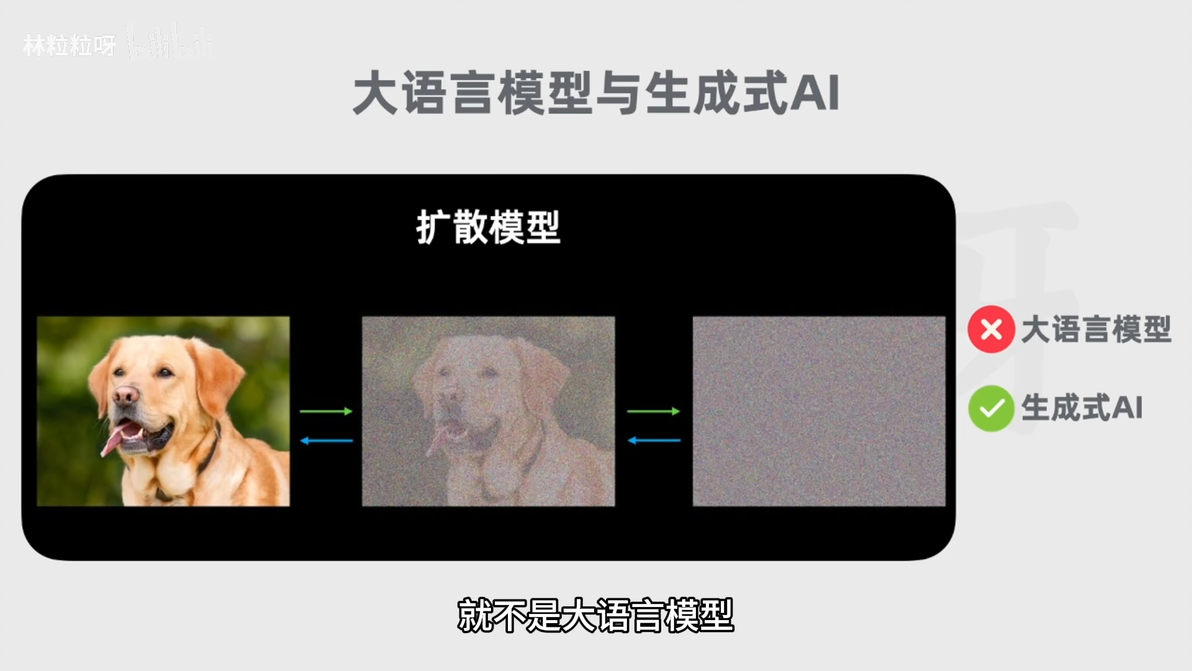
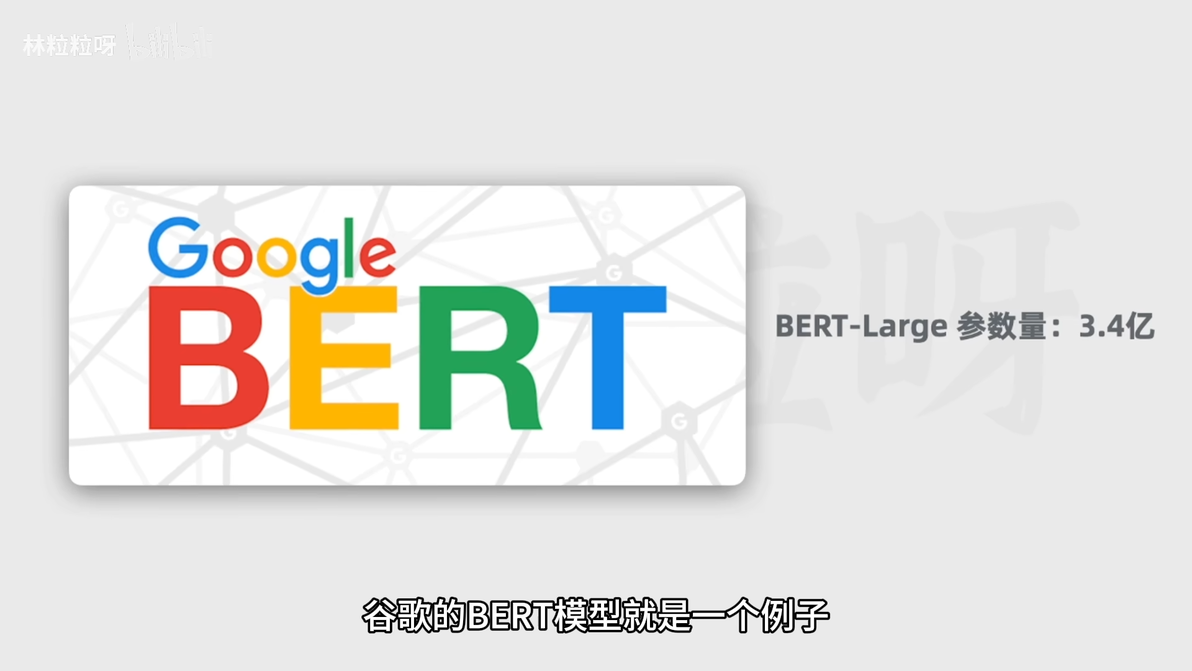
生成图像的模型,并不是大语言模型,因为他并不输出文本。同时有些人认为,不是所有大语言模型都是生成式AI,这是因为有些大语言模型由于其架构特点,不适合进行文本生成,例如谷歌的berd模型,它的参数量和训练数据量很大,属于大语言模型。berd理解上下文的能力较强,因此被谷歌用在搜索上,用来提高搜索排名和信息摘录的准确性,也被用于情感分析、文本分类等任务,但berd不擅长文本生成,特别是连贯的长文本生成,所以有些人认为,此类模型不属于生成式AI的范畴。