


一、背景知识
“网上有很多关于宏基因组的免费知识分享和教程。”
“但大部分都是为了流量和卖课,质量低,难重复。”
“我想要快速掌握这些知识并用于分析自己的数据该怎么办呢?”
“多学习类似半只西瓜的高质量课程并亲自上手训练就可以了。”
宏基因组数据(二代)大部分为长度较短、碎片化的短读长(150 bp-250 bp 的reads),与环境中真正的细菌基因组(上千上万bp)有明显差异,我们数据分析的主要思路就是在尽量不丢弃数据的前提下还原出尽可能完整的基因组,得到最接近真实情况的基因和物种信息。在测序深度足够的情况下(活性污泥大于等于8 Gb),使用原始reads能近乎包含所有的基因信息,却无法还原出完整的细菌基因组;在经过组装分箱后可以还原出近乎完整的基因组却又会丢失掉大量基因信息,这也是现在二代分析技术最大的矛盾。当然,不断有优秀的学者开发新的软件,设计新的算法,通过算法上的优化来克服这一问题,下面也会介绍部分软件的使用。
有同学可能会问,我听说三代测序一次能测很长(数千bp),这不是就可以解决上述的问题了吗?不就能避免拼接组装过程中的数据损失了嘛?
我们看看chatgpt是怎么回答的:
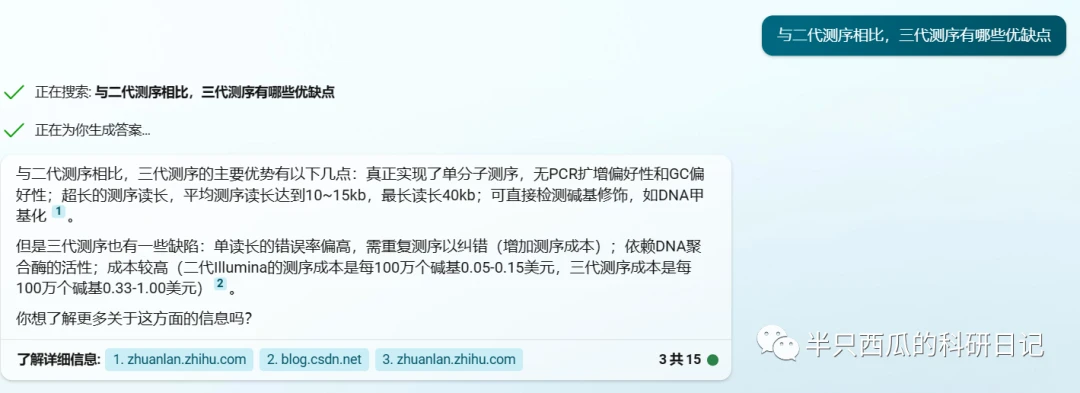
询问了一下,确实三代是要贵出很多,并且现在三代测一个样需要10 ug左右的DNA总量,对于珍贵样品来说还是有点吃紧的(二代可能只需要几百ng)
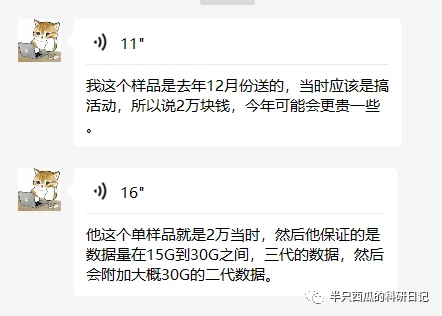
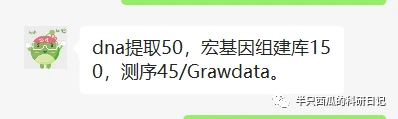
话虽这么说,我还是觉得三代未来可期,毕竟经济是推动科技发展的第一动力
二、数据准备
检测文件校验:
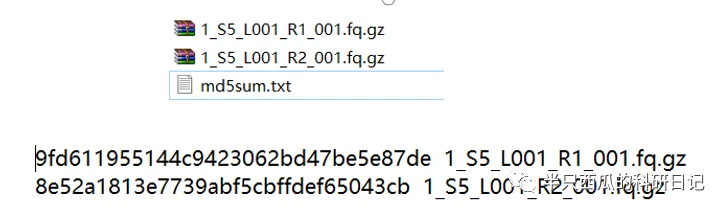
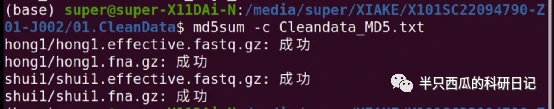
修改文件名并解压:(不会批量修改文件名的可以留言)
使用sratoolkit根据SRR号下载数据:
下载单个数据:
prefetch SRR***
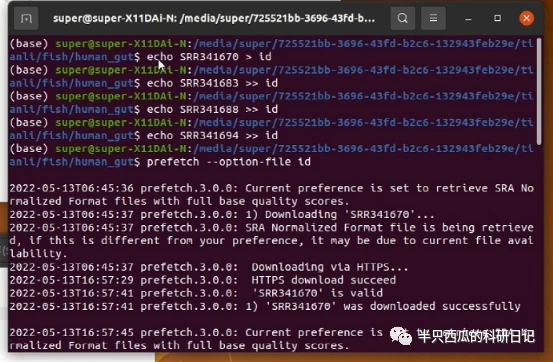
批量下载:
prefetch --option-file SRR_ID_list
下载后的.sra格式的文件需要转化成fq文件:
单端:
fastq-dump SRR***.sra
双端:
fastq-dump --split-3 SRR***.sra
三、质量控制(quality control)
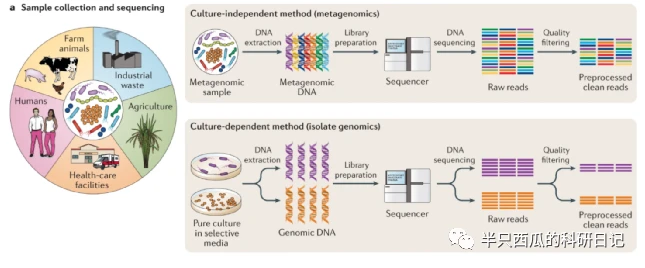
宏基因组数据过滤和质控包括两方面:一方面,与转录组、基因组测序等分析相似的数据质量控制过程,包括质量评估,去除低质量、引物和接头序列;另一方面,涉及到宿主相关微生物的宏基因组样本易受宿主序列的污染,需要去除宿主序列并评估宿主比例。常用软件:fastp、kneaddata、fastqc、trimmomatic和bowtie2等软件。
简单介绍一下fastp的使用:
https://github.com/OpenGene/fastp
批量处理:


先提前把以.clean.fq.gz的文件名储存在sample中,再使用循环即可。其中{sample//?.clean.fq.gz}意思是:把sample中储存的名字中的?.clean.fq.gz替换为空,问号?代表任意一个非空格字符。
小写-i和-o即对应-1端文件,大写-I和-O对应-2端文件
四、拼接组装(assembly)
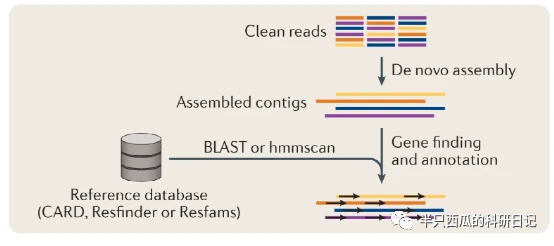
spades手册:
https://cab.spbu.ru/files/release3.15.3/manual.html
重要经验:在进行多样品混合拼接时使用spades容易出错(比如10个宏基因组reads cat在一起,使用两个超大双端数据的情况),尤其在Ubuntu 16以后的高级系统,因为会在调用系统算力上出现问题,导致报错内存不够。此时应使用megahit,分配尽可能多的运存(--m,memory ),适量的CPU(--t,threads)去运行!
双端meta数据:

输出结果中Scaffold可理解为顺序已知的contig排列组成:
有几种常用的方法可以评估contig的质量。例如,我们可以计算N50值,它表示所有contigs按长度从大到小排序后,长度累加到总长一半时的contig长度。N50值越大,说明拼接出的contigs越长,质量可能越好。除了N50值,还有一些其他常用的评估指标可以用来评估拼接结果的质量。例如:
L50:表示按contig长度从大到小排序后,长度累加到总长一半时的contig数量。
N90/L90:与N50/L50类似,只不过是长度累加到总长90%时的contig长度/数量。
Contig数量:表示拼接出的contig总数。通常来说,contig数量越少,说明拼接结果越好。
最长/最短Contig长度:表示拼接出的最长/最短contig的长度。
quast手册:
http://quast.sourceforge.net/docs/manual.html
最基础使用:
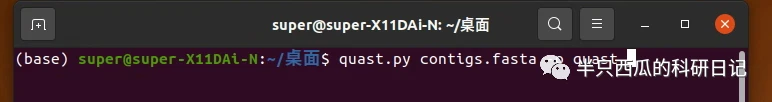
注意!若使用python3作为解释器,quast v5.02会报错,需要找到安装目录下的
quast_libs/site_packages/jsontemplate/jsontemplate.py
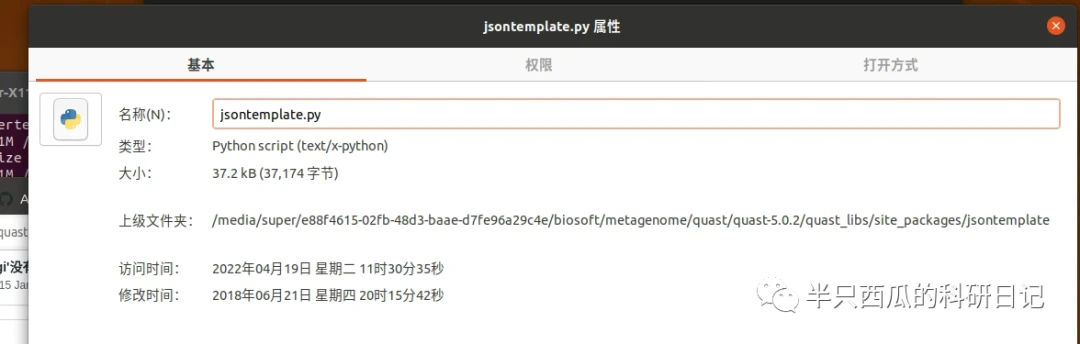
并且把所有的import cgi替换为import html,cgi.escape替换为html.escape
结果展示:
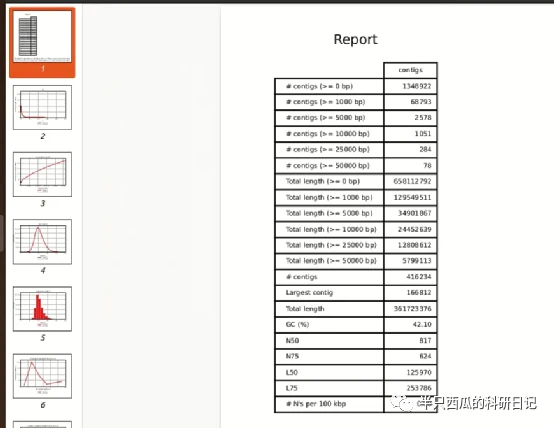
最后使用BBMAP筛选最小contigs长度
reformat.sh in=contigs.fasta out=filtered.fasta minlength=2000
五、分箱(binning)
分箱的优秀软件很多,这里推荐metawrap,因为流程全面,操作简单,适合新手:
(按照官网教程进行质控-拼接-分箱-重组装等分析)
https://github.com/bxlab/metaWRAP
#激活conda环境
conda activate metawrap
#查看帮助
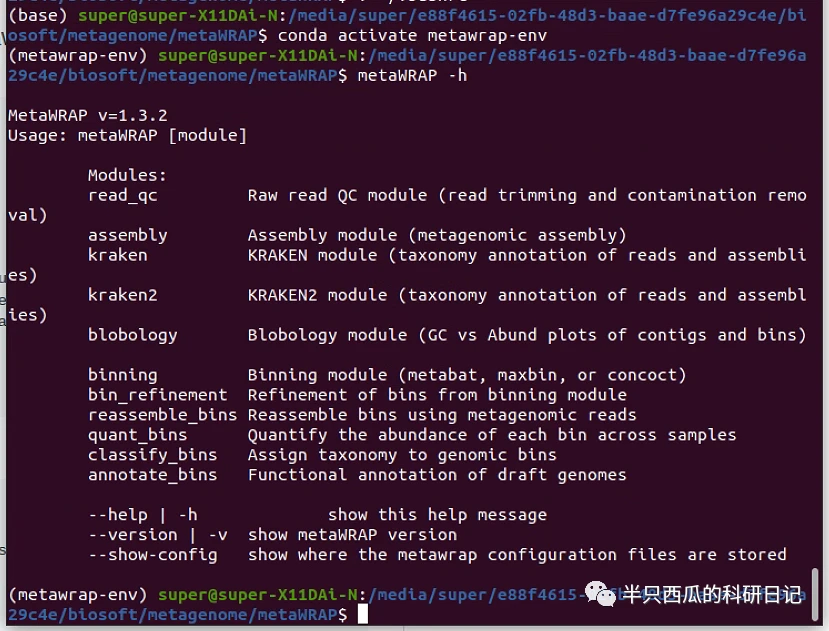
#raw_reads进行质控和去除人类宿主,注意rawreads要以.fastq结尾而不是.fq
(对于环境样本,可以跳过去除宿主的步骤)
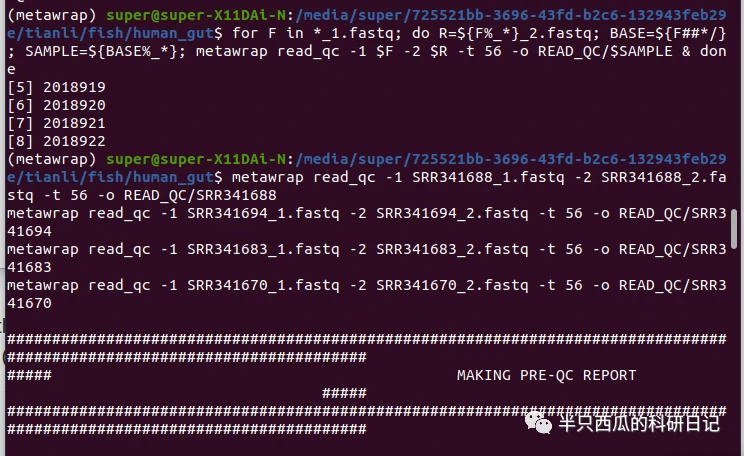
批量运行四个样品,脚本会自动运行:
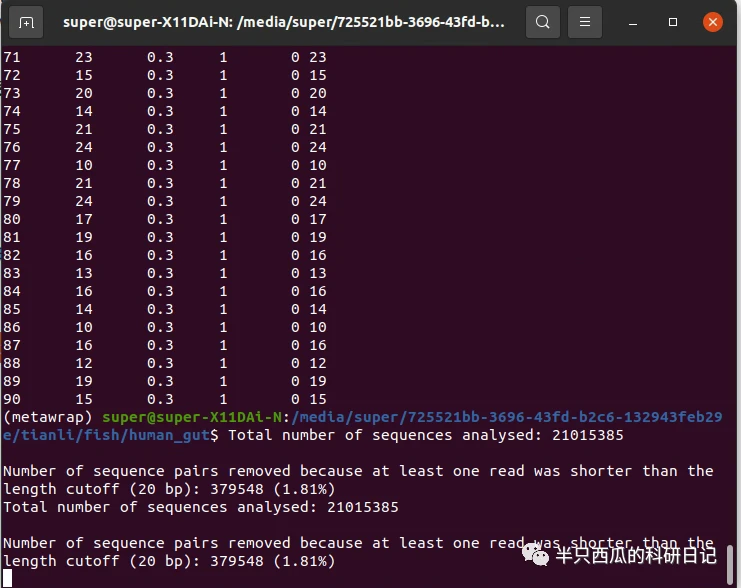
运行结束后似乎不会有特殊提示,直接输入下一步命令即可:
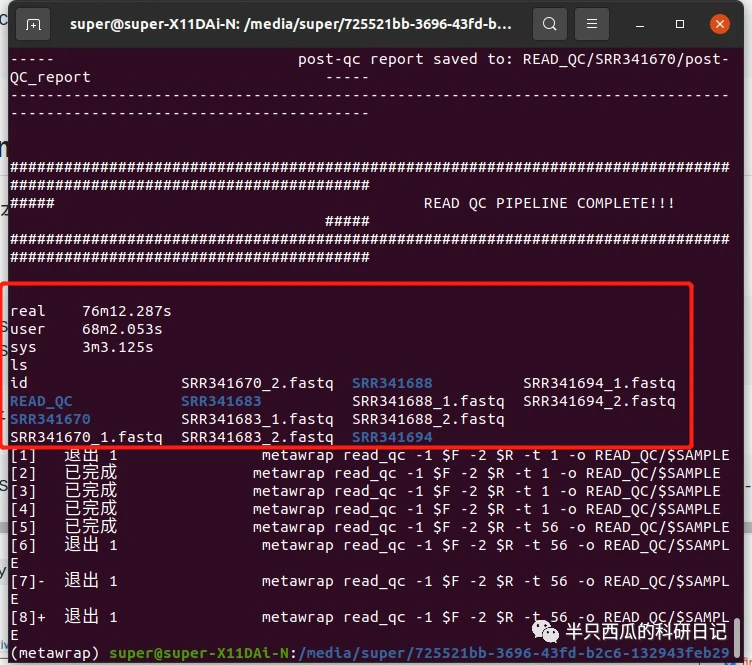
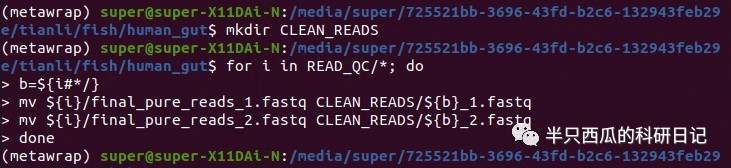
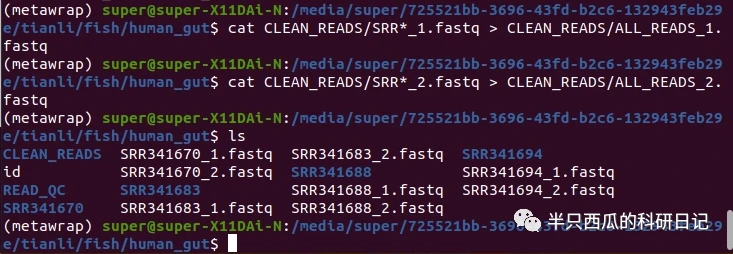
将过滤后的所有样品的双端数据final_pure_reads_1/2.fastq分别合并为ALL_READS_1/2.fastq
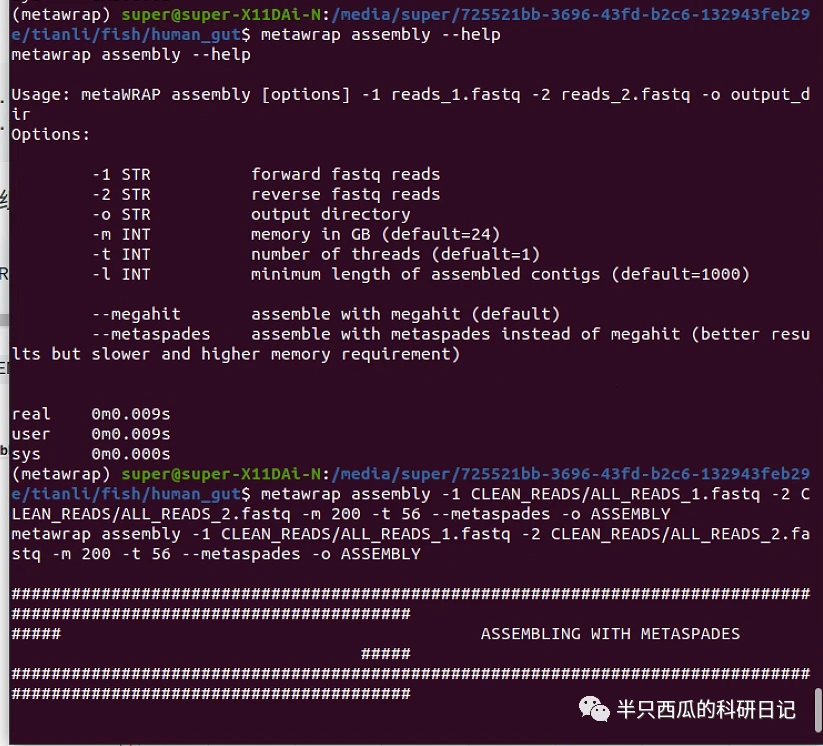
使用metaspades进行组装(-h查看参数,github上的不对,默认截取长度大于1000bp的contig):
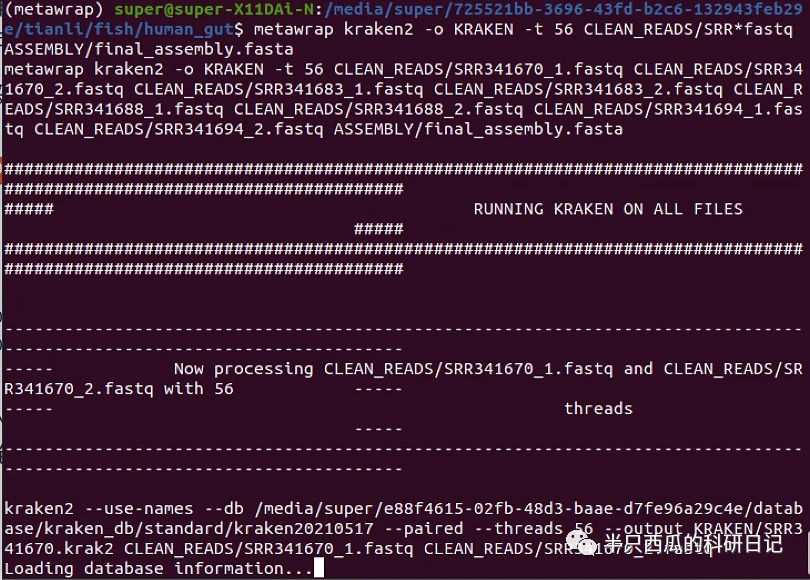
使用kraken2模块计算物种丰度(可选):
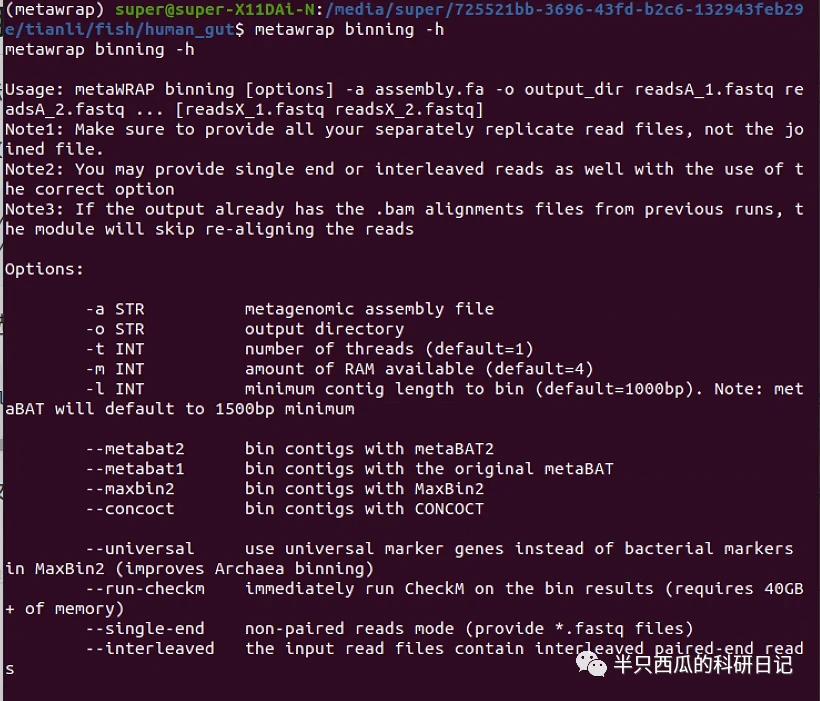
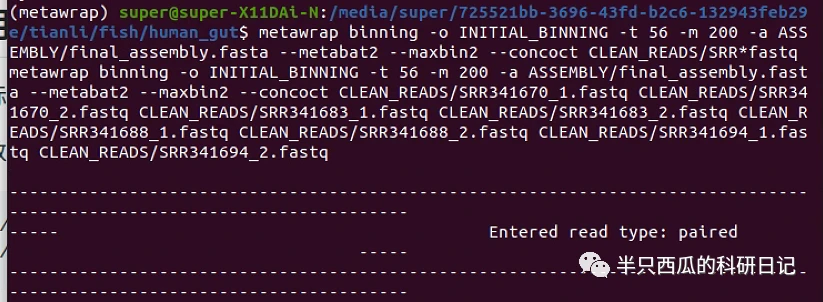
使用bin模块进行分箱(checkM放在下一步):
查看分箱结果,包含三种软件bin的结果和汇总文件夹:
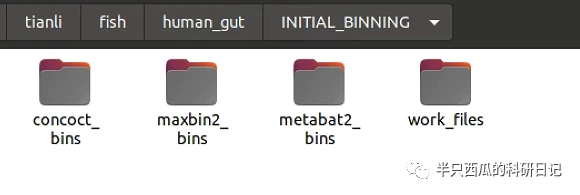
再使用bin-refinement模块优化bin质量:
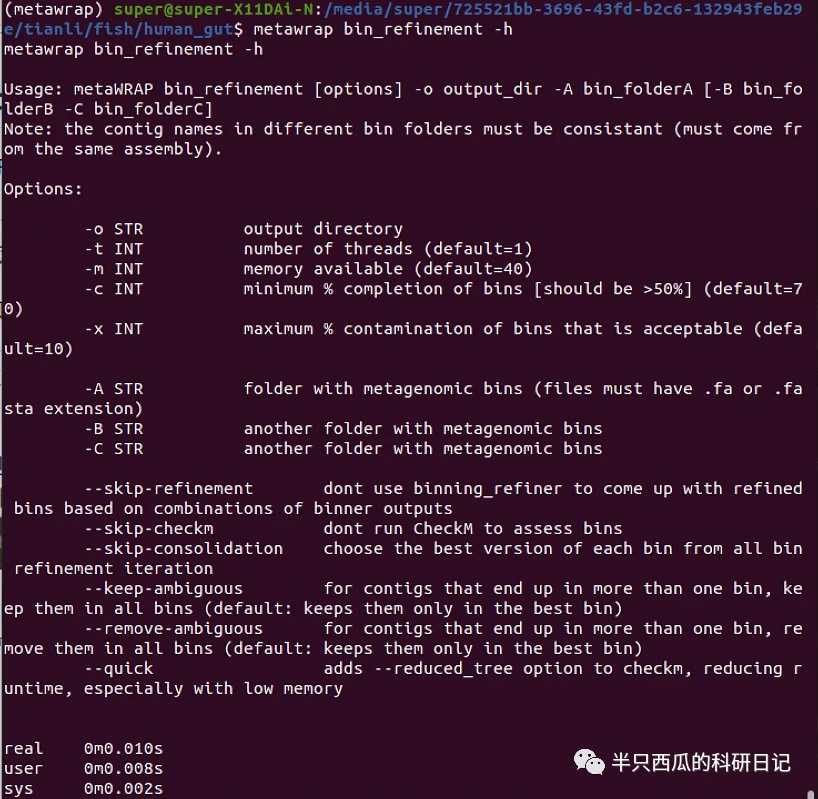
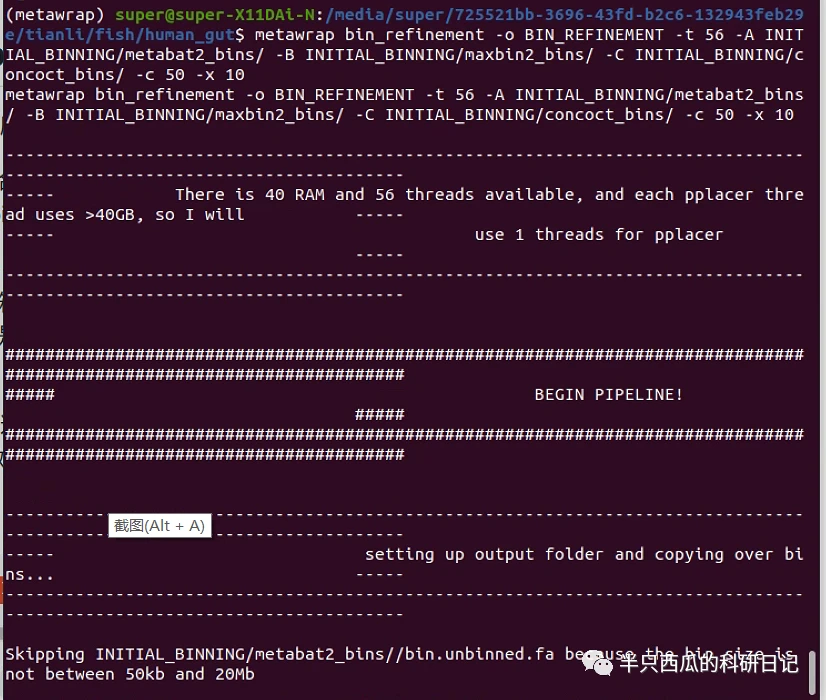
使用-c设置最小完整性,-x设置最大污染度,为了满足完整性-5*污染度≥50%,输出中A为metabat2结果,B为maxbin2,C为concot。如果使用自定义的大于三种的bin结果(比如ABCDE),可先使用前三种进行refinement,再使用后三种refinement,最后两者再一起进行refinement。
查看结果文件(metawrap_50_10即完整性大于50%污染小于10%的最终结果),.stats文件展示了一些基本信息:
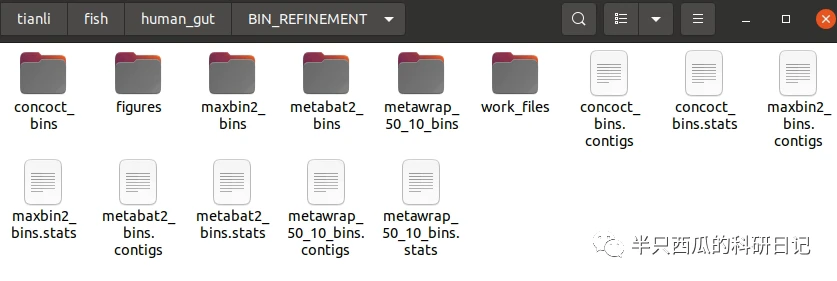
查看得知产生了92个符合要求的bins:

使用biobology模块进行GC含量可视化和注释(需要R!需要设置NCBI_nt数据库!):
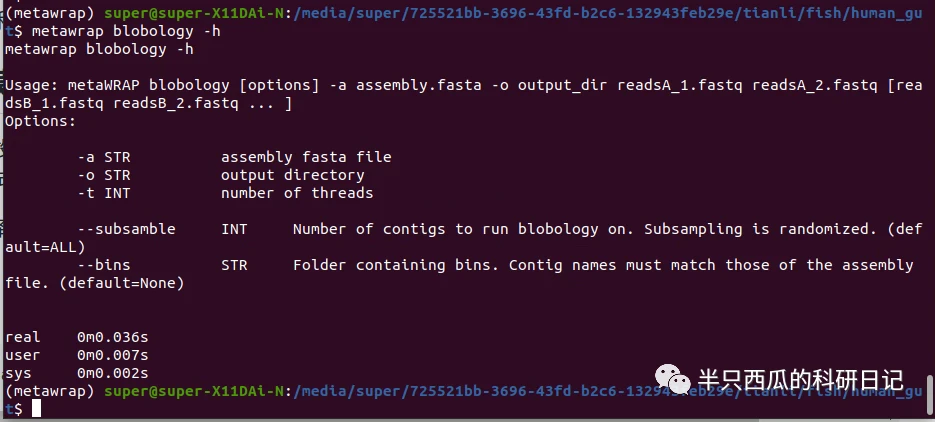
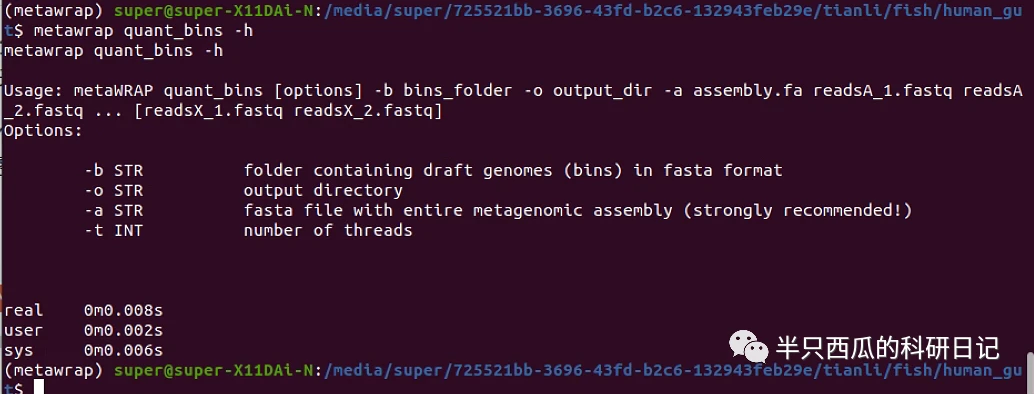
使用quant模块计算每个bin的相对丰度:
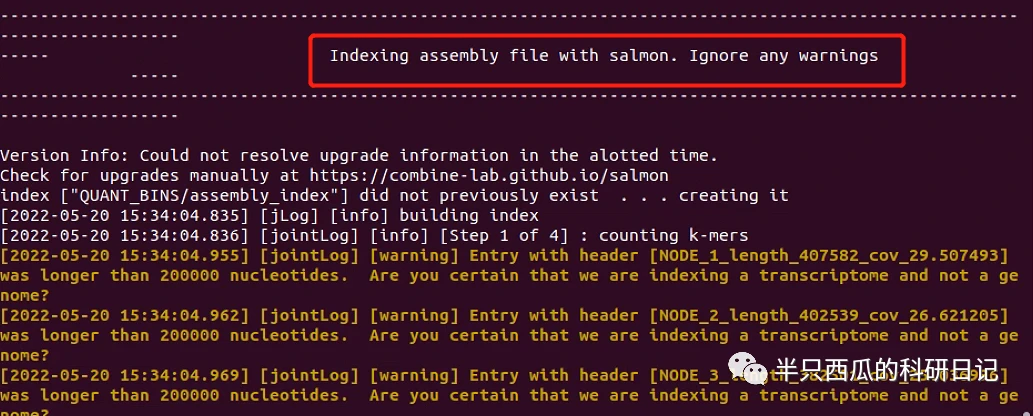
忽略黄色部分salmon的提示
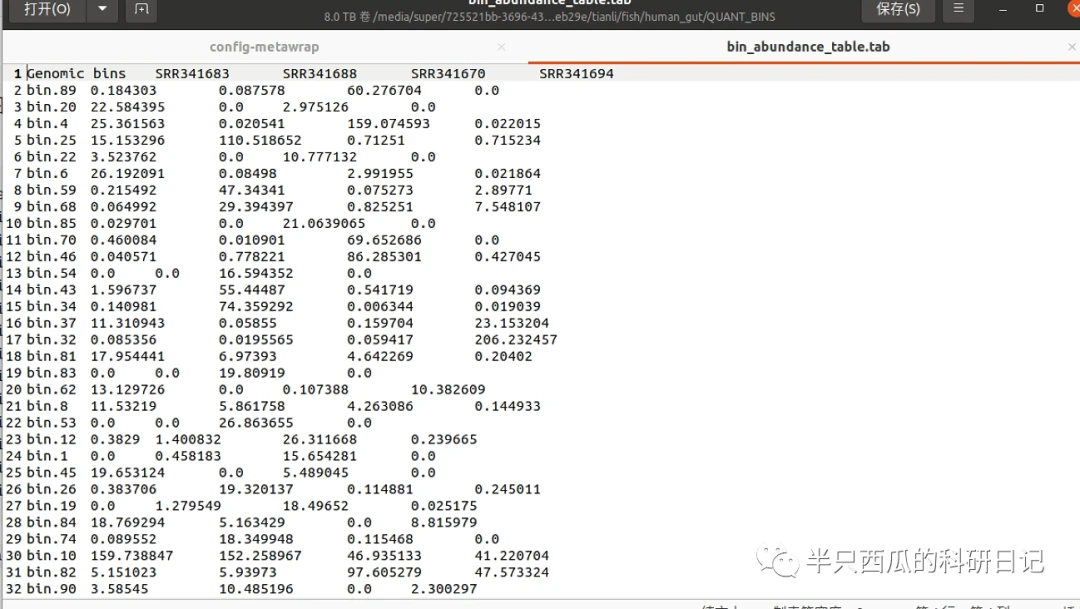
bins丰度单位为TPM
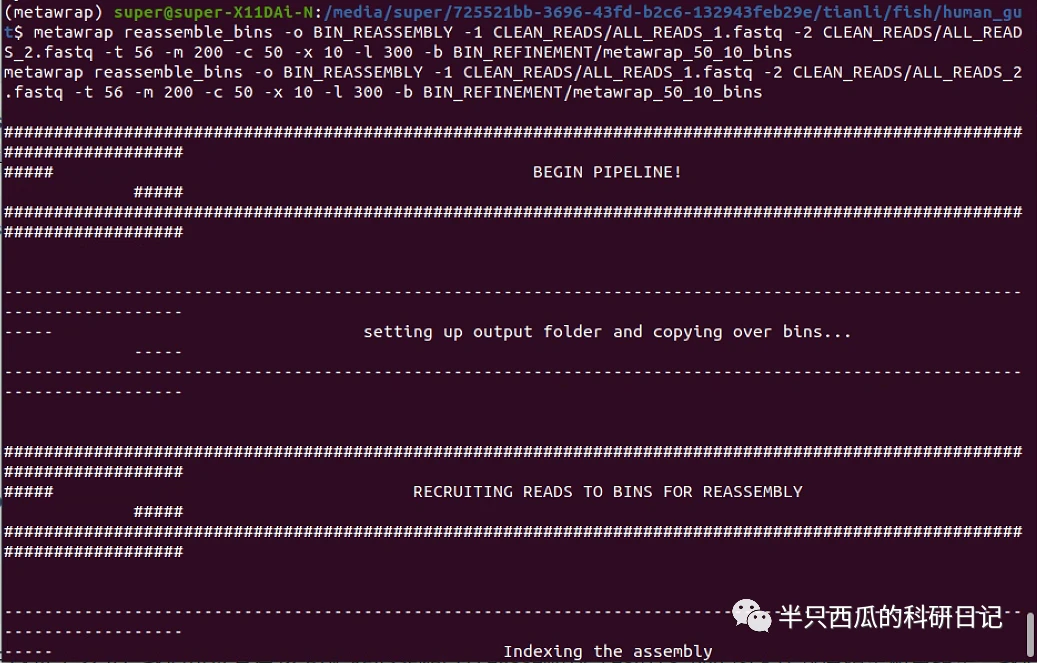
最后进行重组装:
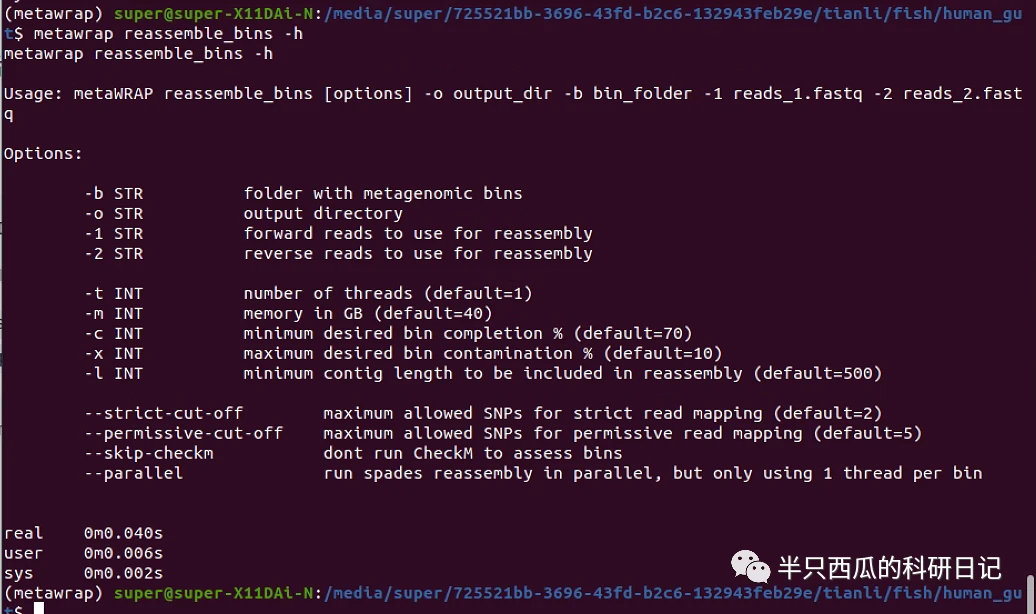
-l使用多长的contig进行重组,默认500.我们使用较为宽松的300;
-c和-x指定完整性和污染度,使用之前的步骤一样参数;
--strict-cut-off和--permissive-cut-off分别指定严格和宽松模式的允许最大SNPs个数(默认为2和5),SNP为单核苷酸多态性,例如,对于某种生物,同一位置基因组片段一部分为AAGCCTA,另一部分为AAGCTTA,则认为此处存在SNP、两种基因型属于等位基因,几乎所有常见的单核苷酸多态性(SNP)位点只有两个等位基因。简单理解,strict严格模式下进行read mapping时,要求SNP个数不超过2的识别为等位基因。
使用GTDB-Tk注释MAGs-bin并构建进化树,大家可以搜一下宏基因组公众号的,有很多优质的教程了
六、功能基因预测
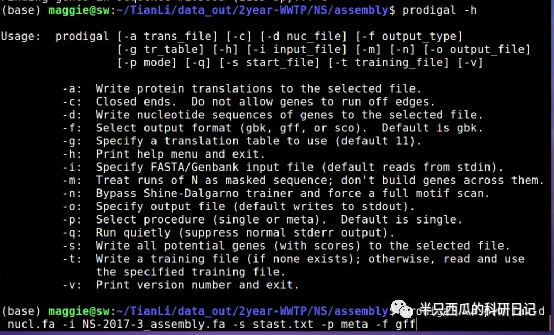
Prodigal软件预测ORF(openreading frames),ORF是能够被3整除的、由终止密码子与终止密码子所包围的碱基片段序列(stop/stop codons)
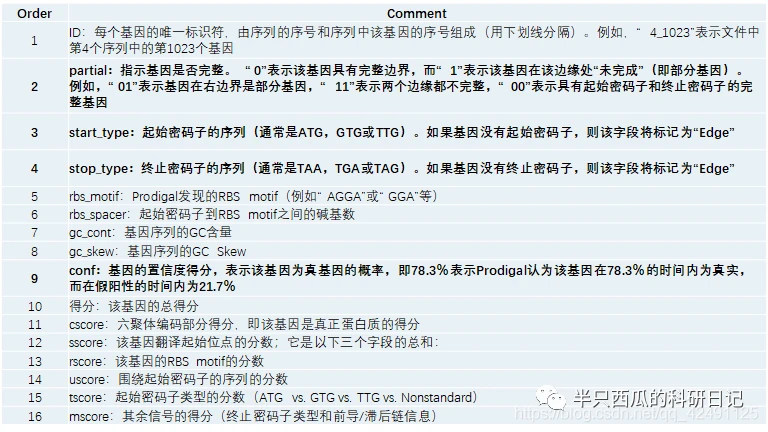
简单介绍 prodigal, -a 输出翻译的蛋白序列 -d 输出核酸序列 -f 输出文件格式(gbk,gff,sco,默认gbk) -i 输入文件 -s stat.txt(将所有结果和得分写入该文件)-p meta(样品是单菌single还是meta,默认single)
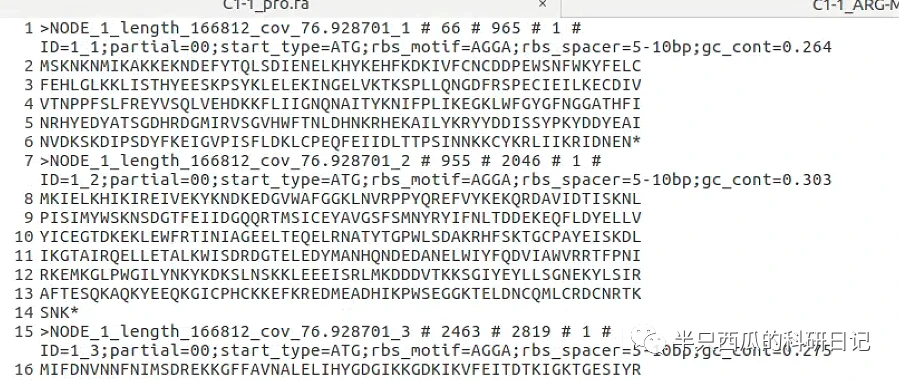
输出文件gff格式:
>contig名_orf序号 # orf在contig上的起始位点 # orf在contig上的终止位点 #1正向-1反向
(可选,可以用来算基因丰度)非冗余基因集:将各样品及混合组装的基因预测结果放在一起,采用聚类软件进行基因聚类及去除冗余重复,将每个Cluster中最长的序列作为代表性序列,以获得非冗余的基因集合。
以下介绍一个简要流程:
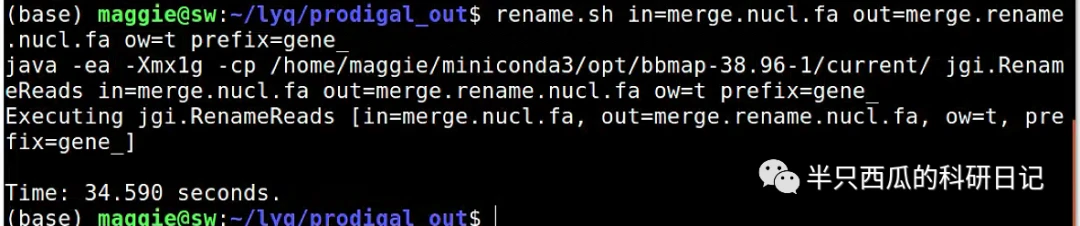
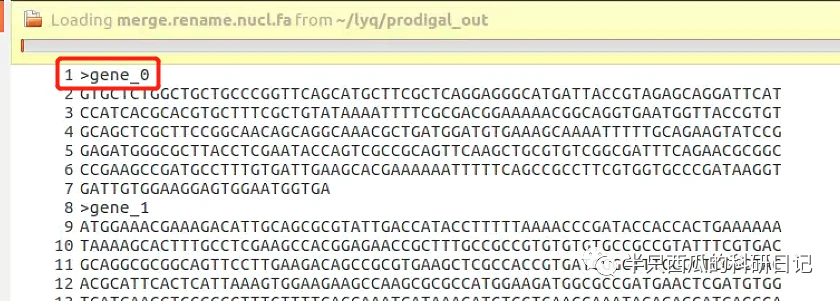
先使用BBMAP中的rename.sh脚本(注:prodigal的蛋白序列无法被识别,需要先用核酸序列改名字再翻译成蛋白质序列)
rename.sh in=input.fasta out=output.fasta ow=t prefix=>gene_
此步获得改了名字的核酸序列
#不需要筛选,默认的90bp跟100bp区别不大
BBMAP筛选最小ORF序列长度
reformat.sh in=contigs.fasta out=filtered.fasta minlength=100
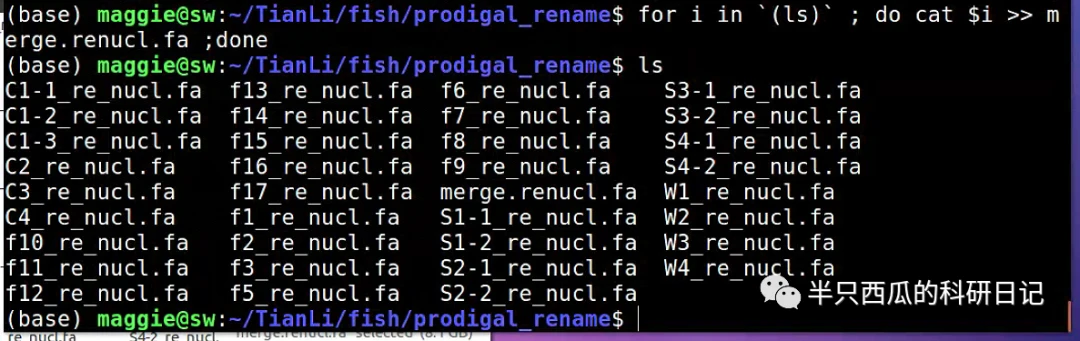
cat > 为把输出的内容重定向到新文件
cat>>则为按照追加的方式输出到新文件
cd-hit-est更适合DNA数据去冗余:
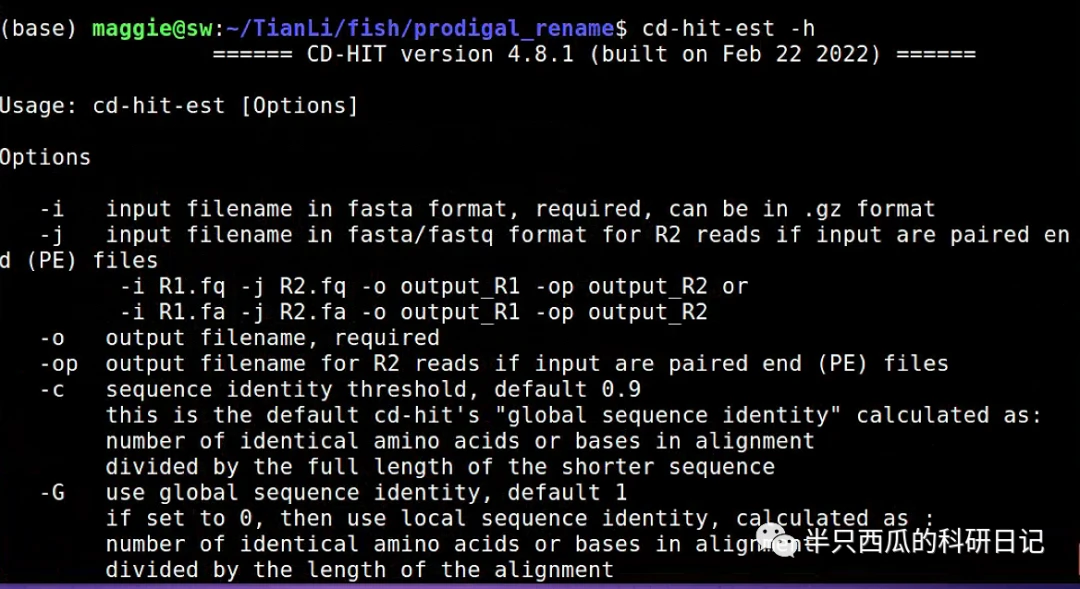
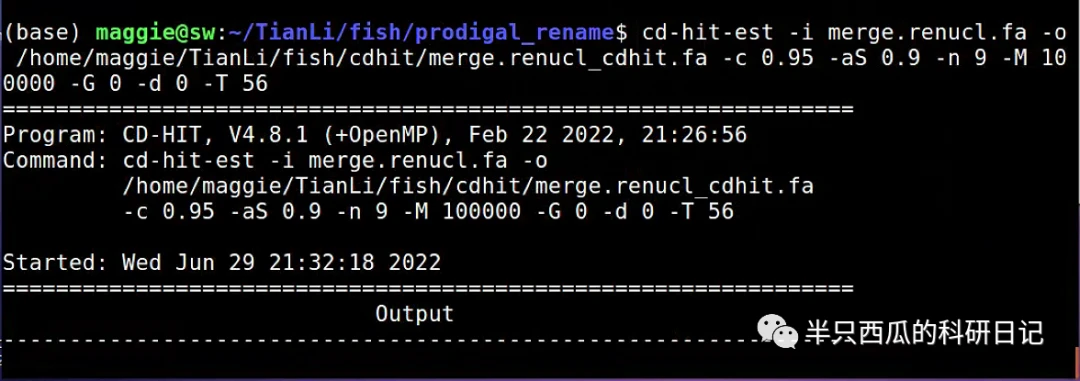
-i 输入文件,fasta格式的序列
-o 输出文件路径和名字
-c 相似性(clustering threshold),0.95表示相似性大于等于95%的为一类
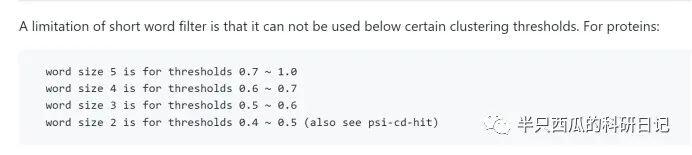
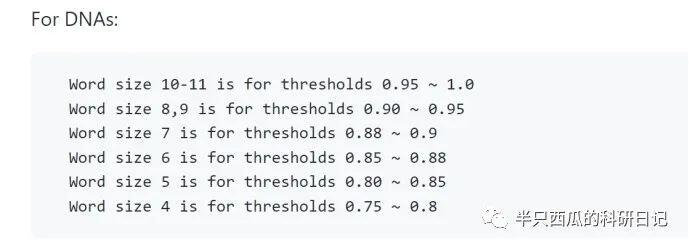
-n word_length c阈值(thresholds)设定为0.95,对应cd-hit n=5;cd-hit-est n=8、9或10
Cd-hit (for proteins)
Cd-hit-est (for DNAs)
-d 0表示使用 fasta 标题中第一个空格前的字段作为序列名字
-M 50000,50GB RAM
-T 使用的线程数
-aL:控制代表序列比对严格程度的参数,默认为0,若设为0.8则表示比对区间要占到代表(长)序列的80%。
-AL:控制代表序列比对严格程度的参数,默认为99999999,若设为40则表示代表序列的非比对区间要短于40bp。
-aS:控制短序列比对严格程度的参数,默认为0,若设为0.8则表示比对区间要占到短序列的80%。
-AS:控制短序列比对严格程度的参数,默认为99999999,若设为40则表示短序列的非比对区间要短于40bp。
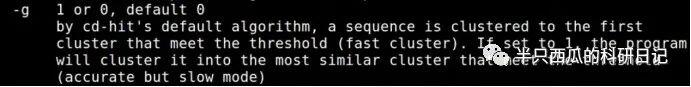
-G:use global sequence identity, default 1.if set to 0, then use local sequence identity, calculated as :number of identical amino acids in alignment divided by the length of the alignment.NOTE!!! don't use -G 0 unless you use alignment coverage controls see options -aL, -AL, -aS, -AS
-uL:maximum unmatched percentage for the longer sequence, default 1.0 if set to 0.1, the unmatched region (excluding leading and tailing gaps) must not be more than 10% of the sequence
-c: sequence identity threshold, default 0.9 this is the default cd-hit's "global sequence identity" calculated as: number of identical amino acids in alignment divided by the full length of the shorter sequence

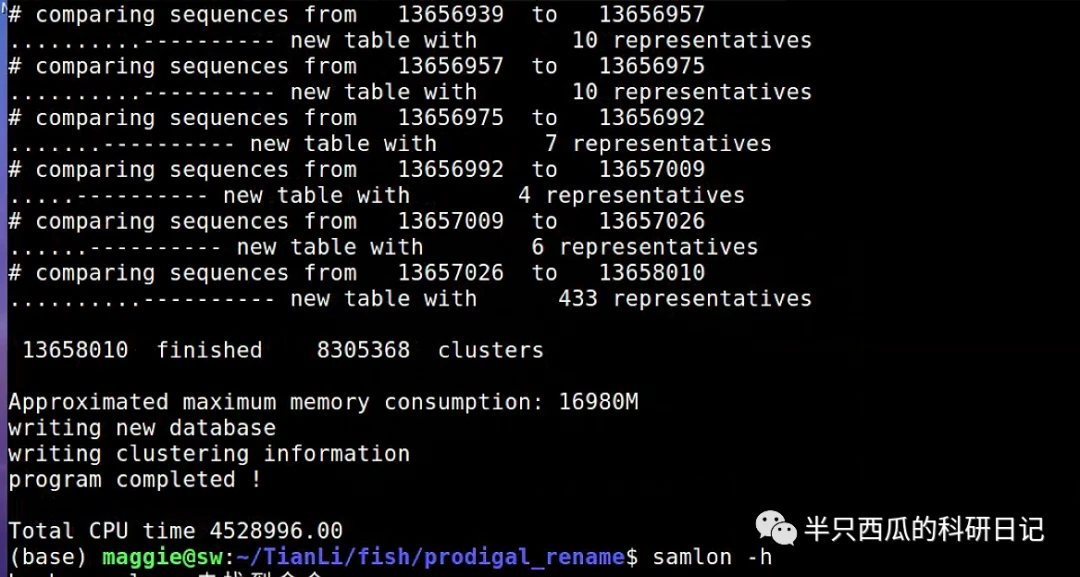
完成:
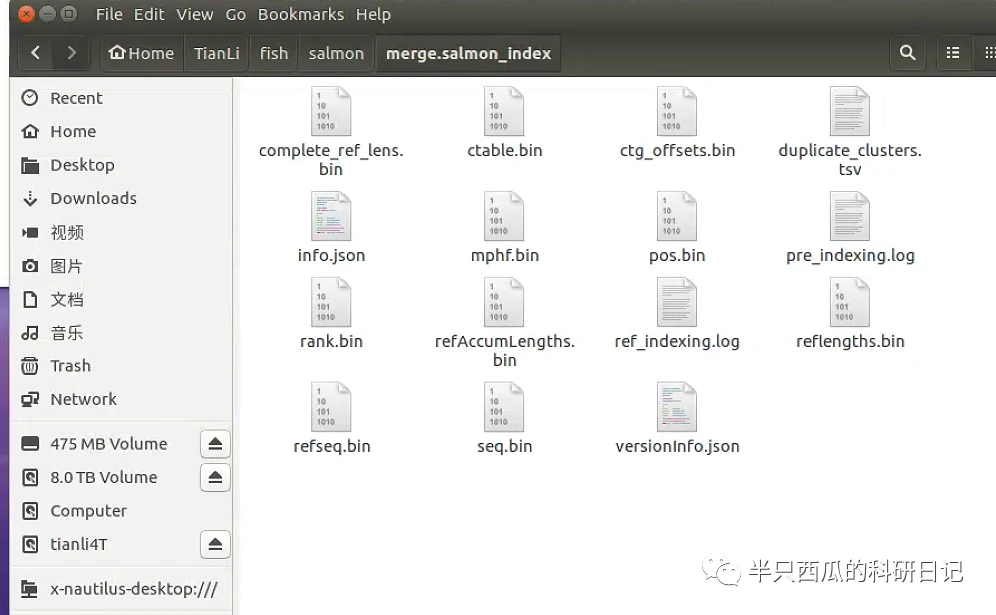
接着使用salmon (index),根据刚建立好的非冗余基因集建立索引:
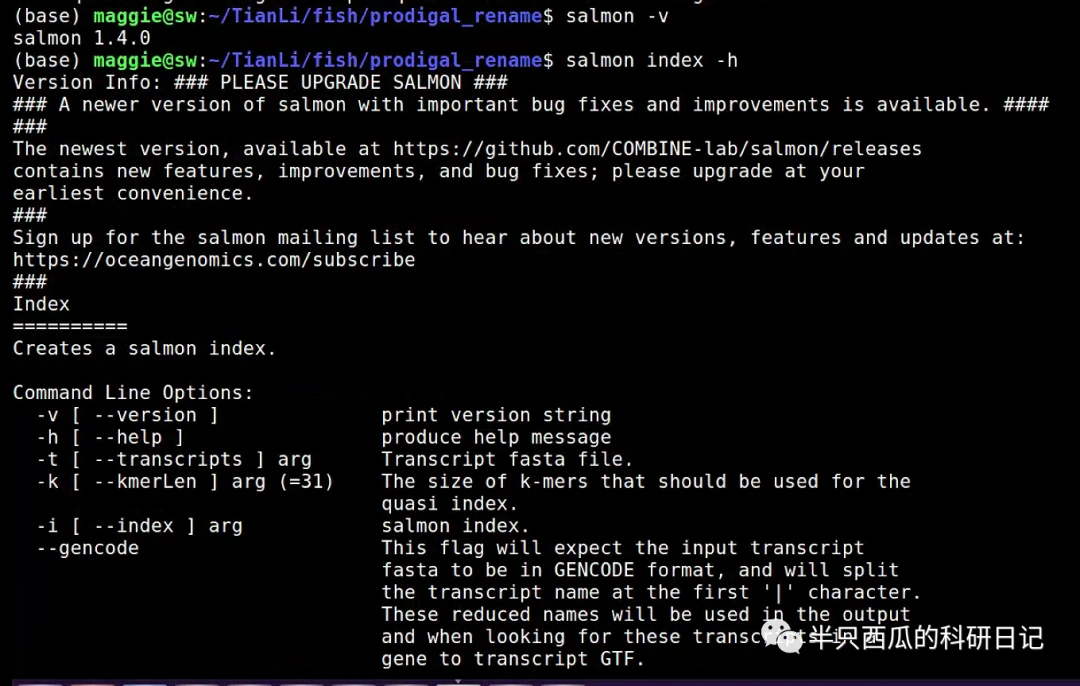
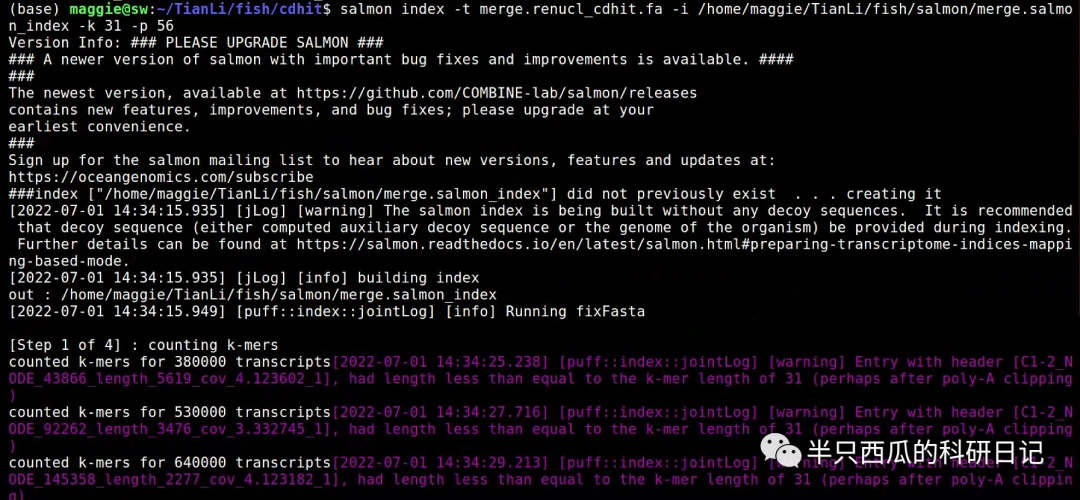
-t输入,-i输出。-k为kmer大小默认31,-p线程,其余默认即可
建立好的索引为一个文件夹:
接着使用salmon(quant)计算样品的基因丰度:
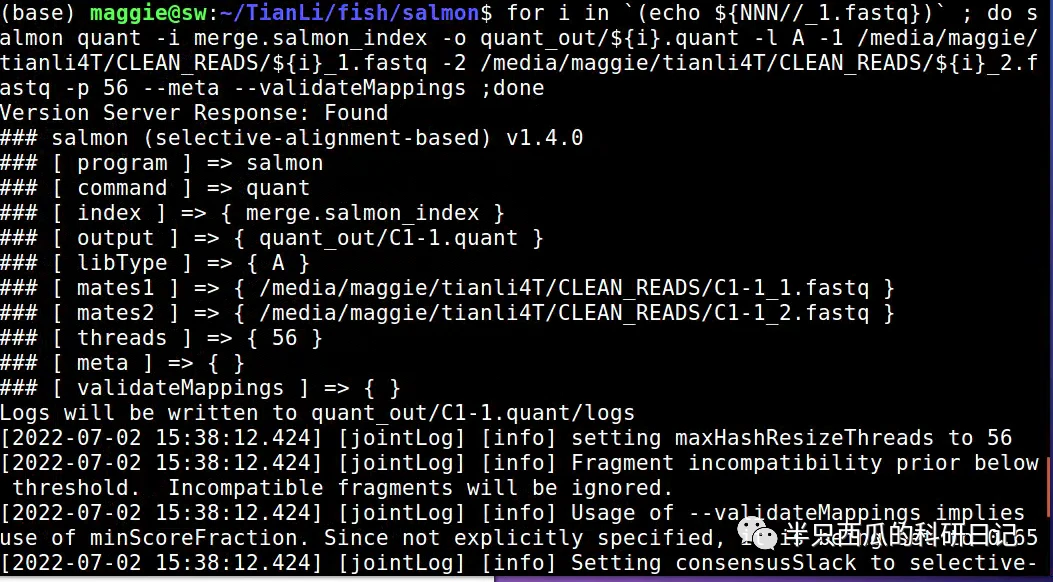
-i索引目录,-o输出目录,-l指定输入数据类型,-1和-2为双端reads,-p线程,--meta宏基因组数据,--validatemapping暂时不清楚干嘛的,参数很多有空慢慢看。
注意!指定输入文件类型的-l参数要在-1和-2参数之前!
#根据上述表格分别获取TPM值和raw counts值
#TPM值
cut -f1,4 quant.sf > tpm.txt
#获得raw counts值,并将序列数目小于等于2的基因(单拷贝基因)过滤掉
awk '{if ($5 > 2)print $1,$5;else print $1, "0"}' quant.sf | cut -f1,5 > rawcounts.txt
# paste合并所有样品 #删除重复的列
paste rawcounts_1.txt rawcounts_2.txt |cut -f1,2,4,6... > TPM_combined_counts.tab
七、总结
到这里对于大部分的新手来说应该都够用了,但其实有很多的细节还是在不断地发展和完善过程中(比如分箱算法的优化、基因丰度的单位等),有任何错漏或问题欢迎随时沟通。今后有机会的话会再分享下游的一些分析经验,如果再再有机会的话也会分享数据可视化的经验。
