一:List(P31 - P38)
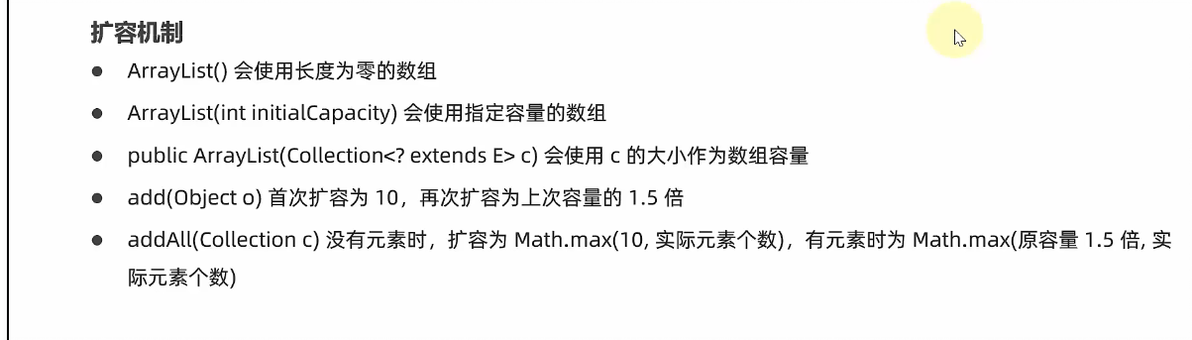
一:ArrayList扩容原理:
1.ArrayList初始为0;
2.第一次扩容为10的数组,替换掉长度为0的数组;
3.第二次扩容为上一次的1.5倍,也就是15,同时还是新数组替换掉旧数组
上面是add方法的情况,下面是addAll()方法的情况:
1.第一种情况,arrayList中为空
(1)第一次扩容,扩容为10
若第一次扩容,我要加11个元素,扩容为11
(addAll规律:)addAll()会在第一次扩容和我的元素大小间找一个大值进行扩容
若是3和10, 那就是第一次扩容的10
总结
二-Iterator分析
一.fail-fast(快速失败)和fail-safe(安全失败)
fast若遍历时发现其他人修改,则立刻抛出异常
safe若发现其他人修改,会有应对策略,例如牺牲一致性(控制台数据不是当前的最新元素)来让整个遍历继续运行完成.
fail-fast增强for循环,底层是利用迭代器对象
new Iter() ,ArrayList()是典型
通过迭代器的修改次数和list集合的修改次数看是否相等,判断是否发生异常(不相等发生异常).
三.fail-save
new COWIterator()迭代器,CopyOnWriteArrayList()是典型
1.会把当前正在遍历的数组保存下来,
2.list的数组和迭代器数组不是同一个数组(复制原来的数组),新加的数组放在复制出的新数组中.
3.遍历还是旧数组,遍历结束后就没用了
四.arrayList与LinkedList
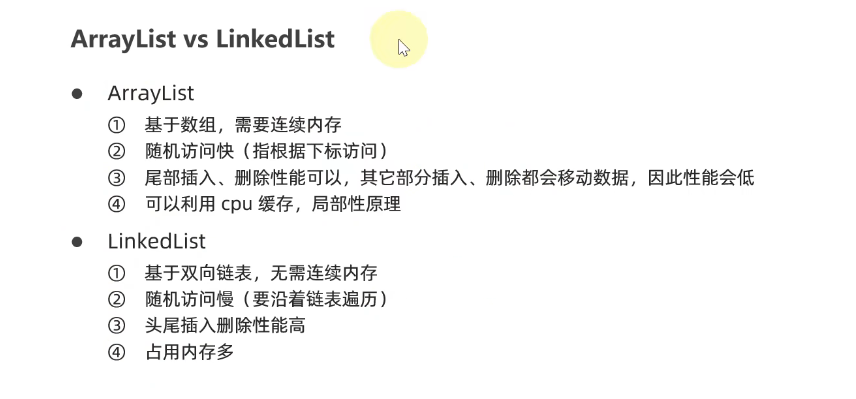
五.局部性原理
一.是往cpu缓存中读数据的一种优化措施
arraylist可以充分利用,提升它相邻元素被访问的机会,而linkedList不能充分利用.
二:Map(P39 - P55)
一.HashMap底层数据结构
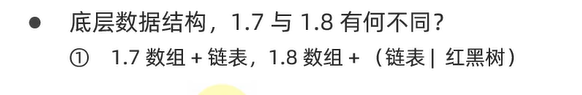
桶->map?
1.通过两次hashcode值与数组初始容量16(扩容因子:0.75,到达0.75之后扩容)的求余,决定值的位置.(可以实现元素的快速查找)
2.两种思路提高查询效率:
2.1 缩减链表长度,也就是去扩容数组长度.
2.2 红黑树树化,
条件:树化阈值为8,
数组长度>= 64(0--63)
规则:先按hashCode比较,hashCode相等时,再按key比较.左小右大
时间复杂度:
链表: O(n)
红黑树:O(log以2为底的n -> logn)
3.为什么不是一开始就树化?
3.1 树的节点是treeNode,链表是node,数据消耗更大,如非必要,不转为红黑树
3.2 正常情况下也不会出现链表长度为8,正常时6左右,一定是有人要恶意攻击我们时,我们的链表才会超过8

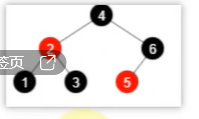
4.红黑树何时退化为链表:
4.1 在扩容时,如果树元素<=6,就会退化成链表;
4.2 remove树节点时,在移除之前检查,根节点的左孩子,右孩子,左孙子,如果有一个不存在,就会退化为链表
eg:
5.索引如何计算,为什么需要hash方法,数组容量为何时2的n次方冥
(1)索引如何计算::通过对象的hashCode值得到原始hahs之后再调用hashMap()里的hash方法进行二次hash,与数组容量取模,得到桶下表,
(二次的hash值 按位与 数组容量-1 得到的桶下标一摸一样->也就是求余的优化)
(2)为什么需要hash方法:为了让hashCode计算出的索引值更为的均匀, 通过移位,异或运算,扰乱hashCode,让其更加均匀,成功的乱一定是趋于规律
(3)为何是2的n次冥:
扩容时优化:二次hash值与原始容量按位与,如果是0,就不动,如果不是0,就移动到新位置(旧位置+原始容量).
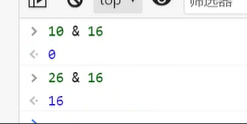
如:这里10的hash不动,26的,移动到+10的桶下标.
(4)能否不用2的n次:
选择质数:①会有更好的hash分布
②不需要二次hash,也可以有很好的分布性
2的n次性能更好,选择质数更分布更好
(5)hashTable:
第一次容量为0,下一次扩容变为11,再然后23,47,他的容量->就是上一次容量翻倍+1.
6.put流程总结:
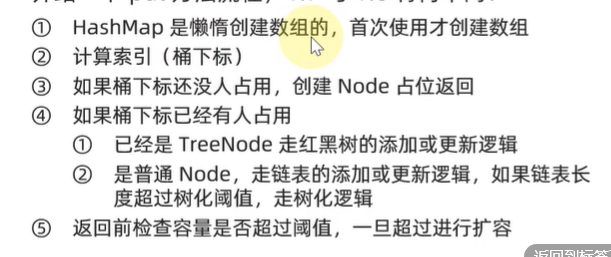
(1)这里占位返回是指:占位之后存储,然后返回
(2)扩容是添加完新元素之后才会扩容,例如16的时候,数组容量到达12,那会先变成13个元素,再扩容,再迁移数据
(3)1.7与1.8的区别
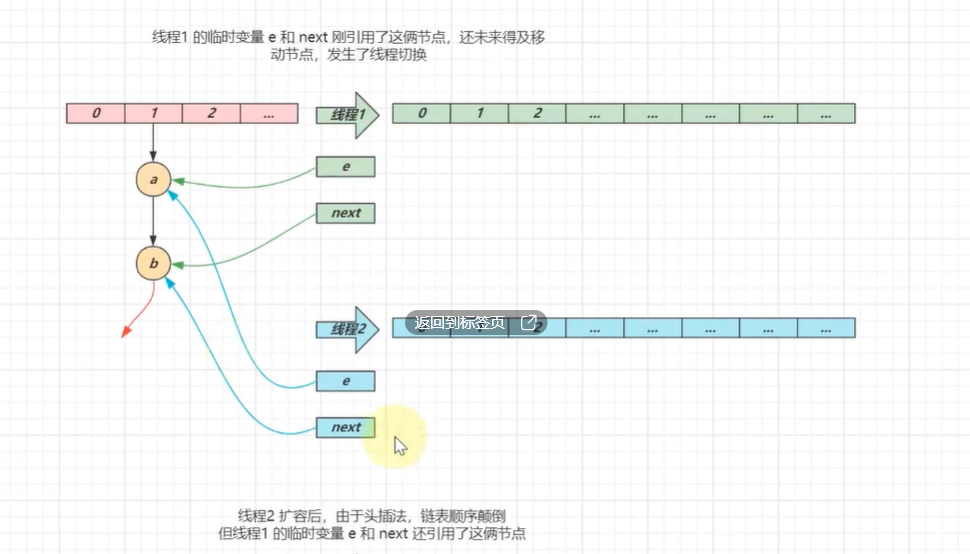
①1.7是链表头插法,1.8是链表尾插法
②1.7是大于等于阈值,且没有空位(几个容量就是几个元素)才扩容,1.8是存完元素后直接扩容
③1.8对扩容后node的桶位置会有优化
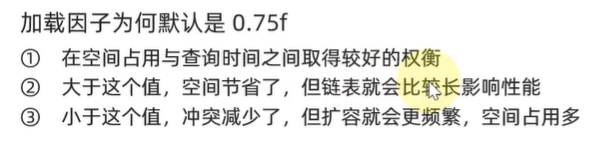
7.为什么是0.75
为了在空间占用与查询时间之间取得较好的平衡.
8.多线程hashMap:
①数据错乱(1.7,1.8)
②并发死链(1.7)
多线程头插法的问题:
9.hashmap key 能否为null
(1)只有hashmap的key可以为null
(2)重写hashCode为了key有更好的hash分布,重写equals是为了保证看是否两个一样hashCode值对象是否相等;
(3)key的内容是常量,不可变,因为变了要从新计算hash值,重新计算桶下标
10.String的hashCode如何计算:
(1)目标是为了得到独特的hashCode值,可以达到散列分布
(2)每一个字符都是一个数字,然后成31的n-1,以此类推
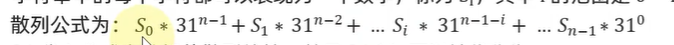
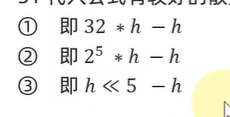
(3)为什么是31:
①有较好散列效果(一般质数都会有较好的效果)
②可以被优化为移位运算,效率更高
四.多线程
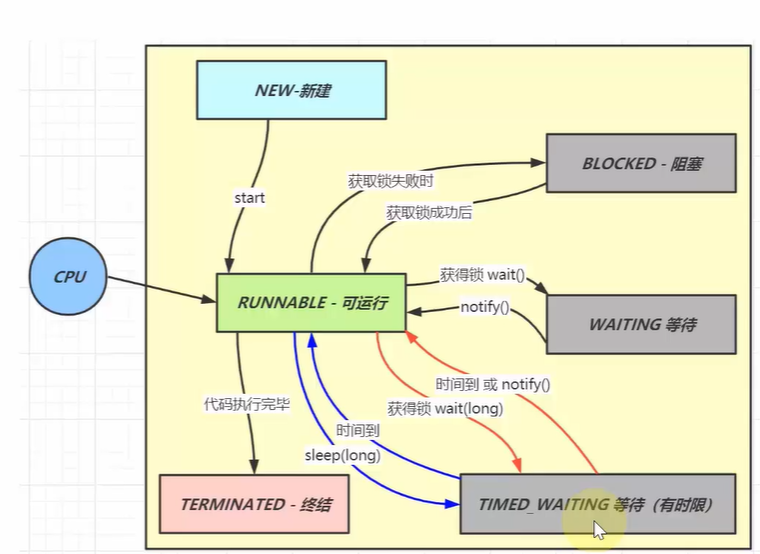
一.线程状态
二.线程池核心参数
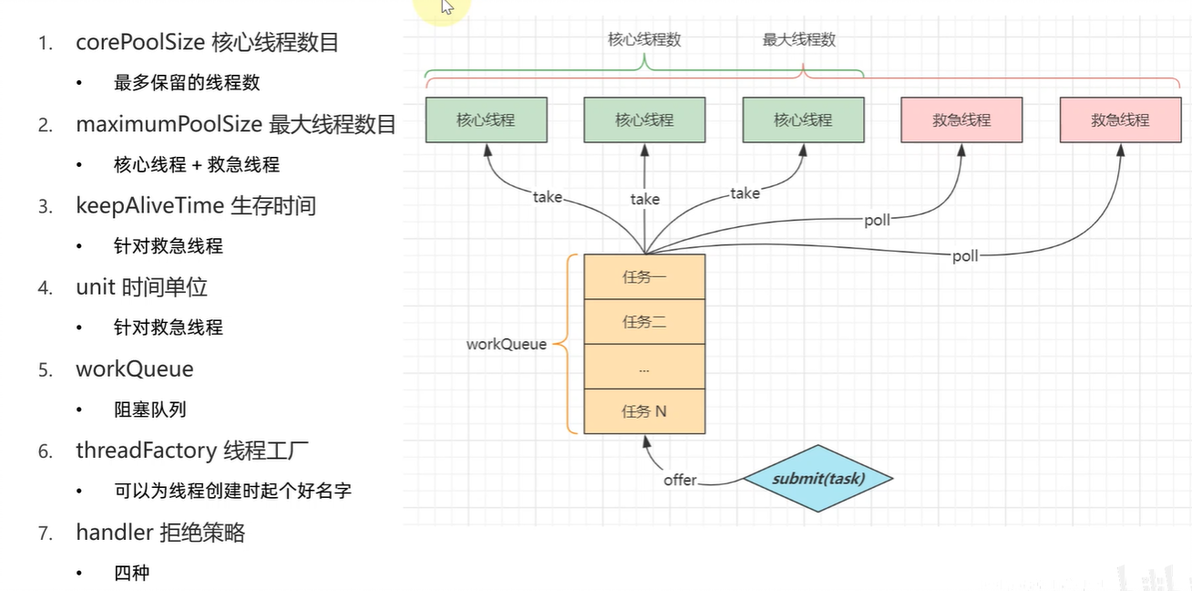
(1)救急线程也叫普通线程
(2)拒绝策略:
AbortPolicy,终止策略,程序将会抛出RejectedExecutionException异常。
CallerRunsPolicy,调用者运行策略,线程池中没办法运行,那么就由提交任务的这个线程运行
DiscardOldestPolicy:丢弃最早未处理请求策略,丢弃最先进入阻塞队列的任务以腾出空间让新的任务入队列。
DiscardPolicy.丢弃策略,什么都不做,即丢弃新提交的任务。
三.sleep和wait
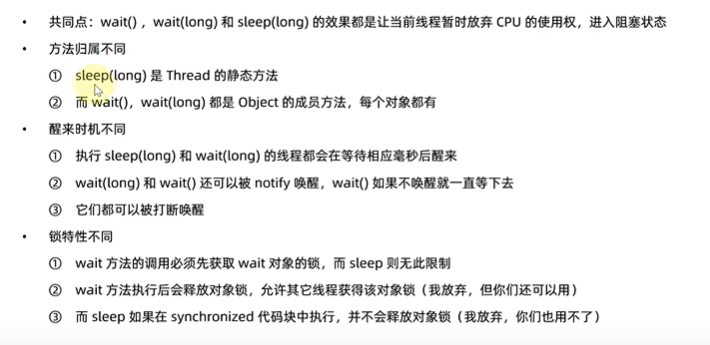
(1)wait释放锁是指,当被锁住的代码块中调用了wait方法时,会释放锁,此时主线程可以继续运行,可以异步
(2)interrupted可以打断唤醒
四.lock(reentrantlock)锁和sychronized锁对比
1.语法层面:
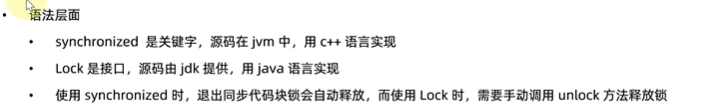
2.功能层面:
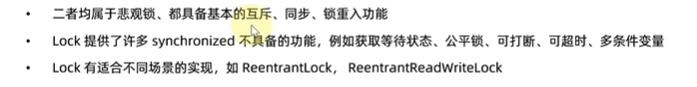
可重入是指可以给同一个对象加多道锁,多个门.
多条件变量是指有多个队列
3.性能层面

4.一些解释:
(1)lock和unlock
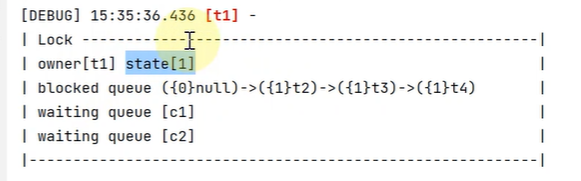
->unlock
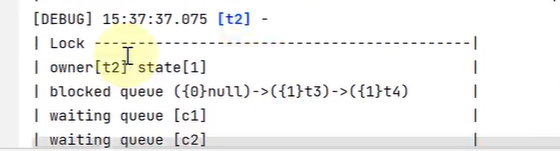
-> 重入锁-lock
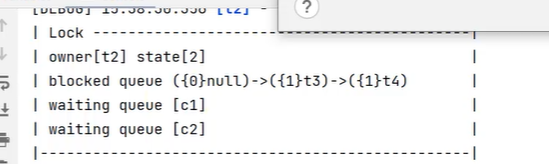
(2)公平与非公平
先入队先获得锁,新的线程不能插队
无参tryLock总是不公平的
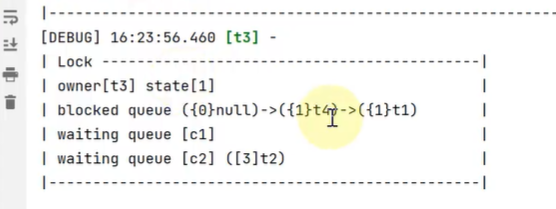
5.lock_条件变量
c2.await()睡,single()唤醒一个
五.volatile
1.
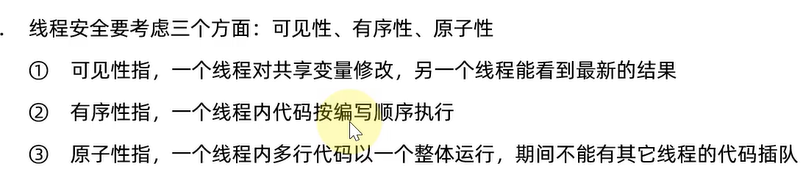
2.可以保证有序性和可见性,不能保证原子性
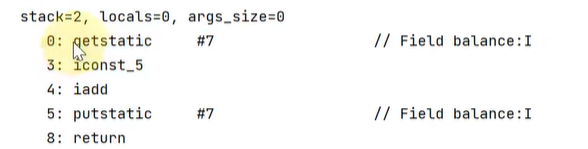
(1)一行命令对应的java虚拟机命令
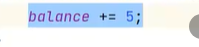
-> 保证了有序,但不原子
(2)可见性:一个线程的修改,另一个线程不可见,(在实践中不断改变,否定之否定)
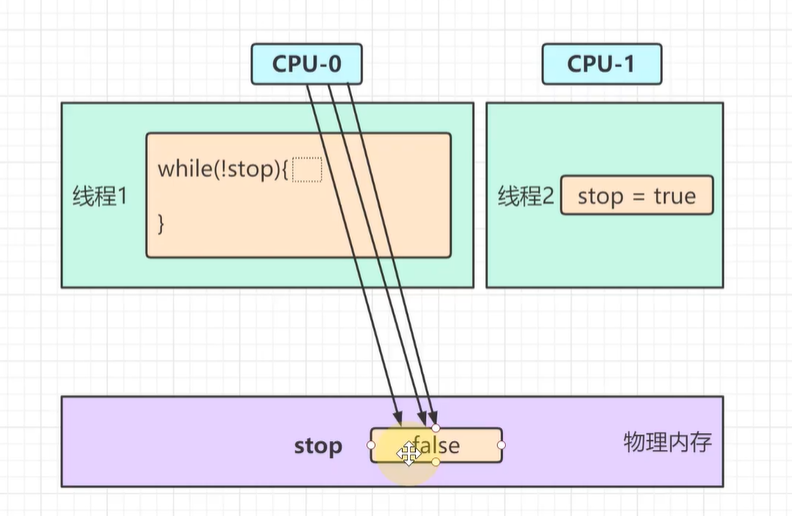
jit:对热点字节码进行优化,替换掉原始代码,导致线程2无法获取线程1的代码,如果没有执行那么多次,不很热点的话,便不会优化,不会替换,自然不会出现可见性问题(或者是禁用jit优化,也可解决可见性问题)->
最根本的解决办法是用volatile关键字,易变的,不被优化
(3)有序性(大量的数据会显现出无序性)
如果出现了指令重排序,就会出现不预期的结果,

出现1,0,说明出现了无序
3.volatile原理:
写屏障与读屏障(单行屏障)
,volatile在写的最后位置,才有用,
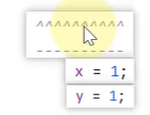
在读的时候要让volatile变量先读,才有用
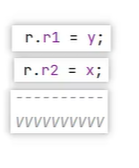
并发篇-18-volatile_有序性_volatile位置不同影响分析 P80 - 02:12
六.悲观锁与乐观锁
1.悲观锁
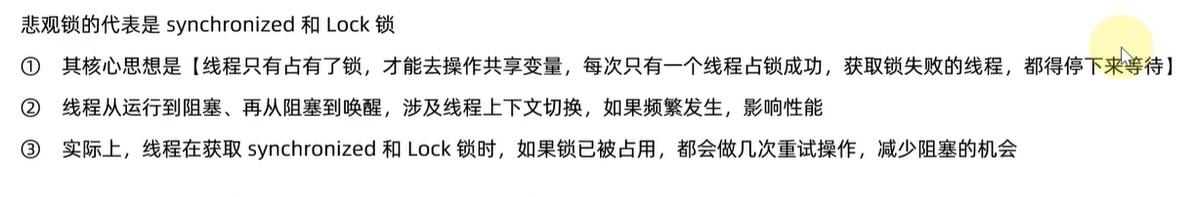
# 上下文切换:从运行到阻塞状态,线程状态变化时,都会记录线程信息,例如:线程执行到哪,现成的变量信息等,下一次线程状态变化时,从中断的地方开始执行,这一个过程就涉及上下文的切换
# 不重试,就会直接进入阻塞;
2.乐观锁
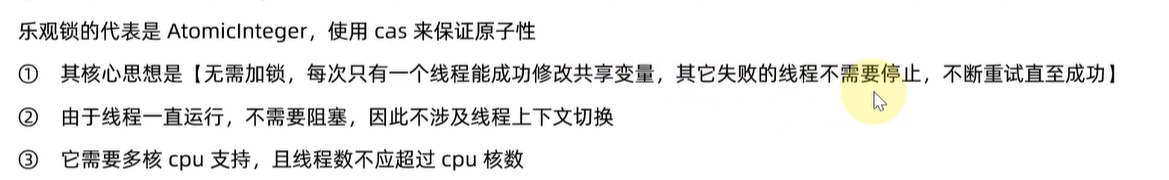
# 一个cpu一核控制一个线程,一个线程又有多个进程;并发一个线程就是并发,多个线程才能并行。
(2)unsafe 关键字
保证原子性,cas方法机制,比较并交换
(3)悲观锁(互斥)阻止指令交错,乐观锁(比较并交换)会有指令交错
,但是它会随时比较,并获取当前最新值,所以也可以保证同步.
七.hashTable和ConcurrentHashMap
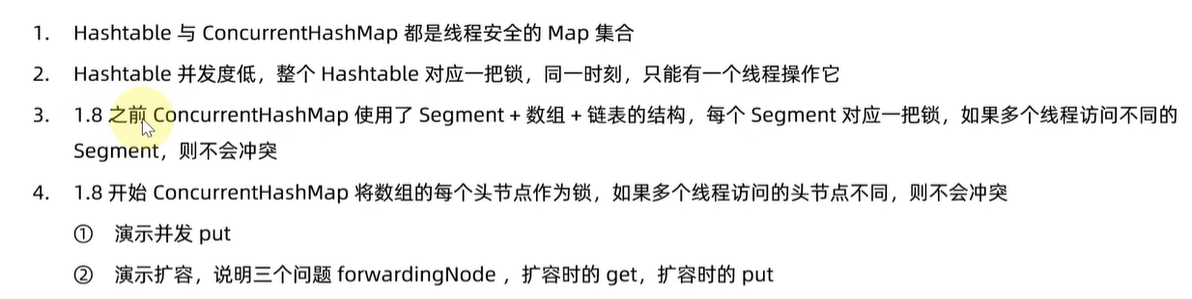
(1)每个segment就是一个锁,1.8之后将每个数组元素中链表的头节点作为锁
(2)hashTable容量一般是质数,不需要二次hash,整个锁
(3)concurrentHashMap
①并发度:
segment数组套hashentry数组,
初始并发度为16,
容量除以并发度就是里面hashentry数组初始容量的长度,有一个最小值最小是2,扩容因子说的也是最小数组hashentry.
②segment索引计算规则:
算出二次hashcode值,根据二进制的高次位作为hash值,高4位或5位,例如 1101 就是 12.
(代码为目的服务)
小数组位置是看它的2的几次冥,看二次hash值得最低位是几,就决定了他在hashentry数组中的位置
③扩容规则
每次容量翻倍,容量达到0.75(3/4)之后扩容,每次扩容两倍,hashentry数组扩容是各扩各得.互相不影响(头插法)
④segment[0]原型
别的hashentry数组会根据segment[0]得数组大小,就是设计模式中的原型模式
⑤1.7与1.8的区别:
一.数据结构上:
二.初始化时机:1.7是饿汉式初始化,
1.8是懒汉式初始化,put元素之后才会创建数组
三.1.7头插法,切超过扩容因子才扩容,1.8尾插法,到达扩容因子之后就扩容
四.
1.在concurrenthashmap中,数组容量(capacity)的含义是我要放几个元素,那实际容量就应该需要扩容后(假如是16个元素,.那实际为32)
2.fackory(扩容因子):只是第一次构造时扩容的因子,之后还是用0.75去扩容
五.并发put.
1.把锁加在每一个链表头上,同一个链表时,会有互斥.
2.扩容原理:
从最后的链表开始处理,该链表是扩容处理过后标记为forwardingNode.
3.扩容时多线程细节:
多个线程之间看forwardingNode,如果时forwardingNode,就去新数组中查找,否则说明还未迁移完,在扩容前的就数组中查找
如果时扩容并且查询链表时,迁移后的node节点,是把当前链表中的元素的重新创建,
有优化,就是链表后面的一些元素,如果位置相同,不需要再重新创建新的节点对象
扩容时一个线程处理16个数组大小,减少阻塞.->总结:迁移前的部分可以并发执行,迁移中的链表,只能阻塞,迁移后的,另一个线程来了会帮忙迁移,然后减少阻塞
八.ThreadLocal
1.概念.

总结.线程间资源对象隔离,线程内资源共享
2.原理
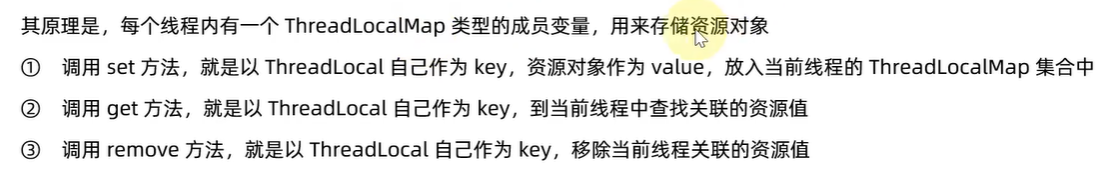
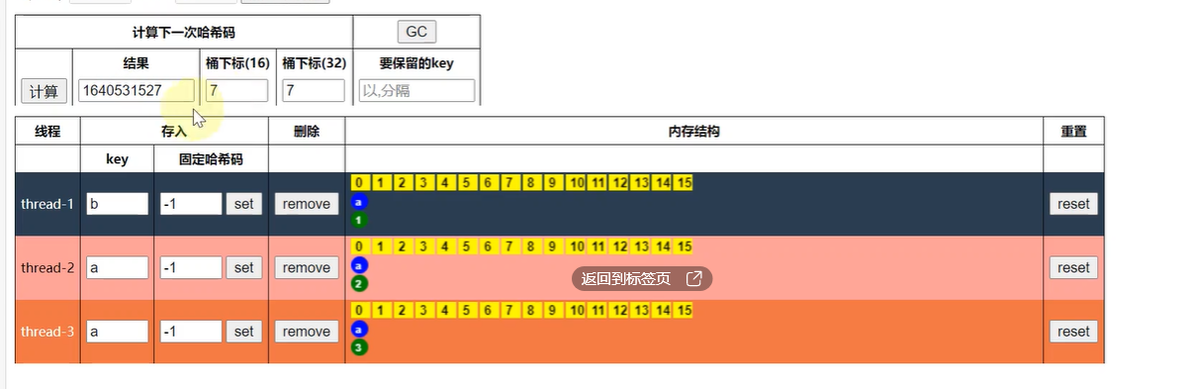
索引如何计算:
为每个新的threadlocal对象在0的基础上加一个特别大的整数做为hashCode,根据hashCode计算出桶下标
初始容量为16,扩容因子2/3
如果索引冲突的话,开放寻址法去解决,找下一个空闲位置,不会链表.
3.key是弱引用,方便垃圾回收,值是强引用,需要自己回收
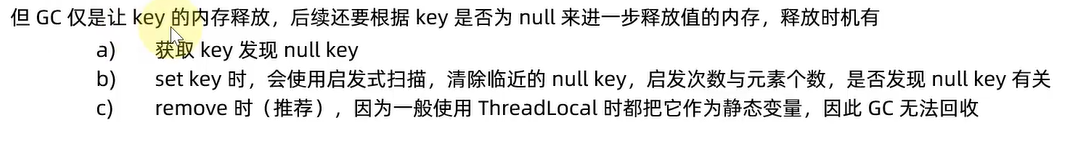
值被回收后,下一次setkey时,如果key是null,就回收这个key的值和邻近的null key(启发式扫描)的值
临近几个null key,就是多少启发次数,与当前元素个数和是否发现null key有关
*实际上:
因为一般threadlocal的静态变量,不可能是弱引用,上面说的情况也不会发生
一般用第三种情况,remove()方法去删除键值对,不会出现内存泄漏!!!
五.虚拟机篇
虚拟机-01-jvm内存结构_代码执行流程 P101 - 02:41
一.jvm内存结构
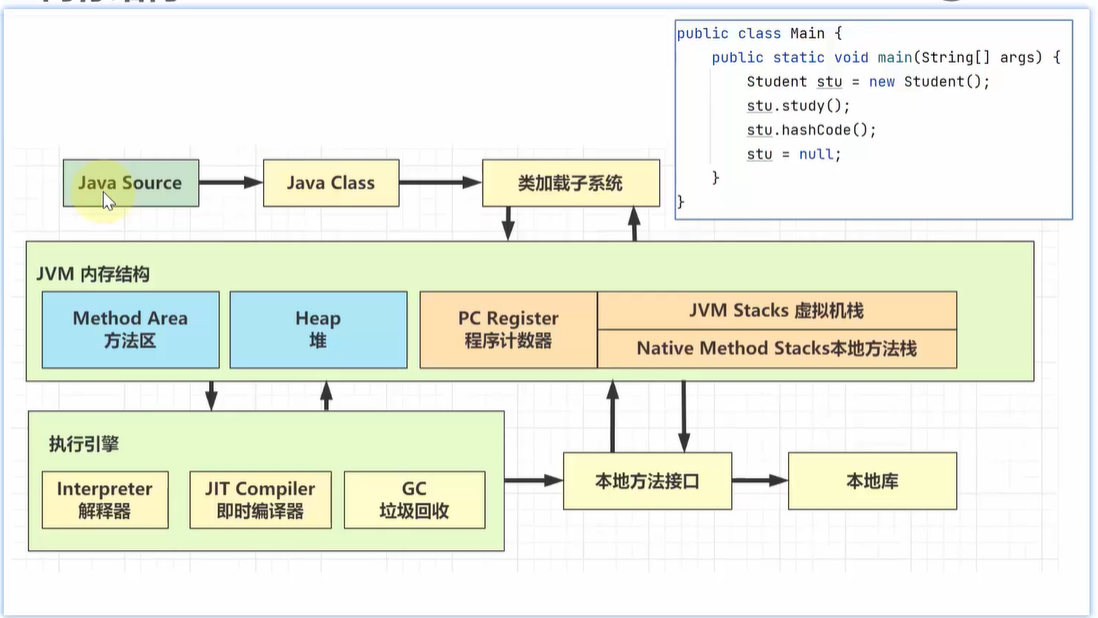
1.要点.
字节码文件可以通过jvm跨平台
①通过java class创建了一个java虚拟机
②创建虚拟机之后,会创建一个main主线程,主要是为了执行main方法(入口方法)
jvm stacks 虚拟机栈,不光是主线程,线程都是在虚拟机栈中创建出来,主线程触发类信息加载
③通过类加载子系统,把类的信息放在方法区,(把所有的类的原始信息(磁盘上的字节码文件)读取到内存中)
类的原始信息 指:
类的名字,
类的继承关系,
类里面的成员变量,
类里面引用其他类的信息
类的方法
④在执行main方法时(栈 stack),遇到没有见过的类,又把信息加载到方法区中
总结:方法区存储的是类的信息,包括方法的代码信息
⑤执行到new 操作时,new 实例对象存储的信息放在堆(Heap)中,也就是成员变量的值存在堆中
总结:堆中存储java对象
⑥局部变量和方法参数都在-->栈,
因为是主线程调用main方法,通过虚拟机栈调用
⑦方法调用
普通java方法(java写的)和本地方法(hashCode方法)
一.java方法在java虚拟机栈中
本地方法在本地虚拟机栈 ,执行会找本地库
在有些jvm中,比如orcle中,它并无这个本地方法栈
⑧多线程情况:
程序计数器,记录每一个线程走到第几行
⑨堆中不再被引用的对象,会被jvm垃圾回收(执行引擎还有:解释器(interpreter),即时编译器jit Compiler,和GC(垃圾回收))
解释器是把字节码翻译成机器码让机器可以运行(多次调用,多次解释)
即时编译器,会发现热点代码并缓存为机器码,重复的代码就不会多次解释,主要是为了提升执行效率
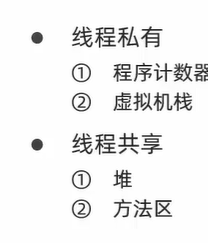
二.内存溢出(该区内存耗尽,报错)
除了程序计数器区,其他区域都会出现内存溢出;分为两种
1.outofmemoryError
堆内存耗尽,对象越来越多,又一直在被使用,jvm无法进行垃圾回收
方法区内存耗尽:加载的类信息(和方法信息)越来越多,很多框架在运行期间都会动态产生新的类
虚拟机栈线程累计过多,一个占用1M内存,
2.stackOverFlowError
虚拟机栈内部方法过多,一般都是由于递归,
栈溢出。
三.方法区 永久代 元空间
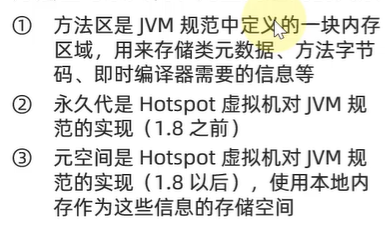
后两者是对方法区的实现
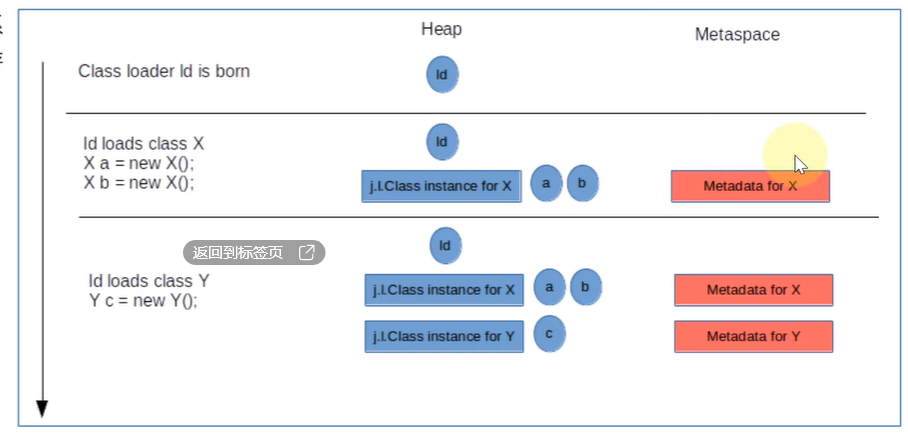
何时清理方法区(元空间):
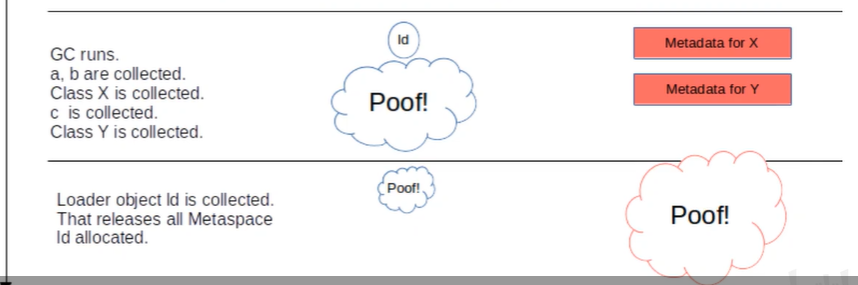
垃圾回收堆内存之后,类加载器里所有的东西都被回收了,那类加载器也会被回收,随后类加载器对应元空间中的信息也会被释放.(只有自定义类加载器会被释放)
四.jvm内存参数
1.堆内存
-Xmx10240m:jvm最大内存参数
-Xms10240:jvm虚拟机最小内存参数
-Xmm5120m:堆中中新生代的大小,剩下的就是老年代
-XX:SurvivorRatio=3,(生存比例):这里是3:1
这个比例代表eden区和survivor区的任意一个区的比例,默认比值是8:1
-XX:NewRatio=2:1:新生代占比
survivor区分为from区和to区,它俩相等
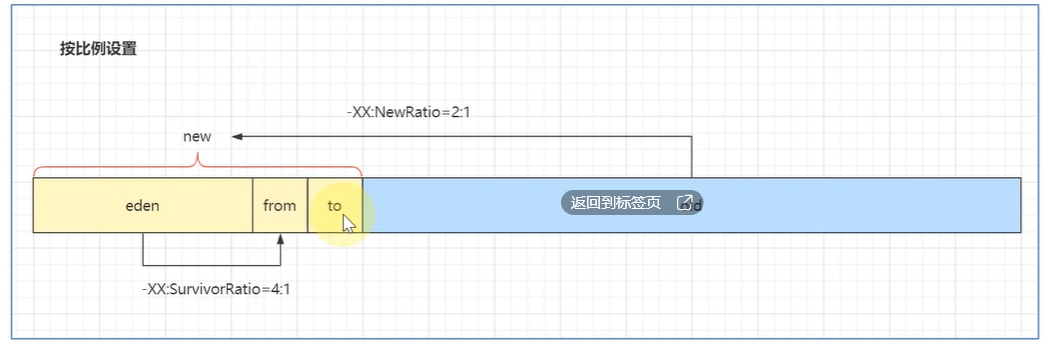
eden+survivor区就是新生代,
还可以按大小设置:
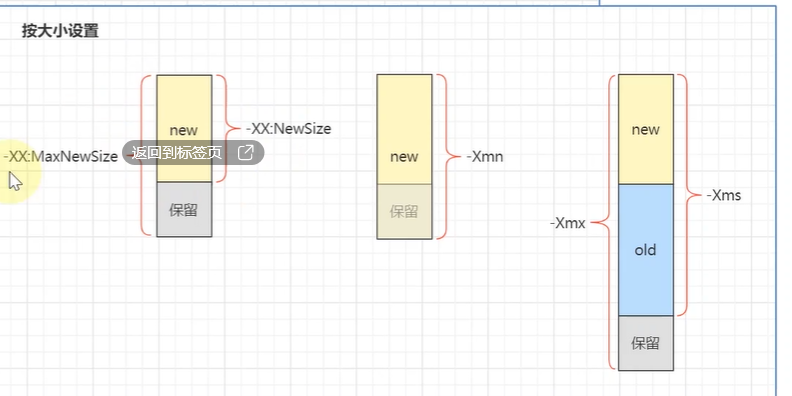
中间图是不要扩展过程,直接设置整个新生代大小,
最后图说的是参数第一个和第二个的大小,建议设置为一样.
2.元空间(方法区):
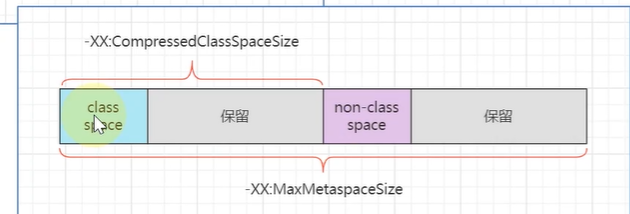
①class space是类最基本的信息:方法入口
参数:--XX:CompressClassSpaceSize
默认1个g
②non-class space 是类的字节码,方法的注解等存储的区域
这两个区的总上限:由--XX:MaxMetaspaceSize控制,默认没有上限
3.JIT即时编译器
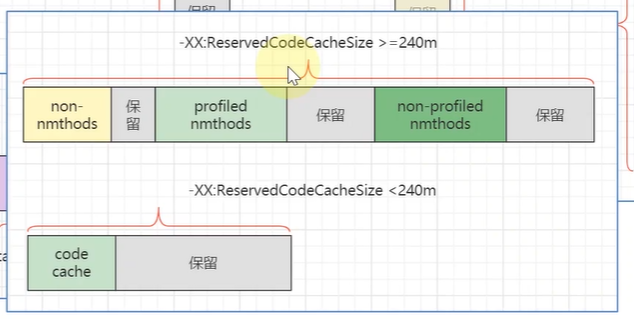
CodeCache(代码缓存区)
代码缓存->,jit存储的重复使用的机器码
--XX:ReservedCodeCacheSize < 240M
总大小不会超过240m,
--XX:ReservedCodeCacheSize >= 240M
会去优化后的机器码进行细分,分成三个区:
non-nmethods:jvm内部自己的代码
profiled(配置,属性) nmethods:部分优化的代码
non-profiled nmethods:经过完整优化的代码
参数控制三个区的总大小
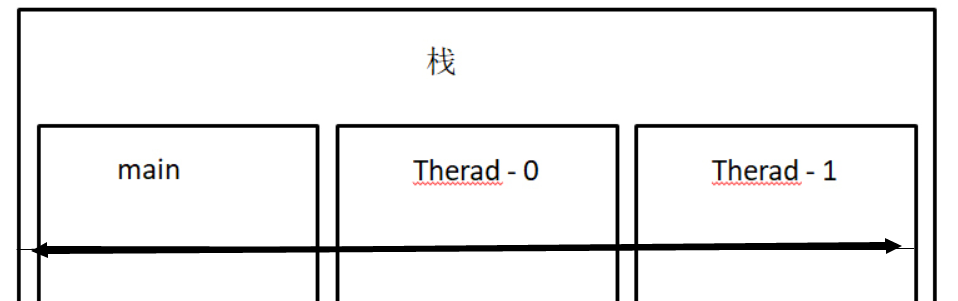
4.线程大小
-Xss:控制虚拟机栈中每个线程的大小
多个线程情况如图:
五.JVM垃圾回收算法
1.标记清除
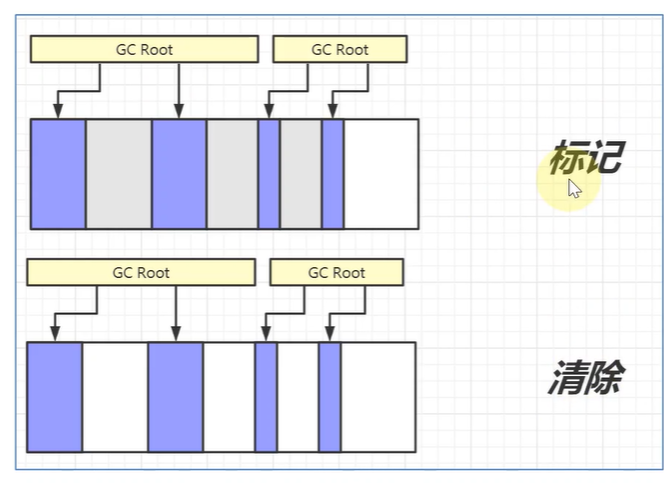
GC Root 根对象,一定不会被回收的对象 (正在使用的局部变量,静态变量)->可达性分析算法
根对象引用的对象(引用链),都不可以被回收
加标记保留,没有加标记清除
会导致内存过于碎片化,没有连续的内存
目前没有虚拟机使用
2.标记整理
先标记,然后清除,最后整理
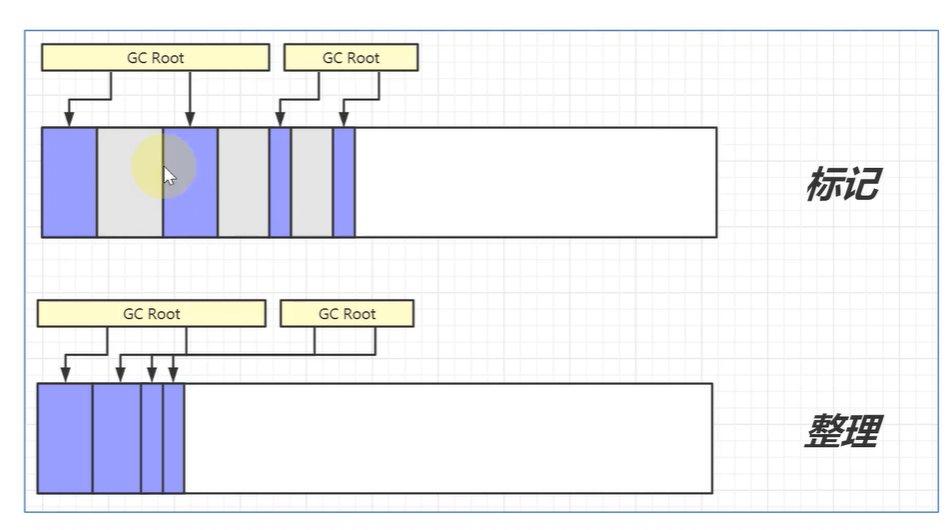
让剩下的对象朝一段靠拢,不会产生碎片,但是会有性能的损耗
3.标记复制
分为两部分,一部分存对象,另一个部分是空白的
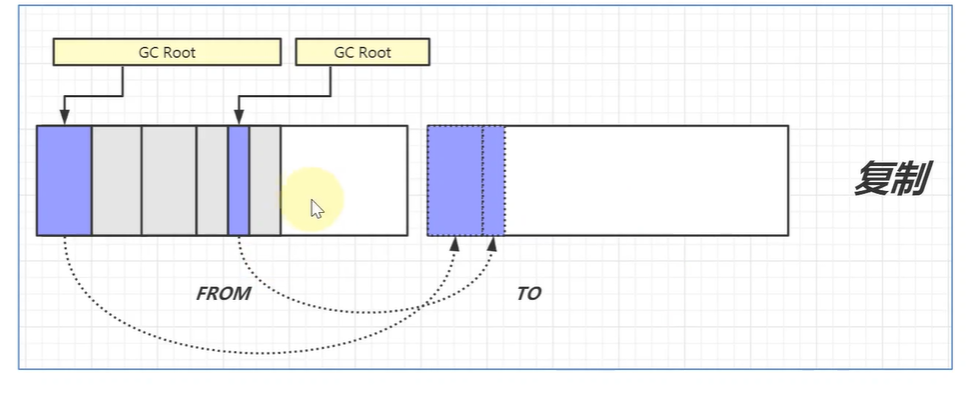
先标记,然后把存活的对象存到空闲区域,也就是to区,然后把from区清空,缺点是内存占用较多,然后交换from区和to区。
4.区别
标记复制,from to区多用于新生代垃圾回收;
老年代对象占用较多,一般用标记整理算法
六.说说GC和分代回收算法
1.GC

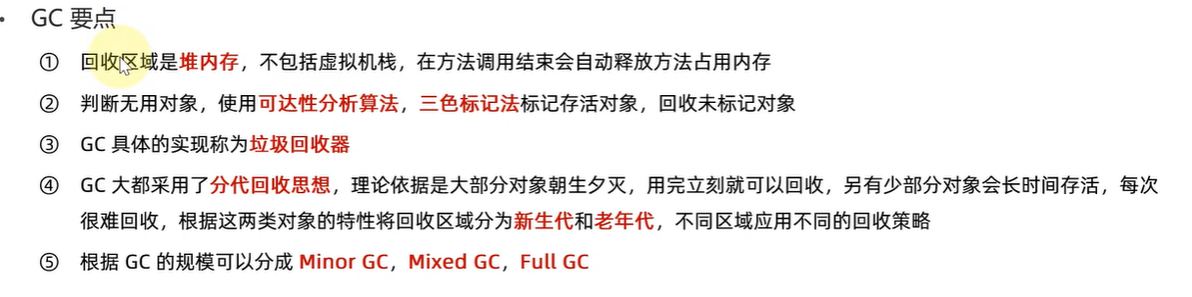
很容易回收的在新生代,很难回收的在老年代
minor GC:新生代的资源回收,占用资源小
Full GC:新生代与老年代都发生垃圾回收,占用资源大,耗时长,会有感觉
Mixed GC:介于二者之间,新生代发生垃圾回收,部分老年代也发生垃圾回收
2.分代回收
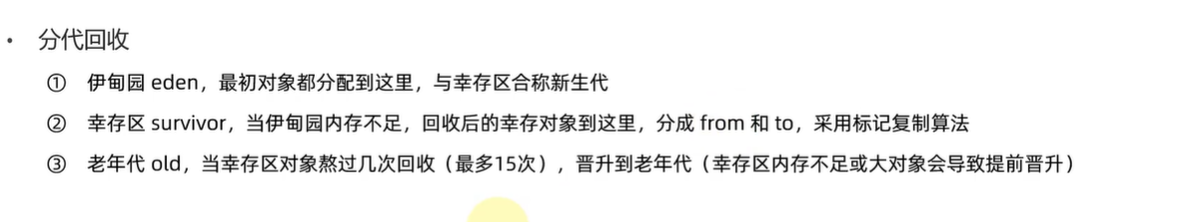
回收时,from和to区的没有被引用的对象也在考虑范围内,
加标记的被放在to区,然后清除所有对象,然后to区与from区互换,,to区又是空的,可以接受下一次复制
七.三色标记与并发漏标问题
1.三色标记
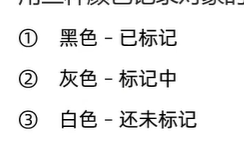
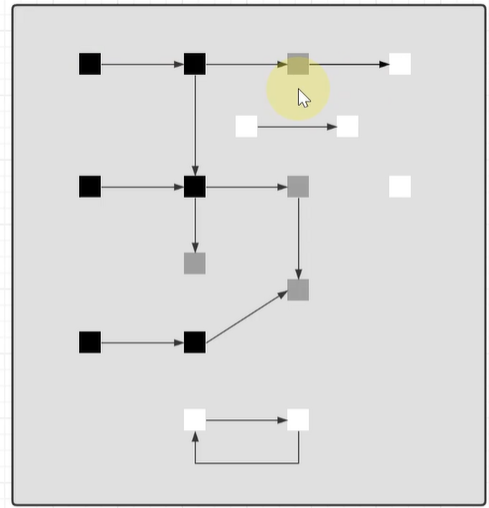
2.漏标问题
回收线程与用户线程并发:
在回收线程回收中,用户线程新增或改变了对象的引用.
解决方案:
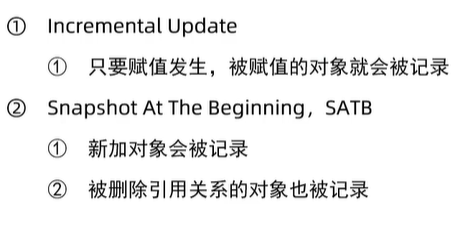
解释:
①增量更新
②原始快照
都是通过记录了标记过程中的变化,来保证标记
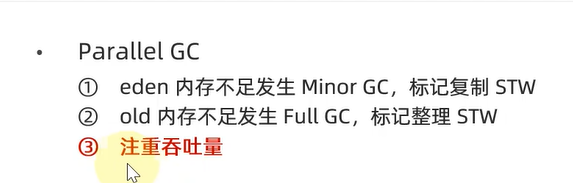
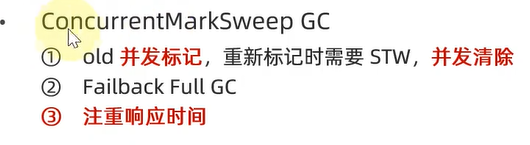
八.垃圾回收器
1.并行GC
2.并发标记GC(废弃)
3.G1GC
jdk9开始作为默认回收器
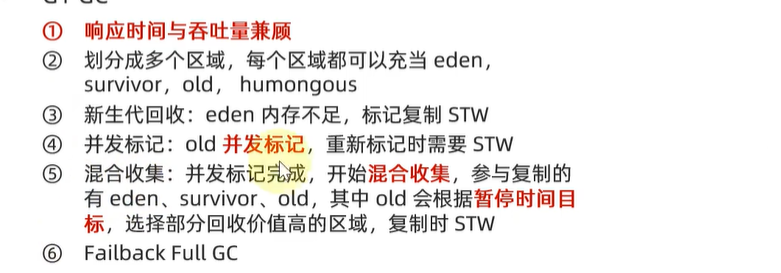
在G1中,eden大概在5%,6%之间,所以eden也是有限的
新生代回收
虚拟机-11-jvm垃圾回收_垃圾回收器_G1 P111 - 04:16
并发标记:混合收集:
虚拟机-12-jvm垃圾回收_垃圾回收器_G1 P112 - 00:24
九.内存溢出
1.误用线程池导致堆内存溢出
2.查询数据量过大,内存溢出
3.动态生成类导致内存溢出
十.类加载过程,双亲委派机制
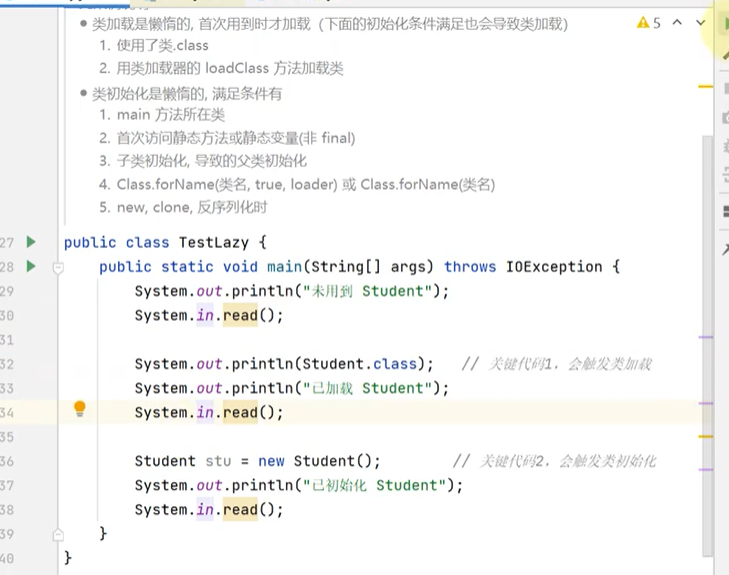
1.加载,链接,初始化
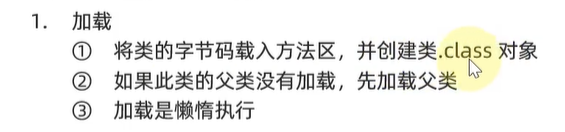
①类的字节码是存在方法区的,但是类的.class对象,也就是类对象(也就是反射的原理)是存在堆中的eden区,最后会被转化到老年代
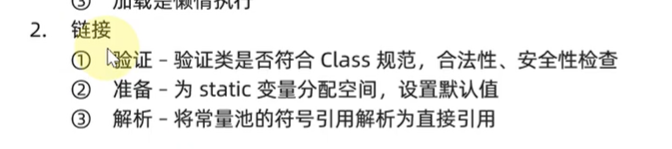
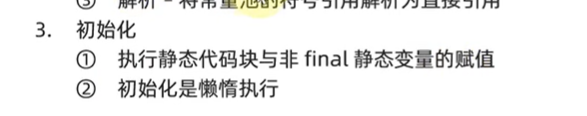
②初始化阶段,静态变量才会完成赋值,而final修饰的静态基本数据类型变量,在加载链接阶段,就完成了赋值。
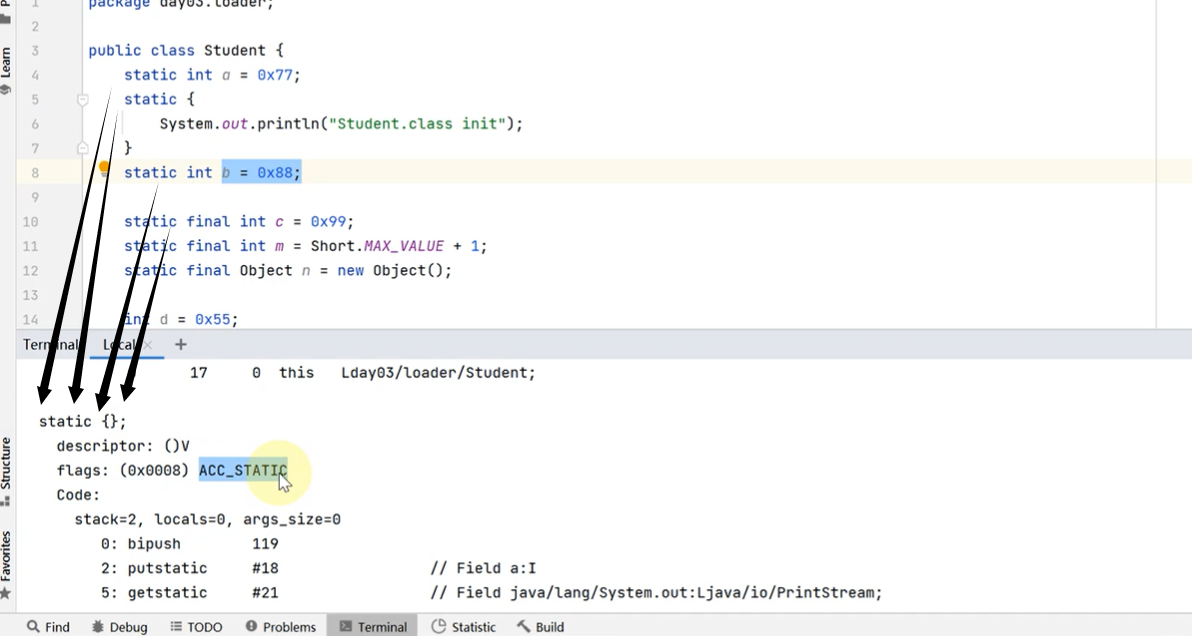
③静态变量的赋值动作,final修饰的引用类型的静态变量赋值动作,还有静态代码块中的语句,按照出现次序由上而下合到一个类的初始化方法中(c init),这个方法在类的初始化阶段被调用
④final修饰的基本类型静态变量,这些变量的赋值是放在声明静态变量时,便已经赋值了
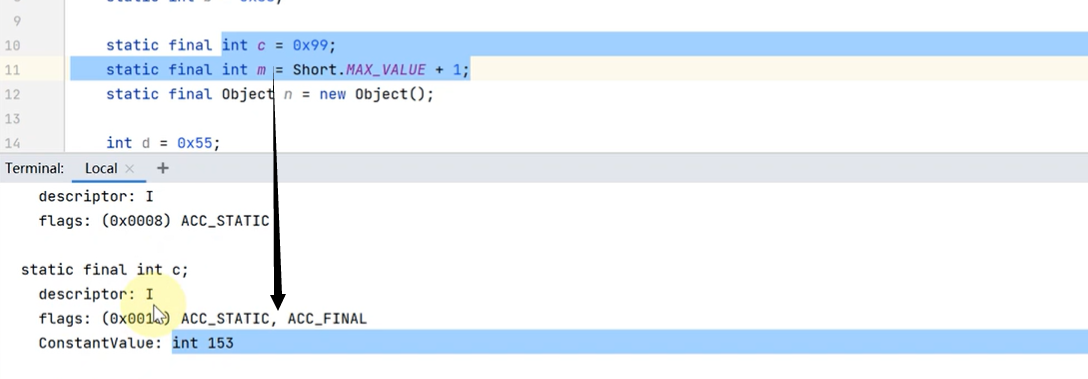
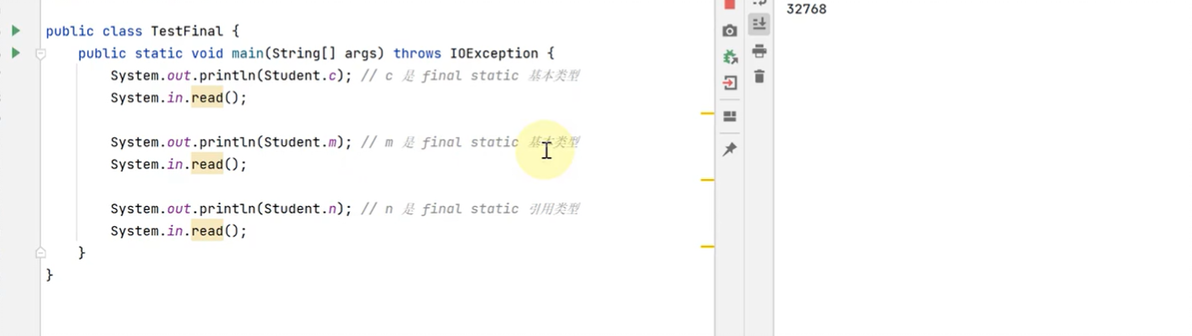
⑤ final修饰的基本数据类型不会触发类的加载,上面的其他情况会,final修饰的基本数据类型,谁用到谁就会赋值这个值到自己的类中。
每个类都有一个自己的常量池
⑥解析:将常量池中的符号引用,变为直接引用(常量池在方法区),
1.7之后,运行时常量池和静态常量池存放在元空间(方法区)中,而字符串常量池存放在堆中。
类的全类名就是常量池中的符号引用,下面这种情况,就是将符号引用变为直接引用
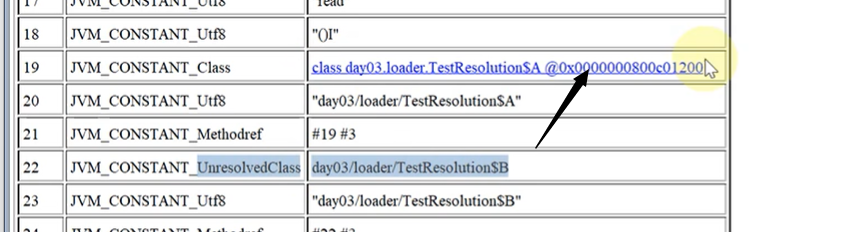
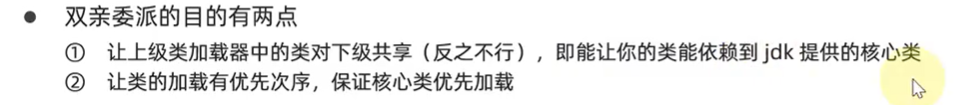
2.双亲委派机制:
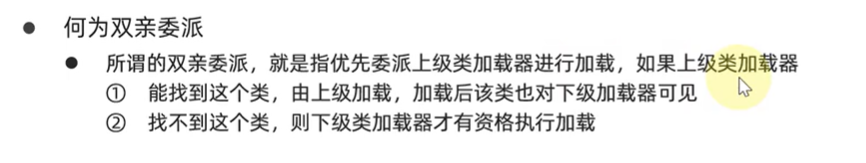
启动类加载器
扩展类加载器(平台类加载器)
应用程序类加载器
自定义类加载器
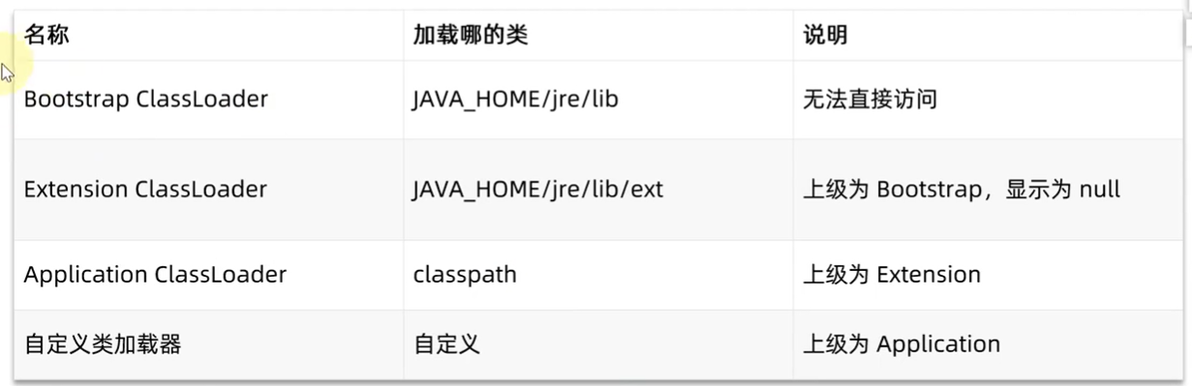
①例如:String.class由启动类加载器加载,Student.class由应用程序类加载器加载。
下级类加载器加载的类对上级是不可见的。
②自己编写类加载器就能加载一个假冒的java.lang.System吗?
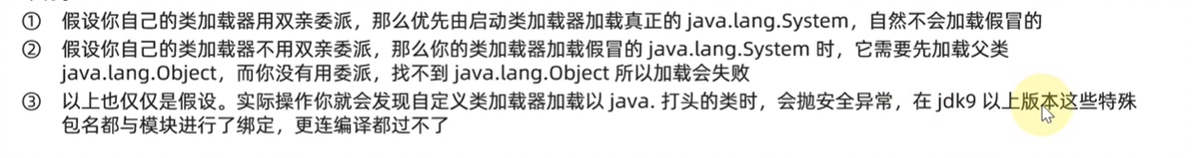
③目的:
十一.对象的四种引用:
1.强引用:
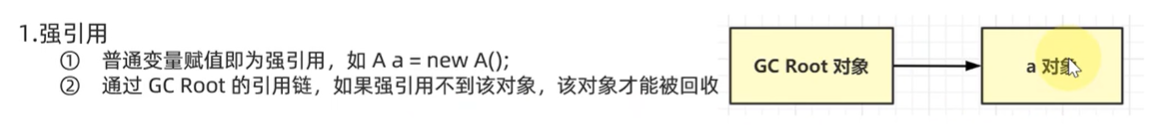
2.软引用:
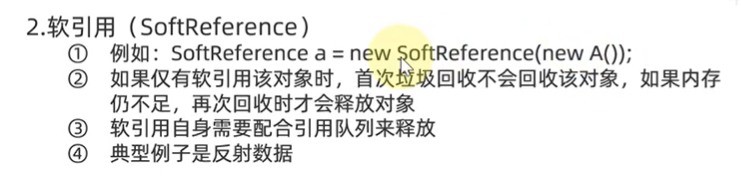
软引用自身是指上面的softReference
反射中用到的大多都是软引用
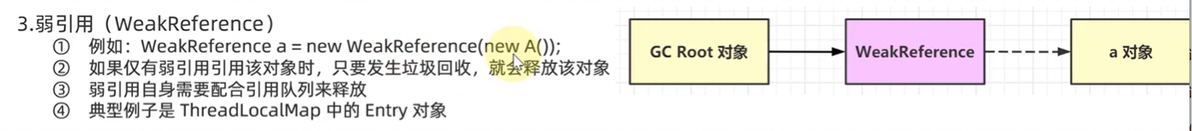
3.弱引用
4.虚引用
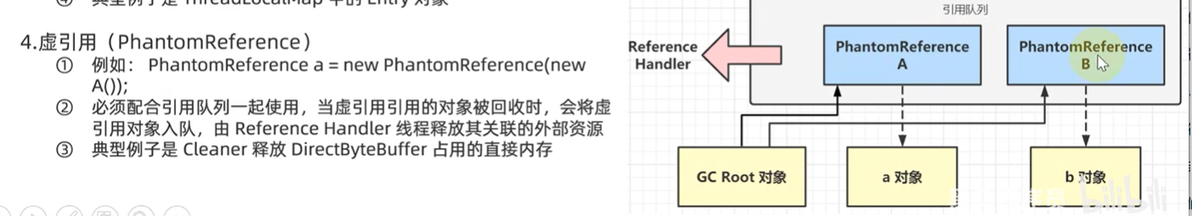
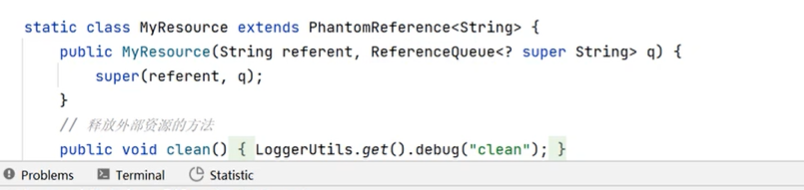
外部资源是指不是java的资源
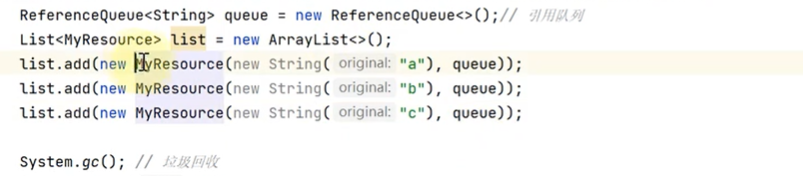
虚引用对象
虚拟机-28-四种引用_虚引用 P128 - 03:01
5.弱引用内存泄漏问题,ThreadLocalMap
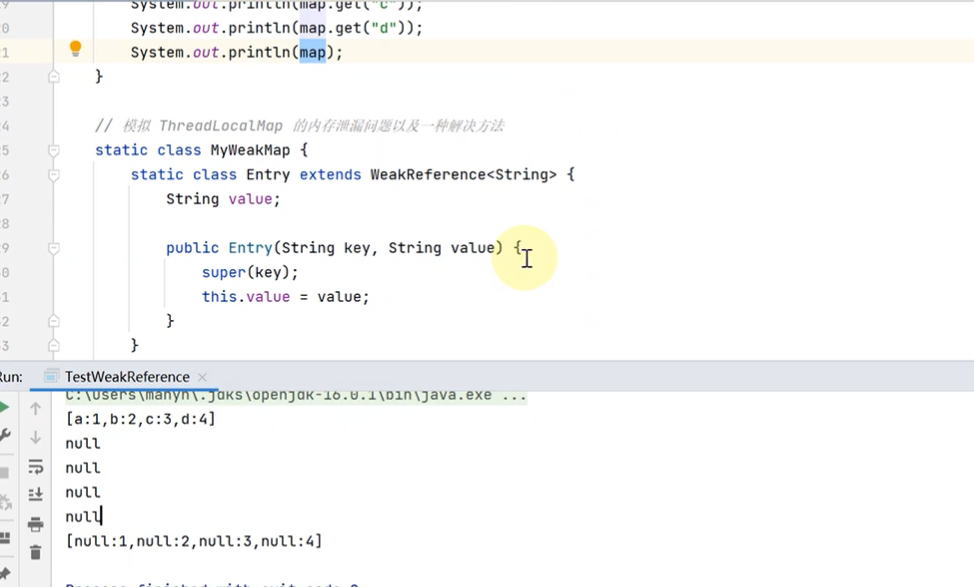
用引用队列可以解决threadlocalMap的内存泄漏问题
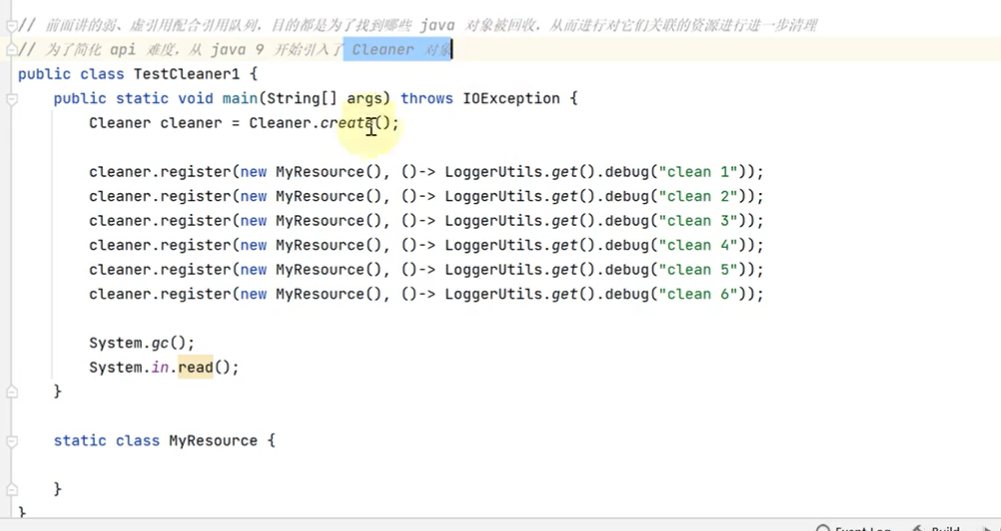
6.Cleaner
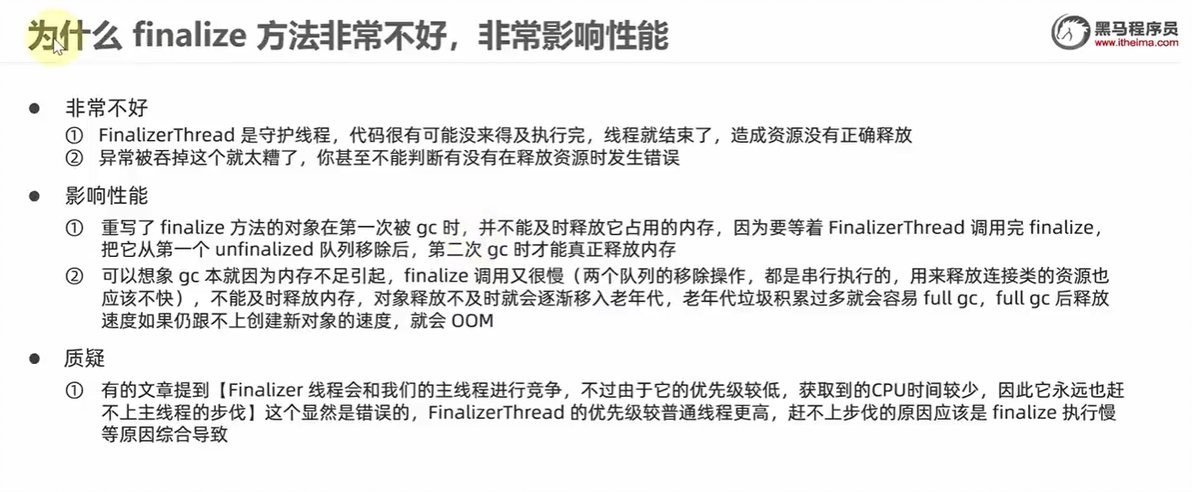
十二:finalize概述
1.概述:
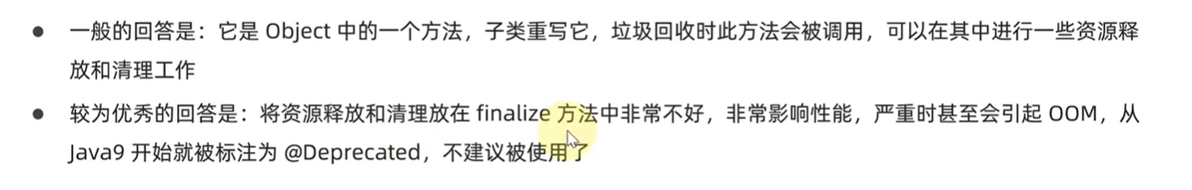
oom 内存溢出
守护线程:如果主线程的代码执行完毕,那么守护线程也会消失
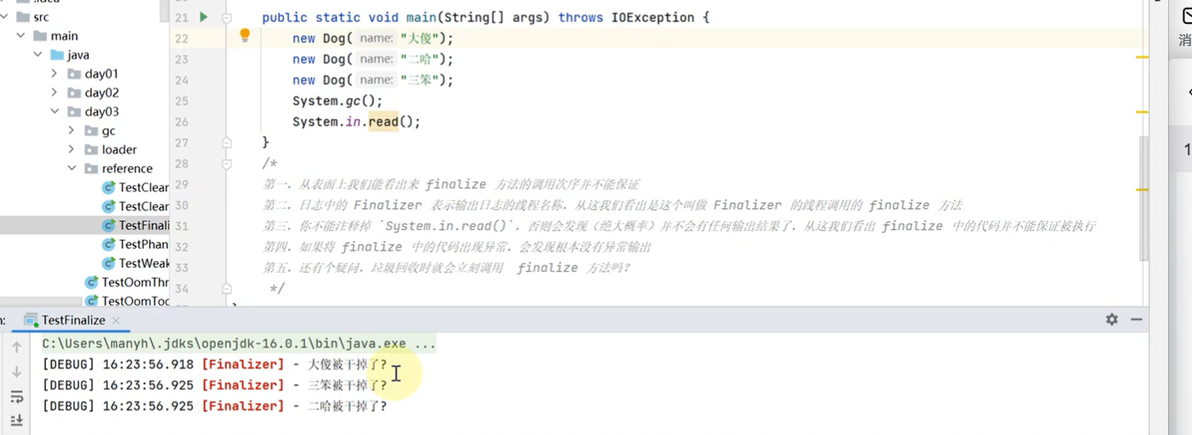
先回收哪个对象,就先调哪个的finalize
出现异常时,吞掉
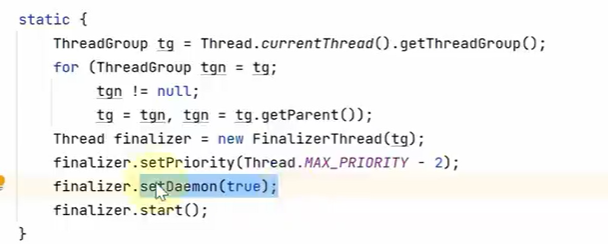
unfinalized链表链入了finalize对象,
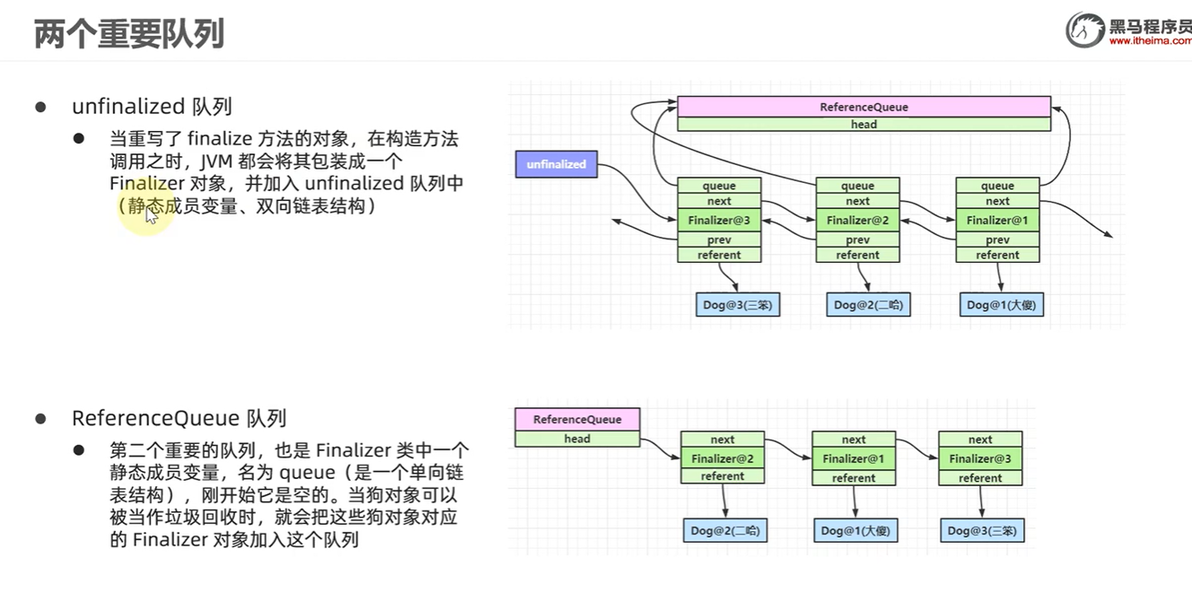
虚软弱它们被加入ReferenceQueue时,它们所关联的对象就已经被回收了,而finalize这种引用,不会被提前回收,一个finalizerThread线程调用了这些对象的finalize方法。
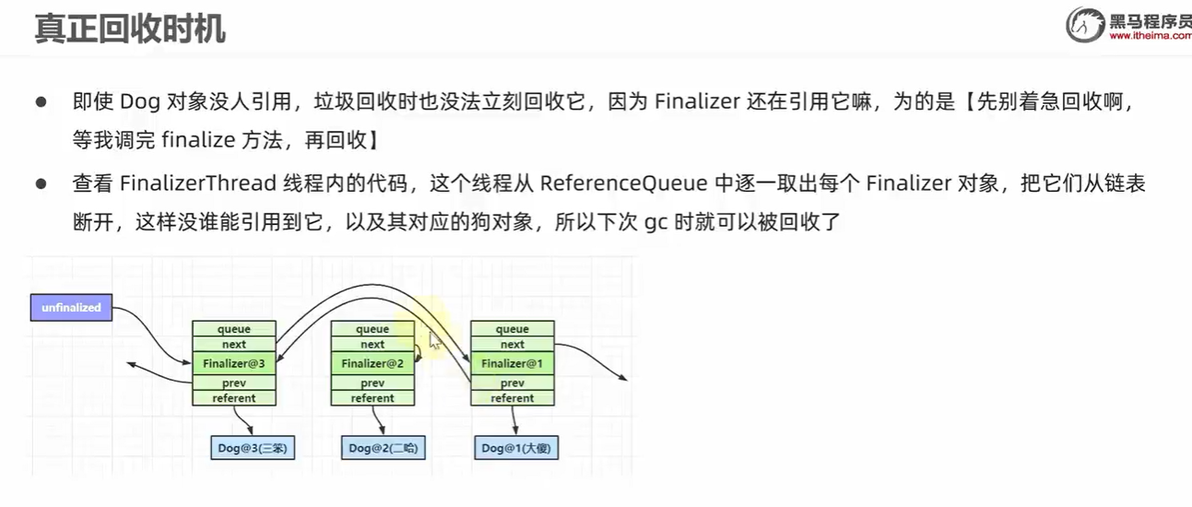
unfinalize:无最终化处理
2.总结: