
参考视频:网页链接,网页链接,网页链接,Mplus网页链接
1 理论框架建构
首先通过文献综述建构理论框架,提出研究假设。这里给出一个案例,如图1所示,“初中生深度学习”案例中提出5条假设。大家也可以通过查阅文献,提出自己的研究假设。
H1:在网络环境下,同伴互动能够正向预测初中生的学习动机。
H2:在网络环境下,同伴互动能够正向预测初中生的批判性思维。
H3:在网络环境下,学习动机能够正向预测初中生的问题解决能力。
H4:在网络环境下,批判性思维能够正向预测初中生的问题解决能力。
H5: 在网络环境下,同伴互动能够正向预测初中生的问题解决能力。
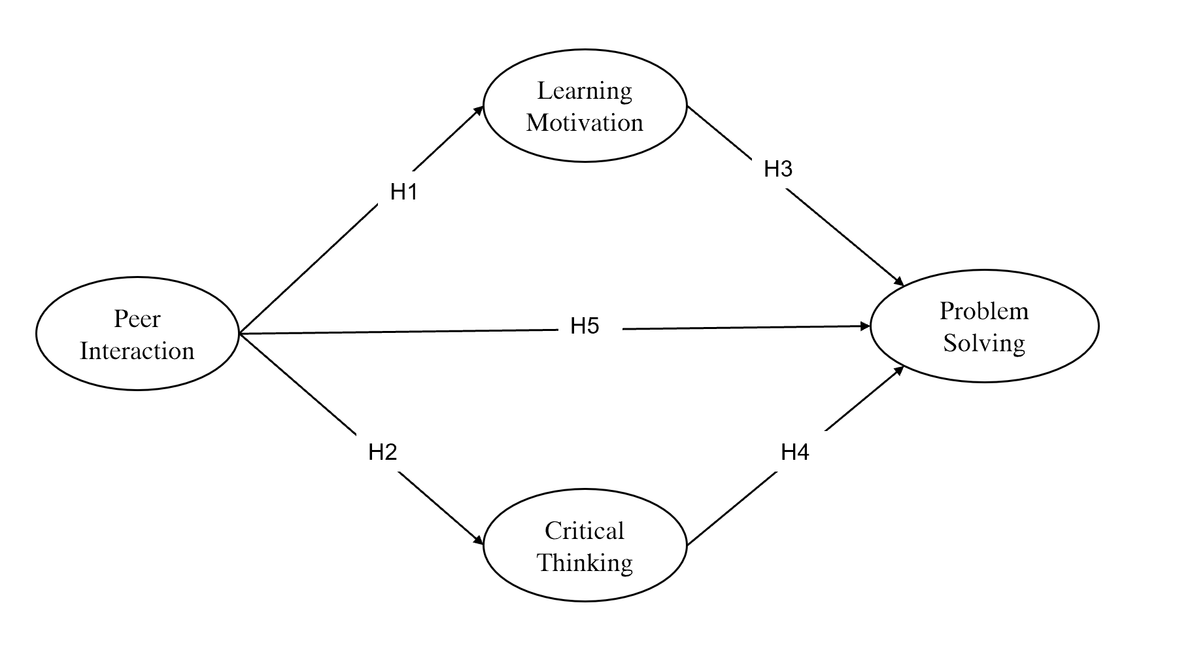
图 1 研究假设举例
2 调查工具开发
针对研究中需要用到的变量,确定调查工具的维度。问卷题项可以根据先前研究问卷改编,或根据访谈、文献等内容自主开发。若自主开发或从英文翻译过来,需要请专家检验内容效度。
3 数据收集
按照一定的取样规则收集问卷数据。可以用问卷星收集,比较方便数据统计。收集之后可以按照测谎题、填写时长等规则对数据进行筛选。对每个题项进行数据的正态性检验,保证偏度绝对值小于1,峰度绝对值小于2[1]。
论文中通常需要呈现样本的基本信息,如性别、年龄等分布情况。
4 问卷信效度检验
分析如果问卷是自主开发,则需要同时进行探索性因子分析(EFA)和验证性因子分析(CFA)。将收集的数据分为两半,一半做EFA,一半做CFA。如果问卷是已有研究制定的,则只需进行验证性因子。
4.1 探索性因子分析(EFA)
4.1.1 SPSS探索性因子分析流程
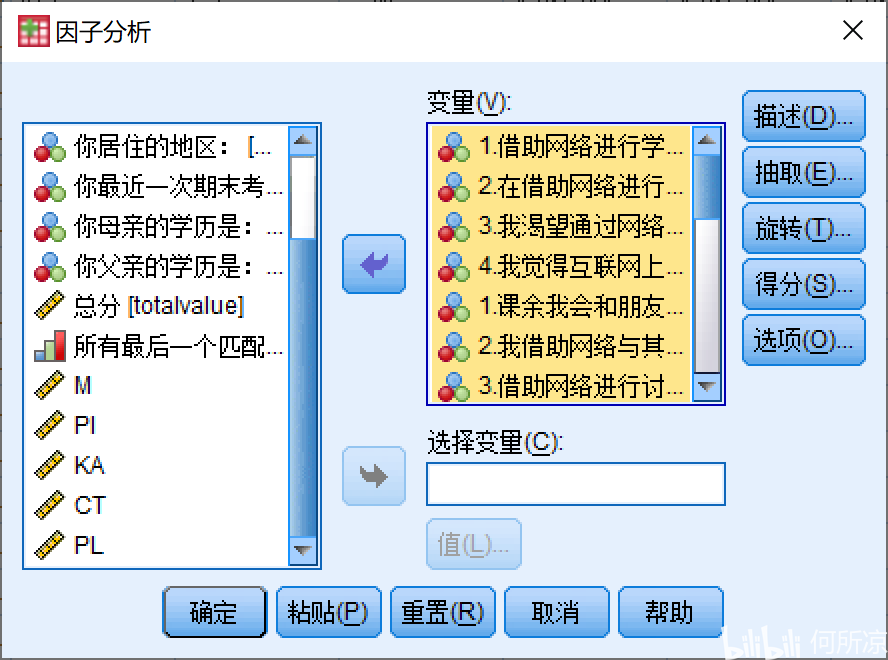
做EFA通常用SPSS。打开数据,点击菜单栏【分析】→【降维】→【因子分析】,打开因子分析主对话框。将要做因子分析的题项(排除基本信息类调查题)选入“变量”框内。
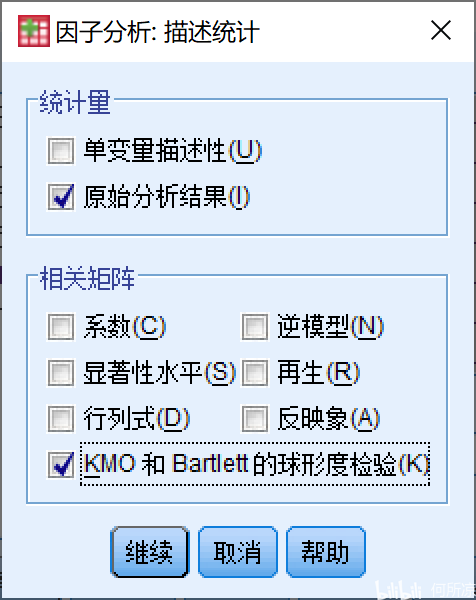
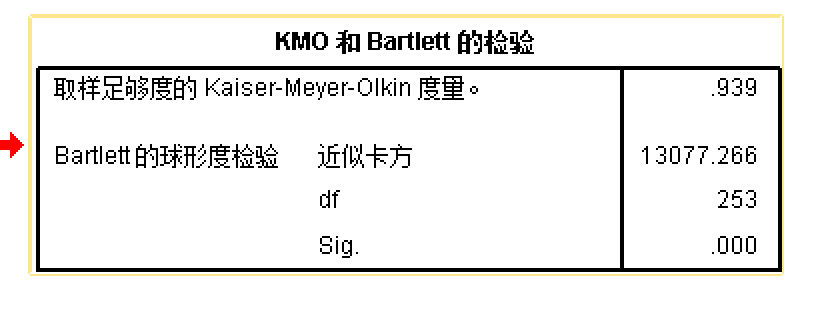
点击右侧【描述】,选中KMO和Bartlett球形检验一项。我们要看一看数据是否适合做因子分析,这是基础工作。点击【继续】。
点击右侧【抽取】,选择因子分析的方法。可以选择【主成分分析】,会得到较好的数据。但【主轴因子分解】的结果要求更高,好一些的期刊通常要求选择主轴因子分解。
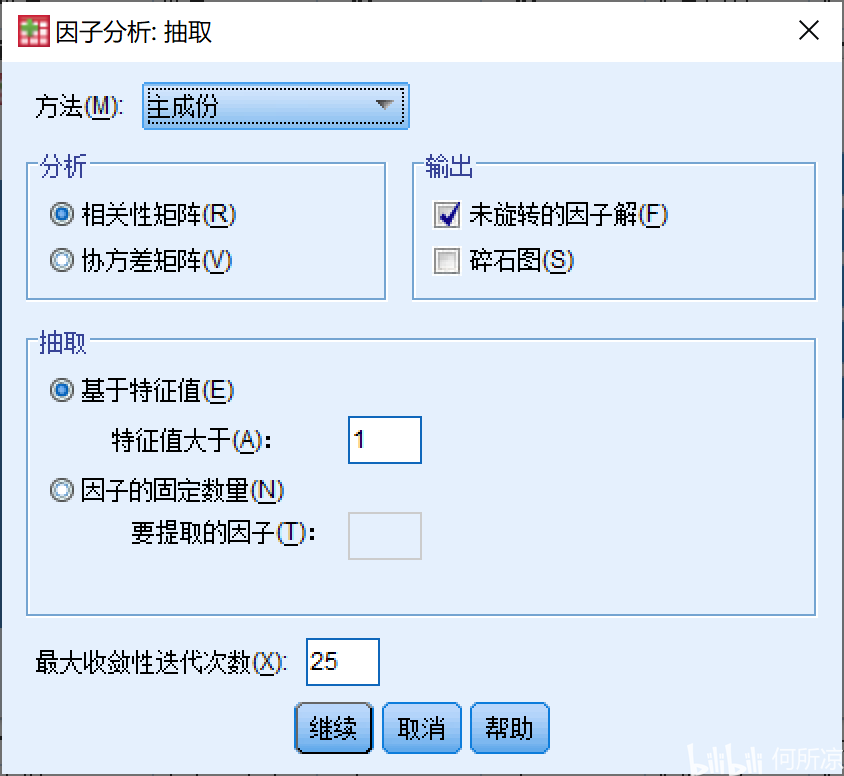
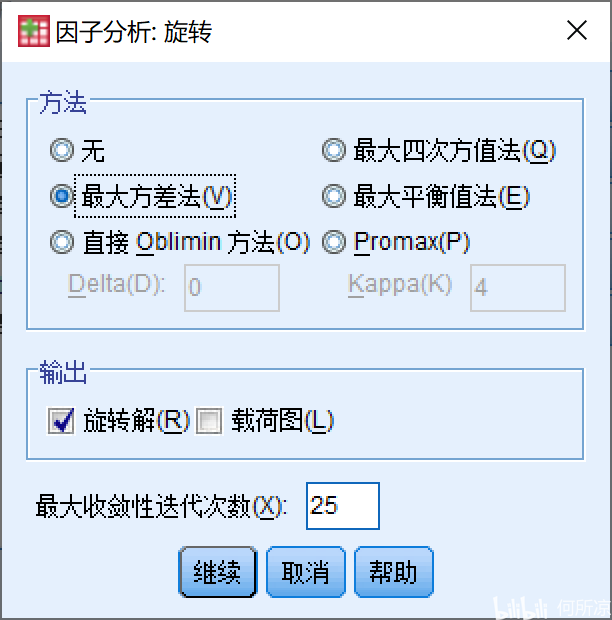
点开【旋转】对话框,为方便对公因子的实际含义进行提炼归纳,可以直接做最大方差的旋转。但好的期刊可能要求较高,需要采用直接Oblimin方法。
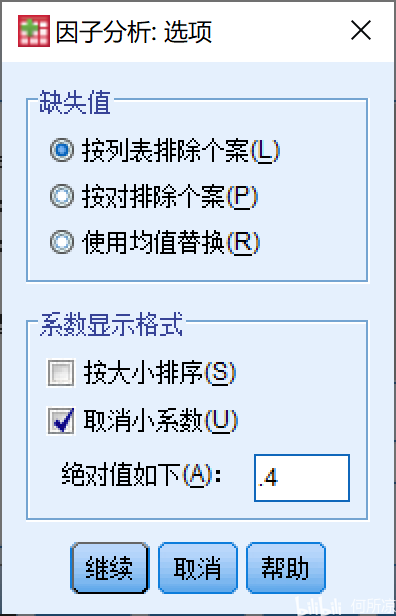
点开【选项】对话框,我们选择隐去小于0.4的载荷,便于观察公因子和变量间的关系。
点击【继续】,回到因子分析主对话框。点击【确定】,进行因子分析。查看分析结果。
4.1.2 探索性因子分析结果解读
KMO在0.9上非常合适做因子分析:0.8-0.9之间适合:0.7-0.8之间适合:0.6-0.7之间尚:0.5-0.6之间表示差:0.5下应该放弃。解释总方差越大越好。
看旋转成分矩阵。题项不能同时在两个成份上载荷都高于0.5,且不能在自己所属的成份上载荷过低。若载荷不满足要求,则挨个删除题项,重新分析。直到得到满意的结果。案例中得到4个主成分,意味着问卷的所有题项被分为4个维度。探索性因子分析得到的四个维度与问卷设计是一致的,说明具有良好的结构效度。如果旋转后的成分矩阵和维度划分是不一致的,可以考虑重新做问卷或者使用成熟的问卷重新发放(这就又回到了问卷设计阶段)。
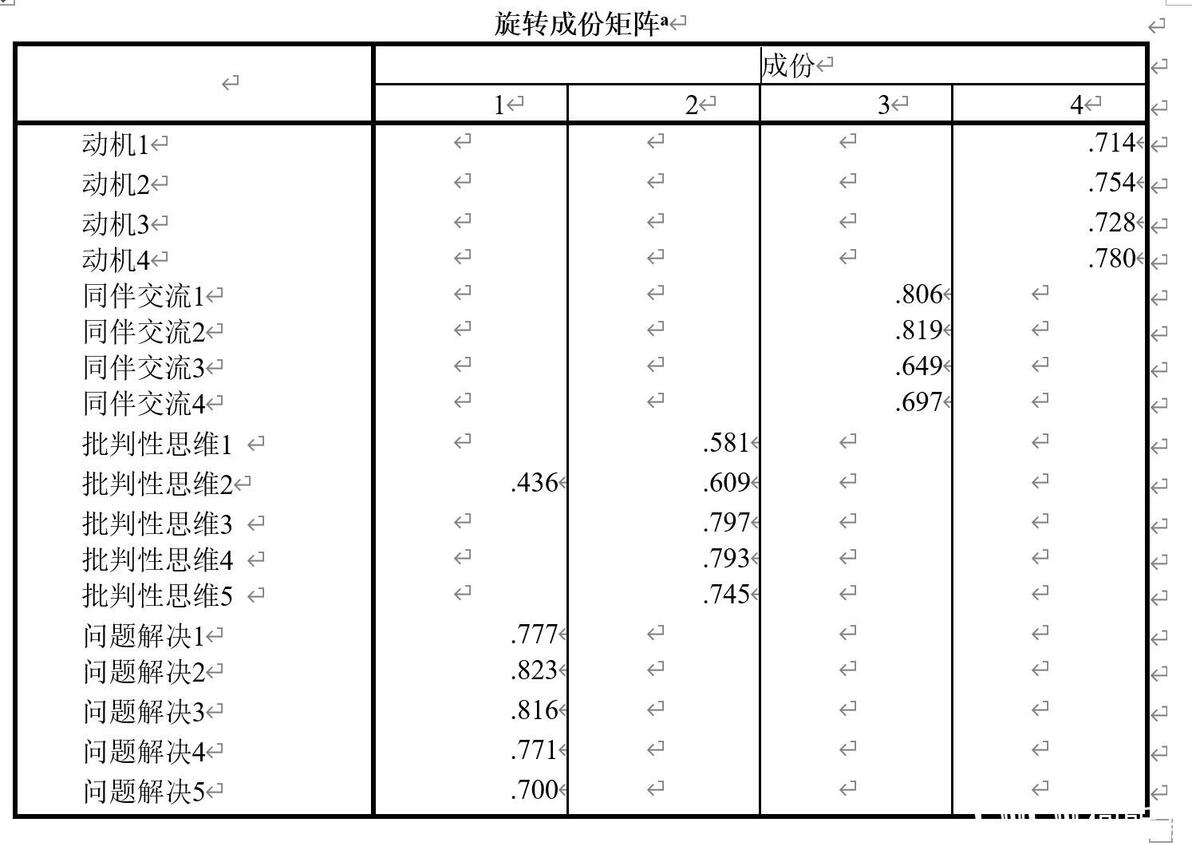
探索性因子分析结果
4.2 验证性因子分析
4.2.1 Mplus验证性因子分析流程
CFA的进行必须有特定的理论观点或概念架构作为基础。如果你的模型是别人已经研究过的模型,同时,你的各变量的题项是确定的(参考别人的),各变量的维度也是被验证过的,同时各维度的题项也是已知的,通过检验的(有人用过的),可以用CFA。
用Mplus进行验证性因子分析,首先需要把数据存储为.dat格式或.csv格式。注意不要保留变量名。
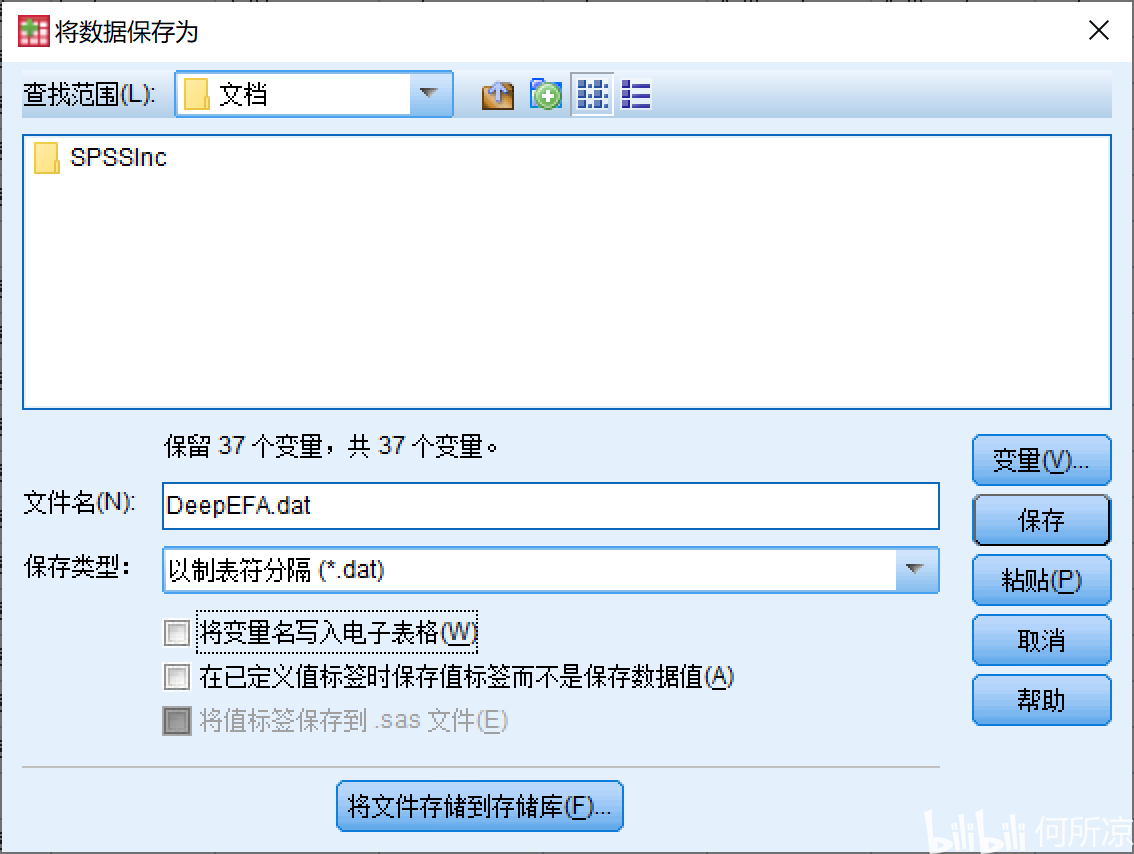
打开Mplus,新建一个文件。如下图所示,输入代码。图中给出了代码的简单解释,大家有需要可以在给出的案例文件DeepCFA.dat中的代码基础上改动。
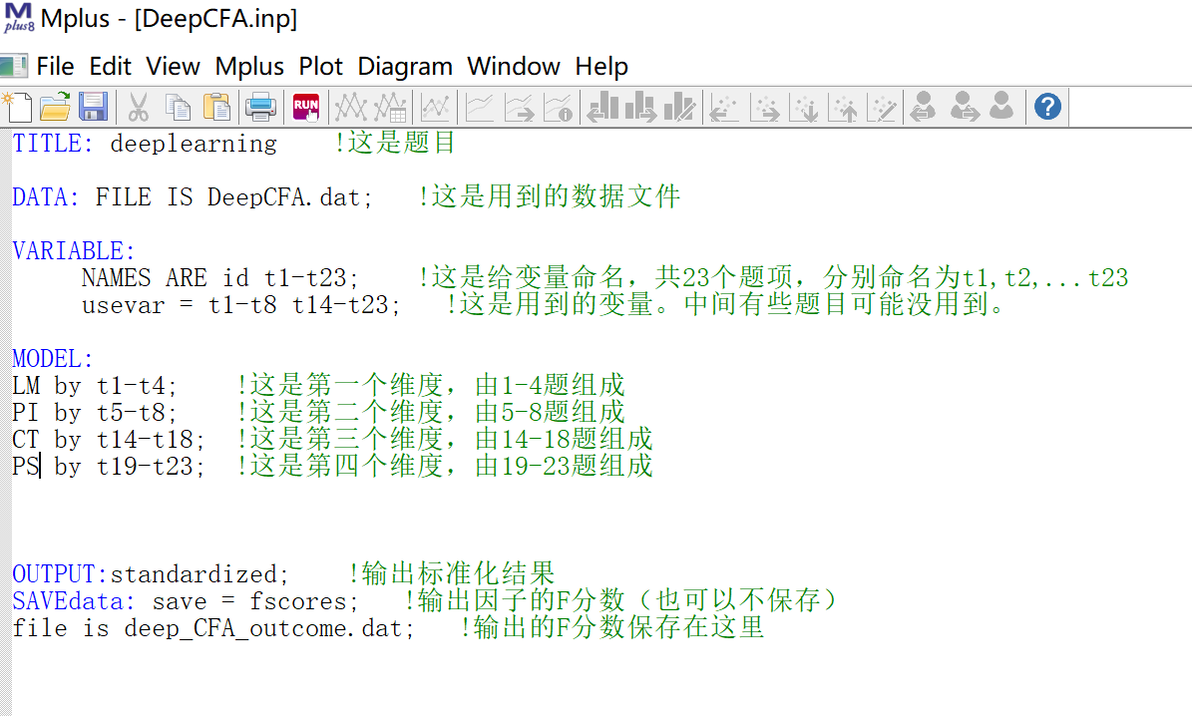
点击红色图标RUN,开始运行。
4.2.2 验证性因子分析结果解读
查看MODEL FIT INFORMATION。数据需要达到的标准:χ2/df (<5), Root Mean Square Error of Approximation (RMSEA) (< 0.10), Standardized Root Mean Square Residual (SRMR) (< 0.05), Comparative Fit Index (CFI) (> 0.90), Tucker-Lewis Index (TLI) (> 0.90)[2]。表明问卷具有良好的结构效度。
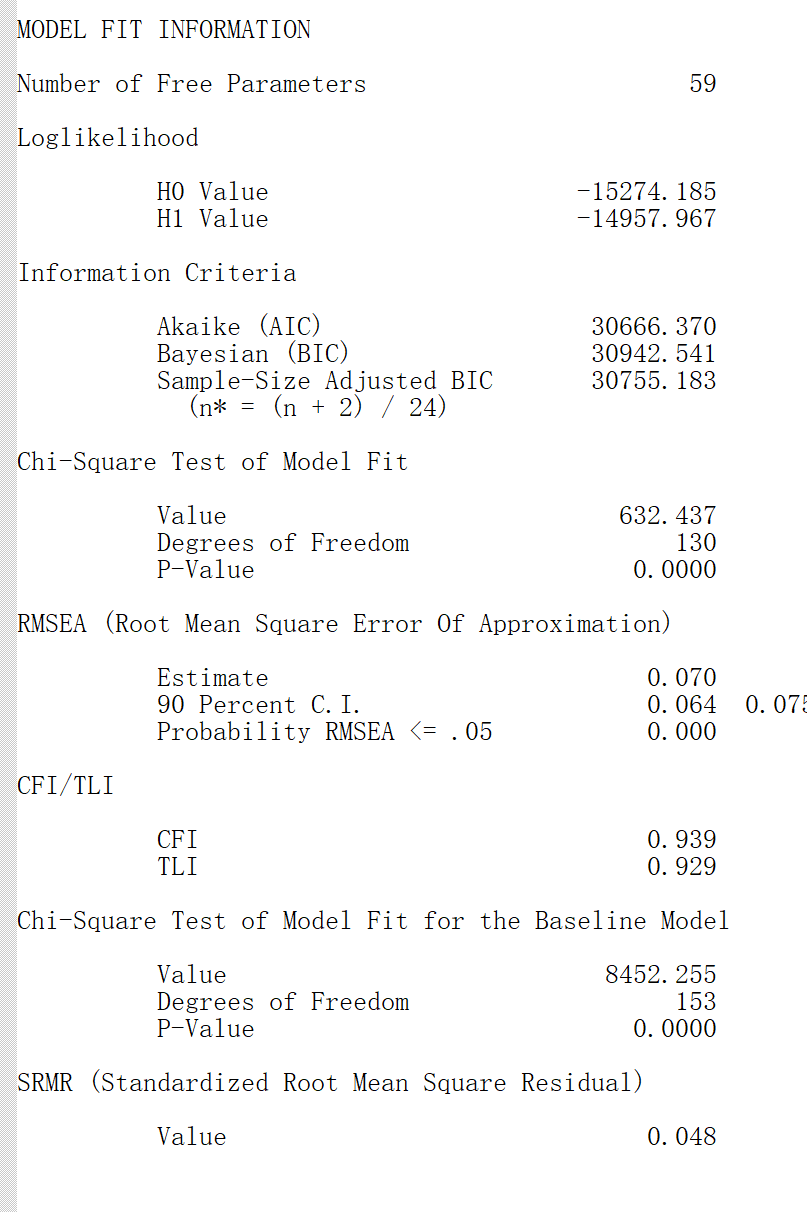
在STANDARDIZED MODEL RESULTS中查看因子载荷(Estimate),越高越好,一般来说不能低于0.5。
根据因子载荷计算Average Variance Extracted (AVE) (> 0.5) 和 Construct Reliability (CR) (> 0.7),看问卷是否具有良好的收敛效度。(AVE和CR的计算方式在文件夹中的EXCEL表中提供)
AVE平方根要大于因子间相关,表明问卷具有良好的区分效度。
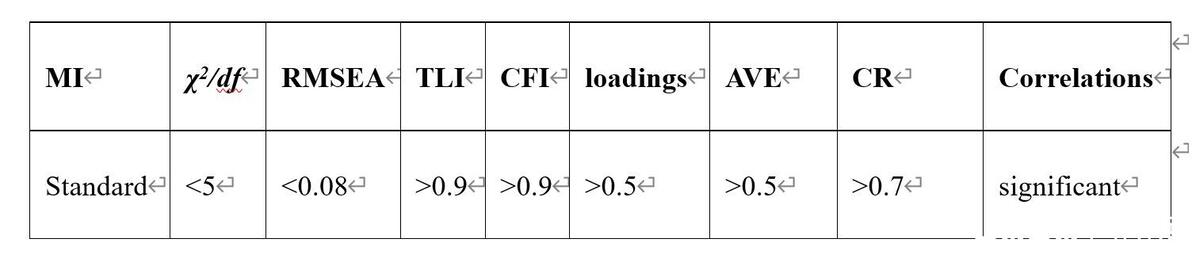
模型拟合指标
4.3 信度检验
使用SPSS可以进行内部一致性信度Cronbach’s alpha系数检验。操作步骤为:点击【度量】-【可靠性分析】,把问卷中的题目放到信度分析的选项框中就可以。Cronbach’s alpha系数值得范围以及信度的效果:0.80~0.90非常好0.70~0.80相当好;0.65~0.70最小可接受值;0.60~0.65最好不要[3]。(不同的参考文献对于这个系数的要求也不同,一般来说,Cronbach’s alpha系数大于0.7都是可以接受的)
5 结构方程模型检验
5.1 Mplus结构方程模型检验流程
当我们问卷的变量之间具有显著相关时,我们就可以探究变量之间的预测作用。此时跟CFA流程类似,不同的是代码要体现变量之间的关系。根据我们最初的五条假设,在CFA的基础上添加变量之间关系的代码,见下图绿色注释。大家有需要可以在给出的案例文件DeepSEM.dat中的代码基础上改动。
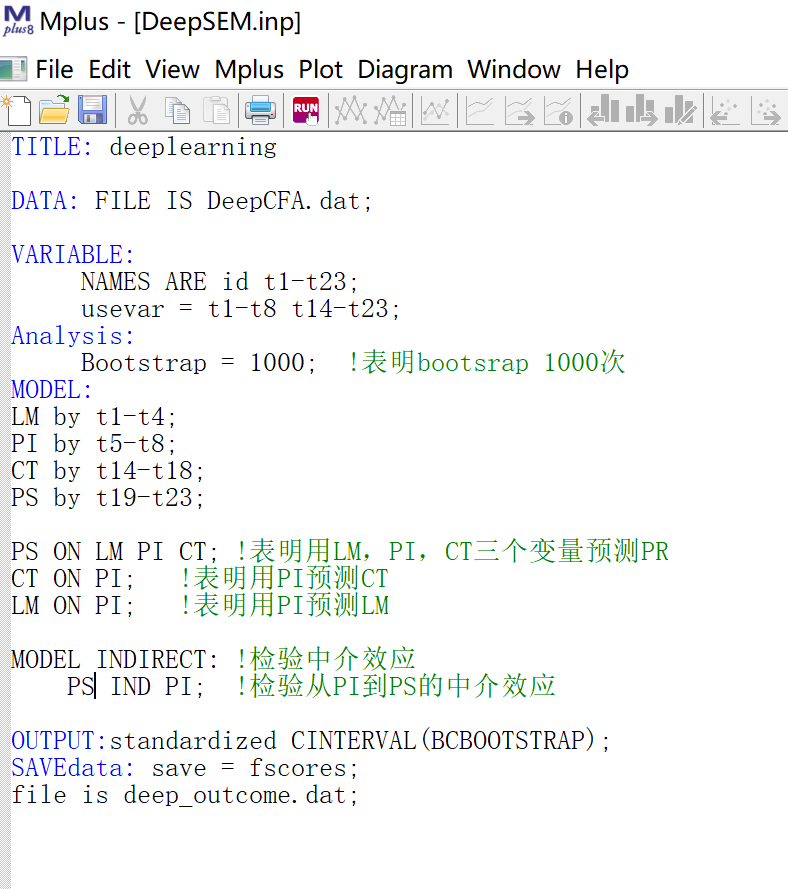
点击上方红色按钮【RUN】,开始运行。
5.2 结构方程模型结果解读
与CFA一样,数据需要达到的标准:χ2/df (<5), Root Mean Square Error of Approximation (RMSEA) (< 0.10), Standardized Root Mean Square Residual (SRMR) (< 0.05), Comparative Fit Index (CFI) (> 0.90), Tucker-Lewis Index (TLI) (> 0.90)。表明结构方程模型拟合指数良好。
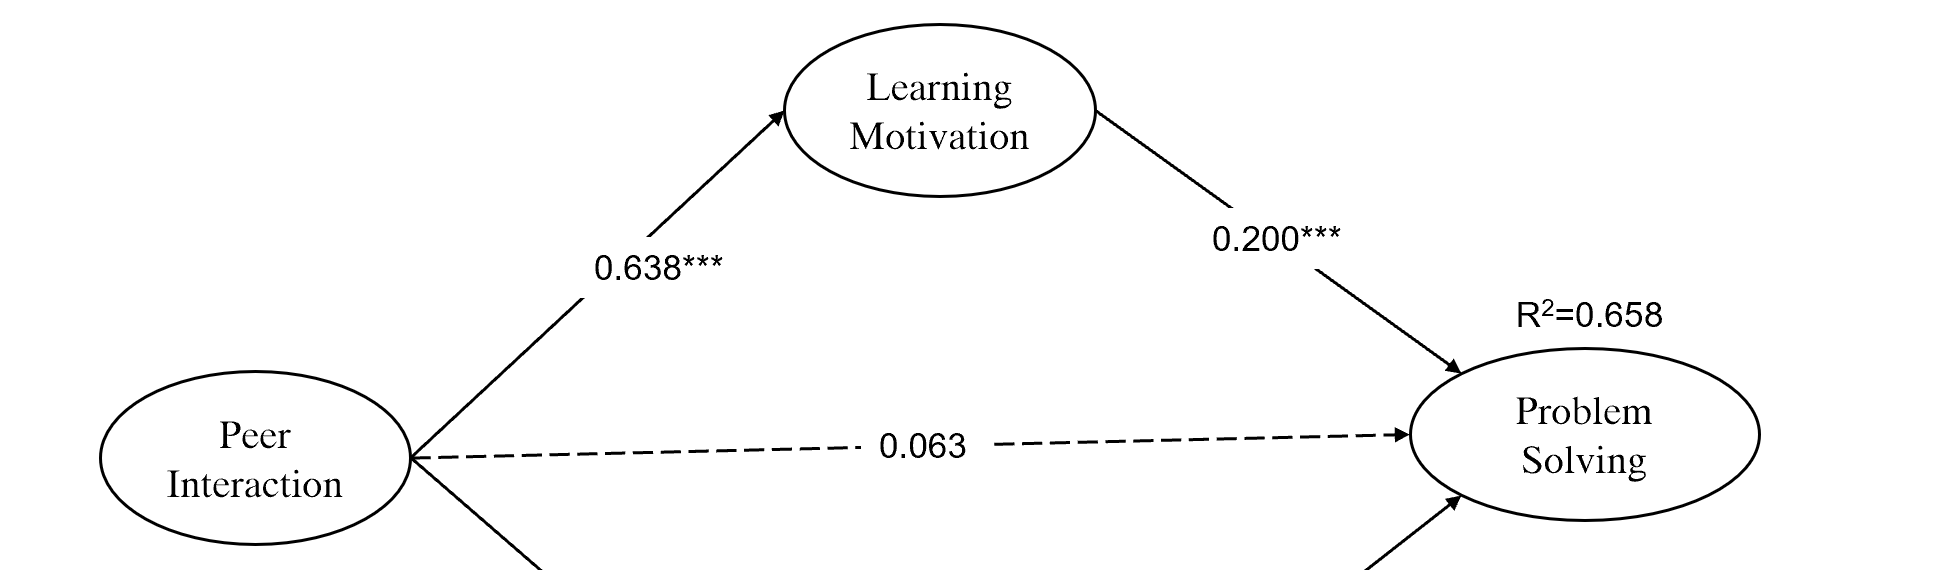
在结果中找到STDYX标准化结果,查看路径的显著性。若显著,则说明预测作用成立。若不显著,则该条研究假设不成立。结果中也能够找到R方值、中介效应、调节效应值,可以根据需要呈现(具体操作可根据需要查看文件夹中提供的电子书)。根据结果解读该条研究假设成立或不成立的可能原因,并用相关研究进行支撑。
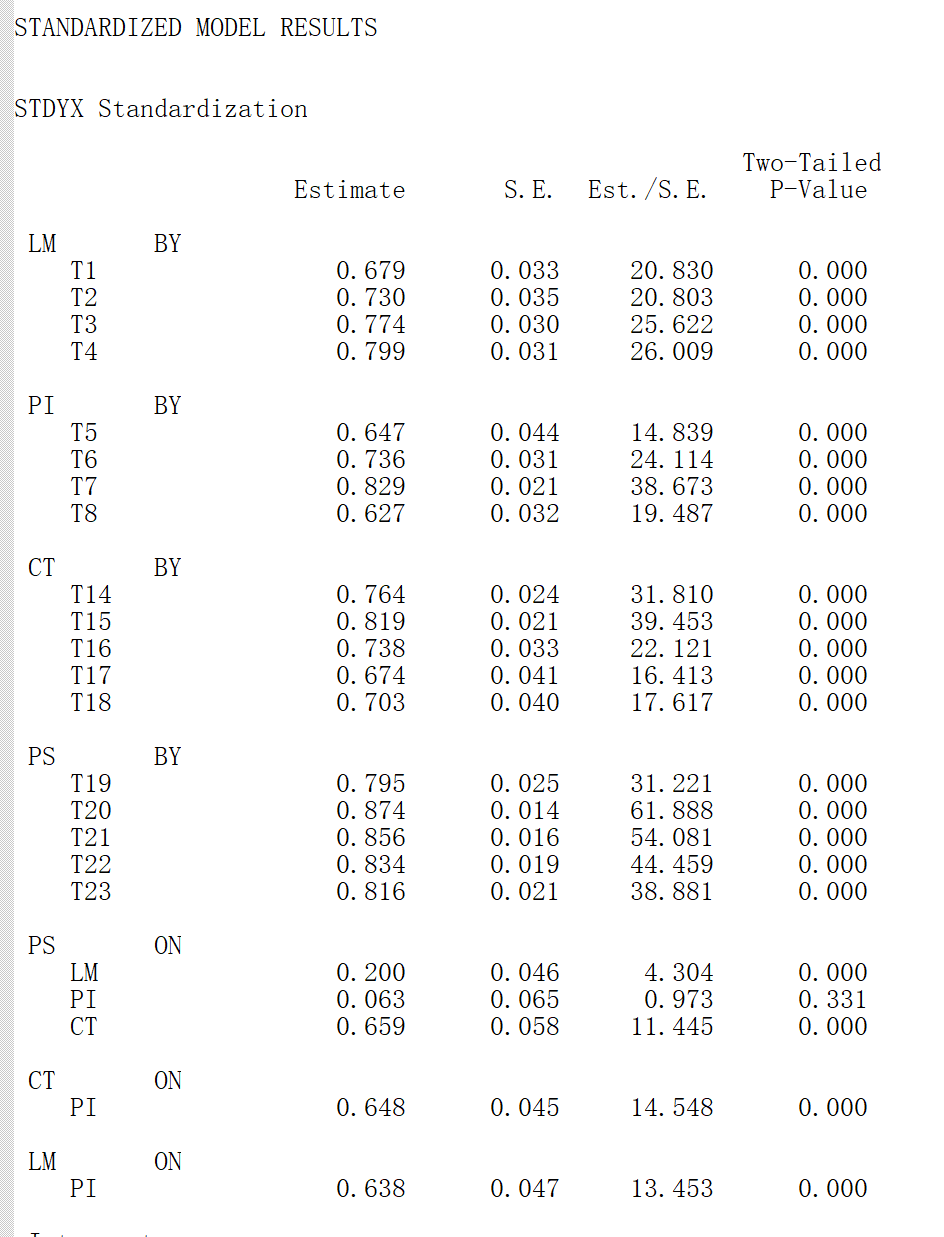
点击菜单栏【Diagram】,可以查看模型结果图。
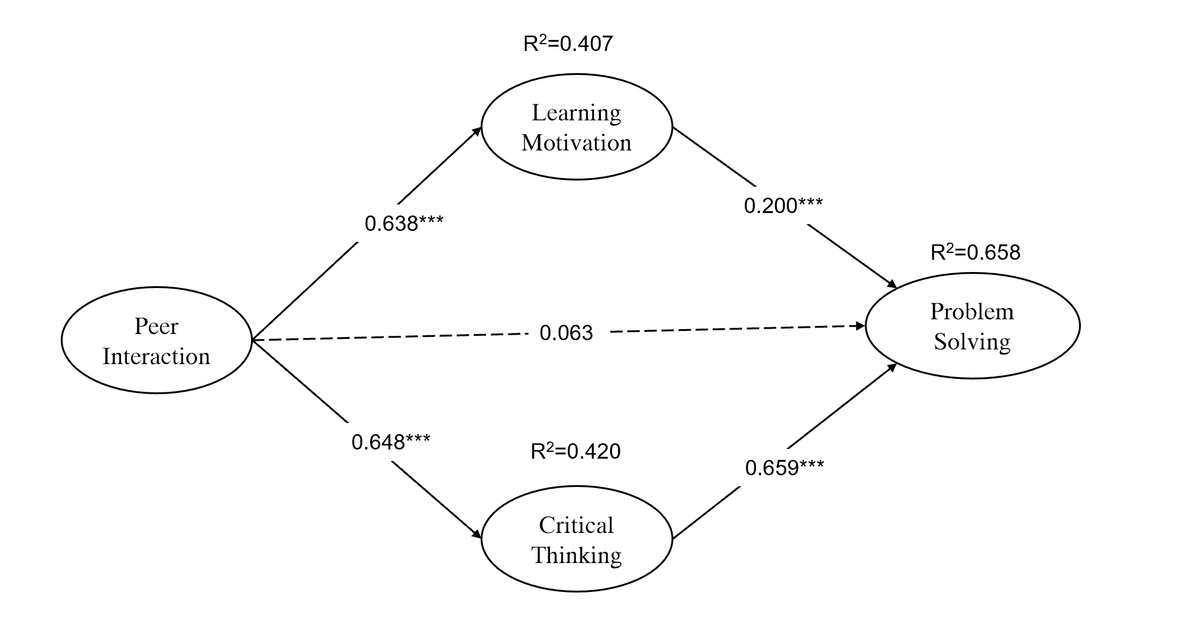
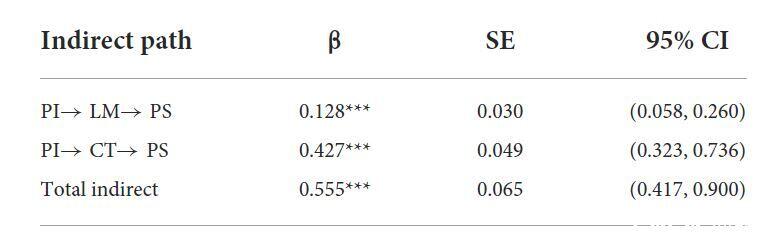
中介效应检验过程见视频MPLUS中介效应检验。中介效应检验结果呈现示例:
[1] Noar, S. M. (2003). The role of structural equation modeling in scale development. Structural Equation Modeling: A Multidisciplinary Journal, 10(4), 622-647.
[2] Hair, J. F., Black, B., Babin, B. J., & Anderson, R. (2014). Multivariate data analysis. Prentice Hall.
[3] Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 24(2), 337-346. http://doi.org/10.2307/3151312
源代码:
TITLE: deeplearning
DATA: FILE IS DeepCFA.dat;
VARIABLE:
NAMES ARE id t1-t23;
usevar = t1-t8 t14-t23;
Analysis:
Bootstrap = 1000; !表明bootsrap 1000次
MODEL:
LM by t1-t4;
PI by t5-t8;
CT by t14-t18;
PS by t19-t23;
PS ON LM PI CT; !表明用LM,PI,CT三个变量预测PR
CT ON PI; !表明用PI预测CT
LM ON PI; !表明用PI预测LM
MODEL INDIRECT: !检验中介效应
PS IND PI; !检验从PI到PS的中介效应
OUTPUT: standardized CINTERVAL(BCBOOTSTRAP);
SAVEdata: save = fscores;
file is deep_outcome.dat;
关于分析结果如何在论文中呈现,分享我的几篇论文作参考: https://link.springer.com/article/10.1007/s10639-022-11286-z https://www.frontiersin.org/articles/10.3389/fpsyg.2022.978144/full https://link.springer.com/article/10.1007/s10639-022-11084-7
