彻底

00:40
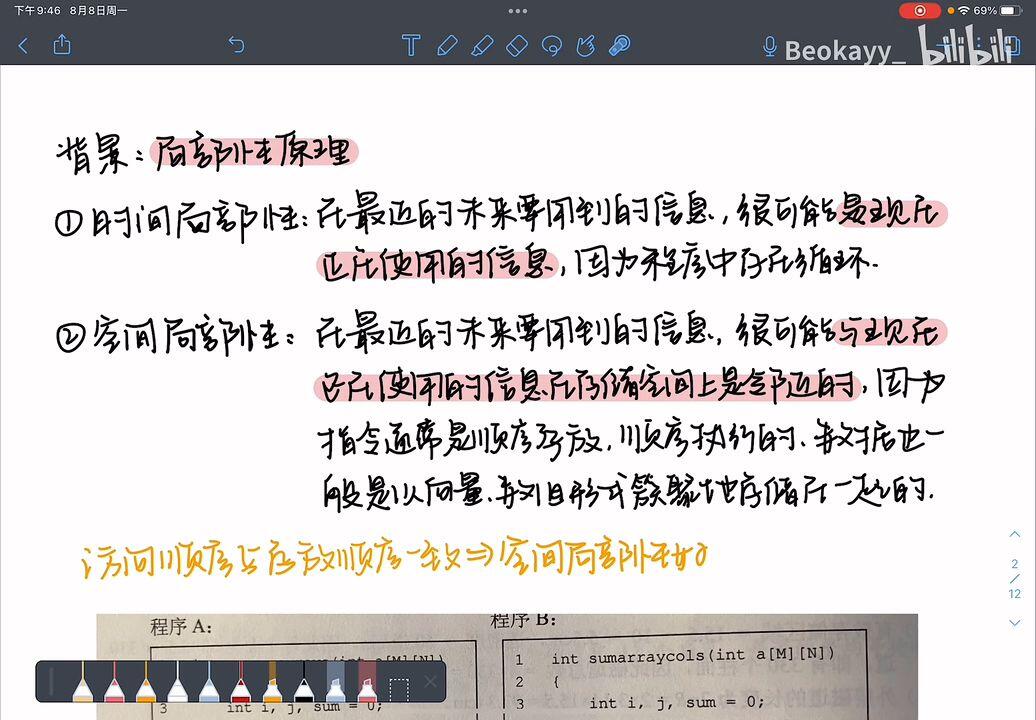
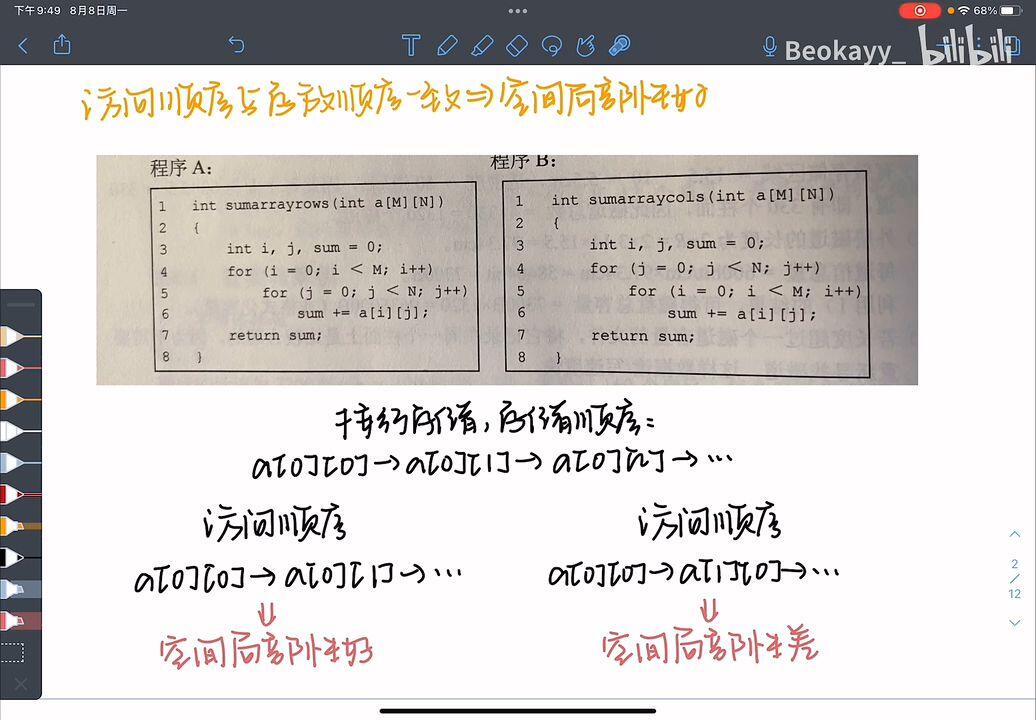
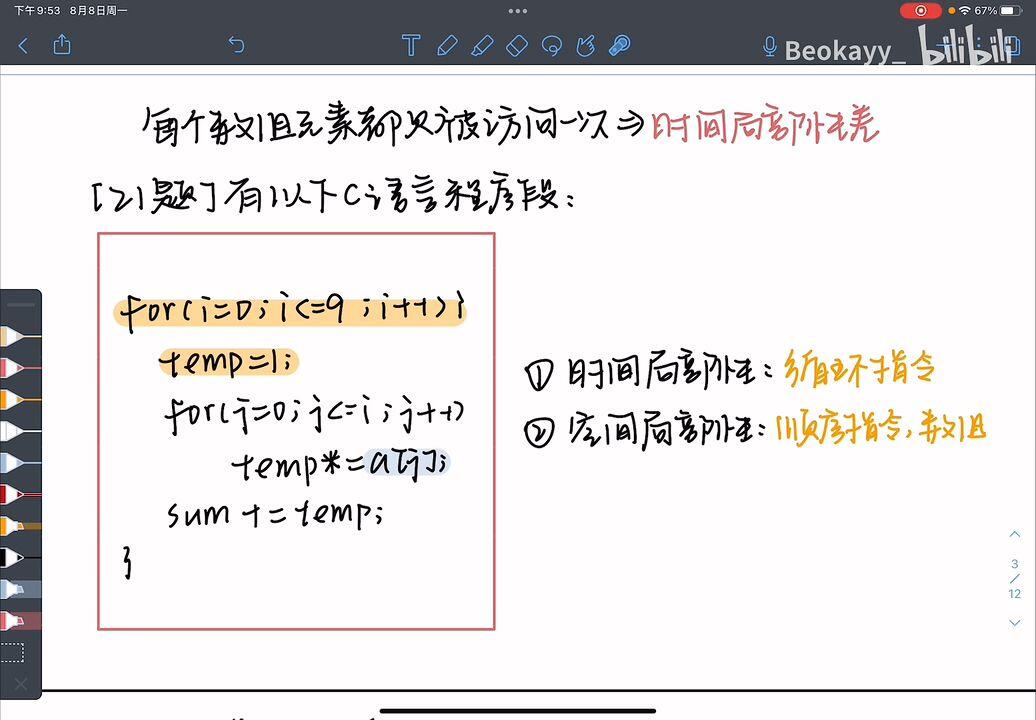
访问顺序与存放顺序保持一致的话,代表空间局部性好。
01:42
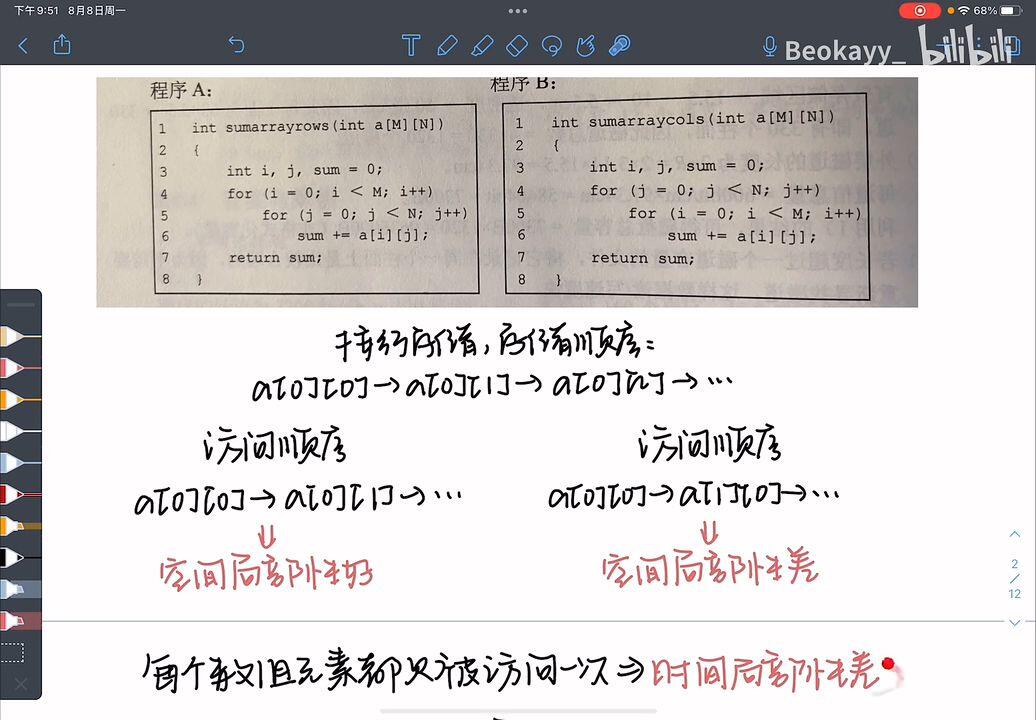
两个程序的时间局部性都很差,因为每个数组元素都只被访问了一次。
04:23
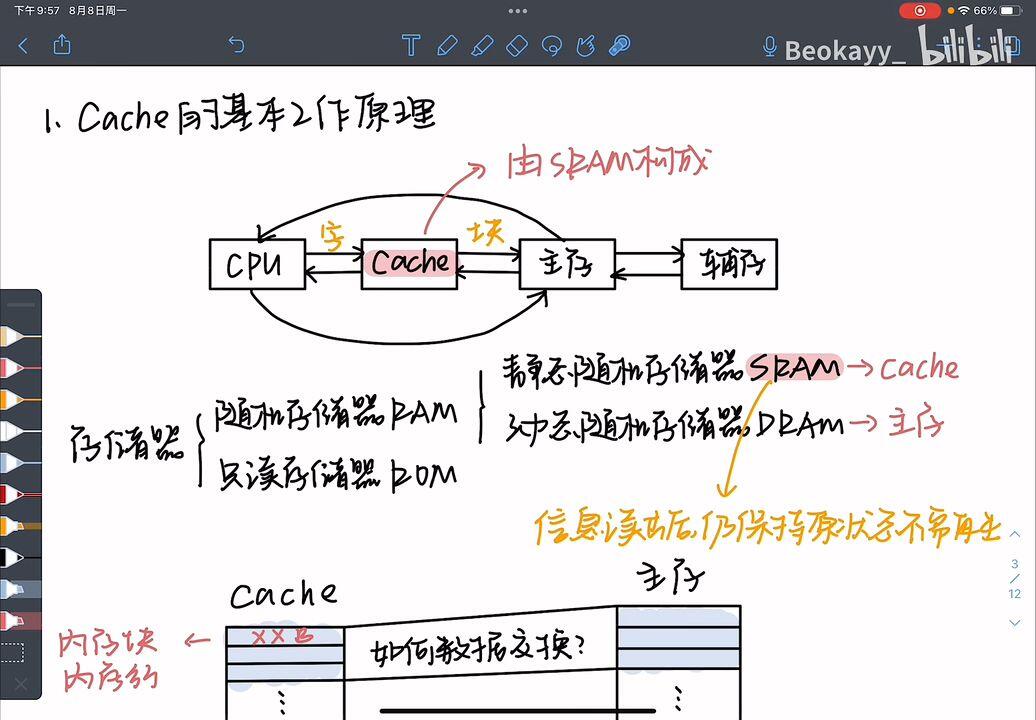
SRAM是非破坏性的读出
05:36 cache和主存的映射方式
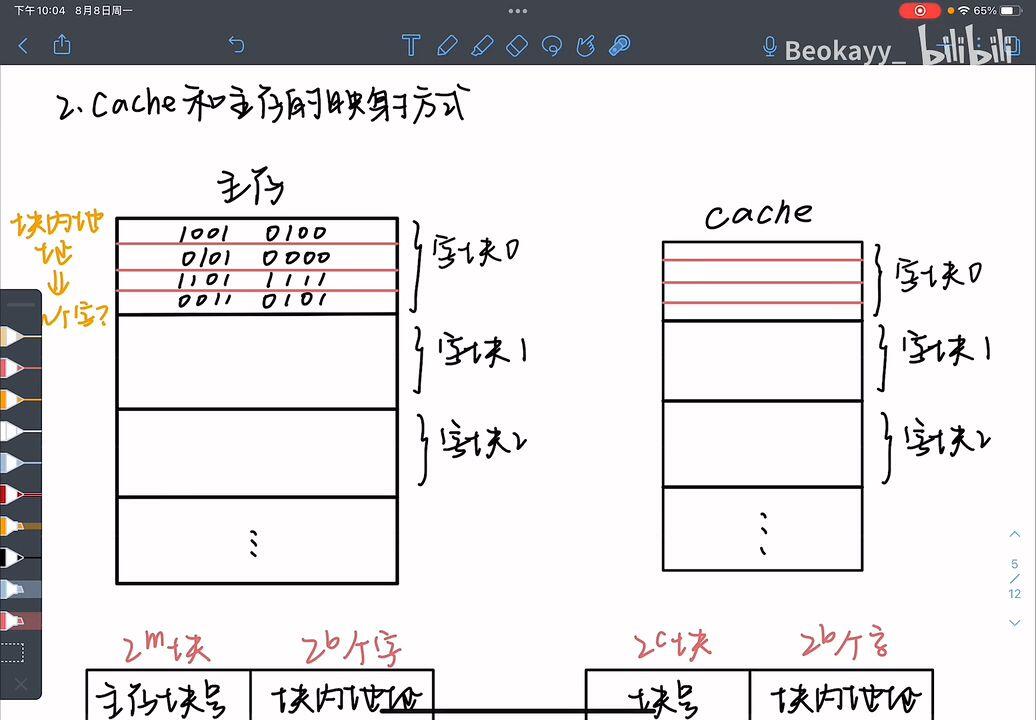
为什么要映射
cache的位数比主存的地址位数要小
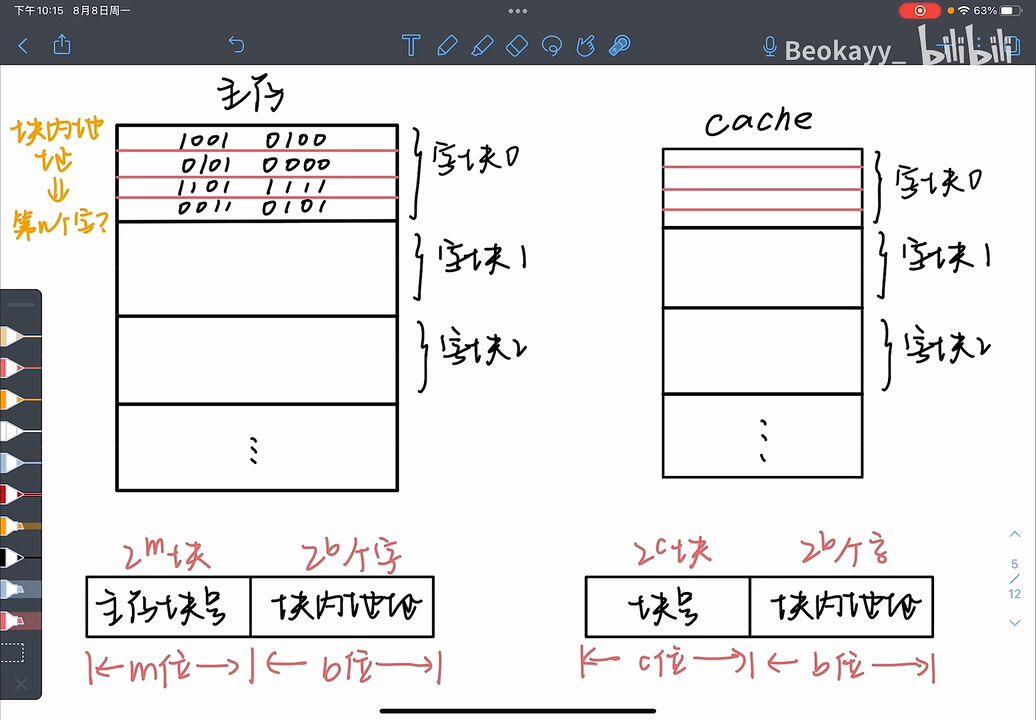
块内地址,第几个字
首先定位在哪个块,然后定位在块内的第几个字。
这就相当于分页管理,指令相对于页面,找它在哪个页面里面,然后还有一个页内偏移量,看它在页面的第几条指令。
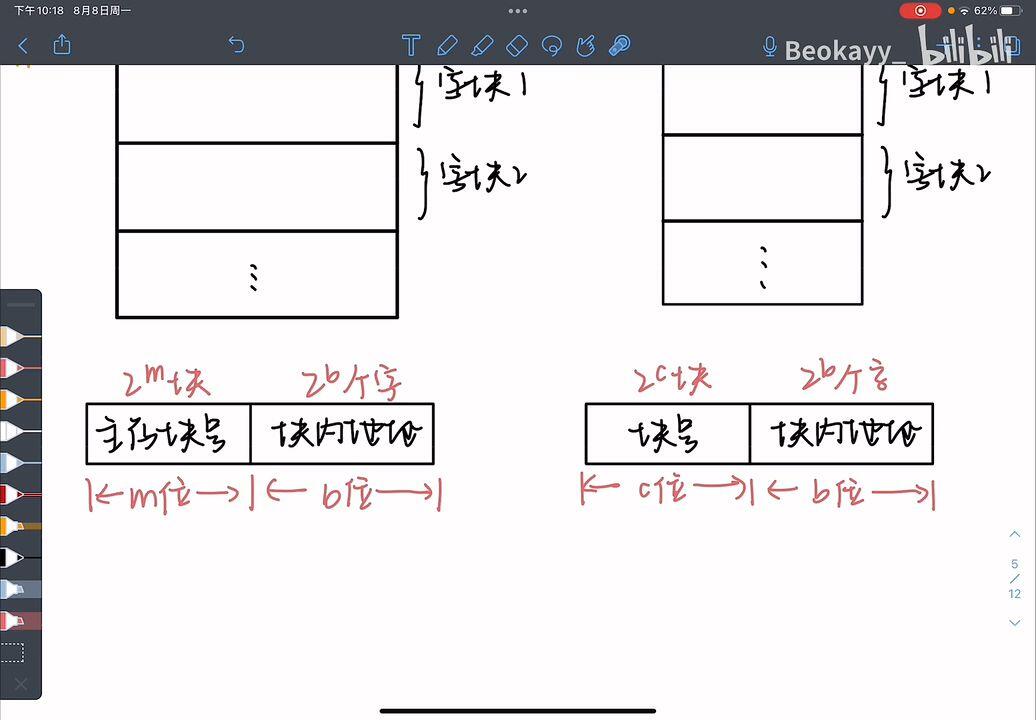
07:45
主存和cache的块内地址位宽相同。
2^m >> 2^c
下面考虑如何映射
08:27 直接映射
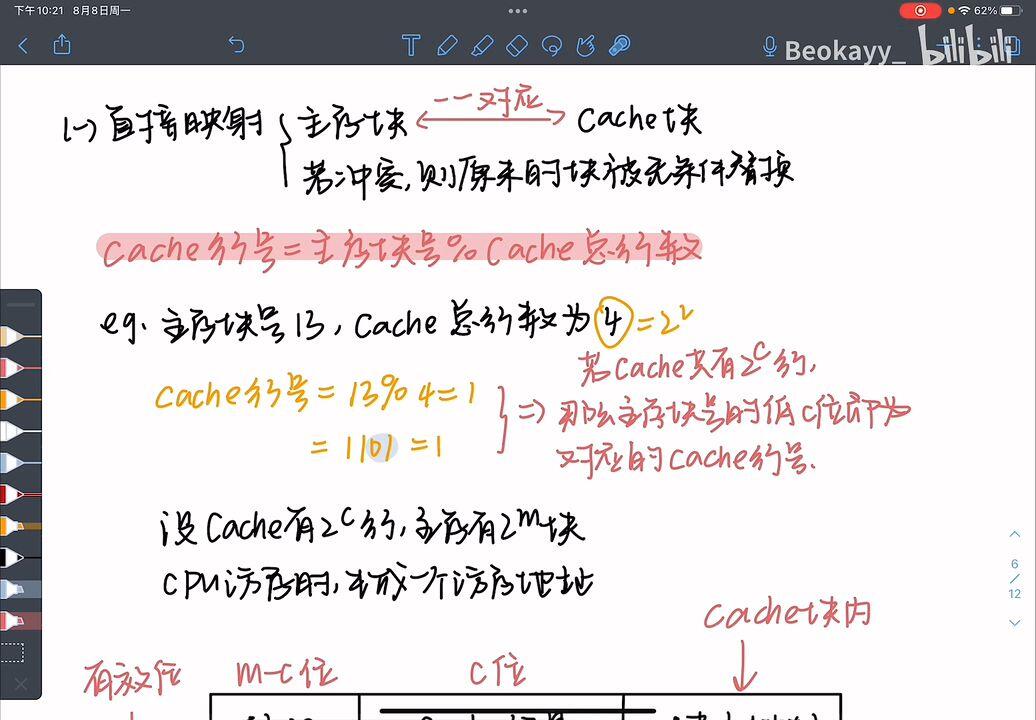
块冲突的概率很高而且空间利用率很低
09:24 全相连的地址计算
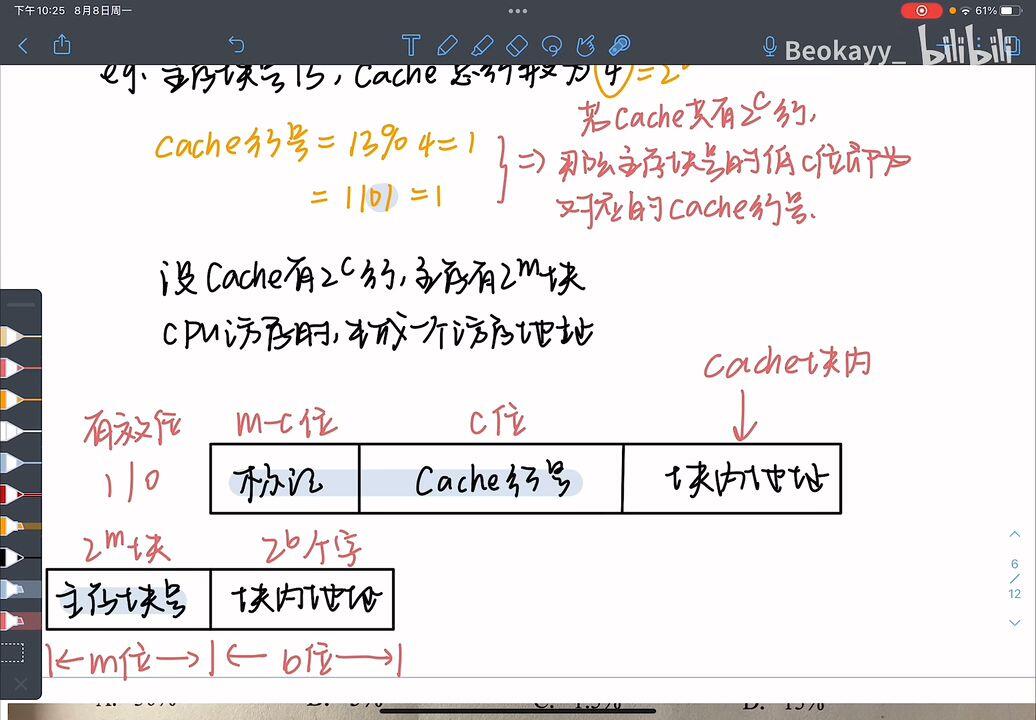
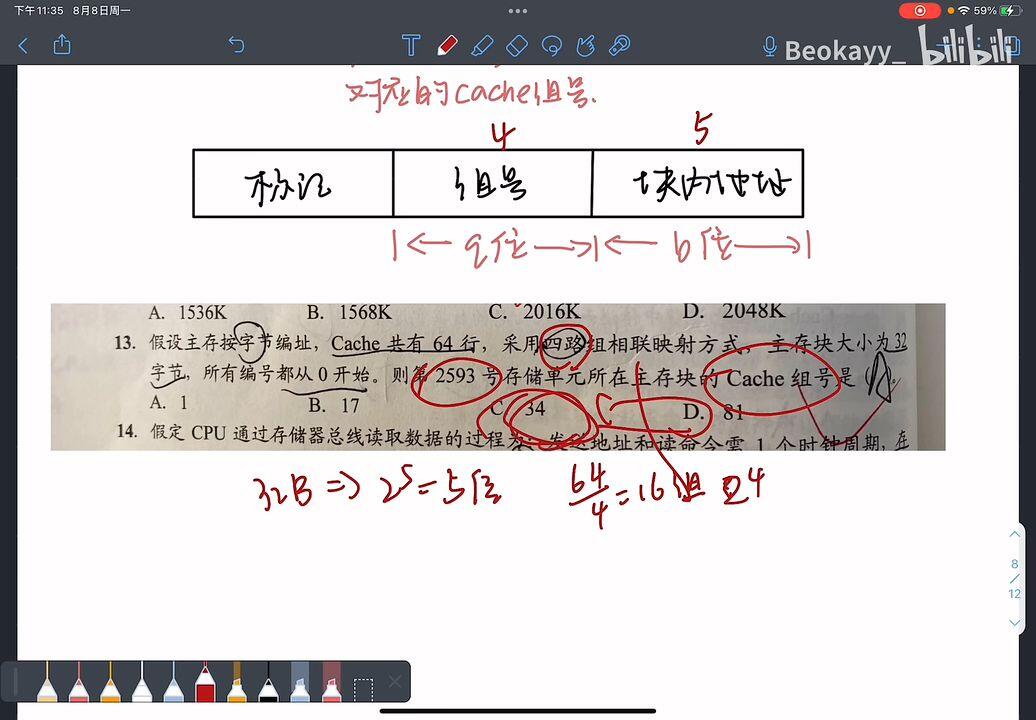
若cache共有2^c行,那么主存块号的低c位即为对应的cache行号
cache
主存块号的低c位,就是cache行号
m-c位是干啥的?
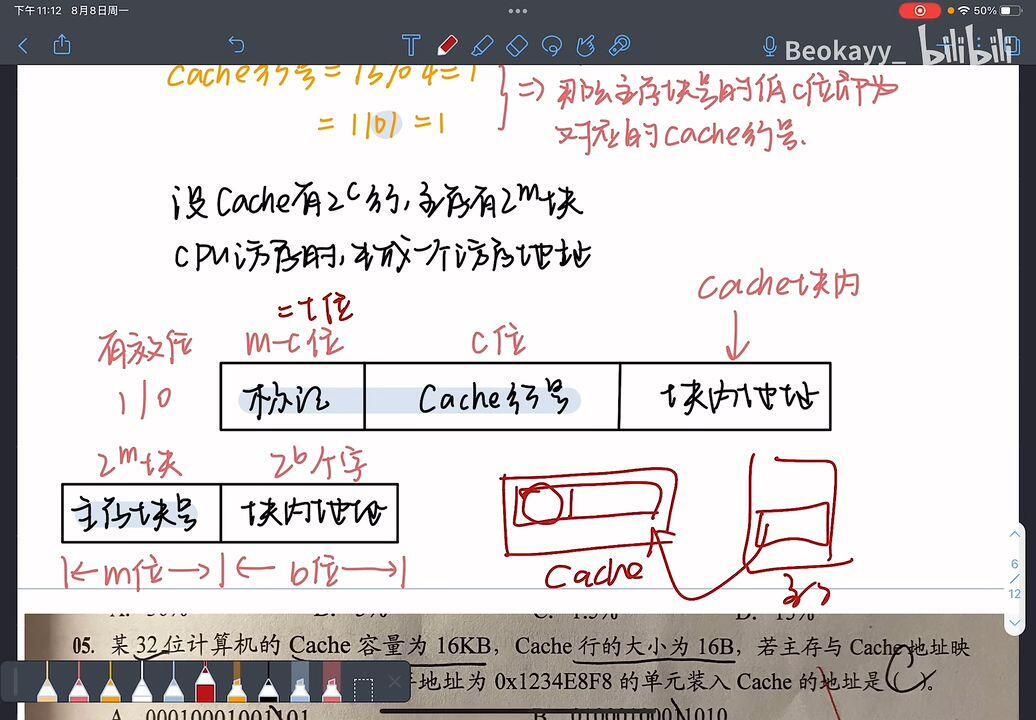
令m-c=t,作为标记位
看cache来自于主存的哪一块
10:33
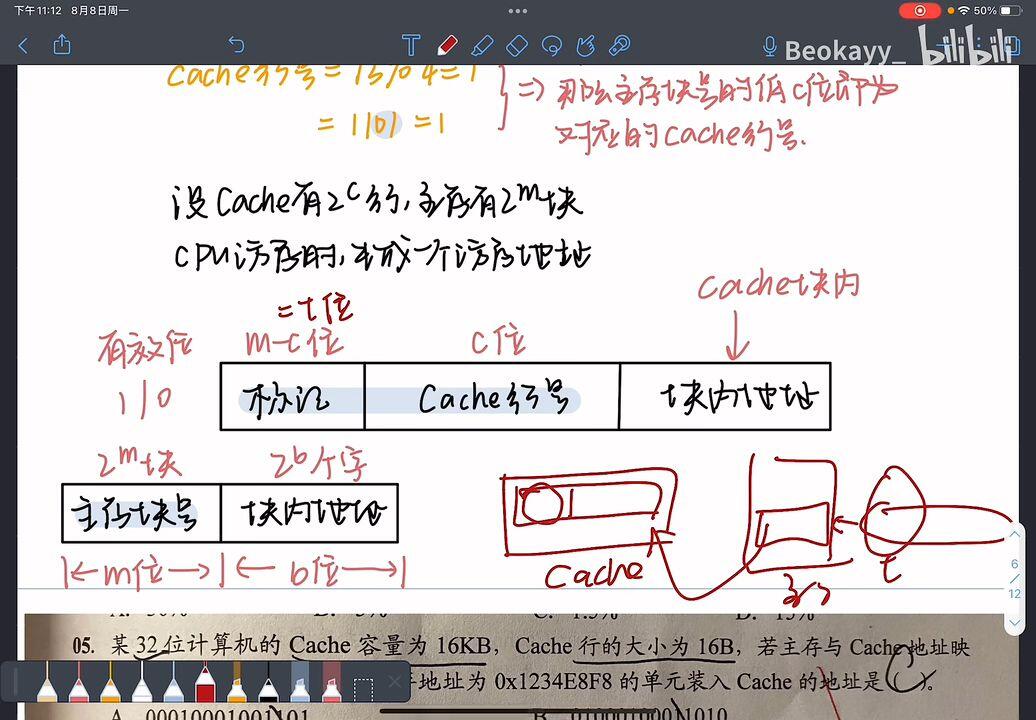
取的是主存中地址的前t位
开始举例子
前面的t位和
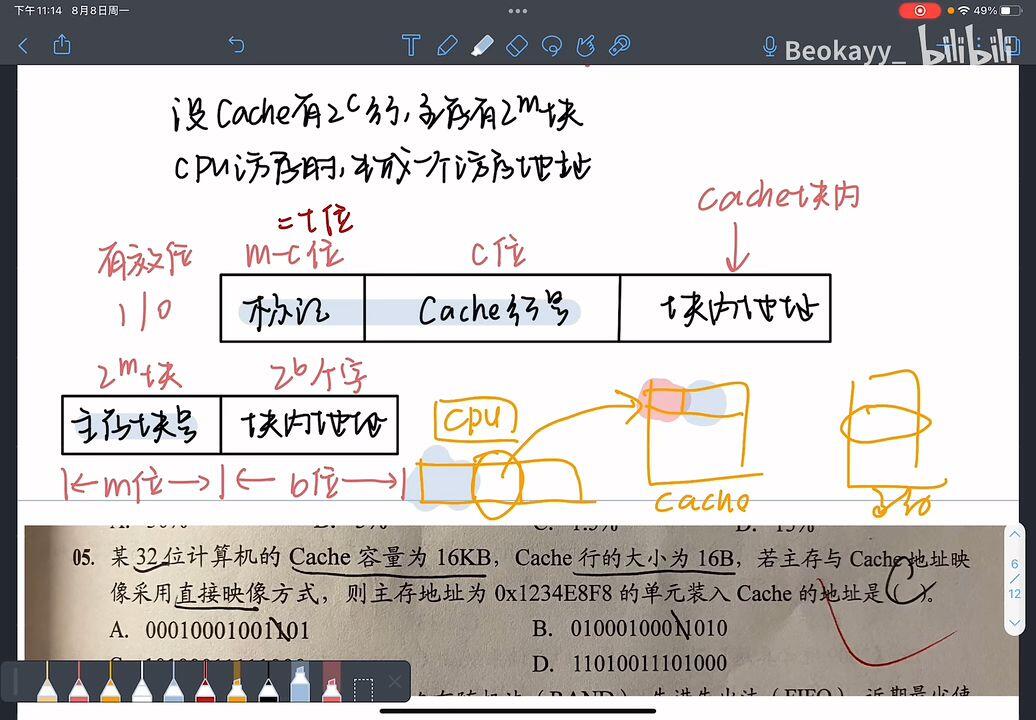
只要cache标记位和访存的标记位一样,且cache的valid为1,则说明cache中的这一行就是来自于我们要访问的主存地址
11:47 很重要,CPU访存方式
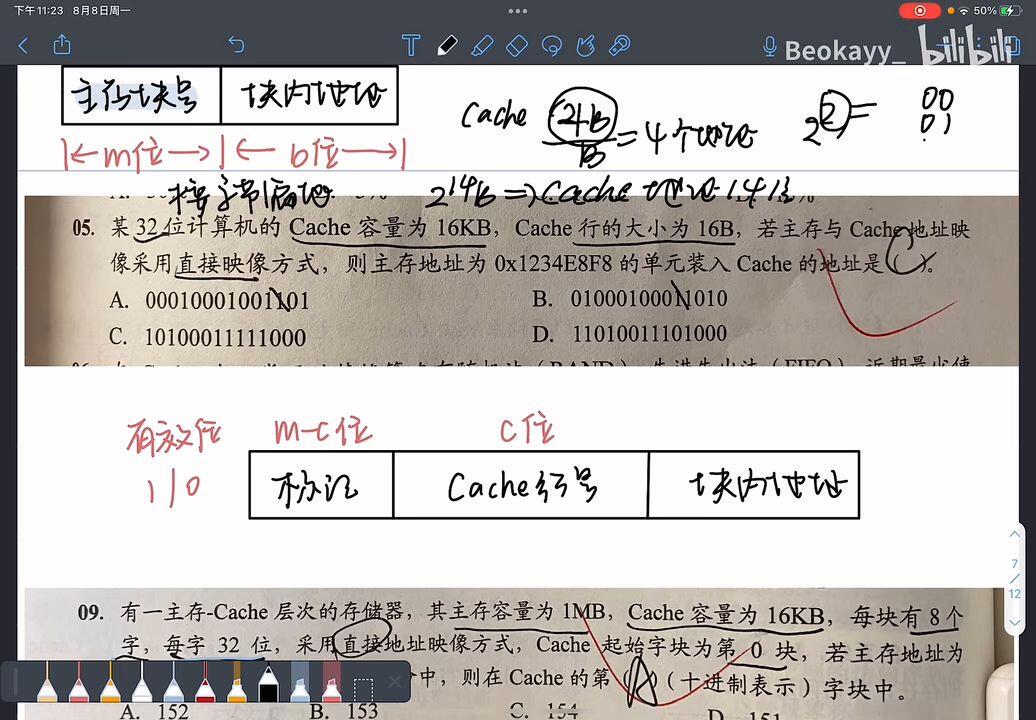
cache的地址容易推出是14位
14:42
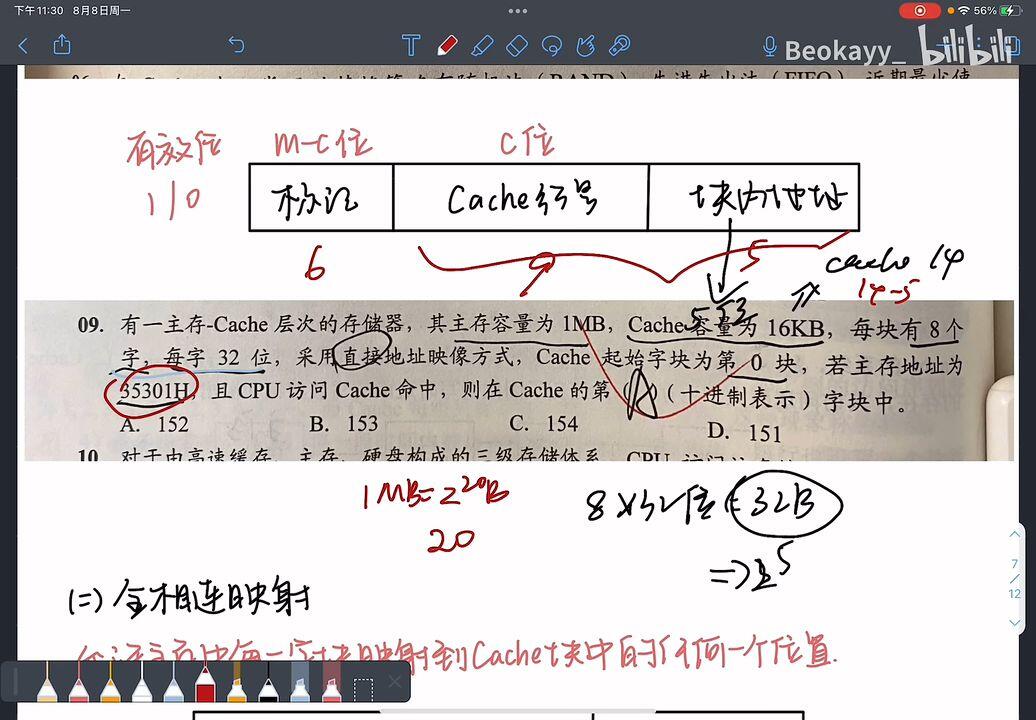
把主存地址转换为2进制,就可以算出cache行号
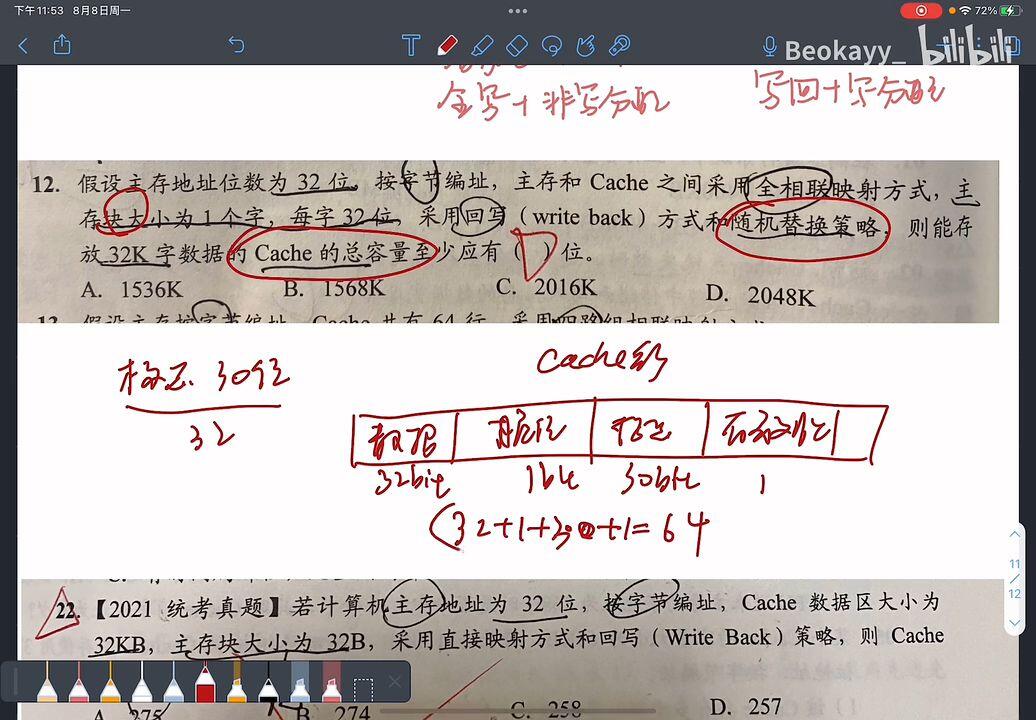
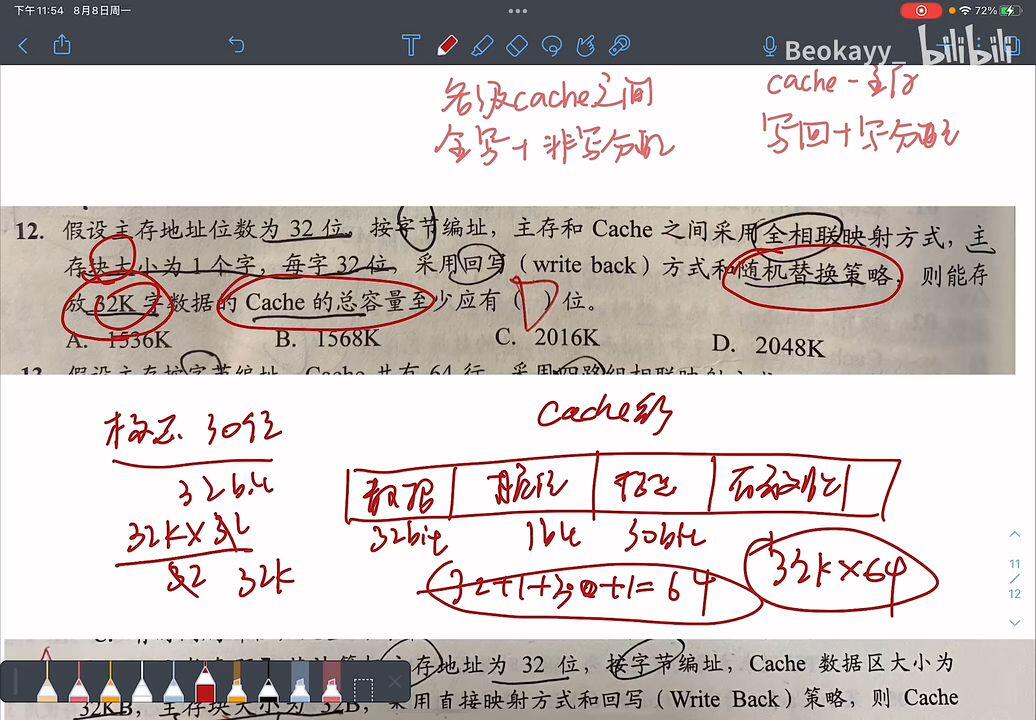
全相连映射
14:53 全相连映射
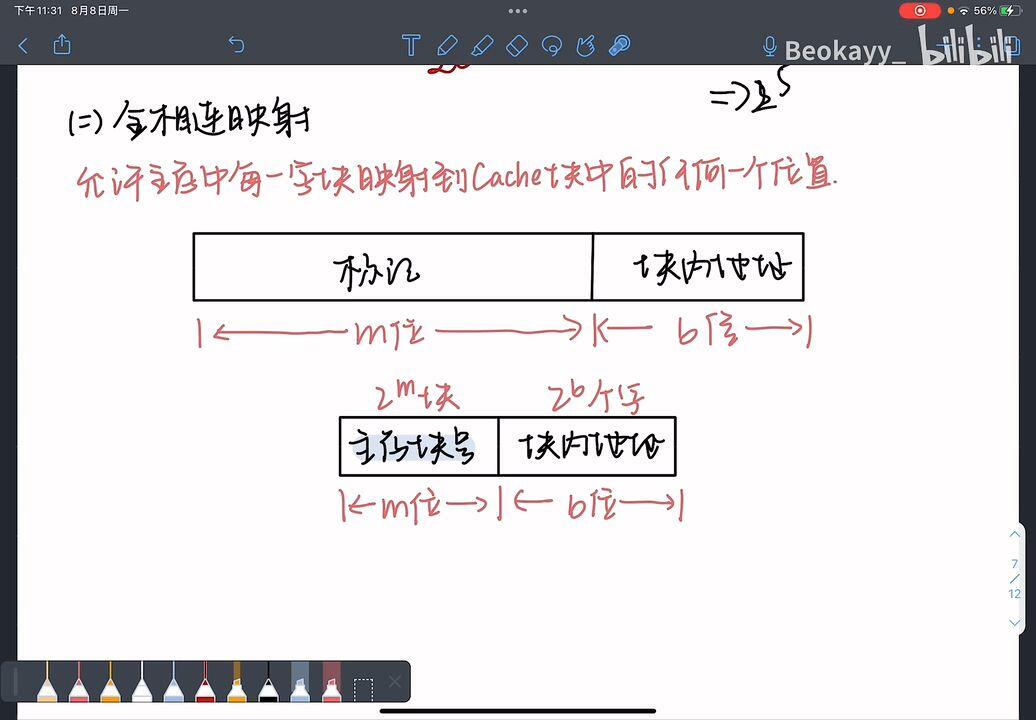
允许主存中每个字块映射到cache块中的任何一个位置。
相比直接映射,就不需要去算映射到哪个位置了。不用去计算cache行号。
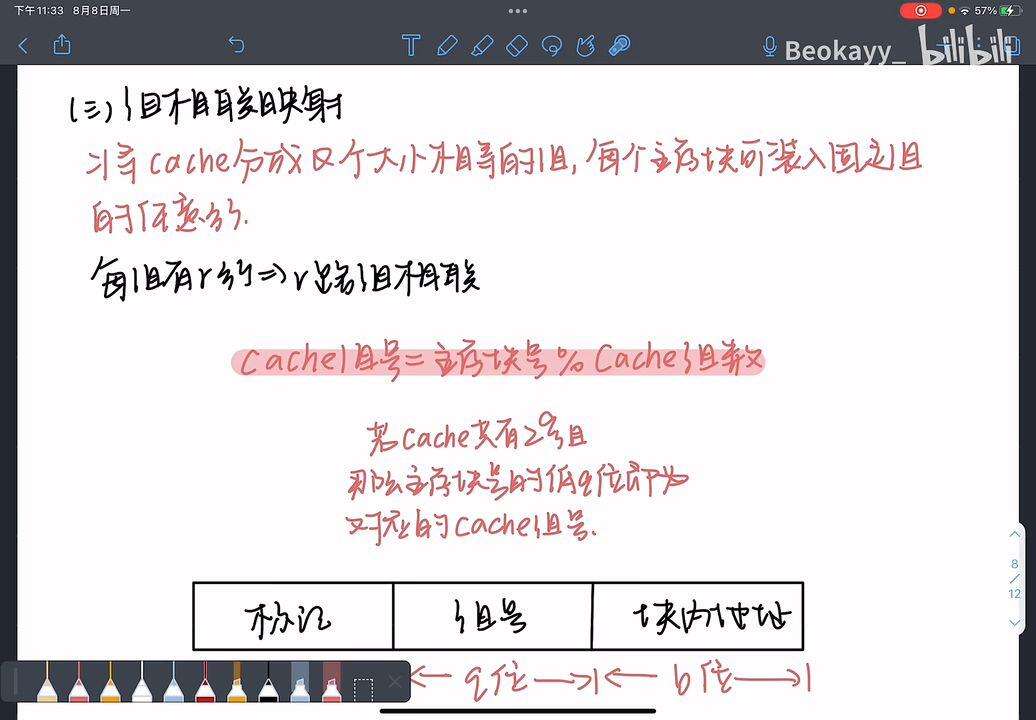
主存块号就等于标记
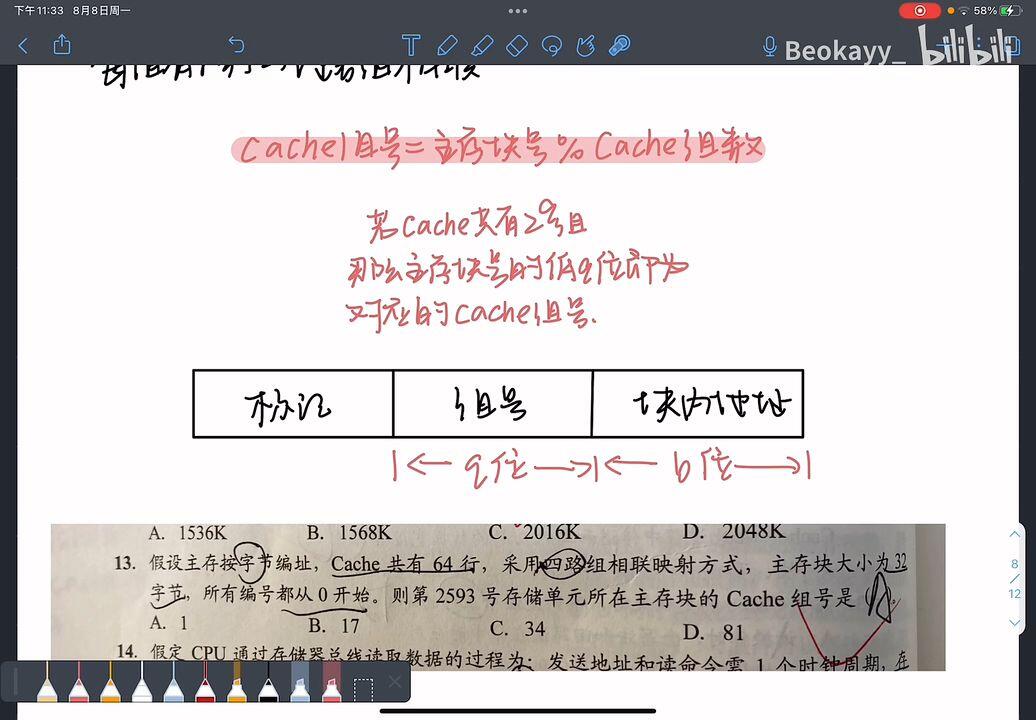
15:23 组相连映射
组间采用的是直接映射
组内采用的是全相连映射
主存块的替换算法
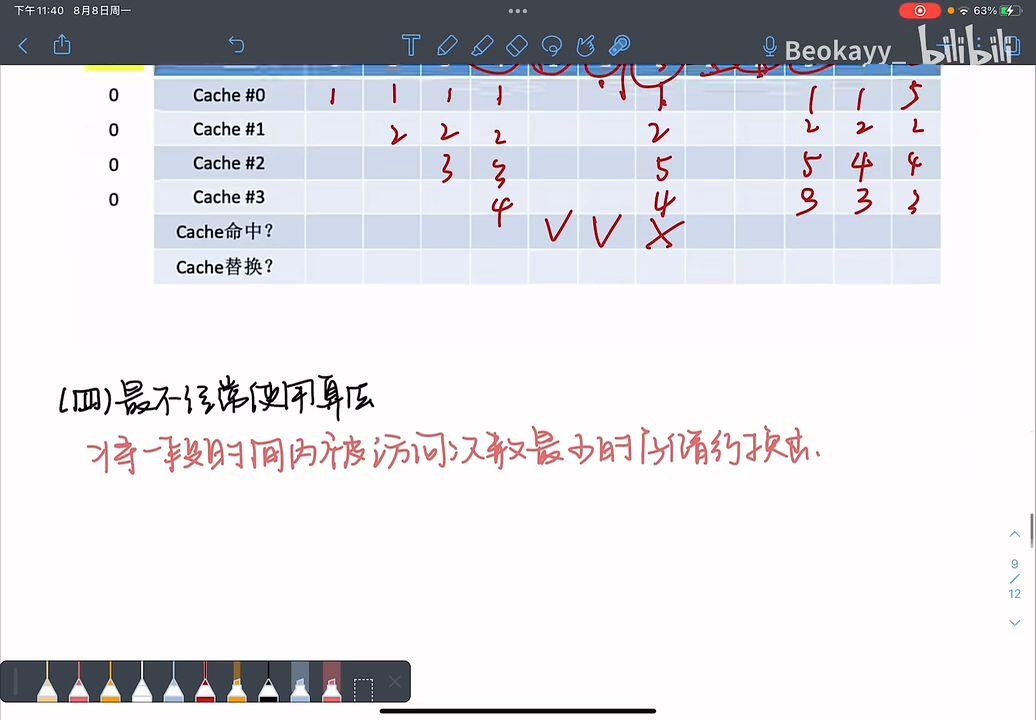
17:39 替换算法
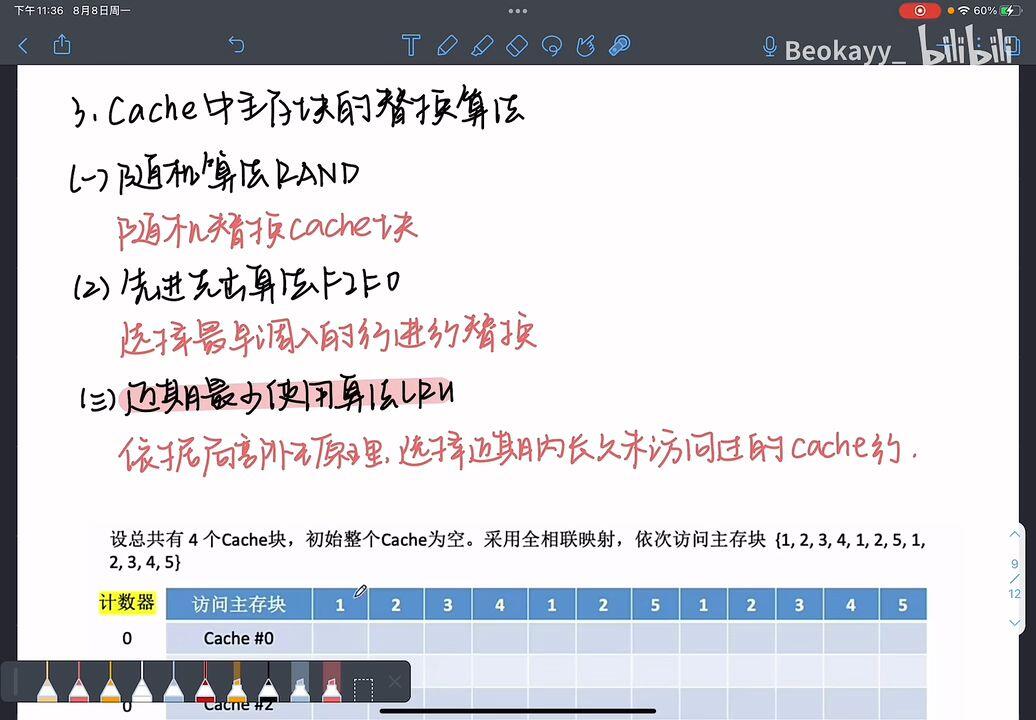
FIFO没有遵循局部性原理,命中率低

19:44 cache写策略
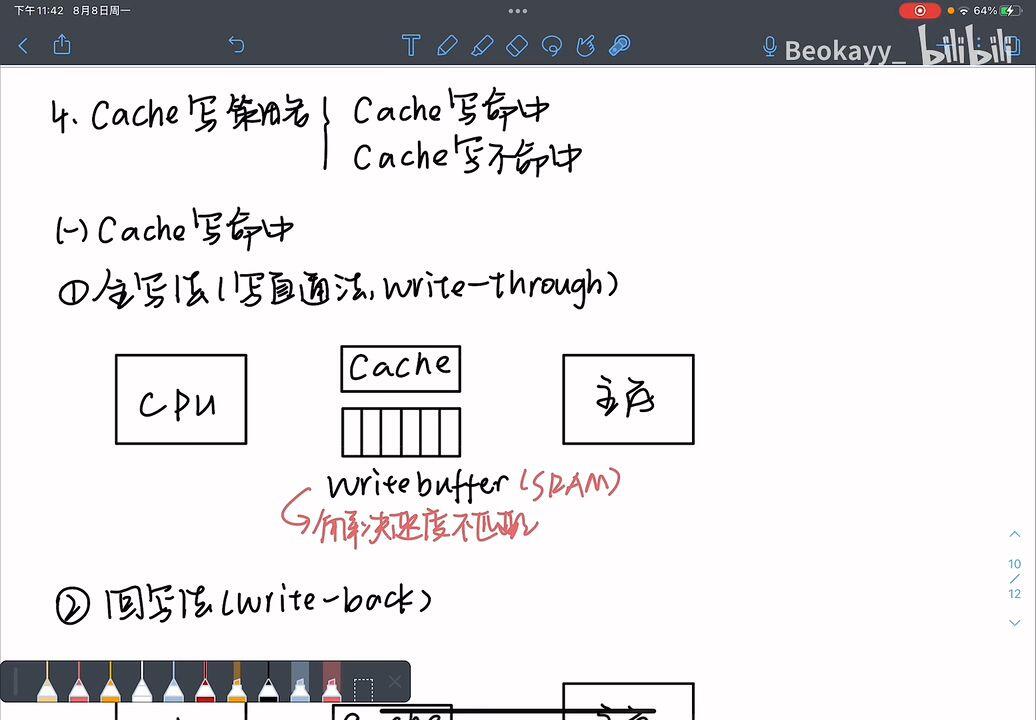
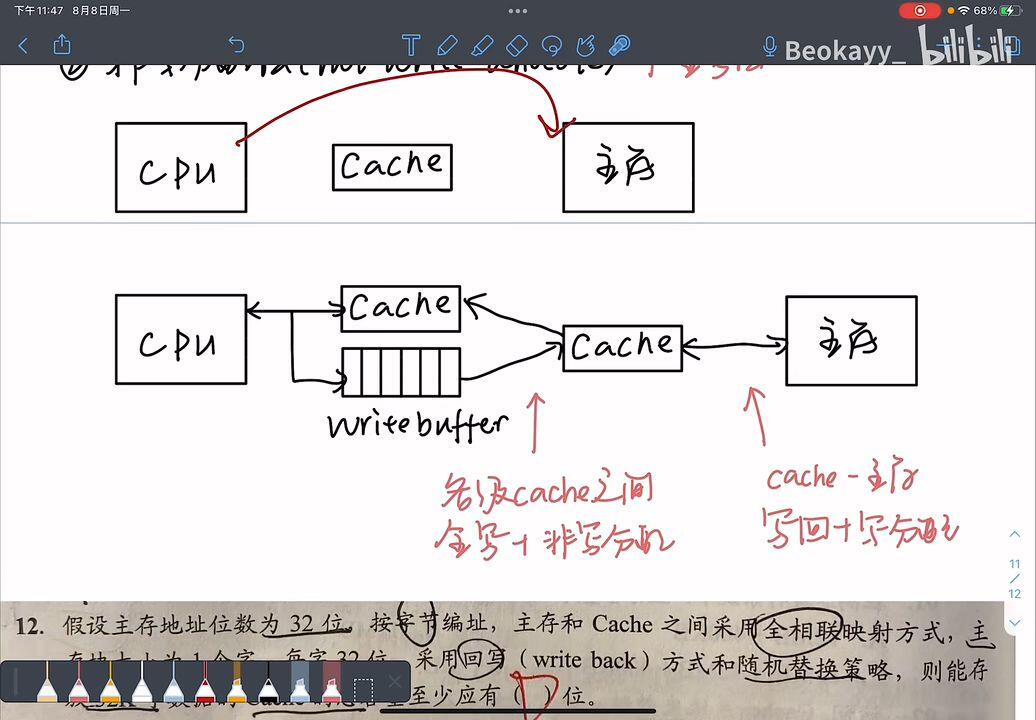
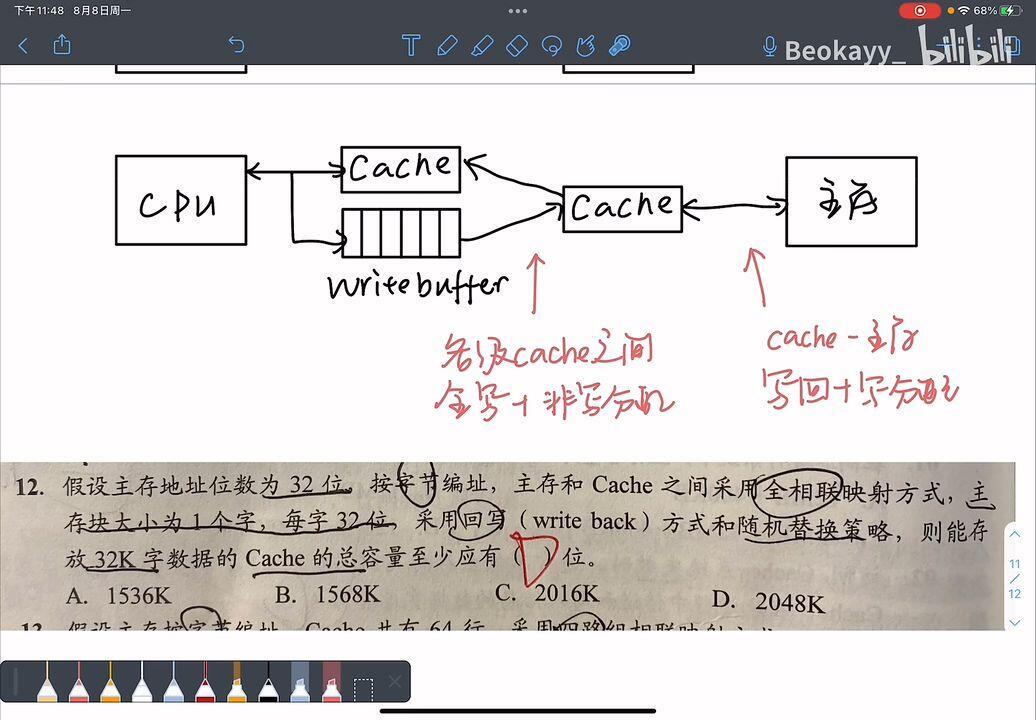
降低了cache效率
设置了一个buffer,解决速度不匹配
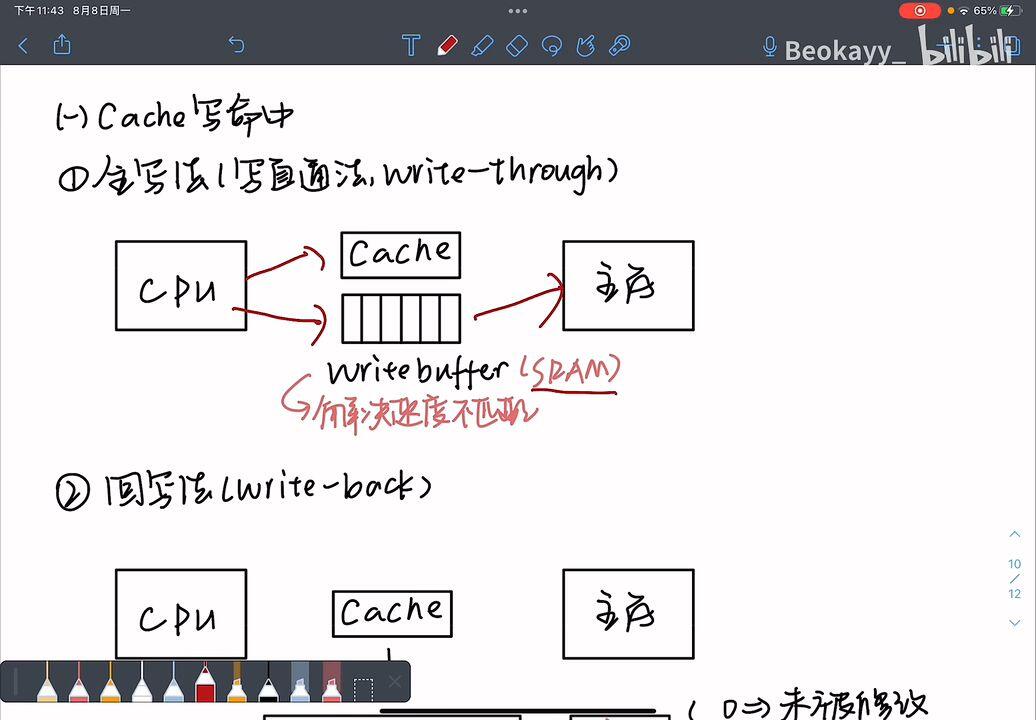
buffer可能会溢出
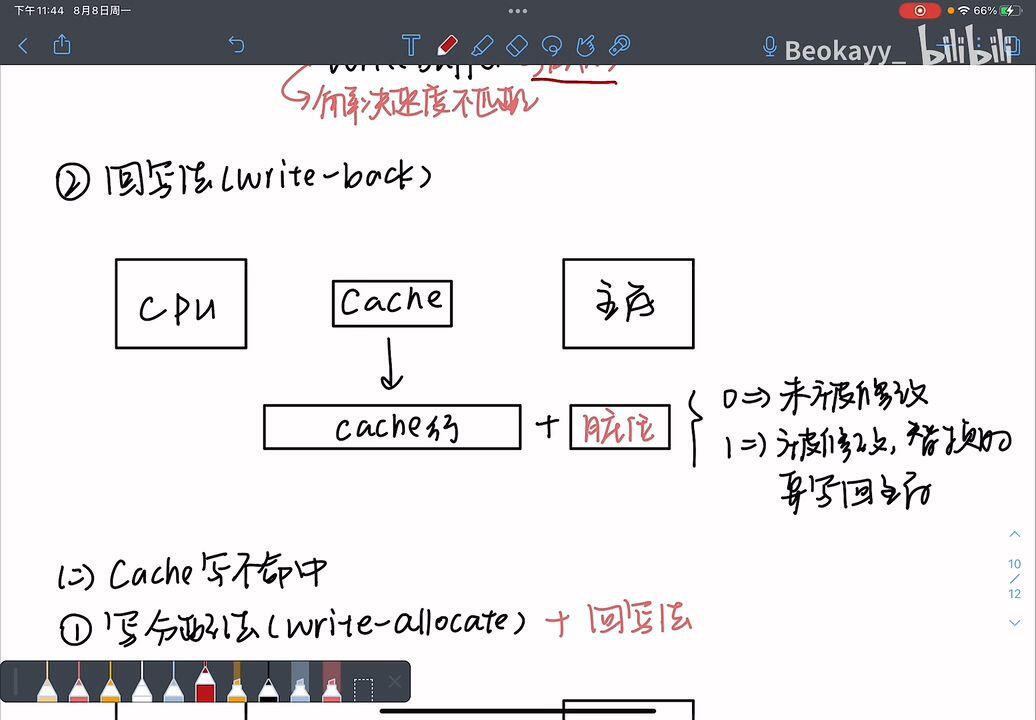
回写法
脏位为1表示被修改,替换时要写回主存
cache写不命中
22:51 写不命中
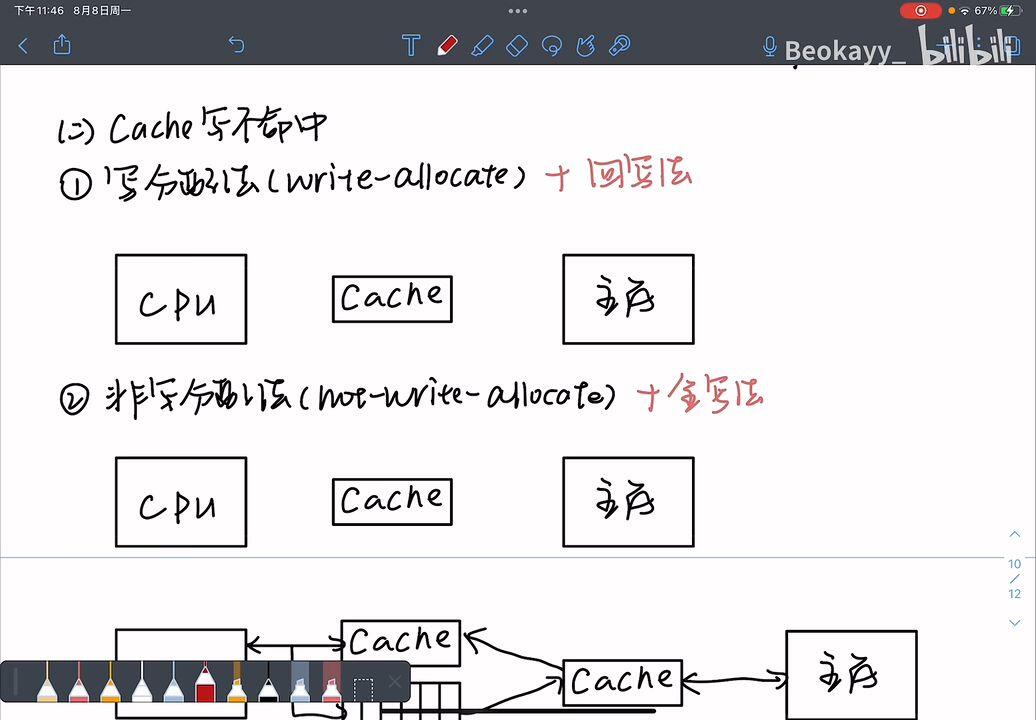
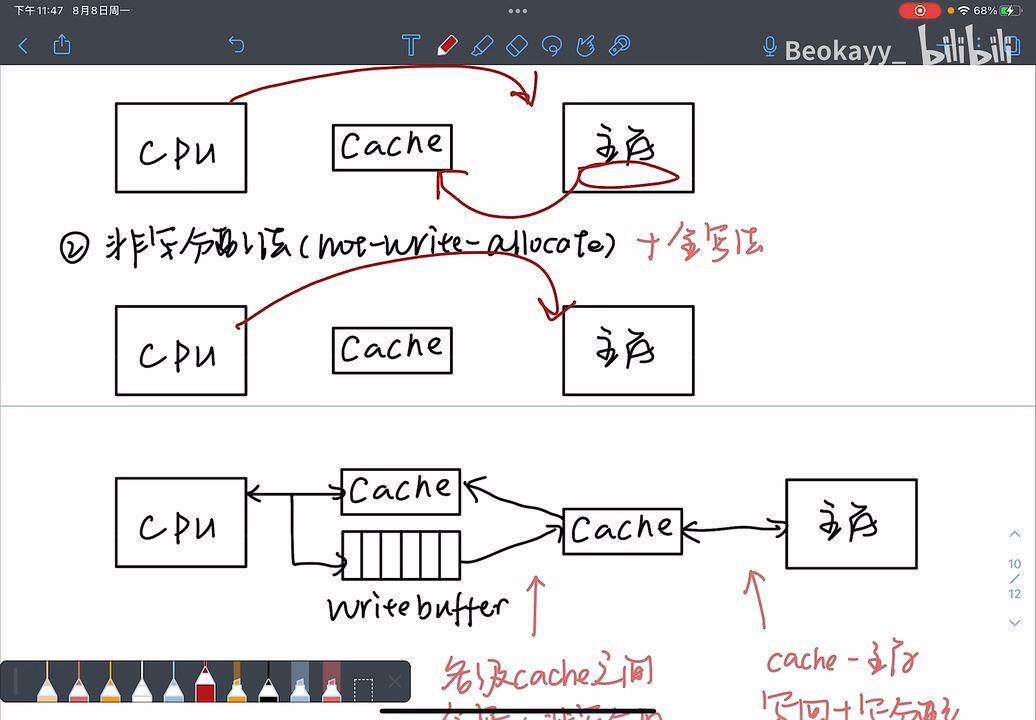
非写分配法,只写入主存