

主成分分析简介
主成分分析 (PCA, principal component analysis)是一种数学降维方法, 利用正交变换 (orthogonal transformation)把一系列可能线性相关的变量转换为一组线性不相关的新变量,也称为主成分,从而利用新变量在更小的维度下展示数据的特征。
主成分是原有变量的线性组合,其数目不多于原始变量。组合之后,相当于我们获得了一批新的观测数据,这些数据的含义不同于原有数据,但包含了之前数据的大部分特征,并且有着较低的维度,便于进一步的分析。
在空间上,PCA可以理解为把原始数据投射到一个新的坐标系统,第一主成分为第一坐标轴,它的含义代表了原始数据中多个变量经过某种变换得到的新变量的变化区间;第二成分为第二坐标轴,代表了原始数据中多个变量经过某种变换得到的第二个新变量的变化区间。这样我们把利用原始数据解释样品的差异转变为利用新变量解释样品的差异。
这种投射方式会有很多,为了最大限度保留对原始数据的解释,一般会用最大方差理论或最小损失理论,使得第一主成分有着最大的方差或变异数 (就是说其能尽量多的解释原始数据的差异);随后的每一个主成分都与前面的主成分正交,且有着仅次于前一主成分的最大方差 (正交简单的理解就是两个主成分空间夹角为90°,两者之间无线性关联,从而完成去冗余操作)。
主成分分析的意义
简化运算。在问题研究中,为了全面系统地分析问题,我们通常会收集众多的影响因素也就是众多的变量。这样会使得研究更丰富,通常也会带来较多的冗余数据和复杂的计算量。 比如我们我们测序了100种样品的基因表达谱借以通过分子表达水平的差异对这100种样品进行分类。在这个问题中,研究的变量就是不同的基因。每个基因的表达都可以在一定程度上反应样品之间的差异,但某些基因之间却有着调控、协同或拮抗的关系,表现为它们的表达值存在一些相关性,这就造成了统计数据所反映的信息存在一定程度的冗余。另外假如某些基因如持家基因在所有样本中表达都一样,它们对于解释样本的差异也没有意义。这么多的变量在后续统计分析中会增大运算量和计算复杂度,应用PCA就可以在尽量多的保持变量所包含的信息又能维持尽量少的变量数目,帮助简化运算和结果解释。
去除数据噪音。比如说我们在样品的制备过程中,由于不完全一致的操作,导致样品的状态有细微的改变,从而造成一些持家基因也发生了相应的变化,但变化幅度远小于核心基因 (一般认为噪音的方差小于信息的方差)。而PCA在降维的过程中滤去了这些变化幅度较小的噪音变化,增大了数据的信噪比。
利用散点图实现多维数据可视化。在上面的表达谱分析中,假如我们有1个基因,可以在线性层面对样本进行分类;如果我们有2个基因,可以在一个平面对样本进行分类;如果我们有3个基因,可以在一个立体空间对样本进行分类;如果有更多的基因,比如说n个,那么每个样品就是n维空间的一个点,则很难在图形上展示样品的分类关系。利用PCA分析,我们可以选取贡献最大的2个或3个主成分作为数据代表用以可视化。这比直接选取三个表达变化最大的基因更能反映样品之间的差异。(利用Pearson相关系数对样品进行聚类在样品数目比较少时是一个解决办法)
发现隐性相关变量。我们在合并冗余原始变量得到主成分过程中,会发现某些原始变量对同一主成分有着相似的贡献,也就是说这些变量之间存在着某种相关性,为相关变量。同时也可以获得这些变量对主成分的贡献程度。对基因表达数据可以理解为发现了存在协同或拮抗关系的基因。
示例展示原始变量对样品的分类
假设有一套数据集,包含100个样品中某一基因的表达量。如下所示,每一行为一个样品,每一列为基因的表达值。这也是做PCA分析的基本数据组织方式,每一行代表一个样品,每一列代表一组观察数据即一个变量。
Expression profile for Gene1 in 100 samples Gene1GroupYa15.99a0a24.66a0a34.92a0a44.79a0……NA…b4720.78b0b4820.5b0b4920.46b0b5019.94b0
从下图可以看出,100个样品根据表达量的不同在横轴上被被分为了2类,可以看做是在线性水平的分类。

那么如果有2个基因呢?
Expression profile for Gene1 and Gene2 in 100 samples Gene1Gene2Groupa15.995.35aa24.665.31aa34.925.12aa44.795.11a………NAb4720.784.95bb4820.54.9bb4920.464.85bb5019.944.87b
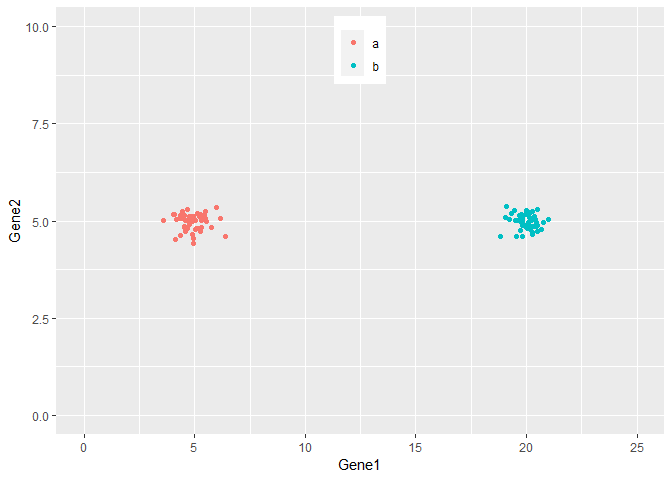
从下图可以看出,100个样品根据和的表达量的不同在坐标轴上被被分为了2类,可以看做是在平面水平的分类。而且在这个例子中,我们可以很容易的看出对样品分类的贡献要比大,因为在样品间的表达差异大。
如果有3个基因呢?
Expression profile for 3 genes in 100 samples Gene1Gene2Gene3Groupa15.995.355.14aa24.665.315.05aa34.925.124.88aa44.795.114.8a…………NAb4720.784.954.91bb4820.54.95.11bb4920.464.854.95bb5019.944.875.18b
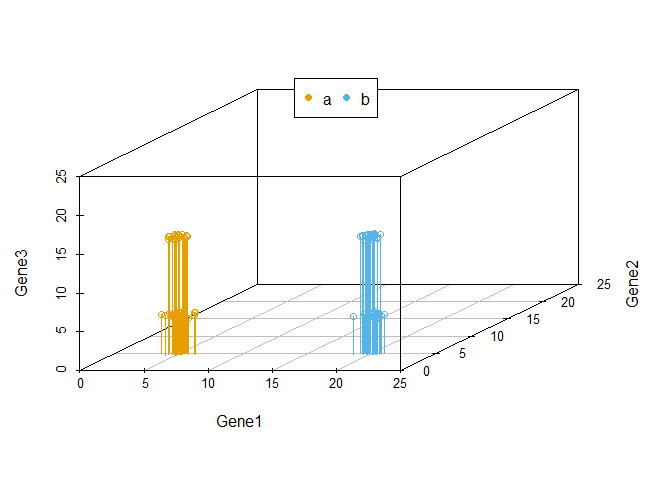
从下图可以看出,100个样品根据、和的表达量的不同在坐标轴上被被分为了4类,可以看做是立体空间的分类。而且在这个例子中,我们可以很容易的看出和对样品分类的贡献要比大。
当我们向由和构成的平面做垂线时,可以很明显的看出,所在的轴对样品的分类没有贡献。因为投射到屏幕上的点在轴几乎处于同一位置。
我们把坐标轴做一个转换,可以看到在由和构成的平面上,样品被分为了4类。对样品的分类几乎没有贡献,因为几乎所有样品在Gene2维度上的值都一样。
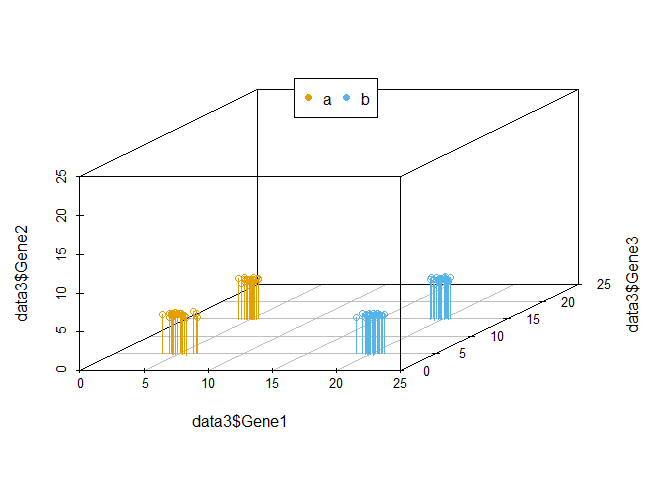
在上述例子中,我们可以很容易的区分出和可以作为分类的主成分,而则对分类没有帮助,可以在计算中去除。
但是如果我们测序了几万个基因的表达时,就很难通过肉眼去看,或者作出一个图供我们筛选哪些基因对样本分类贡献大。这时我们应该怎么做呢?
其中有一个方法是,在这个基因表达矩阵中选出3个变化最大的基因做为3个主成分对样品进行分类。我们试验下效果怎么样。
Gene expression matrix Hi_2338_1Hi_2338_2Hi_2338_3Hi_2338_4Hi_2338_5Hi_2338_6Hi_2338_7Hi_2338_8A1BG9.080.000.001.750.000.400.000.78A1BG-AS10.000.003.470.360.000.000.000.00A1CF0.000.050.000.000.000.000.000.00A2LD10.000.000.000.290.009.190.000.00A2M0.000.000.000.000.000.000.000.00A2M-AS10.000.000.000.000.000.000.000.00A2ML10.100.000.140.000.000.000.000.00A2MP10.000.000.000.000.000.000.000.00A4GALT0.570.000.000.000.000.000.350.00A4GNT0.000.000.000.000.000.000.000.00AA060.000.000.000.000.000.000.000.00AAAS38.950.000.004.440.0032.900.005.58AACS0.120.000.000.000.581.032.1665.74AACSP10.000.000.000.000.000.000.000.00AADAC0.000.000.000.000.000.000.000.00
我们筛选变异系数最大的3个基因。在这之前我们先剔除在少于5个样品中表达的基因和少于1000个表达的基因样品 (这里我们把表达值不小于1的基因视为表达的基因),并把所有基因根据其在不同样品中表达值的变异系数排序。
A table of the 3 most variable genes MT2AANXA1ARHGDIBHi_2338_112.21149311.8371989.543283Hi_2338_211.3062168.0987698.071623Hi_2338_311.92622610.6886269.720535Hi_2338_410.9742079.3865749.883376Hi_2338_514.60399410.3750729.970379Hi_2338_66.90460411.15534910.093510Hi_2338_712.43671910.8522497.742882Hi_2338_89.7983759.7832276.270716Hi_2338_911.7436739.6264769.250251Hi_2338_1011.24001611.3030560.000000A table of the 3 most variable genes MT2AANXA1ARHGDIBgroupHi_2338_112.21149311.8371989.5432832338Hi_2338_211.3062168.0987698.0716232338Hi_2338_311.92622610.6886269.7205352338Hi_2338_410.9742079.3865749.8833762338Hi_2338_514.60399410.3750729.9703792338Hi_2338_66.90460411.15534910.0935102338Hi_2338_712.43671910.8522497.7428822338Hi_2338_89.7983759.7832276.2707162338Hi_2338_911.7436739.6264769.2502512338Hi_2338_1011.24001611.3030560.0000002338A table of the 3 most variable genes in melted formatgroupvariablevalue2338MT2A12.2114932338MT2A11.3062162338MT2A11.9262262338MT2A10.9742072338MT2A14.6039942338MT2A6.9046042338MT2A12.4367192338MT2A9.7983752338MT2A11.7436732338MT2A11.240016
高颜值免费在线绘图工具升级版来了~~~
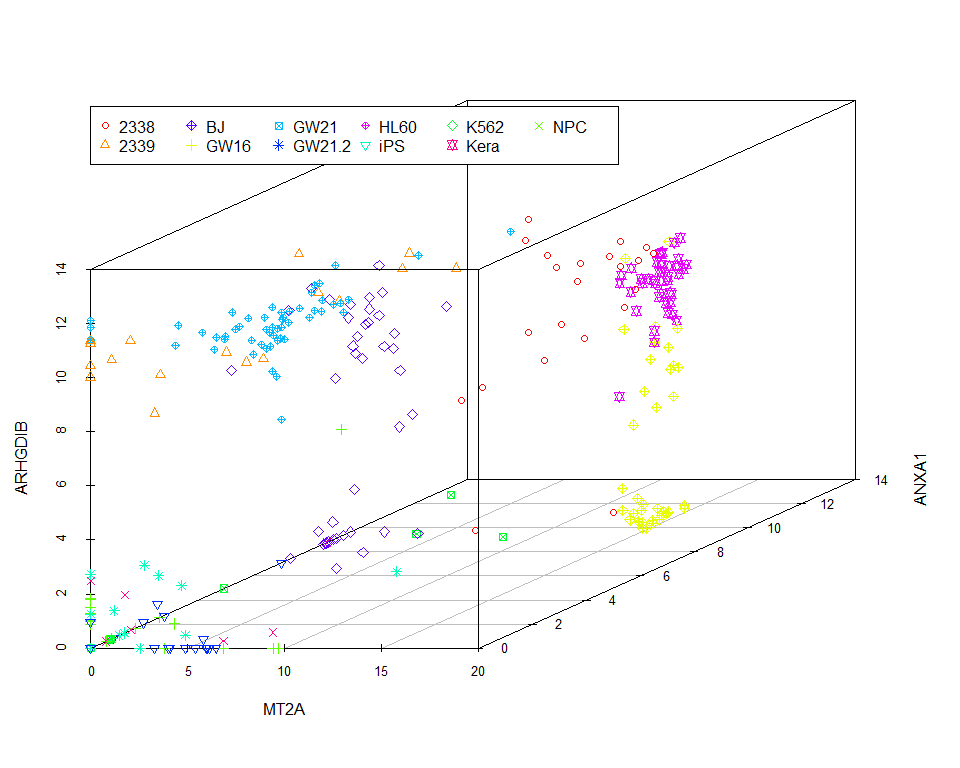
我们看到图中的样品并没有按照预先设定的标签完全分开。当然我们也可以通过其他方法筛选变异最大的三个基因,最终的分类效果不会相差很大。因为不管怎么筛选,我们都只用到了3个基因的表达量。
假如我们把这个数据用PCA来分类,结果是怎样的呢?
从图中可以看到,数据呈现了一定的分类模式 (当然这个分类结果也不理想,我们随后再进一步优化)。
采用3个主成分获得的分类效果优于2个主成分,因为这样保留的原始信息更多。

PCA的实现原理
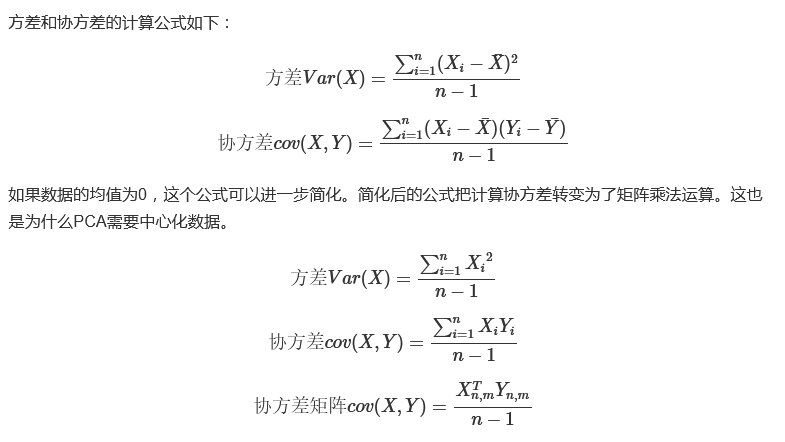
在上面的例子中,PCA分析不是简单地选取2个或3个变化最大的基因,而是先把原始的变量做一个评估,计算各个变量各自的变异度(方差)和两两变量的相关度(协方差),得到一个协方差矩阵。在这个协方差矩阵中,对角线的值为每一个变量的方差,其它值为每两个变量的协方差。随后对原变量的协方差矩阵对角化处理,即求解其特征值和特征向量。原变量与特征向量的乘积(对原始变量的线性组合)即为新变量(回顾下线性代数中的矩阵乘法);新变量的协方差矩阵为对角协方差矩阵且对角线上的方差由大到小排列;然后从新变量中选择信息最丰富也就是方差最大的的前2个或前3个新变量也就是主成分用以可视化。下面我们一步步阐释这是怎么做的。
我们先回忆两个数学概念,方差和协方差。用来表示一组一维数据的离散程度。表示2组一维数据的相关性。当协方差为0时,表示两组数据完全独立。当协方差为正时,表示一组数据增加时另外一组也会增加;当协方差为负时表示一组数据增加时另外一组数据会降低 (与相关系数类似)。如果我们有很多组一维数据,比如很多基因的表达数据,就会得到很多协方差,这就构成了协方差矩阵。
假如我们有一个矩阵如下,
平均值中心化 (mean centering):中心化数据使其平均值为0
中位数中心化 (median centering):如果数据变换范围很大或有异常值,中位数标准化效果会更好。
我们可以计算的方差为 0.973082 ();和的协方差为0.5734631。
mat中5组基因的表达值的方差计算如下:
mat中5组基因表达值的协方差计算如下:
如果均值为0,数值矩阵的协方差矩阵为矩阵的乘积 (实际上是矩阵的转置与其本身的乘积除以变量的维数减1)。
用矩阵形式书写如下,便于理解
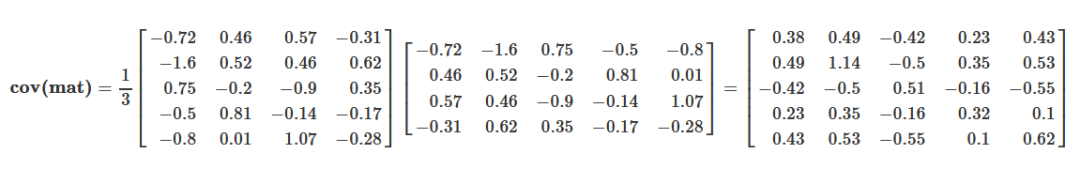
根据前面的描述,原始变量的协方差矩阵表示原始变量自身的方差(协方差矩阵的主对角线位置)和原始变量之间的相关程度(非主对角线位置)。如果从这些数据中筛选主成分,则要选择方差大(主对角线值大),且与其它已选变量之间相关性最小的变量(非主对角线值很小)。如果这些原始变量之间毫不相关,则它们的协方差矩阵在除主对角线处外其它地方的值都为0,这种矩阵成为对角矩阵。
而做PCA分析就是产生一组新的变量,使得新变量的协方差矩阵为对角阵,满足上面的要求。从而达到去冗余的目的。然后再选取方差大的变量,实现降维和去噪。
如果正向推导,这种组合可能会有很多种,一一计算会比较麻烦。那反过来看呢? 我们不去寻找这种组合,而是计算如何使原变量的协方差矩阵变为对角阵。
数学推导中谨记的两个概念:
假设: 把未求解到的变量假设出来,用符号代替;这样有助于思考和演算
逆向:如果正向推导求不出,不妨倒着来;尽量多的利用已有信息
前面提到,新变量(Ym, k)是原始变量(Xm, n)(原始变量的协方差矩阵为(Cn, n))的线性组合,那么假设我们找到了这么一个线性组合(命名为特征矩阵(Pn, k)),得到一组新变量Ym, k = Xm, nPn, k,并且新变量的协方差矩阵(Dk, k)为对角阵。那么这个特征矩阵(Pn, k)需要符合什么条件呢?
从矩阵运算可以看出,最终的特征矩阵(Pn, k)需要把原变量协方差矩阵(Cn, n)转换为对角阵(因为新变量的协方差矩阵(Dk, k)为对角阵),并且对角元素从大到小排列(保证每个主成分的贡献度依次降低)。
现在就把求解新变量的任务转变为了求解原变量协方差矩阵的对角化问题了。在线性代数中,矩阵对角化的问题就是求解矩阵的特征值和特征向量的问题。
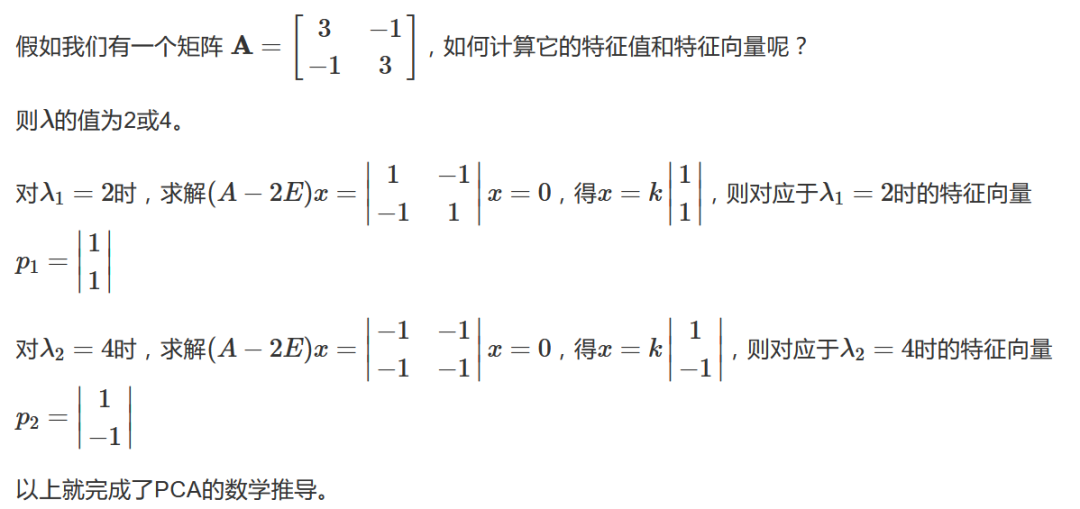
我们举一个例子讲述怎么求解特征值和特征向量。
假设An, n为n阶对称阵,如存在λ和非零向量x,使得A**x = λ**x,则称λ为矩阵An, n的特征值,非零向量x为为矩阵An, n对应于特征值λ的特征向量。
根据这个定义可以得出(An, n − λ**E)x = 0,由于x为非零向量,所以行列式|A − λ**E| = 0。
由此求解出n个根λ1, λ2, …, λ3就是矩阵A的特征值。
回顾下行列式的计算:
行列式的值为行列式第一列的每一个数乘以它的余子式(余子式是行列式中除去当前元素所在行和列之后剩下的行列式)。
当行列式中存在线性相关的行或列或者有一行或一列元素全为0时,行列式的值为0。
上三角形行列式的值为其主对角线上元素的乘积。
互换行列式的两行或两列,行列式变号。
行列式的某一列(行)乘以同意书加到另一列(列)对应元素上去,行列式不变。
简单的PCA实现
我们使用前面用到的数据来演示下如何用R函数实现PCA的计算,并与R中自带的做个比较。
Expression profile for 3 genes in 100 samples Gene1Gene2Gene3Groupa15.995.355.14aa24.665.315.05aa34.925.124.88aa44.795.114.8a…………NAb4720.784.954.91bb4820.54.95.11bb4920.464.854.95bb5019.944.875.18b
标准化数据
Normalized expression for 3 genes in 100 samples Gene1Gene2Gene3a1-0.851.83-0.96a2-1.031.66-0.98a3-0.990.72-1.01a4-1.010.67-1.03…………b471.09-0.11-1.01b481.06-0.38-0.97b491.05-0.61-1b500.98-0.52-0.95
计算协方差矩阵
Covariance matrix for 3 genes in 100 samples Gene1Gene2Gene3Gene11.00000000.0255834-0.0087919Gene20.02558341.00000000.0553298Gene3-0.00879190.05532981.0000000
求解特征值和特征向量
产生新的矩阵
PCA generated matrix for the expression of 3 genes in 100 samples PC1PC2PC3a10.51-0.21-2.17a20.33-0.37-2.12a3-0.36-0.42-1.49a4-0.41-0.43-1.47…………b47-0.51.39-0.17b48-0.681.320.03b49-0.861.310.16b50-0.791.230.1
比较原始数据和新产生的主成分对样品的聚类
利用进行主成分分析
PCA generated matrix usig princomp for the expression of 3 genes in 100 samples PC1PC2PC3a10.510.21-2.17a20.330.37-2.12a3-0.360.42-1.49a4-0.410.43-1.47…………b47-0.5-1.39-0.17b48-0.68-1.320.03b49-0.86-1.310.16b50-0.79-1.230.1
比较手动实现的PCA与实现的PCA的聚类结果

自定义PCA计算函数
比较有无对聚类的影响,从图中可以看到,如果不对数据进行处理,样品的聚类结果更像原始数据,本身数值大的基因对主成分的贡献会大。如果关注的是每个变量自身的实际方差对样品分类的贡献,则不应该;如果关注的是变量的相对大小对样品分类的贡献,则应该,以防数值高的变量导入的大方差引入的偏见。

PCA结果解释
函数会返回主成分的标准差、特征向量和主成分构成的新矩阵。接下来,探索下不同主成分对数据差异的贡献和主成分与原始变量的关系。
主成分的平方为为特征值,其含义为每个主成分可以解释的数据差异,计算方式为eigenvalues = (pca$sdev)^2
每个主成分可以解释的数据差异的比例为percent_var = eigenvalues*100/sum(eigenvalues)
可以使用summary(pca)获取以上两条信息。
这两个信息可以判断主成分分析的质量:
成功的降维需要保证在前几个为数不多的主成分对数据差异的解释可以达到80-90%。
指导选择主成分的数目:
选择的主成分足以解释的总方差大于80% (方差比例碎石图)
从前面的协方差矩阵可以看到,自动定标(scale)的变量的方差为1 (协方差矩阵对角线的值)。待选择的主成分应该是那些方差大于1的主成分,即其解释的方差大于原始变量(特征值碎石图,方差大于1,特征值也会大于1,反之亦然)。
鉴定核心变量和变量间的隐性关系:
原始变量与主成分的相关性Variable correlation with PCs (var.cor) = loadings * sdev
原始数据对主成分的贡献度 var.cor^2 / (total var.cor^2)
在测试数据中,后,三个主成分对数据差异的贡献度大都在30%左右,而未的数据,三个主成分对数据差异的贡献度相差很大。这是因为三个基因由于自身表达量级所引起的方差的差异导致它们各自对数据的权重差异,从而使主成分偏向于数值大的变量。
PCA应用于测试数据
前面用到一组比较大的测试数据集,并做了PCA分析,现在测试不同的处理对结果的影响。
首先回顾下我们用到的数据。
Single cell gene expression data MT2AANXA1ARHGDIBRND3BLVRBHi_2338_112.21111.8379.5439.7629.162Hi_2338_211.3068.0998.07210.1079.423Hi_2338_311.92610.6899.7219.3889.694Hi_2338_410.9749.3879.8838.7929.767Hi_2338_514.60410.3759.9708.8159.350
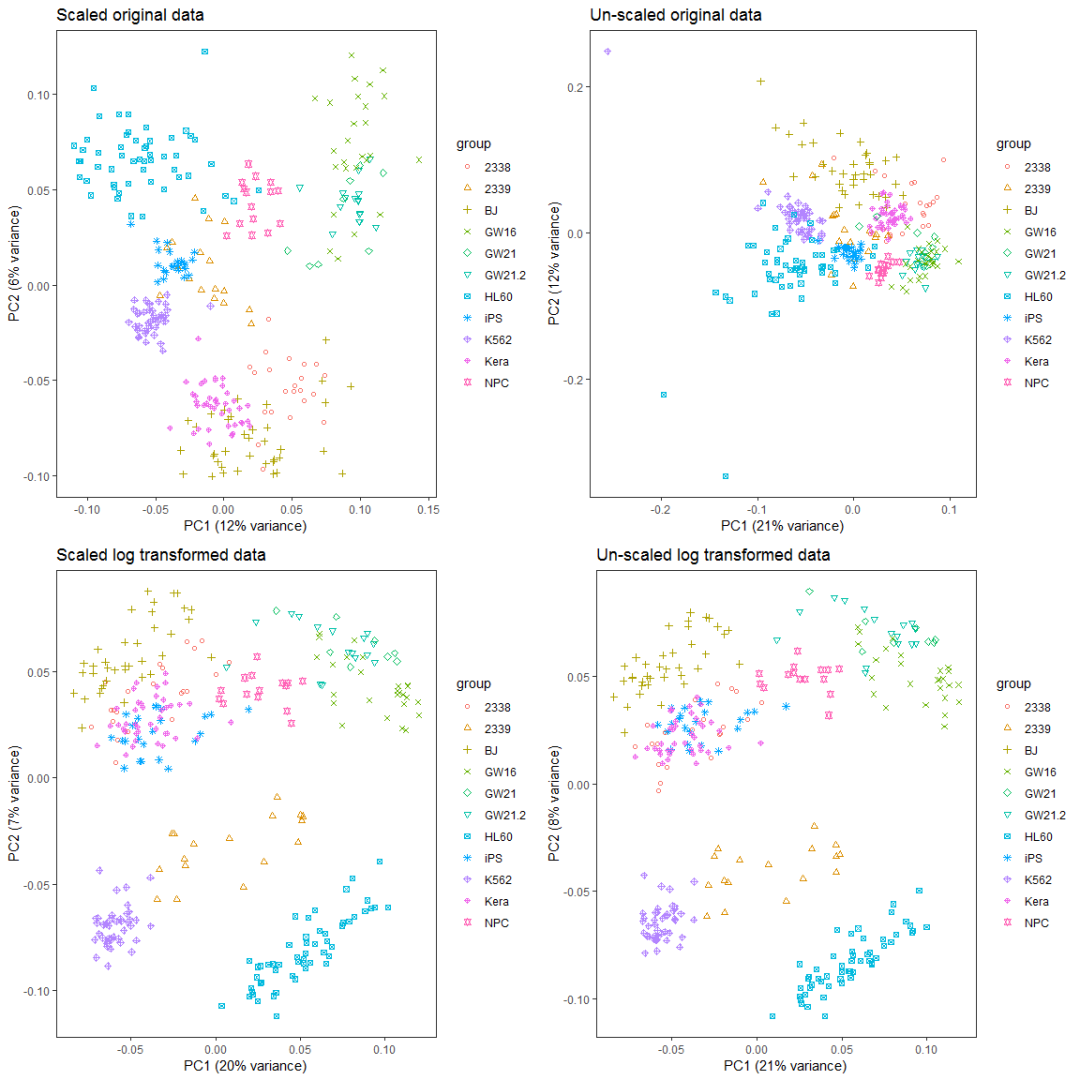
比较对数运算和对样品分类的影响。

如果首先提取500个变化最大的基因,再执行PCA分析会怎样呢?
### PCA注意事项
一般说来,在PCA之前原始数据需要中心化(centering,数值减去平均值)。中心化的方法很多,除了平均值中心化(mean-centering)外,还包括其它更稳健的方法,比如中位数中心化等。
除了中心化以外,定标 (Scale, 数值除以标准差) 也是数据前处理中需要考虑的一点。如果数据没有定标,则原始数据中方差大的变量对主成分的贡献会很大。数据的方差与其量级成指数关系,比如一组数据(1,2,3,4)的方差是1.67,而(10,20,30,40)的方差就是167,数据变大10倍,方差放大了100倍。
但是定标(scale)可能会有一些负面效果,因为定标后变量之间的权重就是变得相同。如果我们的变量中有噪音的话,我们就在无形中把噪音和信息的权重变得相同,但PCA本身无法区分信号和噪音。在这样的情形下,我们就不必做定标。
一般而言,对于度量单位不同的指标或是取值范围彼此差异非常大的指标不直接由其协方差矩阵出发进行主成分分析,而应该考虑对数据的标准化。比如度量单位不同,有万人、万吨、万元、亿元,而数据间的差异性也非常大,小则几十大则几万,因此在用协方差矩阵求解主成分时存在协方差矩阵中数据的差异性很大。在后面提取主成分时发现,只提取了一个主成分,而此时并不能将所有的变量都解释到,这就没有真正起到降维的作用。此时就需要对数据进行定标(scale),这样提取的主成分可以覆盖更多的变量,这就实现主成分分析的最终目的。但是对原始数据进行标准化后更倾向于使得各个指标的作用在主成分分析构成中相等。对于数据取值范围不大或是度量单位相同的指标进行标准化处理后,其主成分分析的结果与仍由协方差矩阵出发求得的结果有较大区别。这是因为对数据标准化的过程实际上就是抹杀原有变量离散程度差异的过程,标准化后方差均为1,而实际上方差是对数据信息的重要概括形式,也就是说,对原始数据进行标准化后抹杀了一部分重要信息,因此才使得标准化后各变量在主成分构成中的作用趋于相等。因此,对同度量或是取值范围在同量级的数据还是直接使用非定标数据求解主成分为宜。
中心化和定标都会受数据中离群值(outliers)或者数据不均匀(比如数据被分为若干个小组)的影响,应该用更稳健的中心化和定标方法。
PCA也存在一些限制,例如它可以很好的解除线性相关,但是对于高阶相关性就没有办法了,对于存在高阶相关性的数据,可以考虑Kernel PCA,通过Kernel函数将非线性相关转为线性相关,关于这点就不展开讨论了。另外,PCA假设数据各主特征是分布在正交方向上,如果在非正交方向上存在几个方差较大的方向,PCA的效果就大打折扣了。
参考资料
https://www.zhihu.com/question/20998460
PCA 教程1
PCA 文字化描述
pca1
ggplot2 axis
scatterplot3D
稳健PCA
http://www.nlpca.org/pca_principal_component_analysis.html
Data centering
Sample R markdown
矩阵特征值,对称矩阵的对角化
Detail usage and visualization of prcomp result
ggplot2 side by side plot
PCA主成分分析实战和可视化 | 附R代码和测试数据
用了这么多年的PCA可视化竟然是错的!!!
这篇Nature子刊文章的蛋白组学数据PCA分析竟花费了我两天时间来重现|附全过程代码
复现nature communication PCA原图|代码分析(一)
