
一、背景介绍
最近一段时间,刘畊宏真是火出了天际,引起一股全民健身的热潮,毕竟锻炼身体,是个好事!
针对此热门事件,我用Python的爬虫和情感分析技术,针对小破站的弹幕数据,分析了众多网友弹幕的舆论导向,下面我们来看一下,是如何实现的分析过程。
二、代码讲解-爬虫部分
2.1 分析弹幕接口
首先分析B站弹幕接口。
经过分析,得到的弹幕地址有两种:
第一种:http://comment.bilibili.com/{cid}.xml
第二种:https://api.bilibili.com/x/v1/dm/list.so?oid={cid}这两种返回的结果一致!但都不全,都是只有部分弹幕!
以B站视频 网页链接 为例,查看网页源代码,可以找到对应的cid为574147025,所以该视频对应的弹幕接口地址是:
http://comment.bilibili.com/574147025.xml
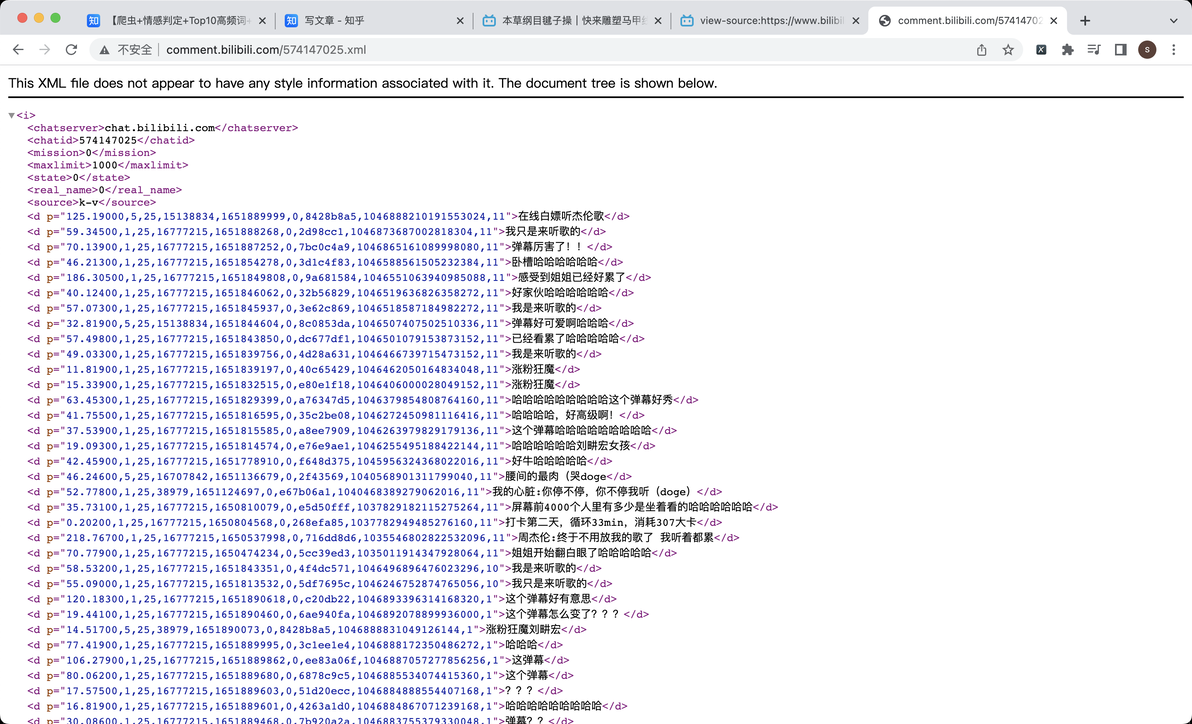
弹幕页面
既然这样,就好办了,开始撸代码!
2.2 讲解爬虫代码
首先,导入需要用到的库:
import re  # 正则表达式提取文本
import requests  # 爬虫发送请求
from bs4 import BeautifulSoup as BS  # 爬虫解析页面
import time
import pandas as pd  # 存入csv文件
import os然后,向视频地址发送请求,解析出cid号:
r1 = requests.get(url=v_url, headers=headers)
html1 = r1.text
cid = re.findall('cid=(.*?)&aid=', html1)[0]  # 获取视频对应的cid号
print('该视频的cid是:', cid)根据cid号,拼出xml接口地址,并再次发送请求:
danmu_url = 'http://comment.bilibili.com/{}.xml'.format(cid)  # 弹幕地址
print('弹幕地址是:', danmu_url)
r2 = requests.get(danmu_url)
解析xml页面:<d>标签的文本内容为弹幕,<d>标签内p属性值(按逗号分隔)的第四个字段是时间戳:
soup = BS(html2, &#39;xml&#39;)
danmu_list = soup.find_all(&#39;d&#39;)
print(&#39;共爬取到{}条弹幕&#39;.format(len(danmu_list)))
video_url_list = [] # 视频地址
danmu_url_list = [] # 弹幕地址
time_list = [] # 弹幕时间
text_list = [] # 弹幕内容
for d in danmu_list:
data_split = d[&#39;p&#39;].split(&#39;,&#39;) # 按逗号分隔
temp_time = time.localtime(int(data_split[4])) # 转换时间格式
danmu_time = time.strftime(&quot;%Y-%m-%d %H:%M:%S&quot;, temp_time)
video_url_list.append(v_url)
danmu_url_list.append(danmu_url)
time_list.append(danmu_time)
text_list.append(d.text)
print(&#39;{}:{}&#39;.format(danmu_time, d.text))
保存时应注意,为了避免多次写入csv标题头,像这样:
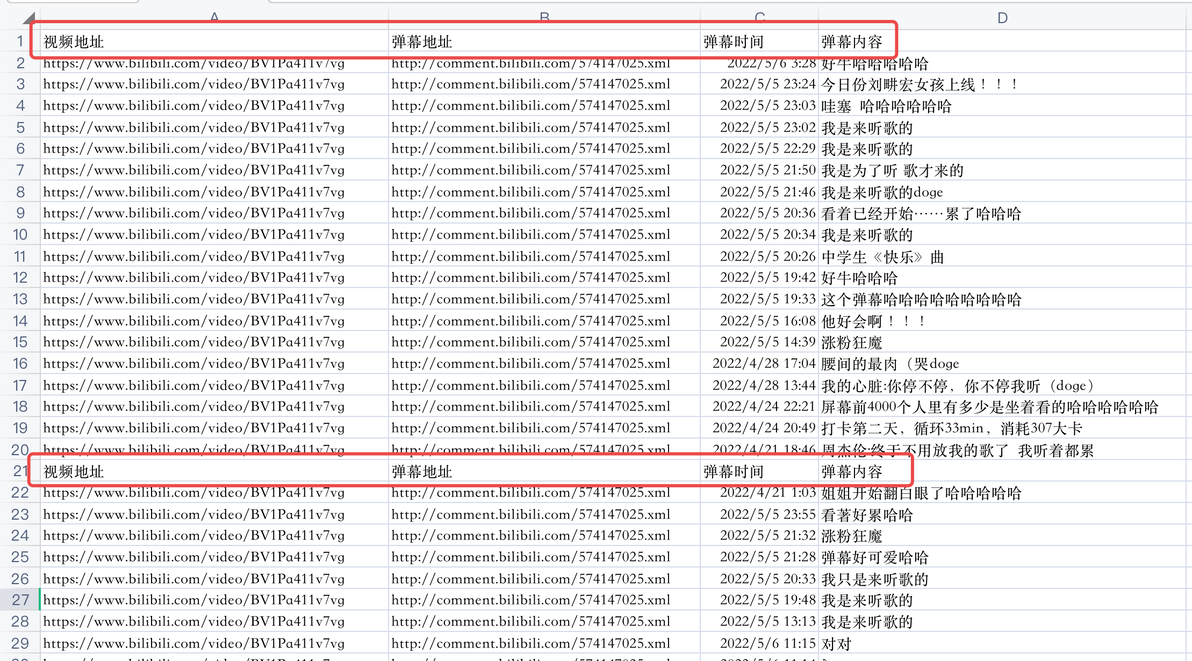
重复写入标题问题
这里,我写了一个处理逻辑,大家看注释,应该能明白:
if os.path.exists(v_result_file): # 如果文件存在,不需写入字段标题
header = None
else: # 如果文件不存在,说明是第一次新建文件,需写入字段标题
header = [&#39;视频地址&#39;, &#39;弹幕地址&#39;, &#39;弹幕时间&#39;, &#39;弹幕内容&#39;]
df.to_csv(v_result_file, encoding=&#39;utf_8_sig&#39;, mode=&#39;a+&#39;, index=False, header=header) # 数据保存到csv文件需要注意的是,encoding参数赋值为utf_8_sig,不然csv内容可能会产生乱码,避免踩坑!
三、代码讲解-情感分析部分
3.1 整体思路
针对情感分析需求,我主要做了三个步骤的分析工作:
用SnowNLP给弹幕内容打标:积极、消极,并统计占比情况
用jieba.analyse分词,并统计top10高频词
用WordCloud绘制词云图
首先,导入csv数据,并做数据清洗工作,不再赘述。
下面,正式进入情感分析代码部分:
3.2 情感分析打标
情感分析计算得分值、分类打标,并画出饼图。
# 情感判定
for comment in v_cmt_list:
tag = &#39;&#39;
sentiments_score = SnowNLP(comment).sentiments
if sentiments_score &lt; 0.5:
tag = &#39;消极&#39;
neg_count += 1
elif sentiments_score &gt; 0.5:
tag = &#39;积极&#39;
pos_count += 1
else:
tag = &#39;中性&#39;
mid_count += 1
score_list.append(sentiments_score) # 得分值
tag_list.append(tag) # 判定结果
df[&#39;情感得分&#39;] = score_list
df[&#39;分析结果&#39;] = tag_list这里,我设定情感得分值小于0.5为消极,大于0.5为积极,等于0.5为中性。(这个分界线,没有统一标准,根据数据分布情况和分析经验自己设定分界线即可)
情感判定结果:
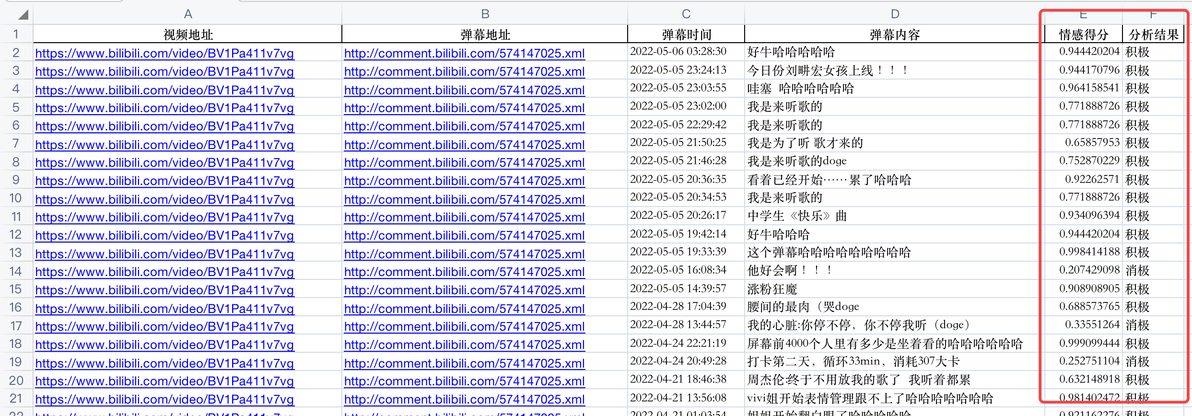
画出占比饼图的代码:
grp = df[&#39;分析结果&#39;].value_counts()
print(&#39;正负面评论统计:&#39;)
print(grp)
grp.plot.pie(y=&#39;分析结果&#39;, autopct=&#39;%.2f%%&#39;) # 画饼图
plt.title(&#39;刘畊宏弹幕_情感分布占比图&#39;)
plt.savefig(&#39;刘畊宏弹幕_情感分布占比图.png&#39;) # 保存图片
饼图结果:
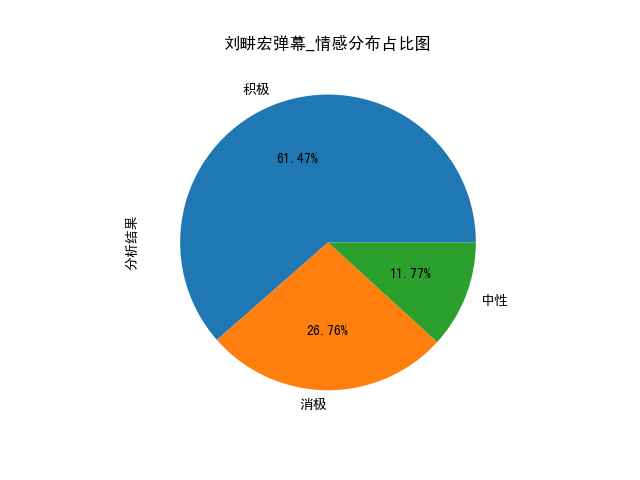
从占比结果来看,大部分网友还是很认可刘畊宏的。
3.3 统计top10高频词
代码如下:
# 2、用jieba统计弹幕中的top10高频词
keywords_top10 = jieba.analyse.extract_tags(v_cmt_str, withWeight=True, topK=10)
print(&#39;top10关键词及权重:&#39;)
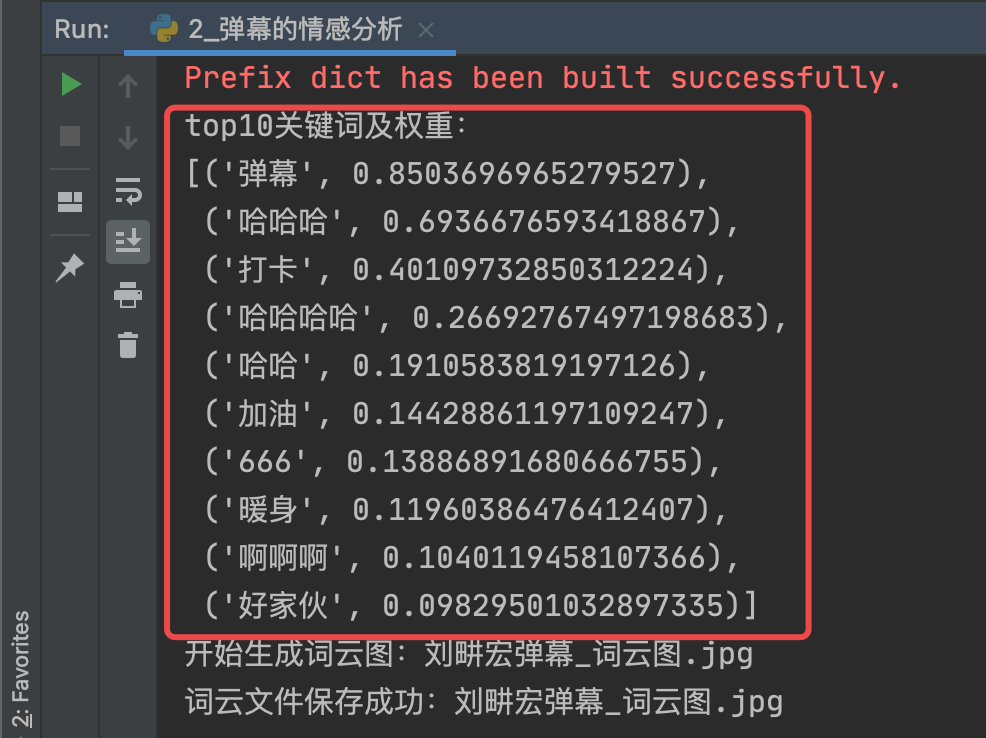
pprint(keywords_top10)这里需要注意,在调用jieba.analyse.extract_tags函数时,要导入的是import jieba.analyse 而不是 import jieba
统计结果为:(分为10组关键词及其权重,权重按倒序排序)
3.4 绘制词云图
注意别踩坑:
想要通过原始图片的形状生成词云图,原始图片一定要白色背景(实在没有的话,PS修图修一个吧),否则生成的是满屏词云!!
try:
stopwords = v_stopwords # 停用词
backgroud_Image = np.array(Image.open(&#39;刘畊宏_背景图.png&#39;)) # 读取背景图片
wc = WordCloud(
background_color=&quot;white&quot;, # 背景颜色
width=1500, # 图宽
height=1200, # 图高
max_words=1000, # 最多字数
font_path=&#39;/System/Library/Fonts/SimHei.ttf&#39;, # 字体文件路径,根据实际情况(Mac)替换
# font_path=&quot;C:\Windows\Fonts\simhei.ttf&quot;, # 字体文件路径,根据实际情况(Windows)替换
stopwords=stopwords, # 停用词
mask=backgroud_Image, # 背景图片
)
jieba_text = &quot; &quot;.join(jieba.lcut(v_str)) # jieba分词
wc.generate_from_text(jieba_text) # 生成词云图
wc.to_file(v_outfile) # 保存图片文件
print(&#39;词云文件保存成功:{}&#39;.format(v_outfile))
except Exception as e:
print(&#39;make_wordcloud except: {}&#39;.format(str(e)))得到的词云图,和原始背景图对比一下:
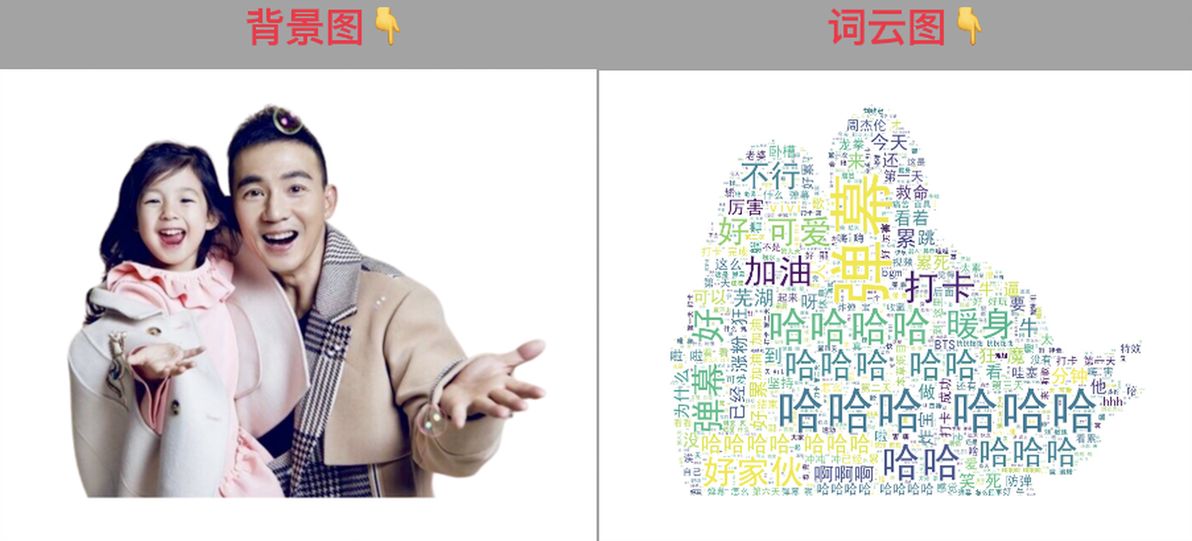
词云图
3.5 情感分析结论
打标结果中,积极和中性评价占约72%,远远大于消极评价!
top10关键词统计结果中,"哈哈哈"、"打卡"、"加油"、"666"等好评词汇占据多数!
词云图中,"哈哈"、"打卡"、"厉害"、"加油"等好评词看上去更大(词频高)!
综上所述,经分析"刘畊宏"相关弹幕,得出结论:
众多网友对刘畊宏的评价都很高,毕竟不但带领全面健身这样正能量的事,还是杰伦的好兄弟,谁能不爱呢!
给他点赞!!
四、同步演示视频
演示代码执行过程:
五、获取python源码
爱学习的小伙伴,本次分析过程的全部python源码(爬虫+情感分析)及结果数据,我已打包好,并上传至我的微信公众号"老男孩的平凡之路",后台回复"刘畊宏"即可获取!
我是@马哥python说,持续分享python源码干货!
