
1. 绪论
1.1 GPU(Programmable Graphics Processing Unit)发展历程
Programmable Graphics Processing Unit(GPU),即可编程图形处理单元, 通常也称之为可编程图形硬件。
GPU 概念在 20 世纪 70 年代末和 80 年代初被提出,使用单片集成电路 (monolithic)作为图形芯片,此时的 GPU 已经被用于视频游戏和动画方面,它能够很快地进行几张图片的合成(仅限于此)。
在 20 世纪 80 年代末到 90 年代 初这段时间内,基于数字信号处理芯片(digital signal processor chip)的 GPU 被 研发出来,与前代相比速度更快、功能更强,当然价格是非常的昂贵。
在 1991 年,S3 Graphics 公司研制出第一个单芯片 2D 加速器,到了 1995 年,主流的 PC 图形芯片厂商都在自己的芯片上增加了对 2D 加速器的支持。
与此同时,固定功 能的视窗加速器(fixed-function Windows accelerators)由于其高昂的价格而慢慢 退出 PC 市场。
1998 年 NVIDIA 公司宣布 modern GPU 的研发成功,标志着 GPU 研发的历 史性突破成为现实。通常将 20 世纪 70 年代末到 1998 年的这一段时间称之为 pre-GPU 时期,而自 1998 年往后的 GPU 称之为 modern GPU。
modern GPU 使用晶体管(transistors)进行计算,在微芯片(microchip)中, GPU 所使用的晶体管已经远远超过 CPU。
回顾 Modern GPU 的发展历史,自 1998 年后可以分为 4 个阶段。
NVIDIA 于 1998 年宣布 Modern GPU 研发成功,这标志着第一代 Modern GPU 的诞生, 第一代 Modern GPU 包括 NVIDIA TNT2,ATI 的 Rage 和 3Dfx 的 Voodoo3,但是很遗憾不支持顶点变换。
从 1999 到 2000 年,是第二代 modern GPU 的发展时期。这一时期的 GPU 可以进行三维坐标转换和光照计算(3D Object Transformation and Lighting, T&L),并且 OpenGL 和 DirectX7 都提供了开发接口,支持应用程序使用基于 硬件的坐标变换。这是一个非常重要的时期,在此之前只有高级工作站 (workstation)的图形硬件才支持快速的顶点变换。同时,这一阶段的 GPU 对 于纹理的操作也扩展到了立方体纹理(cube map)。NVIDIA 的 GeForce256, GeForce MAX,ATI 的 Radeon 7500 等都是在这一阶段研发的。
2001 年是第三代 modern GPU 的发展时期,这一时期研发的 GPU 提供 vertex programmability(顶点编程能力),如 GeForce 3,GeForce 4Ti,ATI 的 8500 等。 这些 GPU 允许应用程序指定一个序列的指令进行顶点操作控制(GPU 编程的本 质!),这同样是一个具有开创意义的时期。
第四代 modern GPU 的发展时期从 2002 年末到 2003 年。NVIDIA的GeForce FX和ATI Radeon 9700 同时在市场的舞台上闪亮登场,这两种GPU都支持vertex programmability 和 fragment programmability。自 2003 年起,可编程图形硬件正式诞生,并且由于 DirectX 和 OpenGL 锲而不舍的追赶 潮流,导致基于图形硬件的编程技术,简称 GPU 编程,也宣告诞生。
1.2 GPU VS CPU
为什么CPU之外要发展GPU?GPU的vertex programmability贺fragment programmability究竟在何处有什么优势?
GPU拥有高并行结构(highly parallel structure)。
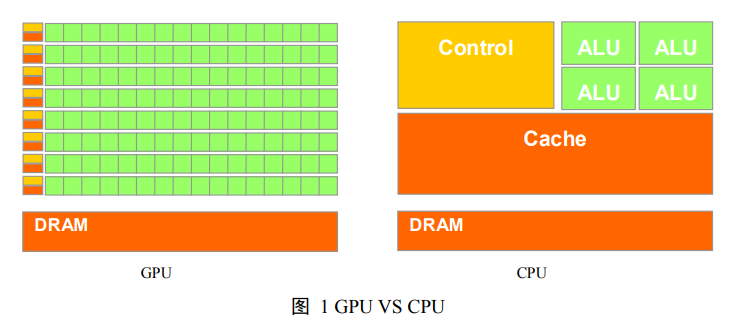
DRAM(动态随机存取存储器(Dynamic Random Access Memory,DRAM)是一种半导体存储器,主要的作用原理是利用电容内存储电荷的多寡来代表一个二进制比特(bit)是1还是0)
CPU大部分面积为控制器和寄存器,而GPU拥有更多的ALU(Arithmetic Logic Unit,逻辑运算单元)用于数据处理,而非数据高速缓存和流控制,这样的结构适合对数据进行并行处理。
CPU一个时刻只处理一个数据,不存在真正的并行处理。而GPU才是真正的并行处理。
GPU采用的是并行计算模式,对每个数据进行独立的并行计算,即流内任意元素的计算不依赖于其它同类型数据。
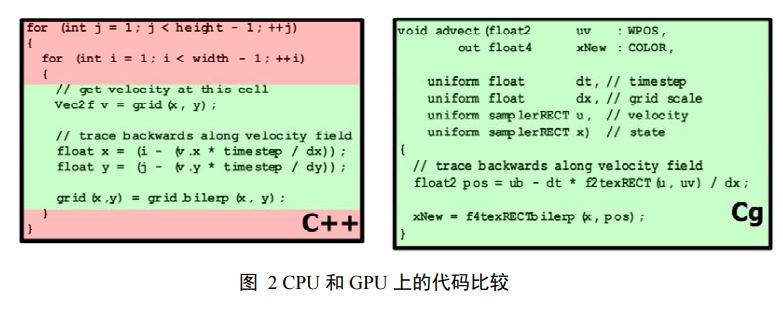
在CPU上运算的C++代码通过循环语句依次遍历像素,而GPU上则一是一条语句就足够了。
为什么不用GPU完全代替CPU?
首先,虽然 GPU 采用数据并行处理方式极大加快了运算速度,但正是由于 “任意一个元素的计算不依赖于其它同类型数据”,导致“需要知道数据之间相关 性的”算法,在 GPU 上难以得到实现(但在 CPU 上则可以方便的实现),一个典型的例子是射线与不规则物体的求交运算。
GPU在控制流方面弱于CPU,GPU中的控制器少于CPU,而控制器的主要功能是取指令,并指出下一条指令在内存中的位置,控制和协调计算机的各个部件有条不紊地工作。
最后进行 GPU 编程必须掌握计算机图像学相关知识,以及图形处理 API,入门门槛较高,学习周期较长,尤其国内关于 GPU 编程的资料较为匮乏,这些 都导致了学习的难度。
2. GPU图形绘制管线
在《实时计算机图形学》一书中,将图形绘制管线分为三个主要阶段:应用程序阶段、几何阶段、光栅阶段。
应用程序阶段,使用高级编程语言(C、C++、JAVA 等)进行开发,主要和 CPU、内存打交道,诸如碰撞检测、场景图建立、空间八叉树更新、视锥裁剪等 经典算法都在此阶段执行。在该阶段的末端,几何体数据(顶点坐标、法向量、 纹理坐标、纹理等)通过数据总线传送到图形硬件(时间瓶颈):
数据总线是一 个可以共享的通道,用于在多个设备之间传送数据;
端口是在两个设备之间传送 数据的通道;
带宽用来描述端口或者总线上的吞吐量,可以用每秒字节(b/s)来度量,数据总线和端口(如加速图形端口,Accelerated Graphic Port,AGP)将 不同的功能模块“粘接”在一起。
由于端口和数据总线均具有数据传输能力,因此 通常也将端口认为是数据总线(实时计算机图形学387页)。
几何阶段,主要负责顶点坐标变换、光照、裁剪、投影以及屏幕映射,该阶段基于 GPU 进行运算,在该阶段的末端得到了经过 变换和投影之后的顶点坐标、颜色、以及纹理坐标。
光栅阶段,基于几何阶段的输出数据,为像素(Pixel)正确配色,以便绘制完整图像,该阶段进行的都是单个像素的操作,每个像素的信息存储在颜色缓冲器(color buffer 或者 frame buffer)中。
光照计算和雾化阶段都属于几何阶段。
2.1 几何阶段
几何阶段的主要工作是“变换三维顶点坐标”和“光照计算”,显卡信息中通常会有一个标示为“T&L”硬件部分,所谓“T&L”即 Transform & Lighting。
一定要牢记,显示屏是二维的,GPU 所需要做的是将三维的数据,绘制到二维屏幕上,并到达“跃然纸面”的效果。顶点变换中的每个过程都是为了这个目 的而存在,为了让二维的画面看起具有三维立体感。
根据顶点坐标变换的先后顺序,主要有如下几个坐标空间,或者说坐标类型: Object space,模型坐标空间;World space,世界坐标系空间;Eye space,观察坐 标空间;Clip and Project space,屏幕坐标空间。
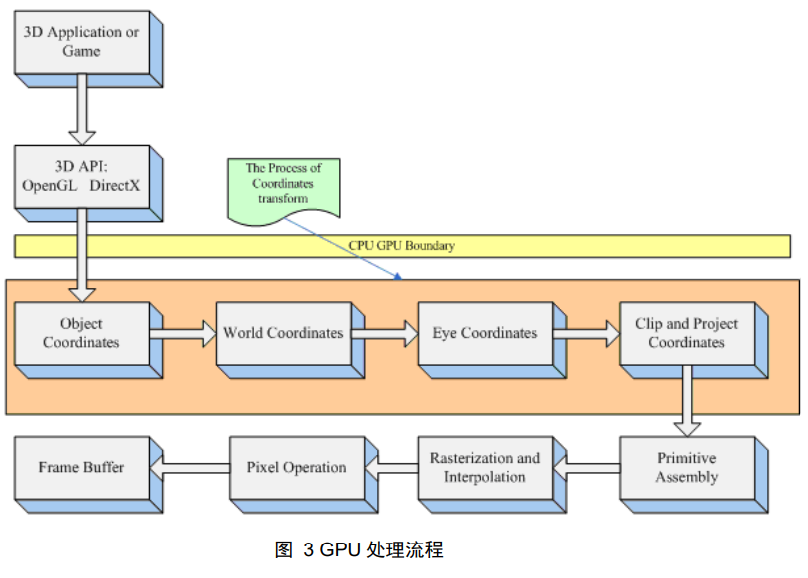
2.1.1 从object space到world space
法向量从 object space 到 world space 的转换矩阵是 world matrix 的转置矩阵 的逆矩阵。
2.1.2 从world space到eye space
所谓eye space,即以 camera(视点或相机)为原点,由视线方向、视角和远近平面,共同组成一个梯形体的三维空间,称之为 viewing frustum(视锥)。而超出这个梯形体之外 的场景数据,会被视点去除(Frustum Culling,也称之为视锥裁剪)。
2.1.3 从eye space到project and clip space
一旦顶点坐标被转换到 eye space中,就需要判断哪些点是视点可见的。
裁剪被安排到一个单位立方体中进行,该立方体的对角顶点分别是 (-1,-1,-1)和(1,1,1),通常称这个单位立方体为规范立方体(Canonical view volume, CVV)。
多边形裁剪就是CVV中完成的。所以,从视点坐标空间到屏幕坐标空间(screen coordinate space)事实上是由三步组成:
1. 用透视变换矩阵把顶点从视锥体中变换到裁剪空间的CVV中;
2. 在CVV进行图元裁剪;
3. 屏幕映射:将经过前述过程得到的坐标映射到屏幕坐标系上。
2.2 图元装配
Primitive Assembly,图元装配,即将顶点根据primitive(原始的连接关系),27还原出网格结构。
网格由顶点和索引组成,在之前的流水线中是对顶点的处理,在这个阶段是根据索引将顶点连接在一起,组成线、面单元。
之后就是对超出屏幕外的三角形进行裁剪,想象一下:一个三角形其中一个顶点在画面外,另外两 个顶点在画面内,这是我们在屏幕上看到的就是一个四边形。然后将该四边形切 成两个小的三角形。
此外还有一个操作涉及到三角形的顶点顺序(其实也就是三角形的法向量朝 向),根据右手定则来决定三角面片的法向量,如果该法向量朝向视点(法向量 与到视点的方向的点积为正),则该面是正面。一般是顶点按照逆时针排列如 果该面是反面,则进行背面去除操作(Back-face Culling)。在 OpenGL中有专门的函数enable和disable背面去除操作。所有的裁剪剔除计算都是为了减少需要绘制的顶点个数。
处理三角形的过程被称为Triangle Setup。到目前位置,我们得到了一堆在屏幕坐标上的三角面片,这些面片是用于做光栅化的(Rasterizing)。
2.3 光栅化阶段
2.3.1 Rasterization
光栅化:决定哪些像素被几何图元覆盖的过程(Rasterization is the process of determining the set of pixels covered by a geometric primitive)。
现在还有两个问题:
一、点的屏幕坐标值是浮点数,但像素都是由整数点来表示的,如何确定屏幕坐标值所对应的像素?
绘制的位置只能接近两指定端点间的实际线段位置, 例如,一条线段的位置是(10.48,20.51),转换为像素位置则是(10,21)。
二、在屏幕上需要绘制的有点、线、面,如何根据两个已经确定位置的2个像素点绘制一条线段,如何根据已经确定了位置的 3 个像素点绘制一个三角形面片?
于问题二涉及到具体的画线算法,以及区域图元填充算法。通常的画线算 法有 DDA 算法、Bresenham 画线算法;区域图元填充算法有,扫描线多边形填 充算法、边界填充算法等,具体请参阅《计算机图形学(第二版)》第 3 章。
这个过程结束之后,顶点(vertex)以及绘制图元(线、面)已经对应到像素 (pixel)。下面阐述的是“如何处理像素,即:给像素赋予颜色值”。
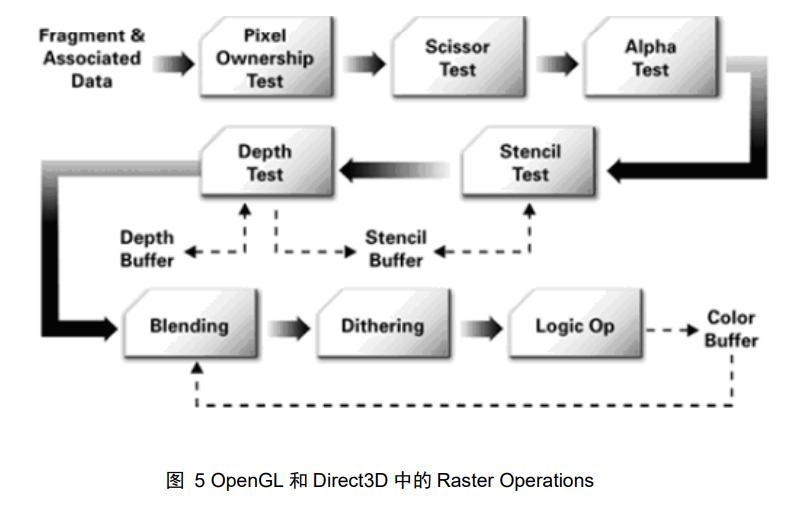
2.3.2 Pixel Operation
Pixel operation 又称为 Raster Operation。
Pixel operation 包含哪些事情呢?
1. 消除遮挡面;
2. Texture operation,纹理操作,也就是根据像素的纹理坐标,查询对应的纹理值;
3. Blending;
当在屏幕上绘制某个物体时,与每个像素都相关联的哟一个 RGB 颜色值和一个 Z 缓冲器深度值,另外一个称为是 alpha 值,可以根据需要生成并存储,用来描述给定像素处的物体透明度。如果 alpha 值为 1.0,则表示物体不透明;如果值为 0,表示该物体是透明的。
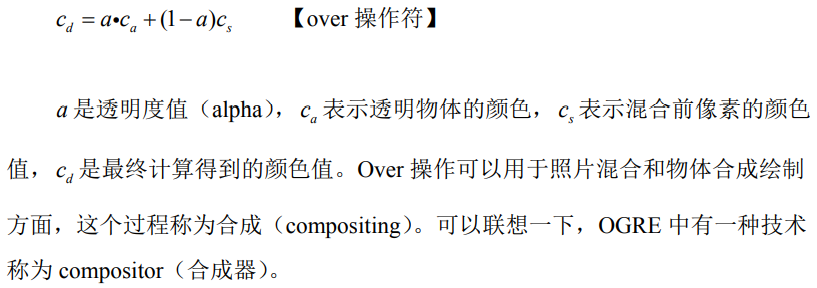
4. Filtering,将正在算的颜色经过某种 Filtering(滤波或者滤镜)后输出。 可以理解为:经过一种数学运算后变成新的颜色值。
该阶段之后,像素的颜色值被写入帧缓存中。
2.4 图形硬件
2.4.1 GPU内存架构
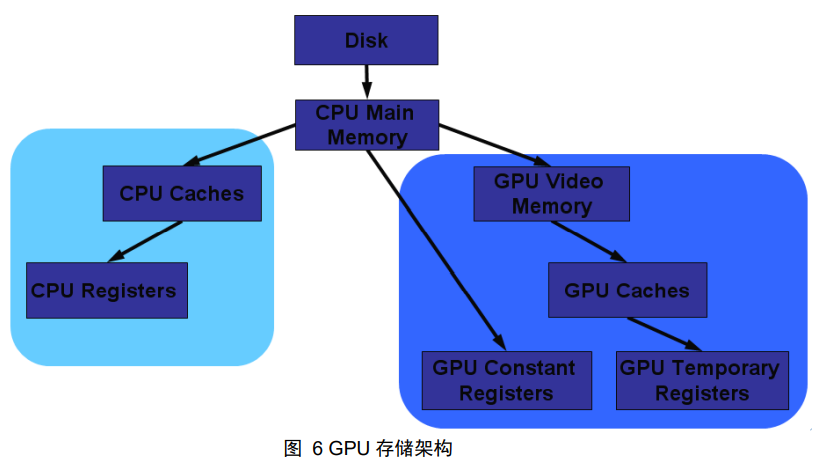
寄存器(Register)和内存(Cache)有什么区别?
从物理结构而言,寄存器是 cpu 或 gpu 内部的存储单元,即寄存器是嵌入在 cpu 或者 gpu 中的,而内存则可以独立存在;
从功能上而言,寄存器是有限存储容量的高速存储部件,用来暂存指令、数据和位址。Shader 编程是基于计算机图形硬件的,这其中就包括 GPU 上的寄存器类型,glsl 和 hlsl 的着色虚拟机版本就是基于 GPU 的寄存器和指令集而区分的。
2.4.2 Z Buffer与Z值
Z buffer 又称为 depth buffer,即深度缓冲区,其中存放的是视点到每个像素所对应的空间点的距离衡量,称之为 Z 值 或者深度值。
可见物体的 Z 值范围位于[0,1]区间。
大多数人所忽略的是,z buffer 中存放的 z 值不一定是线性变化的。在正投影中同一图元相邻像素的 Z 值是线性关系的,但在透视投影中却不是的。
图元顶点位置信息是在应用程序中指定的(顶点模型坐 标),然后通过一系列的过程变换到屏幕空间,但是图元内部点的屏幕坐标必须由已知的顶点信息插值而来。
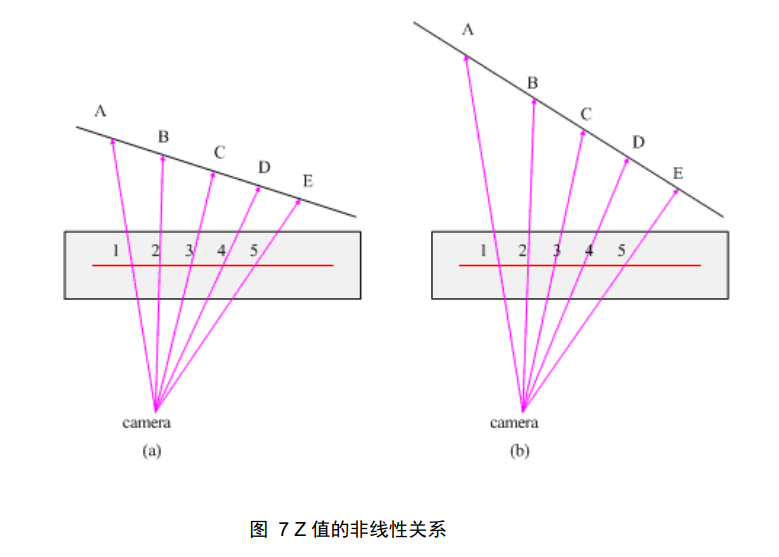
线段 AE 是某三角面片的两个顶点,投影到屏幕空间对应到 像素 1 和像素 5;光栅化时,需要对像素 2、3、4 进行属性插值,从视点引射线 到空间线段上的交点分别为 B、C、D。从图中可以看出,点 B、C、D 并不是均 匀分布在空间线段上的,而且如果离视点越远,这种差异就越发突出。即,投影 面上相等的步长,在空间中对应的步长会随着离视点距离的增加而变长。所以如 果对内部像素点的 Z 值进行线性插值,得到的 Z 值并不能反应真实的空间点的 深度关系。Z 值的不准确,会导致物体显示顺序的错乱,例如,在游戏中常会看到远处的一些面片相互交叠。
为了避免或减轻上述的情况,在设置视点相机远裁减面和近裁减面时,两者 的比值应尽量小于 1000。要想解决这个问题,最简单的方法是通过将近截面远离眼睛来降低比值,不过这种方法的副作用时可能会将眼前的物体裁减掉。
2.4.3 Stencil Buffer
Stencil buffer,中文翻译为“模板缓冲区”,它是一个额外的 buffer,通常附加 到 z buffer 中。每个像素对应 34 一个 stencil buffer(其实就是对应一个 Z buffer)。
Z buffer 和 stencil buffer 通常在 显存中共享同一片区域。Stencil buffer 对大部分人而言应该比较陌生,这是一个 用来“做记号”的 buffer,例如:在一个像素的 stencil buffer 中存放 1,表示该像素对应的空间点处于阴影体(shadow volume)中。
2.4.4 Frame Buffer
Frame buffer,称为帧缓冲器,用于存放显示输出的数据,这个 buffer 中的数据一般是像素颜色值。Frame buffer 有时也被认为是 color buffer(颜色缓冲器) 和 z buffer 的组合。
那么 frame buffer 位于什么地方呢?在 webMediaBrands 网站上摘录了一段英文说明,即 frame buffer 通常都在显卡上,但是有时显卡会集成到主板上,所以这种情况下 frame buffer 被放在内存区域 (general main memory)。
2.5 本章小结
本章介绍了 GPU 图形绘制管线,并对相关的图形硬件进行了阐述。图形绘制管线是 GPU 编程的基础,事实上顶点着色程序和片段着色程序正是按照图形绘制管线而划分的。
