
提到Minimax H3视频生成,本地运行的卡点就是速度慢,其次是加速后,质量变差劣化!
有没有鱼和熊掌兼得的方案呢?
有的,包有的!
这个方案的思路是,目前速度方面,比较好的解决办法是light2v的加速Lora和注意力加速机制。
light2v方案中,分为4步Lora和8步Lora,对比下来,8步Lora兼顾了速度和质量,但是refl2va的效果一直不好,fl2va的加速效果和质量比较稳定。
于是,我们想到,能不能在fl2va模型的加速条件下,使用refl2va的功能,让多参的模型上一个台阶?
可以的,但是不是简单的合并五五开,这样解决不了冲突问题。于是在做了大量测试和优化后,通过算法的合成和嫁接,最后再测试优化后,新的解决方案Smart MiniMax H3 Hybrid Loader节点诞生了!
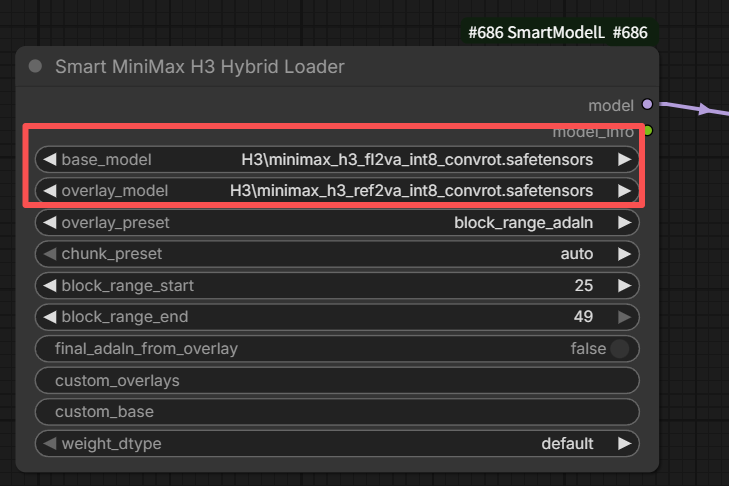
它解决了上面提到的全部问题!
这时,问题又来了:使用2个30多G的模型,本地显卡的显存不得炸啊?谁承受得了?
不必担心,我们已经解决了这个问题,我们在8G显存的显卡+16G内存上完美跑通解决!
7s的视频,305s完成包含提示词生成的全工作流!
采样只需185s!不会爆显存!
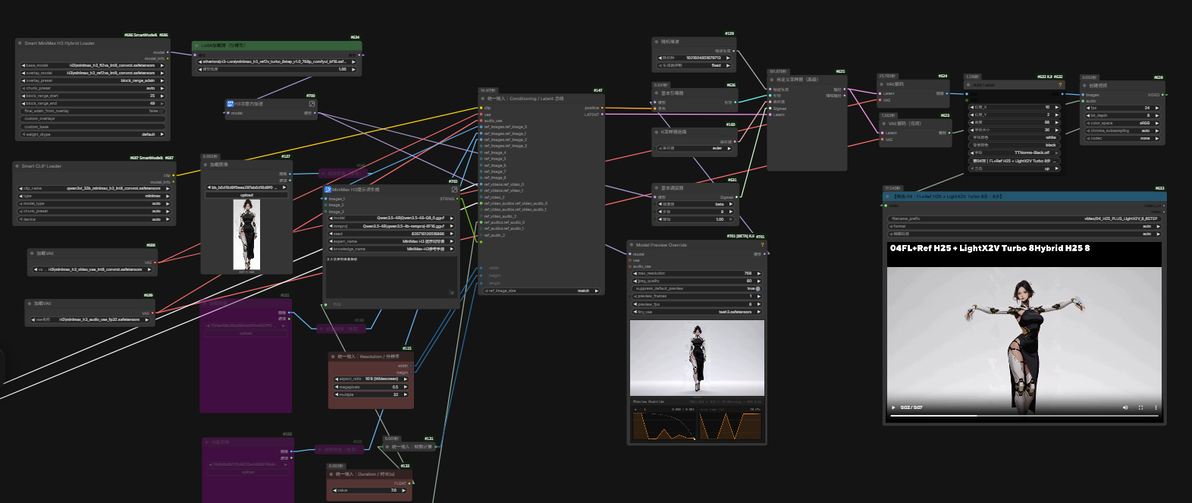
想复现我们的工作流需要以下准备:
1.minimax_h3_fi2va_int8_convrot.safetensors和minimax_h3_ref2va_int8_convrot.safetensors模型,约60多G;
2.minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16的light2v的8步加速Lora,约2G;
3.Smart MiniMax H3 Hybrid Loader节点,需要安装SmartModelloader插件,插件下载地址在文章末尾;
4.我还使用了sage和sol注意力加速。
我们还测试了15s视频生成,用时15分钟。所以只要你的显存大于等于8G,15s的视频都是可以无压力生成的!相当Nice!
SmartModelloader插件下载地址:https://pan.quark.cn/s/8187cc06932e
欢迎一键三连,使用中遇到问题,可以在评论区留言,也可以进群交流,网盘中有群码,扫码进入!
