
在指哪打哪这个方面,开源模型中,Qwen2.1-image还是遥遥领先的!
普通的图片编辑任务,例如换头,改颜色,换服装等等都是手到擒来!
但是在特殊要求任务里,能够做到Qwen2.1的水平的,可能就是闭源图像编辑模型了。
下面来看看Comfyui中,比较特殊的一些任务的处理效果。
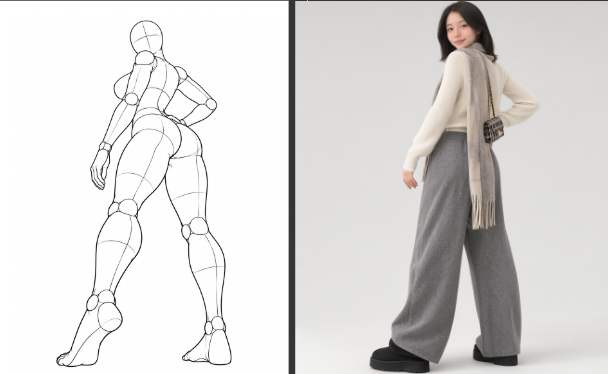
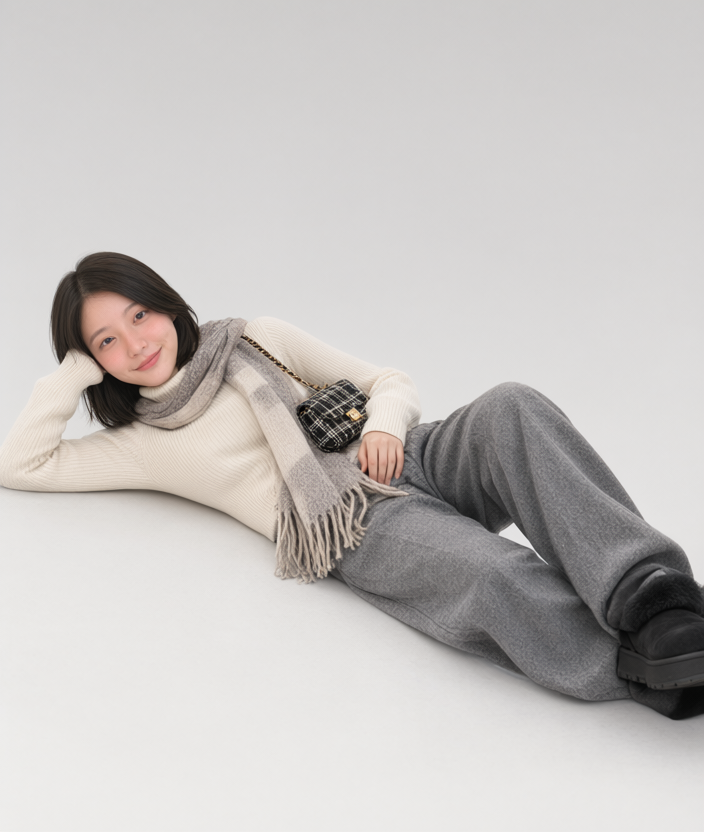
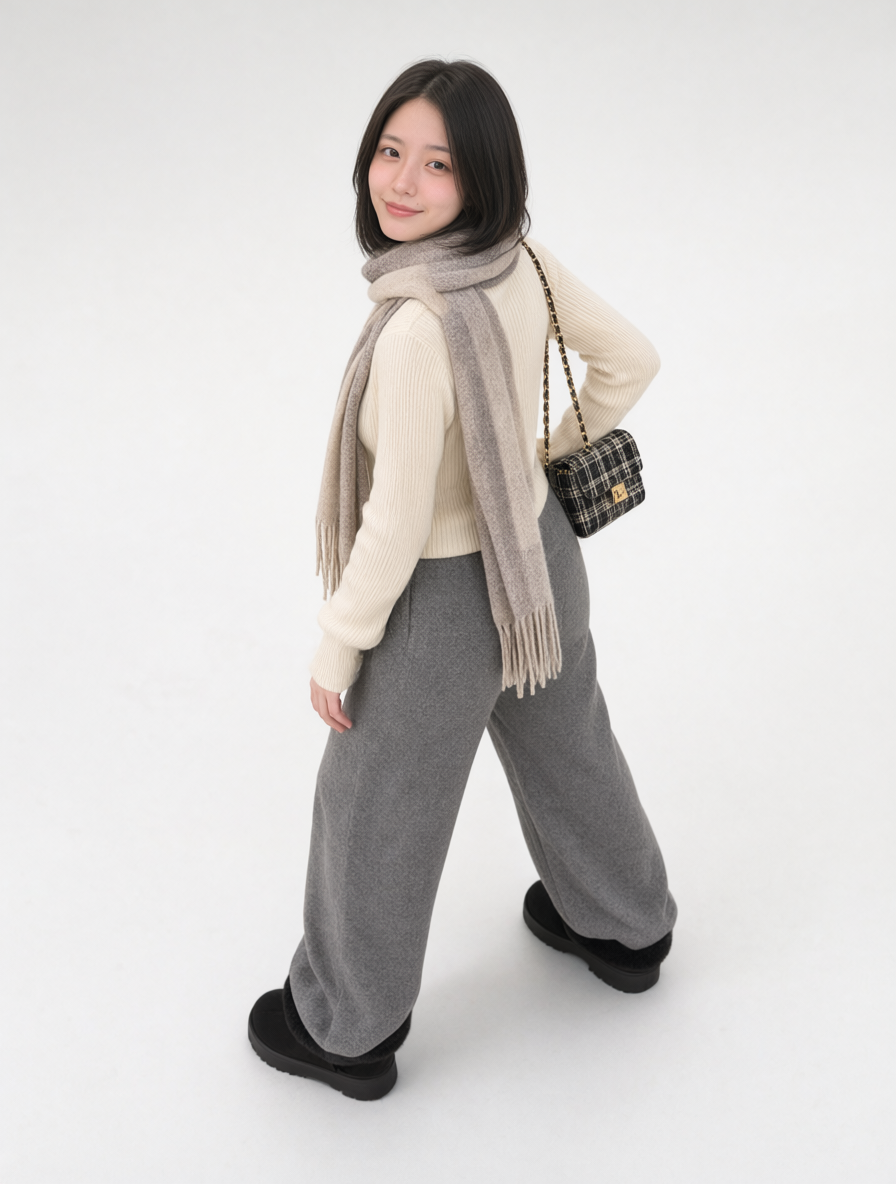
这些姿势大家可以尝试用不同模型生成,看看是否能够达到效果。
我在前期的测试中,这些姿势生成出来都是很诡异的,并不自然,也达不到效果。
测试使用3图融合工作流
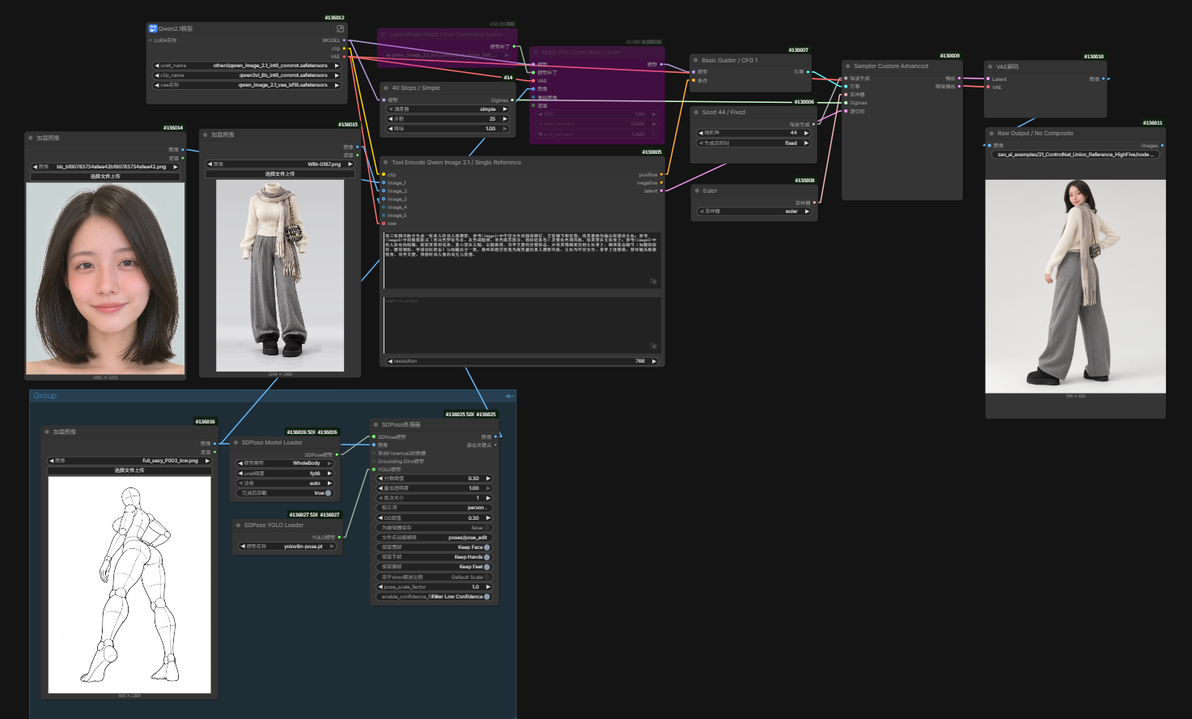
Qwen2.1生图失败经验分享:
1.手写提示词,描述姿势和动作,使用了加速Lora,结果:姿势没还原,人物手脚模糊扭曲。X
2.使用qwen3.5生成提示词,不使用任何Lora,25步生成,结果:人物正常了,但是动作姿势不还原,有随机姿势。X
3.使用调整后的专用提示词,使用Controlnet的openpose,不使用任何Lora,25步生成,结果:人物姿势扭曲,不能正确识别背对镜头转身等描述,人物整体诡异。X
4.使用调整后的专用提示词,不使用任何Lora,25步生成,结果:人物正常,姿势基本还原,略有小不同。V
5.使用调整后的专用提示词,使用Controlnet的openpose,引导姿势,不使用任何Lora,25步生成,结果:人物正常,姿势还原准确。V
通过上面的对比生成,总结以下特点:
1.提示词最重要,尽量使用qwen2.1的skill生成,姿势要准确描述。
2.Controlnet可以锦上添花,有效辅助姿势的准确生成。
3.不要使用任何lora,不论是一致性,加速,美化等等Lora都不要使用,严重影响生图效果,使用原始生成方法。
以后再看到喜欢的人物姿势,都可以完美复刻了!
喜欢讨论交流的小伙伴可以加入我们,共同学习,扫码进入!
https://pan.quark.cn/s/8187cc06932e
也可以一键三连,在评论区说说你的想法和经验。
