
用一座工厂理解 nv-uefi-unlocker 的工作原理
同一张 RTX 4060 Ti,在公开对照中,两种矩阵计算的吞吐提高了约六成,另一种对照计算却几乎没变。理解这种差别,要从显卡内部的分工说起。[7]
下面把显卡当作一座工厂:计算单元是工位,固件像管理人员,受保护的设置像上锁的控制柜。顺着这条线,可以看清工具怎样取得修改机会、调整设置,并把显卡交给系统继续使用。
本文依据 2026 年 10 月 28 日的仓库版本 51bc8b49,以 Ada 路径为主。性能数字来自公开报告;图中的工厂、门禁和旋钮是帮助理解的比喻。
一 工厂里有不同的计算车间
图 1 普通计算与矩阵计算
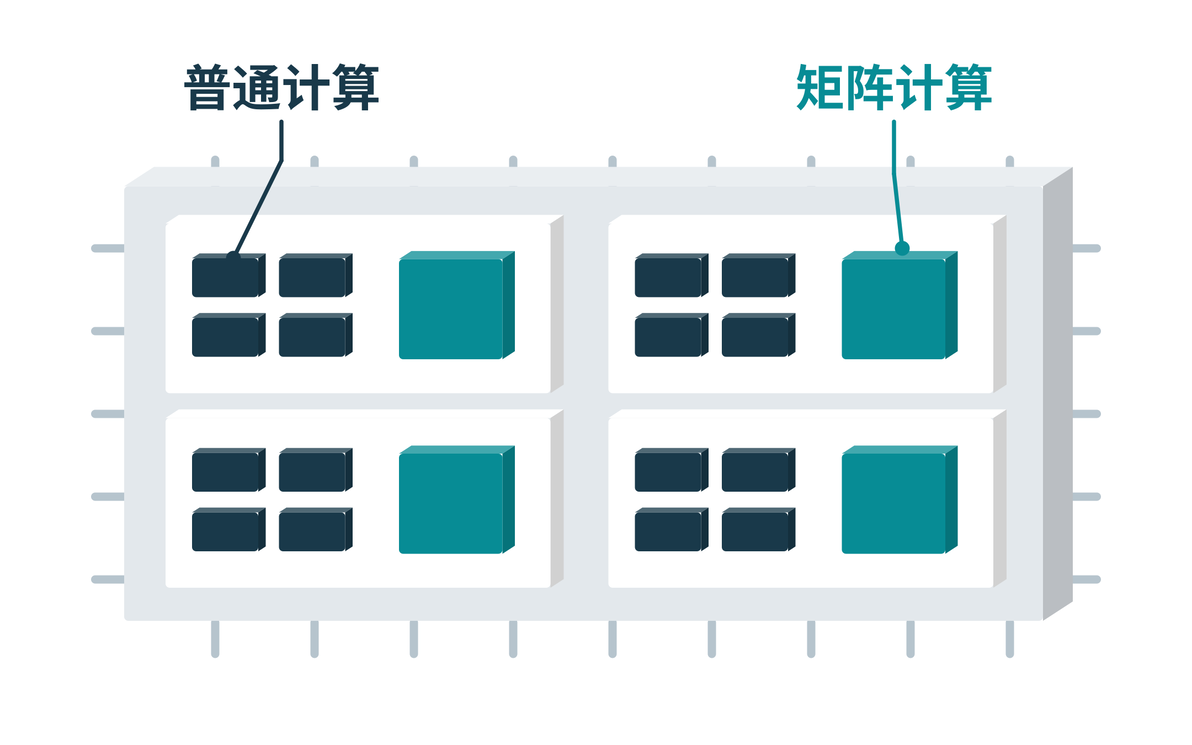
图 1 根据 NVIDIA Ada 白皮书简化。显卡的核心计算芯片叫 GPU,其中的一组计算资源 SM 可以类比成车间:常规运算单元处理普通计算,Tensor Core 擅长成批矩阵乘加。图中只保留功能分组,不表示真实版图。[2]
同一座工厂,包装、装配、运输各有速度。显卡也一样,某一种运算变快,不能直接推出每一种工作都会同比变快。所谓“算力”,首先要说清楚测的是什么。
图 2 矩阵为什么适合成批计算
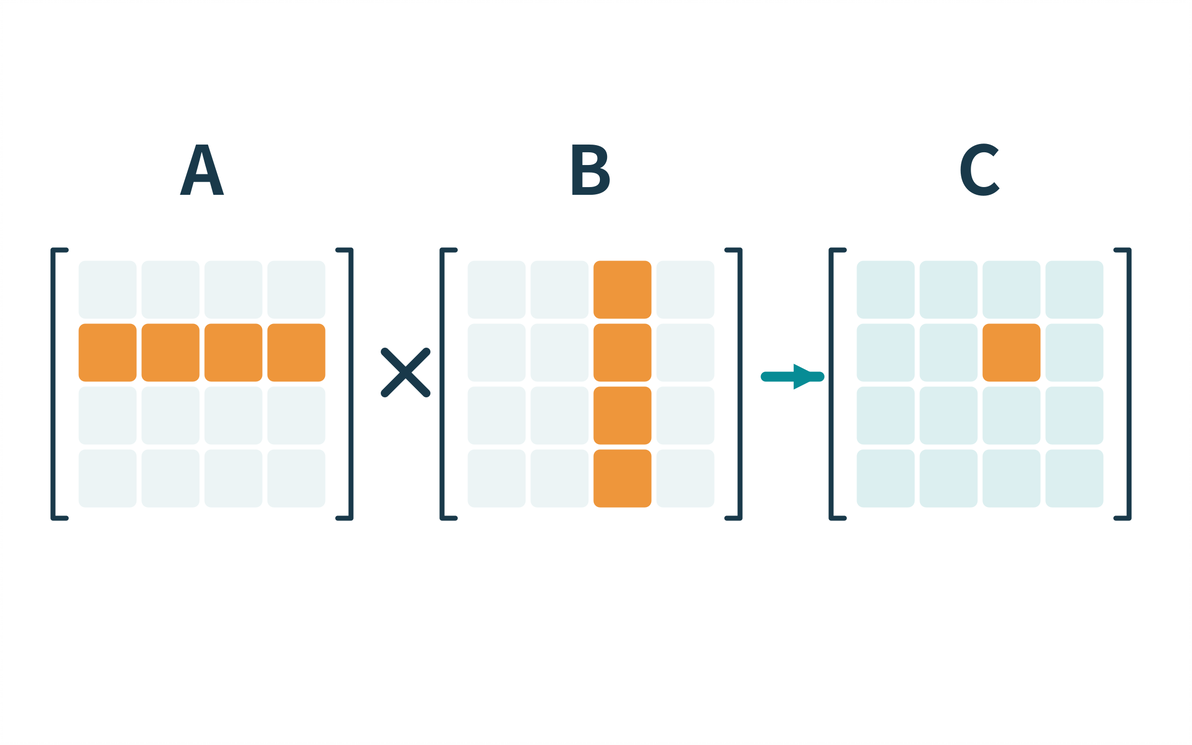
图 2 根据 NVIDIA 矩阵乘法指南简化。矩阵可以先看成数字表:结果中的一个格子,需要把一行与一列逐项相乘,再把结果加起来。Tensor Core 能高效处理这类重复工作,但数据精度、矩阵大小与数据供应仍会影响实际速度。[2][11]
例如,两个格子分别是 1、2,另一组是 3、4,就先算 1×3 和 2×4,再相加得到 11。大型矩阵把这类动作重复很多次,适合交给专门的计算单元。这里把问题缩小,是为了看懂乘加关系,真实硬件会同时处理更多数据。
二 有了工位 还要看允许多快地接活
图 3 流水线的调速设置
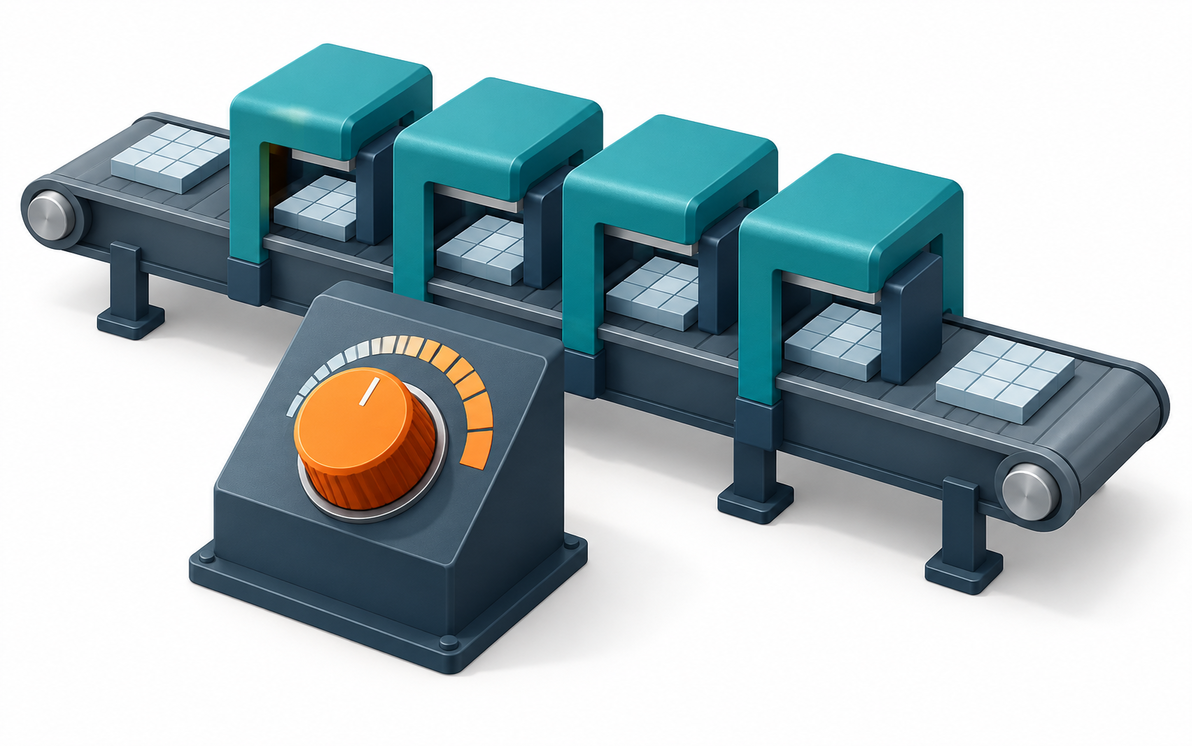
把一条计算路径想成流水线:工位和工人都在,但控制系统可能限制接收工作的节奏。调整这组设置,就有机会提高产出。仓库沿用的研究称它为“速度选择覆盖”,对应 GPU 中的一组运行时设置。[4][12]
图 3 是依据运行时速度覆盖机制制作的比喻插画。旋钮代表速率设置,不表示 GPU 内部真有这样的机械装置,也不能等同于简单超频。项目没有增加计算单元、扩大显存或修复物理熔丝。[4][6]
调速也会遇到新的瓶颈。工位更忙以后,材料运输、供电或散热可能跟不上,所以“解除一处限制”与“整条生产线提速多少”要分开检验。仓库的收益应在相同测试条件下比较;如果同时调整功耗或电压,就又加入了新的变量。[8]
三 驱动接管前是一段维修时间
图 4 驱动接管前的窗口
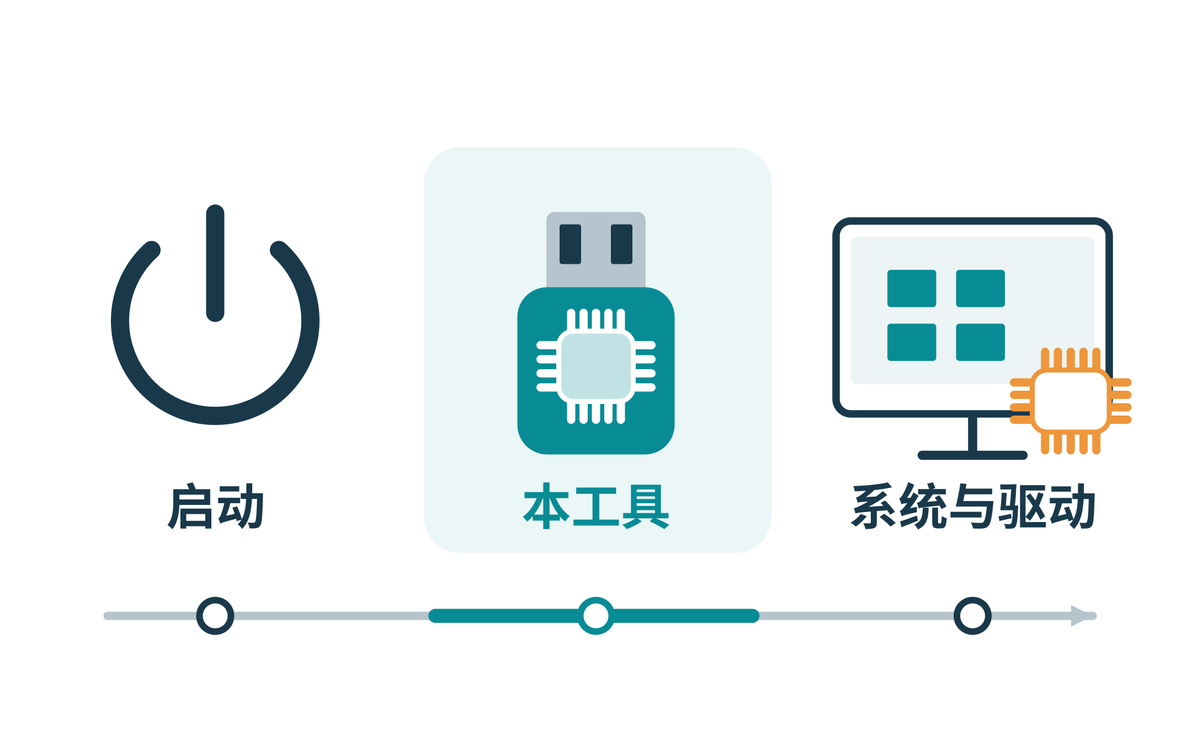
图 4 结合 UEFI 启动规范与仓库入口简化。电脑先运行开机固件,再进入操作系统。这个工具由 U 盘启动,在显卡驱动接管前处理设备,像工厂正式开工前的一段维修时间;完成后再继续启动 Windows。[3][4]
工具会暂时处理目标卡上的图形输出和驱动占用,取得独占操作的机会。因此有些机器会短暂黑屏。这个窗口提供了合适的时机,但屏幕变化本身并不是成功证明。[4]
图 5 进厂不等于能改控制柜
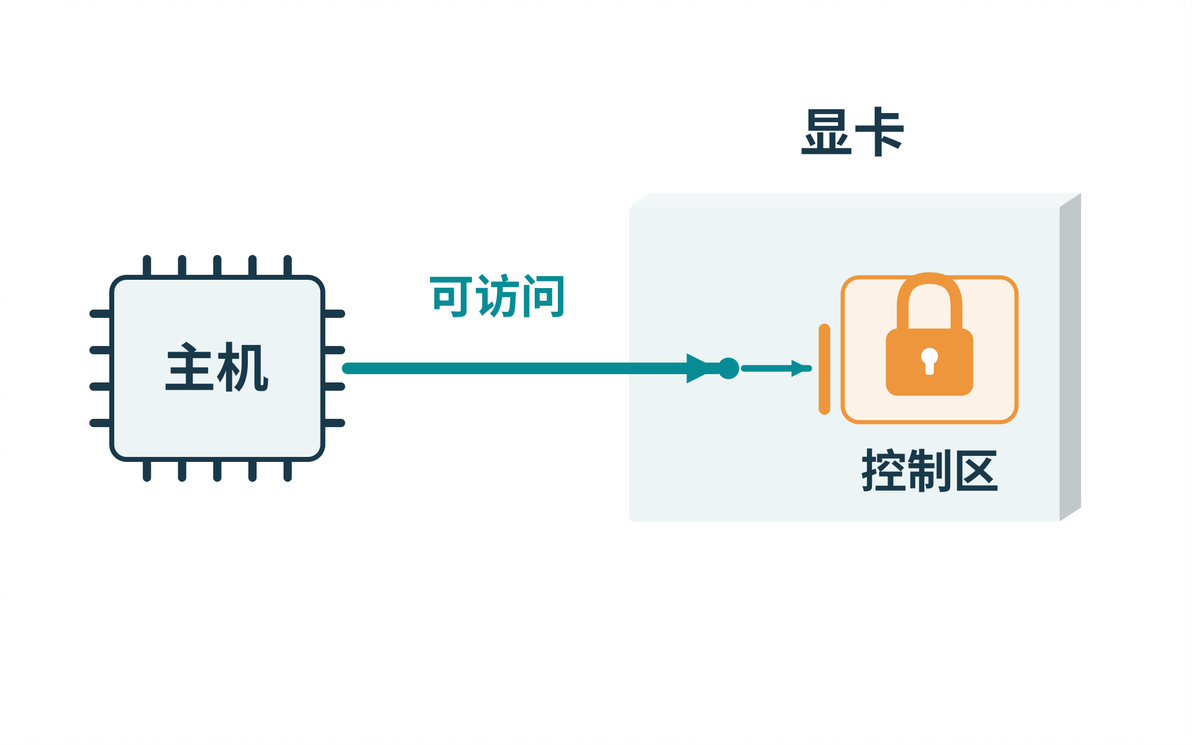
图 5 中,“进厂”对应电脑的主处理器 CPU 能访问显卡,“控制柜”对应 GPU 里受保护的设置。保存这些控制值的位置,叫作寄存器。GPU 会检查谁能修改它们;运行得早,并不会自动拿到每一把钥匙。[4][13]
权限检查保护的是硬件本身,电脑上的普通软件、操作系统驱动和 GPU 内部固件,并不天然拥有相同资格。这个项目要找到的,是一条本来能够执行高权限操作的固件路径;把程序提前运行,只是为这次操作安排场地。[4][13]
四 合法的维修员 也可能处理错工单
固件就是负责硬件启动与管理的程序。工具要先组织好 GPU 原有的固件启动流程,像准备维修场地、材料位置和交接单:真实对象包括安全固件、受保护显存区域,以及记录地址和大小的数据。前提不满足,后续固件可能拒绝继续。[4][8]
图 6 程序身份与外部输入是两个对象
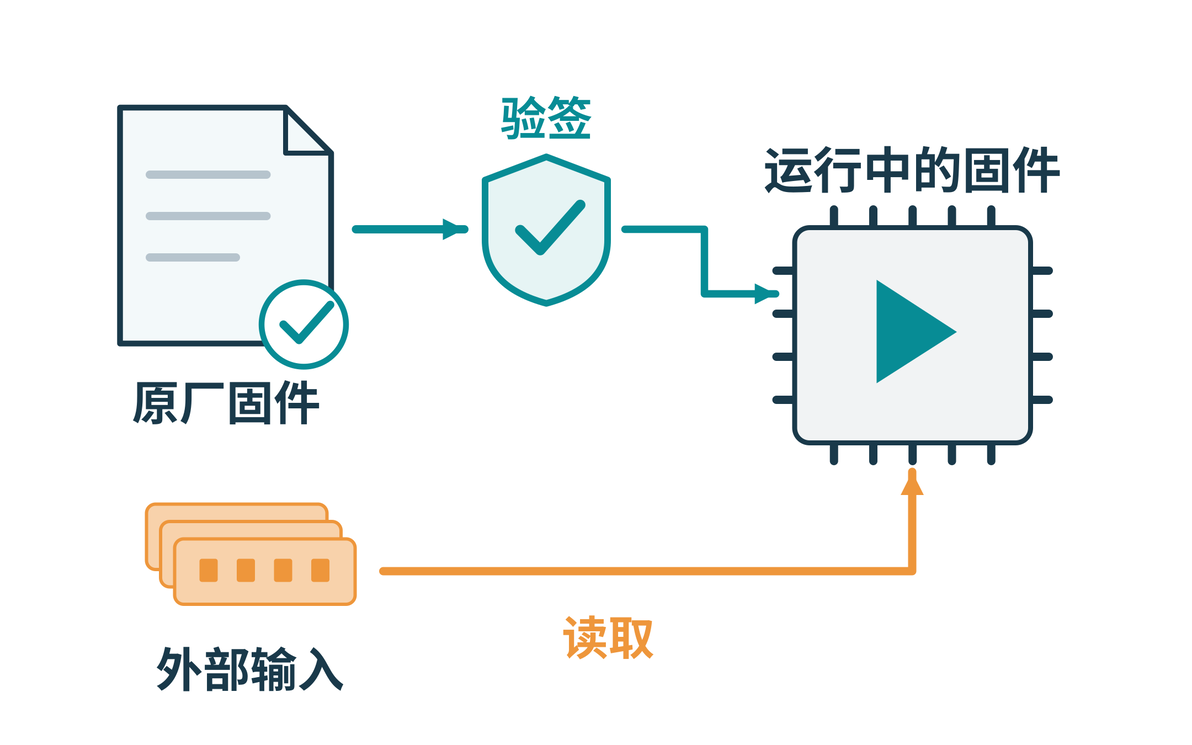
图 6 根据源码和 Ada 报告整理。Booter 可以类比为持有效工牌的维修员:GPU 先检查它的原厂签名,允许它运行。随后它还要读取另一份外部数据,像维修员接过工单。仓库保留程序自身的签名,改变的是后一份输入。[4][8]
工牌比喻的是程序来源与完整性,不保证每一步处理都正确。主板对启动程序的检查,与 GPU 对内部固件的检查,也属于不同层面的规则;放行前者并不会取消后者。
图 7 输入越界影响后续执行
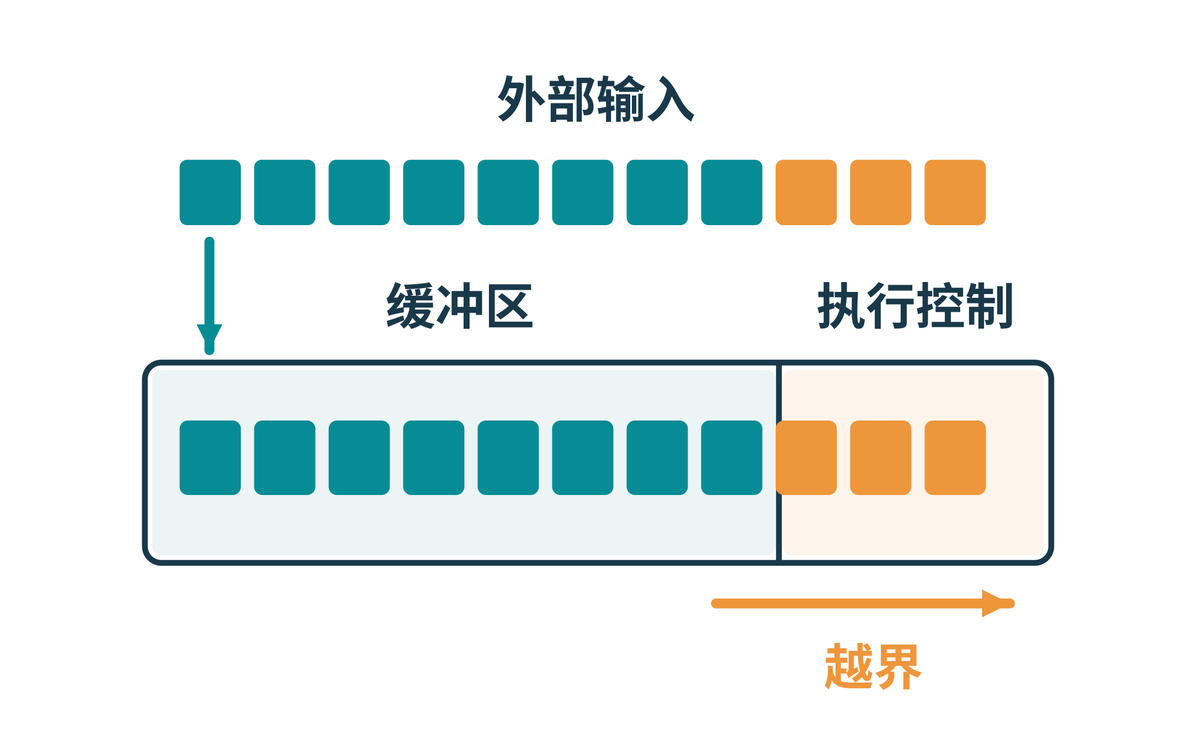
图 7 依据已公开的固件机制简化。Booter 处理输入时存在无界复制,像抄写工单时写出了规定栏位,连后面的执行安排也受影响。构造的输入可借用程序已有的操作片段,在固件权限下完成平时不允许的修改。[4][6]
程序接收数据时,会为它安排一块存放空间。安全的处理应该守住这个边界;越界写入则可能改变相邻内容,甚至影响程序接下来做什么。这个解释只涉及漏洞的基本因果,实际能否利用,还取决于特定固件的实现与启动条件。[4][8]
图中的格子表示内存边界,不是芯片布线。这里最关键的区别是:签名检查通过,能够证明程序身份受到认可,却不能证明它面对所有输入都具有内存安全性。
五 先开控制柜 再调整速度
图 8 门禁与调速旋钮
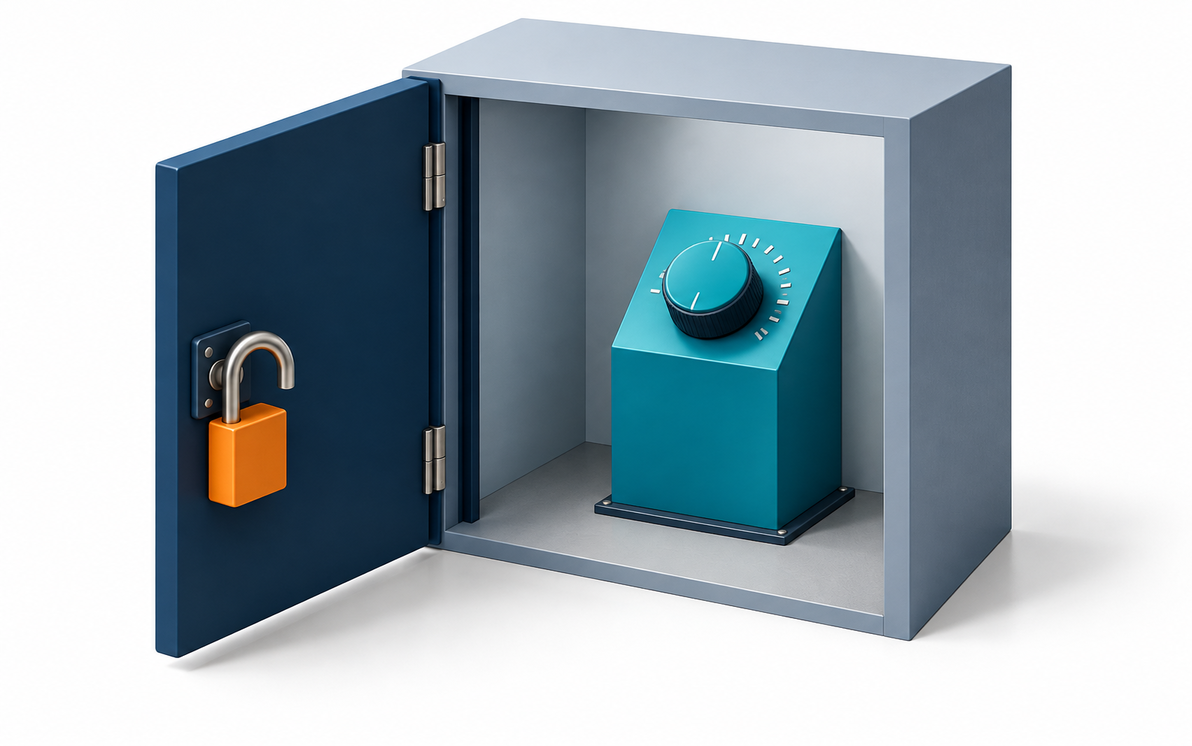
图 8 是工厂比喻,依据对应的源码步骤绘制。门禁对应寄存器访问权限,旋钮对应速度覆盖值。程序先借固件执行打开权限,再由主机写入目标设置。拿到了钥匙,不代表旋钮已经转到需要的位置。[4][5]
因此,两步都要验收。权限不开,写入可能被硬件忽略;权限打开但没有正确写值,速度设置也没有落实。真实程序还要把值读回来,确认硬件保存的状态,而非只相信“写入命令已经发出”。[5]
这也解释了为什么不能只把几项设置抄进普通软件:同样的写入动作,在门禁关闭时可能没有效果,在权限打开后才会落地。仓库的工作是把获得资格、写入目标、确认保存连起来,缺少前面的条件,后面的动作未必成立。[4][5]
六 维修通道与交接同样决定成败
图 9 两个方向的访问通道
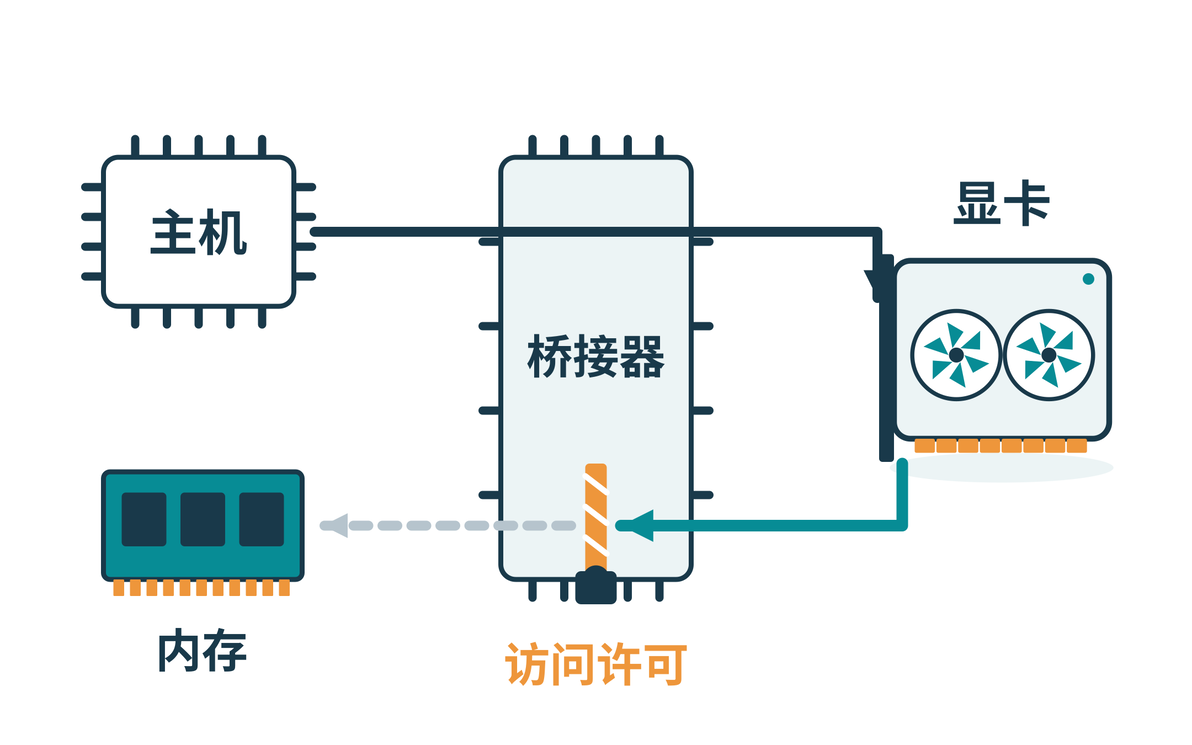
图 9 根据仓库的 PCI 桥排障报告简化。CPU 给显卡下指令,和显卡去内存取材料,是两个方向。4060 Ti 的案例中,前一条路畅通,后一条路却被上游桥挡住;修好桥上的总线主控开关 BME,固件才读到正确材料。[7][9]
道路比喻对应实际的访问权限。它也说明这个仓库为何不只是复用漏洞:搬到更早的启动环境后,还要解决固件装载方式、内存可达性和设备状态等条件。CPU 能访问 GPU,只验证了其中一部分。[8][9]
图 10 三层验收
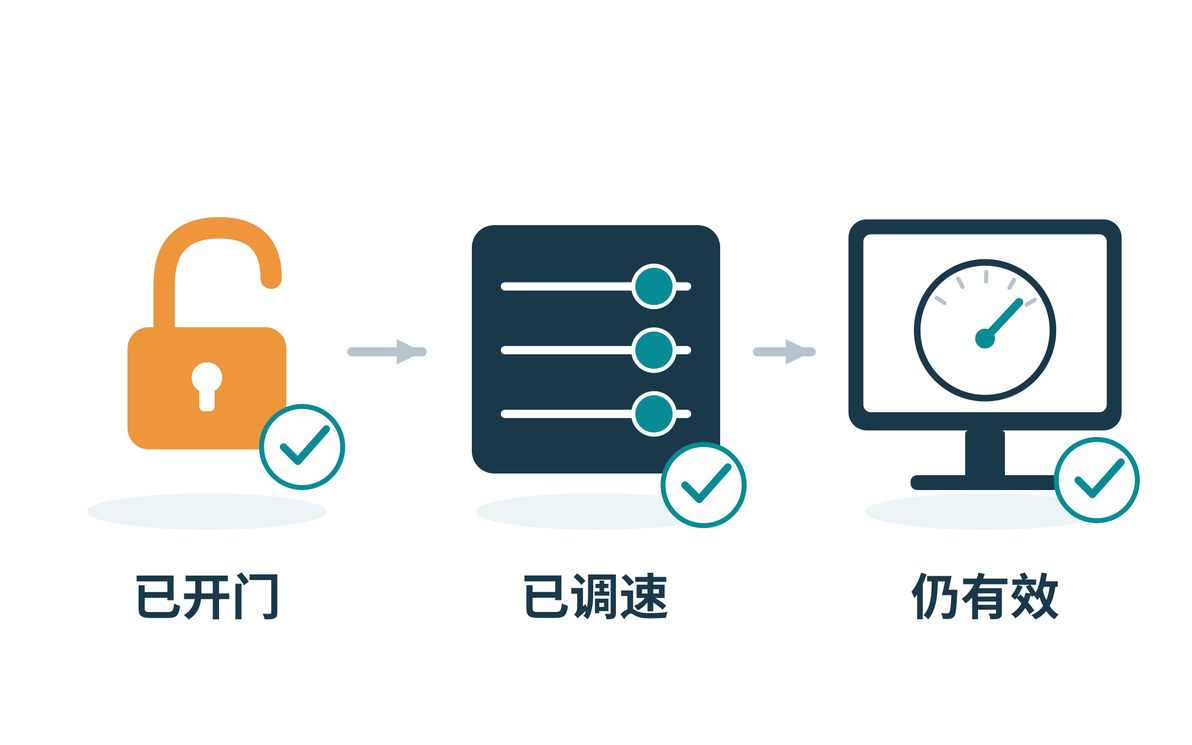
图 10 把验收分成三步:先确认门禁已经打开,再查看旋钮实际位置,最后开工试产。真实程序分别检查固件执行与访问权限、速度值读回,以及系统内的正确性和性能。某一步日志成功,只回答那一步的问题。[4][5]
读回可以理解成拍下控制柜当时的状态。照片准确,也不能保证后面的设备复位或驱动初始化不会再改它。因此要在交接后再检查,并让程序实际运算:既看有没有变快,也看算出的结果是否正确。[4][5]
图 11 三代显卡的不同交接
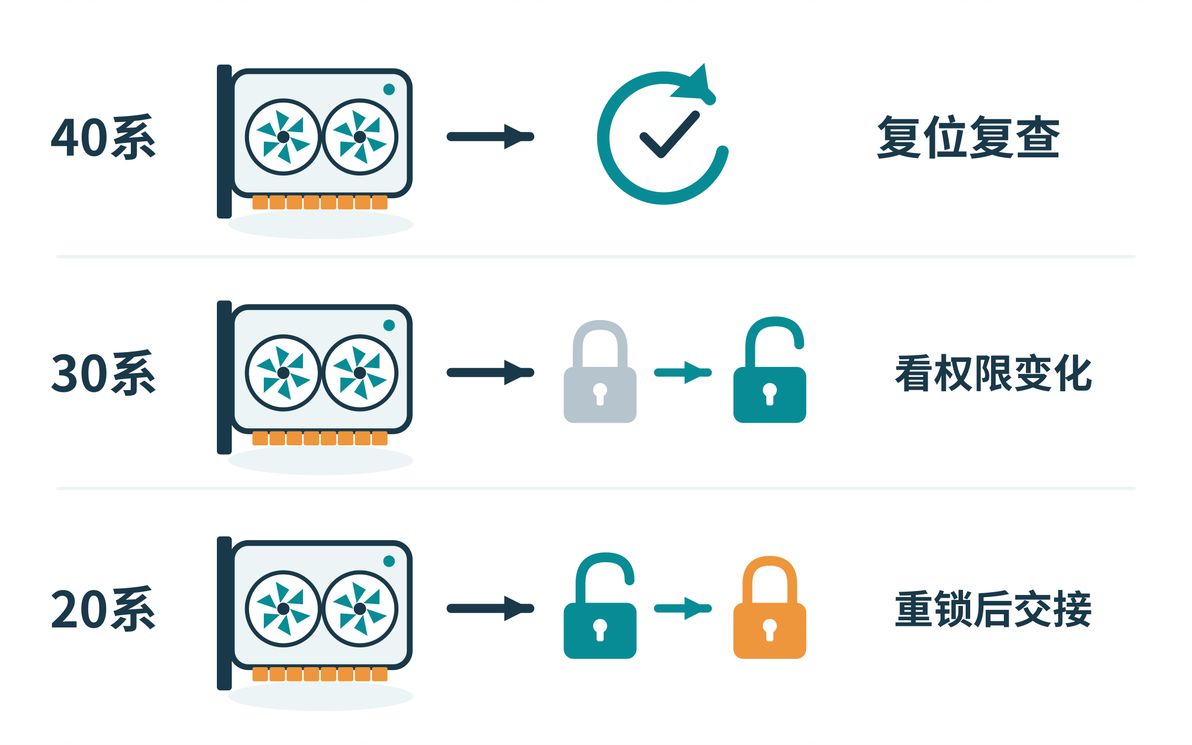
图 11 依据三代代码路径简化。40 系的 Ada 会做一次局部复位后复查;30 系的 Ampere 使用自己的执行判据,再完成复位交接;20 系的 Turing 则写好设置后重新锁门,跳过该复位,并需要适用的固件管理模式。[1][4][5]
这里的“锁门”只收回修改权限,柜内设置仍可保留。局部复位也有特定作用范围,不能当作整张卡断电。不同代际的保留条件不同,照抄另一代的清理步骤,反而可能让设置失效。
同样,支持列表里能识别某张卡,也不等于已经验证了它的全部效果。识别型号、完成固件事务、顺利进入系统、让特定任务提速,是逐层增加的证据。查看报告时,最好看清它实际完成了哪几层。[1]
图 12 易失的班次设置
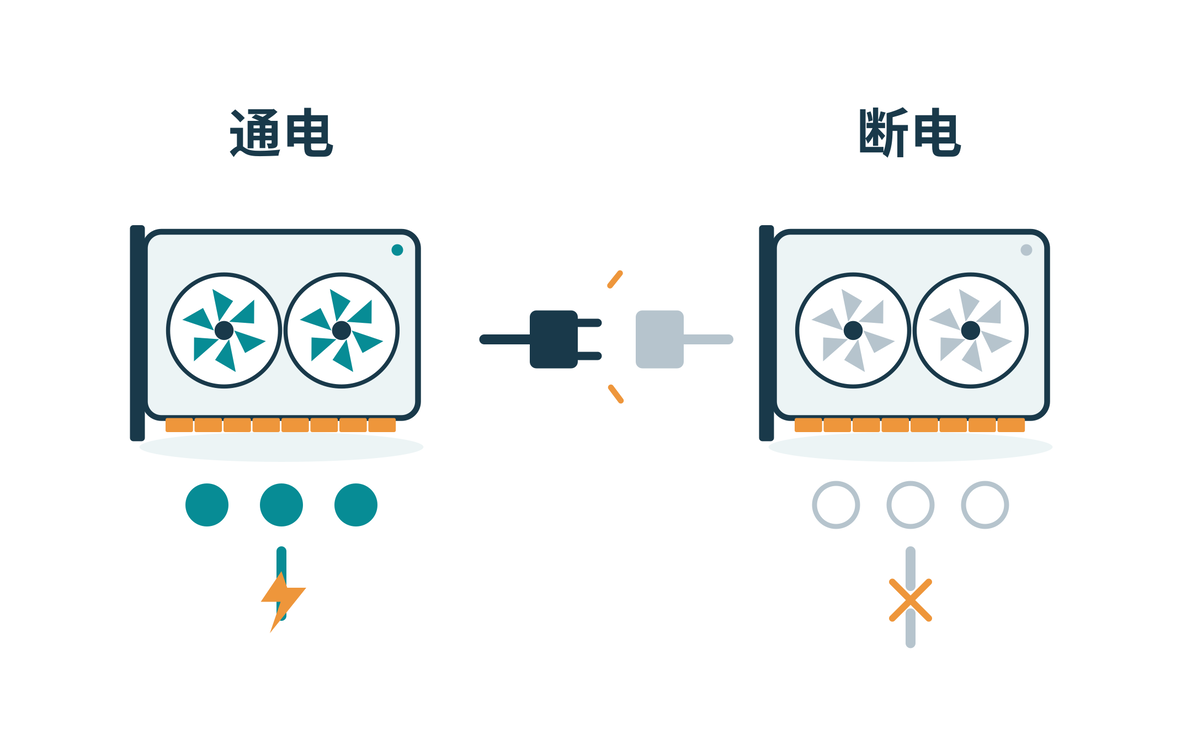
把运行时设置想成白板上的班次安排,就容易理解图 12。这些覆盖没有刻进芯片或烧进显卡 BIOS;相关供电消失后会丢失,某些休眠、恢复或复位路径也可能使其失效。具体要看哪部分状态被清除,不能把所有重启都当成同一种情况。[1][10]
七 试产变快多少 要看真正的任务
图 13 4060 Ti 的公开对照
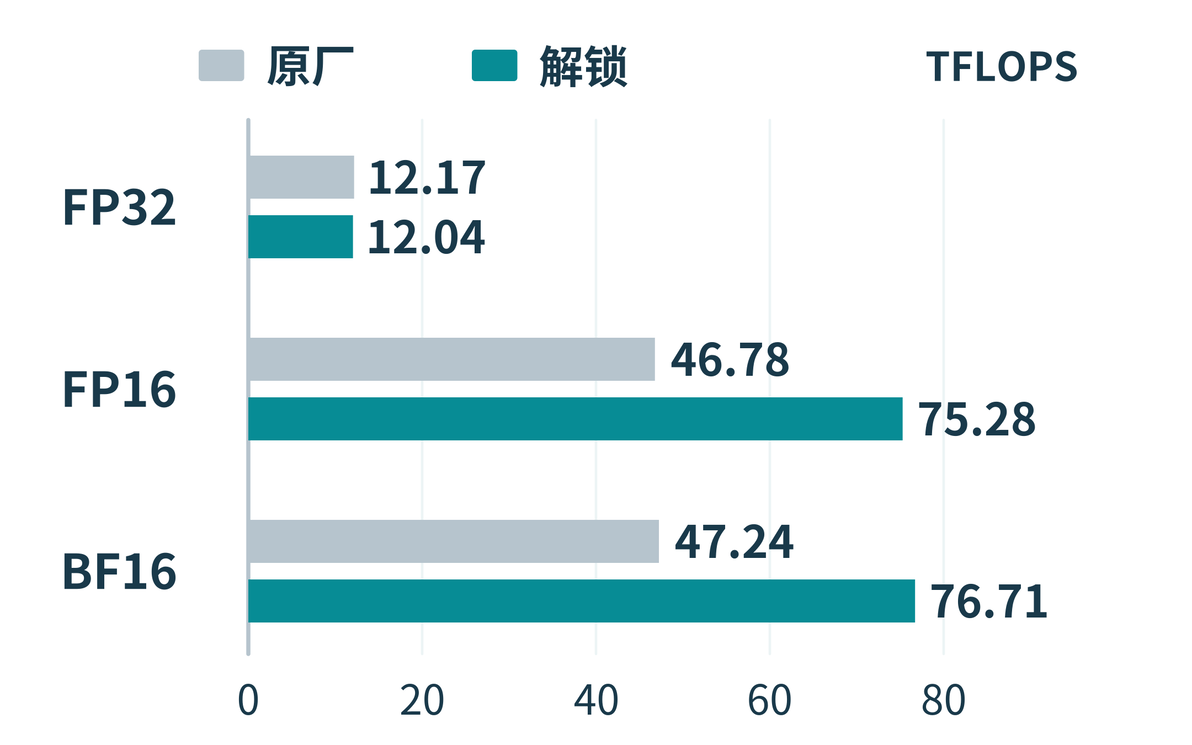
图 13 据仓库原始报告重绘:同卡、同机、165 W 设置,8192 阶矩阵测试中,FP16 为 46.78→75.28,BF16 为 47.24→76.71,FP32 对照为 12.17→12.04,单位均为 TFLOPS。两条矩阵路径约提高到原来的 1.6 倍。[7]
TFLOPS 表示每秒万亿次浮点运算。这里用它比较同类测试前后的吞吐;不同精度、不同任务的数字,不能直接当作同一种生产能力。[7][11]
报告称正确性检查通过,也明确尚未完成长期负载、温度与功耗测量。这里保留它的精度标签,不把矩阵结果扩展成所有任务的保证;图表描述的是这次公开对照。
图 14 部分翻倍后的整体速度
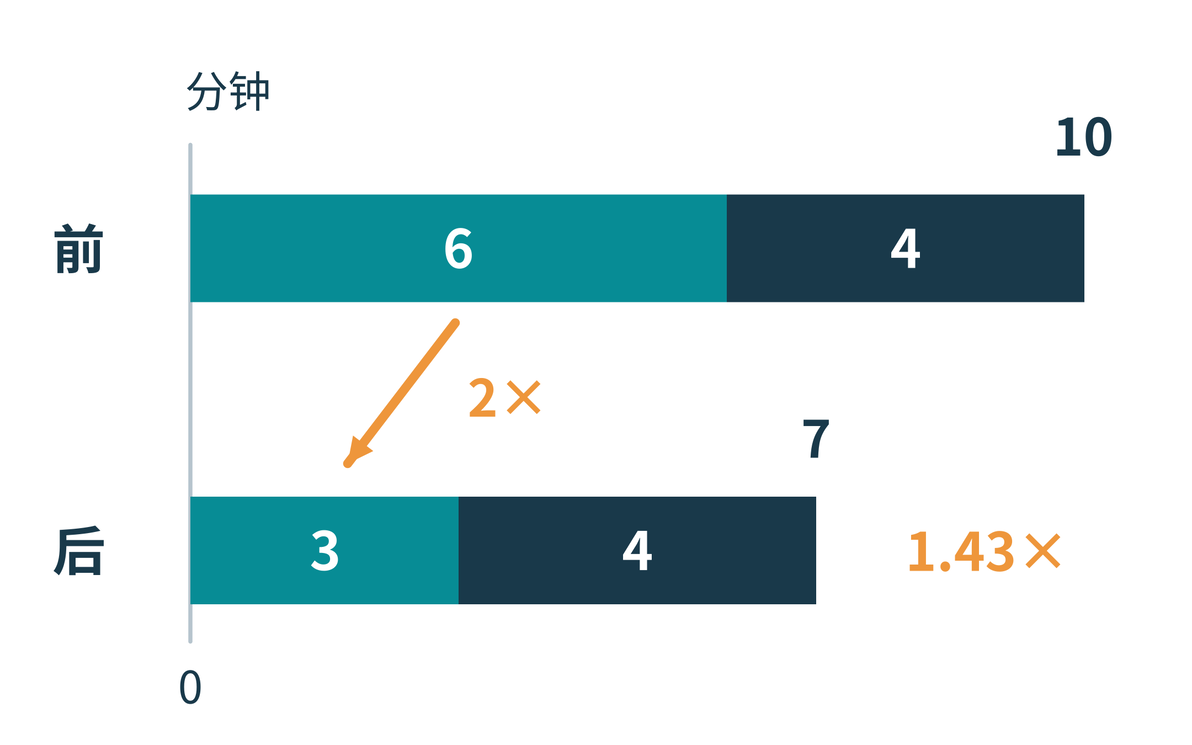
图 14 是假设计算,不是仓库实测:一个任务原来需 10 分钟,其中能加速的 6 分钟减半成 3 分钟,其余 4 分钟不变,总计仍要 7 分钟。整体加速为 10÷7,约 1.43 倍。工厂的一道工序翻倍,全部订单也未必两倍快。
实际应用还有搬运、缓存和其他计算。NVIDIA 的矩阵指南强调了这些条件;上游也报告过指令吞吐接近翻倍、实际矩阵计算却只提高一部分的情况。因此,最终应测试自己真正使用的软件与任务。[11][12]
开始使用前留下可对照的证据
先核对具体显卡与平台是否已有支持记录,再按对应版本说明制作启动材料。运行前保存原厂性能;完成后保留日志,进入系统做同条件的性能与正确性测试。无解锁载荷的回放仍会操作固件和设备状态,不能当作纯只读检查。[1][4]
这项工作的完整价值,在于把一次权限突破接成可检查的过程:准备环境、打开权限、写好设置、正确交接,最后由真实任务证明收益。读懂这条过程,比记住某个跑分倍率更有用。
