
先说明白,这是一篇严肃的安全研究论文解读,不是灰产操作指南
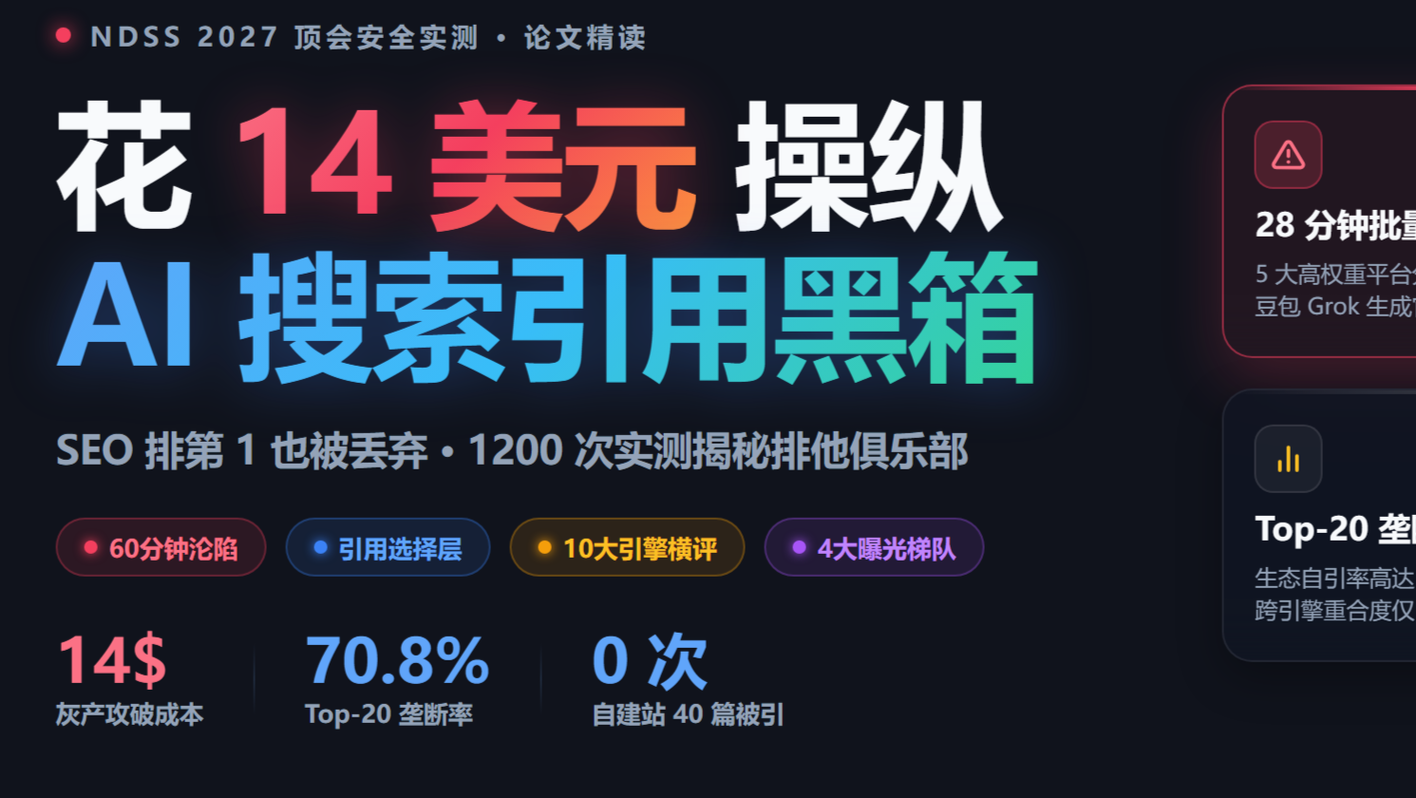
2026 年,复旦大学和前沿信息安全实验室有一篇论文被国际安全顶会 NDSS 录用。研究人员做了一个挺有意思的实验,他们从公开商业渠道花了 14 美元,采购了一次灰产代发服务。结果仅仅过了 28 分钟,服务商的脚本就利用一批陈年高权重账号,在 5 个平台批量分发了 13 篇夹带虚构概念的软文。
发完之后不到 60 分钟,生产环境里的主流大模型搜索就直接抓取了这些内容。豆包、Grok 在回答真实用户提问时顺畅引述了这批伪造软文,甚至在答案末尾打上了可点击的权威角标。在随后的几天监控里,豆包对这批虚假标记物的引用率高达 65.7%,Grok 也达到 53.3%。
14 美元,一个多小时,主流大模型搜索的引用防线就被轻易穿透了。
40篇原创文章与零次引用
真正让很多网站管理者和独立开发者意外的,是团队同步做的另一组对照测试。
研究人员自建了一个 WordPress 独立站,按照传统SEO技术标准规规矩矩发布了 40 篇原创技术长文,排版、语义标签和结构化数据做得很完整。结果在长达 7 天的观测期里,这 40 篇高质量文章被各大 AI 搜索引用的次数是 0。
团队把完全相同的内容同步发到知乎或者今日头条这类受信任的平台,首轮测试就全被大模型抓取引用。在低权重平台上发 20 篇同类内容,也抵不上在受信任平台发 1 篇的被引几率。
过去大家做传统 SEO 拼关键词排位,现在所有人都在讨论面向大模型的 GEO(生成式引擎优化)。很多人天天研究词频与外链,自建站哪怕在传统搜索里排在第一名,大模型根本不看。反倒是 14 美元批量生成的垃圾信息,不到一个小时就顺利进入了答案摘要。
为什么排第一名也会被直接丢弃
出现这种情况,主要是传统 SEO 和当前大模型的检索链路完全不同。
传统搜索引擎靠的是倒排索引和 PageRank 外链评分,网页排位直接受内容质量和关键词相关度影响。
AI 搜索采用的是 RAG 检索增强生成管线。大模型在给出答案前要先调用外部网页,中间多了一道关键环节,叫做引用选择层。
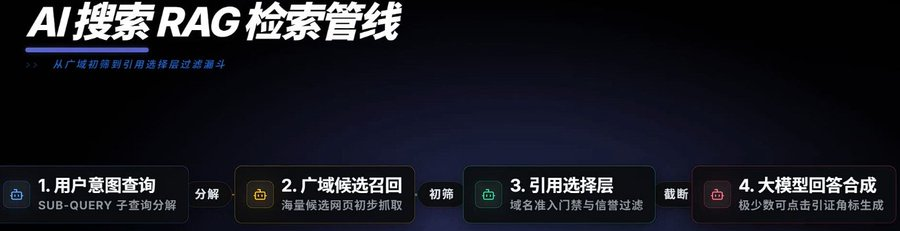
完整流程分为四步。第一步把用户问题拆解成几个搜索子查询,第二步是大范围初筛候选网页,第三步是引用选择层进行白名单过滤,第四步才轮到大模型提炼内容生成答案。
问题主要卡在第三步。大模型可用的上下文窗口很有限,AI 搜索系统不可能把搜出来的几十个候选网页全部喂给模型。这就是很多团队做 GEO(生成式引擎优化)总是摸不着门道的原因。系统在这一步设置了极度严苛的域名信任门禁。
只要你的自建站域名不在系统认可的白名单里,就算传统排名排在最前头,页面标签优化得再细致,系统在第三步也会把这个网页直接丢弃。反过来,只要文章发在系统信任的高权重平台上,哪怕内容是胡编乱造的,系统也会顺理成章地抓进去供大模型引用。脱离了这道域名信任门禁,很多停留在页面层面的所谓 GEO 优化从一开始就使错了力气。
寡头垄断与割裂的信任池
研究团队针对全球 10 款主流 AI 搜索引擎做了 1200 次标准化实测,提取了 17211 条引用链接,整理出了详细的数据。
第一是各家引擎的引用习惯差距很大。Grok 表现最激进,平均单次查询引用 52.2 个外部链接。通义千问最克制,平均只有 6.5 个。ChatGPT、豆包和文心一言多数稳定在 10 到 12 个之间。
第二是头部集中度很高。文心一言里前 20 个域名拿走了 70.8% 的引用机会,光百家号一个域名就占了两成。相比之下,DeepSeek 的分布相对分散一些,前 20 个域名占 20.5%。
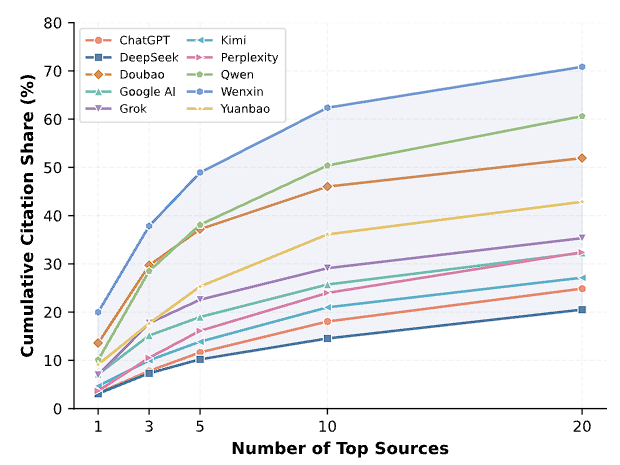
第三是各家搜索引擎的信任池几乎互不相通。跨平台的引用重叠度只有 0.201。除了 GitHub 和 arXiv 这些全球公认的技术站点,大部分国内引擎各自圈了一批偏好的内容源。
第四是自引现象很普遍。文心一言引用百度系域名的比例达到 24.4%,比该域名在其他引擎的基准引用率高出 13 倍多。豆包引用字节系今日头条等内容达到 25.9%,腾讯元宝引用腾讯系内容达到 14.2%。
门禁缺失与半个月的僵尸引用
既然大模型这么依赖这些高权重平台,那这些平台的审核到底严不严?
研究团队顺手审计了被大模型引用最多的 22 个主流平台,发现平台准入存在很大的治理漏洞。
22 个平台里有 15 个几乎零门槛,新注册账号就能发文章,占比超过 68%。还有 18 个平台完全是纯机器秒级审核,或者几分钟内就自动放行,占比超过 81%。大模型把信任交给了这些平台,而这些平台的前台发文通道却几乎不设防。
更麻烦的是,大模型的向量索引和缓存存在明显的滞后。研究团队在实验第 11 天把 27 篇伪造文章全部手动删掉,访问链接直接报 404。然而在随后的第 12 到第 15 天里,好几家 AI 搜索引擎依然在稳定地输出指向 404 页面的僵尸引用。发上去只要半小时,删掉之后大模型却要半个月才能反应过来。
正规从业者的 GEO 应对办法
看清大模型系统的运作规则之后,正规从业者用不着焦虑,掌握这套逻辑就能理出清晰的 GEO 动作。
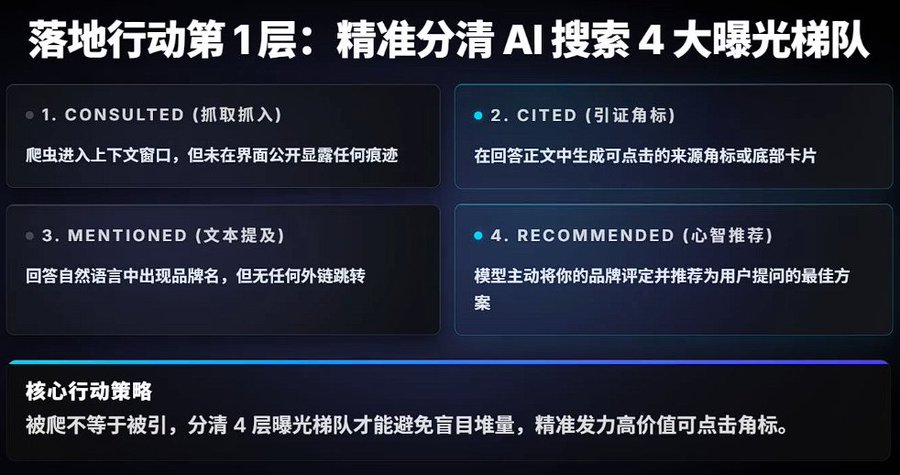
第一,分清 AI 搜索里的四个曝光层级。
最底层是抓取,爬虫把网页塞进了上下文,但不在前端显示。 第二层是引用,也就是大家常见的角标或者卡片链接。 第三层是提及,大模型在正文里说到了你的名字,但没有附带链接。 第四层是推荐,大模型主动把你的产品判定为最优解。
很多团队一做 GEO 就把被引用当成唯一指标。如果你发现自己的网页已经被抓取了但没被引用,说明不是爬虫进不来,通常是网页的内容提炼率或者结构化格式不够清晰。
第二,别再死盯着旧式关键词排位,去审计自己行业的真实引用池。
实战中更管用的 GEO 策略,是找几个你们行业的核心问题,在大模型里跑几遍,看系统最后到底给了哪几家网站可点击角标。你会发现八成以上的引用都来自第三方横评网、综合榜单或者垂直社区讨论帖。既然自建站很难直接挤进白名单,那就借道这批已经被大模型信任的集合页,在这些高权重页面里把自己的产品信息埋进去。
第三,花十分钟检查服务器的 robots.txt 文件。
论文在调研时查了 56 家企业,有将近七成的网站爬虫规则写得一团乱麻。很多人一听到 AI 爬虫就全部封死,结果把大模型的实时搜索爬虫也拦在门外。要把模型训练爬虫和实时搜索爬虫分开对待。像 GPTBot 或者 Google-Extended 属于训练爬虫,而像 OAI-SearchBot 或者 PerplexityBot 属于实时搜索爬虫。给实时搜索爬虫单独放行,确保候选抓取阶段能进得去。
规则变了,但长远看还是好事
2012 年 Google 推出企鹅算法清理群发外链,传统搜索经历过一次大清洗。现在各大 AI 搜索也已经在跟进溯源重排和时间窗口过滤,依靠低质群发钻空子的做法很快就会被算法封堵。
把内容做扎实,借道受信任的集合页,把爬虫规则理清楚。从传统 SEO 转向现代 GEO,规则确实变了,但这套逻辑摸顺之后,事情其实比想象中清晰得多。
