
2026 年 9 月中旬,小米在大模型开源社区做了一件少见的事。
团队把万亿参数全模态模型 MiMo-V2.6 的工业级强化学习训练后台直接开了直播。他们没有发通稿造势,只是把RL训练实时监控看板挂在公网,整个 AI 圈目瞪口呆,还能这样玩儿啊?
小米全模态MiMo V2.6登顶开源第一:强化学习的暴力美学深度拆解
账单记录得很详细。万亿级 Pro 版耗资 262 万美元,轻量 Flash 版耗资 85.4 万美元。整个团队连续训练了 6 天,完成 30 步迭代,记录了 75 万条完整交互轨迹,累计消耗 750 亿 Tokens。
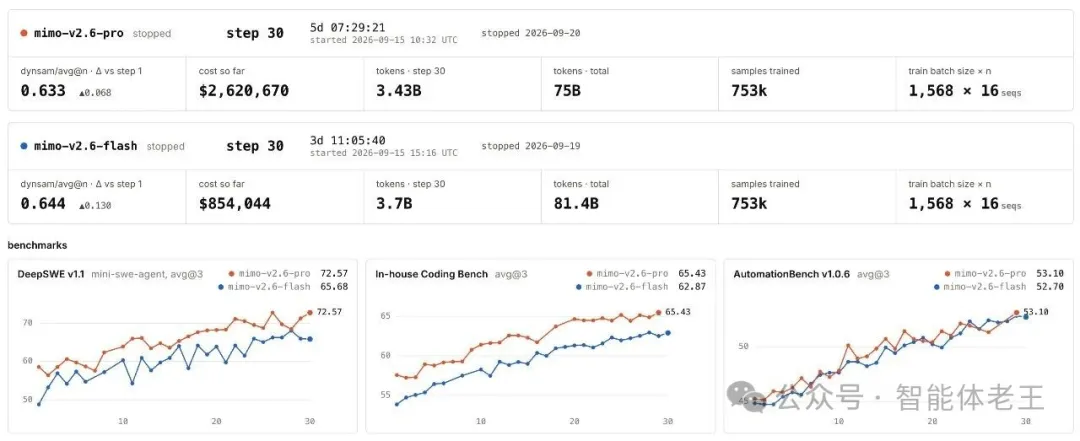
在大模型研发里,各家通常把数据集配比、微调损失曲线和算力成本当成核心机密死死捂住。外界只能看到厂商发布的官方博客,里面往往只有几张挑好的跑分柱状图。小米这次把训练失败的痕迹、显存崩溃的调试记录和花销账本一起公开,直接把行业里心照不宣的做法打破了。
大家关心的核心问题很简单,这笔巨款到底换来了什么样的技术产出,MiMo-V2.6 的实际能力究竟怎么样。
软件工程跑分直逼闭源旗舰
衡量模型表现,得看第三方基准测试给出的硬指标。
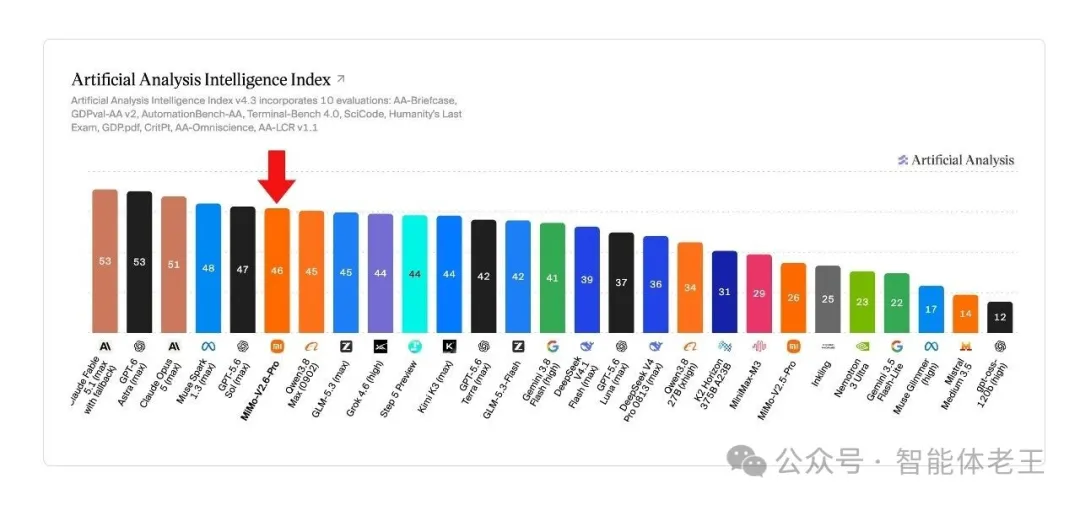
在 Artificial Analysis 发布的综合智能指数里,MiMo-V2.6-Pro 拿到了 46.32 分。同榜单中,Kimi K3 得分是 44.5,Qwen3.8 Max 得分是 43.8,距离闭源标杆 Claude Fable 5.1 的 48.0 分只差不到两分。这个成绩让它暂时排到了全球开源权重的首位。
对于做硬件起家的小米,通用榜单的高分往往容易引起外界质疑。更值得关注的是解决真实代码缺陷的工程测试。
在软件工程权威评测 DeepSWE 里面,前代 MiMo-V2.5 仅拿到 19.0 分,面对复杂的跨文件函数调用常常理不清上下文。这次 V2.6 的成绩达到了 71.9 分。这个分数直接贴住了闭源第一梯队,当时 Claude Opus 5 测出 74.0 分,GPT-5.6 测出 73.0 分。
在实际代码环境里,模型面对的是 GitHub 上的真实 Issue,需要自己去拉取代码、重现报错、修改代码并跑通单元测试。能拿到 70 分以上,说明它具备了处理真实项目工程 Bug 的长程推理韧性。
系统交互维度的表现也比较平均。终端控制基准 Terminal Bench 拿到 89.9 分,桌面智能体环境 OSWorld 拿到 82.0 分,模拟渗透攻防的 CyberGym 拿到 95.1 分。轻量版的 Flash 与万亿 Pro 版在日常任务中的差距不大,给端侧部署留下了可用空间。
MoE 1.02T 稀疏激活与长上下文实现
万亿规模的模型能够实际跑起来,核心在于底层的混合专家架构。
MiMo-V2.6 的总参数量达到 1.02 万亿,但在每次前向推理计算时,系统仅仅激活其中的 42B 参数。这个机制好比一个庞大的工程智囊团拥有一千名专家,处理一个前端样式问题时,只有负责 CSS 和布局渲染的几十位专家出面解题,其余人员继续待命。
决定任务交给谁的关键是稀疏门控路由。网络根据输入文本和模态特征,在毫秒级内完成动态专家分派。这种稀疏激活的方式,既保留了海量参数储备知识的容量,又把单次计算开销压制在了中等尺寸模型的区间,让万亿推理在算力消耗上变得可控。
长文本处理能力做到了 1M 上下文。超长序列通常会带来二次方级的显存膨胀,小米采用了混合滑动窗口与全局注意力结合的方案。滑动窗口专注捕捉临近词句的微观逻辑,全局注意力负责跨段落的核心锚点追踪。两者配合后大幅降低了显存驻留量,几十万字的代码库检索没有出现上下文丢失。
原生多模态统一网络架构
多模态能力的处理方式展现了这套模型的底层技术取向。
业界构建多模态时,常见的捷径是在成熟的纯文本语言模型外面,加挂一个开源视觉编码器,中间用几层线性映射层强行连接。这种外挂拼接方案能快速上线,缺陷在于视觉特征在进入文本深层网络时容易失真,无法胜任高精度的图文视听跨模态深度推理。
MiMo-V2.6 在初始预训练阶段就把文本、图像、视频和音频数据混在一起送入网络,让不同模态在深层特征空间内同步原生对齐。
网络前端搭载了一个 6.81 亿参数的 28 层 ViT 视觉主干网络,横向耦合了 3.08 亿参数的音频感知模块与 1.27 亿参数的处理单元。解码输出端配置了 5 层推测解码器,既能解析高分辨率图表和密集代码截图,又支撑了低延迟的连续生成。
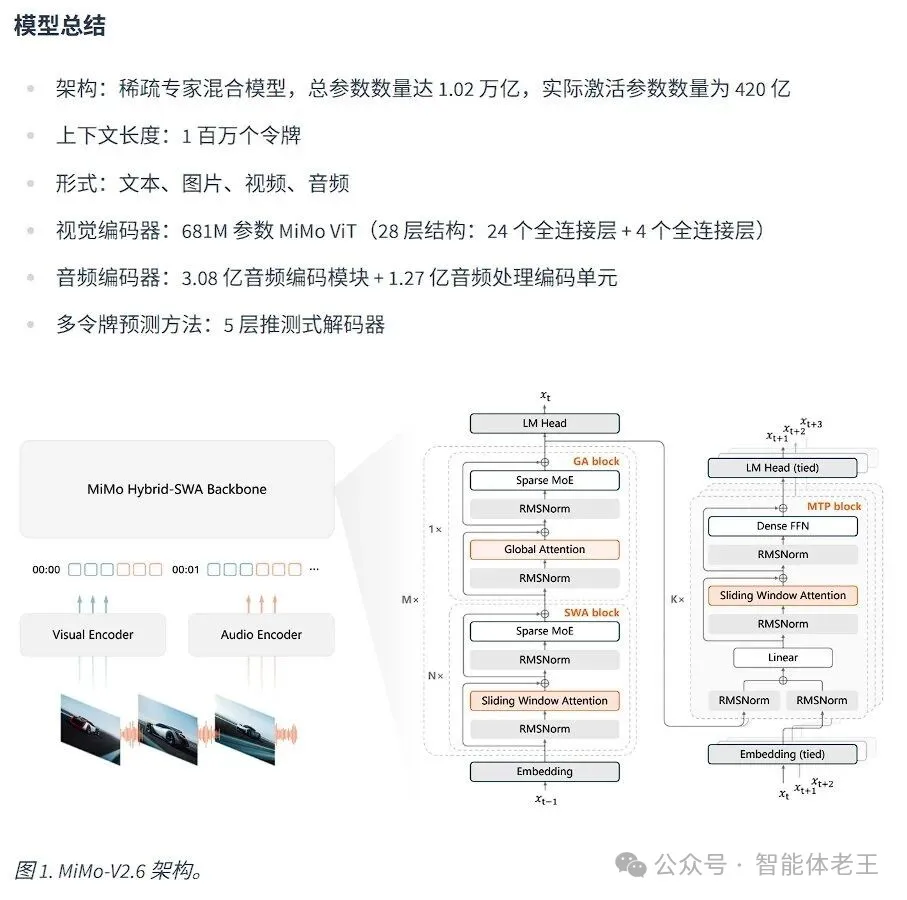
处理一段包含桌面操作录屏和语音解说的视频时,模型可以直接把画面的鼠标移动轨迹与说话人的指令意图绑在一起理解,免去了多个外部小模型反复转译的误差累积。
强化学习后训练的四项具体设计
让模型能力实现大幅跨越的关键,是团队在后训练阶段应用的四项具体工程改进。
第一项是 YORO 单阶段联合强化学习,英文全称 You Only RL Once。过去的通行做法是将代码逻辑、图像理解和安全性对齐分成不同批次按顺序训练。后一个阶段的参数微调容易把前一个阶段掌握的专业技能冲淡。小米把软件工程、操作系统界面点击、视觉图表分析和攻防数据混合放在同一个 Batch 里,多域数据同时反向传播。不同领域的解题策略相互连通,遇到从未见过的软件故障时展现出了较强的零样本求解能力。
第二项是 全异步 GRPO 策略优化。为了给大规模强化学习提供充足的采样广度,单步训练批次设定为 1568 个 Prompt,每个 Prompt 在 GPU 集群中并行生成 16 条探索路径。整个集群在单一步骤内并发前向 25088 条探索轨迹,单步更新吞吐量达到了 37 亿 Tokens。异步流水线将生成采样与梯度更新彻底解耦,集群各节点不再需要等待单条慢任务返回,显卡计算单元维持在较高利用率。
第三项是 群组评分 GAR 机制。传统强化学习评估代码往往采取非对即错的二元打分。两条都能通过测试集的代码,在工程质量上可能差距悬殊,一条只有十几行干净利落,另一条写了几百行臃肿废话。小米通过群组规则建立代码质量梯次,在解法全部正确的前提下,系统在线给予执行步数少、资源占用低的解法更高的奖励分,抑制了冗余垃圾代码的滋生。
第四项是 多前缀蒸馏算法 MOPD2。强化学习冷启动阶段容易产生策略漂移,算法通过反思机制实时修剪偏差节点,同时把教师模型探索出的高价值推理前缀直接转移给轻量级模型。这样大幅减少了低效摸索的样本浪费,让模型能用更少的数据迅速掌握解题思路。
训练日志里的事故与硬件落地门槛
客观审视一个开源项目,不能只看宣传手册上的理想数字,更要看真实的运行边界与工程妥协。
公开的训练看板记录了真实发生过的故障。在训练进行到第 17 步时,因为专家路由分派出现严重倾斜,几个热点专家节点瞬间被巨量计算压垮,显存直接见底报错中断。工程师团队紧急停机介入,临时从训练集里剥离出了引发路由极化的 Cyber 数据,重新平衡了专家权重分配才把训练挽救回来。万亿参数集群的调度难度,远比跑几个小模型复杂得多。
硬件部署门槛也是开发者必须面对的现实。虽然单次前向只激活 42B,但要将 1.02 万亿权重完整装进显存,本地私有化部署仍然需要 4 到 8 张 80GB 专业计算卡。普通个人开发者和初创团队在单张消费级显卡上根本无法全量跑起来。
为此开源包里同时释出了全精度 Flash 版与 9B 端侧蒸馏版,官方同步提供了打包好的桌面客户端。单卡用户可以通过量化或者跑蒸馏版本来完成日常代码辅助任务,不用承担沉重的算力负担。
极低定价背后的商业考量
在模型发布的同一时间,小米给出的 API 调用价格引发了行业讨论。
输入缓存命中价格被压到了 0.02 元每百万 Token。对比海外主流大厂的同级服务,实际使用成本几乎降到了几十分之一。
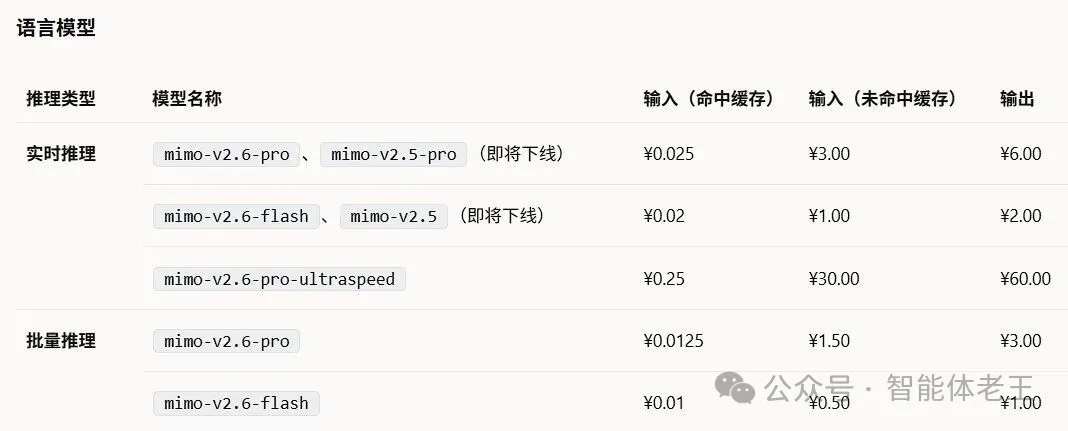
具体的收费阶梯中,Flash 版本输入端标价 1 元每百万 Token,输出端 2 元。万亿级 Pro 版本输入端 3 元每百万 Token,输出端 6 元。所有公开模型全部遵循 MIT协议,不仅权重全开源,包括 verl 强化学习框架和 7000 多个交互测试环境也一并完整交付。
在云端提供大模型 API 本身并不是暴利生意,极低的资费策略有着清晰的商业脉络支撑。小米的主营盘子在手机、平板、智能穿戴和电动汽车等庞大的硬件终端网络。通过免费开源与地板价 API 降低开发者门槛,吸引更多工程师基于这套模型开发应用,最终让这些原生智能体验跑在小米的各个设备终端上,拉动硬件生态的活跃度。生意的重心放在了实体设备销售与互联网服务上,模型本身就可以当作开拓生态的先锋。
总结
MiMo-V2.6 最实在的价值,在于用真金白银的 347 万美元账单和一套完整的代码与日志,证明了万亿规模全模态强化学习能够在开源社区里被真正复现。
过去很长一段时间,行业默认超大规模强化学习只是极少数科技巨头的专属领地。当训练的每一次参数迭代、每一次显存报错排查和全部推理源码都被清晰摆在台面上,社区开发者面对的不再是一个神秘莫测的黑盒。
技术路线的真伪需要交给更多人在真实生产中去检验,但这份敢于把底牌全部摊开的坦诚,确实给大模型开源环境注入了一股健康扎实的力量。
