
业内广泛流传,由于端侧AI频繁调度云端大模型,会产生高频上下文消耗,苹果即将推出每月九到十四美元的增值订阅。用户花了上万元买顶配旗舰,核心体验还要每月付费?

80 TOPS 为什么跑不过 40
先把测试数据摆在台面上。
高通骁龙 8 至尊版二代,NPU 标称算力 80 TOPS。苹果 A20 Pro,NPU 标称算力 40 TOPS。
只看纸面参数,高通的数字整整大了一倍。
但实际拿同一个 7B INT4 开源大模型跑解码测试,高通每秒吐出 21 个 token,苹果每秒能稳定跑到 33 个 token。
苹果的实际出字速度高出了 57%。
数字倒挂的原因其实很直接。大模型生成文字采用自回归机制,每吐出一个字符,芯片都要把整套数十亿参数从内存里完整读取一遍。决定生成速度的瓶颈根本不在算力上限,而在内存带宽。
高通的算力单元再能算,内存搬运速度跟不上,张量核心大半时间都在干等数据。苹果的标称算力虽然只有 40 TOPS,但总线每秒能喂饱运算单元,实际吞吐自然更快。
挡在自回归解码前面的内存墙
很多人习惯把芯片算力和模型推理速度直接画等号,实际测试下来完全是两码事。
以一个 7B 参数的模型为例,就算把权重极限压缩到 4 位整数,模型文件也有将近 3.8GB 大小。自回归解码过程中,芯片每预测一个新词,这3.8G的权重数据就必须在总线上跑完一次全量巡检。
算力单元计算这部分数据可能只需要几毫秒,但把 3.8GB 数据从内存搬进计算核心的时间却远远更长。只要内存带宽卡在 100GB/s 左右,哪怕算力堆到天上去,物理极限每秒也只能吐出二十几个词。
这就业内常说的内存墙。
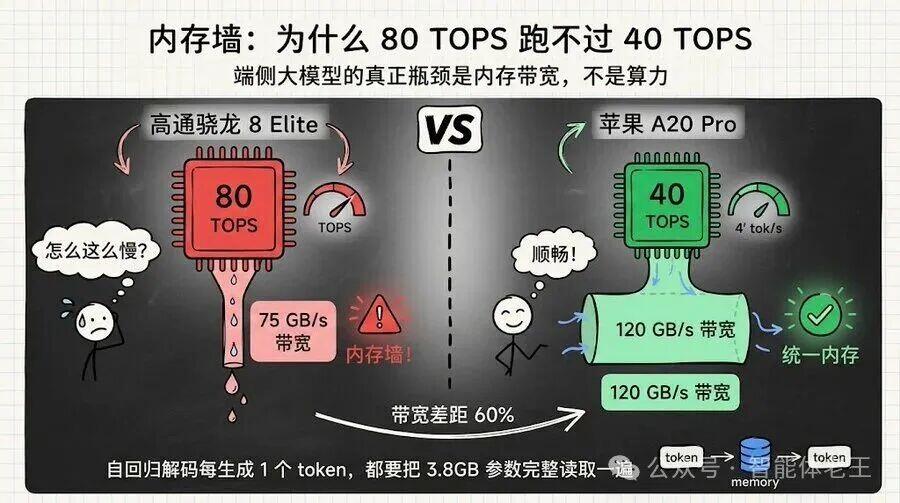
苹果的统一内存架构占了便宜。CPU、GPU 和 NPU 直接共用同一块物理显存池,计算过程中不需要在各芯片模块之间来回搬运拷贝数据。A20 Pro 这代把物理总线带宽又拉高了 50%,刚好把大模型注意力缓存所需的传输通道彻底打通了。
A20 Pro 与台积电 2nm 的实际散热表现
手机端跑大模型,硬件面临的第一道坎就是发热与耗电。
台积电 2nm 制程改用了全环绕栅极结构,把原来鳍式晶体管的三面包围改成了四面全包围。这种改动堵住了纳米级别下的量子隧穿效应,把漏电损耗压了下来,整体能效比前代提升了 30%。
晶体管漏电减少之后,核心排布也跟着变了。A20 Pro 的两颗超级大核心直接在指令译码阶段内嵌了神经加速器,通用计算指令能够顺畅调度张量运算。七核图形处理器也加强了矩阵计算,本地运行绘图模型时的去噪速度比上一代快了一倍。
这些硬件调整在日常跑模型时能感觉到明显区别。上一代机型跑两三分钟机身就明显烫手,iPhone 18 Pro 加大了均热板面积,高负载运行时的持续表现提升了 四成。
不过手机这种没有风扇的被动散热设备,物理规律依然绕不过去。连续满载运行十分钟,机身中框积热排不出去,芯片就会触发温控保护自动降频,推理速度会从最初的峰值跌落大约 三成。
32 核双 NPU 与原生 FP8 指令
A20 Pro 在 NPU 结构上做了堆叠。
苹果直接把两组十六核神经网络引擎并联起来,拼成了 32 核的双 NPU 阵列。单纯堆并联单元还不够,硬件指令集层面这一次原生加入了 FP8 数据格式支持。
过去手机端跑模型主流用的是 FP16 格式,也就是 16 位浮点数。FP8 把精度砍到了 8 位,模型体积和显存占用直接省一半,芯片每次从显存搬运的数据量也跟着减半。
在插着电的云端服务器上,少搬一半数据可能感知不强。但在手机内部几瓦的功耗窗口里,FP8 节约出来的一半传输量,决定了手机能不能真正常驻运行一个 7B 级别的模型。
12GB 内存下,8B 才是手机端侧的真实上限
发布会宣布全系标配 12GB 内存之后,不少人期待能把 14B 甚至更大参数的模型塞进手机。
实际跑一下就会发现行不通。
iOS 系统底层有一套严格的内存监管机制,叫做 Jetsam。一旦某个前台任务吃掉太多内存,系统为了保证打电话、收发消息等基本功能不崩溃,会直接把违规进程强行杀掉。
在 12GB 的总内存里,第三方应用能够申请到的内存上限被系统卡在 6GB 左右。
跑一个 8B 模型,权重本身要占 4GB 到 5GB,再加上对话上下文的键值缓存,已经贴着 6GB 的警戒线在跑。如果硬要载入 14B 模型,往往刚加载完参数就会被系统判定内存超标直接闪退。
苹果自己研发的 3B 官方小模型则走了另一条路。工程团队用了 2 位精度感知量化训练,把运行时显存压到了 1GB 以内。文本润色和通知摘要这些系统级任务,完全能在本地毫秒级处理完毕,不需要调用外部网络。
Siri 接入屏幕语义与第三方调度
系统层面的变化集中在 Siri 的交互逻辑上。
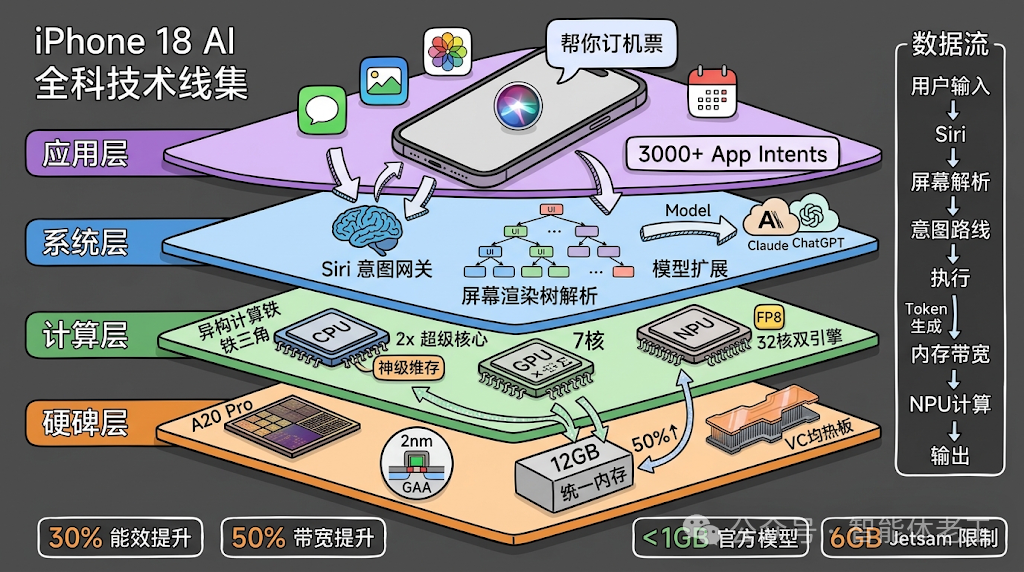
早期的语音助手依赖关键词去触发写好的固定规则。现在的版本直接读取系统的屏幕渲染树,把屏幕上正在显示的控件、图片和文本转成语义层面的节点,识别用户的自然指代意图。
你在屏幕上看着某个商品或者某张照片,直接对它下指令,系统能把屏幕坐标和应用内部数据关联起来执行操作。
底层接口打通了 三千多款主流应用,复杂的专业问题还会通过系统扩展通道透明转发给第三方大模型。灵动岛也配合改了展示方式,前台不需要反复切换应用,后台任务的执行进度可以直接在顶部并发展示。
逆向工程发现的底层微调模型
国外几位逆向黑客在拆解系统二进制包时,挖出了一套有趣的实现细节。
新版 Siri 在手机端处理屏幕感知和系统级控制的微调模块,底层使用的是谷歌专门针对苹果处理器微架构优化过的 Gemini 变体模型。
两家科技巨头在公开市场激烈竞争,但在端侧实际工程落地中,却在底层形成了软硬件层面的直接协同。高难度的复杂推演任务交给云端通道分发,手机本地的高频控制则由这套深度定制的小模型接管。
硬件堆叠背后的真实体验
80 TOPS 的芯片跑不过 40 TOPS,拆解到底就是一套取舍与工程妥协。
台积电 2nm 控制了功耗,统一内存抹平了跨芯片传输延迟,FP8 压低了显存吞吐量,系统层面的 Jetsam 机制则划定了端侧常驻模型的安全边界。这些配合起来,手机端的本地模型才算真正具备了日常可用的条件。
后续的挑战主要集中在商业和成本上。端侧处理不了的复杂问题频繁抛给云端,高频的上下文传输让服务器成本迅速上升。供应链消息显示,苹果后续可能会对高频云端智能体服务收取每月 9 到 14 美元的订阅费用。
手机端侧大模型到底能不能彻底改变我们使用手机的习惯,硬件底座已经铺好了,接下来就看应用生态能走多远。
