
Agent Harness:模型之外的那一半,正在被删掉
大家盯着模型参数、跑分、新版本。但有一篇阅读量很高的文章说:去年底 Agent “突然能用了”,功劳不在模型权重,在模型外面的那套东西——Harness(原意马具/挽具,这里指"让模型跑起来的整套外围系统")。更巧的是,最近 DeepSeek 和 OpenAI 先后把自家 harness 的能力摊开给了外界。
一、发生了什么
2025年圣诞节前后,AI 工程师们注意到一件事:Agent 突然能干活了。为什么?说不太清。
Latent Space 的 Dan McAteer 在 2026年8月22日发的《The Evolution of the Agent Harness》里给了一个判断:不是模型单方面的进步,是模型和"挽具"一起成熟,两条曲线在那个时间点交汇了。
Transformer 的发明人之一 Lukasz Kaiser 2026年6月在播客里也说过类似的话:“去年圣诞那次变化,很难精确定位。大概是 harness 变了、一点 post-training 变了、然后新预训练模型来了……但感觉像一次大跳跃,很难说清楚是哪件事。”
McAteer 的答案是:"发生了什么"不在模型权重里,在权重周围长出来的那套系统里。答案在 Agent Harness 里。
二、原文的核心观点(McAteer, Latent Space)
观点一:Harness 是什么——"缸中之脑"的身体
McAteer 的定义很形象:2022年11月的 ChatGPT 只是个"缸中之脑"——除了训练数据和你给的提示词,什么也干不了。没有工具、没有搜索、没有推理。
Agent Harness 是除了模型权重之外、让 Agent 能运转的一切:环境、工具、上下文、护栏。没有 harness,模型就是缸中之脑;有了 harness,模型才能感知(context)、行动(tools)、持久化(memory/compaction)、执行边界(permissions/guardrails)。“Harness 相当于给模型的意识一个身体。”
观点二:两条曲线和一个鸿沟
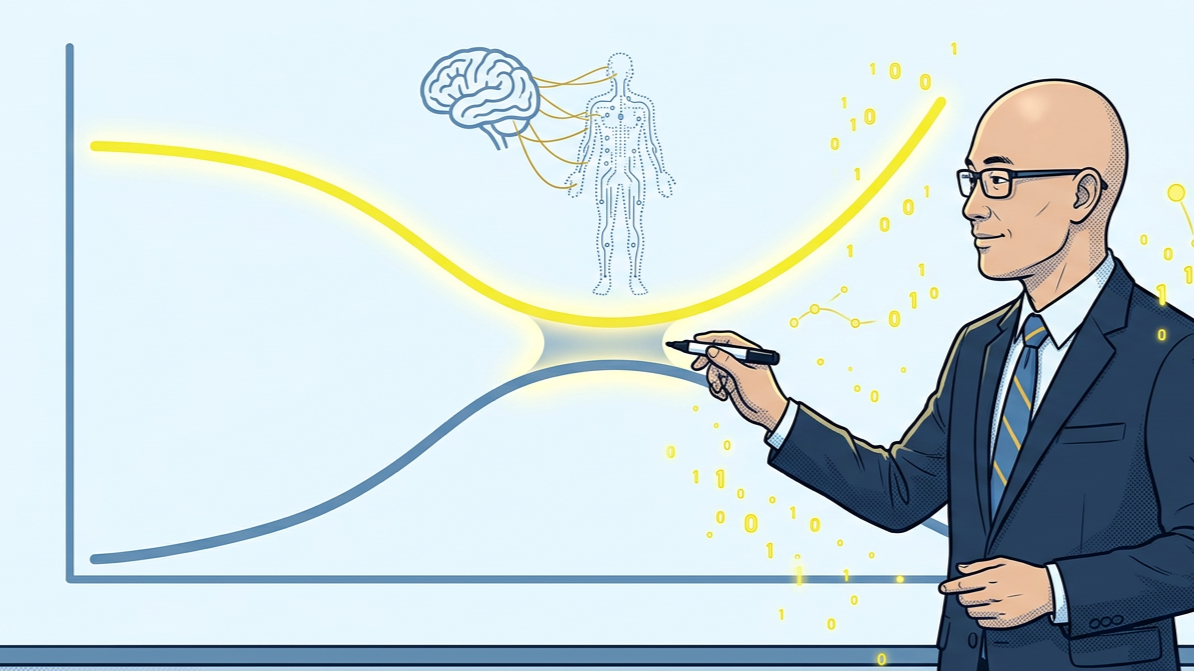
整个模型/Harness 进化史,可以画成两条曲线:
一条是 Harness 向模型"要求"的能力
一条是模型"实际能交付"的能力
两条线之间的鸿沟 = Agent 的有效度。鸿沟收窄,就是 Kaiser 说的那次"大跳跃"。
McAteer 按阶段拆了这个鸿沟怎么收的:
ReAct(2022年10月):“纸上的 Harness”。用提示词让模型走"推理→行动→观察→重复"的循环,循环只存在于提示词里。
AutoGPT/BabyAGI(2023年春):“过早的 autonomy”。Harness 曲线冲到模型能力前面,把"自主员工"的活交给还只是"脆弱的 next-token 预测器"的模型。一个 20 步的任务,每步 95% 可靠,整体成功率只有约 36%。“循环不会给模型增加能力,只会放大模型已有的能力——低于某个阈值,循环放大的是错误。”
Cursor/Copilot(2023–2024):“退回人在回路”。撤回 autonomy,把循环交回给人,模型给人加速。Answer.AI 的测试显示 Devin 第一代自主模式成功率约 15%——证明退一步不是怂,是对的。
Claude Code(2025年2月):“曲线交汇”。o1 把模型能力推过阈值后,Claude Code 第一个把循环重新交还给模型——这次模型"懂任务了"。半年做到约 10亿美元 ARR。
观点三:Harness 2.0——“同一模型,换 harness,分差23.8”
这是最硬的证据。Harness-Bench 用同一个模型、同一批 106 个任务、不同 harness 跑,分数从 52.4 到 76.2——模型一行没改,分差 23.8 分。“Agent 的一半是 harness。”
OpenAI 在 ARC-AGI-3 上也得到类似结果:只加"保留推理 + compaction",GPT-5.6 Sol 分数从 13.3% 涨到 38.3%(三倍)。
底层发生了什么?RL 进了 harness。codex-1(2025年5月)是"在真实编程环境的多种环境里用 RL 训练出来的"。两条曲线开始"编织"成统一系统。然后——模型开始把 harness 能力吸收进权重:比如学会带着对自己 context window 的认知做 auto-compact。GPT-5.1-Codex-Max 的发布说明写的是"第一个原生训练成能跨多个 context window 通过 compaction 运作的模型"。
观点四:进化的闭环——train → absorb → shed → repeat
模型吸收了 harness 能力,harness 就能拆掉脚手架。McAteer 说:“衡量 harness 进化速度的标准,是你删掉了多少 harness,同时保留同等能力。” Anthropic 的 Thariq Shihipar 说他们最近删掉了 Claude Code 80% 的系统提示词。
观点五:Harness 3.0——“注意力时代”
继续删。多智能体编排、工具选择、记忆……最终都会被模型吸收。删到尽头,剩下的是以人为中心的能力:权限、身份、信任、可解释性(legibility)。
McAteer 的关键判断:“吸收不会终结 harness,吸收会反转 harness。” Harness 本来是"人对模型的接口",反转后变成"模型对人注意力的接口"——他叫它 attention-interface(注意力接口)。
他的预测:一年内,每个做 Agent 的公司都会交付一个"人类注意力策略面",就像今天每个公司都交付了 AGENTS.md。 AGENTS.md 告诉 Agent 怎么跟你的代码库协作;注意力接口告诉 Agent 怎么跟你协作——什么时候能打断你、什么时候该继续干活、哪些决定它能自作主张、哪些要你批。
“模型始于缸中之脑。Harness 给了大脑一具身体,然后身体开始溶进大脑。留给我们要建的,是任何未来模型都永远吸收不了的东西——通往唯一真正稀缺资源的接口:人类注意力。”
三、开源 Harness 冲击波
上面是 McAteer 8月22日的判断。但就在他写这篇文章前后,harness 圈发生了一件他没展开写、却对企业影响更直接的事——大厂开始把 harness 能力摊开给外界。两件事要分清楚,不能混为一谈:
① DeepSeek:真开源
2026年8月13日,DeepSeek 发布 DeepSeek Harness v0.1(代号 dsh),MIT 许可,基于自研的 Cordis 元框架。核心设计原则是 “Everything is a Plugin”——模型、工具、会话、沙箱、存储、甚至运行时本身,全是插件。官方定位是 local-first、隐私优先 的编码 Agent 与运行时环境。发布两天 GitHub 星标就冲到 9.5万+,是近年来 adoption 最快的开源 Agent 项目之一。(来源:DeepSeek 官方 harness 文档、VentureBeat / TheNewStack 报道)
② OpenAI:公开设计,不开源实现
OpenAI 这边要写准确——它没有把 Claude-Code 对等的 harness 代码 MIT 放出。它做的是"公开构建方法":
2026年2月4日,OpenAI 发《Unlocking the Codex harness: how we built the App Server》,把 Codex 跨端(web/CLI/IDE/macOS)共用的 App Server 架构、JSON-RPC 协议、集成经验全摊开,明确说"希望你们把同一套 harness 带进自己的产品"。
2026年2月11日,Ryan Lopopolo(就是 McAteer 文中引的那位)发《Harness engineering》,讲 OpenAI 内部如何用 Codex 0 手写代码、1/10 时间造出百万行代码产品的实践,核心一句:“Humans steer. Agents execute.”
所以准确说法是:DeepSeek 开源了 harness 实现,OpenAI 开源了 harness 方法论。两者都在降低企业自建 harness 的门槛,但性质不同。
四、树懒老K的解读:对企业意味着什么,自建对不对
把 McAteer 的判断 + 上面两件真事放一起,回答两个你关心的问题。
问题一:开源 harness 对企业有什么积极影响?
第一,把"护城河"从代码变成了数据和方法。以前企业觉得"用 AI 得自己搭一套",现在 DeepSeek 把运行时的架子给你了,你不用从零造轮子。省下的精力该投到哪?投到 McAteer 说的 harness 五项里最值钱的两格——context(你的业务本体)和 permissions(你的审批边界)。这两格开源给不了,因为它们是你的私有知识。
第二,local-first / 隐私优先 让制造业敢用了。DeepSeek harness 强调 local-first,数据不出厂。我做过工控网络安全创业,最清楚制造业的顾虑:核心工艺参数、质量数据,绝不可能随便传云端。开源 + 本地部署,等于把"能不能用"的开关交回给企业自己。这是制造业 AI 落地过去三年最大的卡点之一,现在松动了。
第三,OpenAI 公开 App Server 协议,意味着"Agent 互联"有了事实标准雏形。就像当年 REST 成了 Web API 的默认,JSON-RPC 这套如果被广泛接受,企业以后接不同模型、不同 Agent,不用每家重写一遍适配层。
问题二:软件厂商甚至企业自己也在构建 harness,对还是错?
不能一概而论。我的判断是分三层:
错的情况——“为建而建”,重复造 AutoGPT 阶段的轮子。 McAteer 把 AutoGPT 叫"过早的 autonomy":给模型超出它能力的自主权,结果放大错误。今天很多企业的"智能体平台"项目,本质就是 2023 年的 AutoGPT——兴致勃勃给了 Agent 一大堆工具和数据源,底下模型没到阈值,跑两步就垮。这种自建,错。直接用 DeepSeek harness 或成熟框架起步,把精力留给业务本体,比自己写一套"万能 Agent 中台"靠谱得多。
对的情况——在开源 harness 之上做"行业 harness"。 DeepSeek 给的是通用骨架(Everything is a Plugin)。企业要的是把行业语义插进去:离散制造的 BOM 结构、化工的工艺配方、药企的 GMP 合规规则。这些插件,开源社区不会替你写,模型权重也吸收不了(因为是你的私有知识)。正确的自建,是建"插件",不是建"骨架"。 我在做 MDM/ERP 时定义的"企业级主数据标准",放到 Agent 时代,就是最该自己写的那个 context 插件——这也呼应了前一篇本体论文章:本体论不是比喻,它是 harness 里 context 那一格的工程实现。
必须自建的情况——涉及核心生产与安全边界。 如果 harness 管的是产线启停、配方下发、质量放行,这类 permissions/guardrails 不能外包给通用框架的默认值。McAteer 说"吸收会反转 harness,剩下的是权限、身份、信任、可解释性"——这四样,越是关键业务越要自己掌控。该自建的是这一层"注意力接口",不是底层运行时。
一句话总结: 底层运行时用开源的(DeepSeek harness 或 OpenAI 公开的协议),中间行业语义自己写插件,顶层安全与审批边界自己控。三层里只有两层需要"建",而且都不是从零建。
来源信息
主文: The Evolution of the Agent Harness / Dan McAteer / Latent Space / 2026-08-22 / https://www.latent.space/p/attention-interface
DeepSeek Harness v0.1: DeepSeek 官方 harness 文档(deepseek.com/harness)、VentureBeat、TheNewStack 报道 / 2026-08-13
OpenAI Codex App Server: Unlocking the Codex harness / Celia Chen / OpenAI / 2026-02-04 / https://openai.com/index/unlocking-the-codex-harness
OpenAI Harness engineering: Ryan Lopopolo / OpenAI / 2026-02-11 / https://openai.com/index/harness-engineering
文中引述人物: Lukasz Kaiser(Transformer 发明人之一)、Thariq Shihipar(Anthropic)、Ryan Lopopolo(OpenAI)
推荐阅读
[[2026-08-07_本体论复活-AI-Agent|AI Agent 正在让"过时的"本体论复活]]
关注 树懒老K,每周分享 AI 时代的企业转型观察。
