
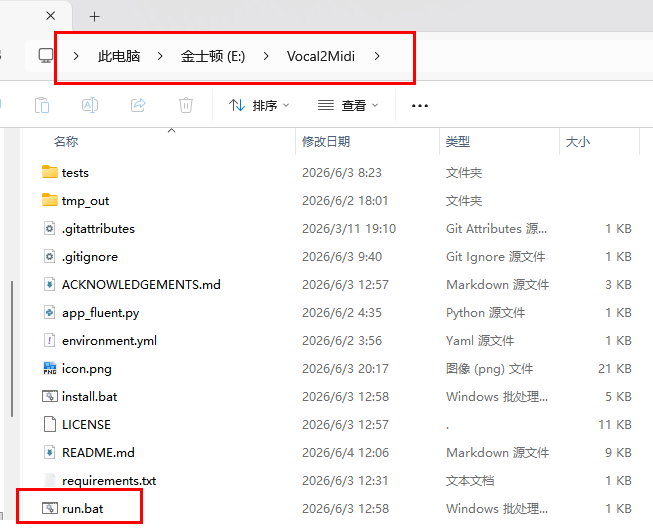
将压缩包解压到非中文目录后,双击run.bat即可打开程序,无需运行install.bat
用户界面如下:
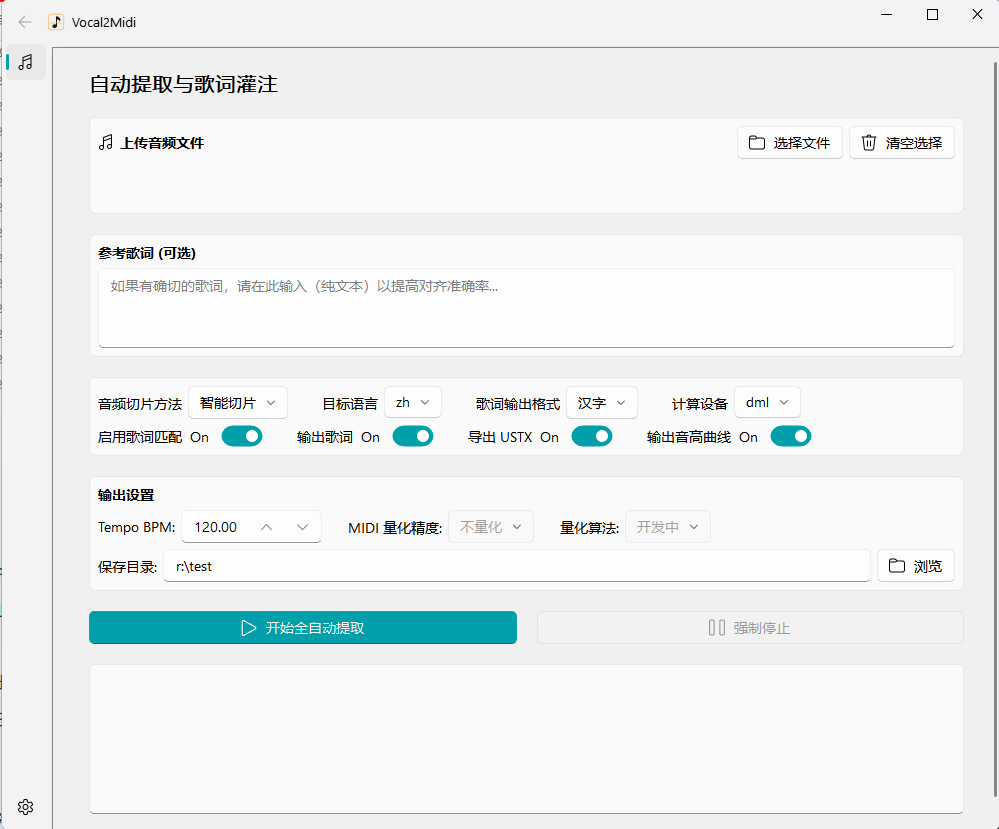
按钮
选择文件:导入待处理的干净的人声干声文件(wav,flac,mp3等)
清空选择:移除当前已选音频并重置列表
浏览:选择提取结果的保存位置
开始全自动提取:启动识别、对齐与导出流程
强制停止:立即中断当前正在运行的任务
开关
启用歌词匹配:使用干净的参考歌词提升匹配准确率(在汉语普通话中可有效提升识别准确率,但在日语中表现不佳,不建议使用)
输出歌词:导出包含歌词标注的结果文件
导出 USTX:生成可在 OpenUtau 编辑的工程
输出音高曲线:把音高曲线写入 USTX 工程
下拉/选择控件
音频切片方法:选择音频分段策略与切片方式(智能切片与启发式切片相对好用)
目标语言:指定识别与歌词处理所用语言
歌词输出格式:设置歌词导出的显示形式
计算设备:选择推理运行所使用的设备
Tempo BPM:设置导出工程的目标速度
MIDI 量化精度:控制音符时值对齐的精度(开发中)
量化算法:选择音符量化时使用的规则(开发中)
侧边栏
音符图标:进入自动提取与歌词灌注页面
齿轮图标:打开全局设置与模型路径配置
设置界面如下:
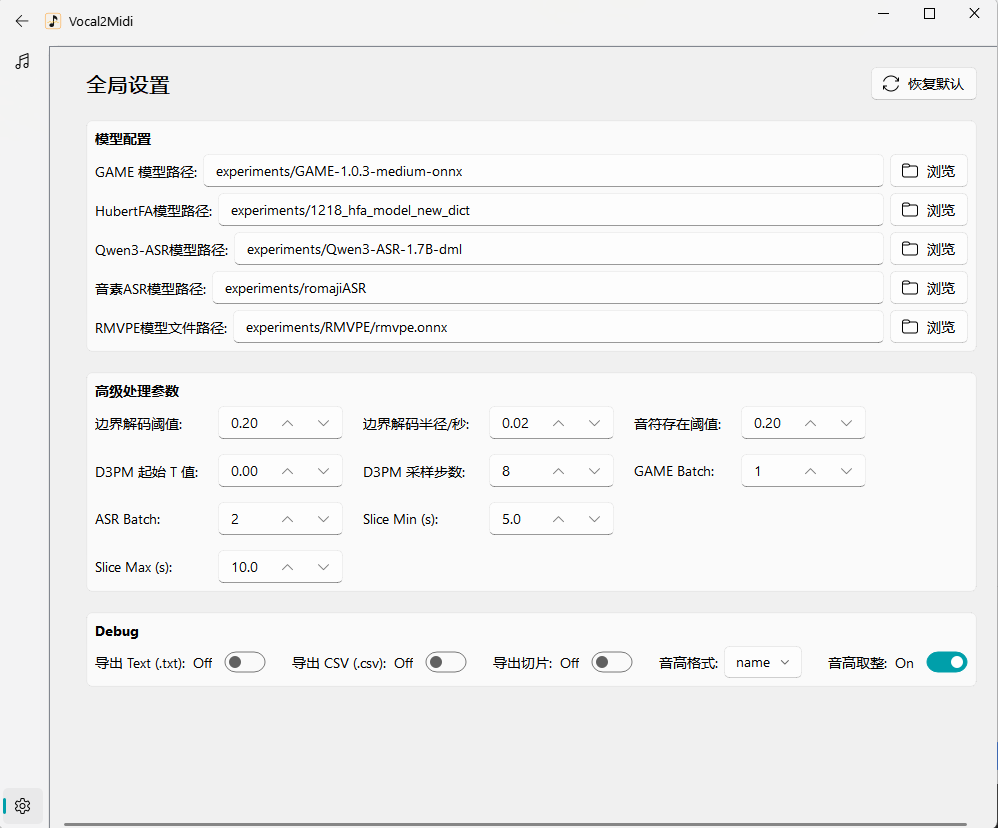
重要提示:如果您不知道这些设置的功能与更改意义,请勿乱改处理参数,如果软件出现问题,请点击右上角的恢复默认选项以重置到默认设置
下面简要讲解几个参数:
GAME Batch:控制 GAME 音高提取时的并行批大小
ASR Batch:控制语音识别阶段一次处理的切片数量
Slice Min (s):限制单个切片允许的最短时长
Slice Max (s):限制单个切片允许的最长时长
如果遇到显存不足的问题,请适当减少上述参数的数值,其中GAME Batch与ASR Batch对识别效果无影响
Slice Min 和 Slice Max设置的过大会极大地占用显存容量,过小会影响转写效果,建议保持默认值或在5-30之间调整。
下载地址见:https://www.bilibili.com/video/BV1Ww7C6kEqL/
