
本文按 CC BY-NC-SA 4.0 署名-非商业性使用-相同方式共享 协议开放转载权,转载请注明出处
专栏撰写@智能BGM,由 deepseek 辅助,感谢 @ZeroAurora零极光酱 提供完整思路
由于 【明日方舟/ARG】预言家的最初指令 —— AMa-10 解谜过程记录 中复原二维码的过程不够严谨,以及一众解析视频中似乎都没有详细描写该过程,故写此文补全推理链条
本文仅会简要的介绍纠错过程中涉及到的二维码技术,如果你想深入了解二维码背后的的完整工作原理,这里有个推荐的视频
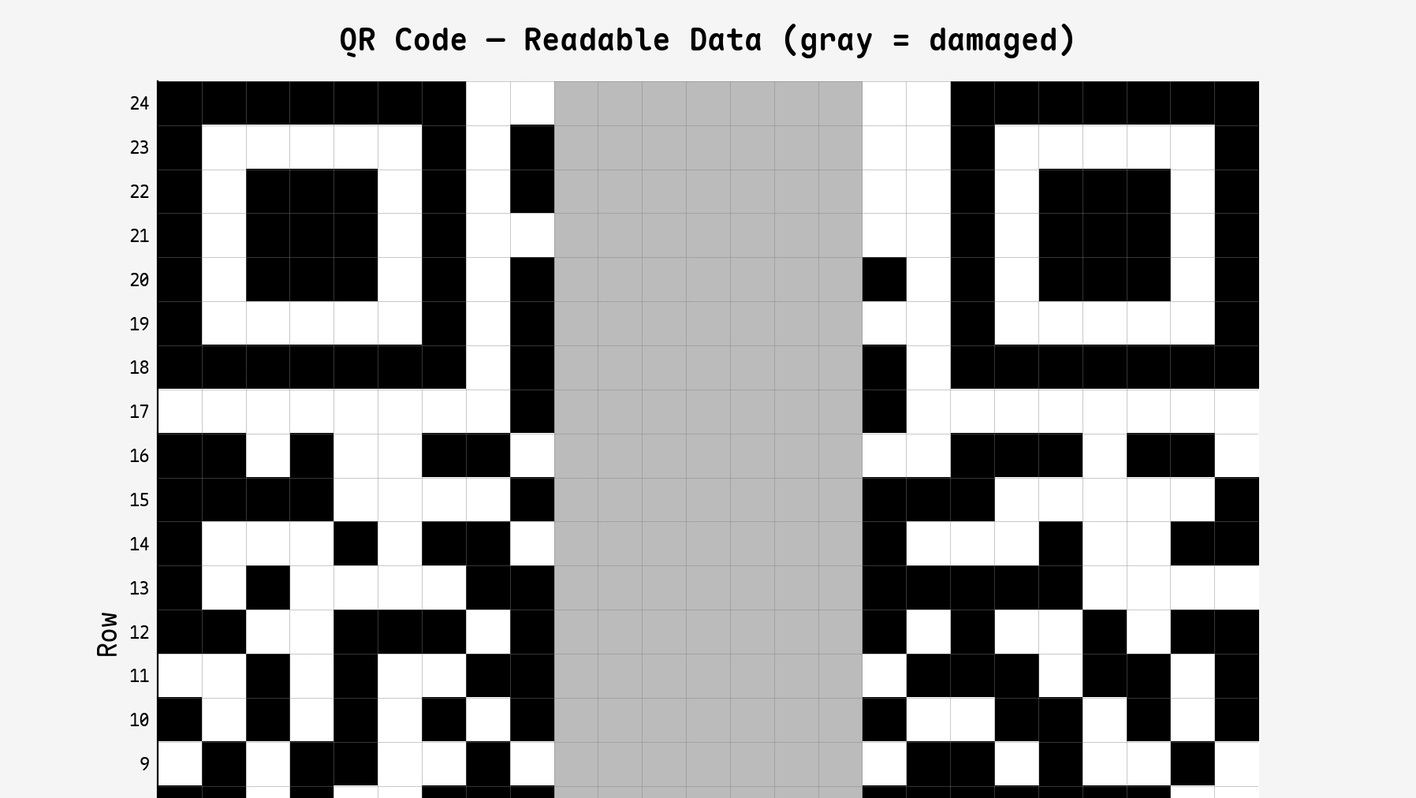
前文提到,可恢复出二维码如下,该二维码为大小 25*25 的 Version 2 标准二维码(QR Code)
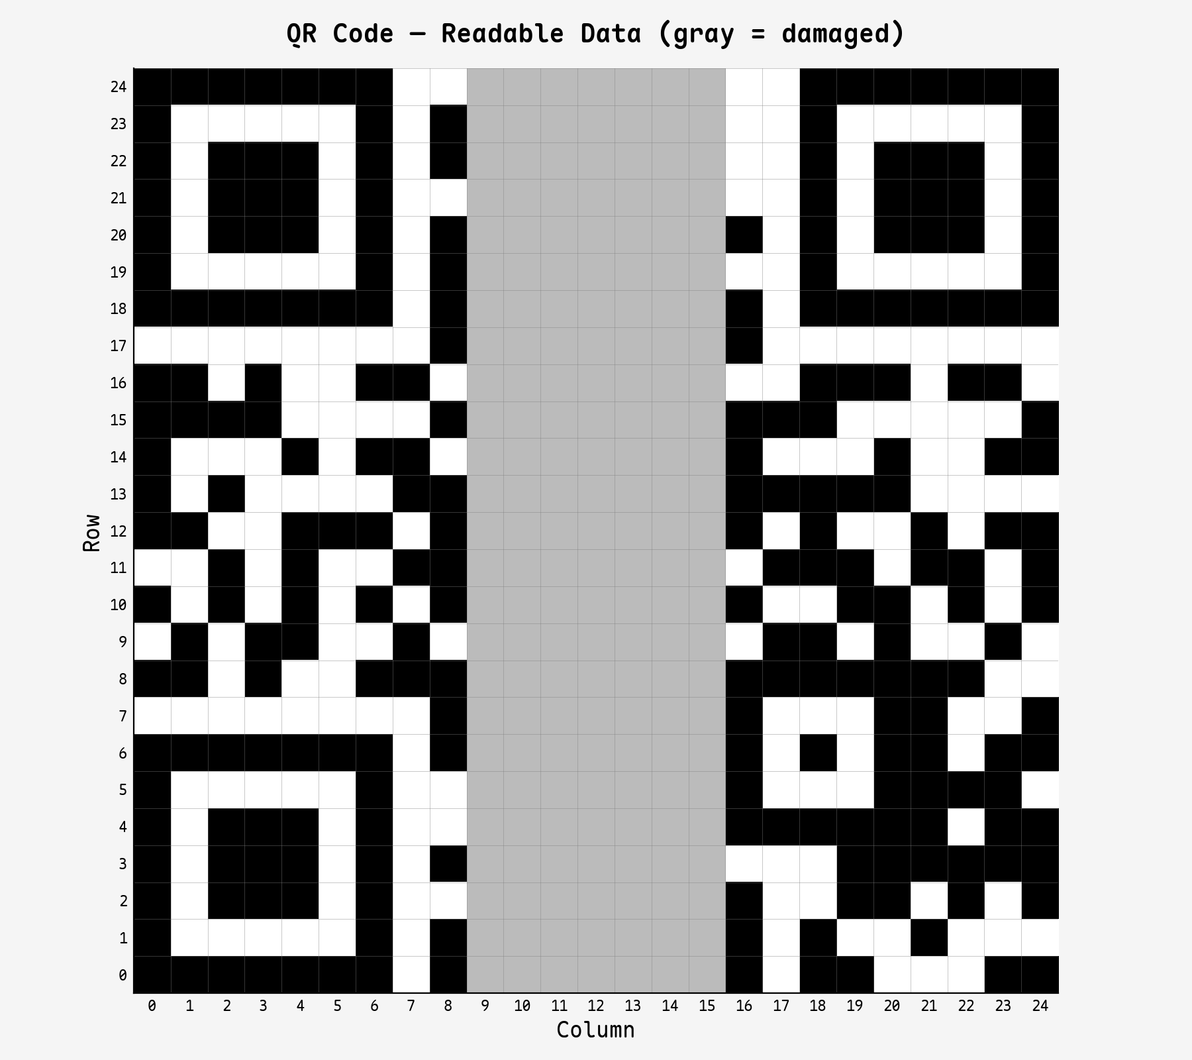
而根据二维码的结构组成,我们可以画出一个示意图
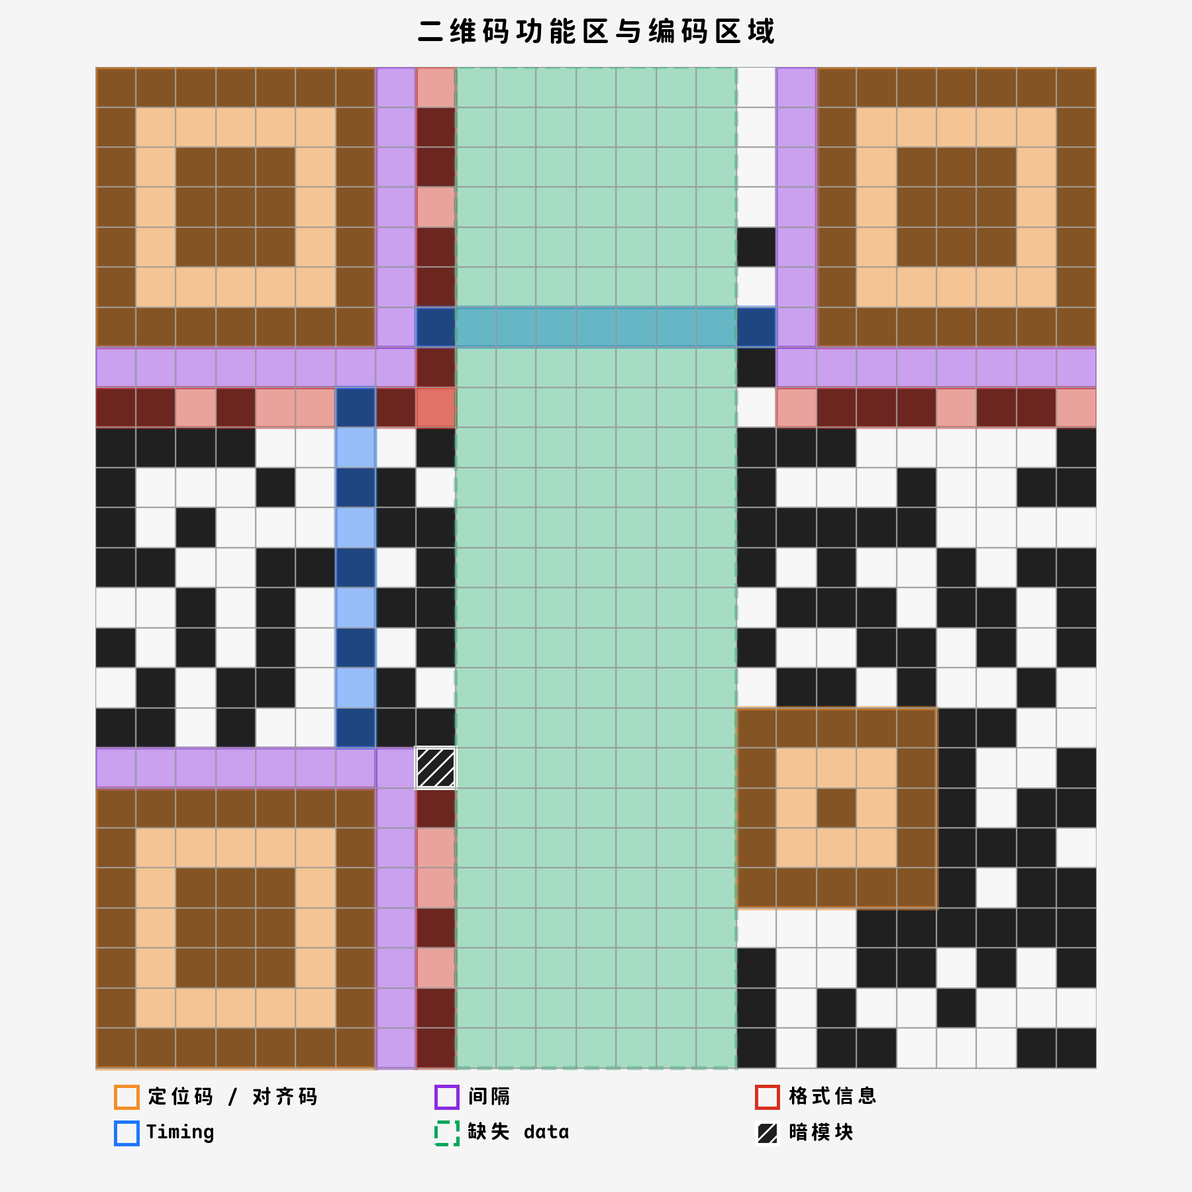
其中橙色的部分为定位码和对齐码,蓝色的部分为时序图形,这两个部分是所有版本 2 的标准二维码中都会出现的部分,用于相机从不同角度扫描二维码时计算图像畸变并恢复原始图像。这些部分对恢复数据没有帮助,真正值得关注的是红色的格式信息
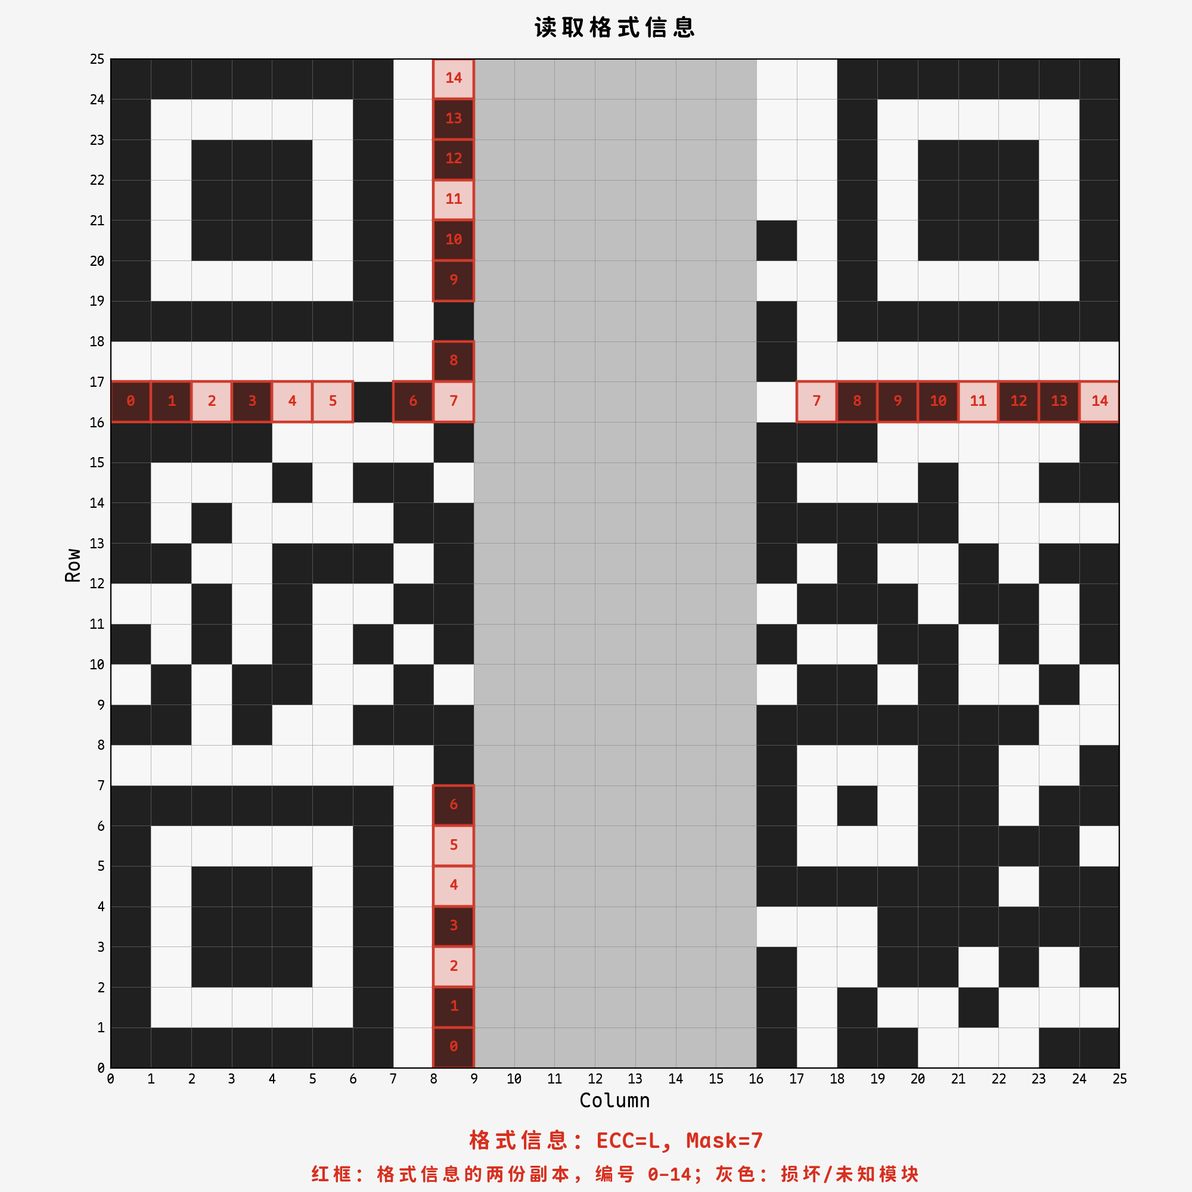
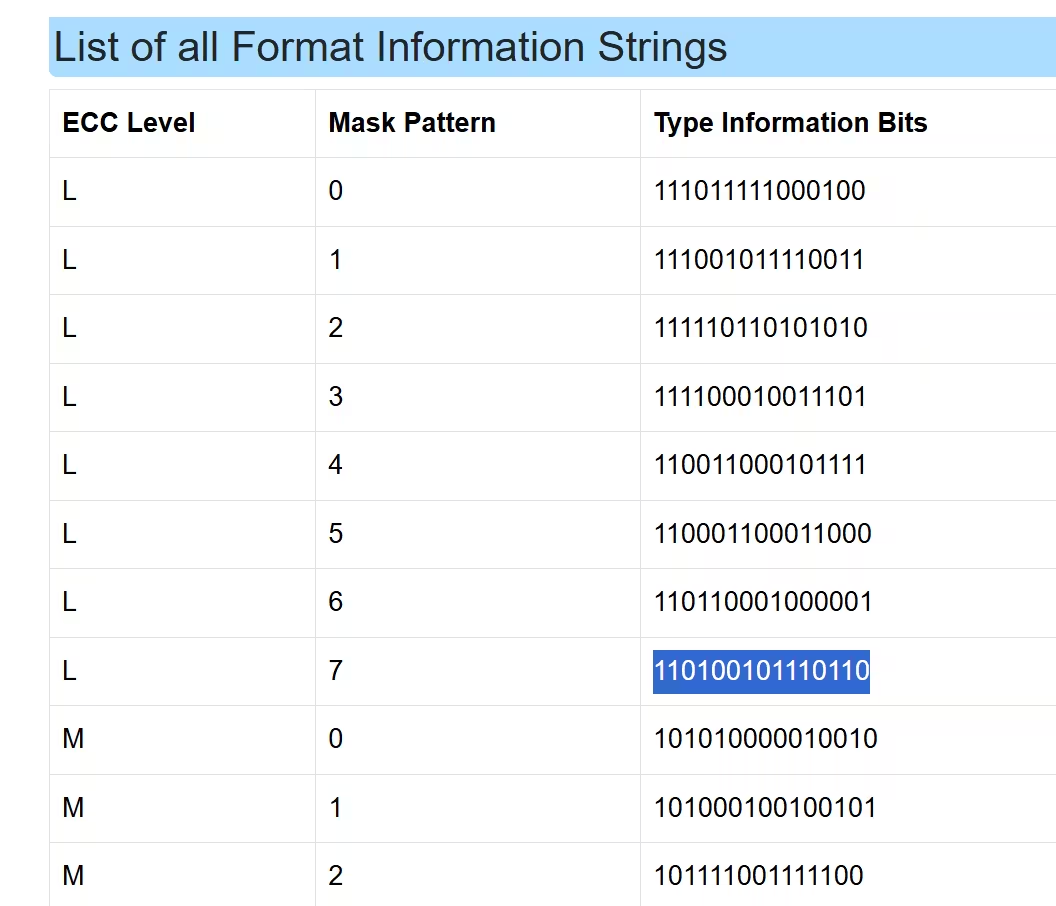
上图中被红色标出的部分为二维码的格式信息串,为了保证二维码的抗污损能力会有一份副本,两份数据均可读出该二维码的格式信息为 110100101110110,对应的纠错等级为 L,掩码为 7
这时候就要涉及到二维码的数据编排方式。在构造二维码的数据编码区域时,数据的填充顺序是从右下角开始,沿着特定的蛇形路径,从右向左、从下向上交替进行
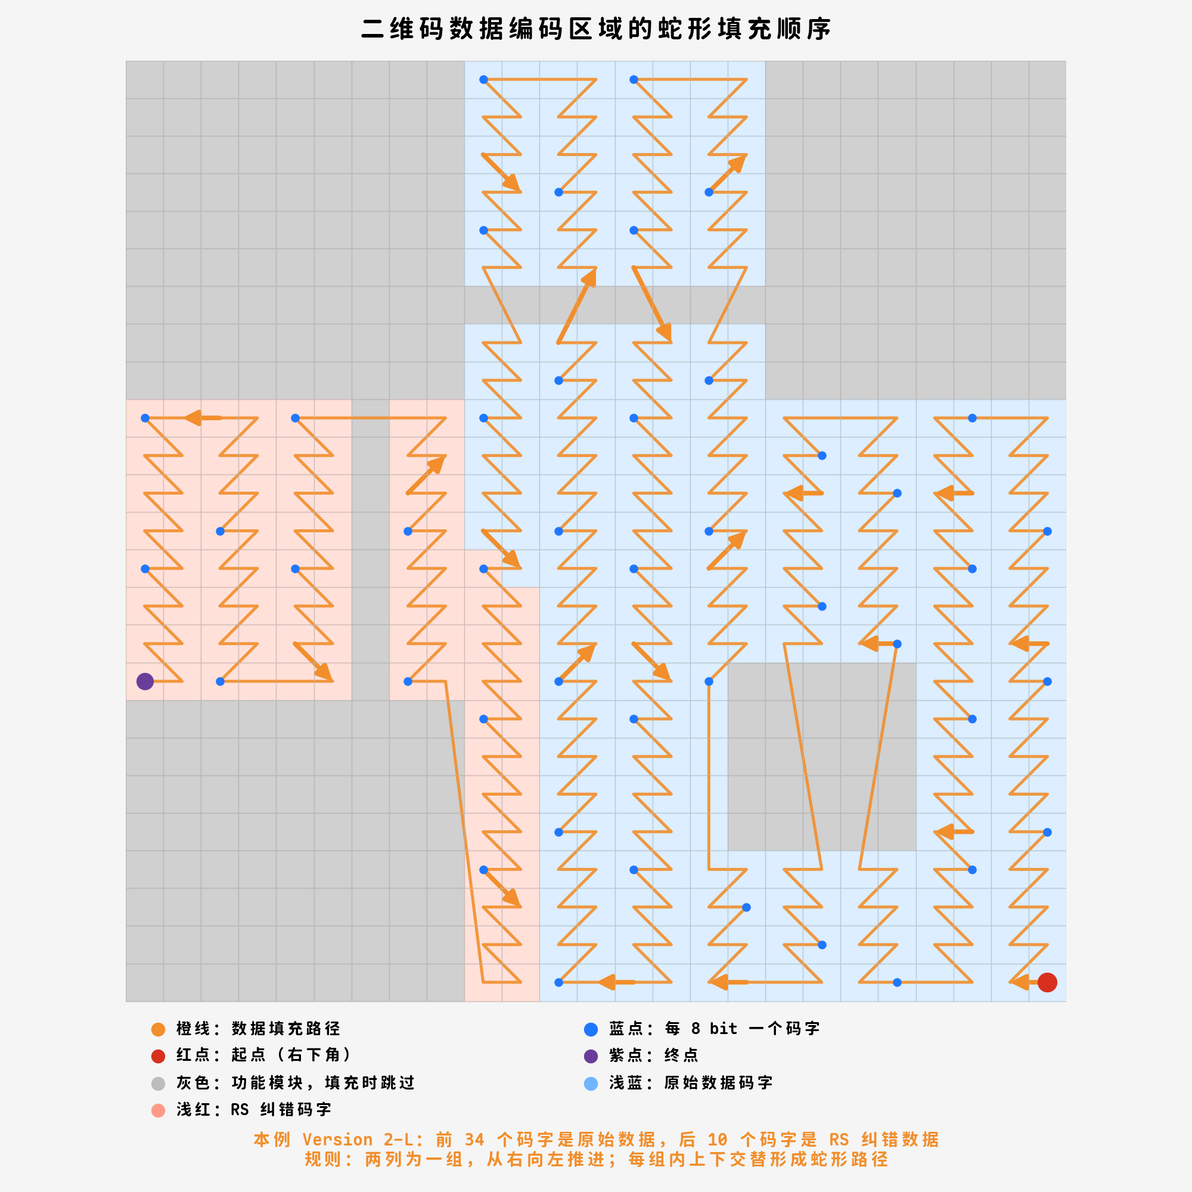
而其中的数据又可以被分为两部分:原始数据和纠错数据。原始数据保存真正要表达的内容,而纠错数据则是根据原始数据计算出来的一组“校验线索”。按照图中信息,可计算如下:
而由于等级 L 的纠错能力约为 7%,显然无法直接计算出原始二维码数据。也正是在这里,解谜陷入了停滞。为了继续推进下去,我们需要理清原始数据和纠错数据之间的关系
二维码在存储数据时,会将每 8 bit 的信息作为一组,称作一个“码字”,原始数据对应原始码字,纠错数据对应纠错码字。如果将原始数据简要地理解为 m 个未知数,那么纠错码就是 n 个线性无关的方程,这些方程组每个都包含前面的 m 个未知数
因此,在满足一定条件的情况下,就可以通过解方程的方式算出所有未知数。在 里德-所罗门(Reed-Solomon)纠错算法 下, 恢复信息的要求是:可读的码字数量 ≥ m,即 损坏的码字数量 ≤ n
这里也很好理解:假设 m 个可读码字中有 m-x 个原始码字,那么就有 x 个纠错码字,也就是说有 x 个未知数和 x 个方程组要解,那么一定能解出这些剩余的未知数。当 x = 0 时,所有可读码字全为原始码字,那么可直接读出原始信息,也就是未知数全部已知,不需要解方程组。当 x = m 时,所有可读码字全为纠错码字,则我们有 m 个方程组,去解出这些方程组中的 m 个未知数,同样可解
有了以上的理论知识,解谜就可以继续了。
对于 Version 2 的标准二维码,按照其标准格式有 m=34,n=10,也就是原始数据码字为 34,纠错数据码字为 10,那么我们只需要至少 34 个可读码字就能恢复所有信息
而我们手头这个二维码,已知的部分有原始可读数据为 127 bit,为 15 码字;纠错数据 57 bit,为 7 码字。15 原始 + 7 纠错 = 22 个可读码字,显然无法恢复信息,我们之前的推论是正确的(无法读取整个码字的部分需要直接丢弃)
但是注意力惊人的同学可能已经想到了,二维码的右半边可见代表着我们拥有一部分原始数据。并且根据二维码的数据排列方式,这部分原始数据对应的正是完整数据的开头。因此可以通过运算直接解出,这里给出脚本的运行结果
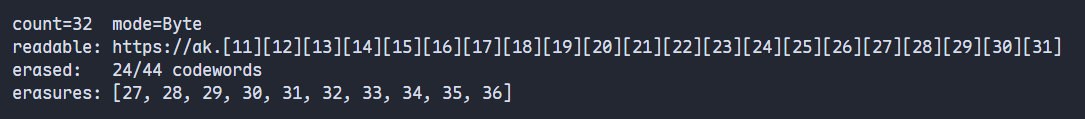
可以看到 readable 部分明显出现了 https://ak. 的样式,并且整个二维码包含的信息为 32 字节。由于 URL 中的英文字母和符号在 UTF-8 编码下各占 1 字节,因此可直接对应为 32 个字符
根据过往的解谜经验补全网址为方舟官网后,该字符串可更新为 https://ak.hypergryph.com/[26][27][28][29][30][31],也即缺失的信息为 6 个字符
此时,则可以按照已知内容填充原始码字到图中,加上固有的时序图形,二维码看起来长这样
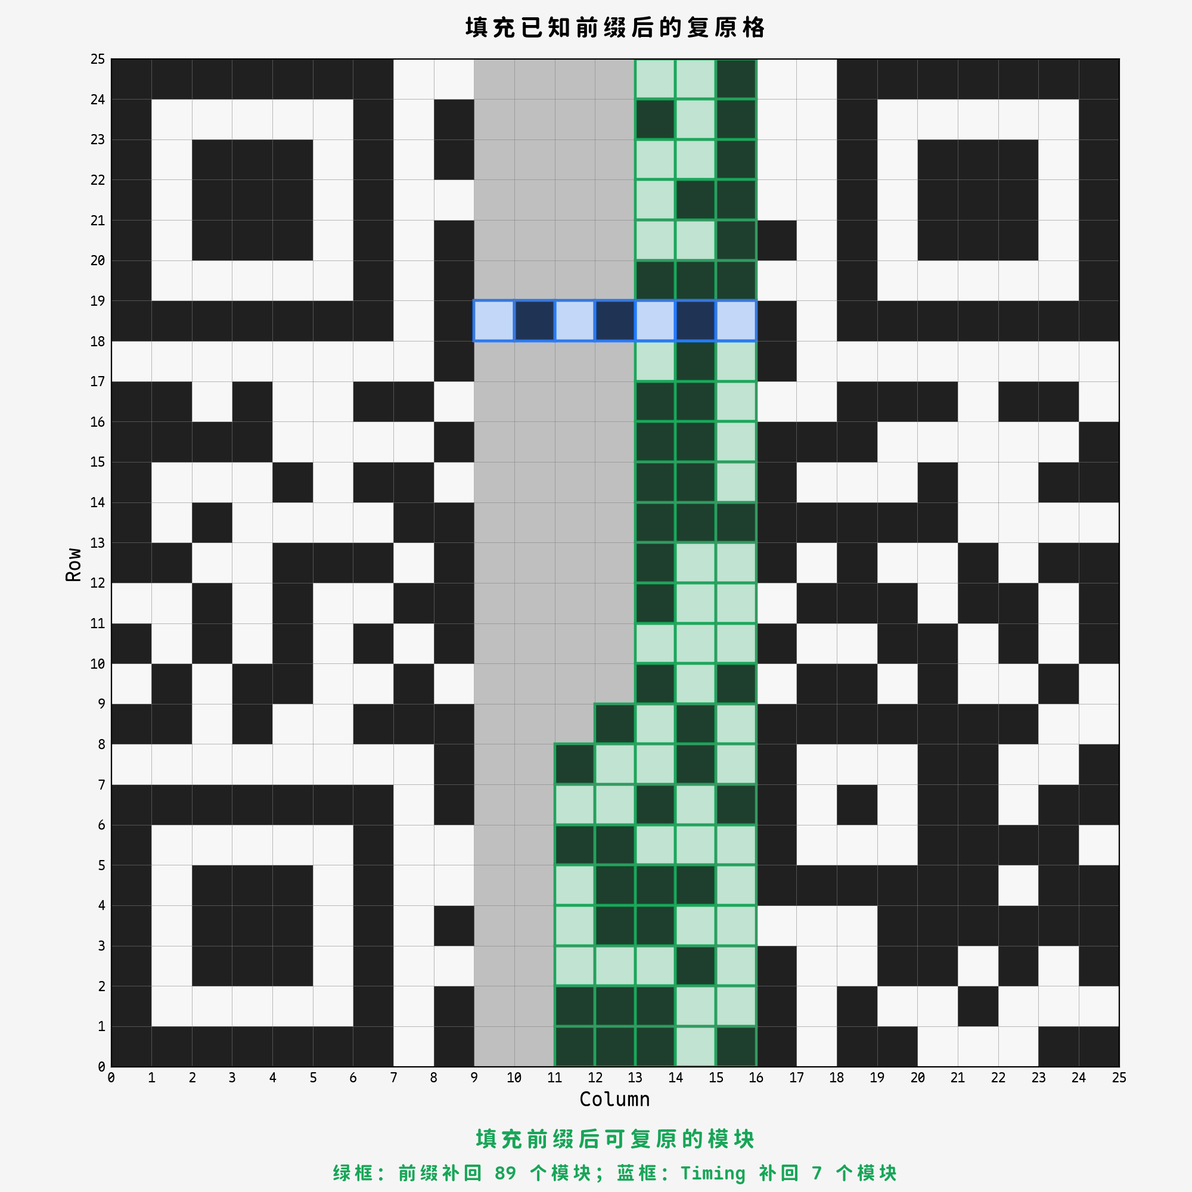
此时,二维码情况如下:原始数据由 127 bit 变为 216 bit,即 27 个码字。那么加上之前的 7 个纠错码字,总的可读码字数变为 27 + 7 = 34 码字,正好等于 Version 2 标准二维码的最低可恢复限度,那么根据里德-所罗门算法去接方程组,即可得出原先二维码的全部信息
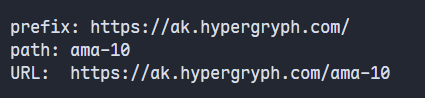
至此,二维码复原过程完成补全
信息学,多么神奇啊
下面给出使用的脚本,也可前往 gist 查看 SherkeyXD@gist: ama10.py
import math
import numpy as np
import qrcode.base as qrbase
from qrcode import constants
from qrcode.main import QRCode
from qrcode.util import QRData, MODE_8BIT_BYTE, create_data
from reedsolo import RSCodec, ReedSolomonError

QR_MATRIX = np.array([
    [1,1,1,1,1,1,1,0,0,-1,-1,-1,-1,-1,-1,-1,0,0,1,1,1,1,1,1,1],
    [1,0,0,0,0,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,0,0,1,0,0,0,0,0,1],
    [1,0,1,1,1,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,0,0,1,0,1,1,1,0,1],
    [1,0,1,1,1,0,1,0,0,-1,-1,-1,-1,-1,-1,-1,0,0,1,0,1,1,1,0,1],
    [1,0,1,1,1,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,1,0,1,1,1,0,1],
    [1,0,0,0,0,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,0,0,1,0,0,0,0,0,1],
    [1,1,1,1,1,1,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,1,1,1,1,1,1,1],
    [0,0,0,0,0,0,0,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,0,0,0,0,0,0,0],
    [1,1,0,1,0,0,1,1,0,-1,-1,-1,-1,-1,-1,-1,0,0,1,1,1,0,1,1,0],
    [1,1,1,1,0,0,0,0,1,-1,-1,-1,-1,-1,-1,-1,1,1,1,0,0,0,0,0,1],
    [1,0,0,0,1,0,1,1,0,-1,-1,-1,-1,-1,-1,-1,1,0,0,0,1,0,0,1,1],
    [1,0,1,0,0,0,0,1,1,-1,-1,-1,-1,-1,-1,-1,1,1,1,1,1,0,0,0,0],
    [1,1,0,0,1,1,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,1,0,0,1,0,1,1],
    [0,0,1,0,1,0,0,1,1,-1,-1,-1,-1,-1,-1,-1,0,1,1,1,0,1,1,0,1],
    [1,0,1,0,1,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,0,1,1,0,1,0,1],
    [0,1,0,1,1,0,0,1,0,-1,-1,-1,-1,-1,-1,-1,0,1,1,0,1,0,0,1,0],
    [1,1,0,1,0,0,1,1,1,-1,-1,-1,-1,-1,-1,-1,1,1,1,1,1,1,1,0,0],
    [0,0,0,0,0,0,0,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,0,0,1,1,0,0,1],
    [1,1,1,1,1,1,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,1,0,1,1,0,1,1],
    [1,0,0,0,0,0,1,0,0,-1,-1,-1,-1,-1,-1,-1,1,0,0,0,1,1,1,1,0],
    [1,0,1,1,1,0,1,0,0,-1,-1,-1,-1,-1,-1,-1,1,1,1,1,1,1,0,1,1],
    [1,0,1,1,1,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,0,0,0,1,1,1,1,1,1],
    [1,0,1,1,1,0,1,0,0,-1,-1,-1,-1,-1,-1,-1,1,0,0,1,1,0,1,0,1],
    [1,0,0,0,0,0,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,1,0,0,1,0,0,0],
    [1,1,1,1,1,1,1,0,1,-1,-1,-1,-1,-1,-1,-1,1,0,1,1,0,0,0,1,1],
], dtype=int)

DAMAGED_COLS = frozenset(range(9, 16))
KNOWN_PREFIX = b"https://ak.hypergryph.com/"

MASK_TABLE = [
    lambda r, c: (r + c) % 2 == 0,
    lambda r, c: r % 2 == 0,
    lambda r, c: c % 3 == 0,
    lambda r, c: (r + c) % 3 == 0,
    lambda r, c: (r // 2 + c // 3) % 2 == 0,
    lambda r, c: (r * c) % 2 + (r * c) % 3 == 0,
    lambda r, c: ((r * c) % 2 + (r * c) % 3) % 2 == 0,
    lambda r, c: (((r + c) % 2) + ((r * c) % 3)) % 2 == 0,
]


def mask_applies(mask_idx, r, c):
    return MASK_TABLE[mask_idx](r, c)


def demask(val, mask_idx, r, c):
    return 1 - val if mask_applies(mask_idx, r, c) else val


def build_data_order(version, ecc, mask_idx):
    qr = QRCode(version=version, error_correction=ecc, box_size=1, border=0)
    qr.map_data = lambda data, mask: None
    qr.makeImpl(False, mask_idx)

    order, inc, row = [], -1, qr.modules_count - 1
    for col in range(qr.modules_count - 1, 0, -2):
        if col <= 6:
            col -= 1
        while True:
            for c in (col, col - 1):
                if qr.modules[row][c] is None:
                    order.append((row, c))
            row += inc
            if not (0 <= row < qr.modules_count):
                row -= inc
                inc = -inc
                break
    return order


def extract_codewords(matrix, data_order, damaged_cols, mask_idx):
    n = len(data_order) // 8
    cw = bytearray(n)
    erased = [False] * n
    for i in range(n):
        byte_val = 0
        has_erasure = False
        for j in range(8):
            r, c = data_order[i * 8 + j]
            v = matrix[r, c]
            if v == -1 or c in damaged_cols:
                has_erasure = True
            elif demask(v, mask_idx, r, c):
                byte_val |= 1 << (7 - j)
        cw[i] = byte_val
        erased[i] = has_erasure
    return cw, erased


def parse_header(cw):
    mode = cw[0] >> 4
    count = ((cw[0] & 0x0F) << 4) | (cw[1] >> 4)
    return mode, count


def read_data_byte(cw, idx, bit_offset=12):
    lo, hi = bit_offset + idx * 8, bit_offset + idx * 8 + 7
    byte_val = 0
    for j in range(8):
        p = lo + j
        if (cw[p // 8] >> (7 - p % 8)) & 1:
            byte_val |= 1 << (7 - j)
    return byte_val


def decode_readable_bytes(cw, erased, count, bit_offset=12):
    result, lost = [], []
    for d in range(count):
        s = bit_offset + d * 8
        involved = range(s // 8, (s + 7) // 8 + 1)
        if any(erased[i] for i in involved if i < len(erased)):
            lost.append(d)
            result.append(None)
        else:
            result.append(read_data_byte(cw, d, bit_offset))
    return result, lost


def step1(matrix, damaged_cols, version, ecc, mask_idx):
    order = build_data_order(version, ecc, mask_idx)
    cw, erased = extract_codewords(matrix, order, damaged_cols, mask_idx)
    mode, count = parse_header(cw)
    decoded, lost = decode_readable_bytes(cw, erased, count)
    return dict(
        cw=cw, erased=erased, mode=mode, count=count, decoded=decoded, lost_bytes=lost
    )


def cw_data_bytes(cw_idx, bit_offset=12):
    lo, hi = cw_idx * 8, cw_idx * 8 + 7
    first = max(0, math.ceil((lo - bit_offset - 7) / 8))
    last = (hi - bit_offset) // 8
    return range(first, last + 1) if first <= last else range(0)


def extract_bytes(cw, start, n, bit_offset=12):
    return bytes(read_data_byte(cw, d, bit_offset) for d in range(start, start + n))


def step2(cw, erased, prefix, version, ecc, mask_idx):
    count = ((cw[0] & 0x0F) << 4) | (cw[1] >> 4)
    path_len = count - len(prefix)

    blocks = qrbase.rs_blocks(version, ecc)
    total_cw = sum(b.total_count for b in blocks)
    data_cw = sum(b.data_count for b in blocks)
    ec_cw = total_cw - data_cw

    ref = create_data(
        version, ecc, [QRData(prefix + b"X" * path_len, mode=MODE_8BIT_BYTE)]
    )

    inp, erasures = bytearray(total_cw), []
    for i in range(total_cw):
        if not erased[i]:
            inp[i] = cw[i]
            continue
        valid = [d for d in cw_data_bytes(i) if d < count]
        is_prefix = len(valid) > 0 and all(d < len(prefix) for d in valid)
        if is_prefix:
            inp[i] = ref[i]
        else:
            erasures.append(i)

    if len(erasures) > ec_cw:
        raise RuntimeError(f"Too many erasures ({len(erasures)} > {ec_cw})")

    try:
        corrected = RSCodec(ec_cw).decode(inp, erase_pos=erasures)[0]
    except ReedSolomonError as e:
        raise RuntimeError(f"RS decode failed: {e}")

    path = extract_bytes(corrected, len(prefix), path_len)
    return dict(path=path, full_url=prefix + path, erasures=erasures)


def main():
    V, E, M = 2, constants.ERROR_CORRECT_L, 7

    print("=" * 56)
    print(f"  QR 修复  V{V} ECC=L Mask={M}")
    print("=" * 56)

    r1 = step1(QR_MATRIX, DAMAGED_COLS, V, E, M)
    readable = "".join(
        chr(b) if b is not None else f"[{i}]" for i, b in enumerate(r1["decoded"])
    )
    print(f"\n  count={r1['count']}  mode={'Byte' if r1['mode']==4 else '?'}")
    print(f"  readable: {readable}")
    print(f"  erased:   {sum(r1['erased'])}/44 codewords")

    r2 = step2(r1["cw"], r1["erased"], KNOWN_PREFIX, V, E, M)
    print(f"  erasures: {r2['erasures']}")

    print("\n" + "=" * 56)
    print(f"\n  prefix: {KNOWN_PREFIX.decode()}")
    print(f"  path: {r2['path'].decode()}")
    print(f"  URL:  {r2['full_url'].decode()}")
    print("\n" + "=" * 56)


if __name__ == "__main__":
    main()
为什么这篇文章拖了这么久呢 因为我懒
为什么今天又想起来写呢?一时兴起了,一时兴起了