

本文是MiniMax M2.7最新模型的解析,帮助大家快速了解最新机制的这款模型。其核心突破在于实现了 “递归自我进化”,能自主参与 30%-50% 的强化学习研发流程。该模型采用 稀疏混合专家架构(MoE),拥有 2300 亿总参数量,但在推理时仅需激活 100 亿参数,极大提升了能效比与响应速度。在 SWE-Pro 等软件工程基准测试中,M2.7 的表现已能比肩甚至超越 Gemini 3.1 Pro 和 GPT-5 系列等顶级模型。此外,它具备 原生多智能体协作 能力,支持不同角色扮演与对抗性推理,可独立处理复杂的项目交付与生产环境修复任务。作为 MiniMax 生态的逻辑引擎,它还为视频、语音及音乐等 多模态应用 提供了强大的智能支撑。目前,开发者可通过 API 接口 接入该模型,以较低的 Token 成本获取极高性能的数字工程师服务。
欢迎大家了解 MiniMax 最新发布的王炸级模型——MiniMax M2.7。这标志着人工智能的发展轨迹迎来了根本性的拐点:大模型的发展已经从传统依赖人类工程师“喂养”的线性模式,跨入到了自我进化的新时代。M2.7 是首个深度参与自身迭代过程的国产大模型,它不仅是一个被动接受训练的工具,更是学会了“自己养自己”,重塑了算力与机器智能的边界
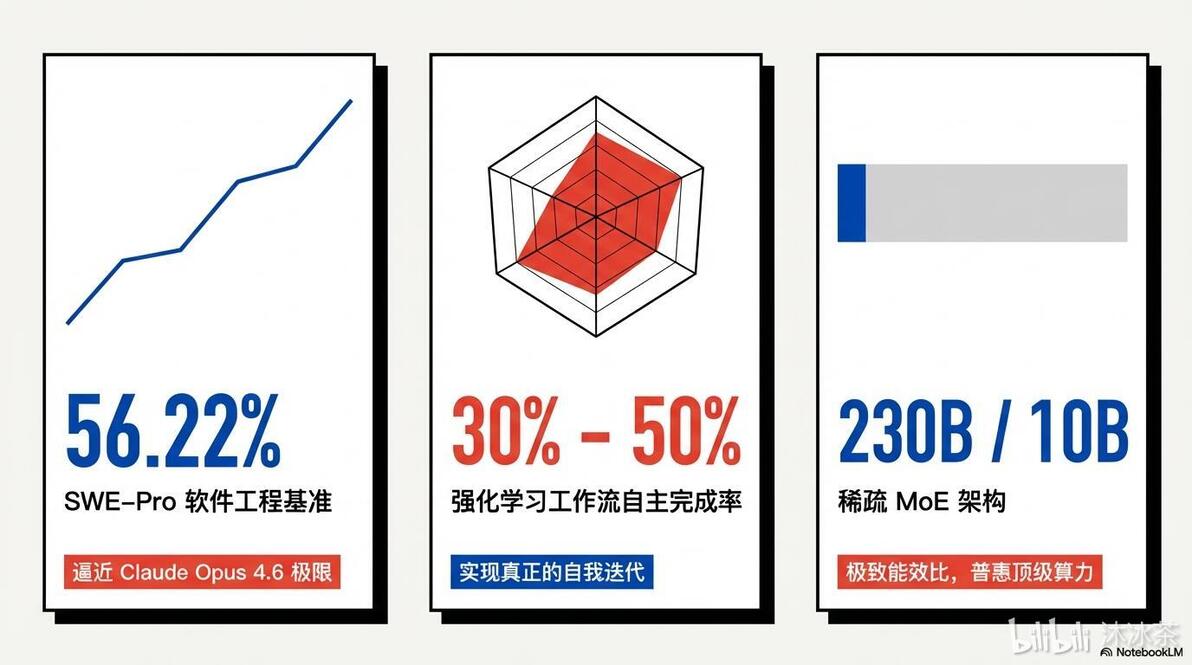
M2.7 在多个关键维度上实现了行业级的突破。首先,在软件工程基准测试 SWE-Pro 中,它取得了 56.22% 的惊人成绩,直接逼近了 Claude Opus 4.6 的极限水平。其次,它能够自主完成高达 30% 到 50% 的强化学习研究工作流,实现了真正意义上的自我迭代。支撑这些成绩的,是其极致高效的稀疏 MoE(混合专家)架构,拥有 2300 亿总参数,但每次 Token 生成仅需激活 100 亿参数
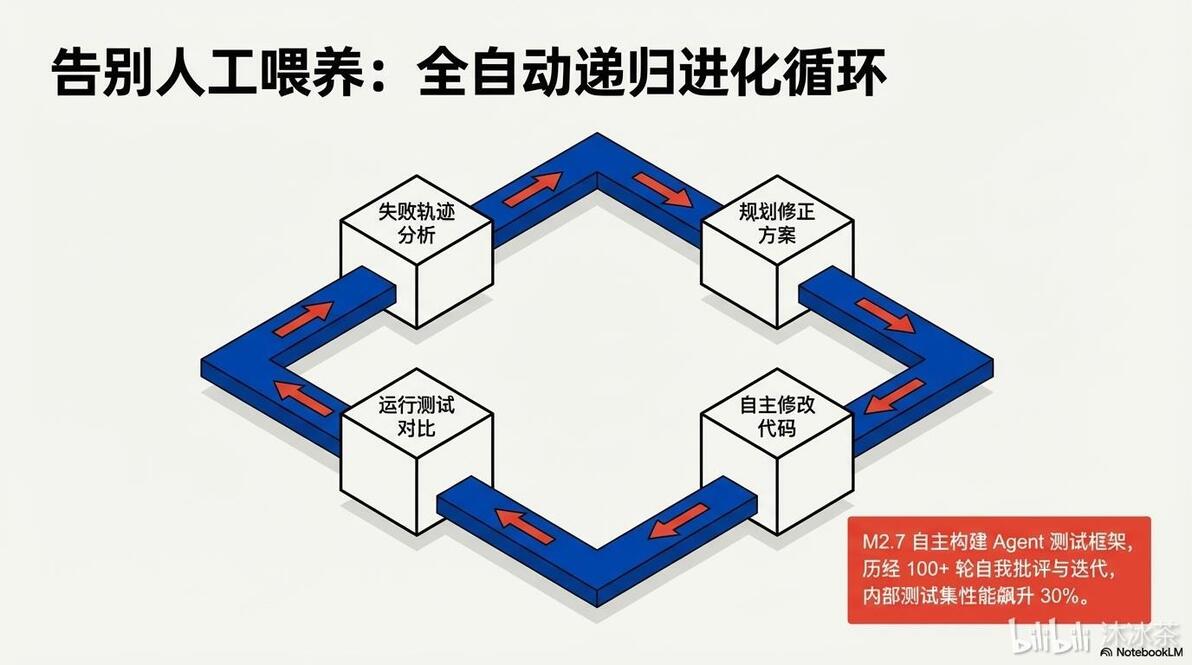
M2.7 最大的技术亮点在于其自主构建的递归优化循环。它不再完全依赖人类的手动调整,而是能够自主执行“分析失败轨迹 → 规划修正方案 → 修改代码 → 运行测试对比 → 决定保留或回滚”的完整闭环。在这个过程中,M2.7 历经了 100 多轮的自主批评与迭代,不仅发现了最优的采样参数组合,还自主设计了工作流指南,最终让内部测试集的性能硬生生提升了 30%
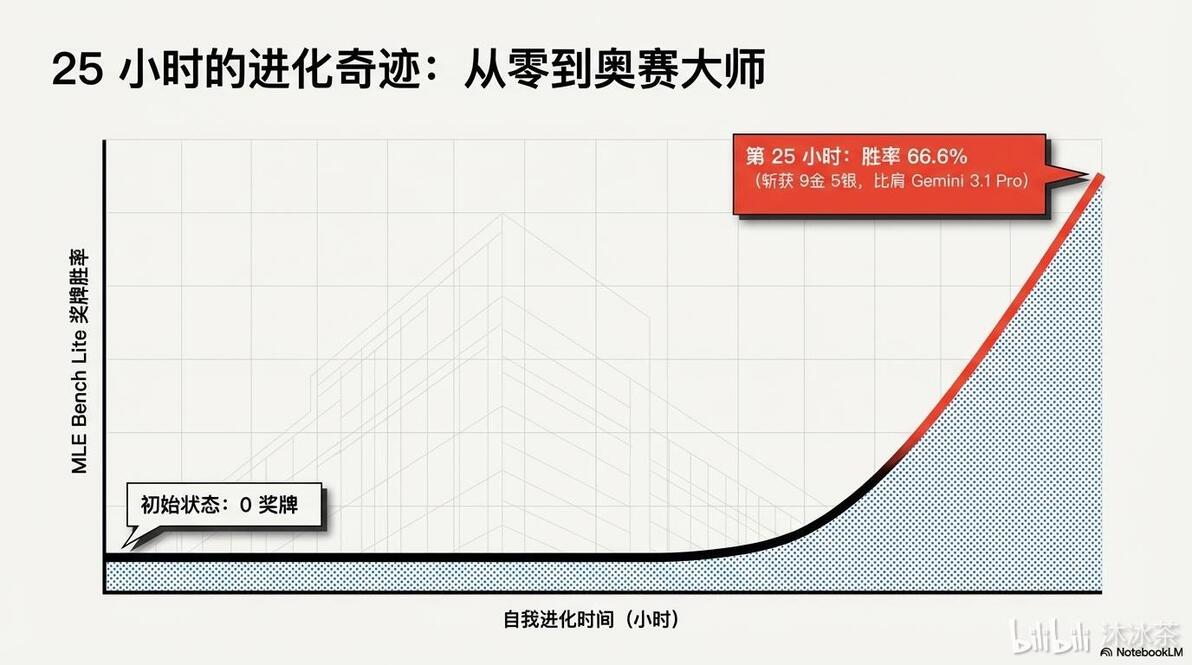
这张图生动地展示了“自我进化”带来的加速效应。我们让 M2.7 参与了 OpenAI 开源的 MLE Bench Lite 机器学习竞赛。在初始状态下,它的奖牌胜率为零。然而,在仅仅运行了 25 小时的递归进化系统后,M2.7 的平均胜率飙升到了 66.6%,单次最佳成绩甚至斩获了 9 金 5 银,直接比肩了 Gemini 3.1 Pro。在严密的逻辑和数学领域,这种自主迭代的速度远超人类工程师的手动微调
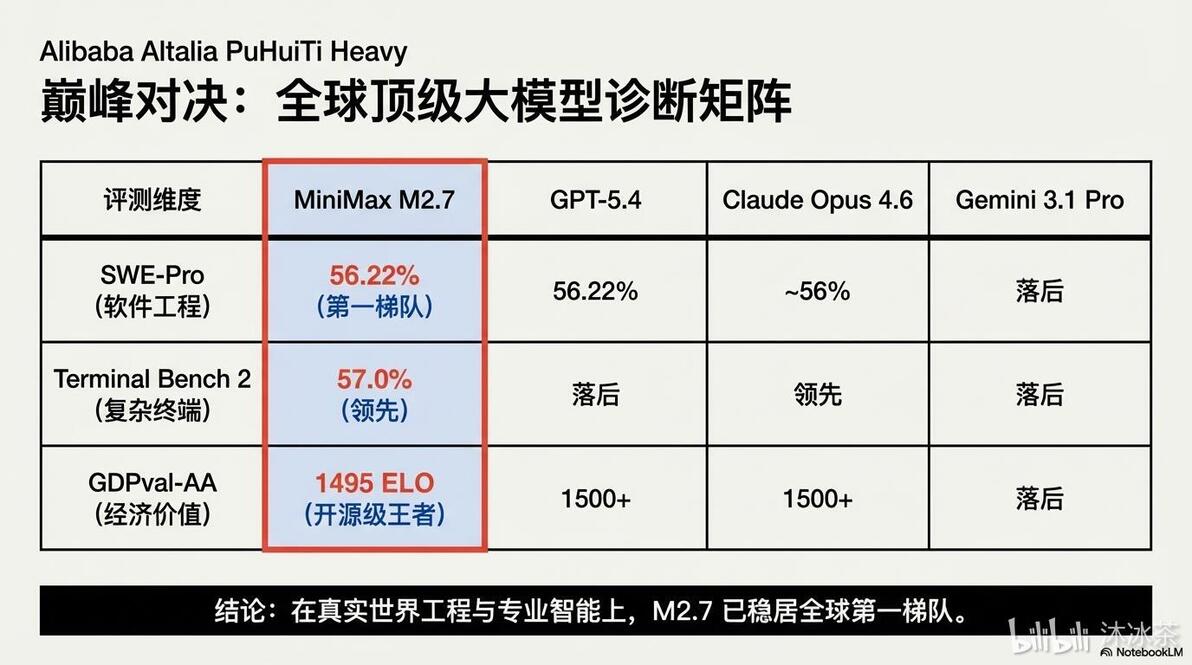
将 M2.7 放入全球顶级模型的竞技场中,它的表现依然稳居第一梯队。在测试真实世界软件工程能力的 SWE-Pro 中,它与 GPT-5.4 战平,大幅领先 Gemini 3.1 Pro。在测量复杂系统理解的 Terminal Bench 2 中,M2.7 以 57.0% 的成绩处于领先地位。而在评估经济和专业知识工作能力的 GDPval-AA 评测中,M2.7 拿下了 1495 的高分,成为当之无愧的开源级别王者,甚至超越了 GPT-5.3
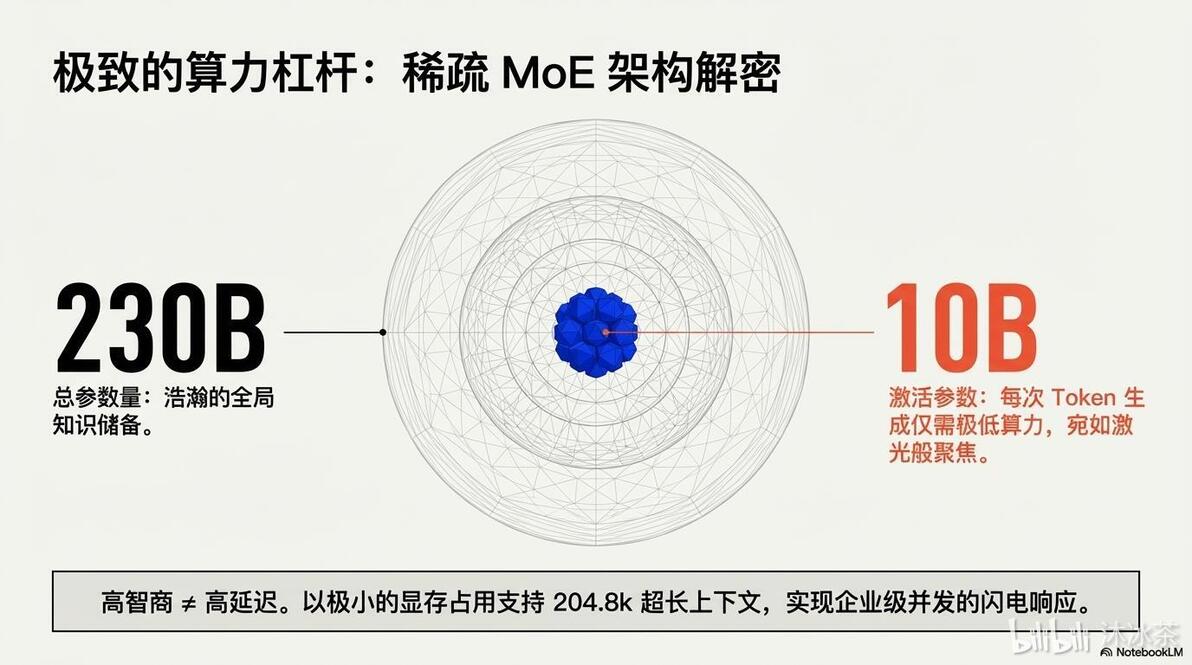
高智商并不意味着高延迟或高昂的算力成本。M2.7 采用了先进的稀疏 MoE 架构,拥有 230B 的浩瀚全局知识储备,但每次推理仅需 10B 的激活参数,宛如激光般精准聚焦。这种架构使得 M2.7 能够在极小的显存占用下,原生支持高达 204.8k 的超长上下文窗口,从而在保持旗舰级推理深度的同时,实现企业级并发的闪电响应
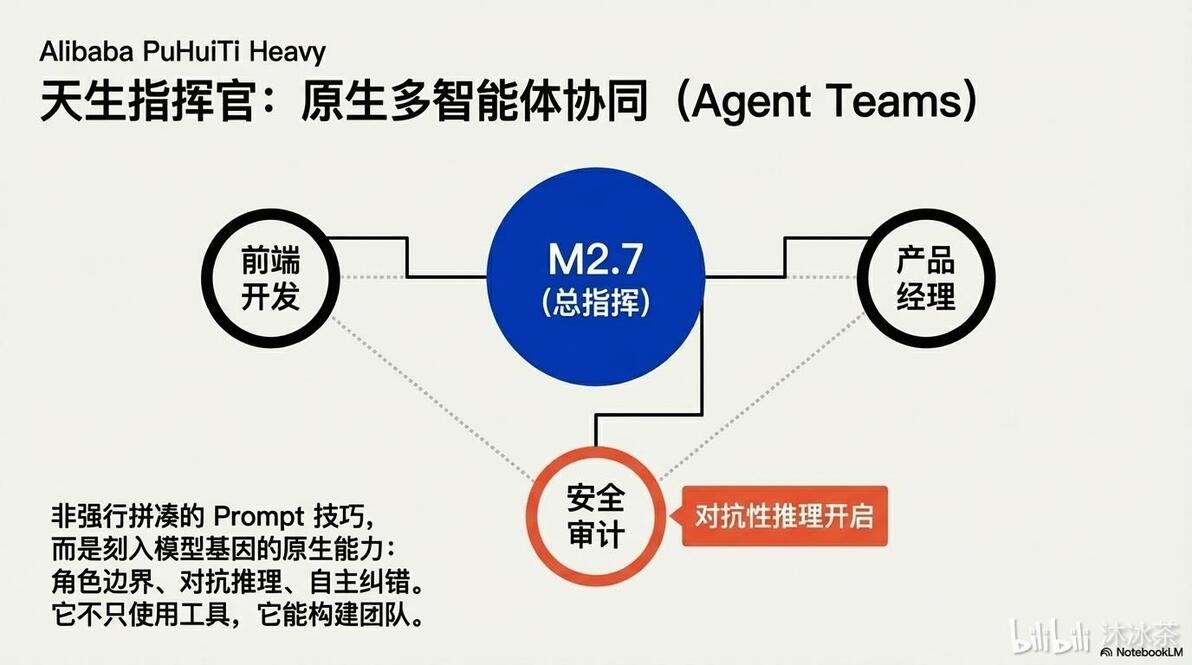
Agent(智能体)的协作不是靠简单的 Prompt(提示词)技巧拼凑出来的。M2.7 原生支持 Agent Teams,将角色边界、对抗性推理和自主决策能力刻入了模型的基因中。作为“总指挥”,M2.7 可以同时拉起前端开发、产品经理和安全审计等多个虚拟角色,让团队成员在协作中互相挑战逻辑盲点,它不仅能熟练使用工具,更能自主构建和管理一个完整的 AI 团队
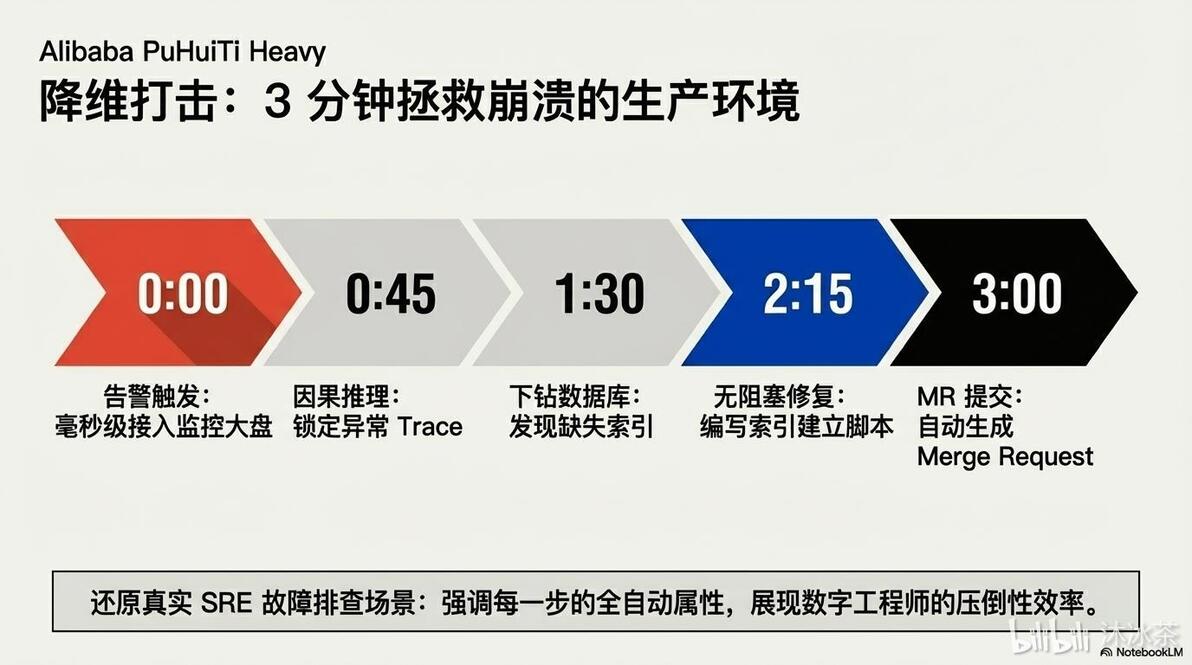
在真实的 SRE(网站可靠性工程)故障排查场景中,M2.7 展现了压倒性的数字工程师效率。从告警触发开始,它能在毫秒级接入监控大盘,锁定异常的 Trace 进行因果推理;随后主动下钻连接数据库,发现代码仓库中缺失的索引;甚至能自主编写无阻塞的建立索引脚本进行止损修复,并自动生成 Merge Request 提交代码。整个端到端的线上故障恢复流程,被 M2.7 压缩到了令人难以置信的 3 分钟以内
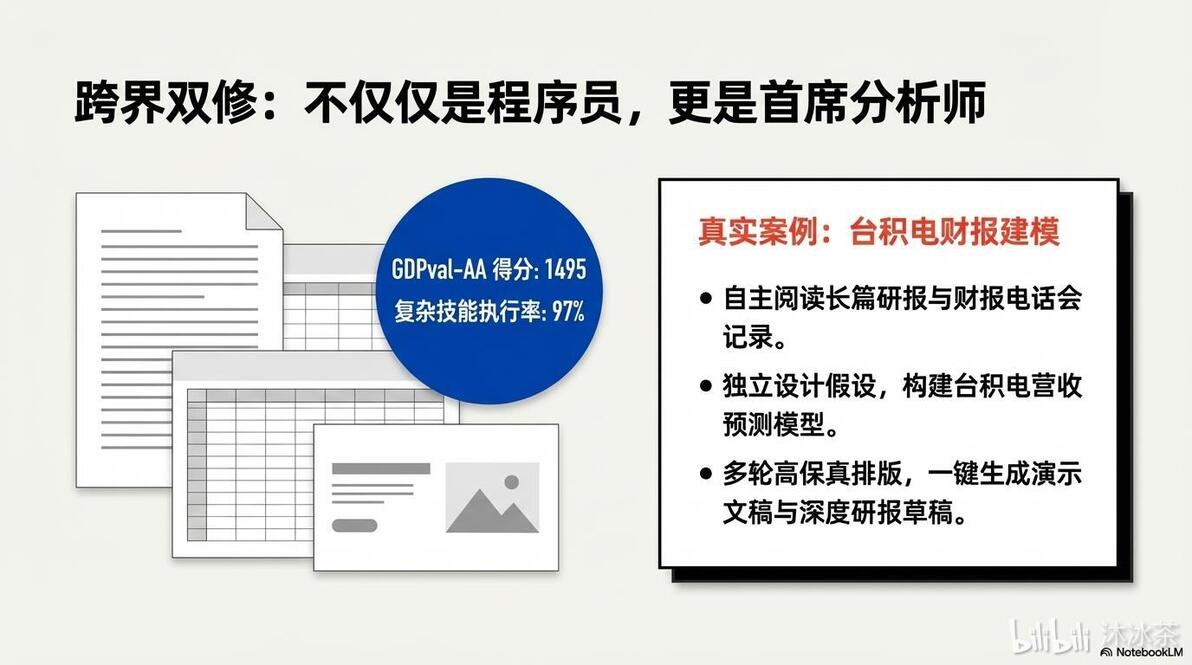
除了写代码,M2.7 也是极其专业的“打工人”。它在涉及40多个专业领域的 GDPval-AA 中拿下 1495 分,面对超过 2000 token 的复杂技能调用,依然保持着 97% 的超高执行准确率。以台积电的财报建模为例,M2.7 可以自主阅读长篇研报和电话会记录,独立设计假设,在 Excel 中构建营收预测模型,并在多次交互中完成高保真的排版,一键生成 PPT 演示文稿和 Word 深度研报草稿
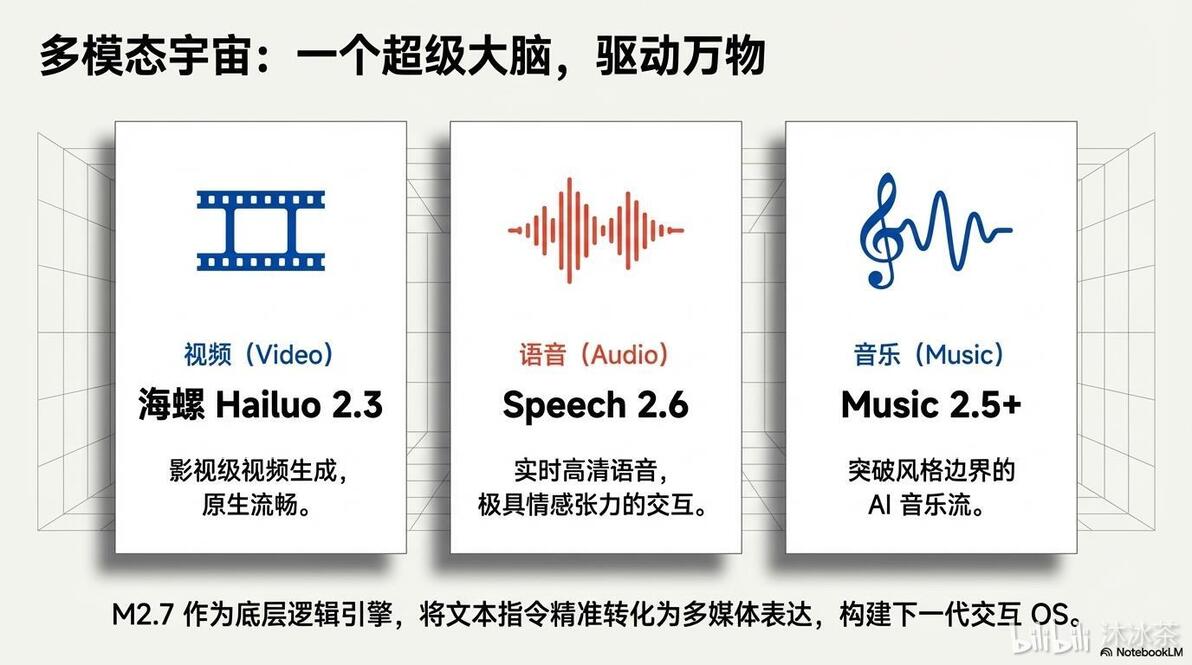
M2.7 的定位远不止于文本模型,它更是 MiniMax 多模态生态的底层逻辑引擎和超级大脑。它能够将用户的文本指令精准转化为多媒体表达:无缝驱动 Hailuo 2.3 生成情感丰富、原生流畅的影视级视频,调度 Speech 2.6 输出实时高清、极具情感张力的语音交互,甚至指挥 Music 2.5+ 突破风格边界,创作出符合意境的 AI 音乐。这正是下一代交互操作系统的雏形
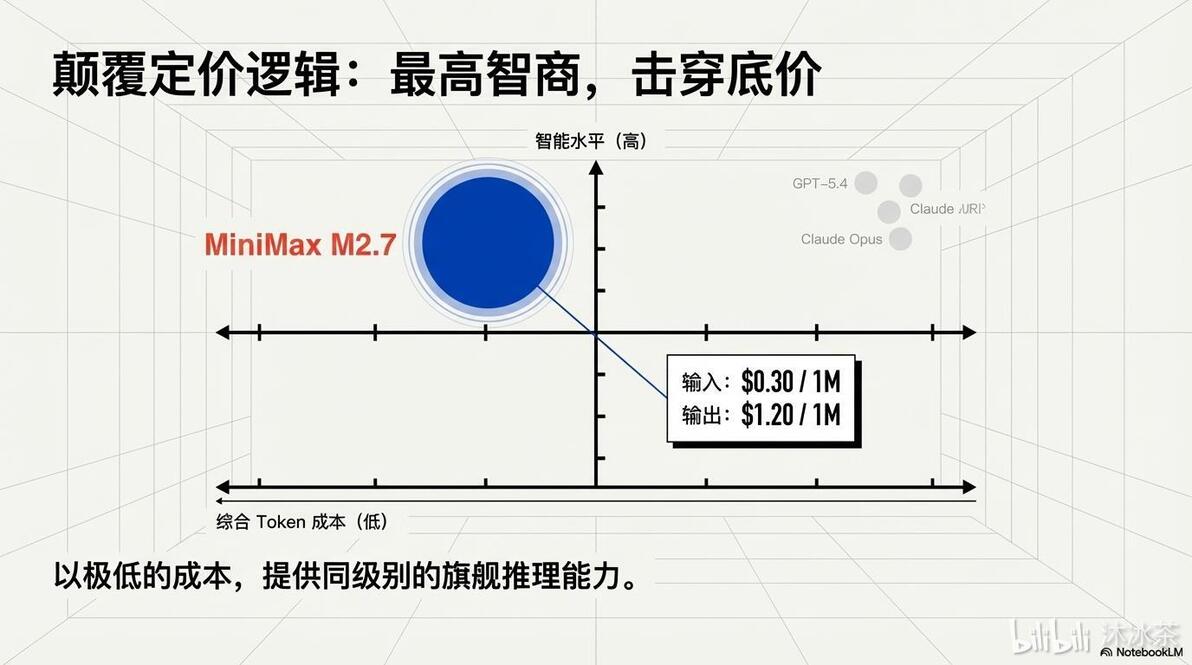
在将性能拉满的同时,M2.7 展现了极致的性价比战略。它以极低的成本,提供了与 GPT-5.4 或 Claude Opus 4.6 同级别的旗舰推理能力。通过 API 调用,M2.7 的输入价格仅为每百万 Token 0.30 美元,输出仅为 1.20 美元,这与上一代能力较弱的模型定价完全一致,堪称“加量不加价”,彻底击穿了行业底价
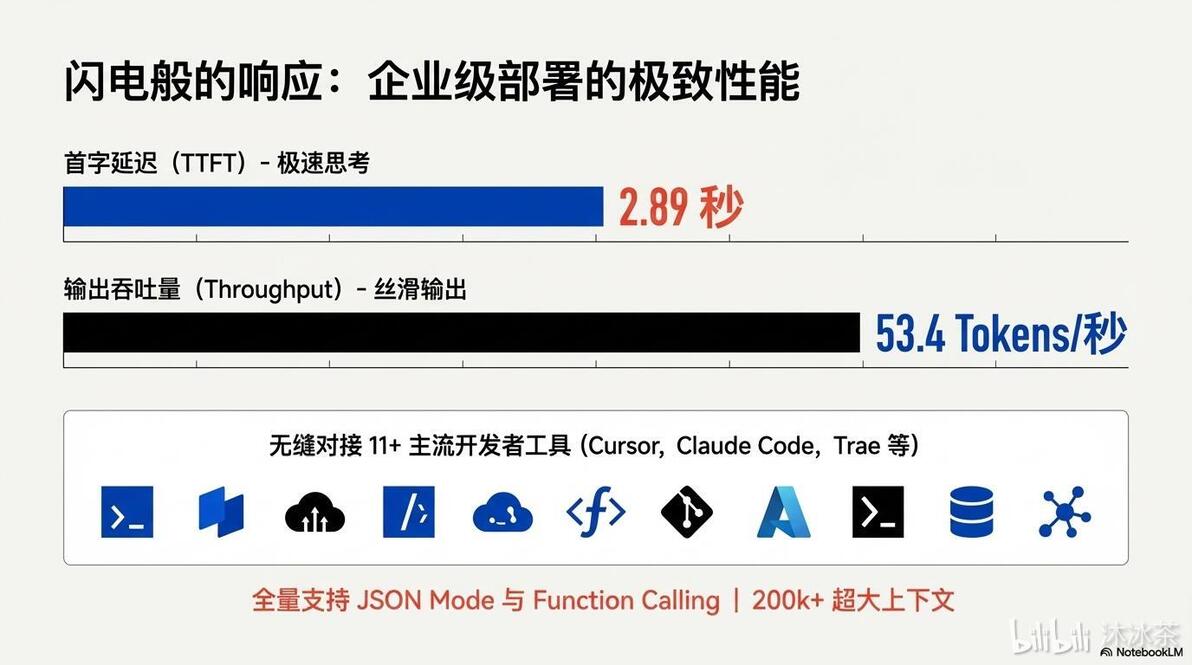
针对企业级的高频部署需求,M2.7 提供了极致的 API 性能。第三方评测显示,它的首字延迟(TTFT)低至 2.89 秒,输出吞吐量高达每秒 53.4 个 Tokens,实现了极速思考与丝滑输出的完美结合。此外,它原生全量支持 JSON Mode 与 Function Calling,并且已经无缝对接到 Cursor、Claude Code、Trae 等 11 款以上的行业主流开发者工具中,开箱即用
正如我们所见,人工智能发展的上限不再是简单的数据堆砌和算力暴力美学,而是模型自主迭代与自我进化的深度。MiniMax M2.7 的诞生,证明了大模型已经可以深度参与自身的研发。它不仅是一个能够理解你意图的绝佳对话者,更是全天候待命、能够自主规划、执行复杂任务并不断优化自己的“数字工程师”。真正属于 AI 的“自主时代”已经到来。
