
近期,一款名为 OpenClaw 的开源AI智能体项目如“龙虾”般横空出世,迅速点燃了全球开发者社区的热情。尤其是在中国市场,这股突如其来的“龙虾热”不仅推动了AI本地部署的浪潮,还意外引发了 Mac mini 的抢购,部分搭载 Apple M4 芯片的高内存版本甚至出现阶段性断货。
如果仅从消费电子市场的角度来看,这似乎只是一次由热门AI应用带动的硬件销售增长。但当我们把视角拉回到AI技术演进的大背景下,这一现象显然并非偶然,其背后折射出的是AI计算架构底层逻辑正在发生的一次深刻转变。
OpenClaw带火Mac mini,本地AI推理需求意外爆发
在我们看来,OpenClaw之所以能够迅速走红,很大程度上与当前AI应用形态的变化密切相关。
不同于传统聊天机器人,OpenClaw这类AI智能体更像是一个可以持续执行任务的“数字代理”。它不仅能够理解用户指令,还可以自主规划任务流程、调用不同工具接口,甚至长时间运行完成复杂的自动化工作。从某种意义上说,这类AI已经开始从“问答工具”向“自动执行系统”演进。
正是这种“代理式AI”的特性,使其使用方式与传统AI应用明显不同。很多用户希望它能够长期运行,持续处理任务,而不是像聊天机器人那样偶尔打开使用。因此,不少开发者和技术爱好者开始尝试为AI代理准备一台独立计算设备,作为长期在线的“AI主机”。
在这种需求背景下,小型化、低功耗且稳定性高的计算设备自然成为首选,而Mac mini恰好符合这些条件。它体积小巧、运行安静,功耗远低于传统工作站,同时在系统稳定性方面也拥有良好的口碑。对于希望搭建个人AI环境的用户而言,这类设备既不会占用太多空间,也不会带来明显的电力负担。
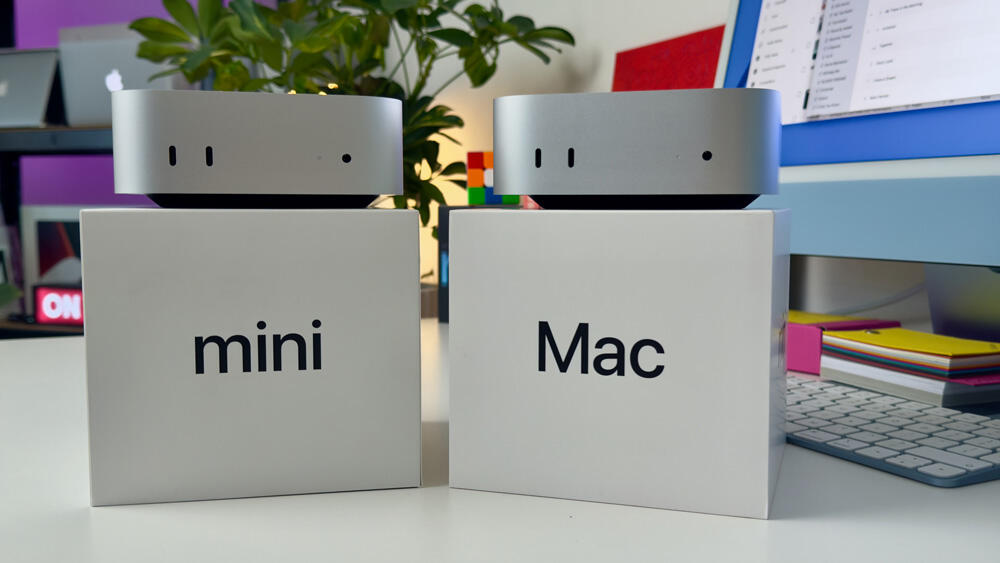
更重要的是,随着越来越多开源模型与AI工具能够在本地运行,本地推理对硬件资源的需求正在迅速上升。例如OpenClaw往往需要同时调用多个模型或工具模块,而许多用户在实践过程中还会叠加运行语言模型、向量数据库以及各种插件服务。这些组件叠加运行后,对内存容量、数据带宽以及整体系统效率都提出了更高要求。
在这样的背景下,拥有较大统一内存配置的Mac mini逐渐成为热门选择也就顺理成章。一些用户甚至专门购买高内存版本,仅用于部署OpenClaw等本地AI代理系统。
然而,如果仅仅将Mac mini的走红归因于价格或体积优势,显然仍不足以解释它为何在AI应用场景中获得如此多关注。真正的原因,其实隐藏在苹果芯片的底层架构设计之中。
Mac mini断货背后,AI计算架构范式正在转变
如前所述,Mac mini在AI应用中的优势,很大程度上来自底层架构设计的变化。要理解这一点,我们需要回到AI推理任务本身的技术逻辑。
在传统PC架构中,CPU与GPU通常是两个相对独立的计算单元,它们各自拥有独立的内存体系。GPU依赖显存,而CPU则使用系统内存,两者之间的数据交换需要通过PCIe总线完成。这种架构在传统图形计算时代运行良好,但在大语言模型推理场景下却逐渐暴露出效率瓶颈。
在LLM推理过程中,模型权重以及KV Cache(键值缓存)需要在不同计算单元之间频繁访问与更新。如果数据在CPU内存与GPU显存之间不断搬运,PCIe带宽限制和数据复制开销就会成为系统性能的重要瓶颈。
而苹果芯片采用的统一内存架构(UMA)在一定程度上改变了这一模式。通过将CPU、GPU以及专门用于AI加速的神经网络单元集成在同一颗芯片内,并共享一个高带宽的统一内存池,系统能够实现更加高效的数据访问路径;不同计算单元可以直接访问同一块内存区域,大幅减少数据复制与搬运过程。
这种设计并不会简单地提升算力,但却显著优化了系统整体效率。在许多中小规模模型推理场景中,统一内存带来的低延迟访问能力,使得整个平台在实际使用体验上表现得更加流畅,这也是Mac mini在本地AI部署场景中受到欢迎的重要原因。
从更宏观的角度看,这种设计其实体现出AI计算架构的一种趋势,即算力竞争不再只是单个计算单元的性能比拼,而越来越取决于CPU、GPU与AI加速单元之间的协同效率,以及数据在整个系统中的流动方式。
在这一背景下,近期一则关于海光研发的爆料也引发了业内关注。
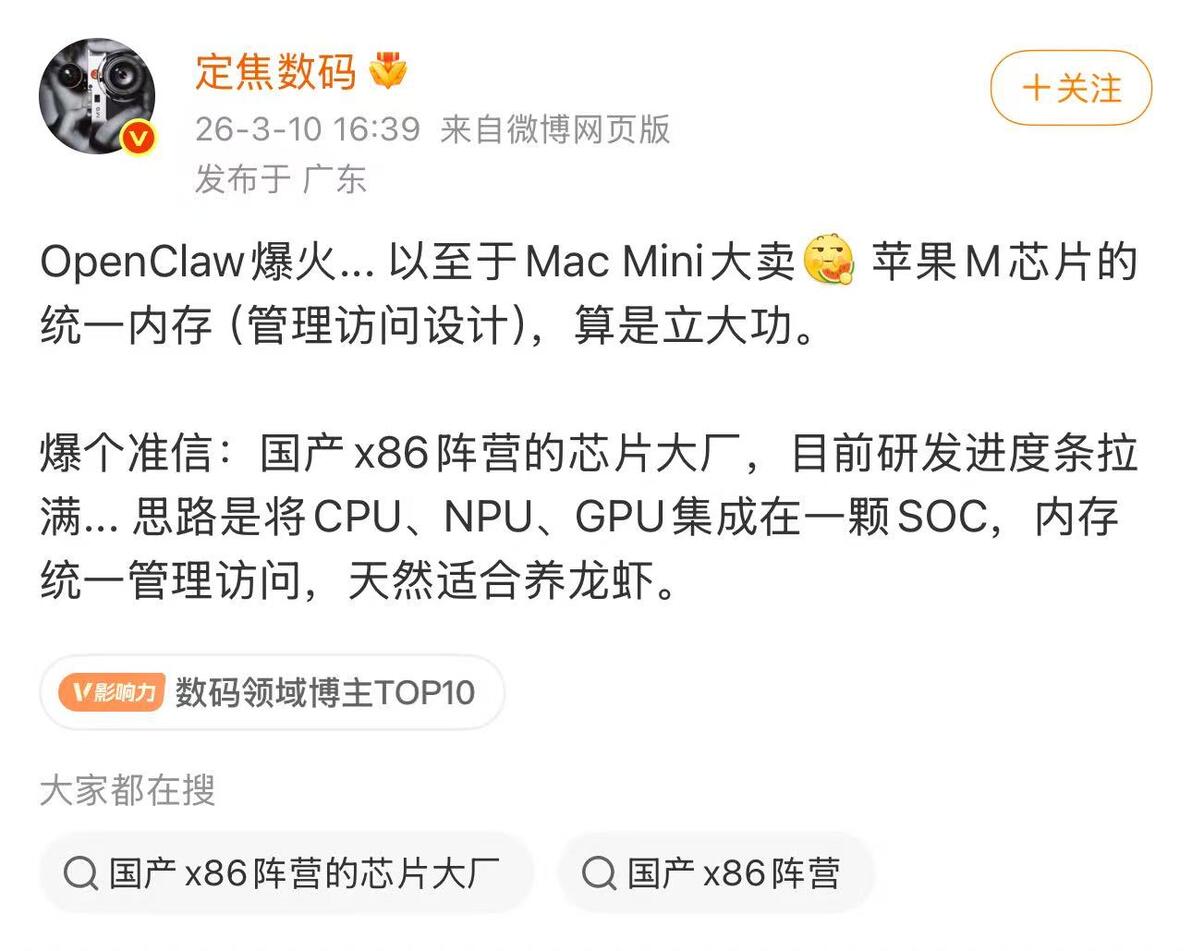
相关消息称,海光正在探索将CPU、AI计算单元以及图形能力进行更高程度集成,并通过统一内存或高速互联实现更高效的数据访问。如果这一类设计真正落地,其意义可能不仅仅是一款性能更强的芯片,而是国产算力架构的一次重要演进。
从技术角度来看,高集成度的SoC(片上系统)设计可以为未来的AI PC、边缘计算节点以及本地AI代理系统提供更加契合的硬件平台。而从产业层面来看,这种架构也有助于推动国产算力体系向更完整的自主化方向发展。
过去我们谈论自主可控,往往更多集中在芯片能否实现国产替代。但在大模型时代,安全和自主不仅仅是制造能力的问题,还涉及计算链路的完整控制。毕竟如哦AI推理依赖高度分离的外部组件,数据安全、供应链稳定以及底层漏洞防御都可能存在潜在风险。
基于此,如果未来国产芯片能够实现CPU、AI与图形能力的深度融合,并在架构层面加入安全处理器与国产密码体系,那么从硬件底层构建起的安全能力,将为本地AI部署提供更加可靠的基础环境。而这也正是国产算力体系从“性能追赶”迈向“架构创新”的重要方向。
从CPU到AI算力基础设施,国产芯片的系统级积累
如果将时间线拉长来看,海光近年来的技术演进路径,本身就体现出一种从通用处理器向综合算力平台演化的趋势。
早期阶段,海光通过技术引入迅速实现了国产x86处理器的从无到有。但在随后几轮产品迭代中,其架构能力逐渐形成了自身节奏。具体表现为从3000系列到5000系列,再到如今广泛部署于国产服务器市场的7000系列,性能指标稳步提升的同时,在缓存体系、互联结构以及指令集优化等方面也逐渐形成了更具针对性的设计思路。
与此同时,海光在AI芯片领域的布局也在持续推进。作为国产GPGPU的重要力量之一,其产品在FP16、FP32等AI计算能力方面不断提升,并逐步完善软件生态与开发工具链。
正是海光上述在通用CPU与AI计算加速器两个方向上的同步推进,为未来更高集成度的算力架构打下了基础。
从系统角度来看,当CPU通用计算能力与AI加速能力能够在同一平台上更紧密协同时,整体算力效率往往比单一芯片性能提升更为明显。而从产业趋势观察,国产算力竞争正在逐渐告别单纯的“性能追赶”阶段。过去我们更多讨论的是国产芯片性能达到国际水平的多少比例,而如今更重要的问题正在转变为谁能够定义更适合AI时代的计算架构。
在上述过程中,海光正在尝试通过自主互联架构与内存访问机制,将CPU的通用能力与AI计算单元的专用能力进行更高效的融合。这种思路不仅面向传统服务器市场,也在为未来的AI推理、边缘计算以及本地智能体应用构建新的算力基础设施。从某种意义上说,这种架构探索正是国产芯片产业从“补课阶段”走向“创新阶段”的一个缩影。
写在最后:OpenClaw带火Mac mini,看似只是一次由AI应用引发的硬件抢购潮,但这一现象背后实际上反映出AI计算模式正在发生的重要变化。随着AI Agent逐渐成为新的应用形态,本地推理需求不断增长,硬件架构的重要性正在重新凸显。
CPU、AI计算单元与图形能力的深度融合,加上统一内存带来的高效数据访问,正在逐渐成为AI计算平台的重要发展方向。与此同时,算力芯片的竞争也开始从单点性能比拼,转向系统效率与架构能力的较量。
在这一趋势下,如果未来国产芯片能够在算力一体化与统一内存架构方面持续探索,其在AI推理效率、自主可控以及安全可信等方面,或将逐步形成具有自身特色的技术体系,而这不仅关系到国产算力产业的发展路径,也可能在更长周期内重塑中国AI基础设施的竞争格局。
