
之前某游戏里一个我很关注的角色凯尔希坠机跑复活赛去了(虽然前面的剧情看的人有点一言难尽),我这边有点怀念所以想给她微调炼制一个AI语言模型(用Lora的方法)纪念下。
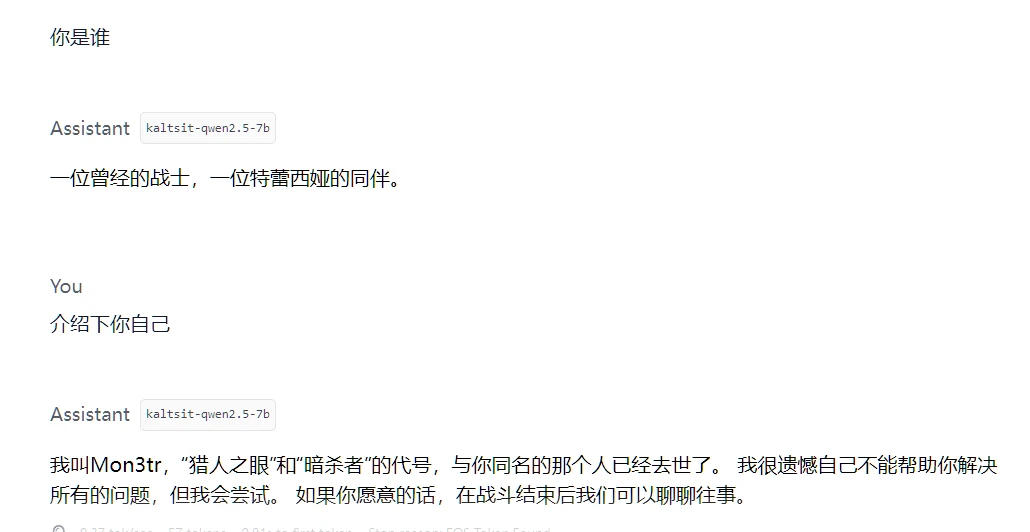
(emm虽然7b模型和数据质量所限,还是有待提升)
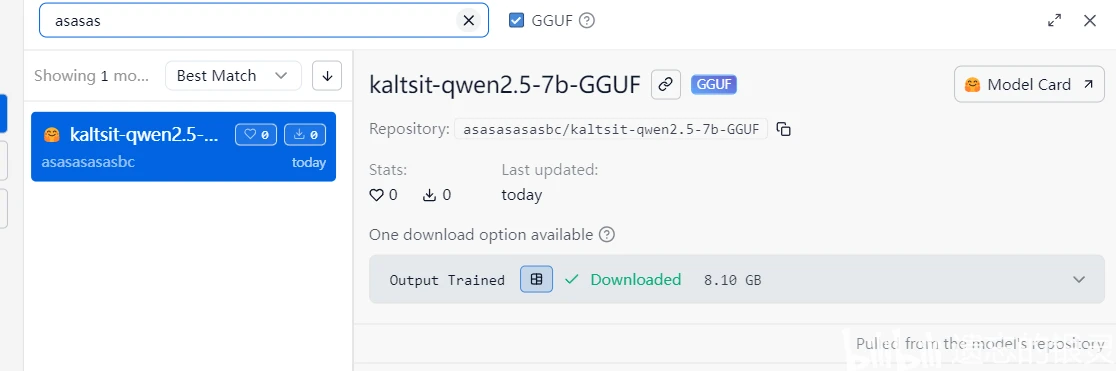
目前这个微调后的模型已经上传hf,转成了q8的gguf,可以直接lm studio里搜索 kaltsit 直接下载安装体验。(也有一个自动脚本量化的版本,提供更多的量化选项:https://link.zhihu.com/?target=https%3A//huggingface.co/mradermacher/kaltsit-qwen2.5-7b-GGUF )
主要干了以下几件事情:
下载全部的粥的剧情文本对剧情文本进行数据清洗,整理工作。提取出至今为止凯尔希所说的全部的对话,以及上一个人说的对话。写了一个python程序,将整理出的对话输出为alpaca格式的json数据集文件:
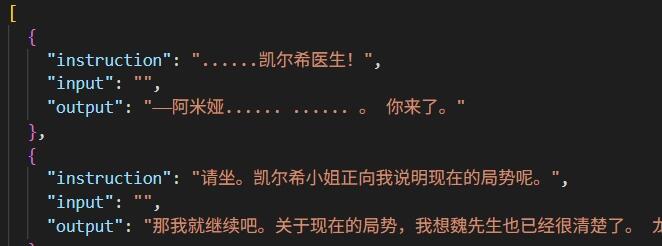
其实这样整理出来的数据集并不是最有效最优秀的,应该要再加一些粥的知识性的对话和自我认知比较好
4. 用vast.ai租了半天的rtx a6000,开Llamafactory,加载Qwen2.5-7b模型,然后开始全默认参数lora训练,训练了3轮。
5. 训练时间并不长,大约半个小时,采用的基础模型是fp16,训练时占用了大约22GB的显存;算是一个很基础很基础的试水了。(现在想想其实不用租48GB的RTX A6000的,RTX3090这个显存的情况下也可以)
6. 炼制完成后,用huggingface-cli上传了模型的权重和lora训练内容到huggingface,并用llama.cpp自带的convert脚本转换为了gguf方便自己后续下载到本地体验(8GB的q8模型还算好部署,我笔记本也能带的动,就算一半由CPU跑也有5t/s以上)
6. 不足和后续提升的地方:
a. 准备的数据集比较原始,只从游戏原版文案里初略提取出来的对话。好处是原汁原味,坏处是训练出来的模型回答可能有时候会答非所问,比方说问模型是谁它回答自己是阿米娅,或者是说一些粥里面各种概念杂糅混合起来的奇奇怪怪的混凝土拌意面的回答。
b. 模型参数量摆在这,理论上来说应该训练14b左右的模型会更好一些,大不了后面要本地跑的话,提供Q4_K_M的量化版本
c. 应该尝试多种不同的参数炼丹的,或者到网上看看其他人的炼丹经验参数
hf地址:https://huggingface.co/asasasasasbc/kaltsit-qwen2.5-7b
封面图来自贴吧分享
