
一、序言
PonyXL已经出了一年了,作为一个目前可以与SDXL模型分庭抗礼的模型类型,我觉得有必要把我对于它的使用经验来分享一下。(无偿分享,谢绝洗稿)
体力回满 + 暂时性伤害上升
二、关于模型
Pony与PonyXL模型是一些小马爱好者们共同烧钱训练出的一个开源Diffusion模型,目前的版本是V6,训练周期大概是三个月。此模型专门用来生成插画漫画,使用自己的一套出图规则,且拥有庞大的独立社区。
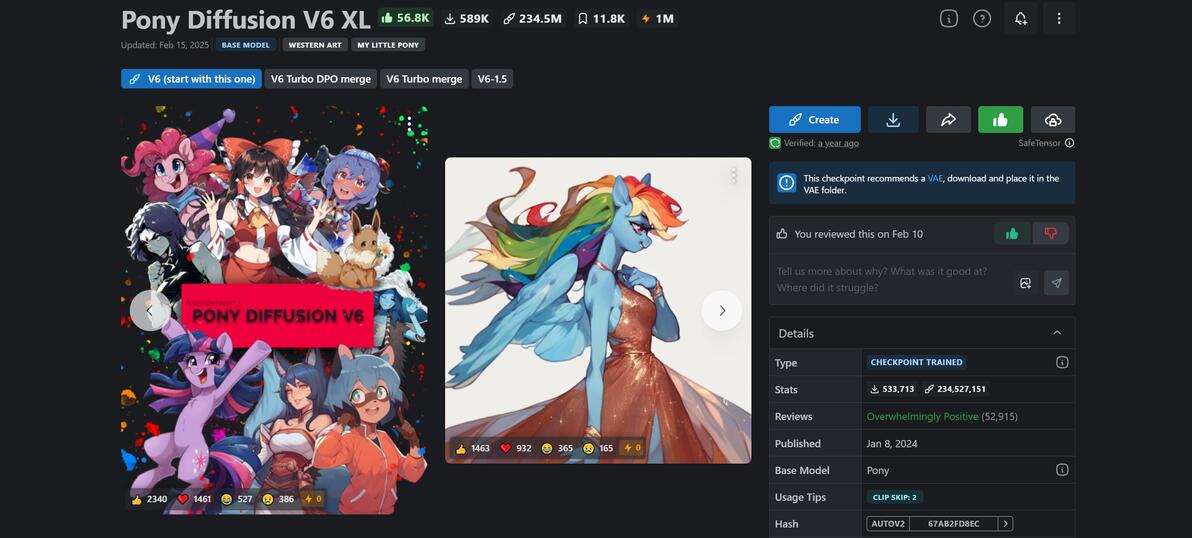
图注:Pony Diffusion V6 XL, CivitAI, 2025
CivitAI模型:https://civitai.com/models/257749/pony-diffusion-v6-xl
存放位置:[ComfyUI根目录]/models/checkpoints
作者网站:https://purplesmart.ai/
Discord:https://discord.com/invite/pYsdjMfu3q
作者为了方便训练和分类,使用评分制的方法来打标签,但由于AI模型本身无法理解什么是“优质图像”,容易将“更受欢迎的”与“真正好的”东西弄混,所以作者亲自为2万张训练图人工打分,其中可能会对画面与技法的美术内容产生人工偏见,这一点需要注意。
警告:PonyXL模型对于NSFW(Not Safe For Work)的分词内容有着独到的深厚理解,比重极高,同样拥有偏见,在使用正常提示词时有时也会出现限制级内容,如需展示则要多加小心,使用者需要为出图负责,不推荐在类似Liblib的非本地平台上使用。(XXX!)

三、搭建最基础的Pony工作流
PonyXL模型在ComfyUI中的工作流与XL模型类似,唯一不同点是必须要为分词器CLIP设置CLIP停止层(CLIPSetLastLayer),值恒为-2,不得调整。
潜空间Latent大小与XL一致,采样步数在26~38步之间比较合适,CFG可变,采样器推荐euler_ancestral、dpm++2msde、ddpm,调度器karras与normal皆可。

图注:基础工作流
如前文所述,作者为训练图亲自打分,所以在模型推理时也可以使用这些评分词:
score_9, score_8_up, score_8, score_7_up, score_7, score_6_up, score_6, score_5_up, score_5, score_4_up, score_4, score_4/5,
最高为9分,最低为4分,评分越高的提词可能会有更好的出图效果,不推荐只使用一个评分词,我们可以为评分词设置一个范围,例如score_9, score_8_up, score_8, score_7_up, score_7, score_6_up作为正向提示词,score_5, score_4_up, score_4, score_4/5作为负向提示词,模型的随机范围会更加自由。
使用评分词后,就不需要继续加入其他质量提示词了,类似masterpiece, high quality之类,但是也可以写,收效甚微,但是至少有效。
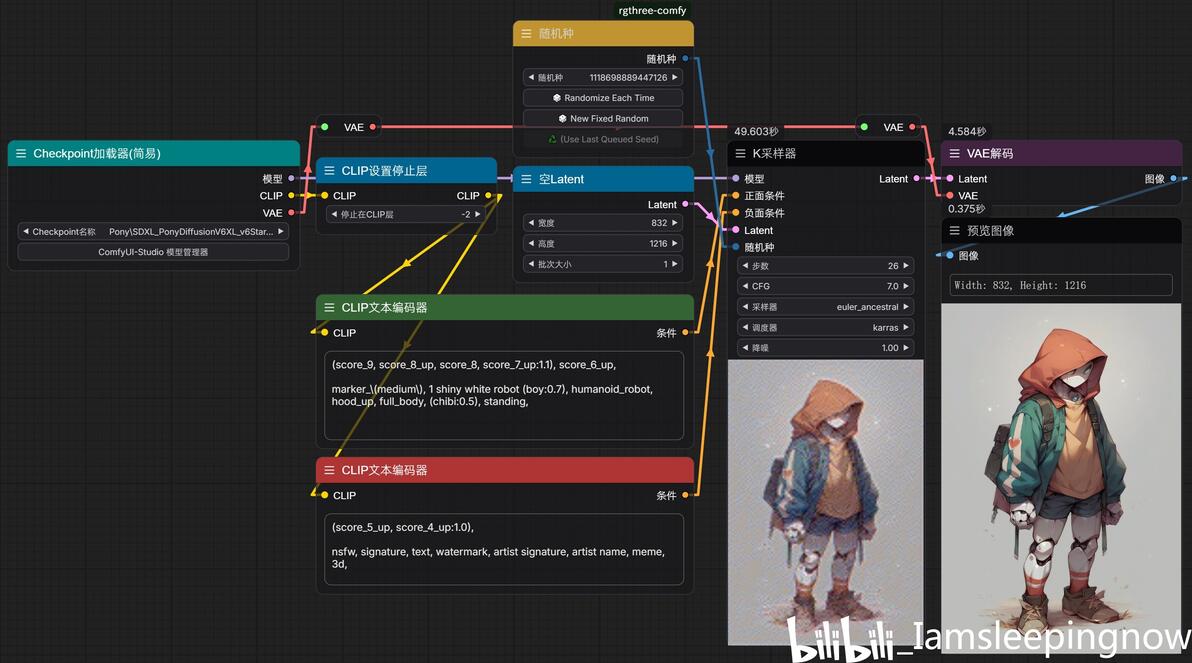
图注:加入评分词(score_9……)
除了评分词之外,作者还设置了一些特殊的风格偏见提示词,例如:
source_pony, source_furry, source_cartoon, source_anime,
以及审查提示词:
rating_safe, rating_questionable, rating_explicit,
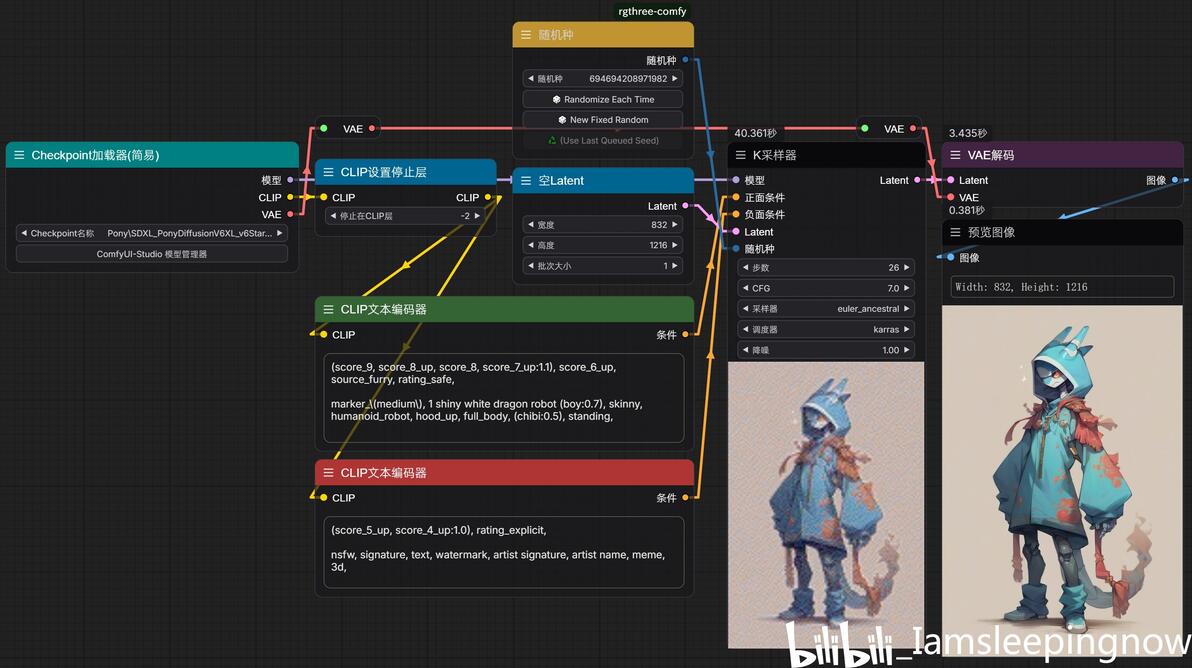
图注:加入风格词和审查词(source_furry, rating_safe)
这次我使用ComfyUI-Easy-Use插件中的管线节点来搭建管线工作流,使用管线节点的必要性我在之前的专栏中已经说明过了:
插件:ComfyUI-Easy-Use: https://github.com/yolain/ComfyUI-Easy-Use
在编排管线之前,我需要先对提示词的编辑窗口做一个分类优化。(这一步不是必要的,只是个人习惯)
首先,我们需要知道PonyXL输入的提示词可以分为几个类型:Pony专属提示词(Pony Prompt)、普通提示词(Prompt)、LoRA模型触发词(Trigger Prompt)、Embedding模型提示词(Embedding Prompt)。
将四个字符串节点使用英文逗号“,”连接,然后接入CLIP编码器。这里使用了插件Advanced CLIP Text Encode的编码器,优点是方便修改插值方式。
插件:Advanced CLIP Text Encode: https://github.com/BlenderNeko/ComfyUI_ADV_CLIP_emb
最后按ctrl键拖选这些节点,在非节点的地方右键 -> 转换为节点组,将其命名为Pony CLIP Batch Encoder。
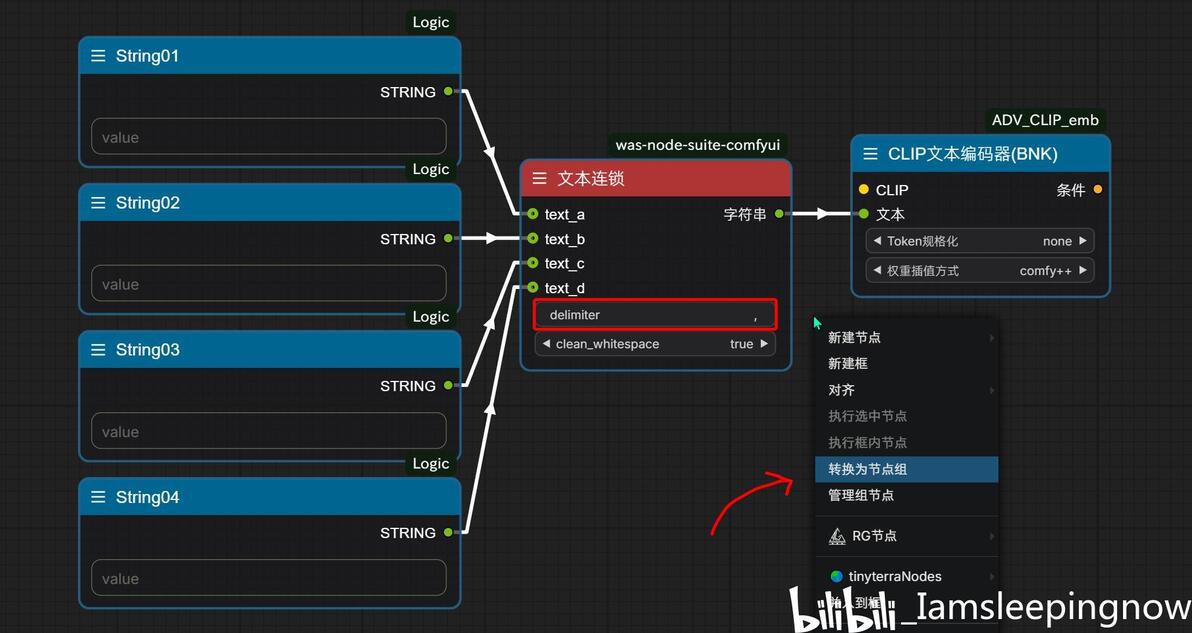
在非节点的地方右键 -> 管理组节点,编辑一下该节点中的每一个子节点的输入输出端口,然后在组件菜单中修改一下参数的显示名称,最后点击保存按钮。

这个自制的组节点就可以做到一个提示词分类的效果,还是比较赞的。
当然,这些文本框不一定只能写里面限定的提示词,可以为了排版方便来随时调整。

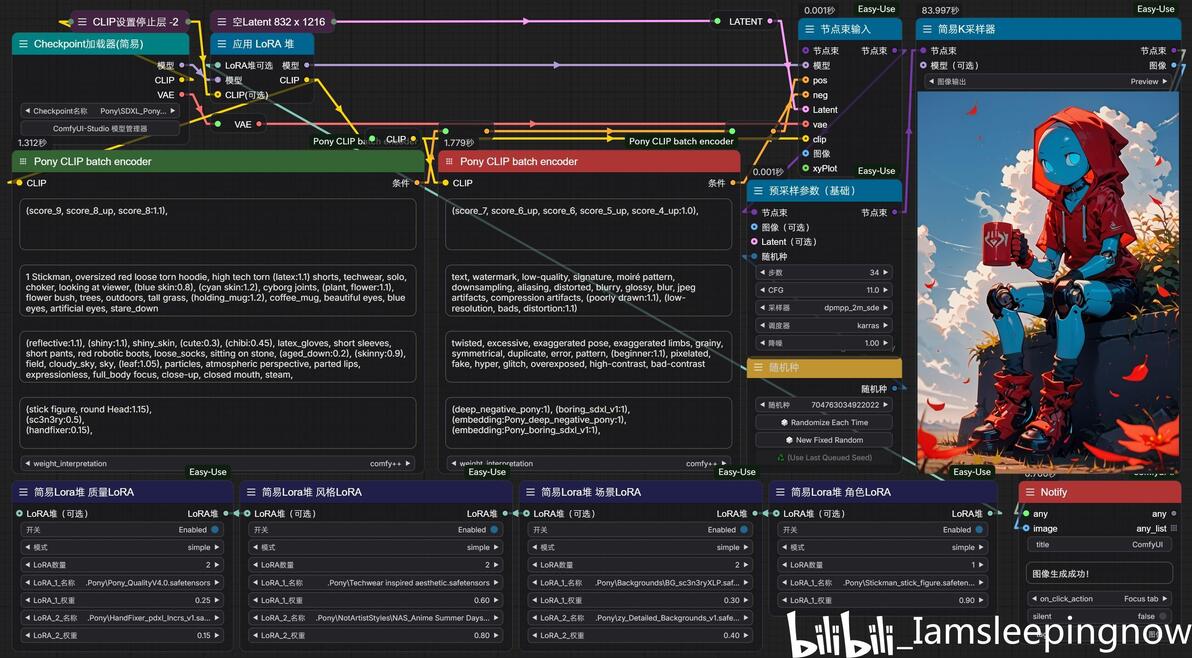
稍微修改一下目前的工作流,把刚刚的组节点放进去,然后将采样器换成EasyUse的采样器。
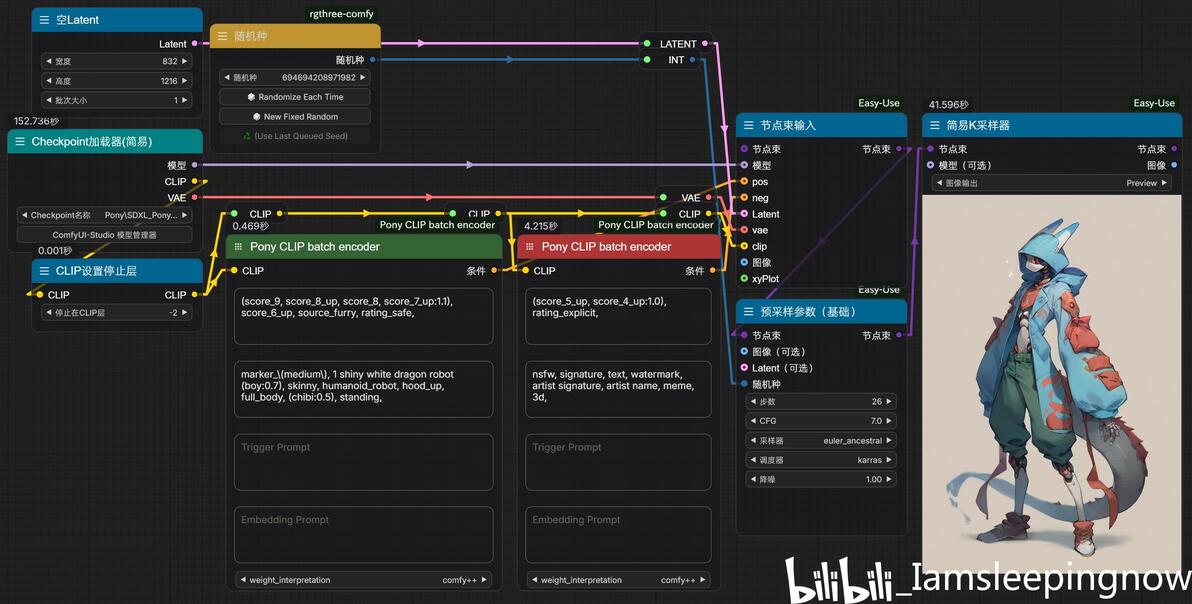
图注:跟之前的图不一样的原因是我把CLIP插值改成Comfy++了。
四、提升出图质量
我在正向提示词中添加了关于画面背景的描述,但是出的图效果太弱了,尤其是背景。这就是PonyXL模型的特点:对提示词有时过分敏感,有时过分麻木。

PonyXL的训练数据太杂了,什么都有,所以当无论怎么修改提示词都无法产生效果时,就需要使用LoRA(Low-Rank Adaptation Model)模型来解决。如果需要背景,就需要添加背景LoRA,例如下图,在Backgrounds For Pony系列中,一共8个模型,可以选择需要的模型进行下载。注意记录每一个模型的触发词Trigger Words和LoRA强度Strength与CLIP强度的推荐范围。

图注:CivitAI: https://civitai.com/models/454079?modelVersionId=505533
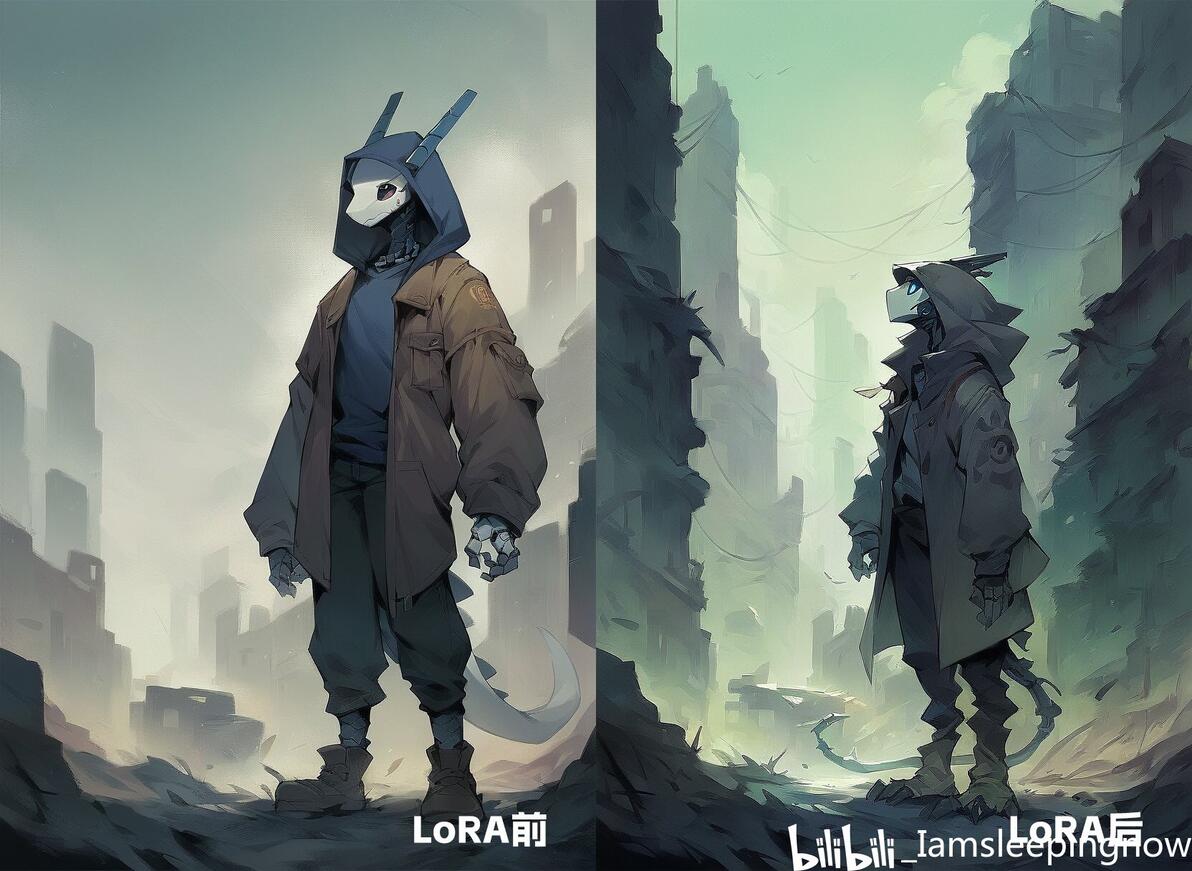
在文本编码节点之前应用一个LoRA堆(Easy-Use),使用刚刚下载的LoRA模型。可以明显地感觉到美学上的差异。by _Iamsleepingnow bili

图注:在拥有全因素背景的插画或概念图中,除了近中远景与大中小体块的层次得拉开之外,还需要考虑特殊材质与大气透视的表现,画面的势,最后是冷暖对比,这样能相对提升绘画的美学性。
这里需要讲解一下LoRA堆的应用原理和规范。
首先,我们可能会用到以下几种LoRA模型:
质量LoRA(能有效提升质量,搜索关键词detail、quality,例如https://civitai.com/models/333358/ponydiffusion-quality-slider、https://civitai.com/models/402462/detail-slider-lora-or-ponyxl-sdxl、https://civitai.com/models/383086/pony-detail-tweaker、https://civitai.com/models/402947/detailed-anime-style-sdxlpony、https://civitai.com/models/669571/pony-add-more-details等)
风格LoRA(改变绘画媒介、艺术家和材质,搜索关键词style、styles、art,例如https://civitai.com/models/550871/bss-styles-for-pony、https://civitai.com/models/297619/styles-for-pony-diffusion-v6-xl、https://civitai.com/models/264290/not-artists-styles-for-pony-diffusion-v6-xl、https://civitai.com/models/1034152?modelVersionId=1412949等)
场景LoRA(增强场景细节表现,搜索关键词background、scene,例如https://civitai.com/models/454079/backgrounds-for-pony、https://civitai.com/models/633524/background-detail-enhancer、https://civitai.com/models/993141/background-emphasis-or-bemp-or-background-on、https://civitai.com/models/661432/flux-pny-scenery-and-landscape-enhancer等)
角色LoRA(专门为某特定角色而训练,搜索关键词character,此类模型不做推荐)
动作LoRA(影响人物行为和画面构图等,搜索关键词pose,此类模型不做推荐)
重点:LoRA模型的应用顺序会影响出图的品质,PonyXL模型在推理时会按照顺序应用LoRA模型,后加载的LoRA对同一神经网络层级的修改和微调会覆盖先前的向量调整。把LoRA应用想象成图层叠加,后面的图层会覆盖前面的图层,所以在LoRA应用时,需要参考如下优先级:
PonyXL模型 -> CLIP设置停止层 -> 质量LoRA -> 风格LoRA -> 场景LoRA -> 动作LoRA -> 人物LoRA -> CLIP编码 -> 采样器
测试LoRA是一个比较漫长的过程,LoRA不是越多越好。当画面提示词调整时,最好检查一下每一个LoRA对于该提词的敏感性,即使用控制变量的方法来测试。
比如说,下图工作流生成的主要对象是一个机器素体粗火柴人,我们需要应用角色LoRA,而角色LoRA影响的范围绝非仅仅是角色,在它的模型黑箱中可能会对场景或材质等向量做不可控的篡改。假设在前面已经应用了风格LoRA及质量LoRA,冒然添加新LoRA很有可能会对画面整体做出大变动。by _Iamsleepingnow bili 为了减少这种影响,我们可以使用对后加载的LoRA降低权重的方法来解决,在这里就需要控制其他变量不变(例如随机种、提词、步数与CFG等),然后修改LoRA的权重值来查看对比效果,直到感官上合适为止。
注:素体粗火柴人是一种有着悠久历史的亚文化美学风格,具体起源有待考究。目前可以确定的结论是,粗体由细体Flush动画夸张进化而来,主要贡献是摇滚角斗士rhg社区之流,而细体则是在动画练习中对于人体结构本身的最优简化方案。具体形象特征是:有色人体,缩小胸腔和骨盆,放大肢体末端结构,船型足、无分趾,流线型身形,弱化肌群与简化关节,最为重要的是:无一例外,头必须是圆的。

LoRAs:https://civitai.com/models/333358/ponydiffusion-quality-slider、https://civitai.com/models/845407/hand-fixer-or-concepttool-lora-xl、https://civitai.com/models/264290?modelVersionId=725772、https://civitai.com/models/403997/iridescent-theme-style-pony-xl-materials-series、https://civitai.com/models/1027187/techwear-inspired-aesthetic、https://civitai.com/models/993141/background-emphasis-or-bemp-or-background-on、https://civitai.com/models/454079?modelVersionId=913775、https://civitai.com/models/438059/dynamic-poses-slider-ponyxl、https://civitai.com/models/748085/stickman-stick-figure
Embedding:https://civitai.com/models/831971/deep-negative-pony、https://civitai.com/models/300217/boringsdxl-enhance-images-stylistically-and-topically-for-pony-diffusion-v6
当两个新LoRA位于同一LoRA堆中时,有必要为该堆做一下LoRA的交换顺序测试,正如前文所述,后添加的LoRA有可能会覆盖一部分之前LoRA的内容。
除了添加LoRA之外,还有一些方法也可以提升出图质量,例如FreeU技术。
FreeU使用对Unet中残差块进行调整以及跳跃连接(Skip Connection)的方法来动态改变去噪的权重分布,最后达到增强细节与增强主体的效果。具体算法需要翻阅论文,不细究。XL与1.5模型都可以应用FreeU,也包括这次的ponyXL。
FreeU技术比较适配一些需要生成主体的画面,而对于一些无主体的抽象画面而言就没有那么适用了。一般情况下,FreeU节点的预设不太需要调整。其中,B1(Backbone Scale 1)影响主体结构的清晰度,值越大时大体块会更加明显,太低的话物体型会散架;B2(Backbone Scale 2)影响细节噪波量,值越大时细小的体块也越多;S1(Skip Scale 1)影响局部细节量,具体会影响纹理量的添加;S2(Skip Scale 2)影响画面整体大效果,具体会影响画面协调性并减少细节。
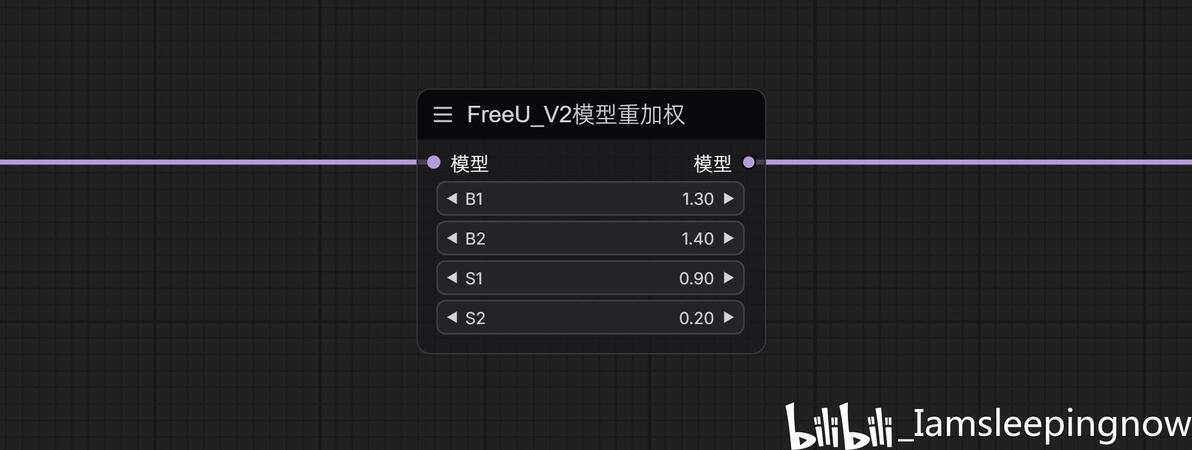
图注:FreeU节点,V2指的是XL模型模版,默认值为1.3, 1.4, 0.9, 0.2
将FreeU_V2节点放在模型管线中,查看输出结果。
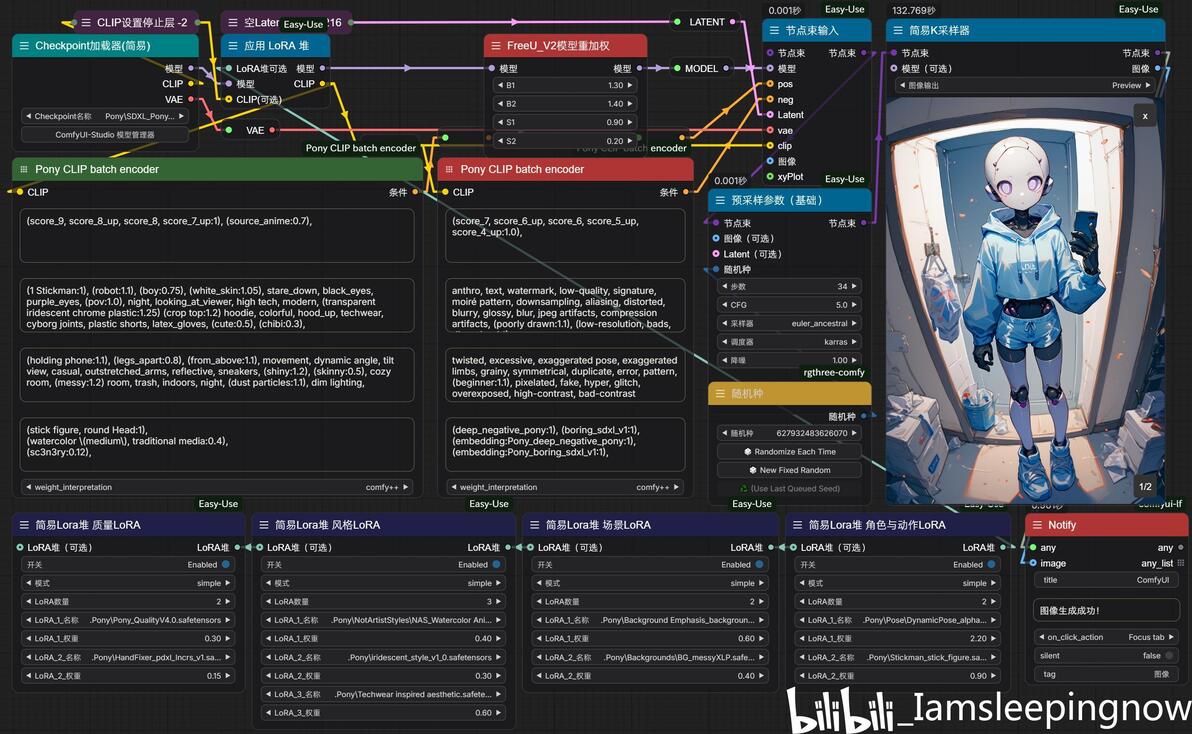
当前工作流一览:https://github.com/Iamsleepingnow/Iamsleepingnow-ComfyWorkflows/blob/main/WFlow_PonyXL_FreeU_by_Iamsleepingnow.json
我们目前没有对它的默认参数做任何调整,在其他变量不变的情况下,FreeU在细节上的体现确实会相对好一点,画面主体更明显,提升了饱和度和对比度(这一点可能不太好),修正了一些解剖学问题,且对于提词的理解较于前者会到位一点。
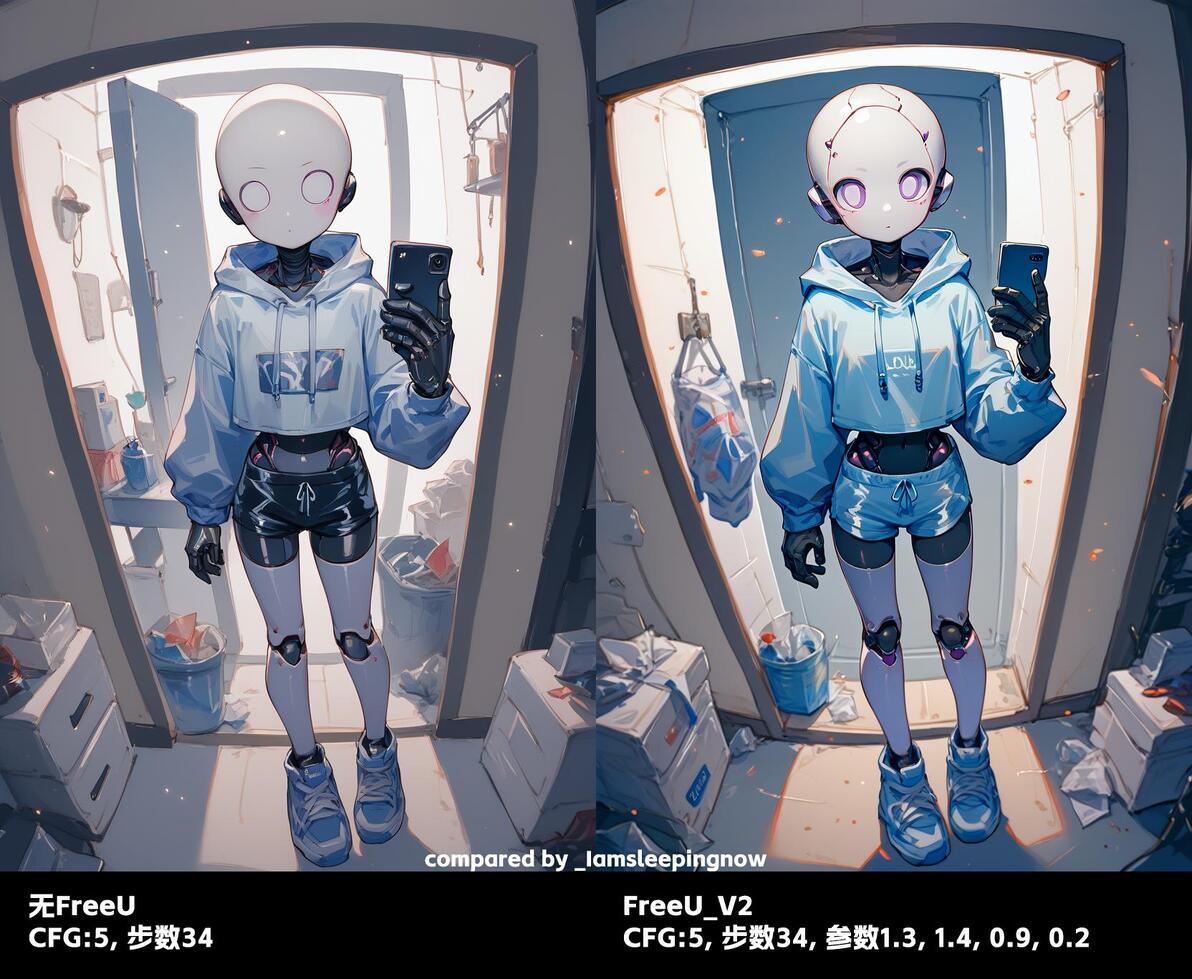
但我认为FreeU后的画面可能会更加零散,画面的空间场较弱,而且画面可能会由于CFG的原因变得更加样板和僵硬。
让我们修改一下参数,减少一下B1和S2,增加一下B2和S1,也就是在削弱整体关系的情况下增加细节纹理。

总而言之,FreeU技术有可能会优化出图质量,但是,当出图质量已经足够好时就不需要加这个节点了。有时候FreeU的添加会产生反作用,是否使用则需要根据实际情况而定。
当我们为角色或场景写了很多设定的提示词后,模型有概率会不遵循嵌入词中的内容,这时就需要提升采样器的引导系数CFG值来进行排查。但CFG值的增加会导致画面色彩的过饱和,模型对于一些作画特征用力过猛,如下图所示 by _Iamsleepingnow bili,这种情况显然不符合正常美学规范,由CFG导致的画面崩坏被称作CFG灼烧(CFG burn)。
图注:CFG = 11
这种灼烧风格的对比度和饱和度都较高,画面较平,笔触较油。这也是一种强风格化的美术风格,但我这里的需求不是这种风格,所以就需要解决这个问题。
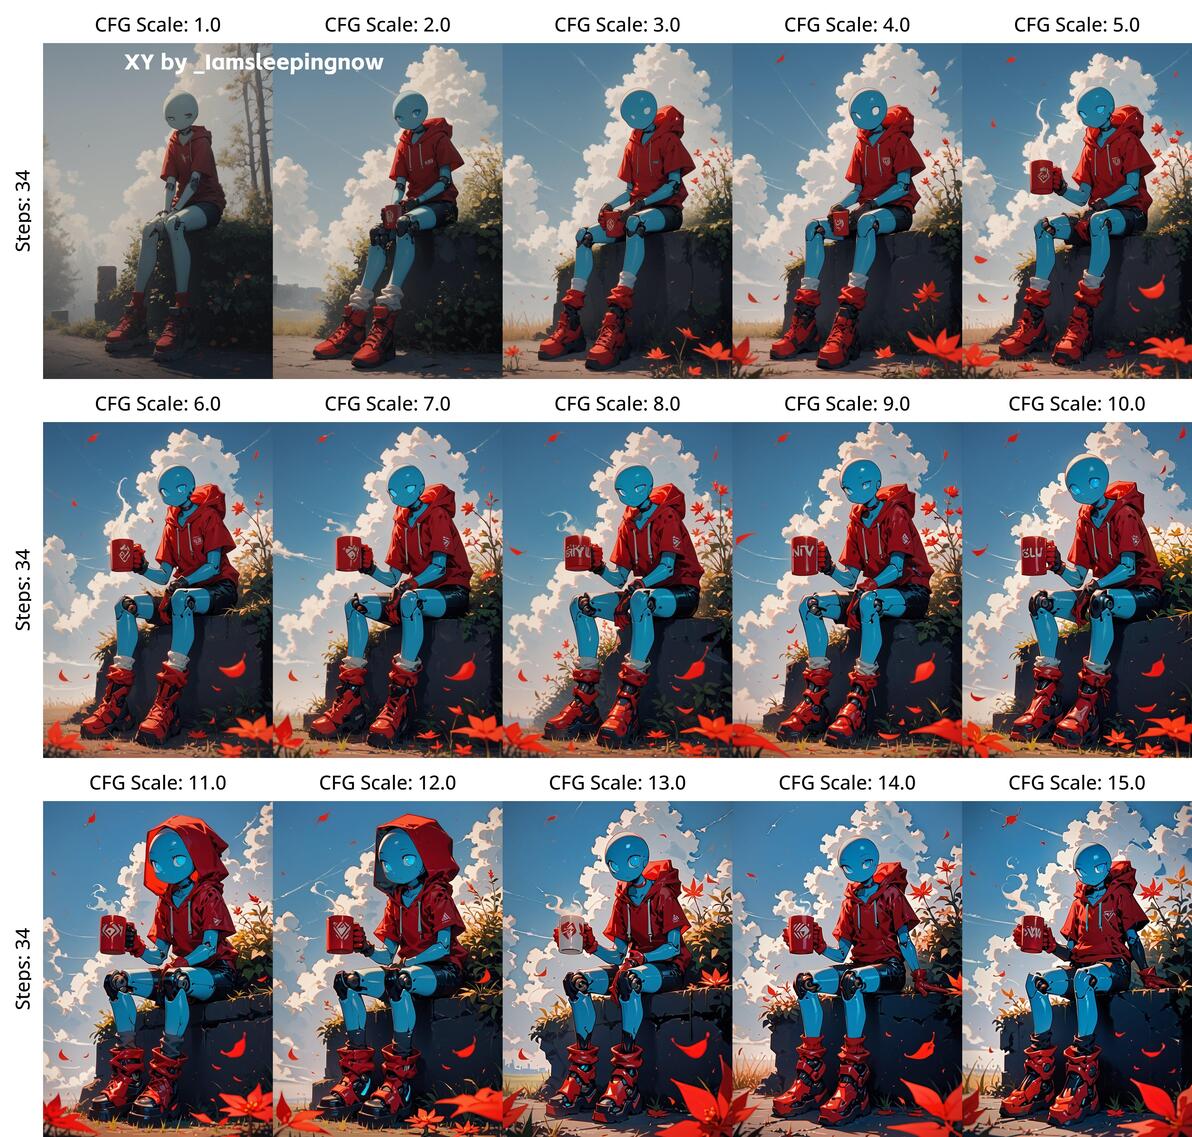
图注:灼烧测试
我们可以使用一些降低CFG的方法,例如添加缩放CFG节点。但这次我打算使用一些CFG抗烧插件来做,例如Skimmed_CFG。Skim是滤除的意思,它可以过滤掉多余的CFG着色,但保留采样器对于提示词的引导力度。
插件:Skimmed_CFG:https://github.com/Extraltodeus/Skimmed_CFG
在该插件中,我比较常用两个节点:Skimmed CFG和Skimmed CFG - linear interpolation dual scales。
这两个节点是平行关系,只需要应用其中一个就可以了。
Skimmed CFG中,参数Skimming_CFG可以把CFG着色限制在一个数量以内(0~10),经测试,4以内属于降低对比和饱和度,而大于4反之。第二个参数full_skim_negative似乎可以完全过滤掉负向提示词中的冲突部分,比较适用于出纯色背景的图,不怎么经常用。参数disable_flipping_filter与full_skim_negative配合,可以增强CFG对负向提示的控制。
Skimmed CFG - linear interpolation dual scales是对正向和负向提示词的预测值之间分别做线性插值,也就是分别控制正向和负向提示词的引导程度。Skimming_CFG_positive越低,画面越灰,饱和对比越弱,而Skimming_CFG_negative越低,画面对负向提示词反映的敏感性越小。(参数范围为0~10)
还有一个节点也是线性插值:Skimmed CFG - linear interpolation,只使用一个值来同时控制正负提示词的过滤。(参数范围为0~10)因为作者比较推荐,所以我觉得这个单值线性插值节点似乎可以替代Skimming_CFG节点。
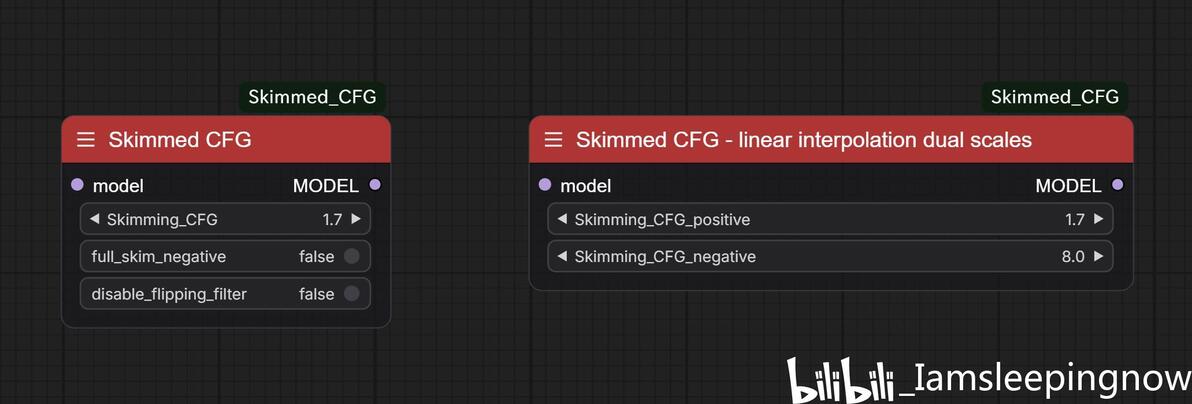
现在来做一下测试:
当使用Skimmed CFG节点时:(参数:1.7,false,false)
实际CFG值在8~26之间比较合适。节点Skimmed CFG可以略微对采样器中的CFG做一个限制,让不同的CFG对于画面的整体贡献差别不会太大。
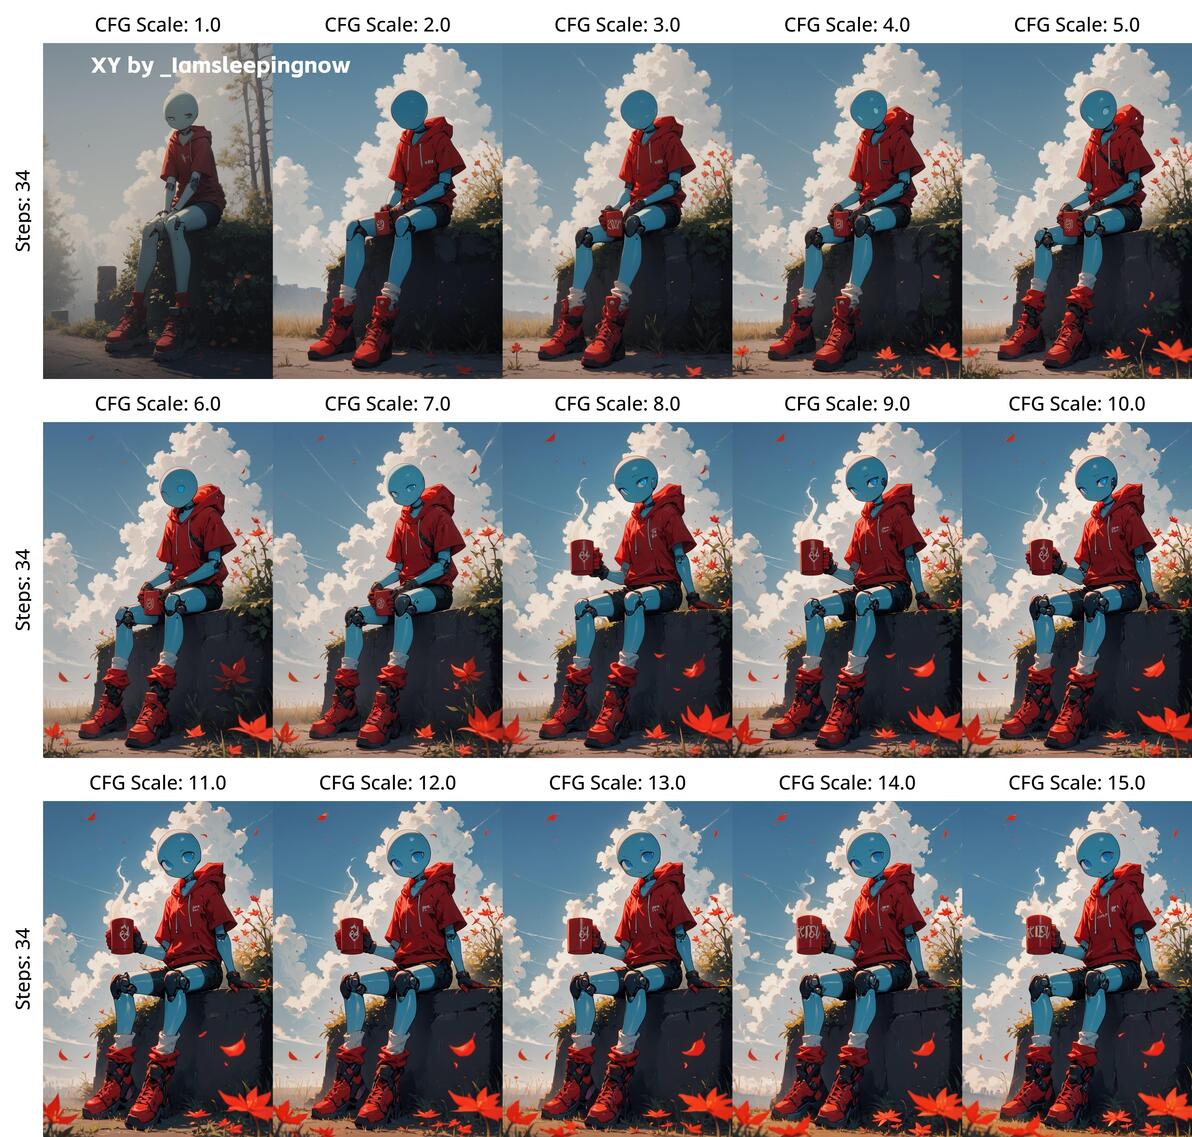
图注:Skimmed CFG(1~15)
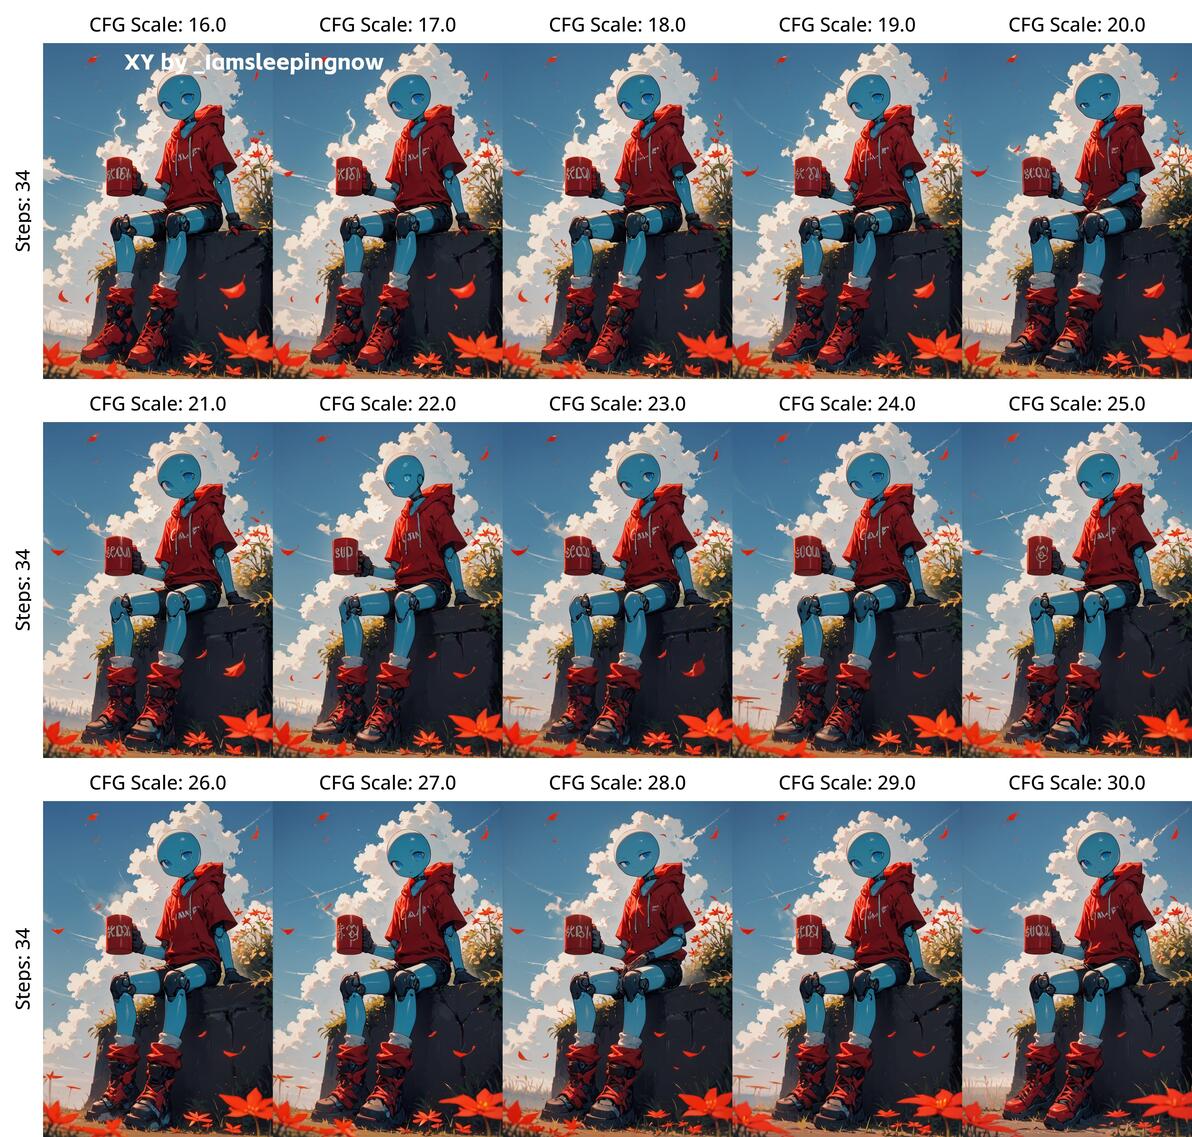
图注:Skimmed CFG(16~30)
当使用Skimmed CFG - linear interpolation dual scales节点时:(参数:1.7,8.0)
我们可以得到更灰的图。虽然不能增加亮部暗部的层次,但是在色调的控制上更舒服一些,可以适合传统一点的美术风格。不同的CFG之间会略微有点差别,这种差别是建立在提词准确性上的,而非颜色。
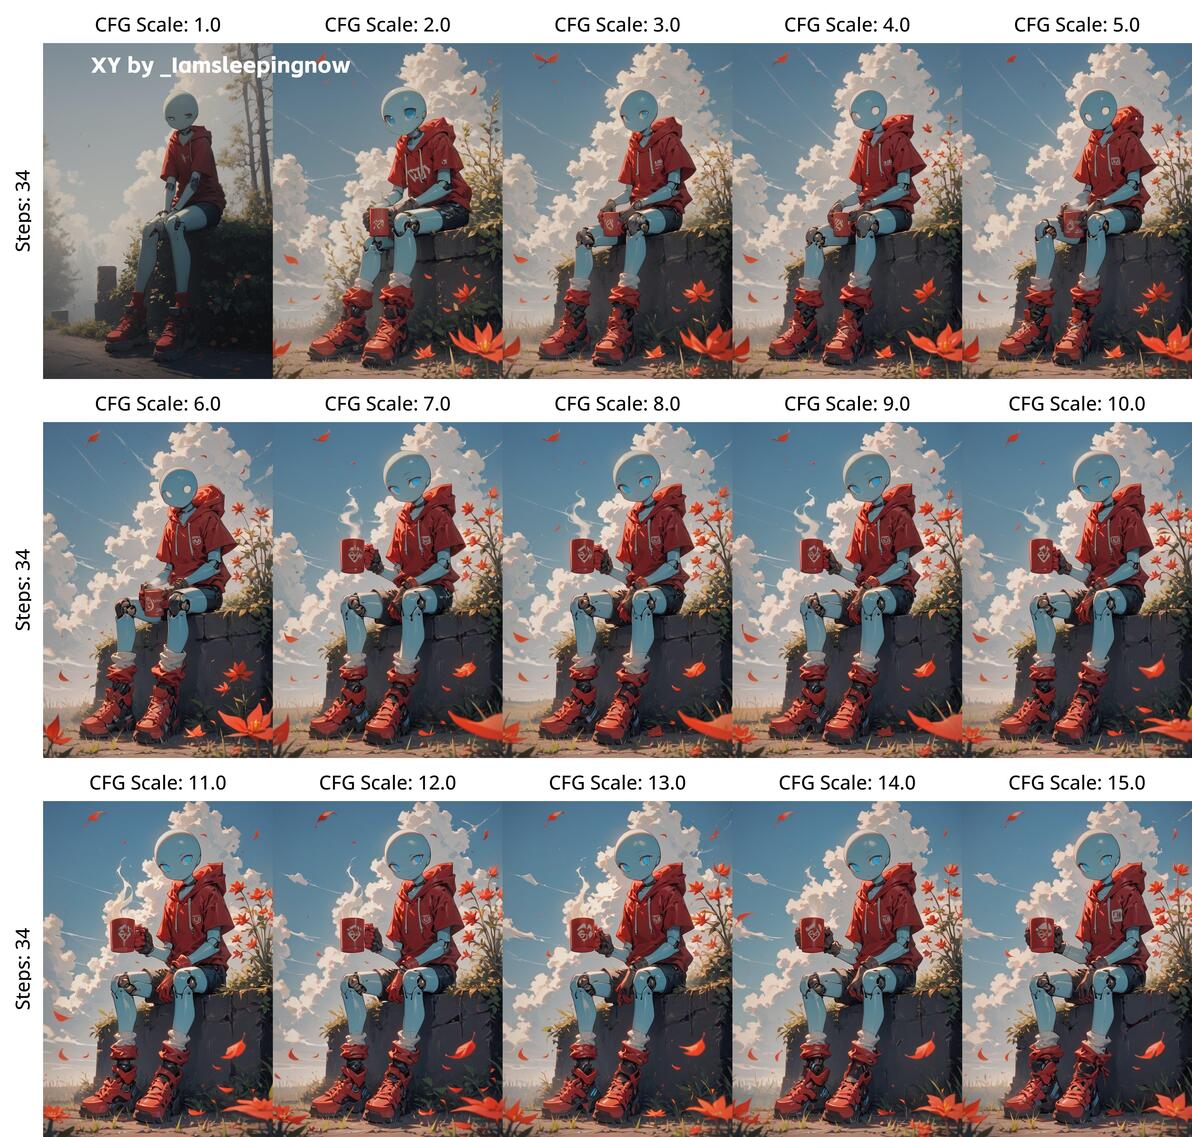
图注:Skimmed CFG - linear interpolation dual scales(1~15)
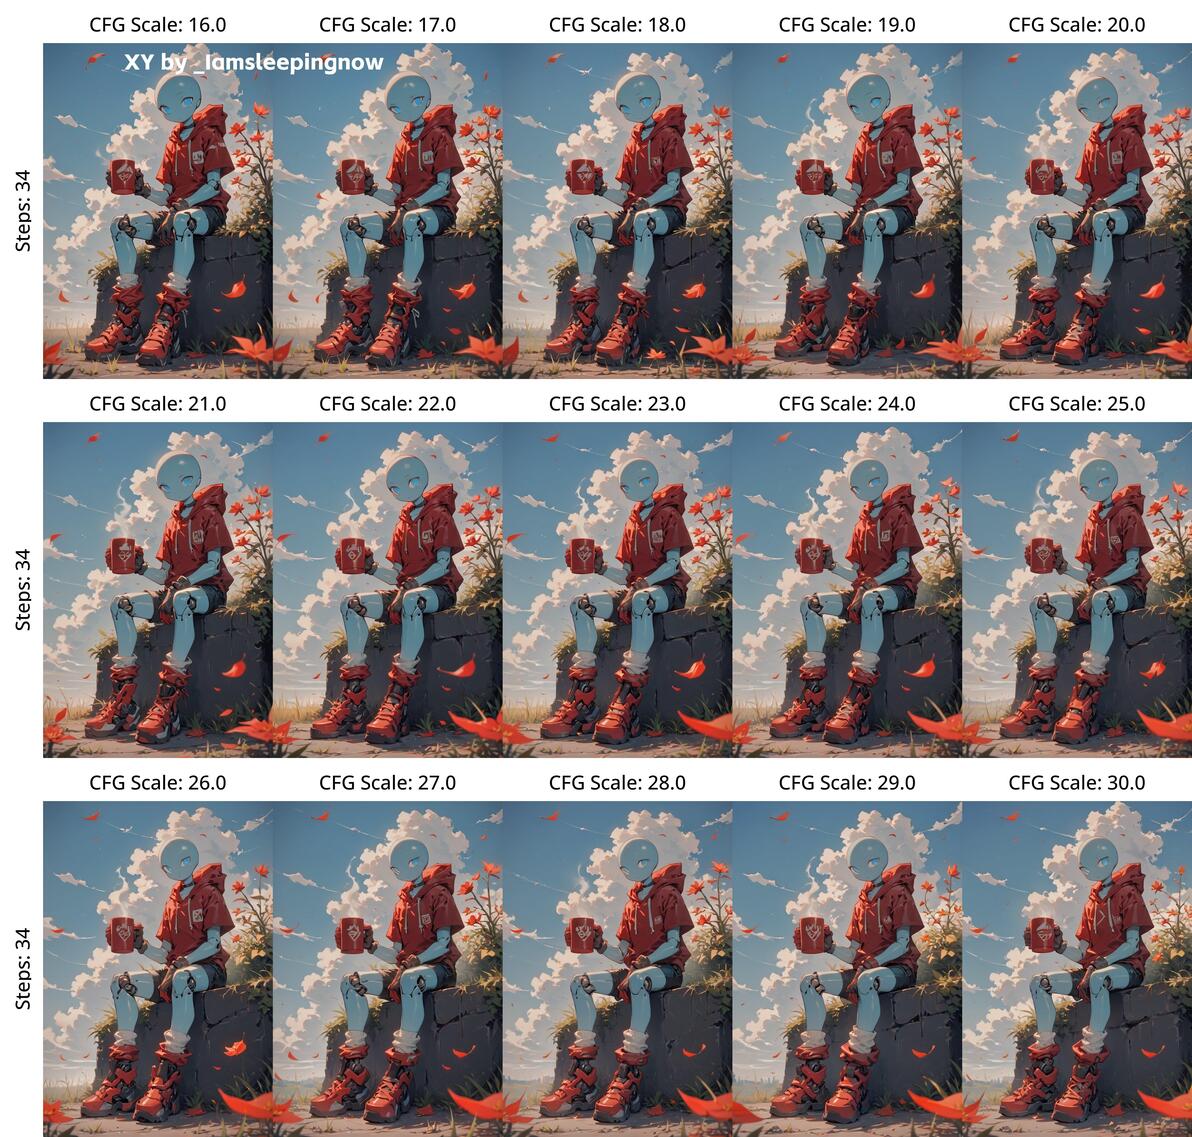
图注:Skimmed CFG - linear interpolation dual scales(16~30)
对比一下。
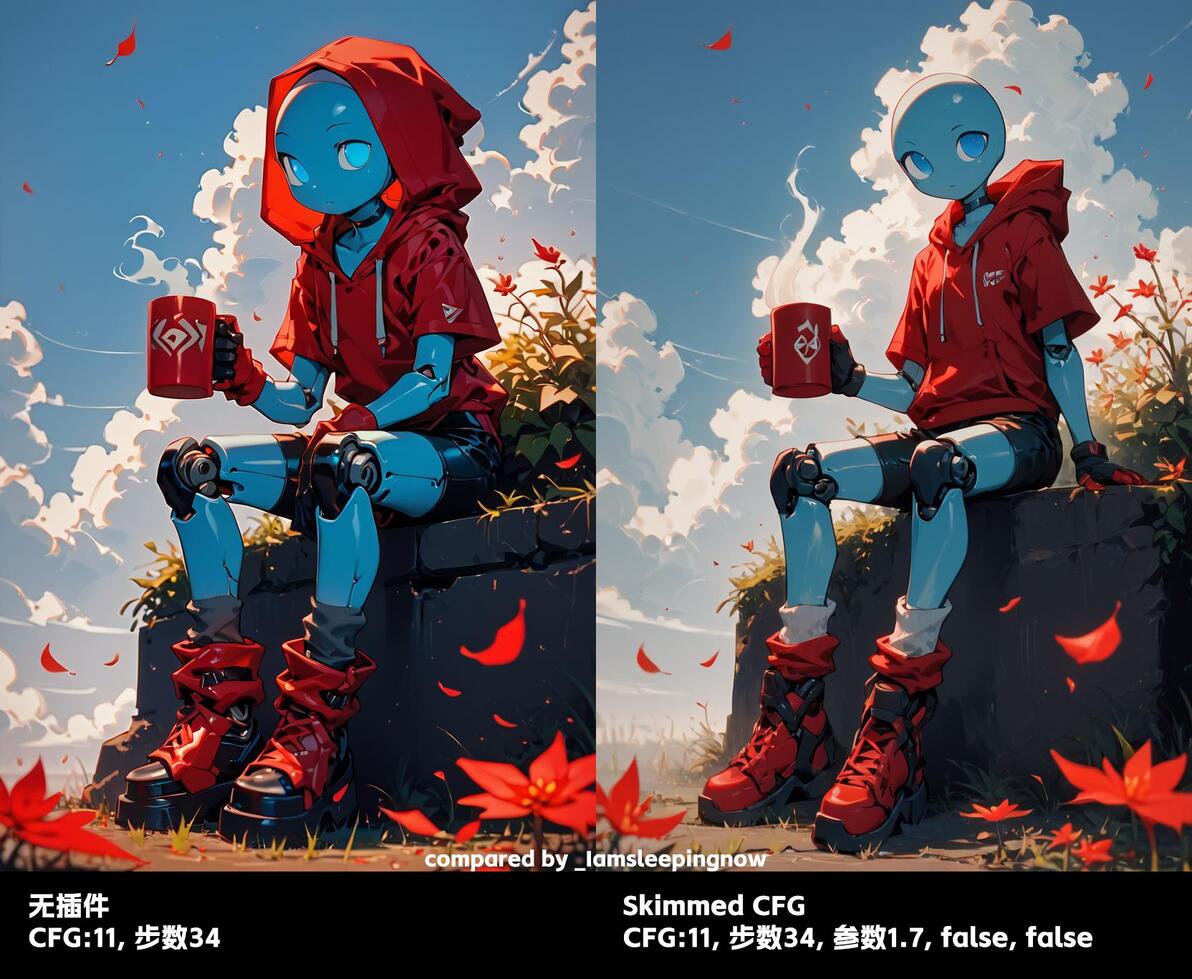
图注:Skimmed CFG
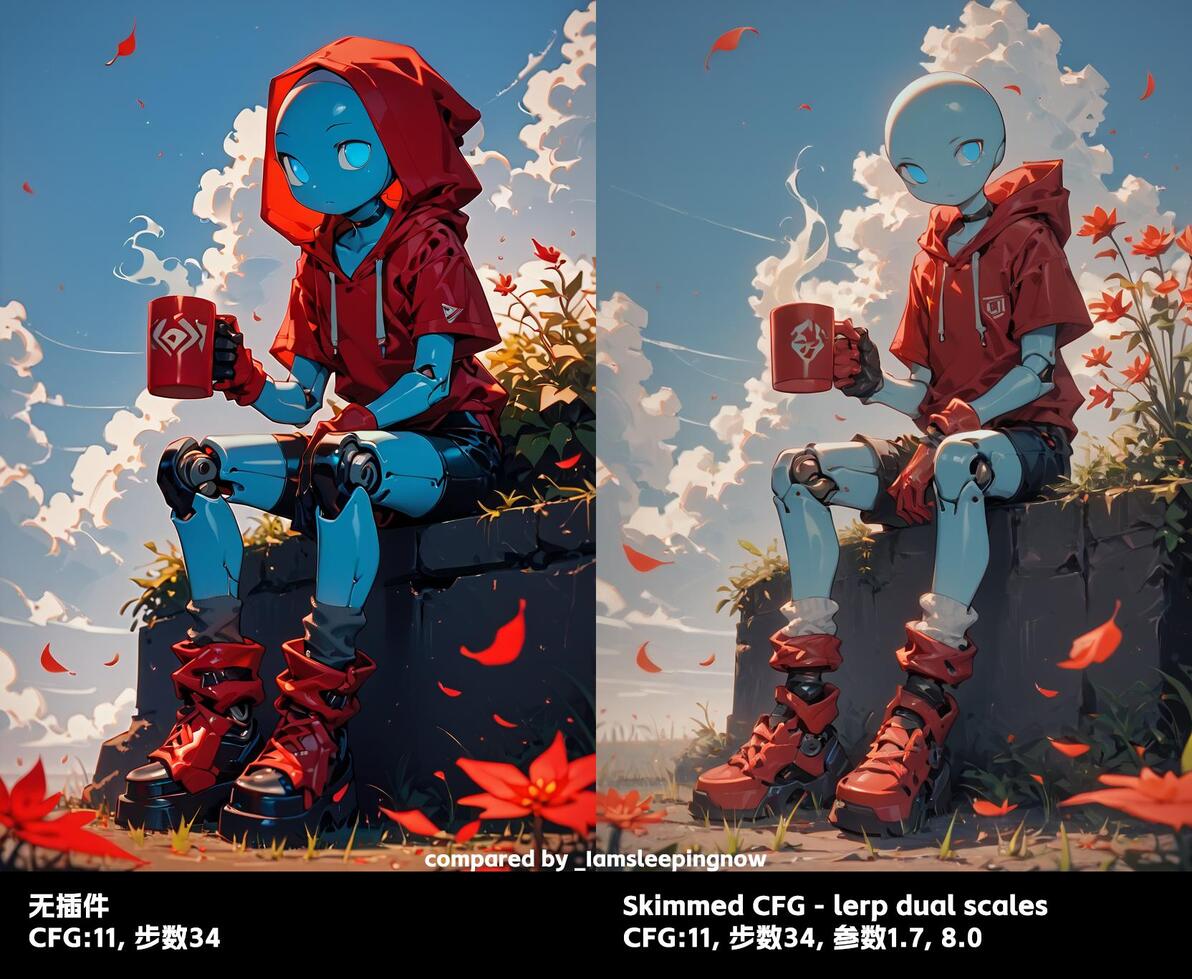
图注:Skimmed CFG - linear interpolation dual scales
根据作者介绍以及我自己的理解,该插件里的节点功能如下:
Skimmed CFG:允许在不灼烧图像的前提下使用更高的CFG值。采样器CFG范围推荐:8~26。绘画风格:写实。
Skimmed CFG - replace:使用正向提词与负向提词的冲突部分相互抵消,减少图像提词冗余导致的混乱。采样器CFG范围推荐:12~30。绘画风格:风格化。
Skimmed CFG - linear interpolation:使用线性插值的方法混合正负冲突特征,而非replace节点的直接替换。采样器CFG范围推荐:8~32。绘画风格:一般绘画。
Skimmed CFG - linear interpolation dual scales:使用双通道线性插值的方法独立调节正负冲突特征的混合,可以有效降低画面饱和对比度。采样器CFG范围推荐:7~26。绘画风格:传统绘画、插画。
Skimmed CFG - Difference CFG:基于因某提词的预测导致某些作画区域的变化幅度过大,此节点通过差异补偿算法可以防止图像因过拟合而偏离合理的范围,从而解决该问题。采样器CFG范围推荐:12~36。绘画风格:风格化。
Skimmed CFG - Timed flip:可以在出图调度过程中随机翻转噪点方向,从而增加图像随机性。该节点解决了高CFG导致的图像过于样板和僵硬的问题,但是该节点只能与其他Skimmed CFG节点混用,不太能单独使用。因为当修正值越高时,画面随机性越强,但饱和对比也会越强。采样器CFG范围推荐:6~12。绘画风格:任意。
当前工作流一览:https://github.com/Iamsleepingnow/Iamsleepingnow-ComfyWorkflows/blob/main/WFlow_PonyXL_SkimCFG_by_Iamsleepingnow.json

LoRAs:https://civitai.com/models/333358/ponydiffusion-quality-slider、https://civitai.com/models/845407/hand-fixer-or-concepttool-lora-xl、https://civitai.com/models/1027187/techwear-inspired-aesthetic、https://civitai.com/models/264290?modelVersionId=372898、https://civitai.com/models/454079?modelVersionId=505533、https://civitai.com/models/633524/background-detail-enhancer、https://civitai.com/models/748085/stickman-stick-figure
Embeddings:https://civitai.com/models/831971/deep-negative-pony、https://civitai.com/models/300217/boringsdxl-enhance-images-stylistically-and-topically-for-pony-diffusion-v6
五、拯救随机种:为潜空间添加噪声
好不容易随到了一个相对优秀的随机种,但就是有小瑕疵,这该怎么办?
有一个廉价的方法是给输入的画布Latent中加噪点,从而在根源上影响图像输出的随机性。
尝试使用插件来完成这个需求:
插件:PowerNoiseSuite:https://github.com/WASasquatch/PowerNoiseSuite
插件:PPF_Noise_ComfyUI:https://github.com/WASasquatch/PPF_Noise_ComfyUI
在混合Latent中,设置混合比率(0~1)来控制噪点注入的程度。by _Iamsleepingnow bili 我们还需要一个新的随机数节点来控制加噪的种子,这样就能实现当采样器种子固定时对画面做细微变化的需求了。

混合比率在0~0.3之间属于非常细微的变化,这里做一个种子对比。
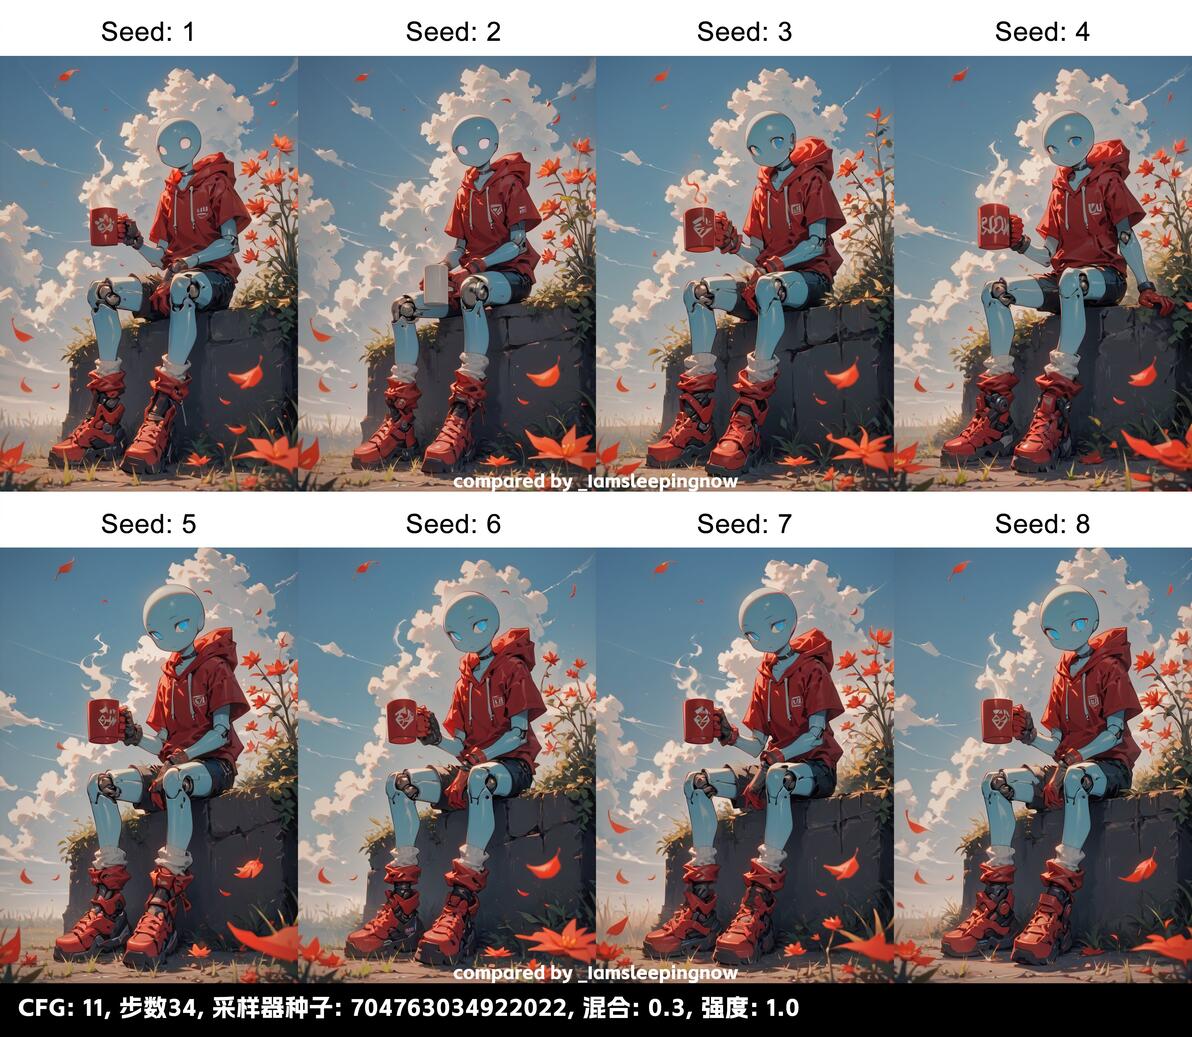
当比率和强度足够大时,画面会和原图产生非常大的区别,跟采样器重新随一个新的种子的效果差不多。
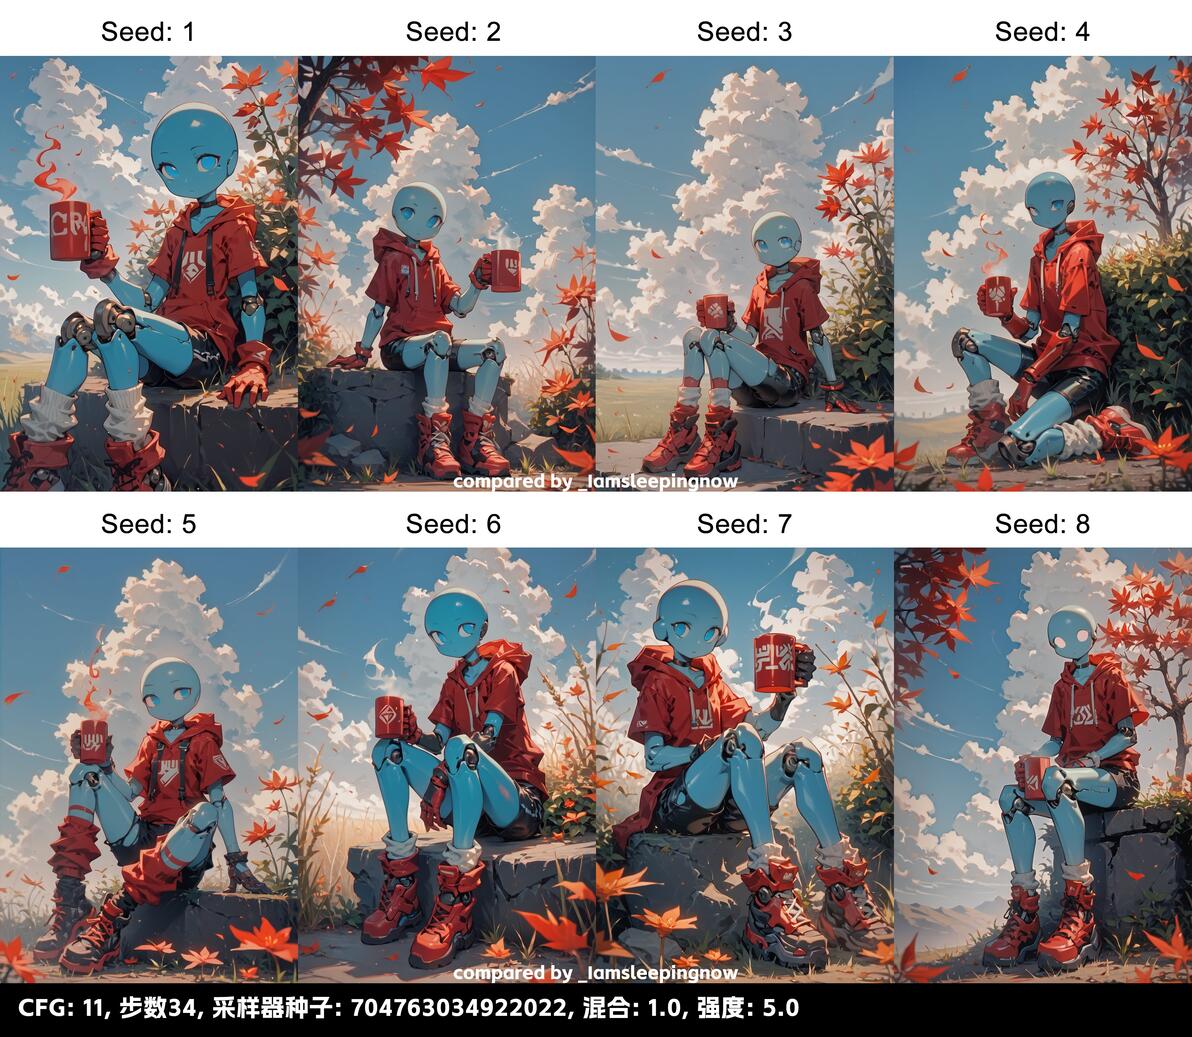
这个方法的优点是能在不重绘的情况下修正固定种子画面中的故障 ,缺点是太取决于随机种了,大海捞针比较耗时。
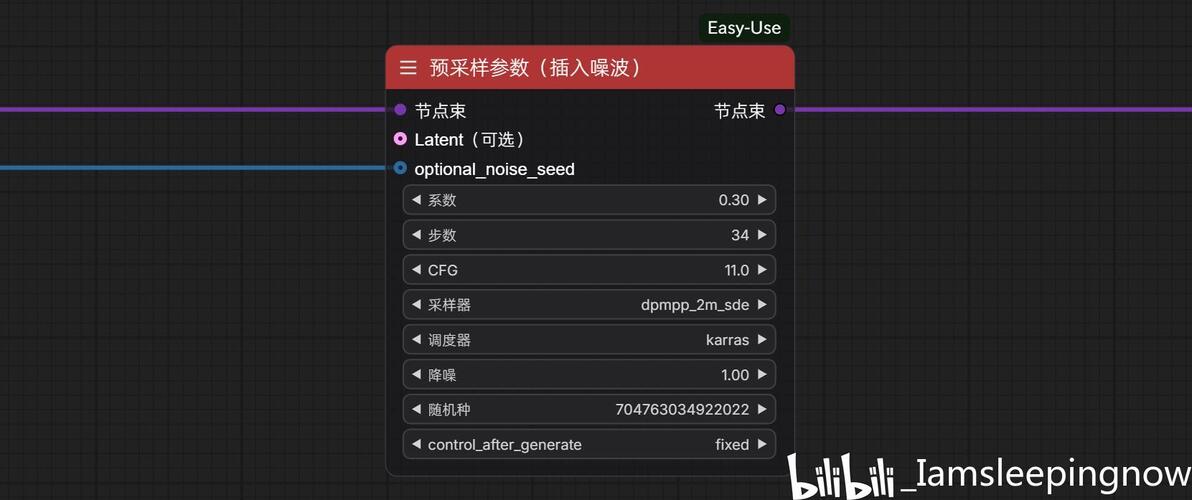
添加噪点也可以只使用EasyUse插件中的预采样参数(插入噪波)来替换当前的预采样参数(基础)来做,使用方法类似,只需要提供插入噪点的种子optional_noise_seed以及配置一下融合系数即可。
六、高显存推荐:使用动态融合模型
我们还可以通过融合模型的方法来给图像的生成做变体,这样就可以控制出图的风格与哪两个主模型之间的偏向性了。
基础的节点有融合模型与融合CLIP,其比率数值范围为0~1。注意,比率越靠近1,出图与模型1越近似;比率越靠近0,出图与模型2越近似,这一点比较反直觉。
我们可以把比率参数暴露成节点端口,然后与同一个浮点数相连,然后就能使用一个参数来控制。这里有一个滑动条插件比较推荐,需要右键该节点,在属性面板中调整它的范围。
插件:ComfyUI-mxToolkit: https://github.com/Smirnov75/ComfyUI-mxToolkit

这里我将PonyXL_v6与写实模型PonyRealism_v2.2进行插值混合,可以发现比率在0.5以下时,图像携带的画面张力与写实质感能融合地比较到位,而超过0.5时,过于写实反而会显得平庸。
注意,模型融合最好不要隔代混用,例如PonyXL与普通XL模型,最好与基于PonyXL训练的模型进行融合。
模型:PonyRealism_v2.2: https://civitai.com/models/372465/pony-realism

可能会发现,在上图融合的过程中,比率越高,与原图画面构图的相似度越低。
by _Iamsleepingnow bili 这个原因是我们在融合了模型的同时也融合了CLIP分词器,PonyRealism的分词器可能不如原版PonyXL,所以这里我选择仅融合模型而不融合CLIP。
再来测试一下。
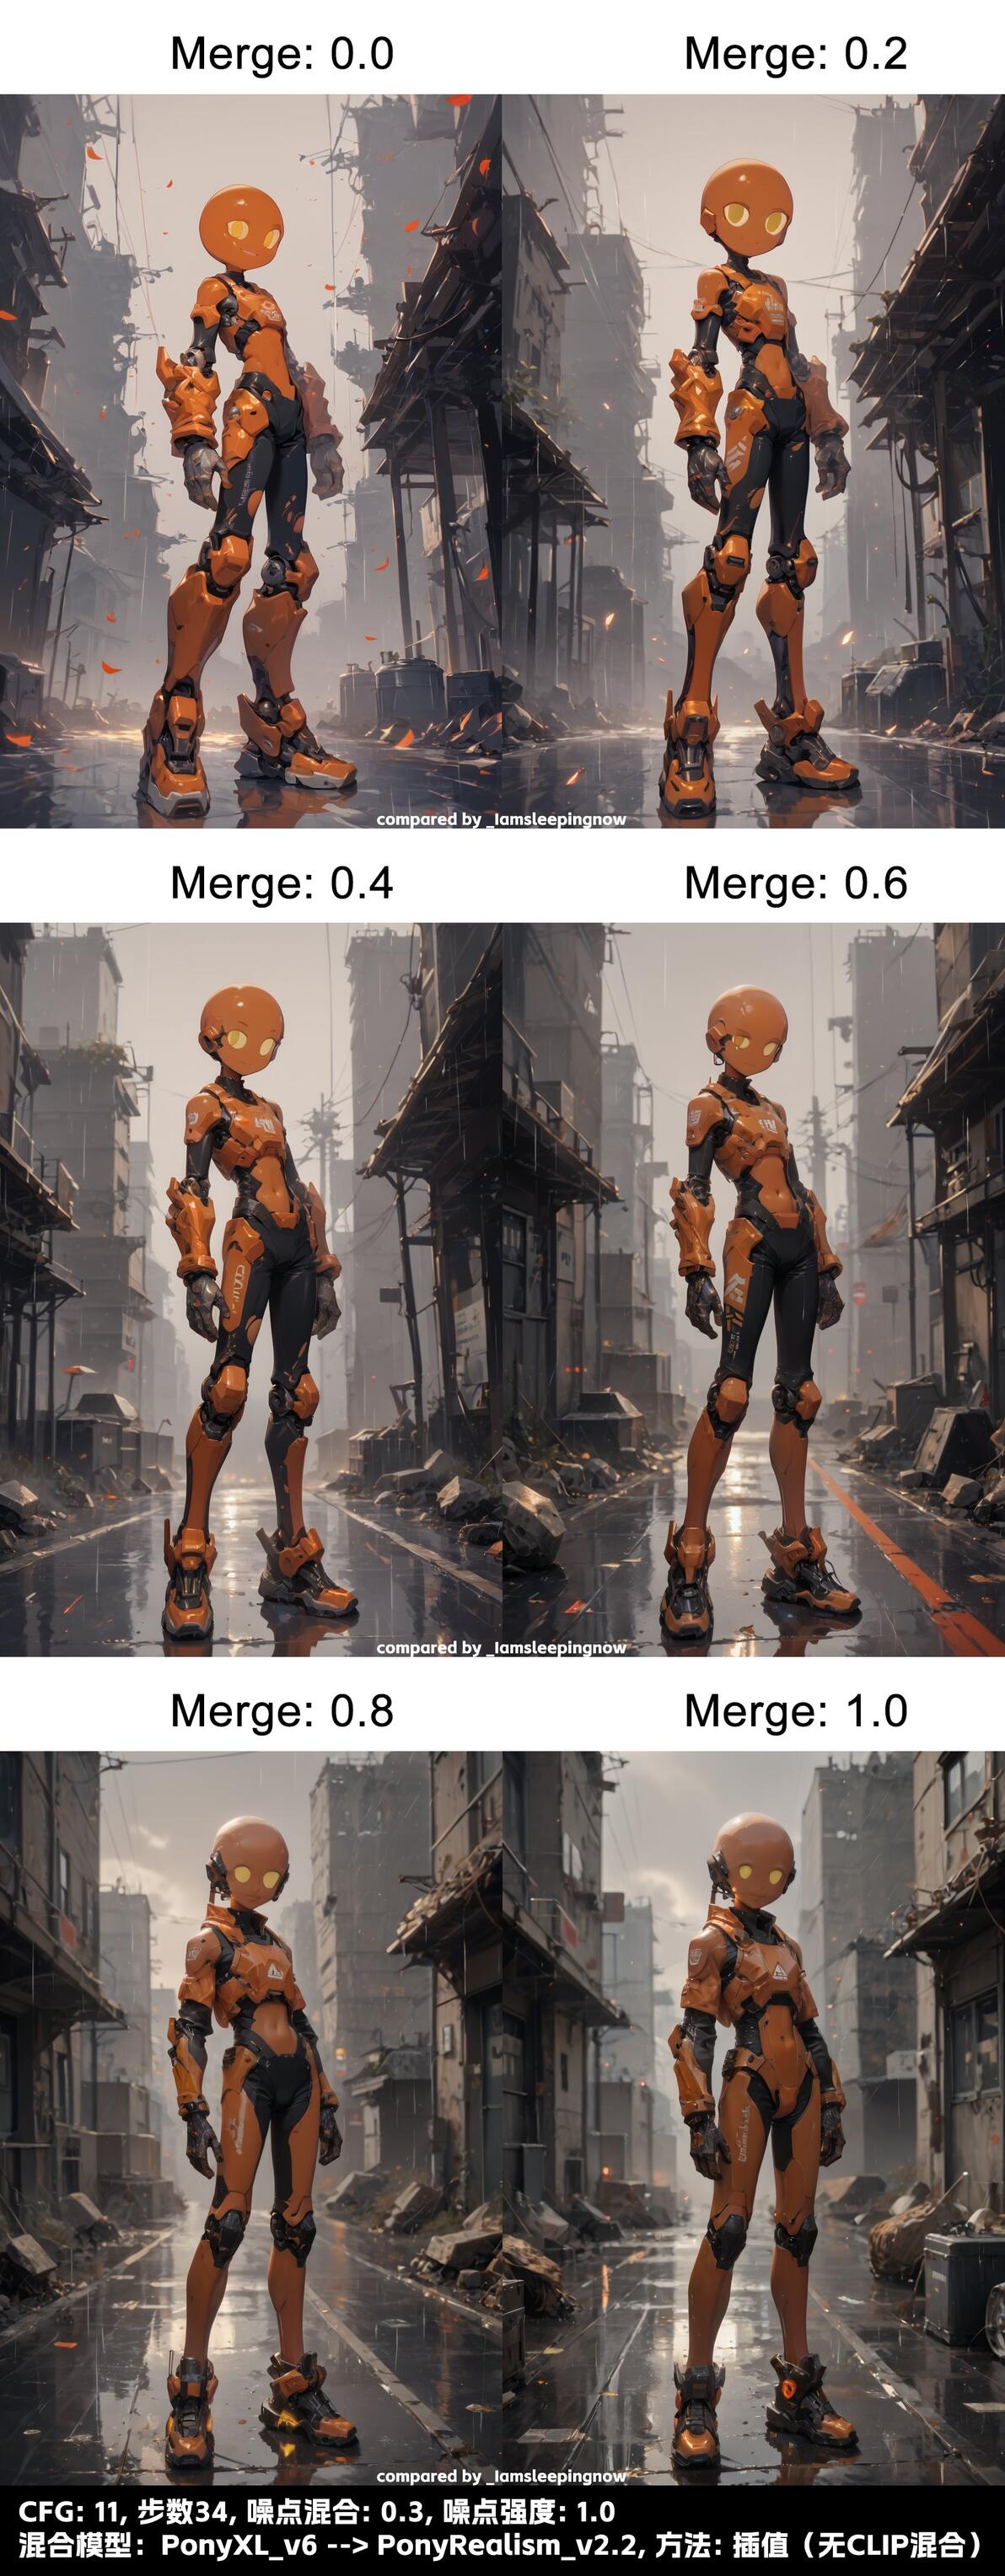
在测试结果中,除了透视的灭点被抬升外,人物动态、服饰结构、背景结构基本一致。
在融合模型流程中,第一次出图时需要加载两个模型,占用比较大,有什么方法可以减少这个占用?
我们如果确定了两个模型融合的比率,就可以将融合后的模型导出成一个新模型。使用保存Checkpoint节点,将融合后的模型、CLIP与VAE接入该节点,然后执行队列。
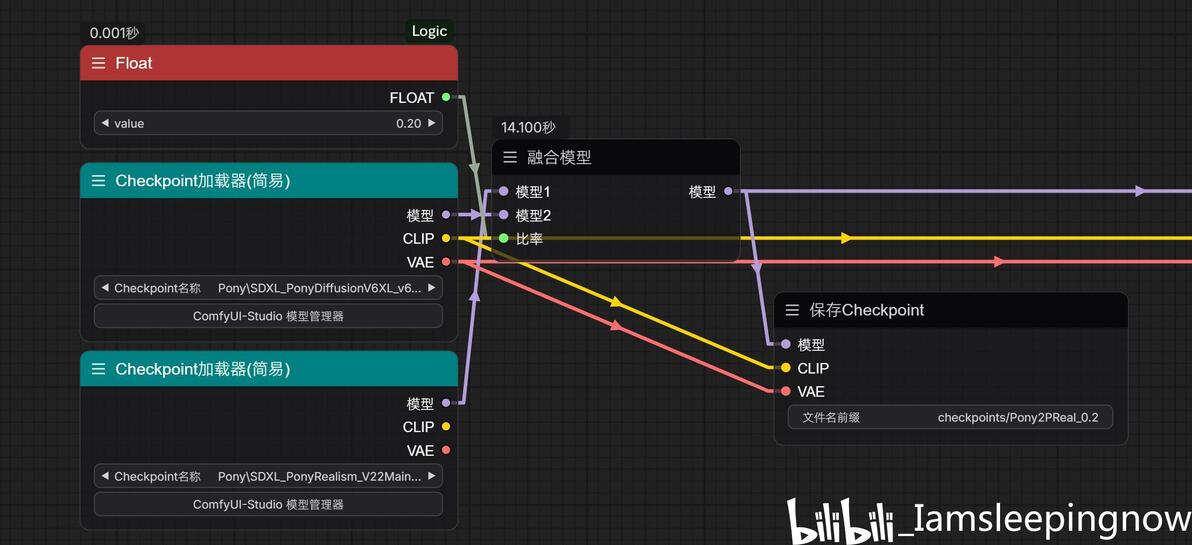
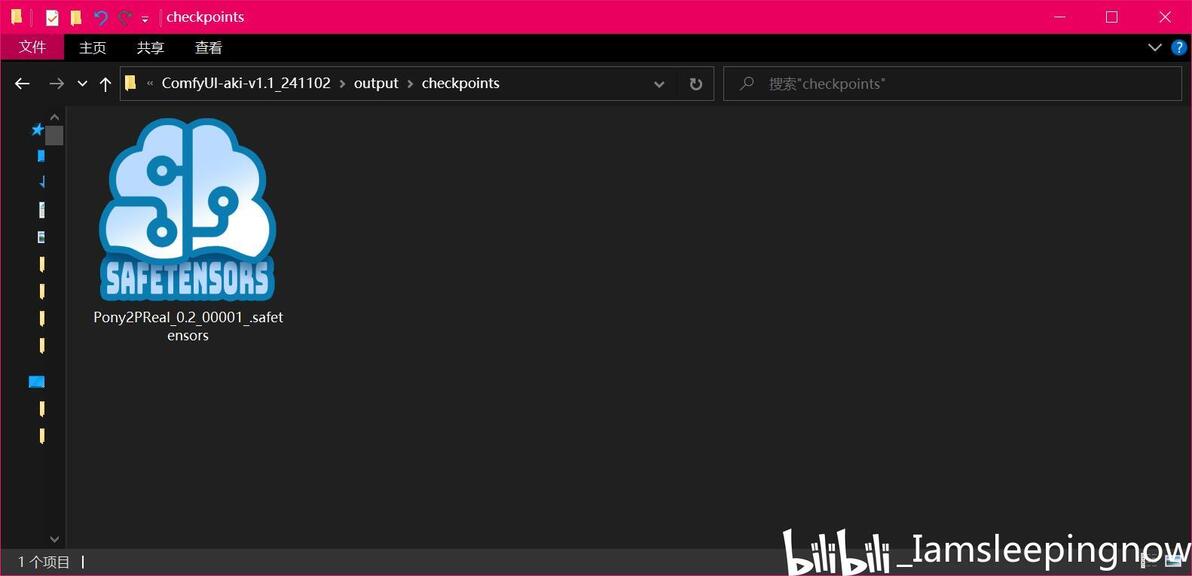
保存后的模型会存储在./output/路径中,支持多级路径。
当前工作流一览:https://github.com/Iamsleepingnow/Iamsleepingnow-ComfyWorkflows/blob/main/WFlow_PonyXL_ModelMerge_by_Iamsleepingnow.json
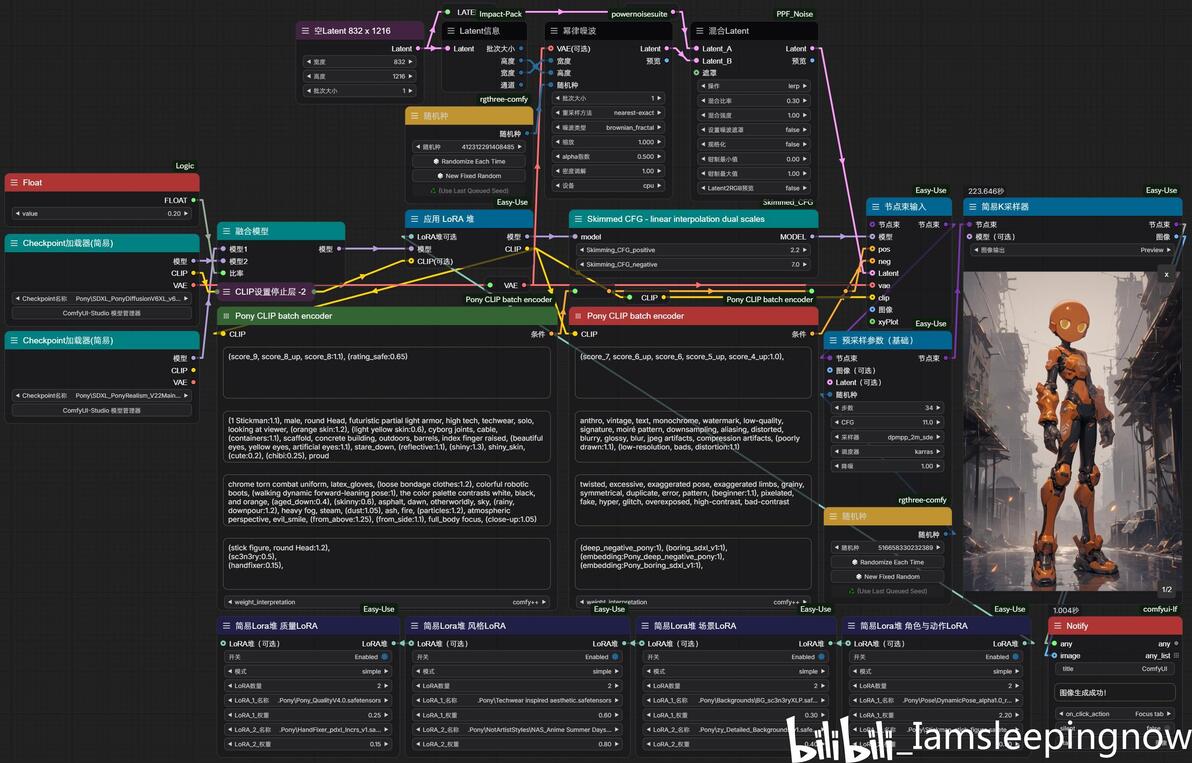
LoRAs:https://civitai.com/models/333358/ponydiffusion-quality-slider、https://civitai.com/models/845407/hand-fixer-or-concepttool-lora-xl、https://civitai.com/models/1027187/techwear-inspired-aesthetic、https://civitai.com/models/264290?modelVersionId=372898、https://civitai.com/models/454079?modelVersionId=505533、https://civitai.com/models/633524/background-detail-enhancer、https://civitai.com/models/438059/dynamic-poses-slider-ponyxl、https://civitai.com/models/748085/stickman-stick-figure
Embedding:https://civitai.com/models/831971/deep-negative-pony、https://civitai.com/models/300217/boringsdxl-enhance-images-stylistically-and-topically-for-pony-diffusion-v6
七、PonyXL对于ControlNet等通用工具的兼容
PonyXL本质上还是XL模型,也是可以兼容XL的ControlNet之类的通用工具的。接下来我来使用同一个上下文来测试这些模型,仅改变采样器种子和工具应用参数。by _Iamsleepingnow bili
测试:QRcode / Optical Pattern(将画面与二值图匹配的ControlNet)
ControlNet: https://civitai.com/models/161132/sdxl-controlnet-opticalpattern-optical-illusions

测试:Openpose(将画面与openpose人物关节图匹配的ControlNet)
ControlNet: https://civitai.com/models/135552/openpose-sdxl
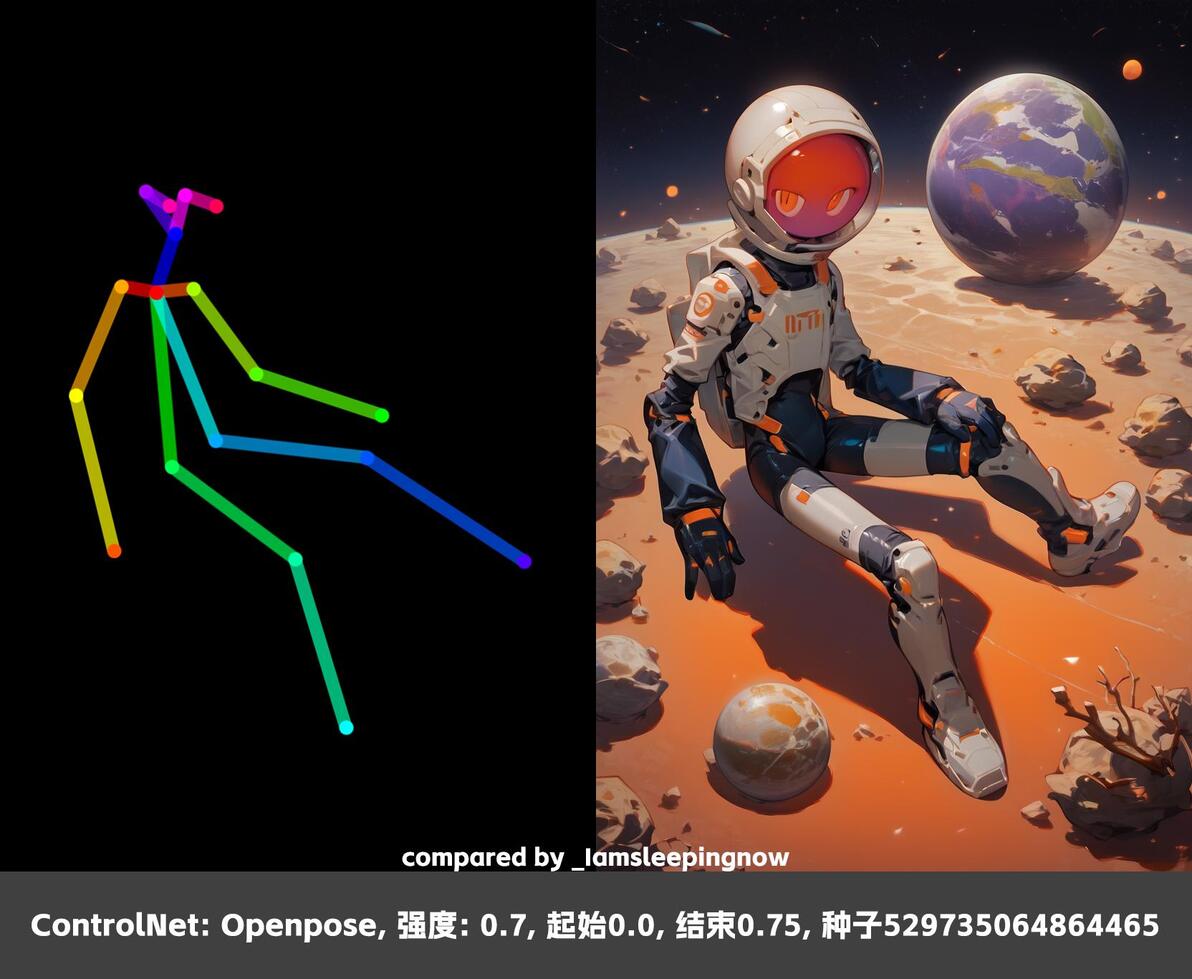
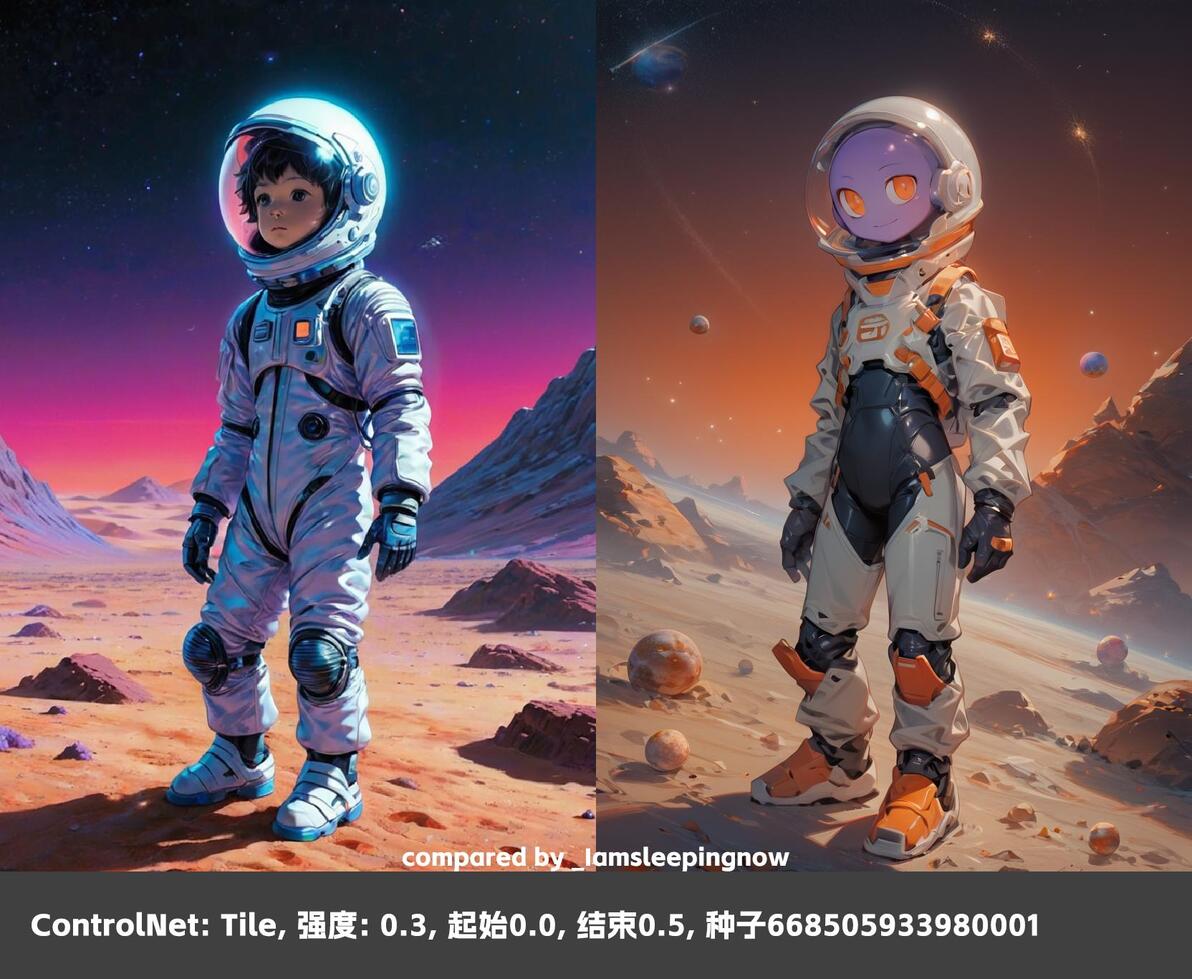
测试:Tile(将画面与垫图下采样匹配的ControlNet)
ControlNet: https://civitai.com/models/330313/ttplanetsdxlcontrolnettilerealistic
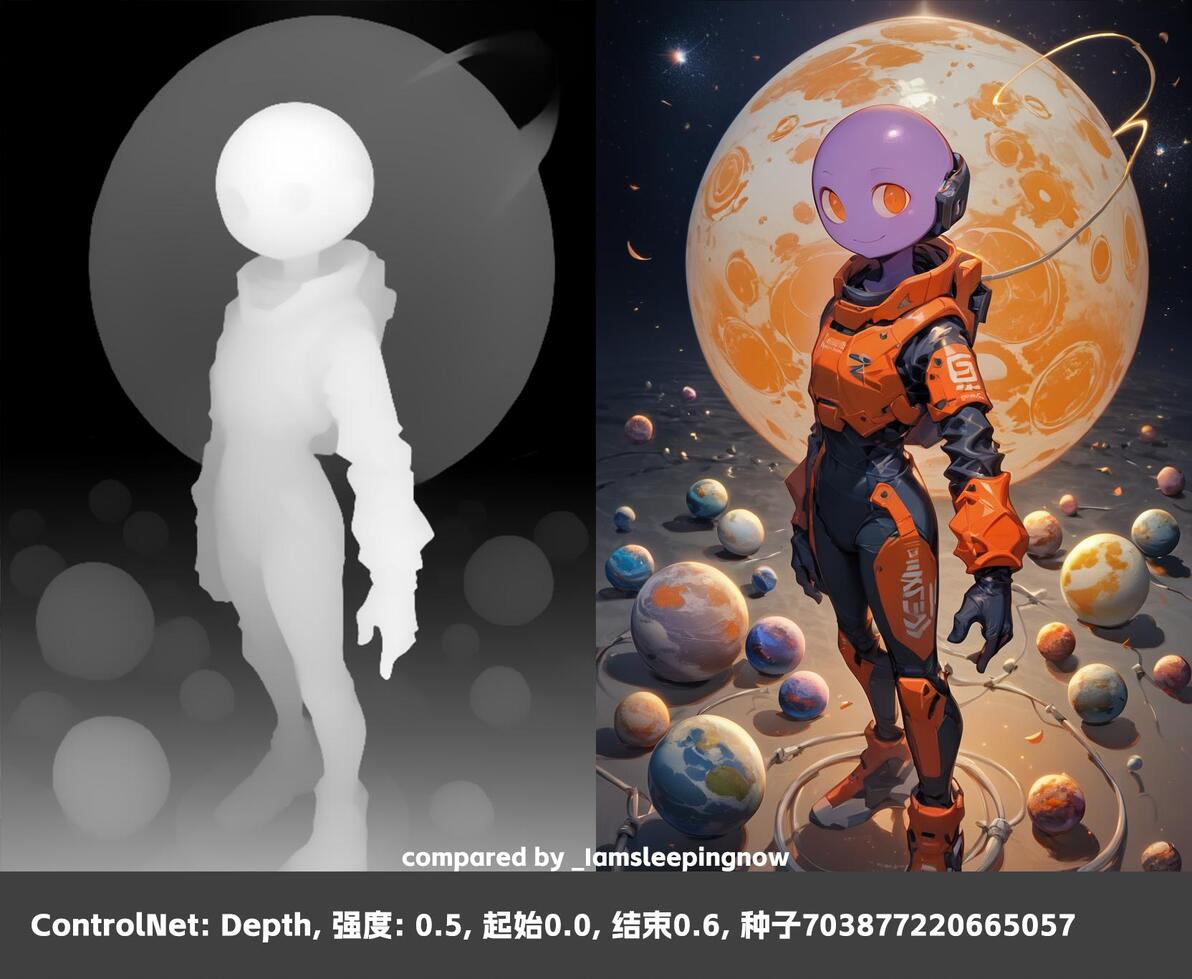
测试:Depth(将画面与深度图匹配的ControlNet)
ControlNet: https://hf-mirror.com/diffusers/controlnet-zoe-depth-sdxl-1.0/tree/main
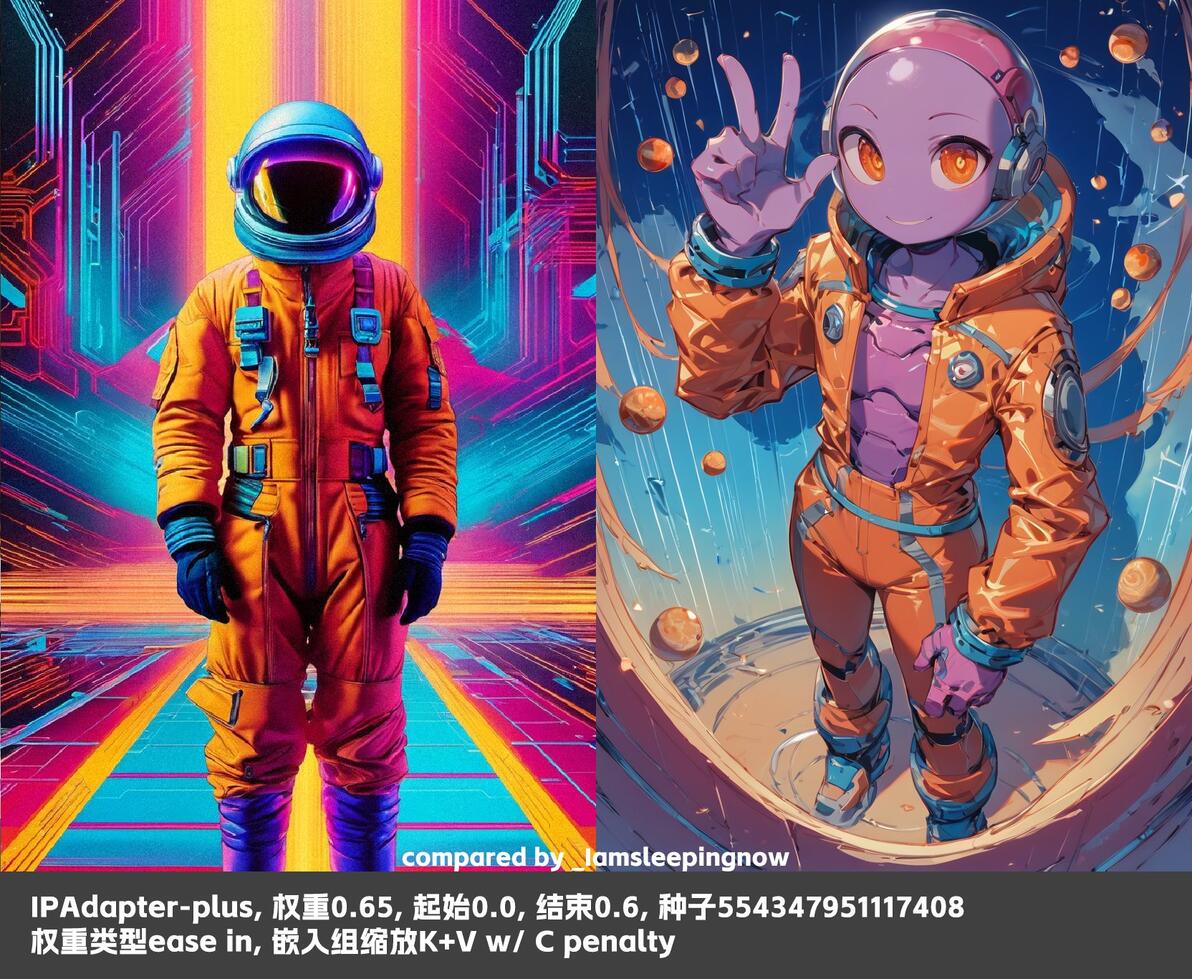
测试:IPAdapter-plus(图像提词适配器)
PonyXL与IPAdapter的兼容不是很好,画面会出现故障,可能在测试时需要削弱IPA应用的权重,以及修改应用的权重曲线和嵌入组缩放算法。
测试:Inpainting(在图像内部限定遮罩范围内进行重绘)
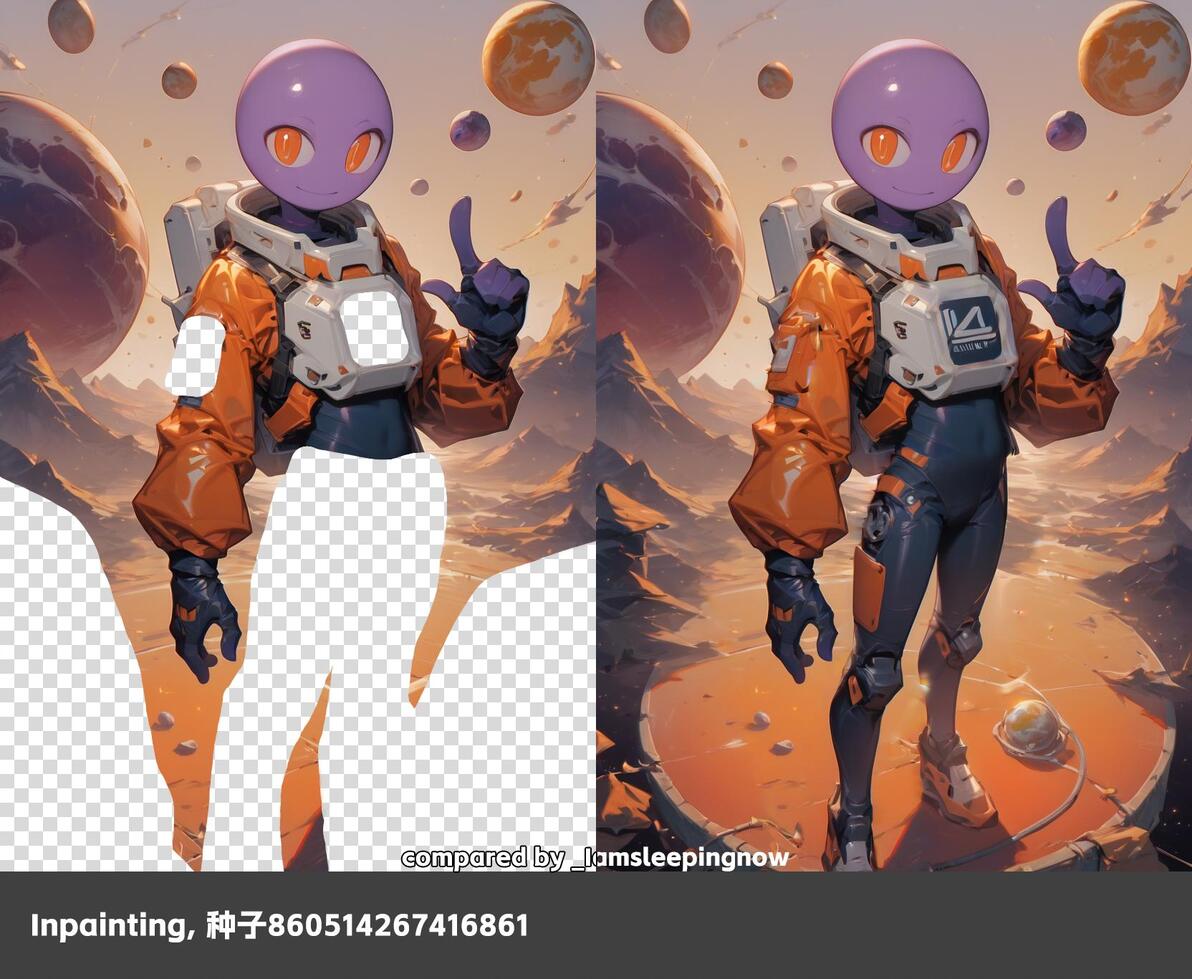
当前工作流一览:https://github.com/Iamsleepingnow/Iamsleepingnow-ComfyWorkflows/blob/main/WFlow_PonyXL_DepthControlnet_by_Iamsleepingnow.json
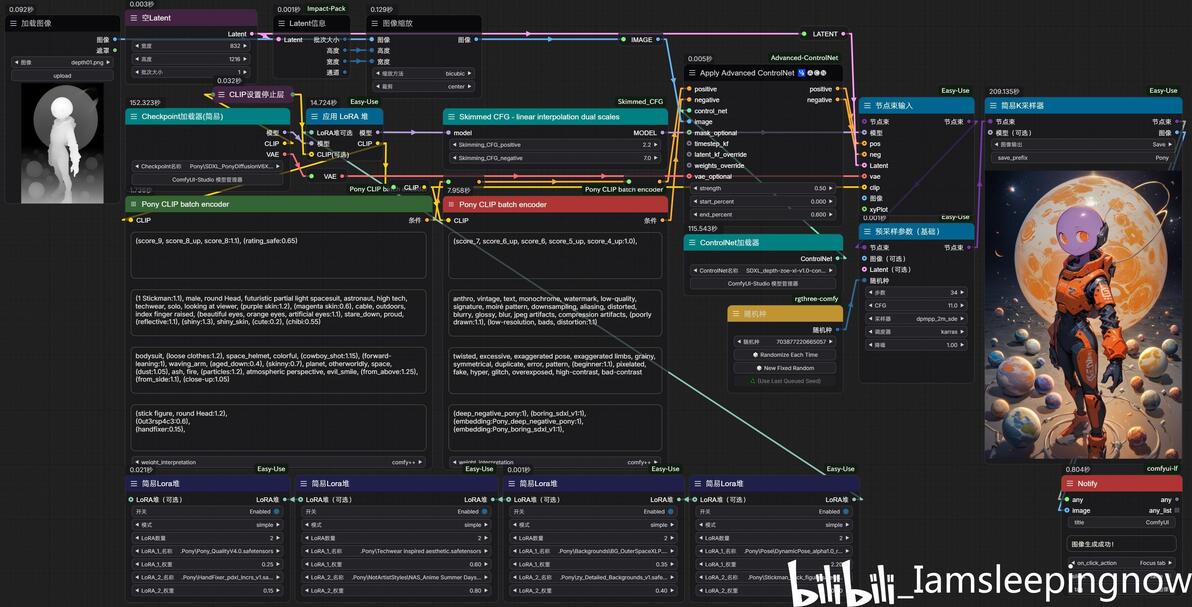
LoRAs:https://civitai.com/models/333358/ponydiffusion-quality-slider、https://civitai.com/models/845407/hand-fixer-or-concepttool-lora-xl、https://civitai.com/models/1027187/techwear-inspired-aesthetic、https://civitai.com/models/264290?modelVersionId=372898、https://civitai.com/models/454079?modelVersionId=515448、https://civitai.com/models/633524/background-detail-enhancer、https://civitai.com/models/438059/dynamic-poses-slider-ponyxl、https://civitai.com/models/748085/stickman-stick-figure
Embedding:https://civitai.com/models/831971/deep-negative-pony、https://civitai.com/models/300217/boringsdxl-enhance-images-stylistically-and-topically-for-pony-diffusion-v6 | ControlNet: https://hf-mirror.com/diffusers/controlnet-zoe-depth-sdxl-1.0
八、关于重绘和放大
重绘与放大的思路与XL差不多,就是在应用TileControlNet的同时于采样器中调整降噪的重绘幅度。

我们可以使用ComfyUI-Detail-Daemon插件来在重绘时的调度流程中添加更多的画面细节。由于该插件我已经在之前的专栏中介绍过了(如下),所以在这个PonyXL流程中可以直接用。
插件:ComfyUI-Detail-Daemon: https://github.com/Jonseed/ComfyUI-Detail-Daemon
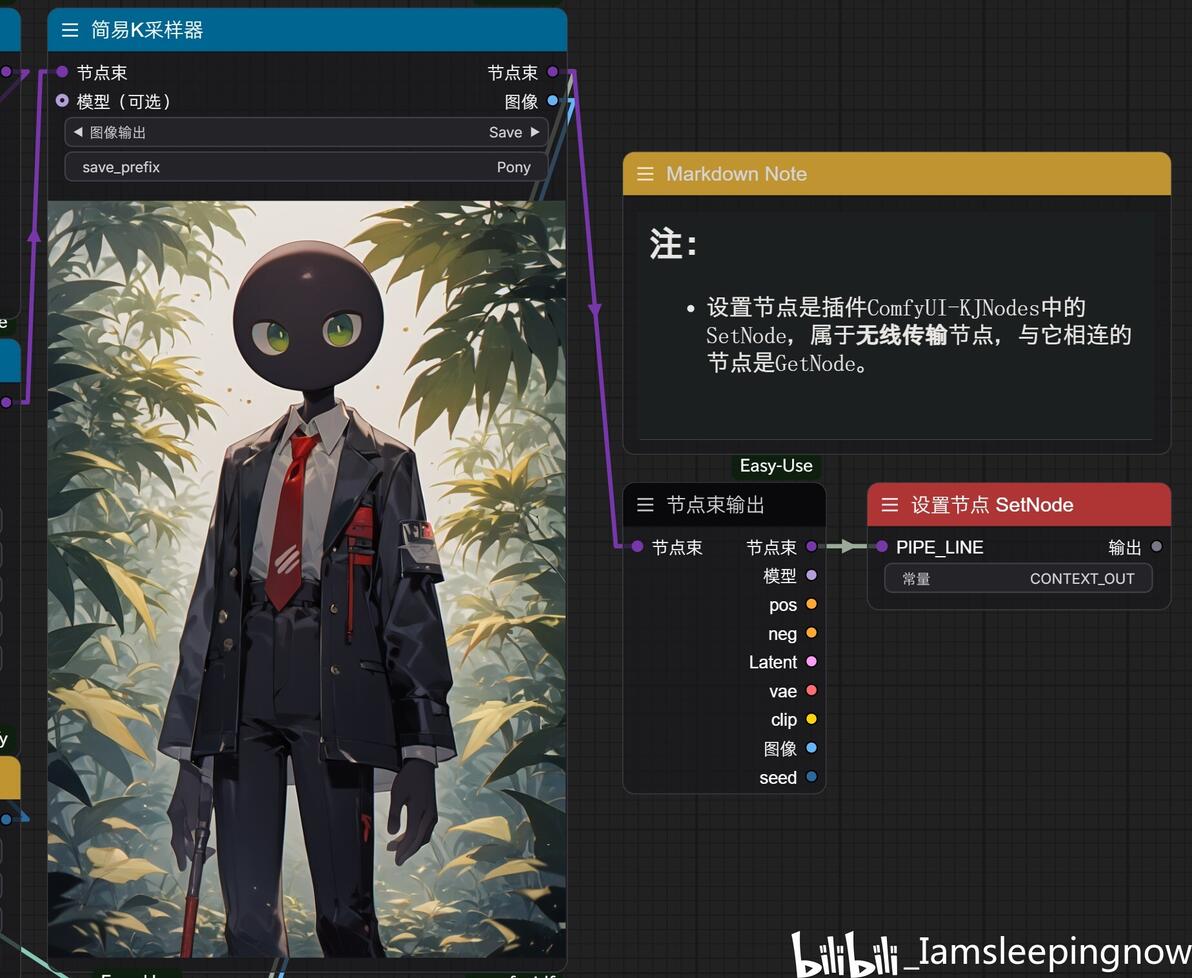
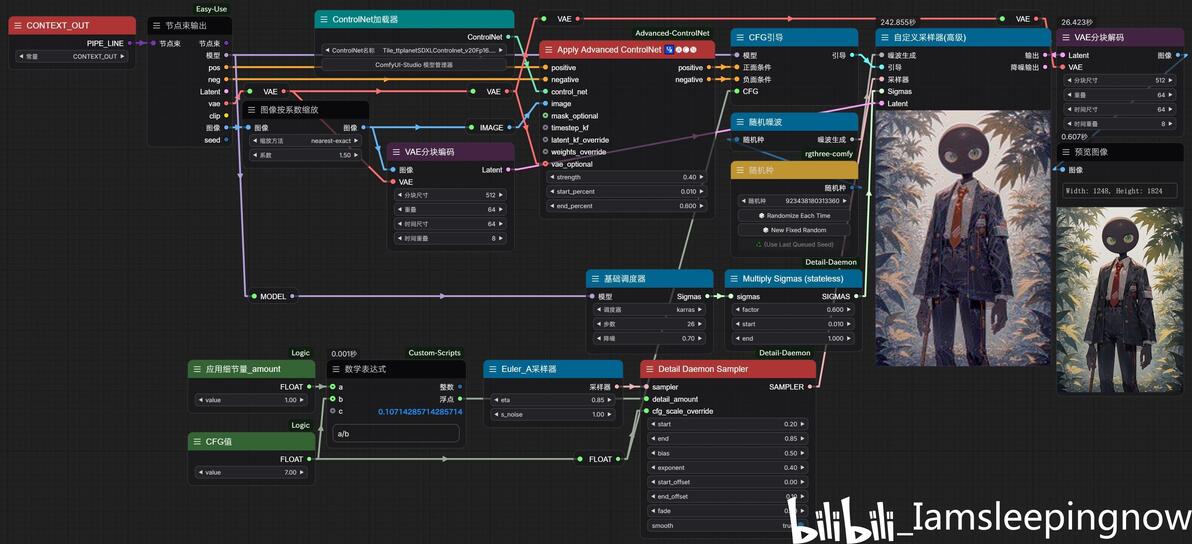
由于上下文流程太长了,所以这里需要使用管线节点来排一下版。将简易K采样器的输出节点束与一个传输节点SetNode相连(示例中使用插件ComfyUI-KJNodes,在ComfyUI-Easy-Use中也有平替节点),修改常量参数为自定义名称。
这里使用GetNode来获取一下上下文通道,然后用节点束来解包。处理一下原图,将原图放大1.5倍,将放大后的图作为TileControlNet的垫图,同时使用VAE分块编码的方式转为潜空间Latent。

然后使用一个自定义采样器(高级)来进行重绘采样,将之后会输出的Latent进行分块解码。这里还需要输入采样器和Sigmas。by _Iamsleepingnow bili

使用基础调度器karras和Euler_A采样器,然后接入Detail Daemon Sampler节点进行调度,最后将输出的Sampler输入自定义采样器(高级)中。
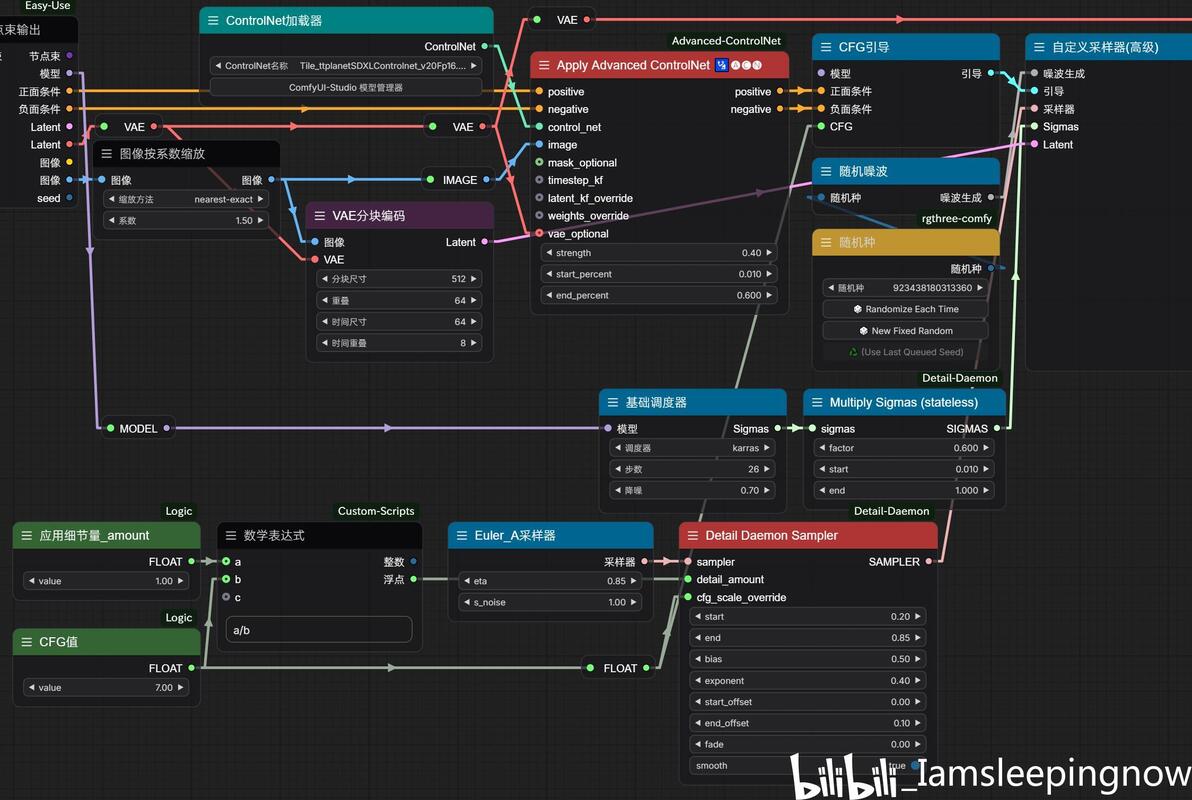
执行队列,查看输出结果。
从结果上来看,细节增量的效果还可以。
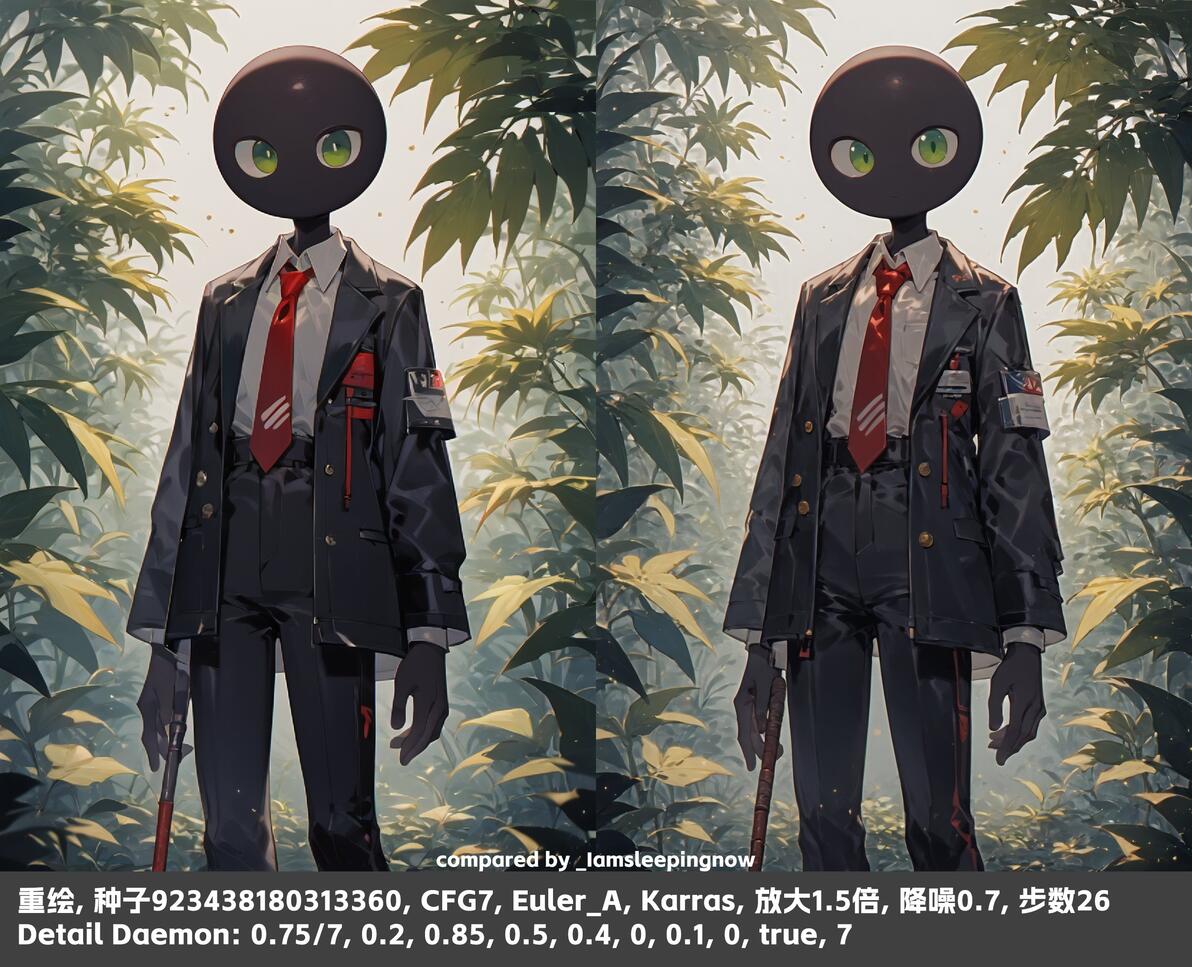
当前工作流一览:https://github.com/Iamsleepingnow/Iamsleepingnow-ComfyWorkflows/blob/main/WFlow_PonyXL_Repainting_by_Iamsleepingnow.json
LoRAs:https://civitai.com/models/333358/ponydiffusion-quality-slider、https://civitai.com/models/845407/hand-fixer-or-concepttool-lora-xl、https://civitai.com/models/1027187/techwear-inspired-aesthetic、https://civitai.com/models/264290?modelVersionId=372898、https://civitai.com/models/454079?modelVersionId=505533、https://civitai.com/models/633524/background-detail-enhancer、https://civitai.com/models/438059/dynamic-poses-slider-ponyxl、https://civitai.com/models/748085/stickman-stick-figure
Embedding:https://civitai.com/models/831971/deep-negative-pony、https://civitai.com/models/300217/boringsdxl-enhance-images-stylistically-and-topically-for-pony-diffusion-v6 | ControlNet: https://civitai.com/models/330313/ttplanetsdxlcontrolnettilerealistic
当需要把图像放得很大时,采样器通常会爆显存,这一点十分困扰,所以我们可以使用插件ComfyUI_UltimateSDUpscale来进行分块放大。
插件:ComfyUI_UltimateSDUpscale: https://github.com/ssitu/ComfyUI_UltimateSDUpscale
但这种分块放大方法有个缺点,当图像需要放得很大,例如2倍放大时,由于两张图之间的倍数差太大(2-1=1),导致模型不能很好地理解细节,画错的概率很大。这时如果增强TileControlnet的应用强度,哪怕出图不会出现多主体的情况,图像生成的效果也会因为过拟合而大打折扣。
有一个解决方法是,分多次来放大,每次只放大一点点,让图像倍数差缩小,直到放大到目标尺寸为止。这种方法被称作递归放大。递归放大的倍数差最好控制在0.05~0.2之间,超过此值图像会变得不稳定。
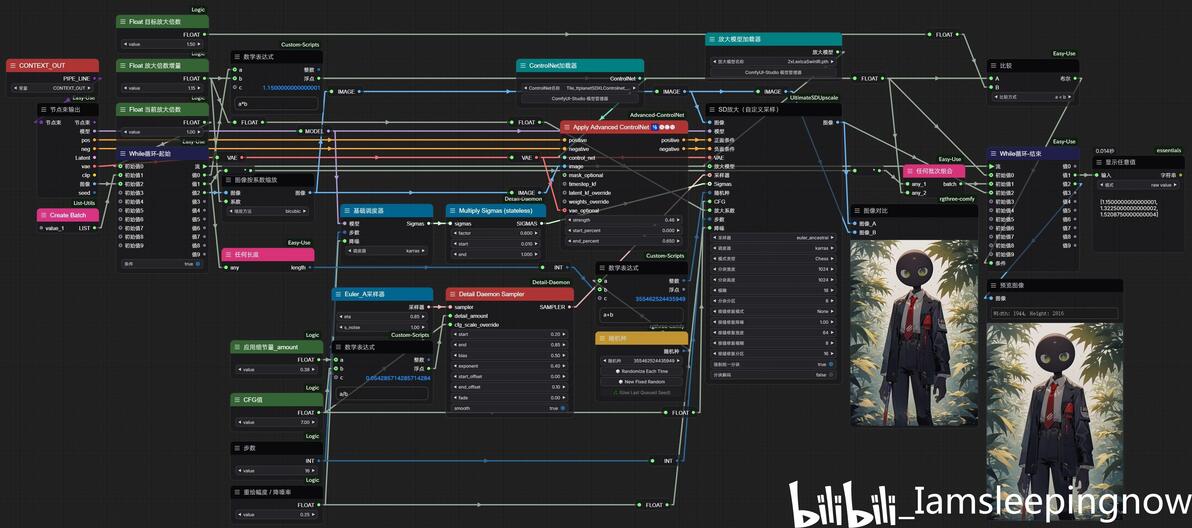
首先我们需要实现下图的递归模版。使用ComfyUI-Easy-Use插件的While循环体来作为主要框架,输入两个参数:一个记录当前放大的实际倍数,一个记录单次放大的倍数增量。当目前放大的倍数大于等于目标放大倍数时,跳出循环并输出图像。by _Iamsleepingnow bili
注:循环节点由起始节点和结束节点构成,其中,两个节点需要以“流”参数进行连接。起始节点的初始值代表该数值通道的默认值,当数值接入到结束节点的初始值时,代表在下个循环时该值将覆盖起始节点的该值通道。结束节点的“条件”参数是个布尔值,当该值为True时才能进行下一次循环。

插件:ComfyUI-List-Utils: https://github.com/godmt/ComfyUI-List-Utils
插件:ComfyUI_essentials: https://github.com/cubiq/ComfyUI_essentials
插件:ComfyUI-Custom-Scripts: https://github.com/pythongosssss/ComfyUI-Custom-Scripts
然后将放大流程插入循环体,增加TileControlNet的应用幅度,削减Detail Daemon的细节应用量,降低生成步数和降噪幅度,设置随机种递增。
插件:rgthree-comfy: https://github.com/rgthree/rgthree-comfy
插件:ComfyUI-Advanced-ControlNet: https://github.com/Kosinkadink/ComfyUI-Advanced-ControlNet
插件:ComfyUI-Logic: https://github.com/theUpsider/ComfyUI-Logic
当前工作流一览:https://github.com/Iamsleepingnow/Iamsleepingnow-ComfyWorkflows/blob/main/WFlow_PonyXL_RecursiveUpscale_by_Iamsleepingnow.json

图注:工作流(其一)
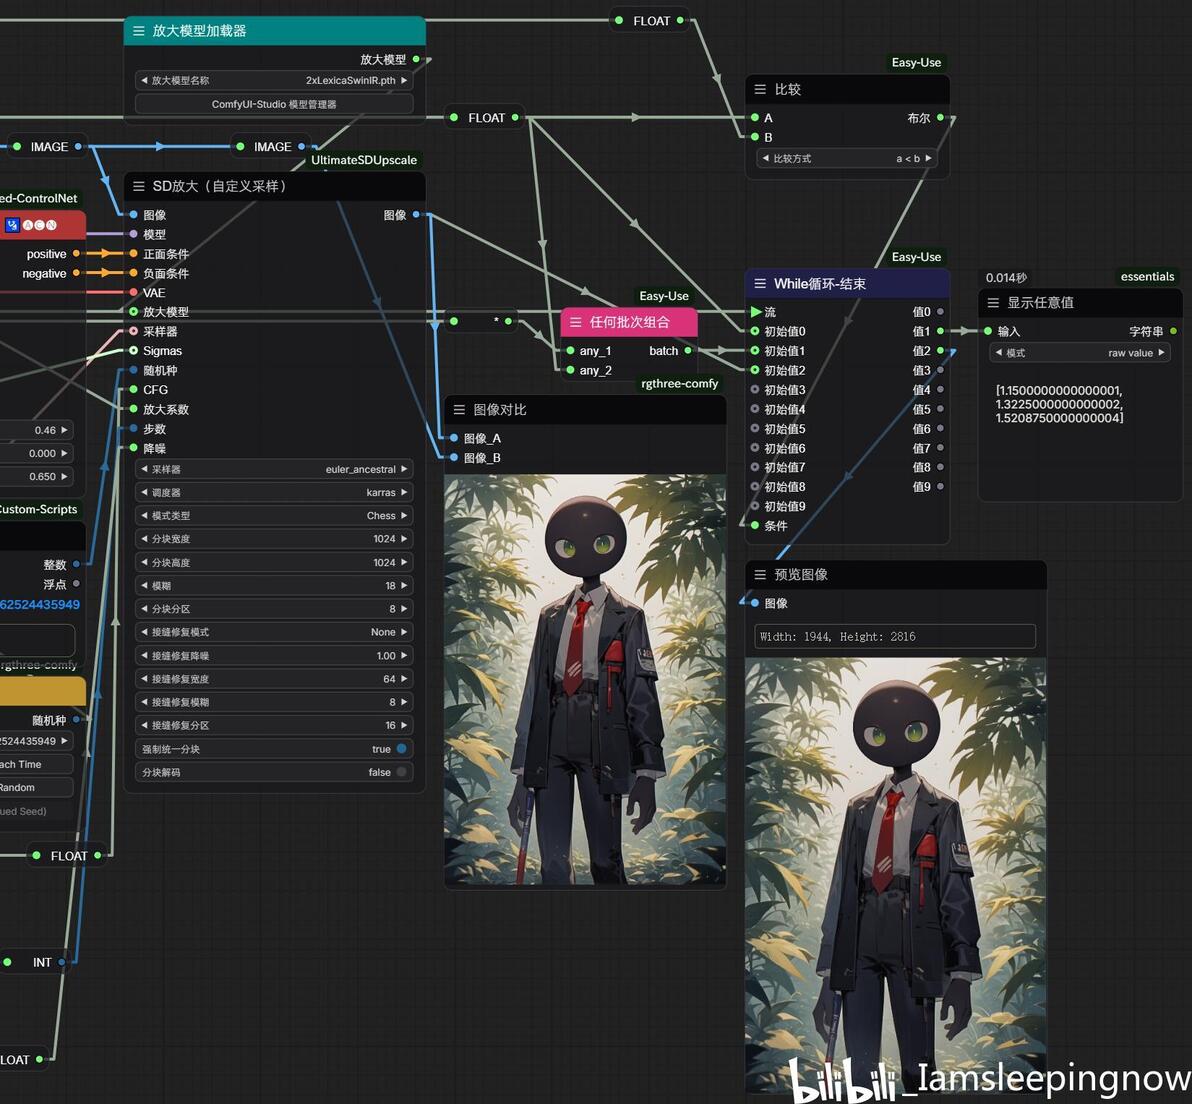
图注:工作流(其二)
九、小结
还是之前说的,PonyXL是一个偏见模型,非常依赖LoRA,有时无论怎么修改提词都无法出效果,这可能是模型问题,不一定是使用者的问题。
总而言之,这个模型是Diffusion社区贡献的产物,质量非常高,但是比较吃理解,一般多出几次图就能找到经验。
