第3版包含主要内容:数据加载、存储与文件格式,读写文本格式的数据,二进制数据格式,与Web API交互,与数据库交互;数据清洗和准备,处理缺失数据, 数据转换,扩展数据类型,字符串操作,分类数据;数据规整:连接、联合和重塑,层次化索引,联合与合并数据集,重塑和透视。
利用Python进行数据分析第3版中英文PDF+源代码
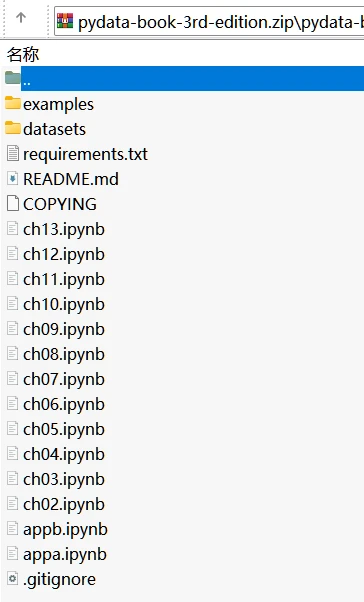
《利用Python进行数据分析第3版》中文PDF,512页,有书签,文字可复制;英文PDF,812页;配套源代码
下载: https://pan.baidu.com/s/1z8RPMm8nathNxv1HOneZ_w?pwd=awa5
提取码: awa5
NumPy可以在整个数组上执行复杂的运算,而不需要Python的for循环,for循环对于大型序列速度较慢。NumPy之所以比常规的Python代码快,是因为NumPy的基于C语言的算法无须对Python代码进行解释,节省了开销。基于NumPy的算法要比纯Python算法快10~100倍(甚至更快),并且使用的内存更少。
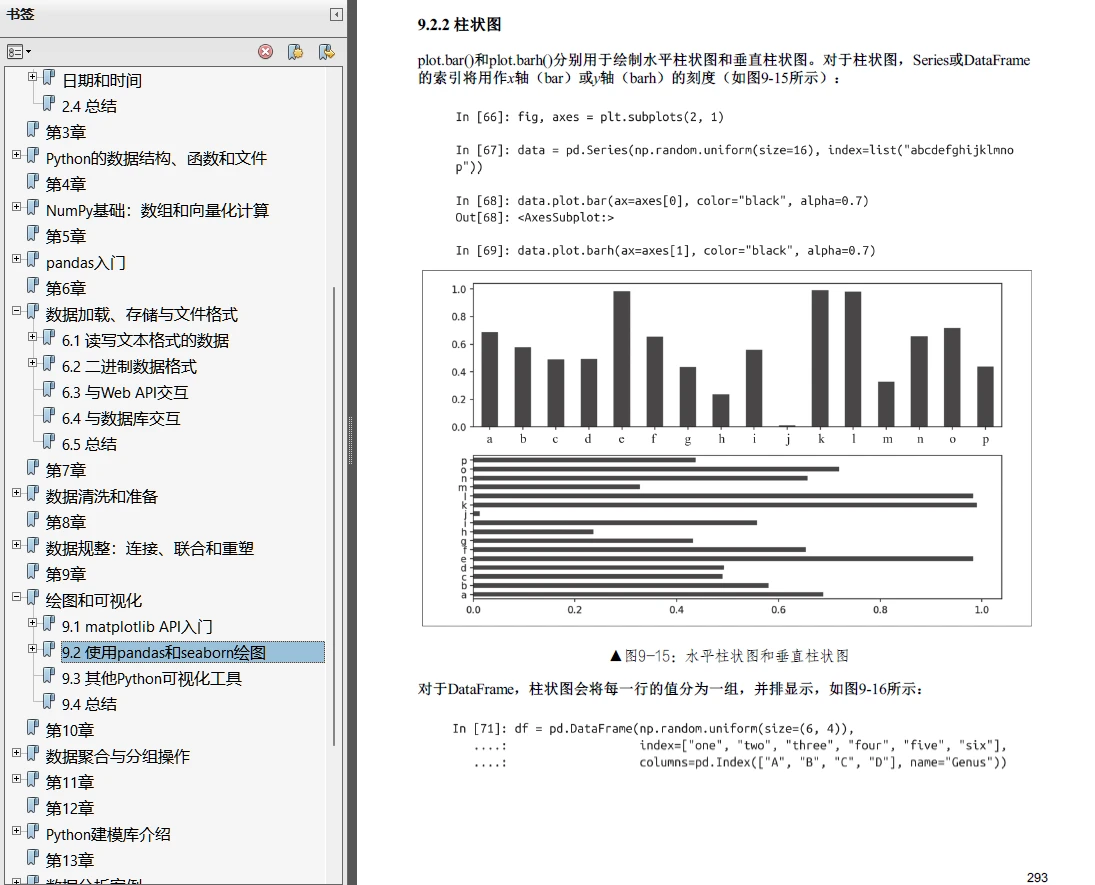
NumPy的核心特点之一就是其N维数组对象,即ndarray,该对象是一个快速且灵活的Python大数据集容器。利用数组可以对整块数据做数学运算,其语法类似于标量元素之间的运算。
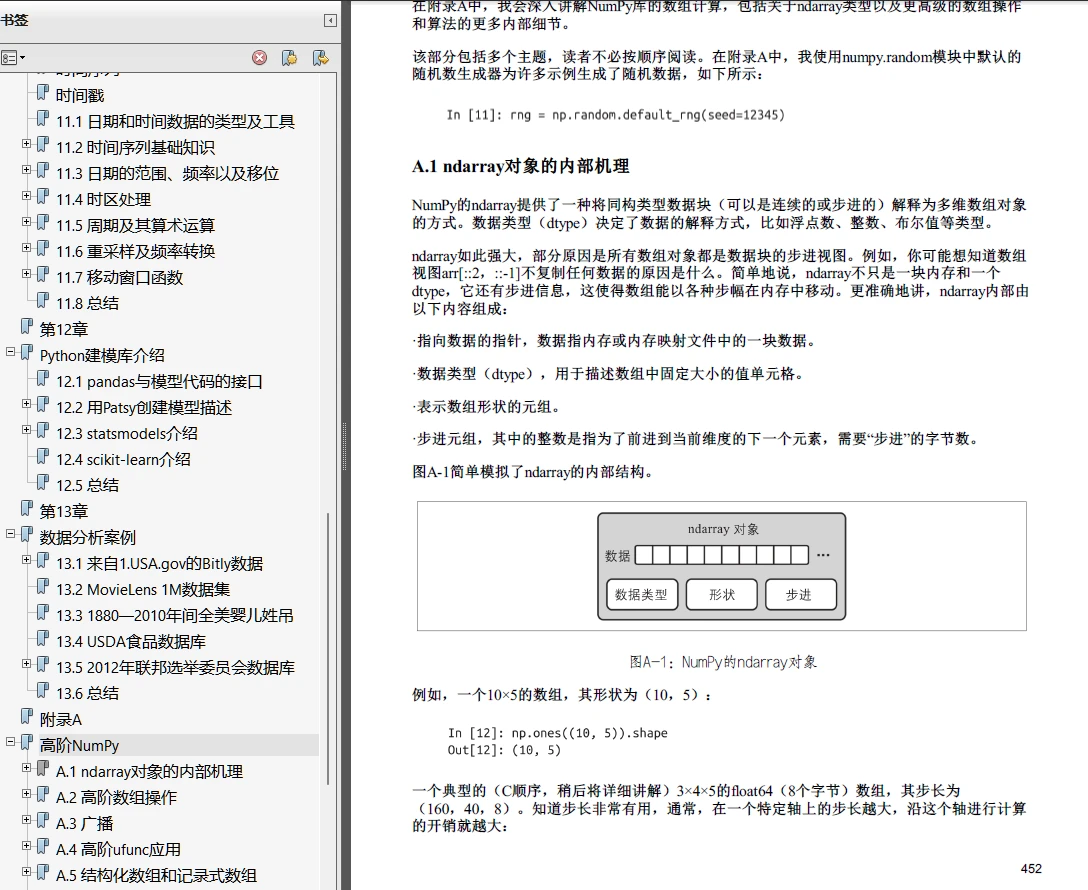
针对 Python3.10 和 pandas1.4 进行了更新,并通过实操讲解和实际案例展示了如何高效地解决一系列数据分析问题。在阅读过程中学习新版本的 andas、NumPy、IPython 和 Jupyter。
numpy的命名空间很大,包含许多函数,其中一些函数名与Python的内置函数重名(比如min和max)。遵循标准引用方式是最稳妥的。ndarray是通用的同构数据多维容器,同构数据是指其中所有元素必须是相同类型的。每个数组都有一个shape(用于表示各维度大小的元组)和一个dtype(用于说明数组的数据类型)。