

DB-GPT是一个开源的AI原生数据应用开发框架,它结合了AWEL(Agentic Workflow Expression Language)和代理技术。该项目的目的是通过开发多模型管理(SMMF)、文本到SQL效果优化、RAG框架及其优化、多代理框架协作、AWEL(代理工作流编排)等多项技术能力,在大型模型领域构建基础设施,使得使用数据的大模型应用变得更加简单和便捷。
在数据3.0时代,基于模型和数据库,企业和开发者可以使用更少的代码构建自己的定制应用。DB-GPT的核心能力包括RAG(检索增强生成)、GBI(生成式商业智能)、模型微调框架、数据驱动的多代理框架、数据工厂以及集成各种数据源以无缝连接生产业务数据到DB-GPT的核心能力。
今天给大家介绍一下DB-GPT使用Docker 以及K8S上实现部署。
1.Docker 部署
首先我们 需要找一台安装好docker 运行环境服务器或者本地电脑。windows平台上可以安装Docker Desktop ,Linux平台可以直安装docker.关于docker 的安装,这里就不展开,大家可以自行搜索安装。
1.数据库
我先把创建好数据库,数据库初始化脚本就行创建。这块考虑数据库做持久化,就不使用官方提供的容器数据库。
我们使用dbeaver数据库客户端管理工具,创建数据库

输入数据库名称,点击OK 按钮创建


接下来我们导入数据库脚本。
脚本地址:https://github.com/eosphoros-ai/DB-GPT/blob/main/assets/schema/dbgpt.sql

选择数据库-打开SQL编辑器-复制dbgpt.sql里面的内容到SQL编辑器里面

点击执行SQL语句。

执行完成后,数据库SQL 脚本初始化工作完成。

2.docker命令行创建
接下来我们使用docker命令行方式安装DB_GPT.
找一台已经安装好docker运行环境的机器,我这里使用linux服务器作为项目演示和介绍。
2.1镜像下载
进入Linux 服务器,输入如下命令行:
docker pull eosphorosai/dbgpt:latest

第一次下载会比较慢,目前该镜像包含最新的DB_GPT 版本号是0.6.3,镜像大小大概是12GB

目前DB_GPT提供多种方式实现容器化部署,有容器包含模型的,有通过非模型代理API方式的。其中非模型代理API也有很多种,官方文档中有1.通过OpenAI代理模型运行、2.通过通义代理模型运行、3.通过智普代理模型运行、4.通过文心代理模型运行、5.通过Gemini代理模型运行 等多种方式
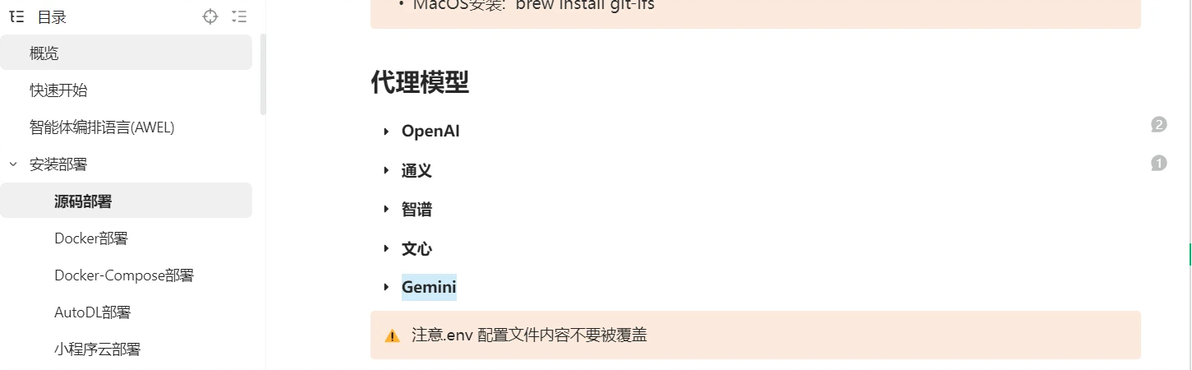
本文采用了硅基流动代理模型运行方式来实现。官方的文档未更新,我这边是根据最新源码反推断来实现的部署方式。
2.2 docker 运行
docker 运行的命令行如下
#SILICON_FLOW
PROXY_API_KEY="sk-XXX"
PROXY_SERVER_URL="https://api.siliconflow.cn/v1/chat/completions"
docker run -d \
-p 5670:5670 \
-e LOCAL_DB_TYPE=mysql \
-e LOCAL_DB_HOST=192.168.xxx.xxx \
-e LOCAL_DB_NAME=dbgpt \
-e LOCAL_DB_PORT=3306 \
-e LOCAL_DB_USER=root \
-e LOCAL_DB_PASSWORD= 数据库密码 \
-e LLM_MODEL=siliconflow_proxyllm \
-e PROXY_SERVER_URL=$PROXY_SERVER_URL \
-e SILICONFLOW_MODEL_VERSION=internlm/internlm2_5-7b-chat \
-e SILICONFLOW_API_BASE=https://api.siliconflow.cn/v1 \
-e SILICONFLOW_API_KEY=$PROXY_API_KEY \
-e EMBEDDING_MODEL=proxy_http_openapi \
-e PROXY_HTTP_OPENAPI_PROXY_SERVER_URL=https://api.siliconflow.cn/v1/embeddings \
-e PROXY_HTTP_OPENAPI_PROXY_API_KEY=$PROXY_API_KEY \
-e PROXY_HTTP_OPENAPI_PROXY_BACKEND=BAAI/bge-large-zh-v1.5 \
-e RERANK_MODEL=rerank_proxy_siliconflow \
-e RERANK_PROXY_SILICONFLOW_PROXY_SERVER_URL=https://api.siliconflow.cn/v1/rerank \
-e RERANK_PROXY_SILICONFLOW_PROXY_API_KEY=$PROXY_API_KEY \
-e RERANK_PROXY_SILICONFLOW_PROXY_BACKEND=BAAI/bge-reranker-v2-m3 \
-e LANGUAGE=zh \
--name dbgpt  \
eosphorosai/dbgpt以上命令行我们简单介绍一下。
PROXY_API_KEY 是硅基流动API KEY
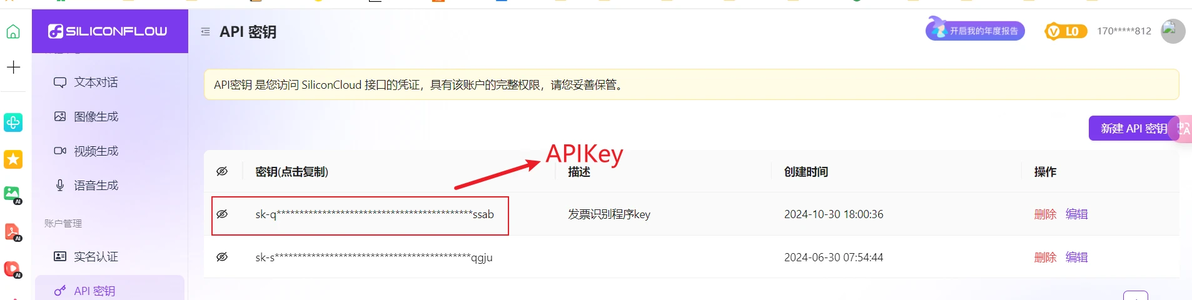
PROXY_SERVER_URL 是硅基流动LLM的 模型请求地址,如果大家没有硅基流动的账号,可以点击https://cloud.siliconflow.cn/i/e0f6GCrN 地址来注册,目前硅基的政策是新户注册送14块钱,14块钱够玩一阵子了。
LOCAL_DB 开头的是数据库的配置,我们上面用了mysql 这里就介绍了mysql数据库连接相关配置。
LLM_MODEL=siliconflow_proxyllm 这里我们用了硅基流动的proxyllm 参考这个写就可以了,大家可以按照上面抄就可以了。
SILICONFLOW_MODEL_VERSION= internlm/internlm2_5-7b-chat 这里就是我们用到的硅基LLM的模型,这个模型可以参考硅基提供的LLM,具体可以参考如下图:

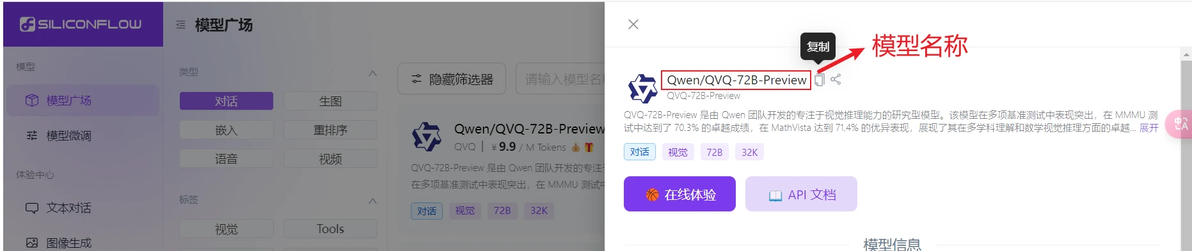
我上面用的 internlm/internlm2_5-7b-chat ,大家可以根据自己实际情况选择。
EMBEDDING 和RERANK_MODEL 和上面llm配置类似,这里就不详细展开。
将以上docker run 命令在Linux 服务器上运行。

执行完成后,我们可以利用下面的命令查看容器启动日志
docker logs dbgpt -f

我们也可以借用第三方容器可视化界面查看容器启动情况

3.DB-GPT使用
我们使用浏览器打开网页http://192.168.xx.xxx:5670/
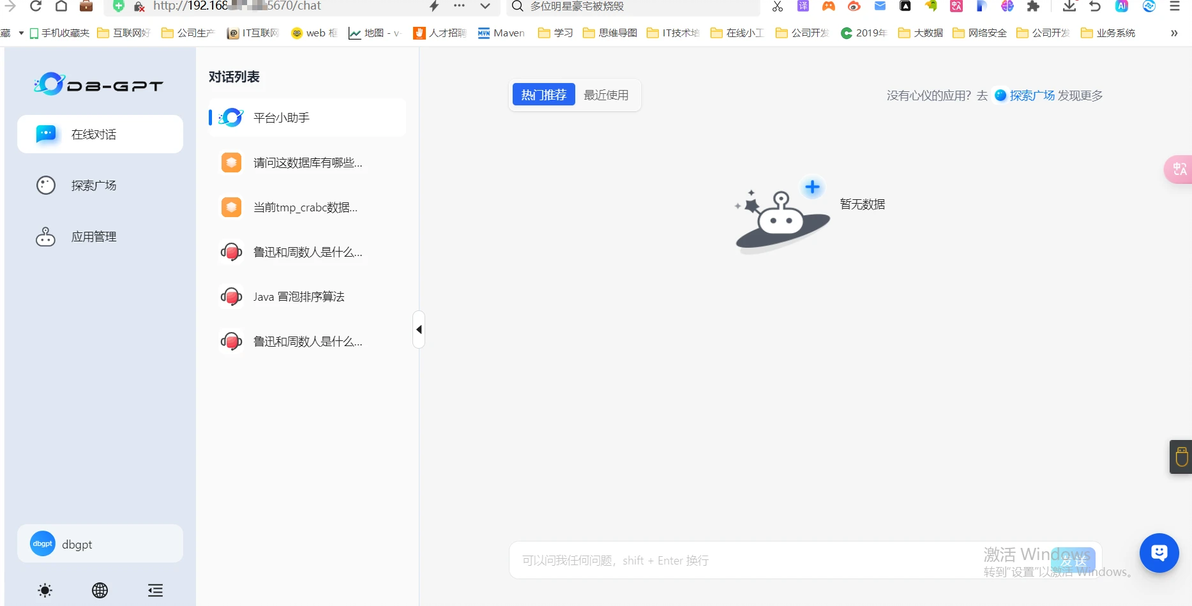
看到上面的管理界面说明我们DB-GPT通过硅基流动API方式就能访问了。

通过以上方式我们就通过docker命令行的方式实现DB-GPT的部署了。
2.Rancher 部署
以上我们使用docker方式部署,考虑到后面集群模式部署或则可以部署多个DB-GPT给其他小伙伴使用。所以我们带大家使用
Rancher (K8S)方式实现部署。这里需要服务器上已经安装好Rancher (K8S),关于Rancher 部署比较复杂,这里我们也不展开介绍了。
2.1 docker镜像上传harbor
docker tag eosphorosai/dbgpt:latest yf.registry.xxx.com/yfzx-public/eosphorosai/dbgpt:latest docker push yf.registry.xxx.com/yfzx-public/eosphorosai/dbgpt:latest

上传成功后我们可以在harbor上查看上传的DB-GPT镜像

看到以上信息说明我们的dbgpt 的镜像已经上传到我们私有化镜像托管平台haror上了。
2.2 编写K8S.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
 name: dbgpt
 namespace: gpt
spec:
 replicas: 1
 selector:
   matchLabels:
     app: dbgpt
 template:
   metadata:
     labels:
       app: dbgpt
   spec:
     containers:
       - name: dbgpt
         image: yf.registry.xxx.com/yfzx-public/eosphorosai/dbgpt:latest
         ports:
           - containerPort: 5670
         env:
           - name: LOCAL_DB_TYPE
             value: "mysql"
           - name: LOCAL_DB_HOST
             value: "192.168.xxx.xxx"
           - name: LOCAL_DB_NAME
             value: "dbgpt"
           - name: LOCAL_DB_PORT
             value: "3306"
           - name: LOCAL_DB_USER
             value: "root"
           - name: LOCAL_DB_PASSWORD
             value: "xxxxx"
           - name: LLM_MODEL
             value: "siliconflow_proxyllm"
           - name: PROXY_SERVER_URL
             value: "https://api.siliconflow.cn/v1/chat/completions"
           - name: SILICONFLOW_MODEL_VERSION
             value: "internlm/internlm2_5-7b-chat"
           - name: SILICONFLOW_API_BASE
             value: "https://api.siliconflow.cn/v1"
           - name: SILICONFLOW_API_KEY
             value: "sk-scwicizfxvjkrcwzepffvbjjfmljpckzpnaxtkbkoiujqgju"
           - name: EMBEDDING_MODEL
             value: "proxy_http_openapi"
           - name: PROXY_HTTP_OPENAPI_PROXY_SERVER_URL
             value: "https://api.siliconflow.cn/v1/embeddings"
           - name: PROXY_HTTP_OPENAPI_PROXY_API_KEY
             value: "sk-scwicizfxvjkrcwzepffvbjjfmljpckzpnaxtkbkoiujqgju"
           - name: PROXY_HTTP_OPENAPI_PROXY_BACKEND
             value: "BAAI/bge-large-zh-v1.5"
           - name: RERANK_MODEL
             value: "rerank_proxy_siliconflow"
           - name: RERANK_PROXY_SILICONFLOW_PROXY_SERVER_URL
             value: "https://api.siliconflow.cn/v1/rerank"
           - name: RERANK_PROXY_SILICONFLOW_PROXY_API_KEY
             value: "sk-scwicizfxvjkrcwzepffvbjjfmljpckzpnaxtkbkoiujqgju"
           - name: RERANK_PROXY_SILICONFLOW_PROXY_BACKEND
             value: "BAAI/bge-reranker-v2-m3"
           - name: LANGUAGE
             value: "zh"
---
apiVersion: v1
kind: Service
metadata:
 name: dbgpt
 namespace: gpt
spec:
 selector:
   app: dbgpt
 ports:
   - protocol: TCP
     port: 5670
     targetPort: 5670
 type: ClusterIP

---
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
 name: dbgpt-ingress
 namespace: gpt
spec:
 rules:
   - host: dbgpt.yfzx.965432.com
     http:
       paths:
         - path: /
           pathType: Prefix
           backend:
             service:
               name: dbgpt
               port:
number: 56702.2 rancher导入k8s.yaml
我们登陆rancher 平台,在gpt的命名空间中导入以上K8S.YAML文件

点击 导入按钮,稍等几分钟等待rancher平台部署这个K8S.yaml

部署完成后,我们看一下Deployment 监控状态

我们可以点开右边日志查看容器pod启动情况

以上说明DB-GPT在rancher 平台上运行成功。
2.3 使用
我们点击工作负载对应80端口

浏览器打开URL链接http://dbgpt.xxx.xxx.com/

页面能够打开,接下来我们在找一个在线聊天窗口测试一下LLM大模型是否能够使用

以上模型返回消息了,说明我们在rancher平台上部署也是OK的了。
总结
DB-GPT是一个开源的AI原生数据应用开发框架,目前它提供了chat excel 、chat dashboard、chat data、chat DB 、chat Normal、chat Knowlege 另外DB-GPT 也开始支持工作流等功能了。今天主要带大家分别在docker 上和rancher 平台上使用硅基流动的API方式实现了DB-GPT的部署,感兴趣小伙伴可以参考上面的内容自己部署一下。今天的分享到这里,我们下个文章见。
参考文献:
https://github.com/eosphoros-ai/DB-GPT
https://www.yuque.com/eosphoros/dbgpt-docs/urh3fcx8tu0s9xmb
